作者注:从安装到 snapshot、ref 操作、结果校验,5 步掌握 agent-browser 的「读页面、点元素、再读页面」循环,让 AI Agent 稳定驱动真实浏览器。
让 AI Agent 操作网页,常见的难点在于它看不到页面,也很难稳定地点中目标元素。截图加坐标点击的方案消耗大量 token,还容易点偏;直接把整段 HTML 交给模型,上下文很快就会被撑满。本文介绍 agent-browser 的 snapshot-ref 操作循环,帮助你掌握让 Agent「一次一条命令」驱动浏览器的方法。
这不是又一篇浏览器自动化框架的概念科普,下面按实际上手顺序,拆解 agent-browser 的安装、snapshot 与 ref 的配合、失败重试策略,以及如何把它接入 Agent 工作流。
核心价值:读完本文,你将理解 agent-browser 的 snapshot-ref 循环为什么适合大模型,并能在自己的 Agent 中用 5 条命令跑通第一个浏览器任务。
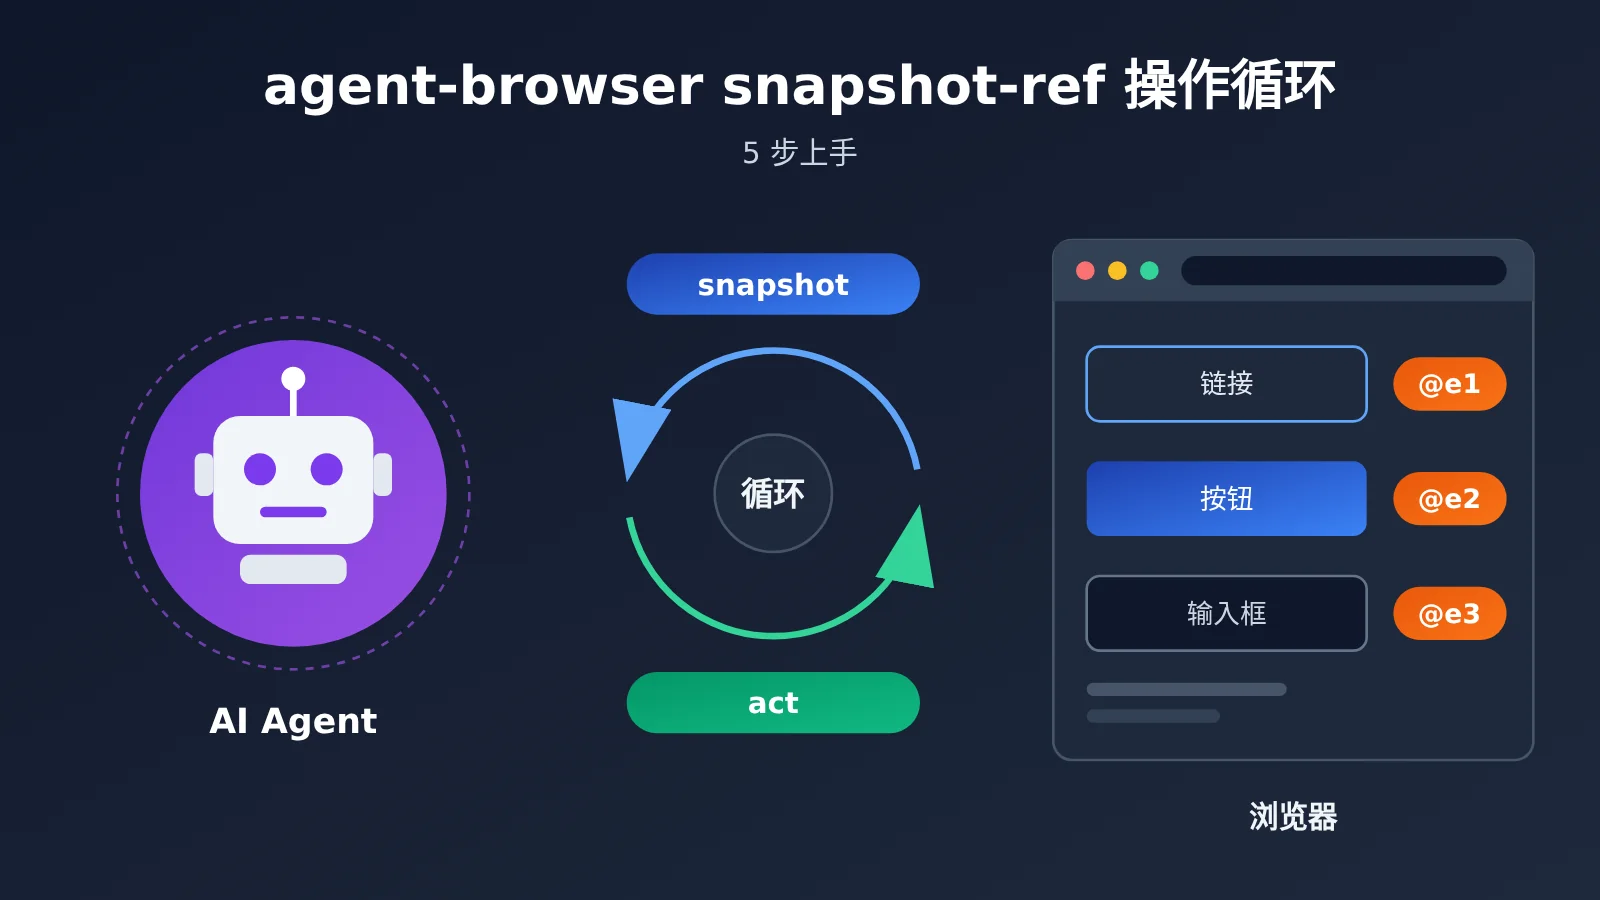
agent-browser snapshot-ref 循环核心要点
agent-browser 是 Vercel Labs 开源的浏览器自动化工具,采用 Apache-2.0 协议。它是一个原生 Rust CLI,目标很明确:给 AI Agent 一个能逐条命令驱动的浏览器。Agent 打开页面后,把页面读成无障碍树(accessibility tree)形式的紧凑文本,再通过 shell 命令对元素执行操作。
| 要点 | 说明 | 对 Agent 的价值 |
|---|---|---|
| snapshot 紧凑文本 | 页面以无障碍树形式输出,每个元素带 @e1 这类 ref |
比截图和原始 HTML 更省上下文 |
| ref 精准定位 | 操作命令直接引用 ref,如 click @e1 |
不必让模型自己拼 CSS 选择器 |
| 浏览器常驻 | 后台守护进程保持浏览器打开 | 每一步只是一次简短的 shell 调用 |
| 失败显式报错 | 元素被遮挡、隐藏、禁用时点击会失败而非假成功 | Agent 能根据真实反馈决定下一步 |
| 自带 skills | CLI 内置与版本匹配的使用说明 | Agent 读到的指令与已安装版本一致 |
snapshot-ref 循环的工作方式
这个循环可以概括为三个动作:先 snapshot 读页面,再对某个 ref 执行操作,然后再次读取页面确认结果,如此往复。官方给出的 example.com 快照只有一行:- link "Learn more" [ref=e1]。模型看到这一行,就知道页面上有一个名为 Learn more 的链接,并且可以用 @e1 去点击它。
这种设计把「理解页面」和「执行动作」拆成两个可验证的步骤,非常契合大模型的工具调用模式。模型不需要理解复杂的 DOM 结构,只需在文本里找到语义正确的元素,再引用对应的 ref 即可。每次操作后重新快照,也让 Agent 始终基于最新的页面状态做判断,而不是靠记忆猜测。
agent-browser 的底层架构
CLI 本身并不直接持有浏览器。第一条命令执行时,会启动一个后台守护进程(daemon),守护进程通过 Chrome DevTools Protocol 控制浏览器,后续每条 CLI 命令都发给这个守护进程。所以浏览器在命令之间始终保持打开,登录态、页面位置都不会丢失。
每个 --session 拥有独立的守护进程和浏览器,方便多个任务并行而互不干扰。默认情况下,无头浏览器在连续一小时没有收到命令后会被关闭,守护进程随之退出;如果配置了会话持久化(session persistence),退出前会先保存状态。
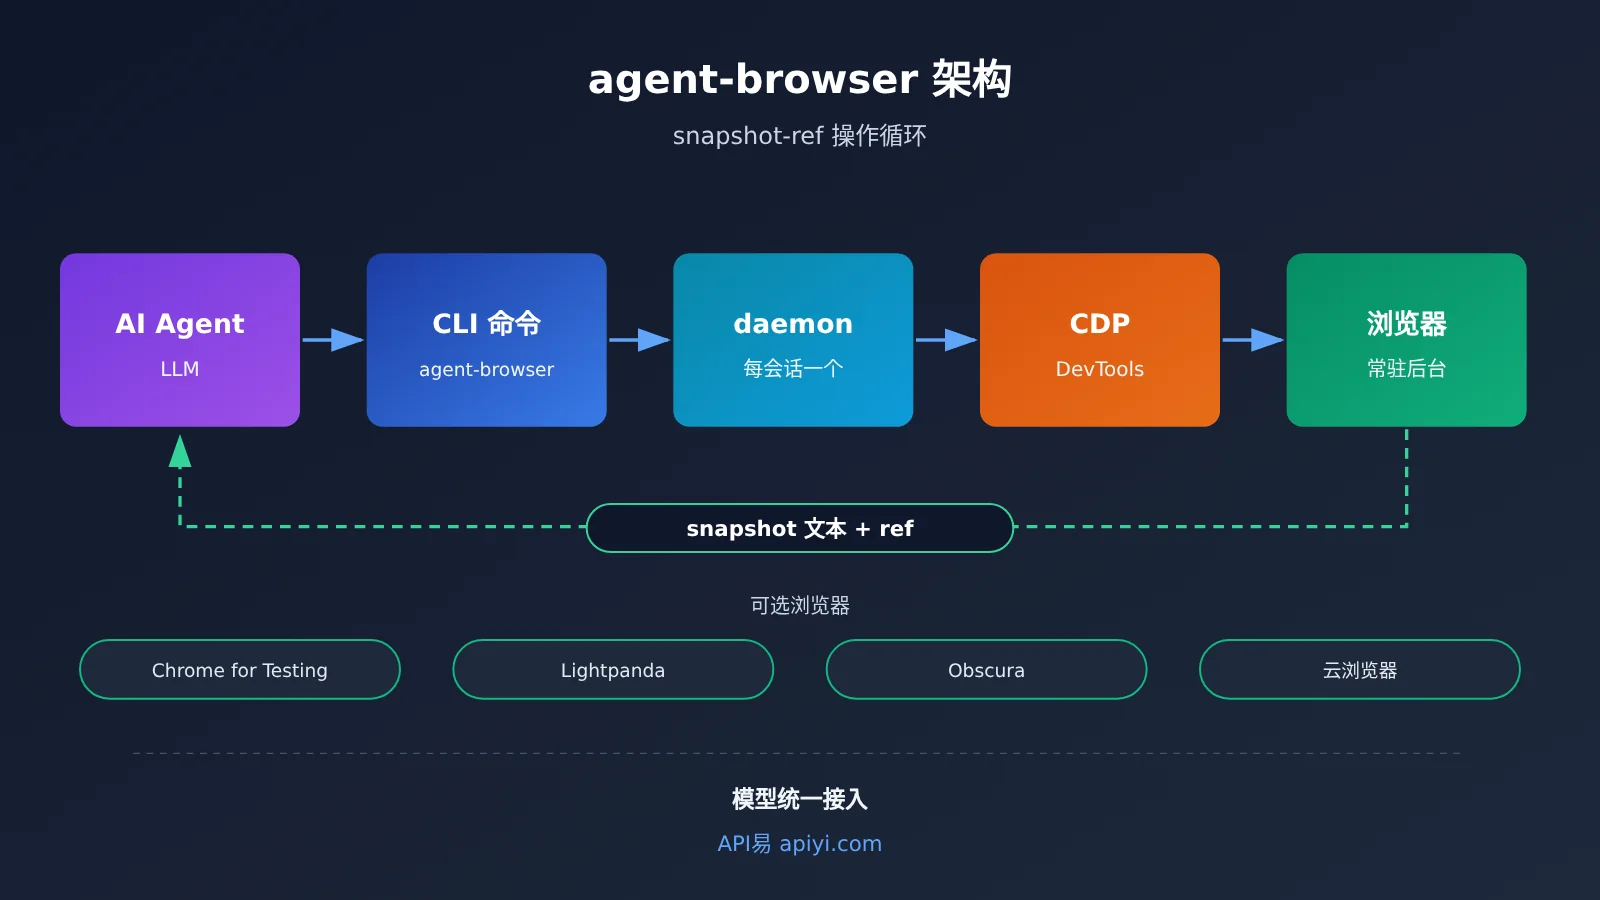
驱动这个循环的「大脑」是大模型。每一轮快照文本都会进入模型上下文,模型决定下一条命令,因此模型的指令遵循能力和单价直接影响任务成功率与成本。API易 提供本文涉及的 Claude、DeepSeek、Kimi 等模型的 API 调用,兼容 OpenAI 与 Anthropic 两种接口格式,接入文档见 docs.apiyi.com。
agent-browser 快速上手:5 步跑通 snapshot-ref 循环
第 1 步:安装 agent-browser 与浏览器
最常见的方式是通过 npm 全局安装,然后下载 Chrome for Testing。npm 包会根据宿主平台自动选择对应的原生二进制,目前覆盖 macOS(ARM64、x64)、Linux(ARM64、x64,glibc 与 musl)以及 Windows(x64)。
| 安装方式 | 命令 | 适用场景 |
|---|---|---|
| npm 全局安装 | 先 npm install -g agent-browser,再 agent-browser install |
大多数开发环境,首次需下载浏览器 |
| Homebrew | 先 brew install agent-browser,再 agent-browser install |
macOS 用户 |
| Linux 带依赖 | agent-browser install --with-deps |
服务器、容器,需同时安装浏览器系统库 |
| 免安装 | npx agent-browser open example.com |
临时试用、CI 中一次性任务 |
| 维护命令 | agent-browser upgrade、agent-browser doctor |
升级版本、排查环境问题 |
如果要从源码构建,官方要求 Node.js 24 及以上、pnpm 11 及以上以及 Rust 工具链。依次执行 pnpm install、pnpm build:source、pnpm link --global,最后运行 agent-browser install 即可。日常使用直接走 npm 安装就够了。
第 2 步到第 5 步:完整的最小循环
安装完成后,下面这组命令就是一个完整的 snapshot-ref 循环。建议先在终端手动跑一遍,确认每一步的输出,再交给 Agent 自动执行。
| 步骤 | 命令 | 作用 | 预期结果 |
|---|---|---|---|
| 2. 打开页面 | agent-browser open example.com |
启动守护进程并打开网址 | 浏览器常驻后台 |
| 3. 读取快照 | agent-browser snapshot -i |
只列出可交互元素,每个带 ref | 输出类似 link "Learn more" [ref=e1] |
| 4. 操作 ref | agent-browser click @e1 |
对快照中的元素执行点击 | 页面跳转或状态变化 |
| 5. 校验结果 | agent-browser get url |
读取当前 URL,确认动作生效 | 返回跳转后的地址 |
| 收尾 | agent-browser close |
关闭浏览器 | 释放资源 |
第 3 步里的 -i 参数很关键,它只输出可交互元素,能显著缩短快照文本,特别适合 token 预算有限的场景。第 5 步的校验也不能省,Agent 必须靠真实反馈判断操作是否成功,而不是默认「点了就算成功」。
🚀 快速开始:跑通手动循环后,就可以把这组命令交给 Agent。建议先通过 API易 apiyi.com 获取测试额度,用同一套任务分别试几款模型,观察谁更擅长从快照文本里挑出正确的 ref。接口兼容 OpenAI 与 Anthropic 格式,现有 Agent 框架基本只需替换密钥和地址,具体以 docs.apiyi.com 文档为准。
agent-browser ref 的有效期与重新快照
ref 描述的是「快照那一刻」的页面。页面一旦发生导航或 DOM 变化,旧的 ref 就可能失效,甚至指向错误的元素。因此铁律是:每次跳转或页面明显变化后,先重新执行 snapshot,再使用新的 ref。
这条规则最好直接写进 Agent 的系统提示词。一个可靠的循环应该是「快照、操作、快照」,而不是「快照一次、连续操作十次」。多花一次快照的开销,远小于点错元素后排查和回滚的成本。
agent-browser 点击失败时的处理策略
agent-browser 的点击不会「假装成功」。当目标元素被隐藏、被禁用、位于视口之外,或被其他元素遮挡(比如 Cookie 同意弹窗)时,click 会直接返回失败。这对 Agent 非常友好,因为错误信息本身就是下一步决策的依据。
| 失败原因 | 典型表现 | 推荐处理 |
|---|---|---|
| 被遮挡 | 同意弹窗、浮层盖住按钮 | 先关闭遮挡元素,重新快照后重试 |
| 不在视口 | 元素在页面下方 | 用 scroll 滚动,再重新快照 |
| 元素禁用 | 表单未填完导致按钮不可点 | 先用 fill 补全必填项,再快照确认 |
| 元素隐藏 | 需展开菜单才出现 | 先点击展开入口,用 wait 等待后快照 |
| ref 过期 | 页面已跳转或刷新 | 重新执行 snapshot 获取新 ref |
除了 ref,agent-browser 还支持 CSS 选择器、文本、XPath 和语义化定位器。例如 agent-browser find role button click --name "Submit" 可以按角色和名称找到提交按钮并点击。在页面结构稳定、元素语义清晰的场景下,语义化定位器可以作为 ref 的补充。
agent-browser 常用命令分组
agent-browser 的命令覆盖面很广,完整列表可以通过 agent-browser --help 查看,单条命令用 agent-browser <command> --help。下面按用途整理了最常用的几组,方便你决定给 Agent 开放哪些能力。
| 分组 | 代表命令 | 典型用途 |
|---|---|---|
| 导航与读取 | open、back、reload、read、snapshot、get、is |
打开页面、读快照、查询状态 |
| 交互 | click、fill、type、press、select、check、scroll、upload、find |
点击、填表、上传文件 |
| 等待 | wait |
等待元素出现或页面加载 |
| 采集 | screenshot、pdf、record、download、diff |
截图、导出 PDF、录屏、页面对比 |
| 页面与网络状态 | cookies、storage、network、eval |
管理 Cookie、拦截网络、执行脚本 |
| 标签页与弹窗 | tab、frame、dialog |
多标签、iframe、对话框 |
| 调试与性能 | console、errors、trace、vitals、a11y |
抓取控制台错误、性能指标 |
| 会话与认证 | session、state、auth、confirm、deny |
会话隔离、登录态、敏感操作确认 |
| Agent 集成 | skills、mcp、flow、batch、plugin |
加载技能、启动 MCP 服务 |
浏览器引擎方面,默认使用 Chrome for Testing。你也可以用 --cdp 或 --auto-connect 连接一个已在运行的 Chrome,用 --engine 切换到 Lightpanda 或 Obscura 引擎,在 iOS 模拟器里驱动 Mobile Safari,或者接入 Browserbase、Browserless、Browser Use、Kernel、AgentCore 等云浏览器服务。
把 agent-browser 接入 AI Agent
用内置 skills 教会 Agent
agent-browser 的一个巧妙设计是把使用说明随 CLI 一起发布。执行 agent-browser skills get core 会输出核心循环、ref 用法、等待策略和常见工作流;加 --ref commands 只看某一份参考,比如完整命令列表;加 --full 则附带完整命令参考和模板。agent-browser skills list 还能列出 electron、slack、dogfood 等专项技能。
在 Agent 框架里,可以通过 npx skills add vercel-labs/agent-browser 安装发现技能。这个技能只是一个很薄的引导,会让 Agent 去加载 agent-browser skills get core,因此指令永远和已安装的 CLI 版本保持一致。如果不想装技能,也可以在 AGENTS.md 里写一句:使用 agent-browser 做浏览器自动化,首次使用前先运行 agent-browser skills get core 并按其说明操作。
通过 MCP 接入
如果你的客户端支持 MCP,执行 agent-browser mcp 会通过 stdio 启动一个 MCP 服务器。这样 Claude 类桌面客户端或自研 Agent 就可以把浏览器操作当作标准工具调用,无需自己封装 shell 执行层。
为 snapshot-ref 循环选择驱动模型
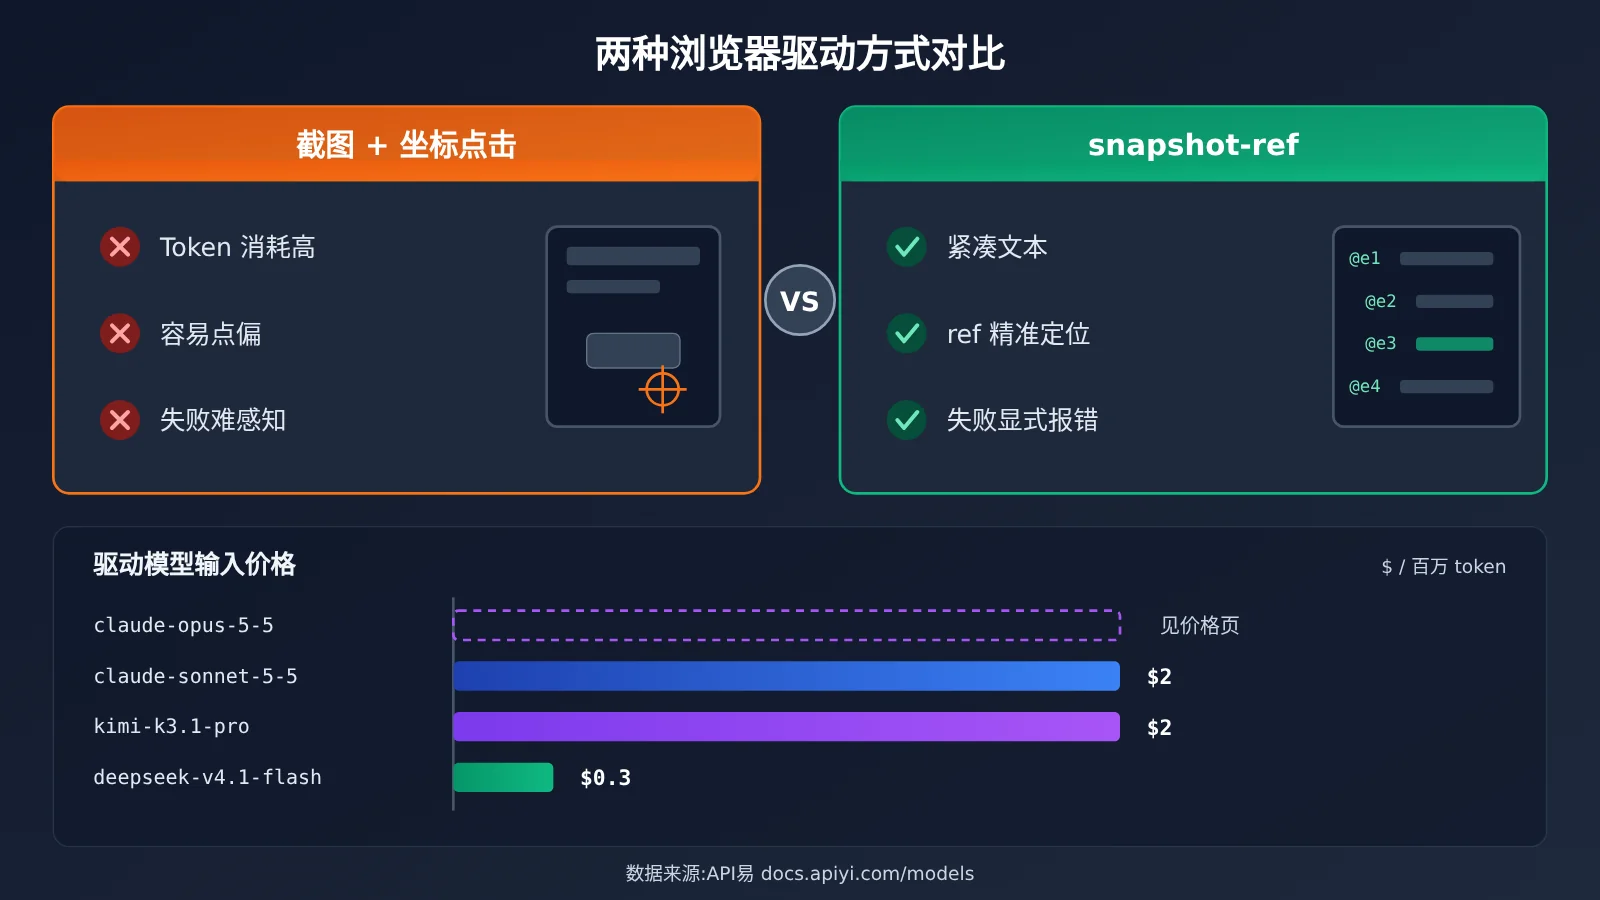
浏览器任务的特点是轮次多、每轮都带一段快照文本,输入 token 占比通常远高于输出。因此选模型时,除了指令遵循能力,还要重点看输入单价和缓存价格。下表价格均以 API易 价格页 docs.apiyi.com/models 的实际数据为准,单位与计费口径请以价格页标注为准。
| 模型 | 输入价格 | 输出价格 | 缓存价格 | 适用角色 | 可用平台 |
|---|---|---|---|---|---|
| claude-opus-5-5 | $4 | $20 | $0.2 | 复杂多步任务、疑难页面 | API易 apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | 日常主力驱动模型 | API易 apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | 中文网页场景 | API易 apiyi.com |
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | 简单表单、批量巡检 | API易 apiyi.com |
一个实用的组合是:用 deepseek-v4.1-flash 处理结构简单、步骤固定的批量任务,用 claude-sonnet-5-5 作为通用主力,遇到复杂交互或频繁失败的页面再升级到 claude-opus-5-5。由于 skills 文本和系统提示在每一轮都会重复出现,缓存价格较低的模型在长循环中更有成本优势。
需要说明的是,文心 ERNIE 系列在 API易 价格表中暂时查不到,API易 目前暂未上线该模型,我们会尽快上线。如果你的 Agent 原本依赖 ERNIE,可以先用上表中的模型替代测试。
💡 选择建议:没有一款模型在所有网站上都最好。建议挑 3 到 5 个真实业务页面做小样本测试,在 API易 apiyi.com 上用统一接口切换模型,对比成功率和单任务成本后再定主力模型。
agent-browser 安全使用建议
让 Agent 操作真实浏览器,安全边界必须提前设计好。agent-browser 官方文档的安全章节提供了认证保险库(auth vault)、域名白名单、操作策略以及内容边界等机制。命令层面,auth 用于管理登录凭据,confirm 和 deny 用于对敏感操作进行确认或拒绝。
在生产环境中,建议至少做到三点:
- 限制可访问域名:用域名白名单把 Agent 限制在业务相关的网站内,避免被页面诱导跳转到陌生站点。
- 凭据不进上下文:把账号密码放进 auth vault,而不是写进提示词,防止凭据出现在模型日志里。
- 敏感动作人工确认:支付、删除、提交订单这类操作配置为需要确认,让人类保留最终决定权。
网页内容本身也可能包含针对 Agent 的恶意指令,所以内容边界机制同样值得开启。它的作用是让模型清楚区分「页面里的文字」和「用户给的指令」,降低提示词注入的风险。
常见问题 FAQ
Q1:什么是 agent-browser 的 snapshot-ref 循环?
这是 agent-browser 的核心工作方式:先用 `snapshot` 把页面读成带 ref 的紧凑文本,再对某个 ref 执行操作,然后重新快照确认结果,如此往复。它把页面理解和动作执行拆成可验证的小步,很适合大模型逐步推理。
Q2:agent-browser 和截图驱动的浏览器 Agent 有什么区别?
截图方案在视觉理解上更通用,但 token 消耗大,坐标点击也容易偏移。相比之下,agent-browser 用无障碍树文本加 ref 定位,上下文更紧凑,操作更精准,失败时还会明确报错,更适合需要稳定执行的自动化任务。
Q3:为什么页面跳转后旧的 ref 不能继续用?
ref 只描述快照那一刻的页面。导航或 DOM 变化后,元素可能已经消失或被替换,旧 ref 可能失效或指向错误元素。正确做法是每次页面变化后重新 `snapshot`,再使用新 ref。
Q4:agent-browser 适合哪些应用场景?
主要适合以下场景:
– **表单自动填写**:注册、报名、后台录入等步骤固定的流程。
– **站点巡检与回归测试**:结合 `errors`、`console`、`vitals` 检查页面错误和性能。
– **信息采集**:登录后台后按菜单逐页读取数据。
– **Electron 与 Slack 等专项场景**:通过 `skills list` 里的专项技能扩展。
Q5:驱动 agent-browser 的模型该如何接入?
可以按以下步骤操作:
1. 访问 API易 apiyi.com 注册账号并获取 API Key。
2. 在 Agent 框架中选择 OpenAI 或 Anthropic 兼容格式,按 docs.apiyi.com 文档填写接入参数。
3. 用本文的 5 步循环作为测试任务,对比不同模型的表现。
API易 支持 Claude、DeepSeek、Kimi 等多种模型统一接入,切换模型只需改模型名。
Q6:运行 snapshot-ref 循环的模型成本怎么估算?
浏览器任务以输入 token 为主,每轮都要带上快照文本和系统提示。估算时重点看输入单价和缓存价格,并尽量用 `snapshot -i` 缩短快照。各模型的实际单价请以 API易 价格页 docs.apiyi.com/models 为准,不要参考过时的第三方报价。
Q7:agent-browser 有哪些已知限制?
ref 的时效性要求 Agent 频繁重新快照,轮次会因此增加。无障碍信息缺失严重的页面,快照可能不够完整,这时需要改用 CSS 选择器、XPath 或截图辅助。另外,无头浏览器空闲一小时后会自动关闭,长时间任务需要配置会话持久化。
agent-browser snapshot-ref 核心要点 Key Takeaways
- 核心定义:agent-browser 是 Vercel Labs 开源的 Rust CLI,让 Agent 逐条命令驱动浏览器。
- 核心循环:快照读页面、对 ref 执行操作、再快照校验,三步不断往复。
- ref 铁律:页面导航或 DOM 变化后,必须重新快照再使用 ref。
- 失败即信号:元素被遮挡或禁用时点击会报错,Agent 应先处理遮挡再重试。
- 接入方式:用
skills get core加载版本匹配的指令,或用agent-browser mcp接入 MCP 客户端。 - 安全优先:生产环境开启域名白名单、auth vault 和敏感操作确认。
- 模型选择:在 API易 apiyi.com 用统一接口对比驱动模型,价格以 docs.apiyi.com/models 为准。
总结
agent-browser snapshot-ref 循环的核心要点:
- 用文本代替截图:无障碍树快照加 ref,让模型以最少的上下文理解页面。
- 一步一校验:每次操作后读取页面或 URL,避免 Agent 在错误状态上继续执行。
- 失败可处理:遮挡、视口、禁用、ref 过期都有明确的处理路径。
- 接入成本低:npm 安装、内置 skills、MCP 服务,三种方式都能快速接进现有 Agent。
建议先在终端手动跑通 open、snapshot、click、get、close 五条命令,再把循环规则写进 Agent 的系统提示词,最后用真实业务页面挑选驱动模型。
推荐通过 API易 apiyi.com 快速验证不同模型驱动 agent-browser 的效果,平台兼容 OpenAI 与 Anthropic 接口格式,接入说明见 docs.apiyi.com,模型价格以 docs.apiyi.com/models 为准。
📚 参考资料
- GitHub – agent-browser:官方开源仓库
- 链接:
github.com/vercel-labs/agent-browser -
说明:包含安装方式、快速上手、命令分组和开发说明
-
agent-browser 官方文档:完整指南与命令参考
- 链接:
agent-browser.dev -
说明:覆盖快照、选择器、会话、CDP 模式和安全机制
-
agent-browser 安全文档:认证与访问控制
- 链接:
agent-browser.dev/security -
说明:介绍 auth vault、域名白名单、操作策略与内容边界
-
API易 文档中心:模型接入说明
- 链接:
docs.apiyi.com -
说明:OpenAI 与 Anthropic 兼容格式的接入方法
-
API易 模型价格页:各模型实际计费
- 链接:
docs.apiyi.com/models - 说明:本文所有模型价格均以此页为准
作者:APIYI 技术团队
技术交流:欢迎在 API易 apiyi.com 网站首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心