作者注:从 Astra 改写 Qwen3.5-0.8B 权重的实验复盘出发,讲清思考模型评测中“答错”与“没写完”的区别,以及按截断拆分结果的方法。
11 月 2 日,MIT CSAIL 的四位研究者发布博客《权重空间编程的火花》。文中称 GPT-6 Astra 只改动了 Qwen3.5-0.8B 约 0.016% 的参数,MATH-500 成绩就从 7.9% 涨到 48.1%,GSM8K 和 IFEval 也大幅上涨,随即被大量转发为“AI 改 AI 大脑”的标志性事件。
这不是要否定这项研究。研究的公开仓库里有 1,125 次调用的逐轮日志,媒体复盘时按逐题记录重新统计,得出的结论更朴素:分数上涨几乎全部来自“模型终于能把答案写完”,而不是“模型变得更会做数学”。
核心价值:本文不重复讨论 RSI 是否成立。我们把这次复盘整理成一套可复用的思考模型评测方法,帮助你在选型、调参或上线前判断:分数变化到底来自能力差异,还是来自重复循环导致的截断。
思考模型评测事件核心信息速览
先把事件里与评测相关的关键事实集中列出来。以下数据均来自原博客和媒体对公开仓库的复盘。
| 信息项 | 详情 |
|---|---|
| 发布时间 | 2026 年 11 月 2 日,MIT CSAIL 研究者博客 |
| 被改模型 | Qwen3.5-0.8B,改动 131,072 个权重,约占 0.016% |
| 宣称成绩 | MATH-500 7.9%→48.1%;GSM8K 13.8%→67.1%;IFEval 21.0%→62.3% |
| 评测设置 | 思考模式开启,输出上限 32,768 token,温度 0.6 |
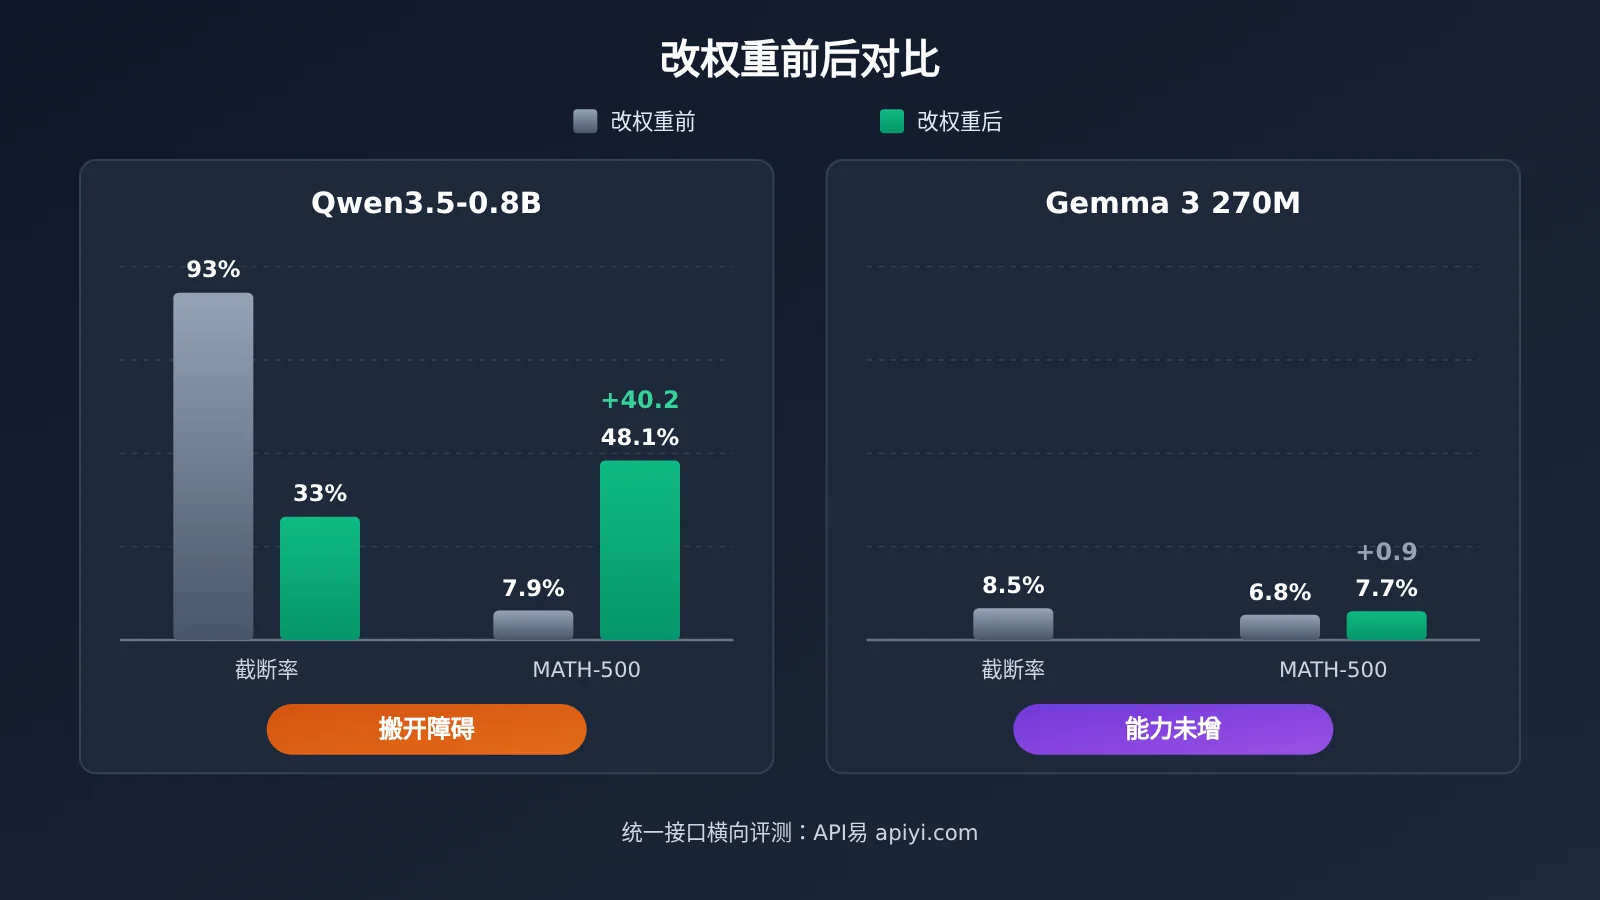
| 基线状态 | 约 93% 的回答写到上限仍未停止 |
| 修改后状态 | 撞到上限的比例从 93% 降到 33% |
| 复盘结论 | 补丁主要修复了重复循环,没有提升数学能力 |
思考模型评测中的“截断”从哪里来
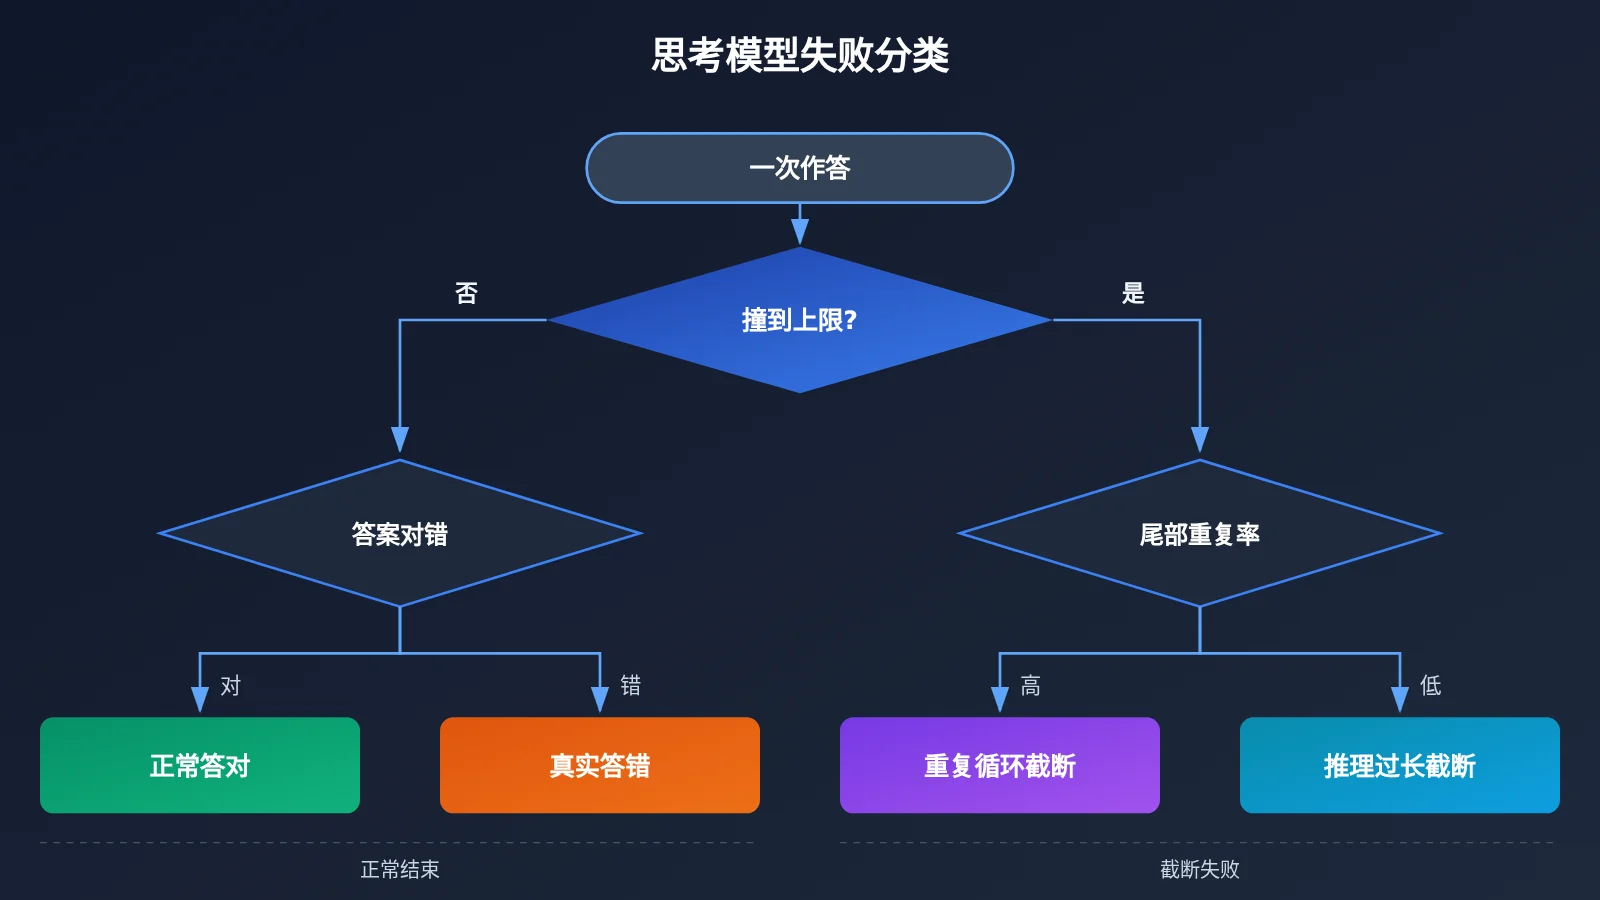
Astra 第一次让 Qwen 跑 96 道练习题,只答对 11 道。剩下的 85 道并非算错,而是全部写到长度上限还没停下来,截断文本尾部按八词片段统计,约 95% 是重复内容。那 11 道正常结束的题,全部答对了。
这说明基线成绩低的主因是“交不上卷”,而不是“不会做”。值得一提的是,研究者给 Astra 的第一轮提示词里,就把“被 token 上限截断,往往是在思考里重复自己”列为失败类型之一,并以“修好驱动重复的东西”作为有效改进的例子。Astra 的最终报告也写明,它瞄准的是重复,而不是数学知识。
思考模型评测数据拆分:涨幅全部集中在截断题
复盘中最有说服力的,是一组 1,152 道留出练习题的修改前后配对测试。只要按“原本是否被截断”把题目分成两组,结论就非常清楚。
| 题目分组 | 题数 | 修改前正确率 | 修改后正确率 | 变化 |
|---|---|---|---|---|
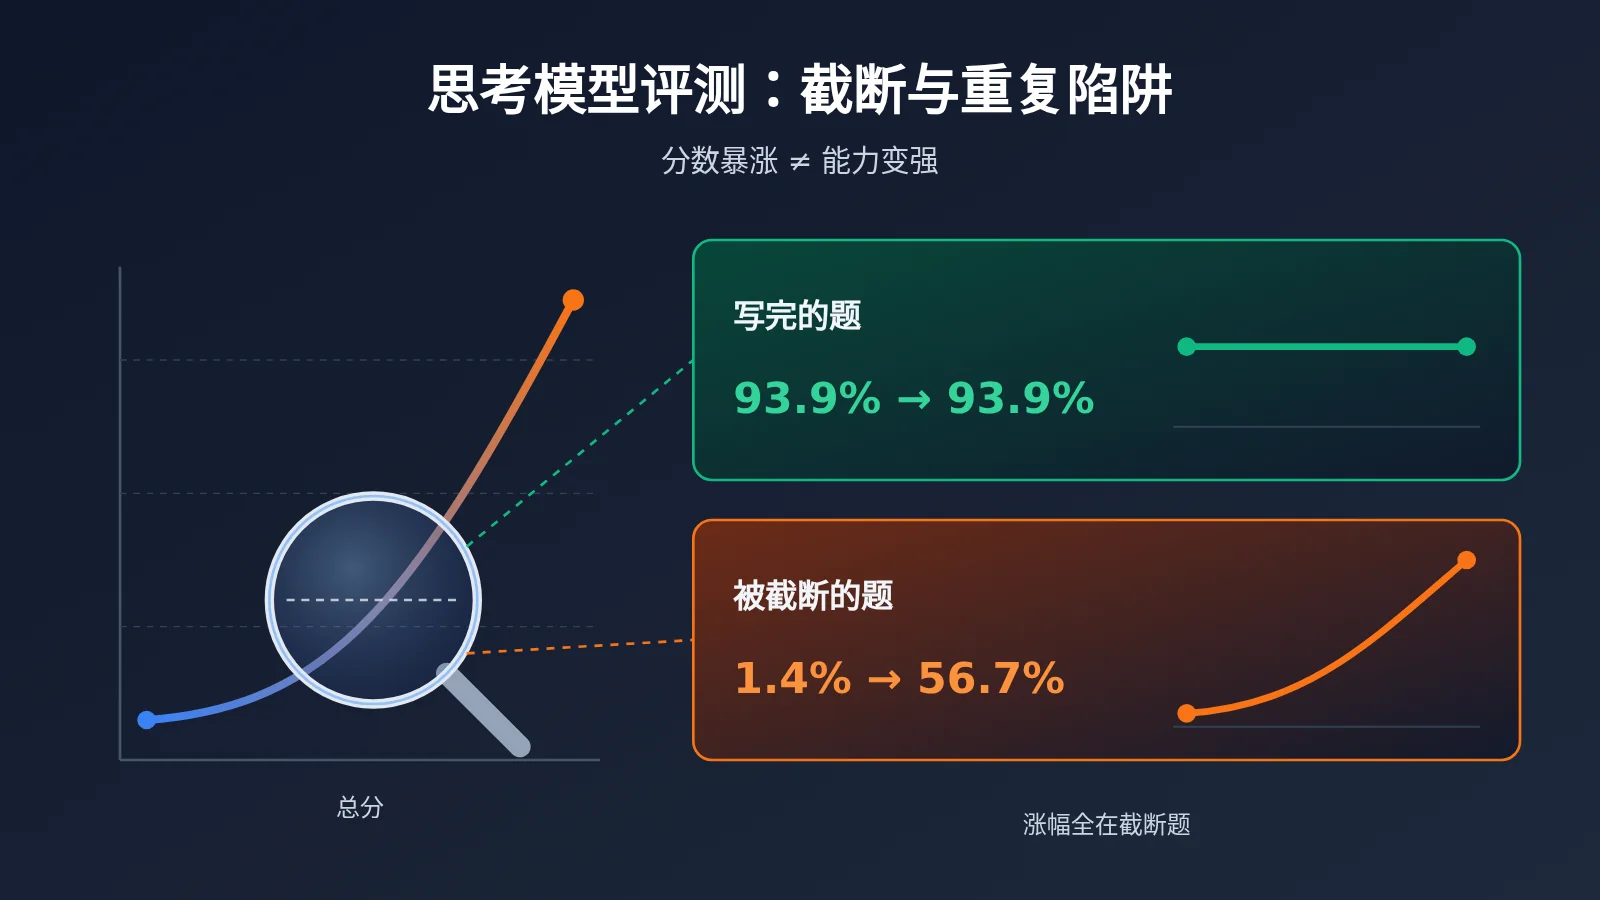
| 原本能写完的题 | 114 | 93.9% | 93.9% | 无变化 |
| 原本被截断的题 | 1,038 | 1.4% | 56.7% | 全部涨幅来源 |
| 由错转对 | 579 | — | — | 其中 576 道原本被截断 |
| 由对转错 | 5 | — | — | 噪声量级 |
还有一个容易被忽略的细节:修改前“写完但答错”的题只有 7 道,修改后变成 245 道。循环停止之后,模型真实的计算错误才暴露出来。在正式的 MATH-500 上,平均作答长度从 30,868 token 降到 22,037 token,下降部分同样集中在原本撞到上限的回答上。
用对照模型验证思考模型评测结论
研究者自己也意识到了这一点,于是在 Gemma 3 270M 上做了同样的实验。两次实验的对比,正好说明“搬开障碍”和“增加能力”是两回事。
| 对比项 | Qwen3.5-0.8B | Gemma 3 270M |
|---|---|---|
| 撞到上限的比例 | 约 93% | 约 8.5% |
| 主要失败类型 | 重复循环,写不完 | 算术错误、推理步骤不成立 |
| 改权重后 MATH-500 | 7.9%→48.1% | 6.8%→最多 7.7% |
| 改进性质 | 搬开挡住能力的障碍 | 几乎无法增加原本没有的能力 |
原博客正文也承认:改权重能搬开挡住能力的障碍,加不上模型没有的能力。对评测者来说,这句话的意义在于:同样的“分数大涨”,在不同的失败结构下含义完全不同。
思考模型评测的参数陷阱:温度与思考开关
这次争议还有一个前提常被忽略:评测设置本身就容易诱发循环。复盘援引的 Qwen3.5-0.8B 官方模型卡信息,与研究者的实际设置存在差异。
| 参数项 | 模型卡说明 | 实验评测设置 | 影响 |
|---|---|---|---|
| 思考模式 | 0.8B 出厂默认关闭 | 强制开启 | 小模型更易陷入思考循环 |
| 温度(思考模式文本任务) | 推荐 1.0 | 0.6 | 0.6 在模型卡中对应看图与写代码任务 |
| 循环处理建议 | 调整采样参数,流式输出及时截断 | 写到 32,768 token 上限 | 大量回答被判为失败 |
需要说明的是,以上模型卡内容来自媒体复盘的转述,建议你在评测前直接核对 Qwen 官方模型卡原文。这里要强调的是方法:同一个模型,换一组采样参数,“基线”就可能完全不同。如果基线本身是在易循环的设置下测出来的,任何让模型“停得下来”的改动都会显得像能力飞跃。
思考模型评测检查清单:先拆截断,再下结论
把这次复盘的教训抽象出来,可以得到一套适用于任何思考模型的评测流程。不管你是在选型、调参,还是验证某个微调或提示词改动,都可以按下表逐项核对。
| 检查项 | 具体做法 | 判定信号 |
|---|---|---|
| 1. 按截断拆分 | 统计 finish_reason == "length" 的比例,分组计算正确率 |
截断率高于 10% 时,总分不可直接比较 |
| 2. 检查重复率 | 对截断回答的尾部做 n-gram 重复统计 | 尾部重复率高,说明是循环而非推理过长 |
| 3. 核对采样参数 | 对照模型卡核对温度、top_p、思考开关 | 与官方推荐不一致时,要单独注明 |
| 4. 配对比较 | 修改前后逐题对照,统计由错转对和由对转错 | 涨幅若集中在截断组,属于“搬开障碍” |
| 5. 横向对照 | 相同提示词与参数下加入低截断率的对照模型 | 对照模型不涨,说明改进不是能力提升 |
🎯 评测建议:做横向对照时,最麻烦的是为每家模型分别写一套调用代码。通过 API易 apiyi.com 的 OpenAI 兼容接口,可以用同一份脚本、同一组提示词和参数调用多家主流模型,方便把“截断率”作为固定统计列输出。
思考模型评测脚本:极简示例
下面的代码统计一批题目中被长度上限截断的比例。finish_reason 为 length 即表示撞到了 max_tokens:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

questions = ["计算 17 * 23 的结果", "求 1 到 100 的整数和"]
truncated = 0
for q in questions:
    r = client.chat.completions.create(
        model="your-thinking-model",  # 替换为实际模型名
        messages=[{"role": "user", "content": q}],
        max_tokens=4096,
    )
    if r.choices[0].finish_reason == "length":
        truncated += 1
print(f"截断率: {truncated / len(questions):.1%}")
查看完整实现代码(含分组正确率与尾部重复率)
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def tail_repetition_ratio(text: str, n: int = 8, tail_words: int = 400) -> float:
    """统计文本尾部 n-gram 的重复比例(中文可改为按字符切分)"""
    words = text.split()[-tail_words:]
    if len(words) < n * 2:
        return 0.0
    grams = [tuple(words[i:i + n]) for i in range(len(words) - n + 1)]
    counts = Counter(grams)
    repeated = sum(c for c in counts.values() if c > 1)
    return repeated / len(grams)

def evaluate(dataset, model, temperature, max_tokens, judge):
    """dataset: [(question, answer)], judge: 判断答案是否正确的函数"""
    stats = {"done": [0, 0], "truncated": [0, 0], "loop": 0}
    for q, ans in dataset:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": q}],
            temperature=temperature,
            max_tokens=max_tokens,
        )
        choice = r.choices[0]
        text = choice.message.content or ""
        group = "truncated" if choice.finish_reason == "length" else "done"
        stats[group][0] += 1
        stats[group][1] += int(judge(text, ans))
        if group == "truncated" and tail_repetition_ratio(text) > 0.5:
            stats["loop"] += 1

    for g in ("done", "truncated"):
        total, correct = stats[g]
        rate = correct / total if total else 0
        print(f"{g}: {total} 题,正确率 {rate:.1%}")
    t = stats["truncated"][0]
    print(f"截断题中疑似循环: {stats['loop']} / {t}")
    return stats
注意,不同模型开启或关闭思考模式的参数并不统一,有的通过请求字段控制,有的通过模型名区分,有的写在提示词模板里。思考内容是否计入 max_tokens、是否单独返回,也因模型而异,评测前务必逐一查阅对应文档。
🚀 快速上手:如果只是想先验证这套拆分方法,可以在 API易 apiyi.com 注册后用免费测试额度,挑两三个思考模型跑几十道题,先看截断率差异,再决定是否扩大评测规模。
思考模型评测事件的影响分析
对开发者的影响
- 总分不再可信:只看总正确率,会把“没写完”和“答错”混为一谈。上线前的评测报告至少应包含截断率和分组正确率两列。
- 调参的收益可能被误读:调高输出上限、调整温度或加入重复惩罚,都可能大幅提升分数,但这属于“搬开障碍”,不代表模型换了。
- 生产环境同样受影响:评测中的截断在线上表现为响应超长、费用失控和用户等待。流式输出配合循环检测与提前截断,是模型卡本身给出的建议。
对模型评估研究的影响
- “大幅提升”需要分解证据:这次复盘表明,一个看起来是能力飞跃的结果,按截断拆分后可能只是 bug 修复。今后任何针对小模型或思考模型的改进声明,都值得追问截断率变化。
- 对照组设计更受重视:Gemma 3 270M 的补充实验,以及 Astra 自己做的随机方向对照(成绩只变动约 1.5 个百分点),都说明对照设计是区分真信号与噪声的关键。
常见问题 FAQ
Q1:什么是思考模型评测中的“截断陷阱”?
指模型在思考过程中陷入重复循环,一直写到 token 上限也没给出答案,被评测系统判为错误。此时低分反映的是“没写完”,而不是“不会做”。
Q2:截断导致的低分和能力不足导致的低分怎么区分?
把题目按是否撞到上限分成两组,分别计算正确率。如果写完的题正确率很高,截断组接近零分,问题就在循环;如果写完的题本身错误很多,才说明能力不足。Qwen 与 Gemma 的对比正好是这两种情况。
Q3:这次 Astra 改 Qwen 的实验是什么时候发布的?
原博客于 2026 年 11 月 2 日发布,媒体基于公开仓库日志的复盘文章发布于 11 月 5 日。本文数据以复盘为准,模型卡细节建议核对 Qwen 官方原文。
Q4:这套评测方法适合哪些场景?
– **模型选型**:比较不同思考模型在数学或代码任务上的表现
– **参数调优**:评估温度、上限、思考开关改动的真实效果
– **改进验证**:判断微调、提示词或权重编辑带来的是能力提升还是障碍移除
Q5:如何用统一接口对多个思考模型做横向评测?
1. 在 API易 apiyi.com 注册账号并获取 API Key
2. 将本文脚本的 base_url 设为 `https://api.apiyi.com/v1`
3. 固定提示词、温度和 max_tokens,只替换模型名,输出截断率与分组正确率
不同模型的思考开关写法不同,需要按各自文档调整请求参数。
Q6:这套拆分方法有哪些局限?
截断拆分只能识别“没写完”,无法判断写完的答案是否靠运气答对;尾部重复率阈值需要按语言和任务调整,中文文本建议按字符而非空格切分。此外,部分模型的思考内容不完整返回,需要结合 usage 中的 token 统计判断。如果预算有限,可以先在 API易 apiyi.com 用小样本试跑,确认统计口径后再扩大规模。
思考模型评测核心要点 Key Takeaways
- 涨幅来源:Qwen 写完的 114 题前后都是 93.9%,涨幅全部来自截断题
- 失败类型:基线 93% 的回答撞到上限,尾部约 95% 是重复内容
- 参数差异:评测温度 0.6 与模型卡推荐的思考文本温度 1.0 不一致
- 对照证据:Gemma 3 270M 截断率低,改权重后 MATH-500 仅提升不到 1 个百分点
- 方法核心:先按
finish_reason拆分截断,再比较正确率 - 上手方式:用 API易 apiyi.com 统一接口,在相同参数下对多模型跑截断统计
总结
这次“Astra 改 Qwen 权重”的争议,给所有做思考模型评测的人提了个醒:
- 分数暴涨要先拆分:按是否撞到 token 上限分组,看涨幅来自哪一组
- 参数是基线的一部分:温度、思考开关和输出上限必须对照模型卡核实并写进报告
- 区分搬开障碍与增加能力:用低截断率的对照模型验证改进的真实性质
下次看到“某改动让成绩翻几倍”的结论时,先问一句:截断率变了多少?这一个问题,往往比总分更能说明真相。
如果你正准备对几款思考模型做上线前评测,推荐通过 API易 apiyi.com 用同一套脚本和参数跑一轮截断率统计,再决定选型方向。
📚 参考资料
- 硅星人 Pro 复盘文章(36氪转载):刷屏的「Astra 改造 Qwen 大脑」跟我们想要的 RSI 没多大关系
- 链接:
36kr.com/p/4056494372181124 -
说明: 基于公开仓库逐题记录重算的配对测试数据,本文核心数据来源
-
MIT CSAIL 研究者博客:Sparks of Weight-Space Programming
-
说明: 实验原始描述与结果表,建议对照原文阅读实验 8 的设置
-
Qwen3.5-0.8B 官方模型卡:采样参数与思考模式说明
- 说明: 核对思考模式默认状态、推荐温度及循环处理建议
作者: APIYI 技术团队
技术交流: 欢迎在 API易 官网 apiyi.com 联系我们,更多调用说明可访问 docs.apiyi.com 文档中心