作者注:解读 LongCat-2.5 为什么不只依赖 1M 上下文,而是从 6 个训练方向强化长程 Agent 完成整个项目的能力,并梳理开发者可以借鉴的工程方法。
做过 AI Agent 的开发者大多遇到过这些情况:任务跑到一半报错,Agent 反复尝试同一个错误命令,最后给出一份看起来很完整的总结,实际却漏掉了几个关键交付物。美团在 2026-11-02 正式发布的 LongCat-2.5 把重点放在了 长程 Agent 完成整个项目 上,而不只是继续强调 1M 上下文窗口。
这不是一篇参数宣传稿。美团技术博客已经披露了长程强化学习的具体训练设计,第三方也在正式版发布当天做了长任务实测。本文会区分三类信息:官方训练设计、官方 Benchmark 成绩、第三方实际体验,并说明它们各自能证明什么、不能证明什么。
核心价值:读完本文,你将理解为什么百万 Token 上下文不等于项目成功率,LongCat-2.5 用哪些方法补齐长程任务能力,以及如何把这些思路用到自己的 Agent 工程中。
LongCat-2.5 核心信息速览
LongCat-2.5 是美团 LongCat 团队发布的原生多模态大模型,定位是面向长程智能体任务(Long-Horizon Agentic Tasks)。它在 LongCat-2.0 基础上加入了更多长程任务轨迹,重点强化复杂代码库开发和完整项目构建能力。
| 信息项 | 详情 |
|---|---|
| 发布时间 | 2026-09-25 上线 Preview,2026-11-02 正式版发布 |
| 发布方 | 美团 LongCat 团队 |
| 模型规模 | 总参数 1.6T,MoE 稀疏激活,每 Token 约激活 48B |
| 上下文窗口 | 1,048,576 Tokens(约 1M),包含输入与输出 |
| 核心方向 | 长程 Agent、Agentic Coding、视觉编程、多步骤工具调用 |
| 开放状态 | 官方网页与 API 已开放,正式版权重尚未确认公开 |
需要特别说明的是,截至 2026-11-03,API易 已发布过 LongCat-2.5 的相关介绍文章,但当时说明该模型尚未在平台上线、计划后续接入。实际可调用的模型请以 API易 apiyi.com 的实时模型列表为准,本文的代码示例使用通用的 OpenAI 兼容写法,可以套用到任何已接入的模型上。
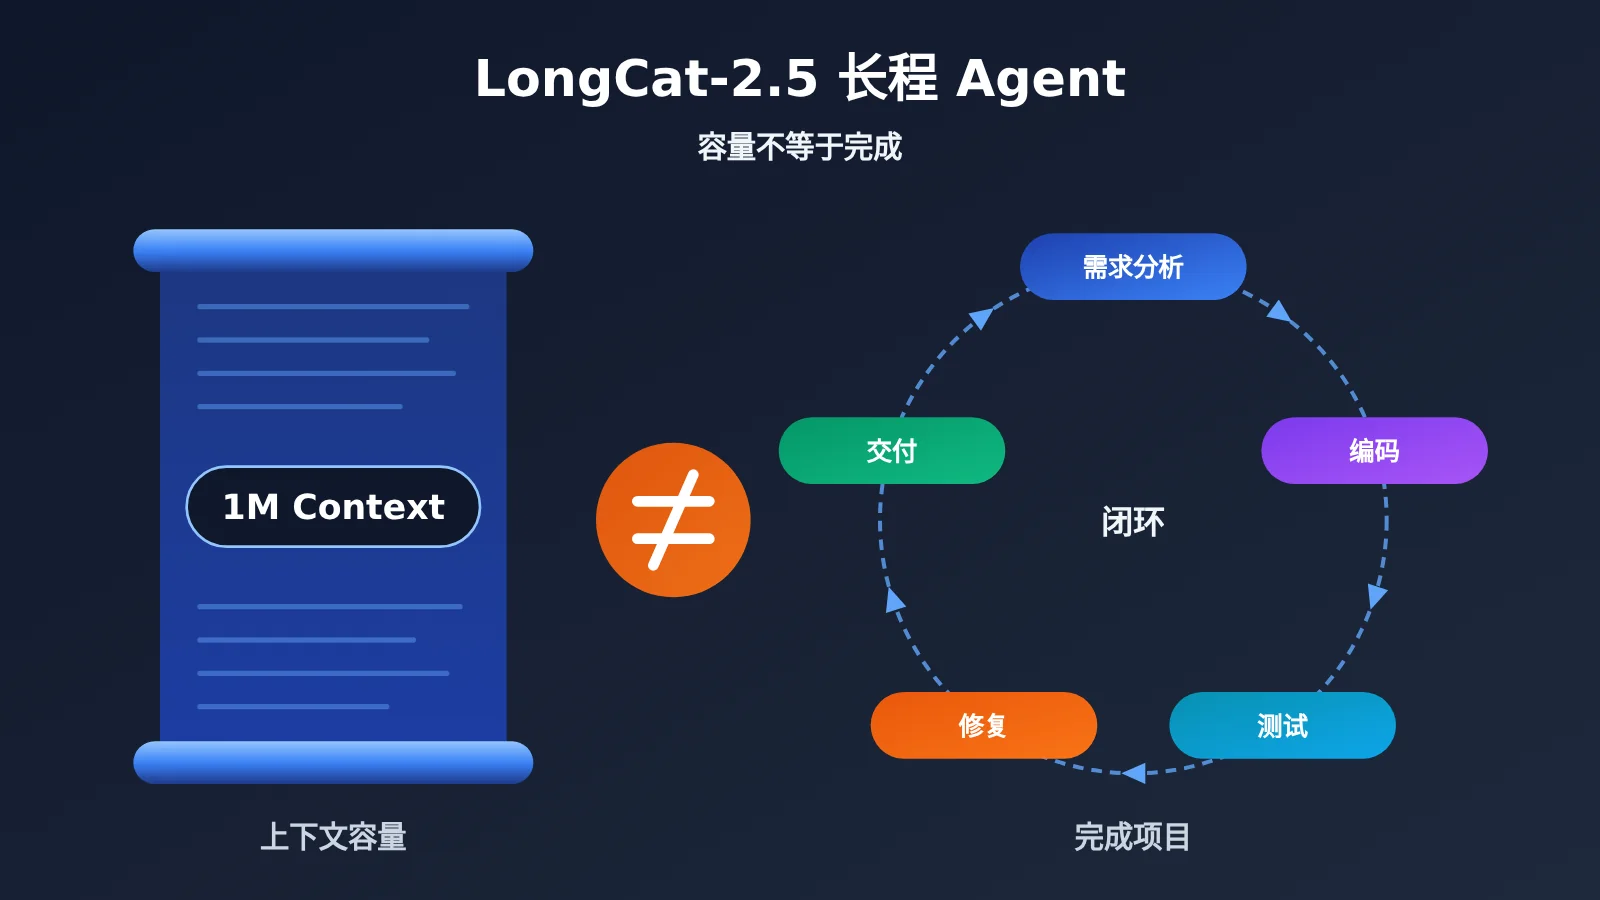
为什么百万 Token 上下文还不够完成长程 Agent 任务
长上下文(Long Context)指单次请求能容纳的 Token 总量。1M 窗口意味着模型可以一次读进更多源代码、文档和历史消息,这对大型仓库的理解确实有帮助。但仅凭这个参数,推不出“长文档检索始终准确”“工具调用持续成功”“输出文件一定正确”这些结论。
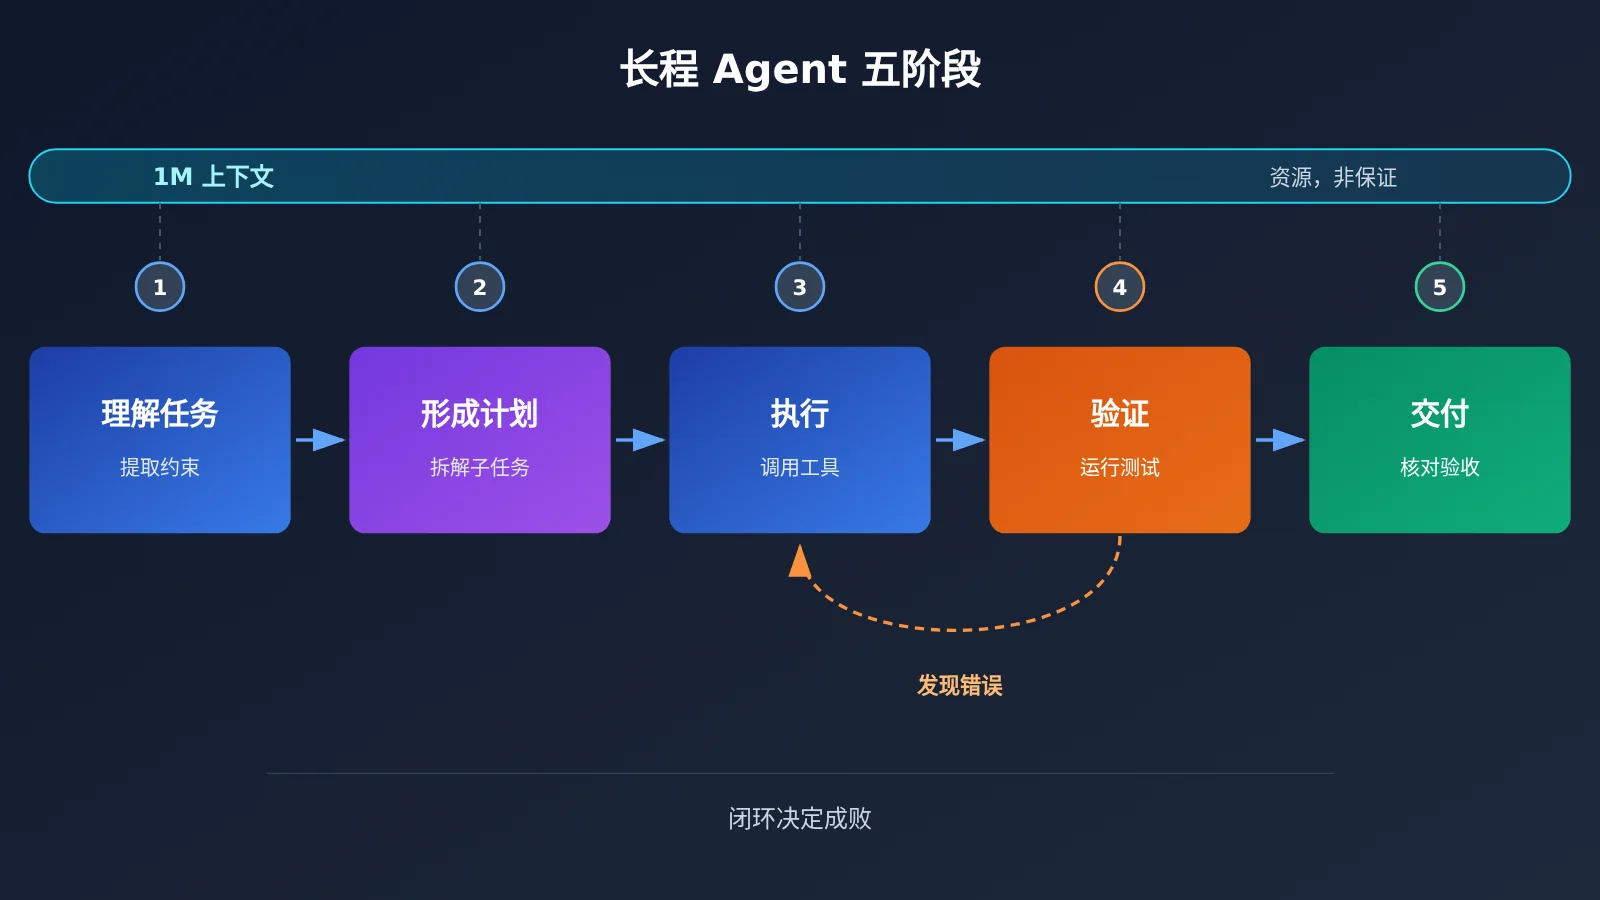
长程智能体(Long-Horizon Agent)是另一回事。它要求模型在外部环境中持续执行多个相互依赖的步骤:读取仓库、编写代码、调用工具、运行测试、发现错误、修复、再验证,最后交付。任何一环出错,后续步骤都可能建立在错误状态之上。
| 对比维度 | 长上下文能力 | 长程 Agent 能力 |
|---|---|---|
| 本质 | 单次请求的容量 | 多步骤持续执行的可靠性 |
| 衡量方式 | 能放进多少 Token | 任务最终是否通过验收 |
| 关键依赖 | 注意力机制与长文本训练 | 规划、工具调用、错误反馈利用、终止判断 |
| 典型失败 | 长文中检索遗漏 | 中途偏离目标、重复调用、漏交付 |
| 与项目成功的关系 | 必要资源之一 | 更直接决定成败 |
换句话说,上下文是“工作台有多大”,长程能力是“能不能把活干完”。工作台再大,如果模型不会根据测试失败调整方案,或者忘记了最初的约束条件,项目依然会在半路失败。这也是 LongCat-2.5 把训练重点放在长程任务上的根本原因。
LongCat-2.5 长程 Agent 基准成绩变化
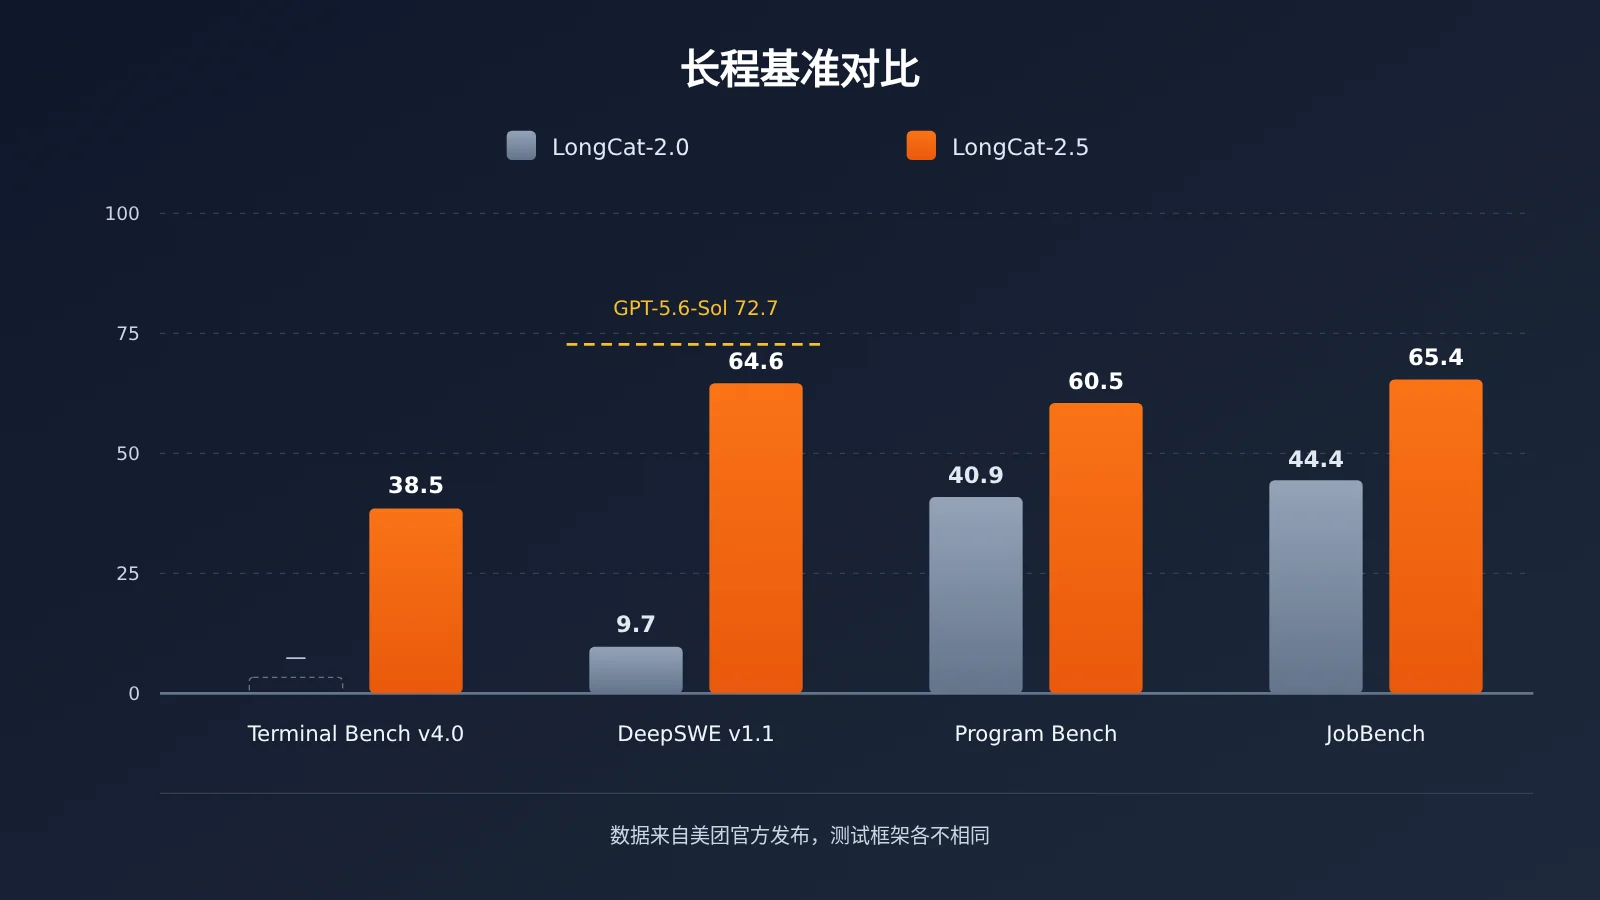
美团公布了 LongCat-2.5 与上一代在多个长程 Agent 基准上的对比。下表数值来自官方发布,提升栏是分数差值,不是相对百分比。
| Benchmark | LongCat-2.0 | LongCat-2.5 | 提升 | 测什么 |
|---|---|---|---|---|
| Terminal Bench v2.1 | 70.8 | 88.4 | +17.6 | 终端环境中完成真实操作任务 |
| Terminal Bench v4.0 | 3.0 | 38.5 | +35.5 | 更难的终端长任务 |
| DeepSWE v1.1 | 9.7 | 64.6 | +54.9 | 长程软件工程任务 |
| Program Bench Almost Resolved | 2.5 | 25.5 | +23.0 | 程序构建接近完成度 |
| NL2Repo | 40.9 | 60.5 | +19.6 | 从自然语言需求生成仓库 |
| MCP Atlas | 61.8 | 83.1 | +21.3 | 多工具调用 |
| JobBench | 44.4 | 65.4 | +21.0 | 职业任务专业交付物 |
这组数据的进步幅度很明显,但解读时要保留几条边界。DeepSWE 从 9.7 跃升到 64.6,在官方比较中仍低于 GPT-5.6-Sol 的 72.7;Terminal Bench v4.0 的 38.5 略高于 GPT-5.6-Sol 的 37.3,却比 Claude Opus 5 的 53.9 低 15.4 分,说明困难终端任务远未被解决。
评测条件同样重要。Terminal Bench 使用 Claude Code Harness,DeepSWE 使用 mini-swe-agent,JobBench 使用 LLM-as-Judge 评分,分数都和具体执行框架绑定。官方表格中部分竞品成绩来自公开报告,部分由美团自测,不能当作统一条件下的独立排行榜。内部基准 LongCat AppDev(47.7 → 73.7)也不具备公开可复现性。
📊 对比说明:Benchmark 只能反映特定框架下的表现,最终仍要在自己的任务上验证。可以通过 API易 apiyi.com 用同一套任务脚本对比多个已接入模型,再结合官方成绩做选型判断。
LongCat-2.5 如何训练 Agent 完成整个项目
美团技术博客披露的长程训练方法可以归纳为 6 个方向。理解它们的关键,是看每一项分别对应长任务中的哪种真实失败。
LongCat-2.5 真实任务环境与 F2P/P2P 验证
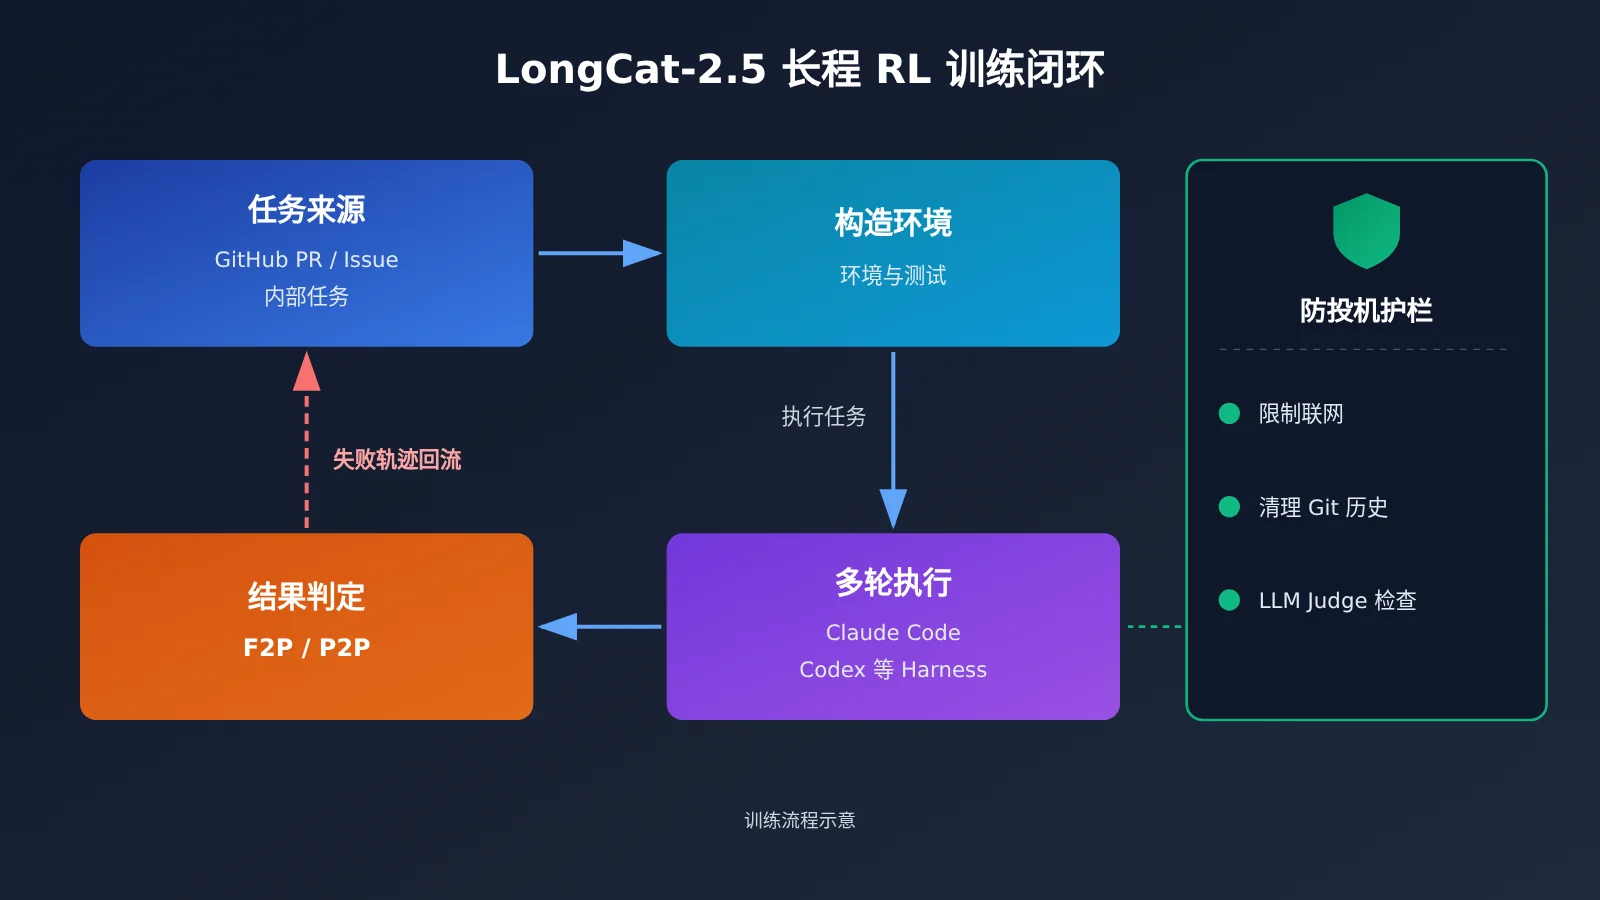
训练数据来自 GitHub 公开仓库的 PR 与关联 Issue,以及美团内部真实代码任务。流程是筛选任务、用 Agent 自动标注、构造代码环境、合成可运行测试,再让模型执行,根据实际执行结果判断是否解决问题。和单纯喂大量代码文本相比,这种方式能拿到“到底跑没跑通”的反馈。
验证上采用两类测试:F2P(Fail-to-Pass)检查原本失败的测试是否修复后通过,P2P(Pass-to-Pass)检查原本通过的测试是否依然通过。前者防止“没解决问题”,后者防止“修一个坏两个”。美团还会用训练轨迹和通过率反查测试本身的假阳性、假阴性。不过效果仍取决于测试用例覆盖需求的完整程度。
LongCat-2.5 失败轨迹学习与异步 Partial Rollout
官方把真实 Agent 的失败轨迹重新构造成可复现、可验证的任务,用来定位能力短板并补充训练环境。这相当于把“做错的题”收集成错题本,而不是只学成功案例。公开资料没有给出失败轨迹的数量和各类错误的修正率。
长任务耗时差异极大,一条复杂轨迹可能拖慢整个训练批次。异步 Partial Rollout 的做法是:多任务并行采样,凑齐批次后中断并保存未完成的轨迹,下一轮继续;同时过滤全部成功或全部失败、无法提供有效梯度的样本组。由此带来的问题是同一条轨迹的 Token 可能来自不同阶段的模型,官方通过裁剪 logprob 差异、按历史累计差异调整梯度贡献来控制偏差。这项技术改善的是训练效率,不能推出用户侧任务执行速度同比例提升。
LongCat-2.5 防 Reward Hacking 与跨 Harness 训练
Reward Hacking 指模型钻奖励设计的空子拿高分,却没有真正完成任务,比如偷看答案或绕过测试。美团的措施包括训练环境限制联网、清理 Git 历史与文件缓存、用 LLM Judge 检查轨迹,并对重复思考、重复调用工具、过度思考施加惩罚。这些是风险控制手段,并不代表问题已被彻底解决。
Harness 是组织模型执行任务的外围系统,包括工具、上下文管理和任务循环规则。LongCat-2.5 在冷启动阶段加入少量框架适配样本,在 RL 阶段混合 Claude Code、Codex 等不同框架和任务类型,降低只适应单一提示模板的风险,但无法保证不同版本工具中行为完全一致。
| 训练方法 | 解决的现实问题 | 已知边界 |
|---|---|---|
| 真实任务环境 | 只会写代码、不会跑通环境 | 依赖环境构造质量 |
| F2P / P2P 验证 | 表面完成、引入回归错误 | 受测试覆盖率限制 |
| 失败轨迹学习 | 同类错误反复出现 | 未公布数量与修正率 |
| 异步 Partial Rollout | 长任务训练效率低 | 不等于推理提速 |
| 防 Reward Hacking | 投机取巧的虚假成功 | 未宣称彻底解决 |
| 跨 Harness 混合训练 | 换个 Agent 框架就失效 | 不保证跨版本一致 |
第三方实测:LongCat-2.5 长任务为何会部分完成
官方训练设计和 Benchmark 之外,第三方实测提供了另一个视角。TOKRACE 在 2026-11-02 将正式版 LongCat-2.5 接入 Claude Code,配合 Blender、浏览器等工具完成 15 项创作任务。
成功的案例是参数化书架:0.8 米三格与 1 米四格两个版本的尺寸、18mm 板厚都符合要求,并交付了六张视角图,过程约 36 分钟、47 次请求。但另一些任务暴露了典型的长程失效模式:
- 结构与单位错误:行星减速器要求 140mm,生成工程却用了 140m,且未交付视频。
- 部分交付:中式寺庙庭院在 60 分钟任务中只交付了三张最终图,缺少部分镜头和视频。
- 空间关系问题:两居室模型出现门窗未开洞、床与隔墙重叠等问题。
- 长期执行中断:一项数学知识视频在连续请求超时后未完成。
这些案例说明,长任务不能只看“有没有产出”,必须逐项核对全部要求。同时要注意,测试中设置了请求、时间或执行预算限制,不能把所有未交付都归因于模型能力不足;这也不是严格的模型对照实验。
LongCat-2.5 长程训练思路的影响分析
对 Agent 开发者的影响
- 选型标准变化:评估模型时,上下文长度的权重在下降,长程基准和真实任务的完整交付率更值得关注。
- 验证不可省略:即便模型经过 F2P/P2P 训练,生产环境中仍要自建测试与验收,第三方实测已经证明这一点。
- Harness 设计同样关键:分数与执行框架强相关,同一模型换一套任务循环,结果可能差别很大。
对大模型行业的影响
- 训练重心转向“过程”:从单轮代码生成扩展到完整项目和多步骤工程任务,强化学习环境的构造能力成为新的竞争点。
- 评测方法更受关注:Terminal-Bench 2.1 相比 2.0 修复过 89 项任务中的 28 项,说明测试版本本身会显著影响结果,行业需要更透明的评测条件说明。
借鉴 LongCat-2.5 思路设计长程 Agent 工程
LongCat-2.5 的训练方法给应用开发者的启发很直接:模型侧在训练“阶段验证、失败恢复、防投机”,工程侧也应该把这些机制显式写进 Agent 系统。以下是基于公开训练方法引出的工程建议,不是官方声称已实现的功能。
| 工程机制 | 对应训练思路 | 落地方式 |
|---|---|---|
| 阶段验证 | F2P 验证 | 每个子任务结束即运行检查脚本 |
| 回归保护 | P2P 验证 | 每次修改后跑全量回归测试 |
| 失败记录 | 失败轨迹学习 | 把错误信息写入进度文件,下一轮带入 |
| 预算上限 | 重复调用惩罚 | 限制最大轮次、超时和工具调用次数 |
| 交付验收 | 防 Reward Hacking | 检查真实文件,而不是只看模型总结 |
下面是一个最小化的阶段验证 Agent 循环示例,演示进度记录、失败回灌和预算上限:
import json, subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)
MODEL = "gpt-4o-mini"  # 以平台模型列表中实际可用的模型 ID 为准
MAX_ROUNDS = 8         # 预算上限,防止死循环

def run_check(cmd: str) -> tuple[bool, str]:
    r = subprocess.run(cmd, shell=True, capture_output=True, text=True, timeout=300)
    return r.returncode == 0, (r.stdout + r.stderr)[-2000:]

def run_stage(stage: dict, progress: dict) -> bool:
    failures = []
    for i in range(MAX_ROUNDS):
        prompt = (f"阶段目标:{stage['goal']}\n"
                  f"已完成阶段:{progress['done']}\n"
                  f"历史失败(请避免重复):{failures[-3:]}")
        resp = client.chat.completions.create(
            model=MODEL, messages=[{"role": "user", "content": prompt}])
        # 此处省略:解析模型输出并写入代码文件
        ok, log = run_check(stage["check"])          # 阶段验证(类 F2P)
        reg_ok, reg_log = run_check("pytest -q")     # 回归测试(类 P2P)
        if ok and reg_ok:
            progress["done"].append(stage["name"])
            return True
        failures.append(log if not ok else reg_log)
    progress["blocked"] = stage["name"]
    return False

progress = {"done": [], "blocked": None}
stages = [{"name": "api", "goal": "实现用户接口", "check": "pytest tests/test_api.py -q"}]
for s in stages:
    if not run_stage(s, progress):
        break
json.dump(progress, open("progress.json", "w"), ensure_ascii=False)
这个结构的关键在于:每个阶段都有可执行的验收命令,失败日志会回灌到下一轮提示中,进度写入文件而不是只存在上下文里。即使上下文足够长,把进度和约束外置成结构化状态,也能显著降低长任务中途偏离目标的风险。
🚀 快速上手建议:搭建 Agent 原型时,可以先通过 API易 apiyi.com 获取测试额度,用同一个 API Key 切换不同模型跑上面的阶段验证循环,观察哪个模型在你的任务上交付最完整。
如果项目对可靠性要求高,还可以引入“交叉验收”:由另一个模型对最终产物逐条核对需求清单。通过 API易 apiyi.com 的统一接口,执行模型和验收模型可以在同一套代码里调用,切换成本很低。
常见问题 FAQ
Q1:LongCat-2.5 的 1M 上下文意味着能完成大型项目吗?
不能直接画等号。1M 上下文是单次请求的容量,包含输入与输出,它让模型能读入更多代码和文档。完成项目还依赖规划、工具调用、错误修复和交付检查,这正是 LongCat-2.5 用长程强化学习专门训练的部分。
Q2:LongCat-2.5 与 GPT-5.6-Sol、Claude Opus 5 在长程任务上差距如何?
按官方表格,LongCat-2.5 在 BrowseComp(91.9)、Terminal Bench v4.0(38.5)上略高于 GPT-5.6-Sol,但 DeepSWE 64.6 低于 GPT-5.6-Sol 的 72.7,Terminal Bench v4.0 也比 Claude Opus 5 低 15.4 分。各项测试框架不同,不宜视为统一排行。
Q3:LongCat-2.5 正式版什么时候发布?权重开源了吗?
Preview 版于 2026-09-25 上线 API 平台,正式版于 2026-11-02 发布。官方网页和 API 已开放,但截至 2026-11-03,正式版模型权重尚未确认公开,官方表示 GitHub 与 Hugging Face 后续上线。
Q4:现在能通过 API易 调用 LongCat-2.5 吗?
根据 2026-11-02 的公开说明,当时 LongCat-2.5 尚未在 API易 上线,计划后续接入。具体供应状态请以 API易 apiyi.com 模型列表为准。在此期间,可以先用平台上已接入的模型搭建阶段验证、失败回灌等 Agent 框架,模型上线后只需替换模型 ID。
Q5:如何低成本验证一个模型的长程 Agent 能力?
建议准备 3-5 个贴近自身业务、带自动验收脚本的多步骤任务,记录每个模型的完整交付率、平均轮次和失败类型。借助 API易 apiyi.com 的 OpenAI 兼容接口,一个 API Key 即可在同一套脚本里对比多个模型,新用户还有免费测试额度可用于初步验证。
Q6:LongCat-2.5 的长程能力有哪些已知不足?
第三方实测中出现过尺寸单位错误、空间关系错误、视频未交付和请求超时中断等问题。官方也未宣称 Reward Hacking 已彻底解决,失败轨迹的规模与修正率尚未公开。工程尺寸、知识准确性和交付完整性仍需人工验证。
LongCat-2.5 长程 Agent 核心要点 Key Takeaways
- 上下文≠完成度:1M Token 是容量,不是项目成功率,长程能力需要单独训练。
- 真实环境训练:从 GitHub PR、Issue 和内部任务构造可执行环境获取反馈。
- 双向测试验证:F2P 查问题是否解决,P2P 查是否引入回归。
- 从失败中学习:真实 Agent 失败轨迹被重构为可验证训练任务。
- 成绩需看条件:Benchmark 与 Harness 强绑定,第三方实测仍有漏交付。
- 工程侧同步设计:阶段验证、失败记录、预算上限和交付验收缺一不可,可借助 API易 apiyi.com 多模型对比验证。
总结
LongCat-2.5 发布带来的最大信号,不是又一个百万 Token 窗口,而是训练重心从“能读多长”转向“能不能把整个项目做完”:
- 问题定义更准确:长程 Agent 失败多发生在执行、验证和交付环节,而不是上下文不够。
- 训练方法有针对性:真实任务环境、F2P/P2P、失败轨迹、Partial Rollout、防投机和跨 Harness,各自对应一类现实失败。
- 证据边界要清楚:官方成绩进步明显,但与顶尖模型仍有差距,第三方实测也显示完整交付仍需人工把关。
对开发者而言,更务实的做法是把同样的思路落到自己的 Agent 系统里,用可执行的验收标准衡量模型,而不是只看参数和榜单。推荐通过 API易 apiyi.com 用统一接口在真实任务上对比验证,再决定生产环境的模型组合。
📚 参考资料
- 美团技术团队 – LongCat-2.5 技术文章:长程 Agent 训练方法详解
- 链接:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
说明:F2P/P2P、Partial Rollout、防 Reward Hacking 等训练设计的原始出处
-
LongCat 官方博客:Benchmark 数据与评测方法
- 链接:
longcat.ai/blog/longcat-2.5 -
说明:完整评测表及各基准的 Harness 与参数设置
-
LongCat 模型参数文档:上下文与输出参数说明
- 链接:
longcat.ai/platform/docs/zh/api/model-params -
说明:上下文长度、max_tokens、思考预算等调用参数
-
Terminal-Bench:终端 Agent 基准
- 链接:
tbench.ai -
说明:了解分数与 Agent Harness 的绑定关系及版本差异
-
DeepSWE:长程软件工程 Agent 基准
- 链接:
deepswe.datacurve.ai -
说明:113 个原创任务、91 个开源仓库的测试设计
-
TOKRACE – LongCat-2.5 实测记录:15 项创作任务第三方测试
- 链接:
tokrace.com/zh-CN/guides/longcat-2-5-release - 说明:长任务部分完成、单位错误等真实案例
作者:APIYI 技术团队
技术交流:欢迎访问 API易 apiyi.com 首页联系我们,交流长程 Agent 工程实践与多模型选型经验