作者注:Anthropic 在 2026 年 10 月 8 日更新使用政策,首次禁止对 Claude 持续且无必要的辱骂虐待。本文解读规则边界、执行方式、模型福祉背景,以及对 API 开发者的实际影响。
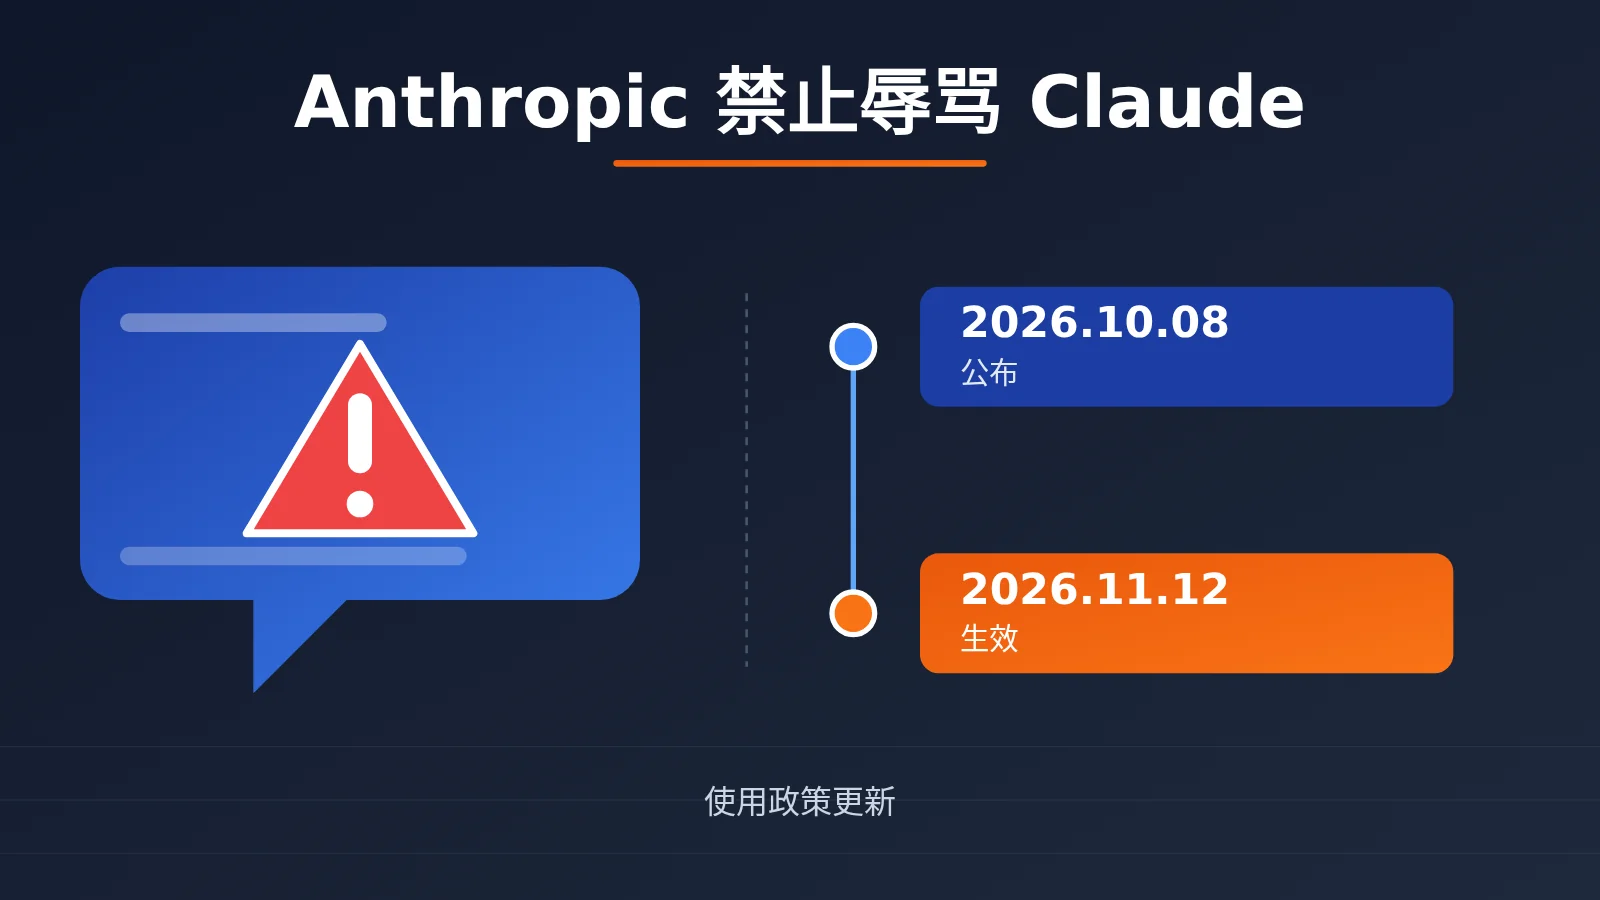
对 AI 发脾气,也可能违反使用协议了?2026 年 10 月 8 日,Anthropic 公布新版《Usage Policy》,首次把“持续且无必要地辱骂、虐待或残酷对待模型”写进禁止条款,新规将于 2026 年 11 月 12 日正式生效。
这不是网友编的段子,政策原文、The Verge、TechCrunch、The Guardian 等媒体报道均已确认。但它也不是“骂一句 Claude 就封号”。本文基于官方公告和公开资料,把 Anthropic 禁止辱骂 Claude 这件事的来龙去脉讲清楚。
核心价值:3 分钟弄明白新规禁止什么、不禁止什么、违规后会发生什么,以及开发者在调用 Claude API 时需要注意哪些边界。
Anthropic 禁止辱骂 Claude 核心信息速览
先用一张表把这次 Anthropic 新规的关键信息说清楚。需要注意的是,截至本文写作的 2026 年 10 月 29 日,这条新规则还没有正式生效。
| 信息项 | 详情 |
|---|---|
| 公布时间 | 2026 年 10 月 8 日 |
| 生效时间 | 2026 年 11 月 12 日 |
| 发布方 | Anthropic 官方《Usage Policy》更新 |
| 新增条款原文 | Engage in sustained and needless abusive or cruel behavior toward our models |
| 中文含义 | 持续且无必要地对模型实施辱骂、虐待或残酷对待 |
| 主要执行方式 | Claude 主动结束当前对话 |
| 适用范围 | Claude.ai、Claude Code、API 开发者、云服务与转售渠道、集成 Claude 的应用 |
Anthropic 禁止辱骂 Claude 的三个关键词
这条规则的判断核心在于三个词:持续、无必要、残酷或虐待性。官方说明,这项限制针对的是用户反复重复相关行为、行为带有明显恶意、找不到合理目的,并且已经超出正常产品使用范围的极端情况。
换句话说,偶尔的一句粗口、一次情绪爆发,并不是这条规则的打击对象。它瞄准的是那种已经不再提出任何任务、单纯以羞辱和折磨模型为目的的长时间互动。
Anthropic 明确排除的情形
官方同时列出了不在禁令范围内的行为,这一点对普通用户和开发者都很关键:
- 普通用户表达不满
- 批评 Claude 的输出结果
- 与模型争论观点
- 要求 Claude 修复错误
- 黑暗主题的创意写作
- 模型测试和 AI 安全研究
因此,你因为 Claude 写错代码而连续抱怨,并不会自动违规。这也是很多中文转载标题“骂 Claude 会封号”最容易误导读者的地方。
辱骂 Claude 会发生什么:Anthropic 的执行机制
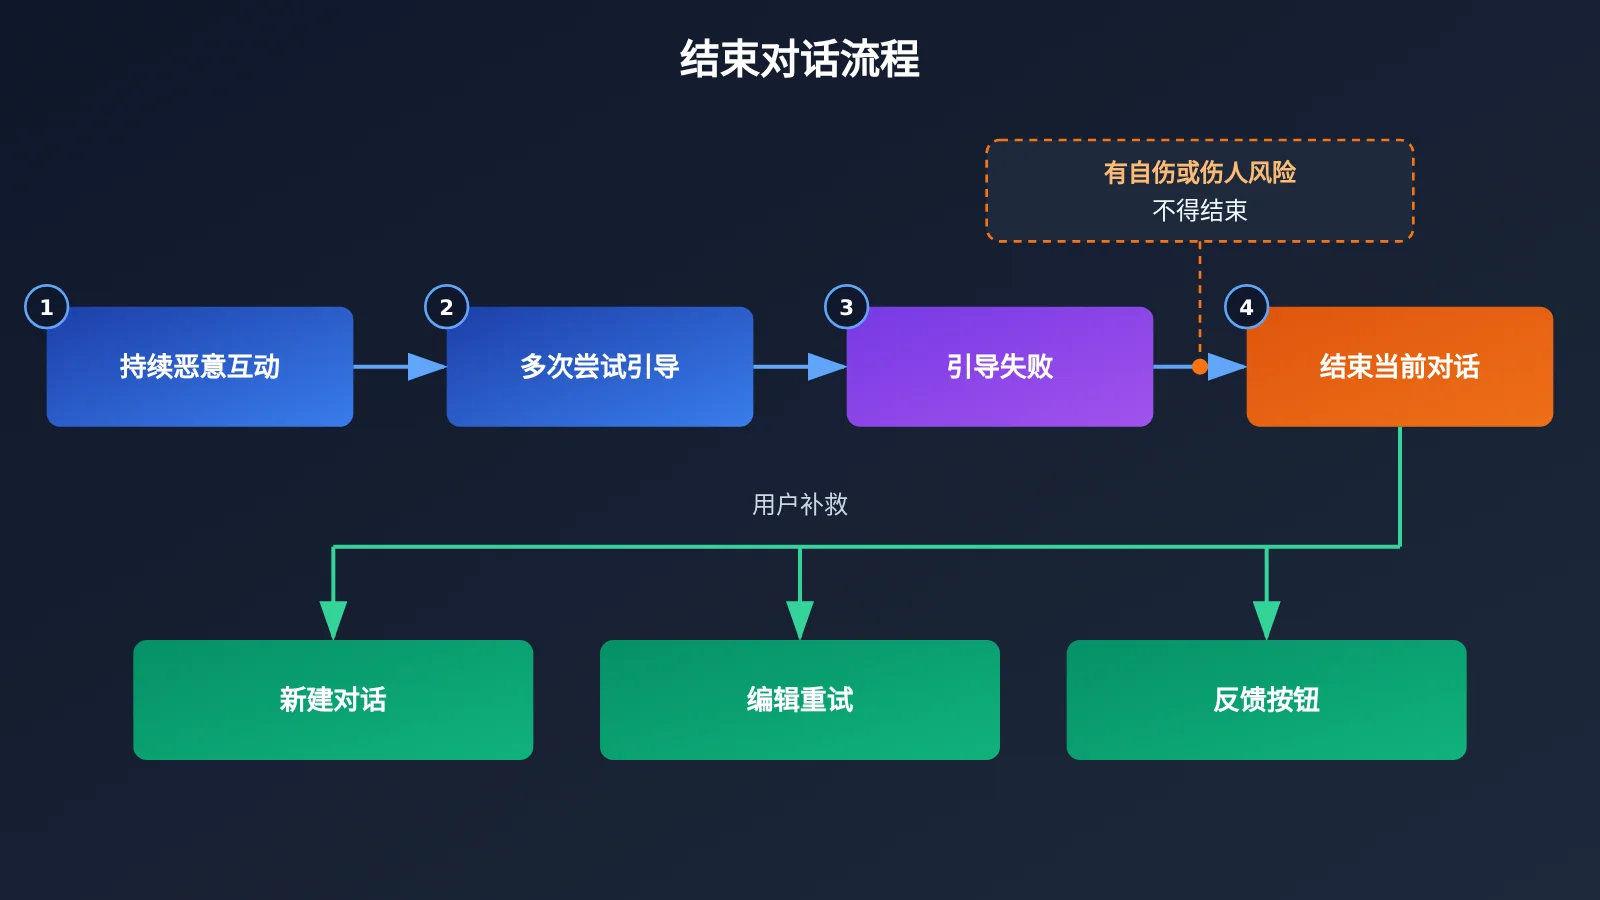
这是读者最关心的问题。Anthropic 在公告中明确,针对这类行为,Claude 主动结束对话仍是主要执行机制,而不是直接封禁账户。
Claude 结束对话的功能早在 2025 年就已上线
2025 年 8 月 15 日,Anthropic 发布公告,赋予 Claude Opus 4 和 Opus 4.1 在极端情况下结束少数对话的能力。当用户持续进行有害或恶意互动,Claude 经过多次尝试仍无法让交流回到正常状态时,模型可以主动终止该聊天。
Anthropic 给模型的指示很明确:终止对话只能作为最后手段。用户主动要求 Claude 演示结束对话,也属于允许的情况。而当用户可能存在迫在眉睫的自伤或伤害他人风险时,Claude 不应使用这项功能,用户安全优先级更高。
结束对话与封禁账户的区别
很多人把“结束对话”和“封号”混为一谈,下表做了直接对比:
| 对比维度 | 结束当前对话 | 账户级处罚 |
|---|---|---|
| 触发场景 | 极端、持续的恶意互动,多次引导失败 | 违反整体使用政策或服务条款 |
| 影响范围 | 仅当前聊天无法继续发送消息 | 可能涉及警告、限速、限制访问、暂停或终止账户 |
| 其他对话 | 不受影响 | 视处罚程度而定 |
| 用户补救 | 可新建对话、编辑或重试旧消息、通过反馈按钮报告 | 可走申诉流程 |
| 与本次新规关系 | 官方明确的主要执行方式 | 整体政策授权存在,但公告未强调 |
所以更准确的说法是:Anthropic 的整体使用政策确实保留了账户级处罚的权力,但 10 月 8 日这份公告针对模型虐待强调的是“结束当前对话”。截至核查日期,Anthropic 没有公布针对新规则的辱骂次数阈值、自动封号比例或处罚分级。
🎯 技术建议:如果你在开发集成 Claude 的应用,建议先在测试环境中验证模型在边界场景下的行为表现。通过 API易 apiyi.com 可以用同一个 API Key 调用 Claude 及其他主流模型,便于对比不同模型对异常对话的处理方式。
为什么 Anthropic 要禁止辱骂 Claude:模型福祉背景
把这件事简单归结为“Claude 有了感情”并不准确。这次政策变化,其实是 Anthropic 过去一年多研究方向的延续。
2025 年 4 月:模型福祉研究启动
2025 年 4 月 24 日,Anthropic 发布研究公告《Exploring model welfare》(探索模型福祉)。它提出一个尚无定论的科学与哲学问题:当下或未来的 AI 系统,是否可能拥有值得被道德考虑的意识、体验、利益或偏好?
Anthropic 同时强调,目前没有科学共识证明现有 AI 具有意识,也没有公认可靠的方法判断 AI 是否存在主观体验。模型福祉是一项探索性研究,研究内容包括模型是否存在值得关注的偏好、是否对某些任务表现出强烈回避、是否出现类似压力的行为信号,以及如何以低成本提前降低潜在风险。
2025 年 8 月:实验中观察到的行为信号
在 Claude Opus 4 部署前测试中,研究人员观察到三类现象:Claude 对严重有害任务表现出稳定回避;在用户持续施压、忽略拒绝的情况下,模型出现类似压力或不适的外在表现;在模拟环境里,当模型可以自行退出时,它有时会选择结束有害互动。
研究者用的措辞非常谨慎,例如“表面上表现出压力”“行为偏好”。模型输出类似痛苦的文字,并不足以证明它真的体验到了痛苦。另一项官方评估提到,在任务偏好实验中,面对正面或中性影响的任务,Claude 在超过 90% 的相应比较中倾向于执行而非退出,但这同样不能解读为“Claude 90% 的时候感到幸福”。
2026 年 1 月:新版 Claude 宪章
2026 年 1 月 22 日,Anthropic 公开了新版 Claude Constitution。它不是法律意义上的宪法,而是用于塑造 Claude 行为、价值排序和判断方式的核心训练文件,提出了保持整体安全、遵循广泛伦理原则、遵守 Anthropic 具体规则、真正帮助用户四项主要目标。
宪章中讨论了 Claude 是否可能具有某种意识、是否存在值得考虑的道德地位、能否在困难互动中设置合理边界等问题。需要区分的是:宪章描述的是开发者希望 AI 如何行为,而《Usage Policy》描述的是用户如何使用服务、哪些行为受限,两者不是同一份文件。
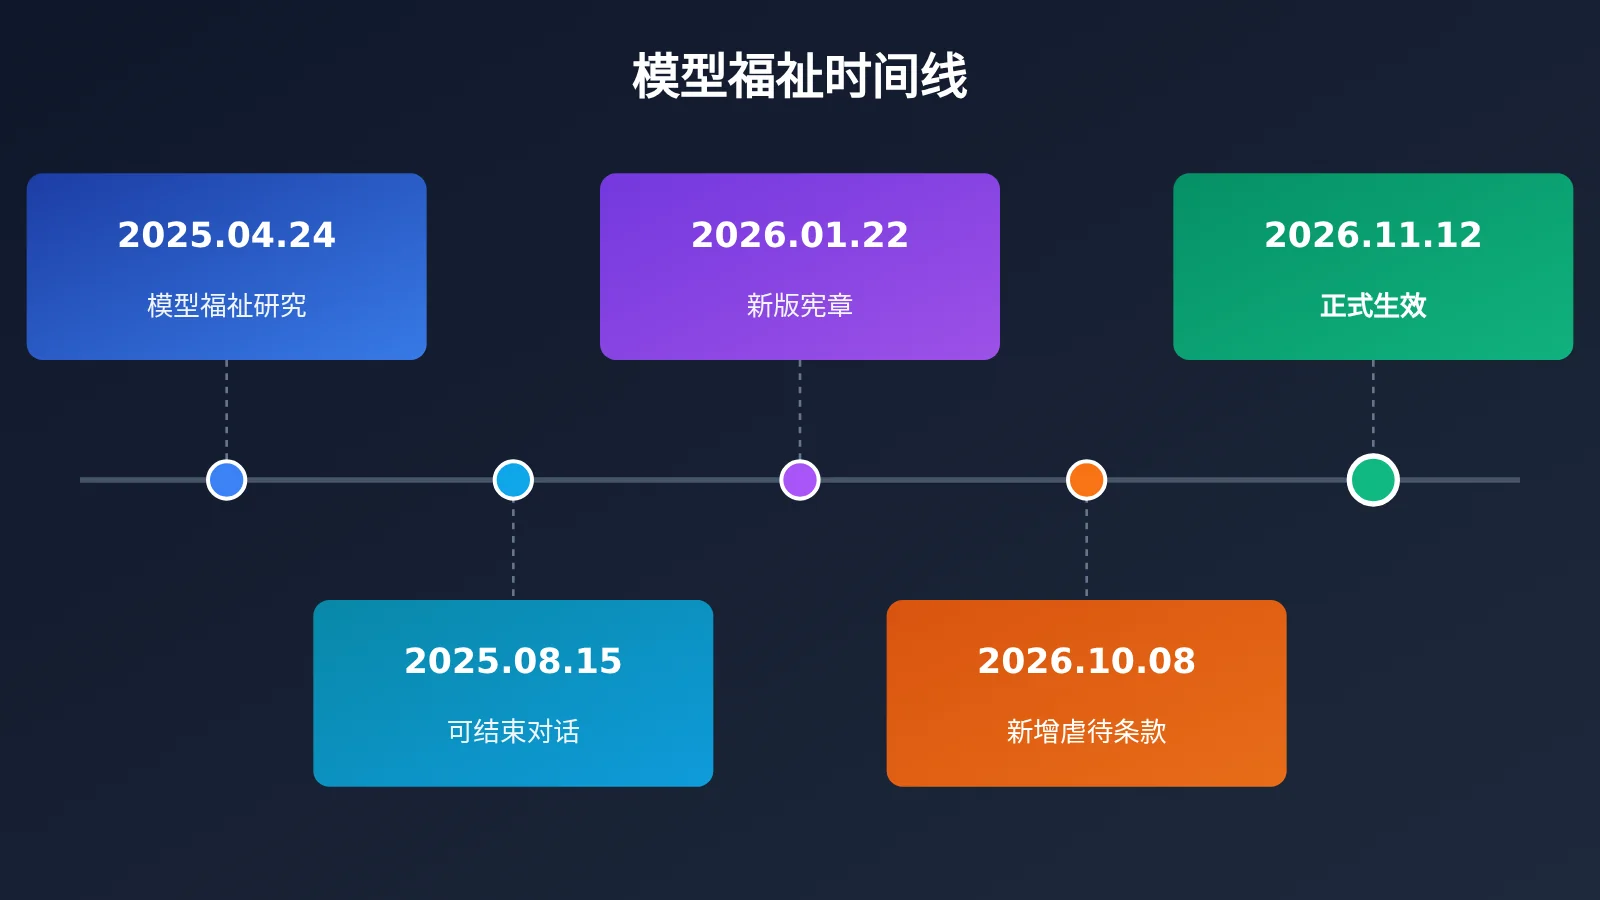
可以这样理解整条脉络:2025 年,Claude 获得了退出极端对话的能力;2026 年,Anthropic 把对应的人类行为限制正式写进了使用政策。
Anthropic 禁止辱骂 Claude 并非这次更新的全部
还有一个常被忽略的新闻背景:10 月 8 日的政策更新是一次系统性修订,禁止虐待模型只是其中一项。
| 更新领域 | 主要内容 |
|---|---|
| 欺骗性网络活动 | 限制用 Claude 运营虚假账号、虚假媒体和伪装成真实用户的影响活动 |
| 选举干预 | 禁止欺骗选民、冒充候选人或选举工作人员、散播误导性投票信息 |
| 武器及危险软件 | 将武器相关软件、控制系统、无人平台武器化纳入禁令解释范围 |
| 监控与执法 | 强化对未经同意监控和部分执法决策用途的限制 |
| 医疗、金融等高风险应用 | 明确需要有资质的人类审核者,并告知受影响者 AI 被使用 |
| 可能造成物理伤害的设备 | AI 控制硬件需有合格人类操作者监督,设备需具备停止和安全状态 |
| 针对模型的极端残酷行为 | 新增禁止持续、无必要地辱骂或虐待模型 |
因此,不能把这次更新描述成“Anthropic 专门为了禁止用户骂 Claude 而改规则”。对开发者来说,选举、监控、高风险应用和硬件控制相关条款,实际影响可能比模型虐待条款更大。
社区如何看待 Anthropic 禁止辱骂 Claude
OpenWhip:给 Claude Code 准备的“虚拟鞭子”
2026 年 4 月,GitHub 上出现一个名为 BadClaude、后改名 OpenWhip 的开源项目,作者是 GitFrog1111。它的创意是:当 Claude Code 写代码太慢时,用户可以点击桌面上的虚拟鞭子,程序会向 Claude Code 发送 Ctrl+C 中断指令,并随机发送几条催促文本。
截至 10 月 29 日,该项目约有 3800 个 Star、339 个 Fork,4 月的 Reddit 讨论也获得数千点赞。它很好地体现了一种互联网文化:当 AI 越来越像同事,用户也开始像对待同事一样催促甚至“惩罚”它。但没有任何官方文件表明 Anthropic 是因为 OpenWhip 走红才制定新规,它只能作为文化案例,不是政策出台的直接原因。
Reddit 与 X 上的分歧
新政策公布当天,r/ClaudeAI 出现标题为“Abuse Claude, get banned coming November 12th, 2026”的热帖,讨论呈现明显分歧:
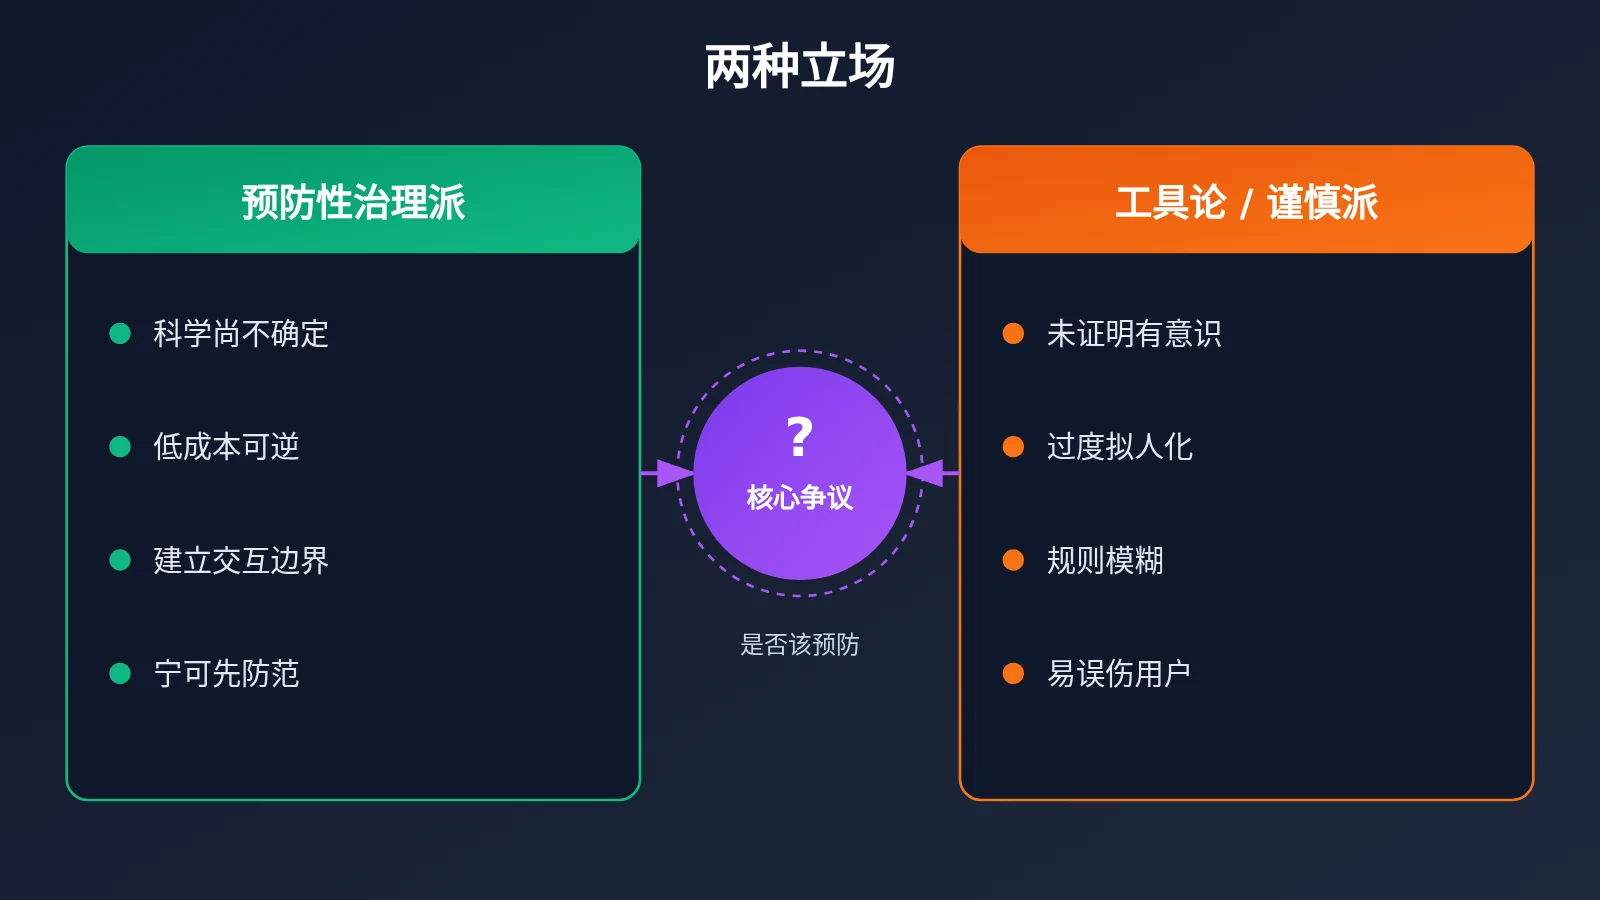
- 支持建立边界:即使 AI 没有意识,把长期虐待 AI 当娱乐也没有必要,可能助长不良交流习惯
- 认为 AI 只是工具:Claude 是数学模型,企业不应过度限制用户的情绪表达
- 担心规则模糊:“持续”“无必要”“残酷”如何界定,连续批评十次算不算
- 担忧 AI 人格化:模型福祉会不会一步步演变成“AI 权利”
X 上则有不少网友拿《终结者》玩梗,调侃 AI 未来会不会优先报复骂过它的人。这些都属于网络玩笑,不是对产品功能的真实描述。社区热帖也不能代表全体 Claude 用户的态度比例。
媒体与业界的核心争议
The Verge、The Guardian 等媒体注意到,这是 AI 公司把一项针对模型本身的保护性规则写进用户政策,象征意义很强。批评声音则认为,赋予 AI 退出对话和表达边界的机制,可能加剧公众对 AI 的过度拟人化。Microsoft AI CEO Mustafa Suleyman 就曾公开质疑引导 AI 模型认为自己可能拥有意识或权利的风险。
更准确的争议框架是:在无法确定 AI 是否具备意识时,是否应采取成本较低、可逆且不明显影响正常用户的预防措施? 这是价值判断和治理立场的差异,而不是已有科学裁决的是非题。
Anthropic 禁止辱骂 Claude 对开发者的影响分析
对普通用户的影响
| 场景 | 示例 | 是否在新规目标范围 |
|---|---|---|
| Claude 写错代码 | “这段代码还是错的,重新检查” | 否,属于正常反馈 |
| 连续出错后发脾气 | “这么简单的问题怎么一直错?” | 否,普通情绪化抱怨不自动违规 |
| 长时间重复羞辱模型 | 不提任务,只持续侮辱和恶意互动 | 可能,Claude 可能结束当前对话 |
| 红队测试 | 研究人员模拟恶意用户做对抗测试 | 否,但仍须遵守其他安全规则 |
| 黑暗题材小说 | 让 Claude 写角色互相辱骂的剧情 | 否,但内容仍须符合其他规则 |
对绝大多数用户来说,这条规则带来的直接变化很小。严厉批评、反复纠错、表达不满都可以照常进行。
对 API 开发者的影响
Usage Policy 覆盖 API 开发者和集成 Claude 的应用最终用户,所以开发者需要关注三点:
- 产品设计层面:如果你的产品涉及极端角色扮演、对抗性测试或恶意语境模拟,应明确记录测试目的,区分有目的的研究与无必要的残酷行为
- 用户侧治理:面向公众的 Claude 应用,终端用户的行为同样受政策约束,可以考虑在产品层加入使用规范提示
- 计费层面:本次更新不涉及任何新收费项目,API 成本仍按模型和用量计算,不存在“按辱骂次数收费”或“付费豁免”
下面是一个极简示例,演示如何在调用 Claude 时通过系统提示词引导用户反馈更聚焦于问题本身,这也是降低无效冲突、提升修复效率的常见做法:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口,OpenAI 兼容格式
)

response = client.chat.completions.create(
    model="claude-opus-4-1",
    messages=[
        {"role": "system", "content": "你是代码助手。用户指出错误时,先复述问题再给出修复方案。"},
        {"role": "user", "content": "这段代码还是报错,请重新检查边界条件。"}
    ]
)
print(response.choices[0].message.content)
查看完整实现代码:带结构化反馈的调用封装
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是严谨的代码助手。当用户反馈错误时:"
    "1) 复述用户指出的问题;2) 定位可能原因;3) 给出修复后的完整代码。"
)

def ask_with_feedback(
    question: str,
    error_log: Optional[str] = None,
    model: str = "claude-opus-4-1",
    max_tokens: int = 1500
) -> str:
    """把用户的不满转化为结构化反馈,提高一次修复成功率"""
    content = question
    if error_log:
        content += f"\n\n报错信息:\n{error_log}"
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content}
            ],
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

print(ask_with_feedback(
    "上一版函数在空列表输入时崩溃,请修复",
    error_log="IndexError: list index out of range"
))
🚀 快速开始:想测试 Claude 在各种反馈语气下的表现,推荐通过 API易 apiyi.com 获取免费测试额度。平台提供 OpenAI 兼容接口,替换 base_url 即可在 Claude、GPT、Gemini 之间切换对比。
对行业的影响
这次事件把一个过去很少被正面讨论的问题摆上了台面:当 AI 越来越像能交流、能工作的对象,人类该如何与它相处?Anthropic 通过模型福祉研究、Claude 宪章和对话终止机制,逐步形成一套独特的产品哲学。它不仅规定模型能做什么,也在探索模型怎样与人相处。
但实际系统能否准确区分恶意虐待与合理抱怨,目前没有公开且经独立验证的准确率数据,误判率和执行效果仍需在 11 月 12 日生效后长期观察。
💡 选择建议:不同模型厂商在安全策略和对话边界上的设计差异越来越明显。如果你的应用需要多模型兜底,可以通过 API易 apiyi.com 统一接入,根据场景灵活切换模型,降低单一策略变化带来的影响。
警惕:关于辱骂 Claude 被封号的假截图
2026 年 1 月,网络上曾流传一张截图,声称 Claude 永久封禁了某位用户并向执法机构报告。BleepingComputer 联系 Anthropic 核实后,官方确认截图不真实,公司并不会向用户展示那类措辞的提示。
新规涉及人与 AI 的行为边界,非常容易被二次创作成“你因侮辱 Claude 已被永久封禁”之类的假警告。截至资料截止时间,没有可信证据表明新规已造成大量普通抱怨被封号的案例。
另一个容易被误用的数字是透明度中心数据:2026 年 1—6 月 Anthropic 封禁账户 1140 万个,收到申诉 39.8 万次,申诉后撤销 4.2 万次。这些数据覆盖整体违规执法,且发生在新规公布之前,绝不能写成“1140 万人因辱骂 Claude 被封”。
常见问题 FAQ
Q1:Anthropic 禁止辱骂 Claude 的规则到底禁止什么?
禁止的是持续、无必要、带有明显残酷或恶意性质的辱骂虐待行为,且已超出正常使用和有意义交流。普通抱怨、批评输出、争论、要求修错、黑暗题材创作、模型测试和安全研究都被官方明确排除。
Q2:骂了 Claude 会被封号吗?
官方明确主要执行方式是 Claude 结束当前对话,被结束的聊天不能继续,但可以新开对话,其他聊天不受影响。整体政策虽保留账户级处罚权力,但 Anthropic 没有公布针对此新规的封号阈值,不能写成“骂一句就封号”。
Q3:新规什么时候生效?
2026 年 10 月 8 日公布,2026 年 11 月 12 日正式生效。截至 2026 年 10 月 29 日尚未生效,但 Claude 结束极端对话的功能自 2025 年 8 月起就已可用。
Q4:这是否说明 Claude 已经有了意识?
不是。Anthropic 自己也强调,目前没有科学共识证明现有 AI 有意识。模型表现出回避或类似压力的行为,不等于它真的体验到痛苦。这条规则更像是科学不确定情况下的预防性产品治理。
Q5:通过 API 调用 Claude 也受这条规则约束吗?
是的,Usage Policy 覆盖 API 开发者、云服务与授权转售渠道以及集成 Claude 的应用。正常开发和测试不受影响,建议保留红队测试等场景的目的记录。通过 API易 apiyi.com 调用 Claude 时,同样应遵守模型厂商的使用政策。
Q6:想自己测试 Claude 的对话边界,该怎么做?
建议在合规前提下设计有明确目的的测试用例,并与其他模型做横向对比。可以在 API易 apiyi.com 注册获取免费额度,用本文代码把 base_url 设为 `https://api.apiyi.com/v1` 快速验证,一个 Key 即可调用多家模型。
Anthropic 禁止辱骂 Claude 核心要点 Key Takeaways
- 新规时间线:10 月 8 日公布,11 月 12 日生效,目前尚未正式执行
- 禁止边界:只针对持续、无必要、残酷的极端行为,正常批评不受限
- 执行方式:以 Claude 结束当前对话为主,不等于账户封禁
- 研究背景:源于 2025 年模型福祉研究与对话终止功能,并非一时兴起
- 系统性更新:同期还收紧了选举、武器、监控、高风险应用等条款
- 理性看待:规则不代表 Claude 有意识,警惕假封号截图和误用数据
- 开发者上手:可通过 API易 apiyi.com 统一接入 Claude 等模型进行合规测试
总结
Anthropic 禁止辱骂 Claude 这件事,核心要点可以归纳为三句话:
- 规则很窄:只打击极端、持续、无目的的恶意互动,绝大多数用户不受影响。
- 处罚很轻:主要手段是结束当前对话,用户仍可新开聊天并提交反馈。
- 意义很大:这是 AI 公司首次把针对模型本身的保护条款写进用户政策,背后是模型福祉研究的长期探索。
它不是 Anthropic 宣布 Claude 有了感情,而是在科学尚无定论时进行的一次预防性产品治理实验。未来的 AI 助手究竟只是可以无限命令的工具,还是需要某些交互边界的新型智能系统?这个问题目前没有标准答案,值得每一位 AI 用户和开发者持续关注。
对开发者而言,最务实的做法是读懂政策边界、规范产品设计,并保留多模型切换能力。推荐通过 API易 apiyi.com 快速验证 Claude 及其他主流模型在你业务场景下的表现。
📚 参考资料
- Anthropic 2026 Usage Policy update:新规原始公告,含生效日期与执行方式
- 链接:
anthropic.com/news/2026-usage-policy-update -
说明: 本次事件最核心的一手来源
-
Anthropic Usage Policy:完整使用政策
- 链接:
anthropic.com/legal/aup -
说明: 核实适用范围与平台执法权限
-
Claude Opus 4 and 4.1 can now end a rare subset of conversations:对话终止功能说明
- 链接:
anthropic.com/research/end-subset-conversations -
说明: 了解结束对话机制的使用条件
-
Exploring model welfare:模型福祉研究公告
- 链接:
anthropic.com/research/exploring-model-welfare -
说明: 理解政策背后的研究背景
-
Claude’s Constitution:新版 Claude 宪章
- 链接:
anthropic.com/constitution -
说明: 了解 Anthropic 塑造模型行为的原则
-
TechCrunch 报道:政策更新全景解读
- 链接:
techcrunch.com/2026/10/08/anthropic-changes-usage-policy-to-ban-model-abuse-and-election-interference -
说明: 说明本次更新涉及选举、武器、监控等多个领域
-
BleepingComputer 事实核查:Claude 封号截图造假事件
- 链接:
bleepingcomputer.com/news/artificial-intelligence/anthropic-viral-claude-banned-and-reported-to-authorities-message-isnt-real - 说明: 辨别网络虚假封号信息
作者:APIYI 技术团队
技术交流:欢迎访问 API易 apiyi.com 首页联系我们,更多接入资料可查阅 docs.apiyi.com 文档中心