作者注:兩家峯時價格相同,但擅長的任務不同。本文用參數、價格、跑分和分工四張表,說明不同任務該交給哪個模型。
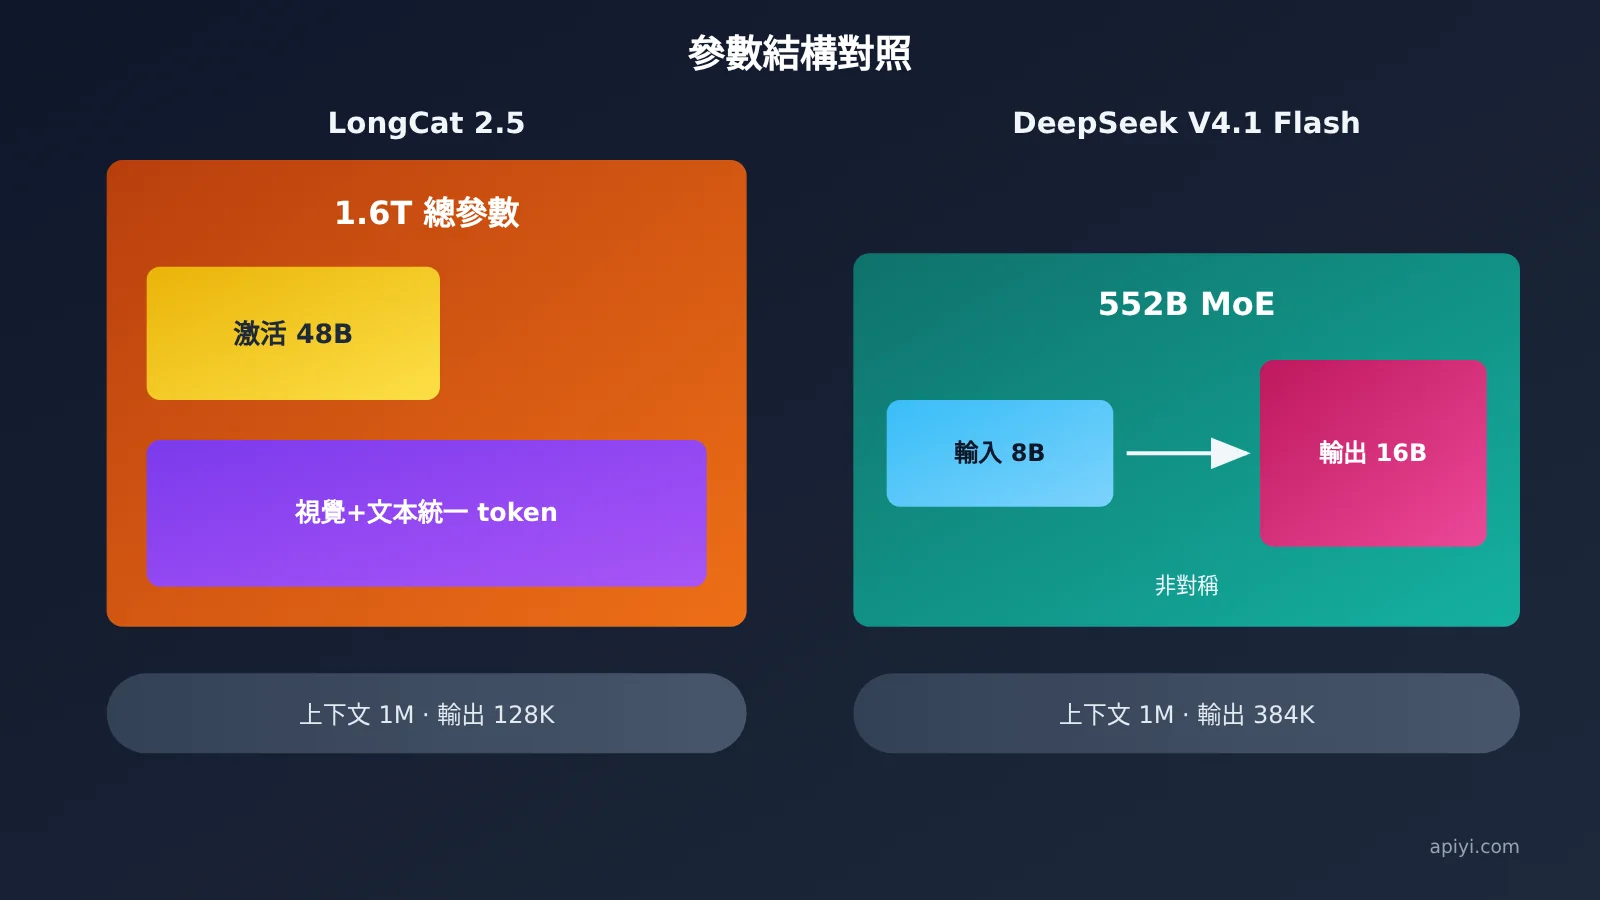
兩家峯時價格完全相同:輸入 $0.30、緩存 $0.006、輸出 $1.20(每 100 萬 tokens)。區別在擅長的任務,選誰要看你跑什麼活。LongCat 2.5 是 1.6T 總參數、每 token 激活約 48B 的原生多模態模型。DeepSeek V4.1 Flash 是 552B 的非對稱 MoE,輸入激活 8B、輸出激活 16B,權重已經開源。
這不是一篇「各有千秋」的折中稿。下文的數字全部來自兩家官方博客、技術報告和價格頁。兩家的跑分都是各自自測,本文只做同級參考,不排總座次,也不寫沒有跑過的實測。
核心價值:讀完本文,你能拿自己項目裏的任務逐項對照,決定主用哪一個、補充用哪一個,再算清楚把批量任務挪到谷時能省多少。
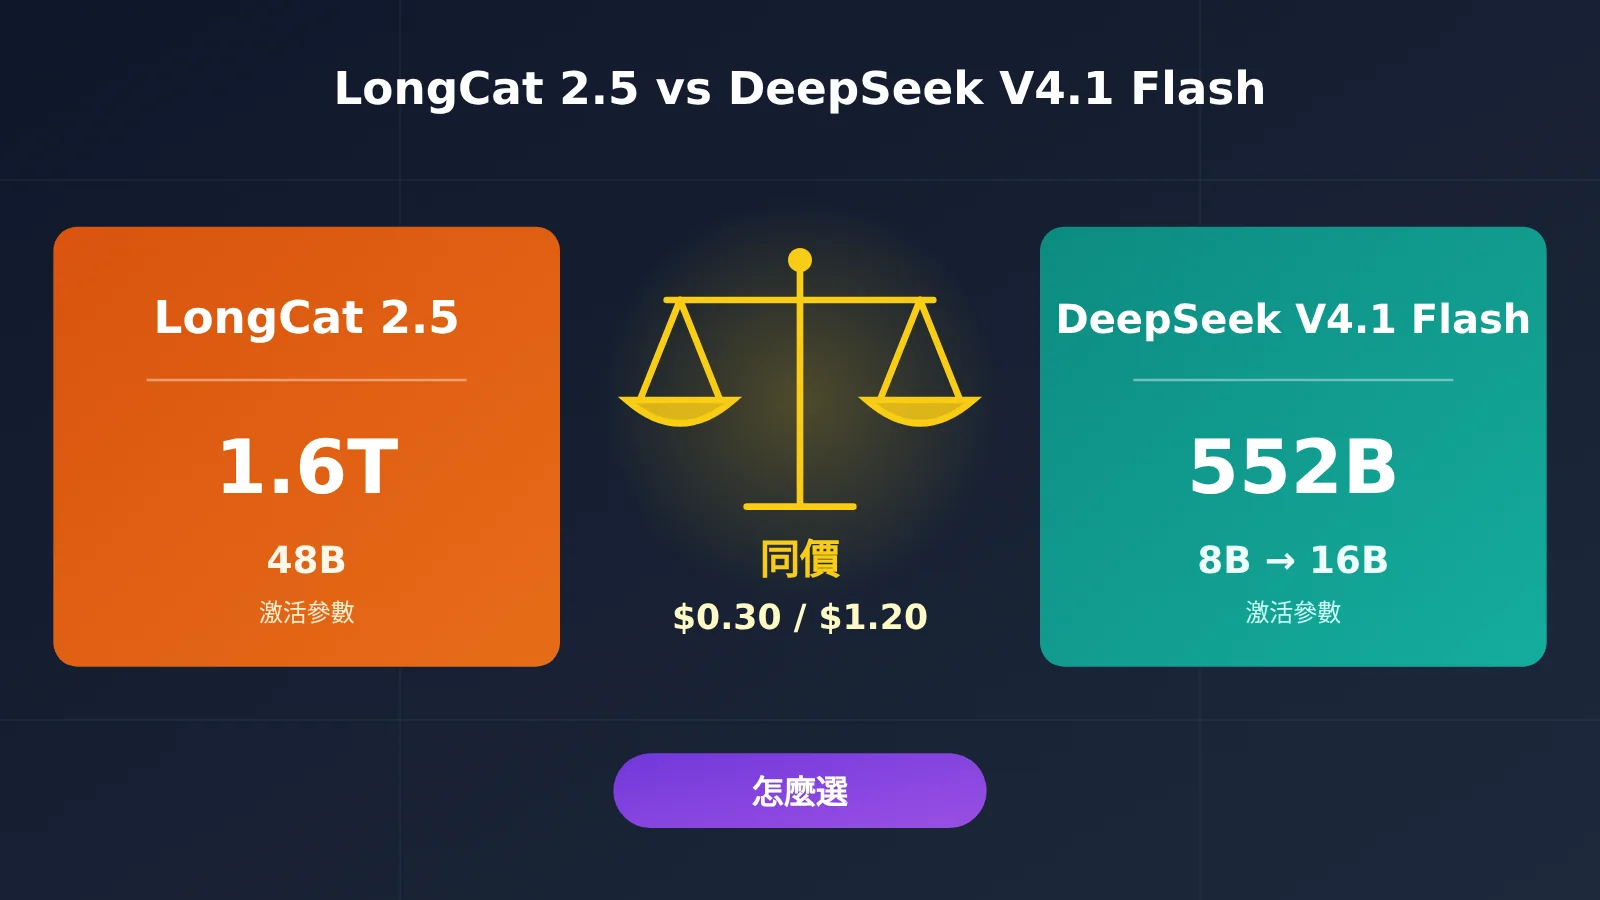
LongCat 2.5 對比 DeepSeek V4.1 Flash:兩張模型名片
先說結論:LongCat 2.5 參數更多,每次激活也更多。DeepSeek V4.1 Flash 體量更小、激活更省,同時輸出上限更長,權重也能直接下載。兩者上下文都是 1M。真正影響選型的是三項:最大輸出 128K 對 384K、開源與否、激活規模。
| 維度 | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| 總參數 | 1.6T(1.6 萬億) | 552B |
| 激活參數 | 每 token 約 48B | 輸入激活 8B,輸出激活 16B |
| 結構 | 面向智能體的原生多模態模型,視覺與文本用統一 token 處理 | MoE,Causal-Encoder-Decoder 非對稱結構 |
| 上下文長度 | 1M | 1M |
| 最大輸出 | 128K | 384K |
| 原生視覺 | 支持,視覺信號表示爲多層級離散 token | 支持(Vision) |
| 權重開源 | 未放權重,GitHub 與 HuggingFace 均標「敬請期待」 | 已開源,HuggingFace 發佈權重並附技術報告 |
| 思考開關 | 官方評測在 thinking 開啓下取得 | 思考模式默認開啓,可用 reasoning_effort 調檔 |
LongCat 2.5 結構要點
LongCat 2.5 的定位寫得很直接:面向長程智能體任務。相對 2.0 版本,它重點強化了原生視覺理解和智能體編程兩塊。視覺部分把圖像做原生分辨率離散化(SAE+RVQ),先離線預處理成視覺 token,再和主幹聯合學習。主幹用同一套 token 處理視覺和文本,所以叫原生多模態。
訓練上,LongCat 2.5 大量使用長程軌跡數據和大規模長程 RL。官方博客提到幾個細節:把真實 Agent 的失敗軌跡改造成可驗證任務;異步 RL 採用 partial rollout,並過濾掉全對或全錯、產生零梯度的樣本組;對重複思考和重複工具調用加懲罰。最後一條對做 Agent 的人很重要,模型在工具循環裏原地打轉的情況會更少,token 浪費也更少。
推理工程方面,W4A4 相對 W8A8 INT8 的變化是:prefill 吞吐提升 43.3%,decode 吞吐提升 42.77%,TTFT 降低 15.91%,TPOT 降低 19.72%。訓練側的雙重分片 FSDP 讓長序列 SFT 單卡吞吐比 DDP 基線高 86%。這些數字說明 1.6T 的體量在服務端做過專門壓縮,不過官方沒有公開限流數字。
DeepSeek V4.1 Flash 結構要點
DeepSeek V4.1 Flash 是新結構系列裏最小的尺寸。它的特點是輸入和輸出不對稱:讀輸入時只激活 8B,生成輸出時激活 16B。Agent 場景通常輸入遠多於輸出,比如讀倉庫、讀日誌、讀工具返回,這種設計正好壓低了讀取那一側的計算量。
成本側的變化更大。新一代 KV Cache 大幅縮小,HBM 需求降到上一代的 1/4,SSD 需求降到 1/8;相對初代模型,KV Cache 累計縮小 437 倍。另外有一個變化需要留意:2026-09-14 12:00 之後,訪問 deepseek-v4-pro 的請求會被路由到 V4.1 Flash,並按 Flash 單價計費,這個安排持續到 V4.1 Pro 上線。還在用舊模型名的項目,實際調用的已經是 Flash。
LongCat 2.5 對比 DeepSeek V4.1 Flash 價格:同價只在峯時成立
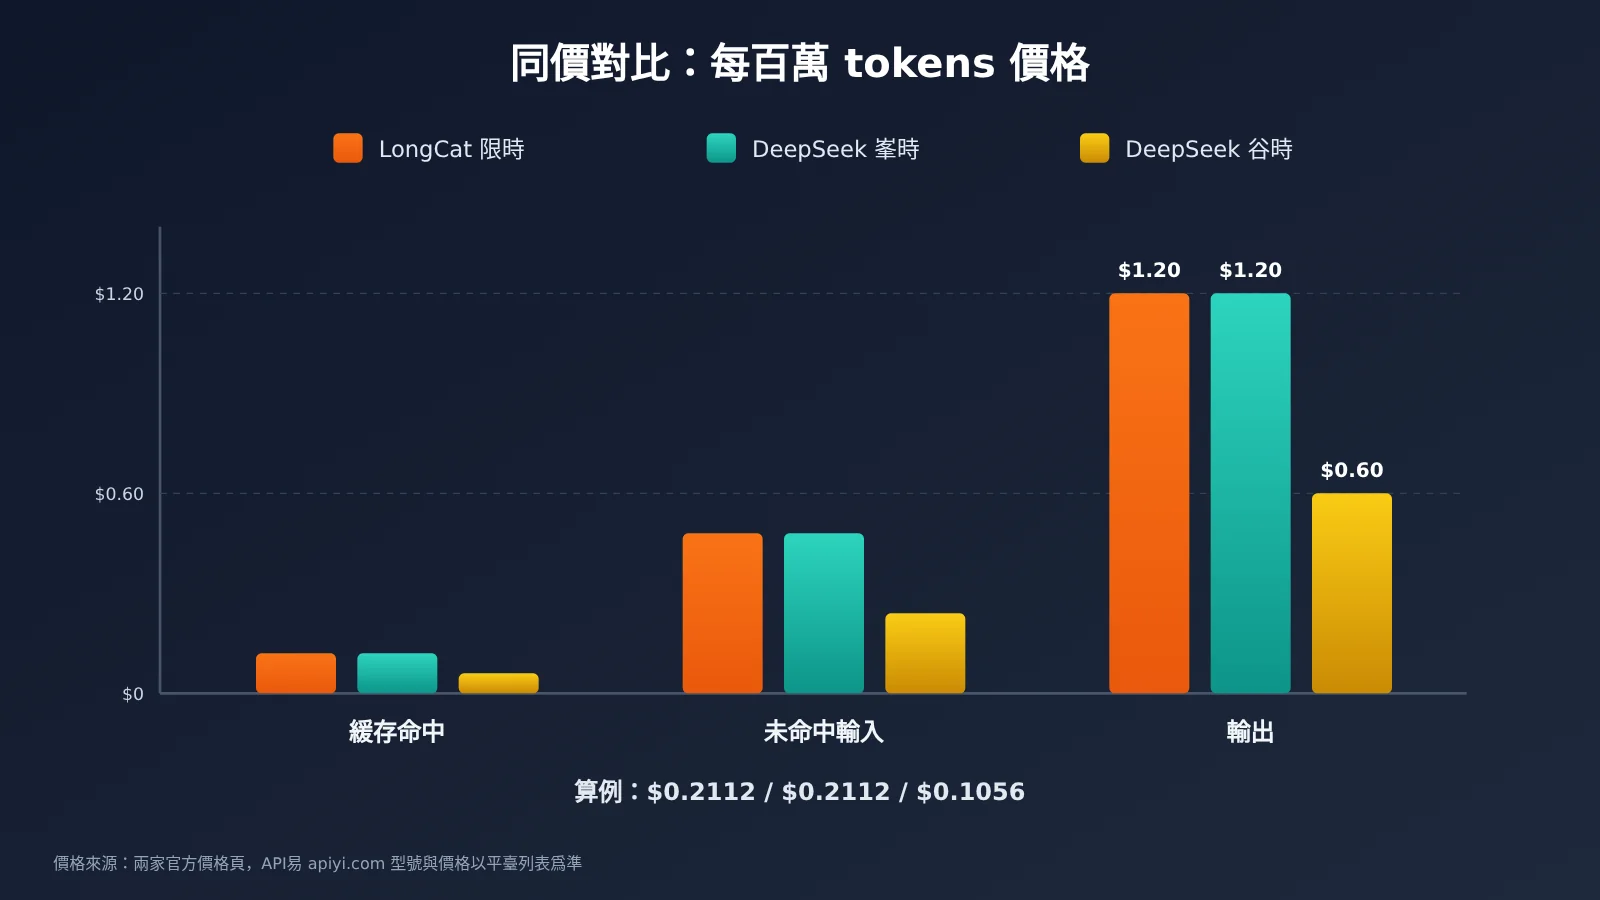
結論:LongCat 2.5 的限時折扣價和 DeepSeek V4.1 Flash 的峯時價逐項相同。到了谷時,DeepSeek 直接打五折,同樣的任務只要一半的錢。所以「同價」這個說法只在工作日白天成立。
| 每 100 萬 tokens(美元) | LongCat 2.5(限時折扣) | DeepSeek 峯時 | DeepSeek 谷時 |
|---|---|---|---|
| 緩存命中輸入 | $0.006 | $0.006 | $0.003 |
| 緩存未命中輸入 | $0.30 | $0.30 | $0.15 |
| 輸出 | $1.20 | $1.20 | $0.60 |
算一筆賬。假設一個 Agent 任務消耗 50 萬輸入 tokens(其中 30 萬未命中緩存、20 萬命中)和 10 萬輸出 tokens:
- LongCat 2.5(限時折扣):0.3×0.30 + 0.2×0.006 + 0.1×1.20 = $0.2112
- DeepSeek 峯時:計算過程相同,$0.2112
- DeepSeek 谷時:0.3×0.15 + 0.2×0.003 + 0.1×0.60 = $0.1056
單個任務差 1 毛錢,看起來不多。放大到每天 1000 個同規模任務,LongCat 和 DeepSeek 峯時都是 $211.2,DeepSeek 谷時是 $105.6。跑批量的團隊一個月下來,差額相當可觀。
DeepSeek 的峯時是北京時間工作日 09:00-12:00、14:00-18:00,對應 UTC 週一至週五 01:00-04:00 與 06:00-10:00,中國法定節假日除外。其餘時間都是谷時半價,包括工作日的中午、晚上、凌晨,以及週末和法定節假日全天。換句話說,一週 168 小時裏,峯時只佔工作日每天 7 小時。
LongCat 2.5 的計費也有幾處細節值得記下:
- 只有 HTTP 200 才扣費,401、403、429、500 都不計費,重試失敗不花錢。
- 額度包每天北京時間 10:00、16:00、21:00、23:00 限量閃購,有效期 30 天,未消耗部分可全額退款;緩存命中不佔額度包 token。
- 贈送額度:新用戶 10M tokens,老用戶 5M tokens,自動到賬,緩存命中不消耗贈送額度。
- 價格標注爲限時折扣,後續調整要以官方價格頁爲準。
DeepSeek 這邊,聯網搜索和網頁抓取是獨立計費的 API,每 1000 次成功請求 $0.75,搜索和抓取同價。如果你的 Agent 頻繁聯網,這部分要單獨算進預算。
💰 成本提示:如果你通過 API易 apiyi.com 調用 DeepSeek V4.1 Flash,計費以平臺型號列表爲準,不一定等同於官方峯谷價。在平臺控制檯先跑一小批任務看賬單,再決定批量方案,結果最準確。
LongCat 2.5 對比 DeepSeek V4.1 Flash 官方跑分
結論:兩家在多數 Agent 基準上相差不到 3 分,基本屬於同一檔。LongCat 2.5 在 Terminal Bench v4.0、Program Bench、JobBench、3D 生成上領先;DeepSeek V4.1 Flash 在 DeepSWE、NL2Repo、AutomationBench 上領先,而且領先幅度更大。
| 基準 | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Terminal Bench v2.1 | 88.4 | 90.6 |
| Terminal Bench v4.0 | 38.5 | 31.2 |
| Program Bench | 25.5 | 20.3 |
| DeepSWE v1.1 | 64.6 | 74.2 |
| NL2Repo | 60.5 | 65.4 |
| BrowseComp | 91.9 | 91.5 |
| HLE w/tools | 63.1 | 63.9 |
| AutomationBench | 51.8 | 54.8 |
| MCP Atlas | 83.1 | 84.4 |
| JobBench | 65.4 | 63.2 |
| 3DCodeBench(Text to 3D) | 55.4 | 53.3 |
| Vision2Web | 78.6 | 79.2 |
口徑說明(必讀):兩家的數字都是官方自測。LongCat 2.5 用自家 harness,在 thinking 開啓、temperature=1.0、top_p=0.95 下取得;DeepSeek 一列多數取自其公開技術報告,用的是 DeepSeek 自家 harness 和 Max 推理檔。兩邊的 harness、評測日期、推理檔位都不同,這張表只能作同級參考,不構成排名。
跑分怎麼讀
差距最大的兩項方向相反。Terminal Bench v4.0 上,LongCat 2.5 比 DeepSeek 高 7.3 分(38.5 對 31.2);DeepSWE v1.1 上,DeepSeek 比 LongCat 高 9.6 分(74.2 對 64.6)。前者考的是更難、更長的終端任務,後者考的是在真實倉庫裏修 bug。兩個模型的強項就此分開:一個擅長長鏈路的終端操作,一個擅長在既有代碼庫裏精確改動。
舊版 Terminal Bench v2.1 上 DeepSeek 反而高 2.2 分,說明難度上去之後 LongCat 的優勢才顯出來。Program Bench 上 LongCat 高 5.2 分,NL2Repo 上 DeepSeek 高 4.9 分。NL2Repo 是從自然語言描述生成整個倉庫,更接近「從零搭項目」的工程化能力。
視覺相關的項目差距很小。Vision2Web 上 DeepSeek 高 0.6 分;3DCodeBench 上 LongCat 高 2.1 分;官方表裏的 CharXiv-RQ w/tools,LongCat 90.2 對 87.7;MathVision w/tools 則是 DeepSeek 97.4 對 96.5。只看純視覺理解,兩家差不多。LongCat 的優勢主要在把視覺理解和 3D、交互式頁面生成串起來。官方 8 個演示裏有實時流體模擬、3D 文物交互展示、城市沙盤、微縮場景資產,方向很明確。
BrowseComp、HLE w/tools、MCP Atlas 三項的差距都在 1.3 分以內,聯網檢索和 MCP 工具調用這類通用 Agent 能力可以看作打平。
DeepSeek 的推理檔位是成本槓桿
DeepSeek 技術報告 5.3.3 節給出一組很實用的數據。reasoning effort 從 25 提到 100,8 個推理類基準的平均 Pass@1 從 67.1% 升到 76.3%,DeepSWE v1.1 從 66.0 升到 74.2,代價是輸出 token 增加到約 2.5 倍。60-80 檔已經接近滿檔準確率,token 預算卻不到滿檔的一半;最後衝到 100 檔,agent 軌跡長度還會再漲 1.6-1.8 倍,換來的只是邊際提升。
另外要注意,DeepSeek API 的 reasoning_effort 默認是 high,而官方成績是在 Max 檔跑出來的。想復現上表裏 DeepSeek 一列的分數,必須顯式設成 max。日常任務用中等檔,最難的任務再開滿檔。輸出 token 是兩家賬單裏最貴的一項($1.20),這個檔位開關直接決定錢花在哪裏。
LongCat 2.5 對比 DeepSeek V4.1 Flash:任務怎麼分工
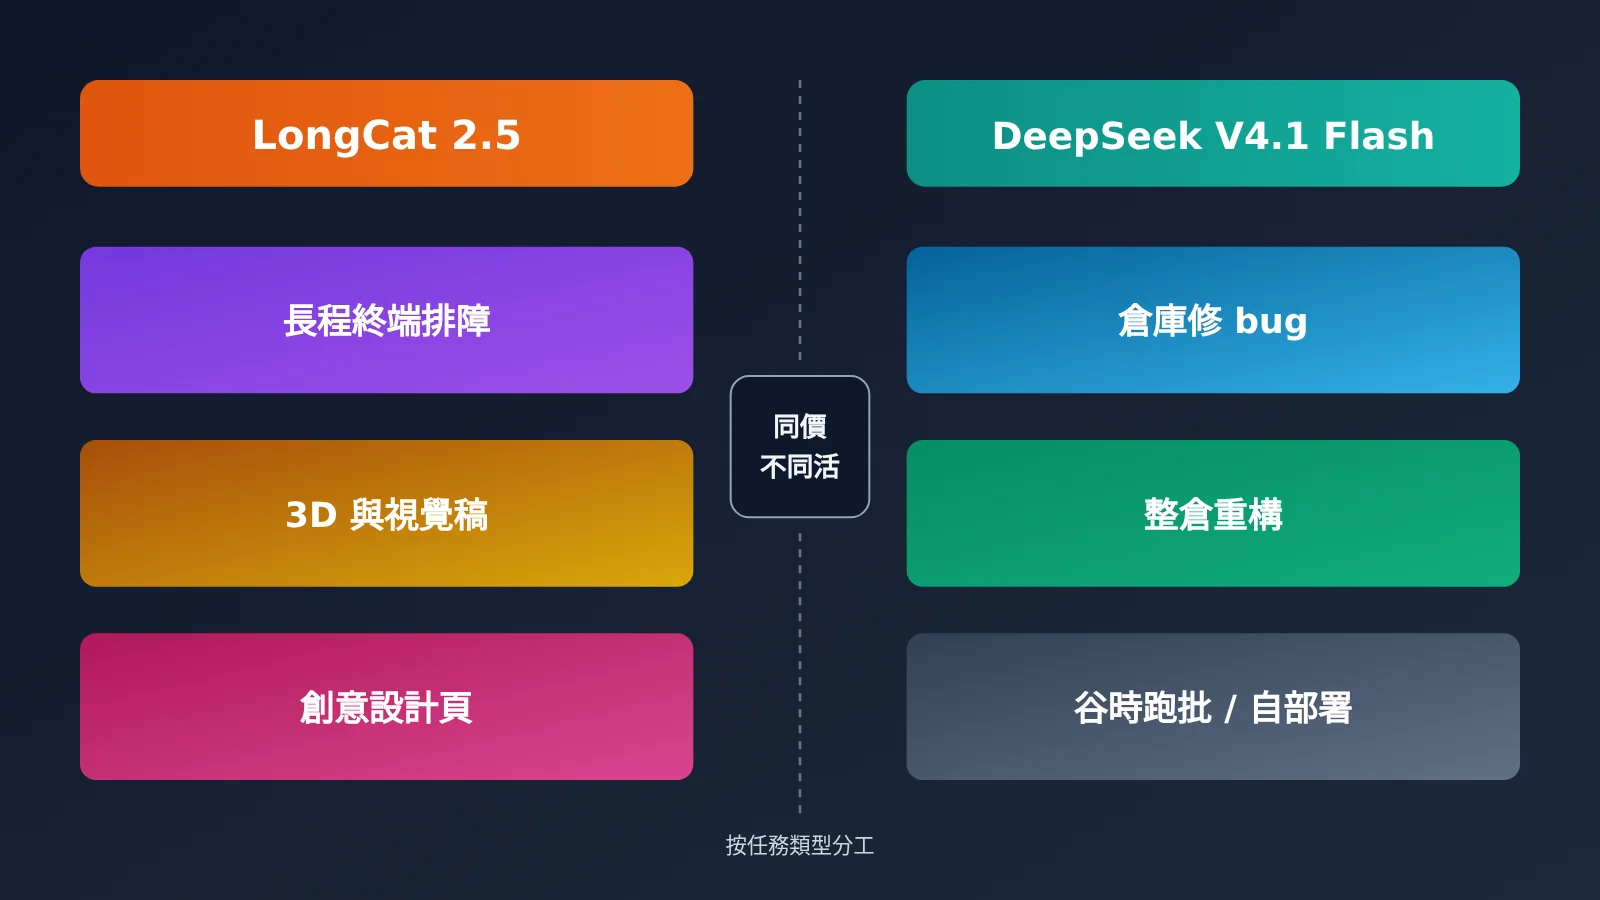
結論:同價不同活。長程終端任務、視覺與 3D、創意設計頁交給 LongCat 2.5;真實倉庫改代碼、SWE 修 bug、自動化流水線、需要自部署的場景交給 DeepSeek V4.1 Flash。
| 更適合 LongCat 2.5 | 更適合 DeepSeek V4.1 Flash |
|---|---|
| 長程終端排障:多步驟登錄服務器、查日誌、改配置、重啓驗證(Terminal Bench v4.0 高 7.3 分) | 真實倉庫修 bug:讀 issue、定位文件、改動並通過測試(DeepSWE 高 9.6 分) |
| 3D 資產與視覺稿:文本生成 3D 場景、交互式展示頁(3DCodeBench 55.4) | 整倉重構與從零搭倉庫:按需求描述生成多文件項目(NL2Repo 高 4.9 分) |
| 創意設計頁:活動邀請函、風格化色彩頁、數據可視化報告(官方演示方向) | 自動化流水線與批量跑批:夜間批處理、數據清洗、報表生成(AutomationBench 高 3.0 分,谷時半價) |
| 編程題式的程序構造與職業類綜合任務(Program Bench、JobBench 領先) | 需要自部署或私有化:權重已在 HuggingFace 開源;單次長輸出(最大 384K) |
選擇 LongCat 2.5 的理由
LongCat 2.5 最有說服力的數字是 Terminal Bench v4.0。v2.1 落後 2.2 分,v4.0 反而領先 7.3 分,說明任務越長、越難,它的相對優勢越大。這和它訓練時大量使用長程軌跡、並對重複工具調用加懲罰的做法相符。如果你的 Agent 經常要在終端裏連續執行幾十步,LongCat 2.5 更值得優先試。
第二個理由是視覺和生成結合的任務。原生多模態加上 3D、交互頁面方向的訓練,讓它更適合「看圖出稿」「文字出 3D」這類活。另外它對新用戶有 10M tokens 贈送,緩存命中不扣贈送額度,先試成本很低。
選擇 DeepSeek V4.1 Flash 的理由
DeepSeek V4.1 Flash 最硬的數字是 DeepSWE 74.2,在兩家對照項裏差距最大。日常寫代碼最常見的就是在已有倉庫裏改東西,這正是它的強項。最大輸出 384K 是 LongCat 的 3 倍,生成長文件或大段補丁時不容易被截斷。
第三個理由是成本結構。谷時半價,再加上可調的推理檔位,兩個開關疊加起來,批量任務的成本彈性比 LongCat 的固定限時價大得多。併發上限 2500 也寫在官方文檔裏,規劃吞吐時有明確數字可依據。需要私有化的團隊還能直接下載權重,不過官方說明大規模部署需要 2k 卡 GPU 級別的資源,小團隊自部署前要先評估硬件。
💡 選擇建議:表格只能縮小範圍,最終還要看你自己的任務。可以從項目裏挑 10-20 個代表性任務,同時給兩個模型跑一遍,對比成功率和 token 消耗。DeepSeek V4.1 Flash 這一側可以先通過 API易 apiyi.com 接入測試,省去單獨開戶。
LongCat 2.5 與 DeepSeek V4.1 Flash 怎麼接入
結論:兩家都兼容 OpenAI 和 Anthropic 兩種接口格式,接 Claude Code 只要改 ~/.claude/settings.json 裏的幾個環境變量。DeepSeek 額外支持 Responses API。
接入 LongCat 2.5
- OpenAI 格式(任意 OpenAI SDK):base_url 填
https://api.longcat.ai/openai,模型名填LongCat-2.5。 - Anthropic 格式(Anthropic SDK):base_url 填
https://api.longcat.ai/anthropic。 - Claude Code(編輯
~/.claude/settings.json的 env 字段),四個變量都要寫: ANTHROPIC_AUTH_TOKEN填你的 LongCat KeyANTHROPIC_BASE_URL填https://api.longcat.ai/anthropicANTHROPIC_MODEL填LongCat-2.5CLAUDE_CODE_MAX_OUTPUT_TOKENS填131072- 限流處理(你自己的調用代碼):超限時返回 429(rate_limit_exceeded,retry_after 60),官方建議指數退避。文檔沒有公開 RPM/TPM 數字,429 不計費。
接入 DeepSeek V4.1 Flash
- OpenAI 格式(任意 OpenAI SDK):模型名填
deepseek-flash。舊名deepseek-v4-flash、deepseek-v4-flash-vision-exp仍可用,會路由到 V4.1-Flash-1017,按 Flash 價計費。 - Claude Code(編輯
~/.claude/settings.json的 env 字段): ANTHROPIC_AUTH_TOKEN填你的 DeepSeek KeyANTHROPIC_BASE_URL填https://api.deepseek.com/anthropicANTHROPIC_MODEL填deepseek-flash- 推理檔位(OpenAI SDK 請求參數):日常把
reasoning_effort設爲中等檔,難題再設max。 - 現成工具:WorkBuddy(含 CodeBuddy)和 OpenCode 是官方合作工具,已全量接入。
通過 API易 統一調用
如果你手上要同時跑幾個模型做對比,API易 一個賬號、一把 key 就能切換,不用每家單獨開戶。
- OpenAI SDK 配置(你的項目代碼):base_url 填
https://api.apiyi.com/v1,api_key 填 API易 控制檯生成的 key。 - 模型名(同一個請求參數裏切換):DeepSeek V4.1 Flash 用
deepseek-v4.1-flash或deepseek-v4.1-flash-1017,按平臺型號列表計費。 - 對比測試(同一套代碼):只改 model 參數,就能和平臺上其他模型並排跑同一批任務,base_url 依然是
https://api.apiyi.com/v1。
型號與價格以平臺型號列表爲準;API易 目前還沒上架 LongCat-2.5,會盡快推出此模型。在那之前,LongCat 2.5 先走官方端點,DeepSeek 這一側可以放在 API易 apiyi.com 上統一管理。
🚀 快速開始:新用戶在 API易 apiyi.com 註冊即有免費測試額度。先把 DeepSeek V4.1 Flash 接進現有的 OpenAI SDK 項目,改一行 base_url 就能跑起來。
LongCat 2.5 對比 DeepSeek V4.1 Flash 常見問題
Q1:兩家價格真的一樣嗎?
只在 DeepSeek 峯時一樣。LongCat 2.5 的限時折扣價是 $0.30 / $0.006 / $1.20,和 DeepSeek 峯時逐項相同。DeepSeek 谷時全部打五折,覆蓋工作日 09:00-12:00、14:00-18:00 以外的所有時間。另外 LongCat 的價格是限時折扣,以後可能調整。
Q2:跑分表能說明誰更強嗎?
不能直接排座次。兩家都是官方自測,harness、日期、推理檔位都不同,DeepSeek 一列還是 Max 檔成績。比較合適的讀法是看差距大的單項:Terminal Bench v4.0 上 LongCat 領先 7.3 分,DeepSWE 上 DeepSeek 領先 9.6 分。差距在 1-2 分以內的項目,視爲打平即可。
Q3:LongCat 2.5 什麼時候開源?
官方沒有給時間表。目前 GitHub 和 HuggingFace 都標「敬請期待」,沒有放出權重。必須自部署的項目,現階段只能選 DeepSeek V4.1 Flash,它的權重和技術報告都已公開。
Q4:在 API易 上能同時調用這兩個模型嗎?
目前只能調用 DeepSeek V4.1 Flash,型號是 `deepseek-v4.1-flash` 和 `deepseek-v4.1-flash-1017`,按平臺型號列表計費。API易 目前還沒上架 LongCat-2.5,會盡快推出此模型。型號與價格以 API易 apiyi.com 平臺型號列表爲準。
Q5:批量任務怎麼壓成本?
用 DeepSeek 時同時用好兩個開關:一是把任務排到谷時,單價直接減半;二是把 reasoning_effort 設在中等檔。報告顯示 60-80 檔已接近滿檔準確率,token 預算不到滿檔的一半。緩存命中價格只有未命中的 1/50,把固定的系統提示和工具定義放在請求前部,可以提高命中率。
總結:LongCat 2.5 對比 DeepSeek V4.1 Flash 怎麼選
結論很明確:同價不同活,按任務分工,批量任務放谷時。
- 規模:1.6T / 48B 激活對 552B / 輸入 8B、輸出 16B 激活,上下文都是 1M。
- 輸出上限:LongCat 128K,DeepSeek 384K,長輸出任務選 DeepSeek。
- 價格:LongCat 限時價等於 DeepSeek 峯時價;DeepSeek 谷時半價,算例 $0.2112 對 $0.1056。
- 跑分:長程終端任務 LongCat 領先 7.3 分,倉庫修 bug DeepSeek 領先 9.6 分,其餘多數項打平。
- 開源:DeepSeek 已開源,LongCat 未放權重。
- 接入:兩家都兼容 OpenAI 與 Anthropic 格式,Claude Code 改 env 變量即可切換。
帶走一句話:先按任務分工表挑一個主用,另一個留作補充;批量任務儘量安排在谷時跑。DeepSeek V4.1 Flash 這一側可以通過 API易 apiyi.com 用統一接口先做小規模驗證,再決定主力方案。
📚 參考資料
- LongCat-2.5 官方博客:模型定位、結構、訓練與工程細節
- 鏈接:
longcat.ai/blog/longcat-2.5 -
說明:參數規模、視覺 token 方案、W4A4 推理數據與官方評測表
-
LongCat 開放平臺文檔:價格、端點與 Claude Code 接入
- 鏈接:
longcat.ai/platform/docs -
說明:限時折扣價、429 處理、額度包與贈送規則
-
DeepSeek V4.1 Flash 發佈文:結構、開源與 API 變更
- 鏈接:
deepseek.com/news/deepseek-v4-1-flash -
說明:非對稱 MoE、KV Cache 壓縮、模型名遷移說明
-
DeepSeek API 價格頁:峯谷價格與併發限制
- 鏈接:
api-docs.deepseek.com/quick_start/pricing -
說明:峯谷時段定義、併發 2500、搜索抓取獨立計費
-
DeepSeek-V4.1-Flash 權重倉庫:開源權重與技術報告
- 鏈接:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash - 說明:Table 3 跑分與 5.3.3 節推理檔位分析
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心