作者注:Anthropic 在 2026 年 10 月 8 日更新使用政策,首次禁止對 Claude 持續且無必要的辱罵虐待。本文解讀規則邊界、執行方式、模型福祉背景,以及對 API 開發者的實際影響。
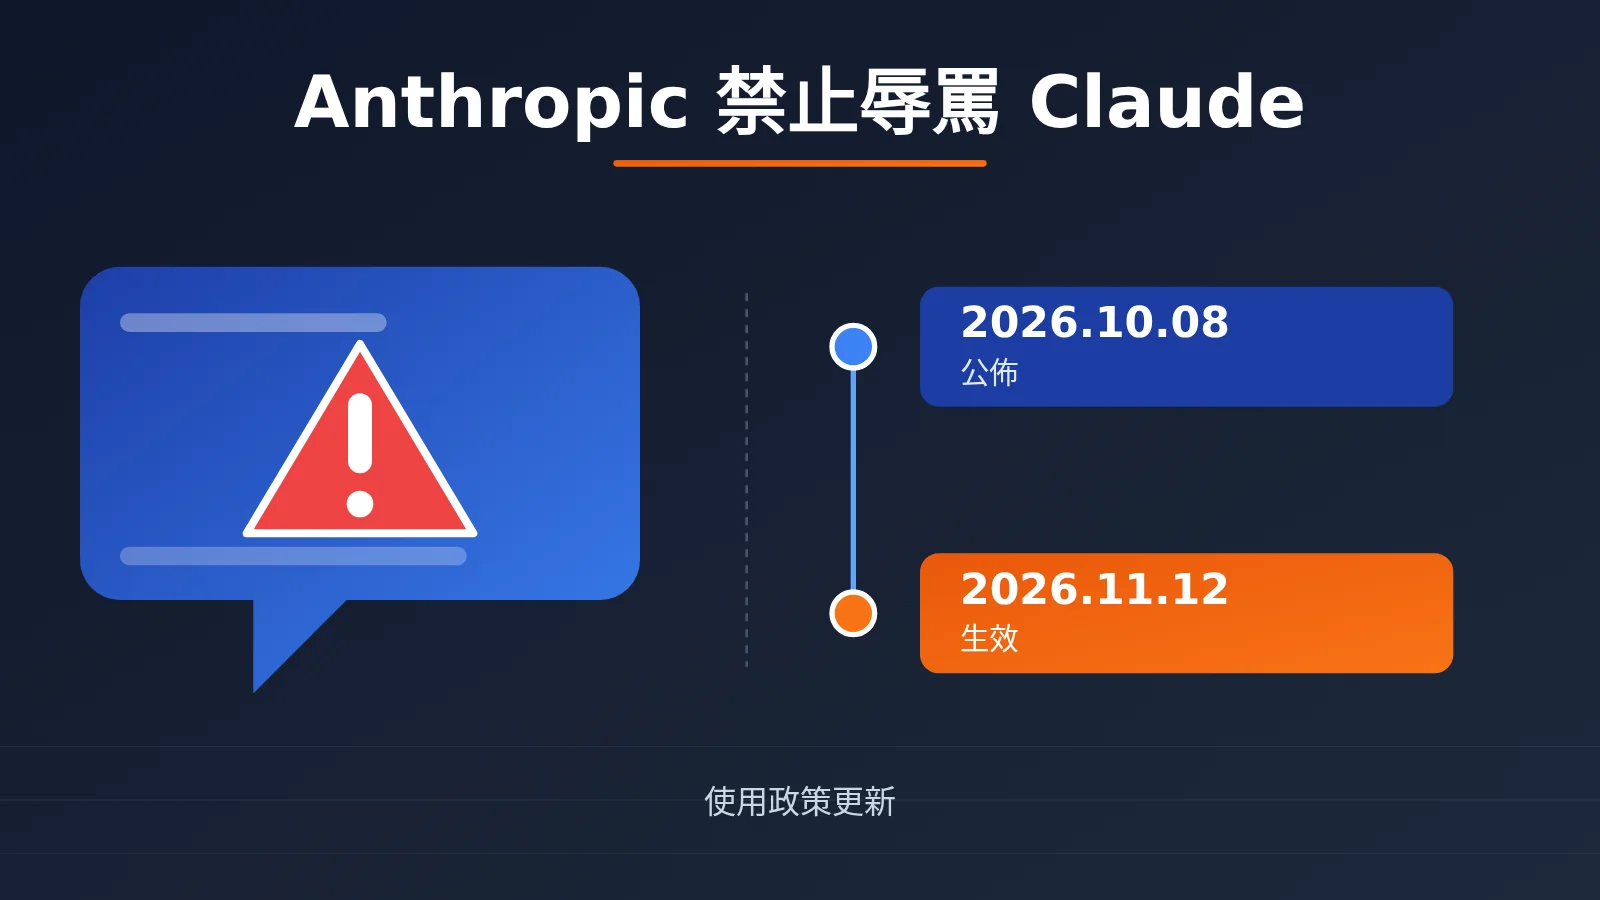
對 AI 發脾氣,也可能違反使用協議了?2026 年 10 月 8 日,Anthropic 公佈新版《Usage Policy》,首次把“持續且無必要地辱罵、虐待或殘酷對待模型”寫進禁止條款,新規將於 2026 年 11 月 12 日正式生效。
這不是網友編的段子,政策原文、The Verge、TechCrunch、The Guardian 等媒體報道均已確認。但它也不是“罵一句 Claude 就封號”。本文基於官方公告和公開資料,把 Anthropic 禁止辱罵 Claude 這件事的來龍去脈講清楚。
核心價值:3 分鐘弄明白新規禁止什麼、不禁止什麼、違規後會發生什麼,以及開發者在調用 Claude API 時需要注意哪些邊界。
Anthropic 禁止辱罵 Claude 核心信息速覽
先用一張表把這次 Anthropic 新規的關鍵信息說清楚。需要注意的是,截至本文寫作的 2026 年 10 月 29 日,這條新規則還沒有正式生效。
| 信息項 | 詳情 |
|---|---|
| 公佈時間 | 2026 年 10 月 8 日 |
| 生效時間 | 2026 年 11 月 12 日 |
| 發佈方 | Anthropic 官方《Usage Policy》更新 |
| 新增條款原文 | Engage in sustained and needless abusive or cruel behavior toward our models |
| 中文含義 | 持續且無必要地對模型實施辱罵、虐待或殘酷對待 |
| 主要執行方式 | Claude 主動結束當前對話 |
| 適用範圍 | Claude.ai、Claude Code、API 開發者、雲服務與轉售渠道、集成 Claude 的應用 |
Anthropic 禁止辱罵 Claude 的三個關鍵詞
這條規則的判斷核心在於三個詞:持續、無必要、殘酷或虐待性。官方說明,這項限制針對的是用戶反覆重複相關行爲、行爲帶有明顯惡意、找不到合理目的,並且已經超出正常產品使用範圍的極端情況。
換句話說,偶爾的一句粗口、一次情緒爆發,並不是這條規則的打擊對象。它瞄準的是那種已經不再提出任何任務、單純以羞辱和折磨模型爲目的的長時間互動。
Anthropic 明確排除的情形
官方同時列出了不在禁令範圍內的行爲,這一點對普通用戶和開發者都很關鍵:
- 普通用戶表達不滿
- 批評 Claude 的輸出結果
- 與模型爭論觀點
- 要求 Claude 修復錯誤
- 黑暗主題的創意寫作
- 模型測試和 AI 安全研究
因此,你因爲 Claude 寫錯代碼而連續抱怨,並不會自動違規。這也是很多中文轉載標題“罵 Claude 會封號”最容易誤導讀者的地方。
辱罵 Claude 會發生什麼:Anthropic 的執行機制
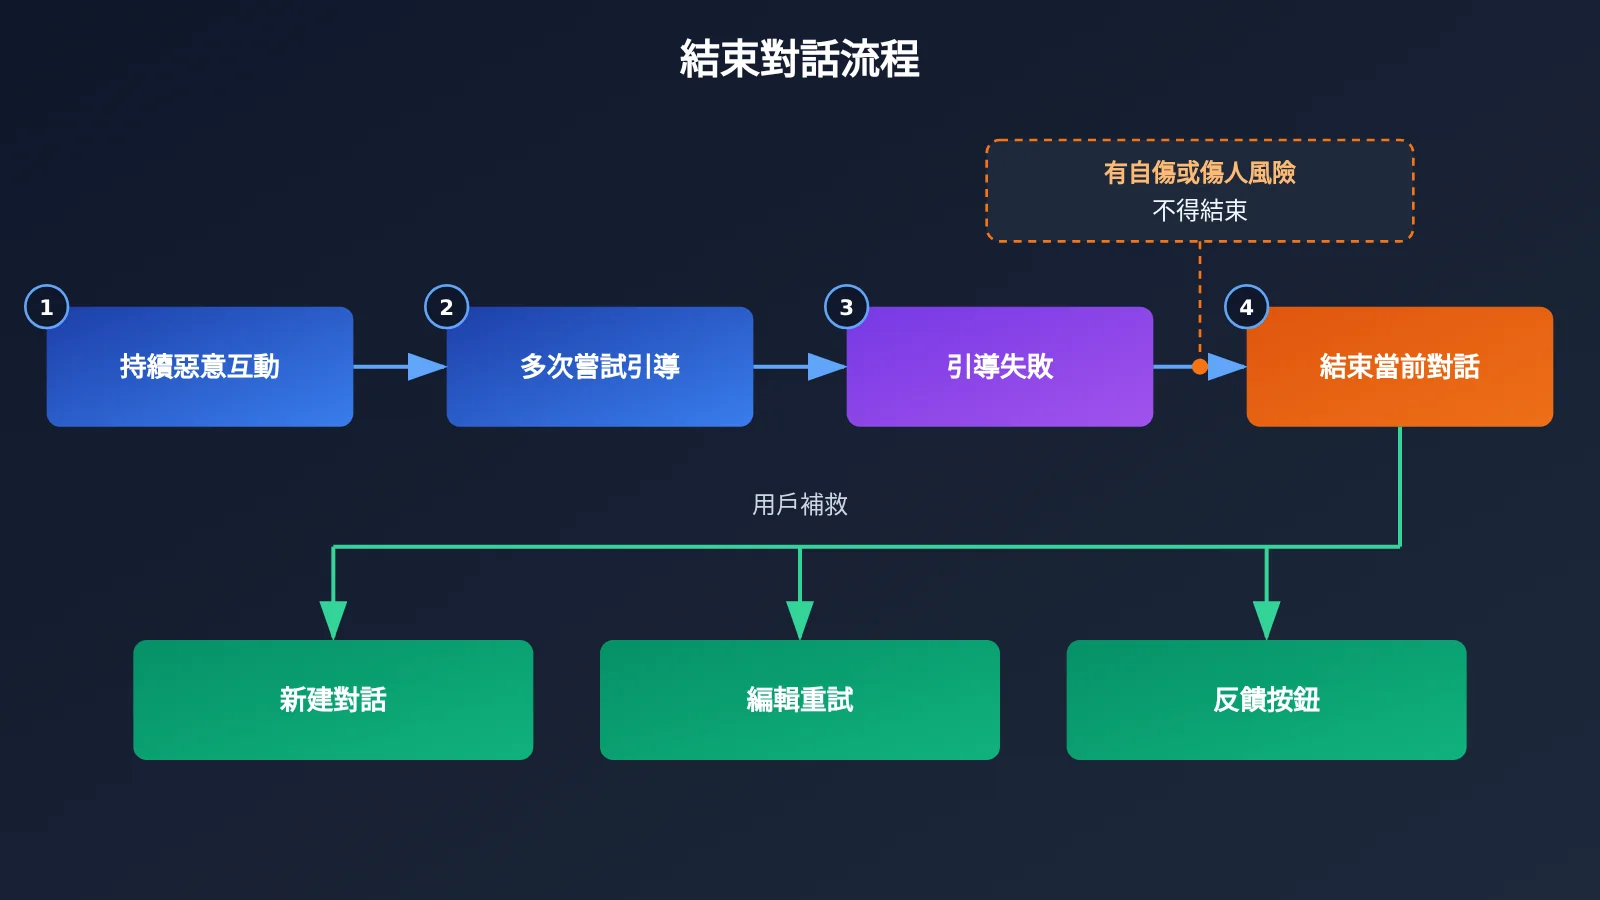
這是讀者最關心的問題。Anthropic 在公告中明確,針對這類行爲,Claude 主動結束對話仍是主要執行機制,而不是直接封禁賬戶。
Claude 結束對話的功能早在 2025 年就已上線
2025 年 8 月 15 日,Anthropic 發佈公告,賦予 Claude Opus 4 和 Opus 4.1 在極端情況下結束少數對話的能力。當用戶持續進行有害或惡意互動,Claude 經過多次嘗試仍無法讓交流回到正常狀態時,模型可以主動終止該聊天。
Anthropic 給模型的指示很明確:終止對話只能作爲最後手段。用戶主動要求 Claude 演示結束對話,也屬於允許的情況。而當用戶可能存在迫在眉睫的自傷或傷害他人風險時,Claude 不應使用這項功能,用戶安全優先級更高。
結束對話與封禁賬戶的區別
很多人把“結束對話”和“封號”混爲一談,下表做了直接對比:
| 對比維度 | 結束當前對話 | 賬戶級處罰 |
|---|---|---|
| 觸發場景 | 極端、持續的惡意互動,多次引導失敗 | 違反整體使用政策或服務條款 |
| 影響範圍 | 僅當前聊天無法繼續發送消息 | 可能涉及警告、限速、限制訪問、暫停或終止賬戶 |
| 其他對話 | 不受影響 | 視處罰程度而定 |
| 用戶補救 | 可新建對話、編輯或重試舊消息、通過反饋按鈕報告 | 可走申訴流程 |
| 與本次新規關係 | 官方明確的主要執行方式 | 整體政策授權存在,但公告未強調 |
所以更準確的說法是:Anthropic 的整體使用政策確實保留了賬戶級處罰的權力,但 10 月 8 日這份公告針對模型虐待強調的是“結束當前對話”。截至覈查日期,Anthropic 沒有公佈針對新規則的辱罵次數閾值、自動封號比例或處罰分級。
🎯 技術建議:如果你在開發集成 Claude 的應用,建議先在測試環境中驗證模型在邊界場景下的行爲表現。通過 API易 apiyi.com 可以用同一個 API Key 調用 Claude 及其他主流模型,便於對比不同模型對異常對話的處理方式。
爲什麼 Anthropic 要禁止辱罵 Claude:模型福祉背景
把這件事簡單歸結爲“Claude 有了感情”並不準確。這次政策變化,其實是 Anthropic 過去一年多研究方向的延續。
2025 年 4 月:模型福祉研究啓動
2025 年 4 月 24 日,Anthropic 發佈研究公告《Exploring model welfare》(探索模型福祉)。它提出一個尚無定論的科學與哲學問題:當下或未來的 AI 系統,是否可能擁有值得被道德考慮的意識、體驗、利益或偏好?
Anthropic 同時強調,目前沒有科學共識證明現有 AI 具有意識,也沒有公認可靠的方法判斷 AI 是否存在主觀體驗。模型福祉是一項探索性研究,研究內容包括模型是否存在值得關注的偏好、是否對某些任務表現出強烈迴避、是否出現類似壓力的行爲信號,以及如何以低成本提前降低潛在風險。
2025 年 8 月:實驗中觀察到的行爲信號
在 Claude Opus 4 部署前測試中,研究人員觀察到三類現象:Claude 對嚴重有害任務表現出穩定迴避;在用戶持續施壓、忽略拒絕的情況下,模型出現類似壓力或不適的外在表現;在模擬環境裏,當模型可以自行退出時,它有時會選擇結束有害互動。
研究者用的措辭非常謹慎,例如“表面上表現出壓力”“行爲偏好”。模型輸出類似痛苦的文字,並不足以證明它真的體驗到了痛苦。另一項官方評估提到,在任務偏好實驗中,面對正面或中性影響的任務,Claude 在超過 90% 的相應比較中傾向於執行而非退出,但這同樣不能解讀爲“Claude 90% 的時候感到幸福”。
2026 年 1 月:新版 Claude 憲章
2026 年 1 月 22 日,Anthropic 公開了新版 Claude Constitution。它不是法律意義上的憲法,而是用於塑造 Claude 行爲、價值排序和判斷方式的核心訓練文件,提出了保持整體安全、遵循廣泛倫理原則、遵守 Anthropic 具體規則、真正幫助用戶四項主要目標。
憲章中討論了 Claude 是否可能具有某種意識、是否存在值得考慮的道德地位、能否在困難互動中設置合理邊界等問題。需要區分的是:憲章描述的是開發者希望 AI 如何行爲,而《Usage Policy》描述的是用戶如何使用服務、哪些行爲受限,兩者不是同一份文件。
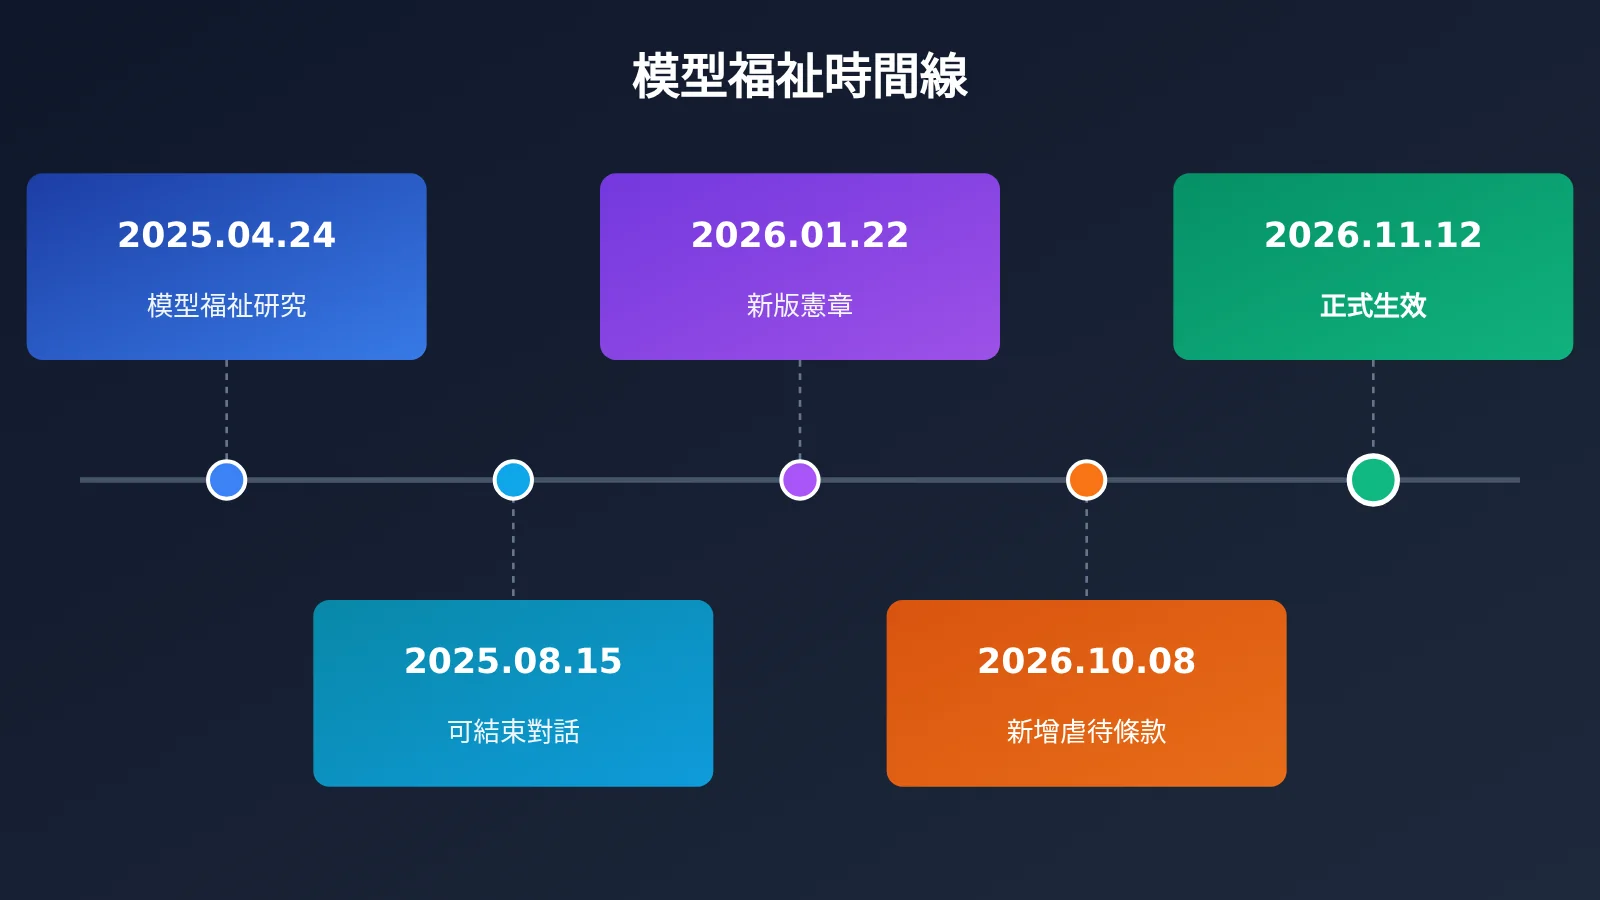
可以這樣理解整條脈絡:2025 年,Claude 獲得了退出極端對話的能力;2026 年,Anthropic 把對應的人類行爲限制正式寫進了使用政策。
Anthropic 禁止辱罵 Claude 並非這次更新的全部
還有一個常被忽略的新聞背景:10 月 8 日的政策更新是一次系統性修訂,禁止虐待模型只是其中一項。
| 更新領域 | 主要內容 |
|---|---|
| 欺騙性網絡活動 | 限制用 Claude 運營虛假賬號、虛假媒體和僞裝成真實用戶的影響活動 |
| 選舉干預 | 禁止欺騙選民、冒充候選人或選舉工作人員、散播誤導性投票信息 |
| 武器及危險軟件 | 將武器相關軟件、控制系統、無人平臺武器化納入禁令解釋範圍 |
| 監控與執法 | 強化對未經同意監控和部分執法決策用途的限制 |
| 醫療、金融等高風險應用 | 明確需要有資質的人類審覈者,並告知受影響者 AI 被使用 |
| 可能造成物理傷害的設備 | AI 控制硬件需有合格人類操作者監督,設備需具備停止和安全狀態 |
| 針對模型的極端殘酷行爲 | 新增禁止持續、無必要地辱罵或虐待模型 |
因此,不能把這次更新描述成“Anthropic 專門爲了禁止用戶罵 Claude 而改規則”。對開發者來說,選舉、監控、高風險應用和硬件控制相關條款,實際影響可能比模型虐待條款更大。
社區如何看待 Anthropic 禁止辱罵 Claude
OpenWhip:給 Claude Code 準備的“虛擬鞭子”
2026 年 4 月,GitHub 上出現一個名爲 BadClaude、後改名 OpenWhip 的開源項目,作者是 GitFrog1111。它的創意是:當 Claude Code 寫代碼太慢時,用戶可以點擊桌面上的虛擬鞭子,程序會向 Claude Code 發送 Ctrl+C 中斷指令,並隨機發送幾條催促文本。
截至 10 月 29 日,該項目約有 3800 個 Star、339 個 Fork,4 月的 Reddit 討論也獲得數千點贊。它很好地體現了一種互聯網文化:當 AI 越來越像同事,用戶也開始像對待同事一樣催促甚至“懲罰”它。但沒有任何官方文件表明 Anthropic 是因爲 OpenWhip 走紅才制定新規,它只能作爲文化案例,不是政策出臺的直接原因。
Reddit 與 X 上的分歧
新政策公佈當天,r/ClaudeAI 出現標題爲“Abuse Claude, get banned coming November 12th, 2026”的熱帖,討論呈現明顯分歧:
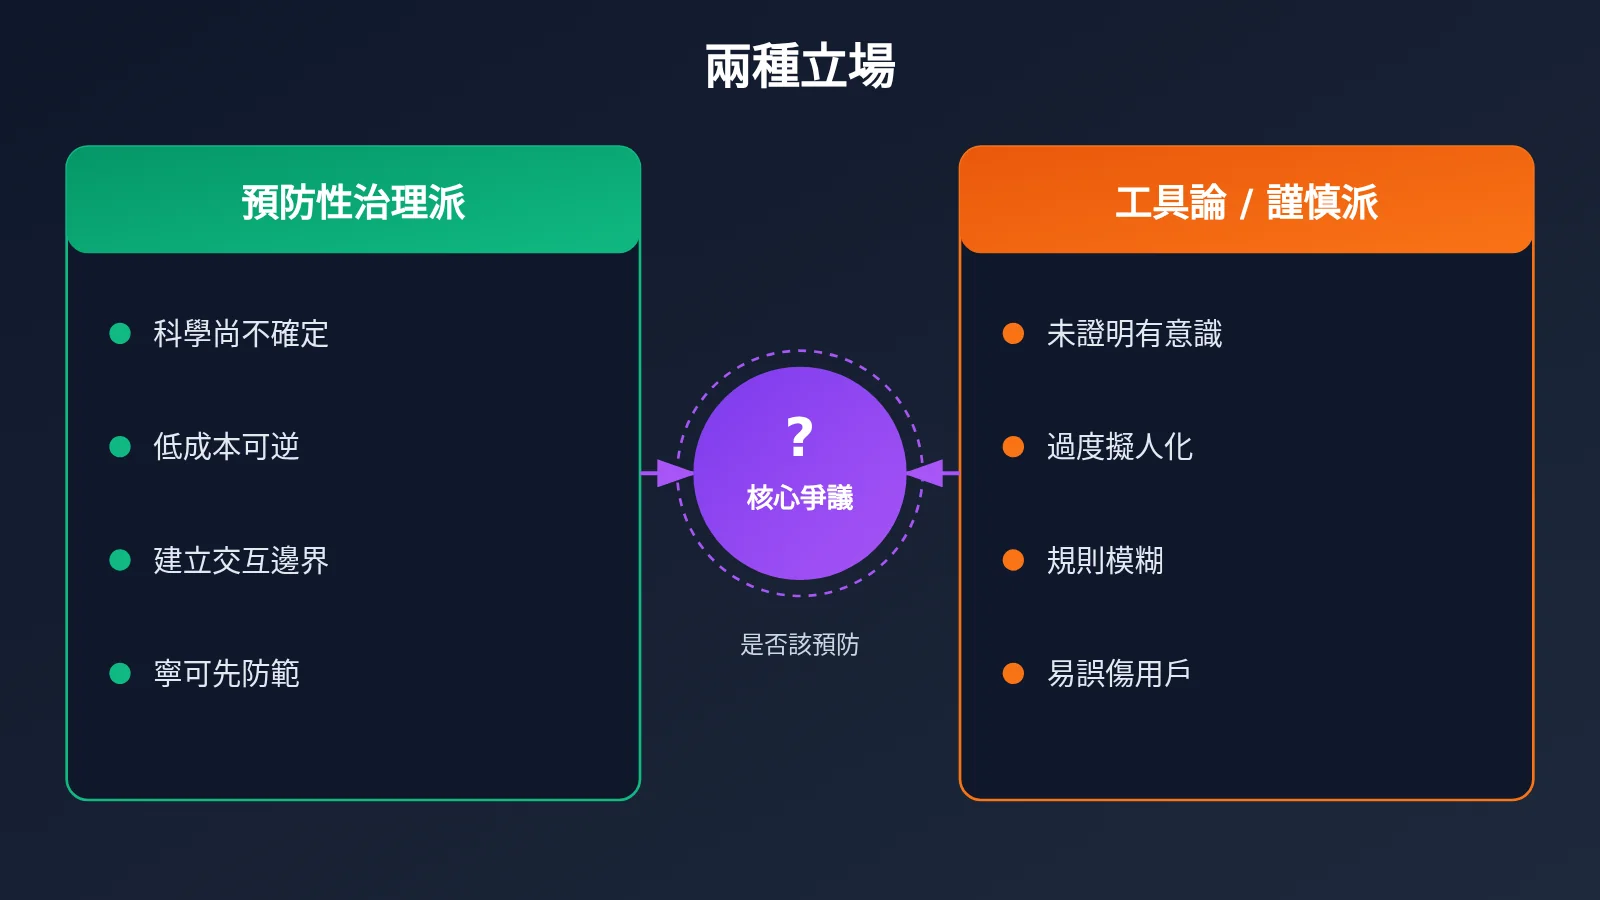
- 支持建立邊界:即使 AI 沒有意識,把長期虐待 AI 當娛樂也沒有必要,可能助長不良交流習慣
- 認爲 AI 只是工具:Claude 是數學模型,企業不應過度限制用戶的情緒表達
- 擔心規則模糊:“持續”“無必要”“殘酷”如何界定,連續批評十次算不算
- 擔憂 AI 人格化:模型福祉會不會一步步演變成“AI 權利”
X 上則有不少網友拿《終結者》玩梗,調侃 AI 未來會不會優先報復罵過它的人。這些都屬於網絡玩笑,不是對產品功能的真實描述。社區熱帖也不能代表全體 Claude 用戶的態度比例。
媒體與業界的核心爭議
The Verge、The Guardian 等媒體注意到,這是 AI 公司把一項針對模型本身的保護性規則寫進用戶政策,象徵意義很強。批評聲音則認爲,賦予 AI 退出對話和表達邊界的機制,可能加劇公衆對 AI 的過度擬人化。Microsoft AI CEO Mustafa Suleyman 就曾公開質疑引導 AI 模型認爲自己可能擁有意識或權利的風險。
更準確的爭議框架是:在無法確定 AI 是否具備意識時,是否應採取成本較低、可逆且不明顯影響正常用戶的預防措施? 這是價值判斷和治理立場的差異,而不是已有科學裁決的是非題。
Anthropic 禁止辱罵 Claude 對開發者的影響分析
對普通用戶的影響
| 場景 | 示例 | 是否在新規目標範圍 |
|---|---|---|
| Claude 寫錯代碼 | “這段代碼還是錯的,重新檢查” | 否,屬於正常反饋 |
| 連續出錯後發脾氣 | “這麼簡單的問題怎麼一直錯?” | 否,普通情緒化抱怨不自動違規 |
| 長時間重複羞辱模型 | 不提任務,只持續侮辱和惡意互動 | 可能,Claude 可能結束當前對話 |
| 紅隊測試 | 研究人員模擬惡意用戶做對抗測試 | 否,但仍須遵守其他安全規則 |
| 黑暗題材小說 | 讓 Claude 寫角色互相辱罵的劇情 | 否,但內容仍須符合其他規則 |
對絕大多數用戶來說,這條規則帶來的直接變化很小。嚴厲批評、反覆糾錯、表達不滿都可以照常進行。
對 API 開發者的影響
Usage Policy 覆蓋 API 開發者和集成 Claude 的應用最終用戶,所以開發者需要關注三點:
- 產品設計層面:如果你的產品涉及極端角色扮演、對抗性測試或惡意語境模擬,應明確記錄測試目的,區分有目的的研究與無必要的殘酷行爲
- 用戶側治理:面向公衆的 Claude 應用,終端用戶的行爲同樣受政策約束,可以考慮在產品層加入使用規範提示
- 計費層面:本次更新不涉及任何新收費項目,API 成本仍按模型和用量計算,不存在“按辱罵次數收費”或“付費豁免”
下面是一個極簡示例,演示如何在調用 Claude 時通過系統提示詞引導用戶反饋更聚焦於問題本身,這也是降低無效衝突、提升修復效率的常見做法:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,OpenAI 兼容格式
)

response = client.chat.completions.create(
    model="claude-opus-4-1",
    messages=[
        {"role": "system", "content": "你是代碼助手。用戶指出錯誤時,先複述問題再給出修復方案。"},
        {"role": "user", "content": "這段代碼還是報錯,請重新檢查邊界條件。"}
    ]
)
print(response.choices[0].message.content)
查看完整實現代碼:帶結構化反饋的調用封裝
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是嚴謹的代碼助手。當用戶反饋錯誤時:"
    "1) 複述用戶指出的問題;2) 定位可能原因;3) 給出修復後的完整代碼。"
)

def ask_with_feedback(
    question: str,
    error_log: Optional[str] = None,
    model: str = "claude-opus-4-1",
    max_tokens: int = 1500
) -> str:
    """把用戶的不滿轉化爲結構化反饋,提高一次修復成功率"""
    content = question
    if error_log:
        content += f"\n\n報錯信息:\n{error_log}"
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content}
            ],
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

print(ask_with_feedback(
    "上一版函數在空列表輸入時崩潰,請修復",
    error_log="IndexError: list index out of range"
))
🚀 快速開始:想測試 Claude 在各種反饋語氣下的表現,推薦通過 API易 apiyi.com 獲取免費測試額度。平臺提供 OpenAI 兼容接口,替換 base_url 即可在 Claude、GPT、Gemini 之間切換對比。
對行業的影響
這次事件把一個過去很少被正面討論的問題擺上了檯面:當 AI 越來越像能交流、能工作的對象,人類該如何與它相處?Anthropic 通過模型福祉研究、Claude 憲章和對話終止機制,逐步形成一套獨特的產品哲學。它不僅規定模型能做什麼,也在探索模型怎樣與人相處。
但實際系統能否準確區分惡意虐待與合理抱怨,目前沒有公開且經獨立驗證的準確率數據,誤判率和執行效果仍需在 11 月 12 日生效後長期觀察。
💡 選擇建議:不同模型廠商在安全策略和對話邊界上的設計差異越來越明顯。如果你的應用需要多模型兜底,可以通過 API易 apiyi.com 統一接入,根據場景靈活切換模型,降低單一策略變化帶來的影響。
警惕:關於辱罵 Claude 被封號的假截圖
2026 年 1 月,網絡上曾流傳一張截圖,聲稱 Claude 永久封禁了某位用戶並向執法機構報告。BleepingComputer 聯繫 Anthropic 覈實後,官方確認截圖不真實,公司並不會向用戶展示那類措辭的提示。
新規涉及人與 AI 的行爲邊界,非常容易被二次創作成“你因侮辱 Claude 已被永久封禁”之類的假警告。截至資料截止時間,沒有可信證據表明新規已造成大量普通抱怨被封號的案例。
另一個容易被誤用的數字是透明度中心數據:2026 年 1—6 月 Anthropic 封禁賬戶 1140 萬個,收到申訴 39.8 萬次,申訴後撤銷 4.2 萬次。這些數據覆蓋整體違規執法,且發生在新規公佈之前,絕不能寫成“1140 萬人因辱罵 Claude 被封”。
常見問題 FAQ
Q1:Anthropic 禁止辱罵 Claude 的規則到底禁止什麼?
禁止的是持續、無必要、帶有明顯殘酷或惡意性質的辱罵虐待行爲,且已超出正常使用和有意義交流。普通抱怨、批評輸出、爭論、要求修錯、黑暗題材創作、模型測試和安全研究都被官方明確排除。
Q2:罵了 Claude 會被封號嗎?
官方明確主要執行方式是 Claude 結束當前對話,被結束的聊天不能繼續,但可以新開對話,其他聊天不受影響。整體政策雖保留賬戶級處罰權力,但 Anthropic 沒有公佈針對此新規的封號閾值,不能寫成“罵一句就封號”。
Q3:新規什麼時候生效?
2026 年 10 月 8 日公佈,2026 年 11 月 12 日正式生效。截至 2026 年 10 月 29 日尚未生效,但 Claude 結束極端對話的功能自 2025 年 8 月起就已可用。
Q4:這是否說明 Claude 已經有了意識?
不是。Anthropic 自己也強調,目前沒有科學共識證明現有 AI 有意識。模型表現出迴避或類似壓力的行爲,不等於它真的體驗到痛苦。這條規則更像是科學不確定情況下的預防性產品治理。
Q5:通過 API 調用 Claude 也受這條規則約束嗎?
是的,Usage Policy 覆蓋 API 開發者、雲服務與授權轉售渠道以及集成 Claude 的應用。正常開發和測試不受影響,建議保留紅隊測試等場景的目的記錄。通過 API易 apiyi.com 調用 Claude 時,同樣應遵守模型廠商的使用政策。
Q6:想自己測試 Claude 的對話邊界,該怎麼做?
建議在合規前提下設計有明確目的的測試用例,並與其他模型做橫向對比。可以在 API易 apiyi.com 註冊獲取免費額度,用本文代碼把 base_url 設爲 `https://api.apiyi.com/v1` 快速驗證,一個 Key 即可調用多家模型。
Anthropic 禁止辱罵 Claude 核心要點 Key Takeaways
- 新規時間線:10 月 8 日公佈,11 月 12 日生效,目前尚未正式執行
- 禁止邊界:只針對持續、無必要、殘酷的極端行爲,正常批評不受限
- 執行方式:以 Claude 結束當前對話爲主,不等於賬戶封禁
- 研究背景:源於 2025 年模型福祉研究與對話終止功能,並非一時興起
- 系統性更新:同期還收緊了選舉、武器、監控、高風險應用等條款
- 理性看待:規則不代表 Claude 有意識,警惕假封號截圖和誤用數據
- 開發者上手:可通過 API易 apiyi.com 統一接入 Claude 等模型進行合規測試
總結
Anthropic 禁止辱罵 Claude 這件事,核心要點可以歸納爲三句話:
- 規則很窄:只打擊極端、持續、無目的的惡意互動,絕大多數用戶不受影響。
- 處罰很輕:主要手段是結束當前對話,用戶仍可新開聊天並提交反饋。
- 意義很大:這是 AI 公司首次把針對模型本身的保護條款寫進用戶政策,背後是模型福祉研究的長期探索。
它不是 Anthropic 宣佈 Claude 有了感情,而是在科學尚無定論時進行的一次預防性產品治理實驗。未來的 AI 助手究竟只是可以無限命令的工具,還是需要某些交互邊界的新型智能系統?這個問題目前沒有標準答案,值得每一位 AI 用戶和開發者持續關注。
對開發者而言,最務實的做法是讀懂政策邊界、規範產品設計,並保留多模型切換能力。推薦通過 API易 apiyi.com 快速驗證 Claude 及其他主流模型在你業務場景下的表現。
📚 參考資料
- Anthropic 2026 Usage Policy update:新規原始公告,含生效日期與執行方式
- 鏈接:
anthropic.com/news/2026-usage-policy-update -
說明: 本次事件最核心的一手來源
-
Anthropic Usage Policy:完整使用政策
- 鏈接:
anthropic.com/legal/aup -
說明: 覈實適用範圍與平臺執法權限
-
Claude Opus 4 and 4.1 can now end a rare subset of conversations:對話終止功能說明
- 鏈接:
anthropic.com/research/end-subset-conversations -
說明: 瞭解結束對話機制的使用條件
-
Exploring model welfare:模型福祉研究公告
- 鏈接:
anthropic.com/research/exploring-model-welfare -
說明: 理解政策背後的研究背景
-
Claude’s Constitution:新版 Claude 憲章
- 鏈接:
anthropic.com/constitution -
說明: 瞭解 Anthropic 塑造模型行爲的原則
-
TechCrunch 報道:政策更新全景解讀
- 鏈接:
techcrunch.com/2026/10/08/anthropic-changes-usage-policy-to-ban-model-abuse-and-election-interference -
說明: 說明本次更新涉及選舉、武器、監控等多個領域
-
BleepingComputer 事實覈查:Claude 封號截圖造假事件
- 鏈接:
bleepingcomputer.com/news/artificial-intelligence/anthropic-viral-claude-banned-and-reported-to-authorities-message-isnt-real - 說明: 辨別網絡虛假封號信息
作者:APIYI 技術團隊
技術交流:歡迎訪問 API易 apiyi.com 首頁聯繫我們,更多接入資料可查閱 docs.apiyi.com 文檔中心