
作者注:解讀 OpenAI Signals v3.0 公開的 165 類工作活動 ChatGPT 使用數據,釐清統計口徑,並分析它對開發者和企業 AI 應用的參考價值。
2026 年 10 月 26 日,OpenAI 經濟研究團隊發佈了《ChatGPT’s expanding world of work》(中文官方標題《ChatGPT 不斷拓展的工作版圖》),公開了覆蓋近 100 個國家和地區、165 類工作活動、連續 7 個季度的 ChatGPT 使用數據。這批數據屬於 OpenAI Signals v3.0 計劃,以 CC BY 4.0 許可免費開放下載,研究者可以直接拿 CSV 做二次分析。
這不是一次新模型或新功能發佈,而是一套面向研究人員的經濟使用數據。官方公告、數據字典和第三方媒體對原始 CSV 的核查已經同時出現,數字口徑可以相互印證。本文會把官方結論和第三方計算明確區分開,避免把“消息佔比”誤讀成“崗位替代”。
核心價值:幾分鐘看懂 OpenAI 165 類工作活動數據到底統計了什麼、發現了什麼,以及它對 AI 應用開發者有哪些實際參考意義。
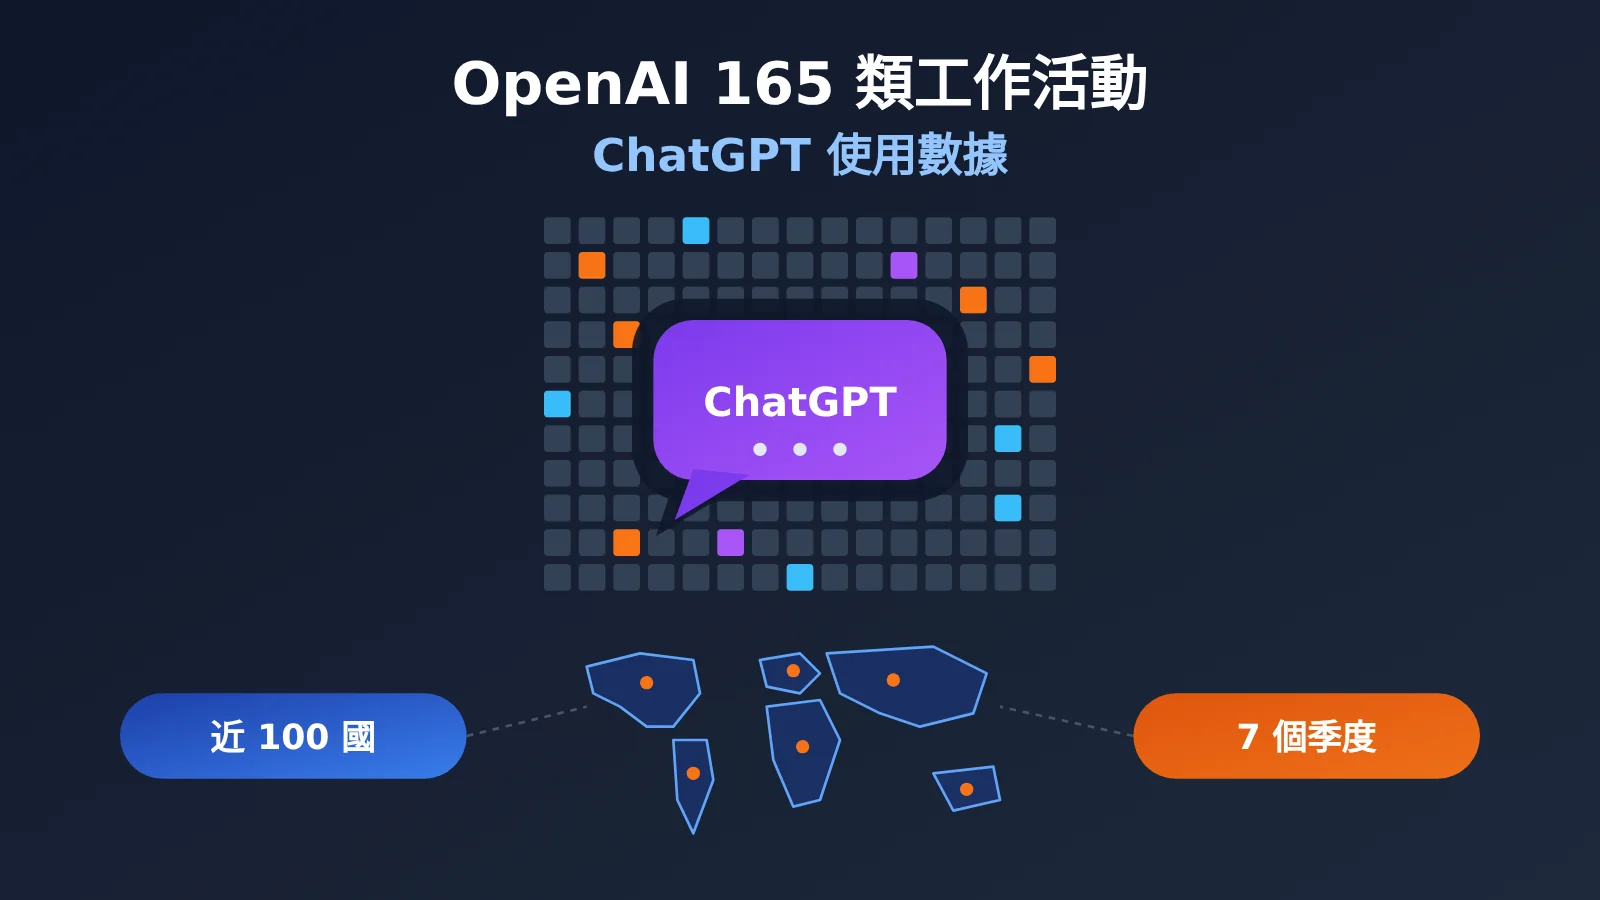
OpenAI 165 類工作活動數據核心信息速覽
先用一張表把這次 ChatGPT 使用數據發佈的基本事實說清楚:
| 信息項 | 詳情 |
|---|---|
| 發佈時間 | 2026 年 10 月 26 日 |
| 發佈方 | OpenAI 經濟研究團隊(OpenAI Signals v3.0) |
| 分類體系 | 美國 O*NET 中間層級工作活動(IWA) |
| 覆蓋範圍 | 近 100 個國家和地區,165 類工作活動 |
| 時間跨度 | 2025 年第一季度至 2026 年第三季度,共 7 個季度 |
| 樣本來源 | Free、Go、Plus、Pro 個人賬戶,聲明年齡 18 歲以上 |
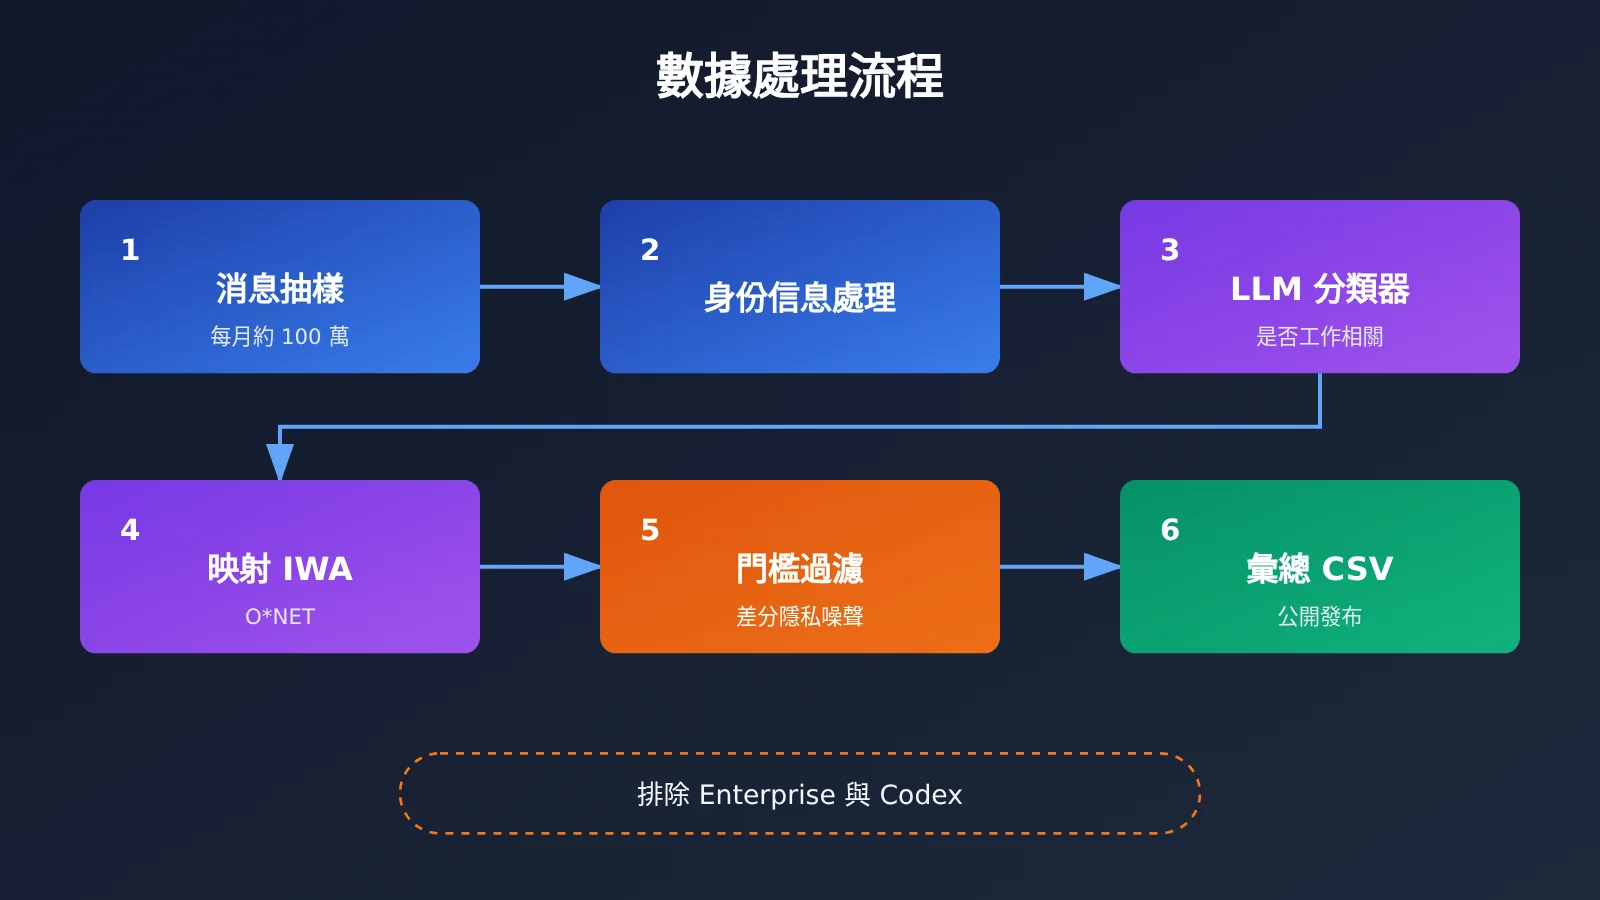
| 排除範圍 | ChatGPT Enterprise、Codex、已刪除賬戶、不允許用於訓練的樣本 |
| 數據授權 | CC BY 4.0,免費查看與 CSV 下載,需署名 |
165 類工作活動不是 165 種職業
這是解讀 OpenAI 這份數據時最容易出錯的地方。O*NET 是美國官方支持的職業信息數據庫,它把“職業”拆成多層“工作活動”。比如“編輯書面材料”這一活動,既出現在編輯的工作裏,也出現在教師、律師、工程師和財務人員的日常中。
因此 OpenAI 統計的是“人們用 ChatGPT 做什麼事”,而不是“哪些職業的人在用 ChatGPT”。IWA(Intermediate Work Activities,中間層級工作活動)介於寬泛的工作行爲和非常具體的任務之間,O*NET 參考體系裏共有 332 個 IWA 條目。
OpenAI 只單獨報告了其中常見且滿足樣本門檻的活動,低頻活動被合併。據 PPC Land 對原始 CSV 的核查,公開表實際是 164 個具名類別加 1 個“Other IWA”合併類別,合計 165 個分類結果。所以不能說 OpenAI 完整統計了全部 332 類 IWA。
數據是怎麼收集和分類的
Signals v3.0 每月抽樣約 100 萬條 ChatGPT 消息,整體覆蓋 2024 年 7 月至 2026 年 9 月共 27 個月,合計約 2700 萬條分類樣本。需要注意,2700 萬是各月樣本數之和,既不等於獨立用戶數,也不代表全部都是工作消息。
分類由自動化的語言模型分類器完成:先判斷消息是否與工作相關,再映射到 O*NET 工作活動,同時標註主題、意圖、時間和地區等維度。隱私方面,OpenAI 表示研究人員不直接閱讀原始聊天,分類前處理身份信息,只發布彙總結果,並對小樣本做隱藏、加入差分隱私噪聲。國家季度工作活動分佈要求有效消息至少 1000 條才發佈。
ChatGPT 使用數據最核心的發現:工作用途更分散
OpenAI 官方給出的頭條結論是:個人用戶用 ChatGPT 處理的工作類型正在變得更多樣。在 7 個季度都有完整記錄的 74 個國家和地區中,各國最常見的前十類工作活動,在本國已分類工作消息中的平均佔比明顯下降。
| 時間 | 各國前十類工作活動平均佔比 |
|---|---|
| 2025 年第一季度 | 56.0% |
| 2026 年第三季度 | 51.1% |
| 變化 | -4.9 個百分點 |
這裏有兩個口徑必須講清楚。第一,51.1% 不是某個全球統一前十榜單的佔比,而是先算每個國家自己的前十,再對 74 國取平均,各國的前十項可以不同。第二,佔比下降不等於消息量下降,如果整體使用量在增長,頭部活動的絕對請求數仍可能增加。
換句話說,更多“長尾”工作活動分到了更大的份額。這和 74 國與近 100 國是兩個不同樣本範圍,引用時也不能混用。
哪些具體工作活動最常見
PPC Land 在 2026 年 10 月 27 日基於全部公開 CSV 做了獨立計算,對 74 國分別統計後取平均。以下是 2026 年第三季度最常見的六項具名工作活動(第三方計算,非 OpenAI 公告直接列出):
| 排名 | 工作活動 | 74 國平均消息佔比 |
|---|---|---|
| 1 | 編輯書面材料或文檔 | 15.0% |
| 2 | 創建視覺設計或展示內容 | 7.9% |
| 3 | 開發營銷或推廣材料 | 5.1% |
| 4 | 解釋語言或文化信息 | 4.0% |
| 5 | 準備信息或教學材料 | 3.2% |
| 6 | 編程計算機系統或生產設備 | 3.1% |
編輯文檔依然是最普遍的工作用途,視覺設計已經升到第二位。營銷內容、教學材料和跨語言理解都有明顯需求,而編程雖然重要,但在這份個人賬戶樣本里並不佔最大份額。
視覺設計上升,編程佔比下降
按 PPC Land 的計算,“創建視覺設計或展示內容”的 74 國平均佔比從 2025 年第一季度的 3.1% 升到 2026 年第三季度的 7.9%,增加 4.8 個百分點,是 165 個類別中增幅最大的具體活動。美國同期從 2.4% 升到 7.6%,2026 年第三季度巴西達到 11.2%、印度 8.7%。
相反,“編程計算機系統或生產設備”從 7.8% 降到 3.1%,美國從 6.7% 降到 2.4%,印度在 2026 年第三季度仍有 5.8%。解決計算機問題、研究技術設計等相關活動也同步下降。一種合理假設是開發者轉向了 Codex 等專門編程代理,但數據本身並沒有證明這種遷移,更穩妥的表述是:在這份排除 Codex 與企業賬戶的數據中,編程類工作消息的佔比明顯下降。
營銷是另一個值得關注的信號。“製作營銷或推廣材料”的平均佔比從 5.2% 到 5.1%,幾乎持平,阿根廷、巴基斯坦、尼日利亞等國在 2026 年第三季度達到 9% 左右。這說明通用寫作佔比雖在下降,專門的營銷內容需求依然穩定。
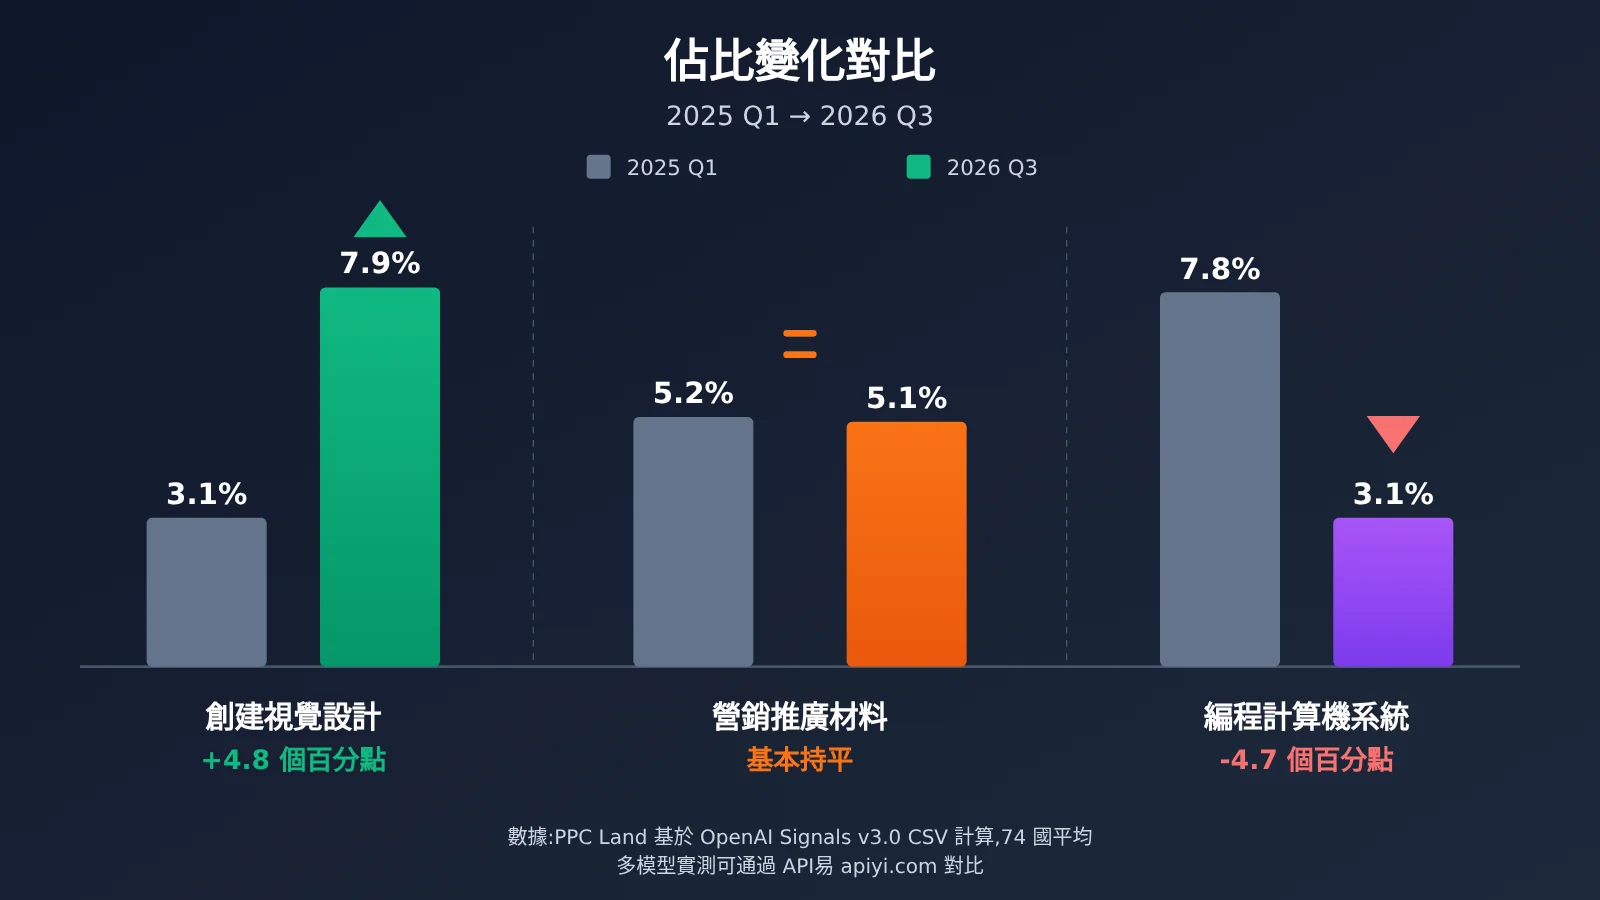
📊 圖表說明:上圖數據來自 PPC Land 對 OpenAI 公開 CSV 的二次計算。如果你想在自己的業務裏驗證“設計類、文案類、編程類”請求分別適合哪個模型,可以通過 API易 apiyi.com 用同一個 API Key 切換 OpenAI、Claude、Gemini 等模型做小規模對比。
美國和德國的 ChatGPT 工作結構對比
PPC Land 還逐項讀取了 OpenAI 交互圖表中更寬泛的 Generalized Work Activities(注意與上面的 IWA 不是同一層級,不能混排)。統計口徑爲各國工作相關消息的佔比:
| 寬泛工作活動 | 美國 Q1 2025 | 美國 Q1 2026 | 德國 Q1 2025 | 德國 Q1 2026 |
|---|---|---|---|---|
| 作出決策與解決問題 | 22.8% | 21.6% | 22.0% | 19.4% |
| 創造性思考 | 11.8% | 15.6% | 11.3% | 13.1% |
| 記錄信息 | 10.6% | 11.8% | 10.3% | 11.4% |
| 使用計算機 | 11.7% | 6.7% | 12.7% | 8.4% |
| 提供諮詢與建議 | 5.5% | 9.0% | 7.1% | 11.7% |
| 爲他人解釋信息 | 5.1% | 4.0% | 9.5% | 8.6% |
兩國都顯示“決策與解決問題”是重要用途,“創造性思考”和“諮詢建議”的佔比明顯上升。這描述的是用戶請求類型,並不代表 ChatGPT 已經獨立做出商業決策,也不等於提供了經過驗證的專家級諮詢。
在國家之間,PPC Land 讀取的跨國分佈差異指標(總變差距離)從約 22.2% 微升到約 23.0%。OpenAI 也承認,這種差異可能來自工作結構、語言文化、工具可用性和使用習慣,本次數據不足以證明因果關係。
165 類工作活動數據對開發者的影響分析
對 AI 應用開發者的影響
- 需求在變寬:用戶不再只拿 ChatGPT 改文檔,視覺設計、營銷、教學材料、諮詢建議都有可觀份額,單一功能的 AI 工具需要考慮多任務場景。
- 多模態更重要:視覺設計是增幅最大的活動,同期全部個人消息中“多媒體”主題也從 2.0% 升到 8.8%(PPC Land 計算),圖像能力值得納入產品規劃。
- 編程場景走向專用化:通用聊天裏的編程消息佔比下降,提示開發類需求可能更多發生在專用代理或企業環境中,適合用專門的代碼模型和工作流承接。
- 可複用分類方法:OpenAI 用 LLM 分類器把消息映射到標準任務體系,這套思路同樣可以用在你自己的產品日誌分析上。
對企業 AI 落地的影響
個人賬戶數據不能代表企業使用。OpenAI 另一項 Enterprise Signals 數據顯示,截至 2026 年 6 月,在所分析企業客戶中 Codex 貢獻了 ChatGPT 與 Codex 合計輸出 Token 的 64%。這說明企業側的使用結構可能與個人賬戶差異很大,評估內部 AI 方案時應基於自己的任務日誌,而不是直接套用 Signals 的個人數據。
🚀 快速開始:如果想像 OpenAI 一樣給自家業務請求打上“工作活動”標籤,推薦通過 API易 apiyi.com 快速搭建原型。平臺提供 OpenAI 兼容接口,新用戶有免費測試額度,幾分鐘即可跑通下面的示例。
用 API 復現“工作活動分類”思路
下面是一個極簡示例,用大模型把一條用戶請求歸類到少量工作活動標籤,原理與 OpenAI 的分類器一致(標籤爲簡化示意,並非 O*NET 完整體系):
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

labels = "編輯文檔, 視覺設計, 營銷推廣, 語言解釋, 教學材料, 編程, 決策分析, 其他"
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": f"從[{labels}]中選一個標籤描述這條工作請求,只輸出標籤:幫我寫一份新品發佈的公衆號推文"}]
)
print(resp.choices[0].message.content)
查看批量分類與佔比統計的完整代碼
import openai
from collections import Counter
from typing import List

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一個 Key 可切換多家模型
)

LABELS = ["編輯文檔", "視覺設計", "營銷推廣", "語言解釋",
          "教學材料", "編程", "決策分析", "非工作", "其他"]

SYSTEM = (
    "你是工作活動分類器。先判斷請求是否與工作相關,"
    f"再從以下標籤中選擇一個:{', '.join(LABELS)}。只輸出標籤本身。"
)

def classify(text: str, model: str = "gpt-4o-mini") -> str:
    try:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": SYSTEM},
                      {"role": "user", "content": text}],
            temperature=0,
            max_tokens=10,
        )
        label = r.choices[0].message.content.strip()
        return label if label in LABELS else "其他"
    except Exception as e:
        print(f"Error: {e}")
        return "其他"

def activity_share(messages: List[str]) -> dict:
    counts = Counter(classify(m) for m in messages)
    work = {k: v for k, v in counts.items() if k != "非工作"}
    total = sum(work.values()) or 1
    return {k: round(v / total * 100, 1) for k, v in work.most_common()}

if __name__ == "__main__":
    logs = [
        "幫我潤色這份季度彙報",
        "設計一組活動海報的構圖建議",
        "這段 Python 爲什麼讀不到數據",
        "週末去哪裏露營比較好",
    ]
    print(activity_share(logs))
和 OpenAI 的方法一樣,這種自動分類會有誤判,一項任務也可能拆成多條消息,所以統計出的“消息佔比”不能直接等同於工作量或業務價值。
不同工作活動的模型選型參考
結合數據中佔比較高的活動,可以按任務類型做初步選型,具體效果仍需在自己的數據上實測:
| 工作活動 | 能力側重 | 選型思路 | 可用平臺 |
|---|---|---|---|
| 編輯書面材料 | 文本理解與改寫 | 性價比較高的通用對話模型 | API易 apiyi.com、官方 API |
| 視覺設計與展示 | 圖像生成與理解 | 多模態 / 圖像模型 | API易 apiyi.com、官方 API |
| 營銷推廣材料 | 創意與風格控制 | 寫作風格穩定的旗艦模型 | API易 apiyi.com、官方 API |
| 編程與排錯 | 代碼推理 | 代碼能力強的模型或專用代理 | API易 apiyi.com、官方 API |
| 決策與諮詢 | 長上下文推理 | 推理型模型,配合人工複覈 | API易 apiyi.com、官方 API |
OpenAI 165 類工作活動數據的侷限
這份數據很有價值,但邊界同樣清晰。以下幾點是引用時最需要注意的:
- 樣本只含成人個人賬戶:排除 Enterprise 和 Codex,不能代表 OpenAI 企業產品的全部工作應用。
- 分類是自動完成的:LLM 分類器可能誤讀意圖,比如“設計活動宣傳方案”可能是真實營銷工作,也可能是個人興趣。
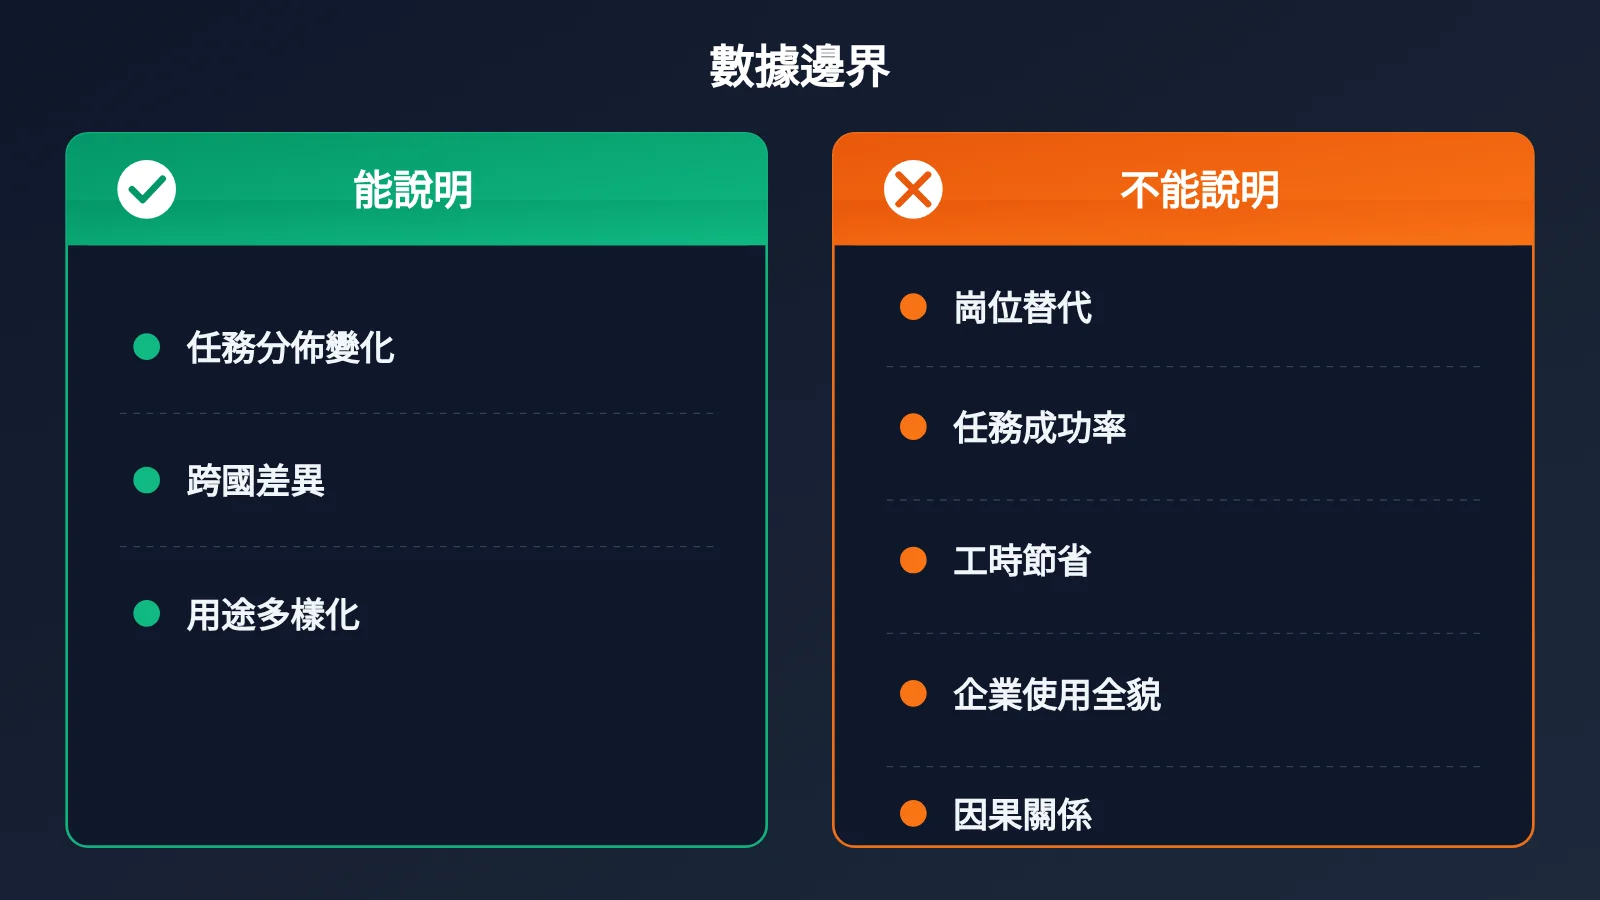
- 消息佔比不等於產出:它不代表任務數量、工作時長、使用人數、節省工時或成功率。
- 存在隱私噪聲和樣本門檻:小樣本結果被隱藏,並加入了差分隱私噪聲。
- 與真實經濟並非一一對應:按就業人數加權,美國約 43% 的現實工作活動落在“Other IWA”類別中,這既不代表 43% 的工作無法被 AI 完成,也不代表其餘 57% 已被 ChatGPT 覆蓋。
此外,PPC Land 的計算顯示,全部個人消息中被標爲工作相關的比例從 2024 年 7 月約 51.6% 降到 2026 年 9 月約 32.2%。這更可能與非工作用戶大量加入、部分專業工作轉向企業賬戶和專門 Agent 有關,不能據此判斷 ChatGPT 對職場變得不重要。
常見問題 FAQ
Q1:OpenAI 發佈的 165 類工作活動數據是什麼?
這是 OpenAI Signals v3.0 計劃公開的一套匯總數據,把個人 ChatGPT 用戶的工作相關消息映射到 O*NET 的 165 類中間層級工作活動,覆蓋近 100 個國家和地區、2025 年第一季度至 2026 年第三季度共 7 個季度,可免費下載 CSV。
Q2:165 類工作活動和 165 種職業有什麼區別?
工作活動是“做什麼事”,職業是“什麼崗位”。同一項活動(如編輯文檔)可以出現在多個職業裏,所以這份數據描述的是 ChatGPT 被用來完成哪些類型的工作,而不是各職業的使用率,更不能推斷哪些職業會被替代。
Q3:這份數據何時發佈,後續會更新嗎?
OpenAI 於 2026 年 10 月 26 日發佈,數據截至 2026 年第三季度。官方以季度爲單位追蹤變化,後續是否持續更新以 OpenAI Signals 數據頁面的公告爲準,本文不做推測。
Q4:編程類消息佔比下降,是不是說明 AI 編程需求在萎縮?
不能這麼下結論。這份數據排除了 Codex 和企業賬戶,而 Enterprise Signals 顯示企業側 Codex 的輸出 Token 佔比很高。編程需求可能轉移到了專用代理,也可能與用戶結構變化有關,數據本身無法區分。
Q5:如何用 API 復現類似的工作活動分類分析?
可以參考本文的示例代碼,用大模型對你自己的用戶請求打標籤,再統計佔比:
1. 訪問 API易 apiyi.com 註冊賬號並獲取 API Key
2. 領取新用戶免費測試額度
3. 將代碼中的 base_url 設爲 `https://api.apiyi.com/v1`,即可切換不同模型對比分類效果
Q6:想對比不同模型在設計、文案、編程任務上的表現,有簡便方法嗎?
最省事的做法是用統一接口調用多家模型,同一批提示詞跑一遍再人工評估。通過 API易 apiyi.com 一個 Key 就能調用 OpenAI、Claude、Gemini 等模型,按量計費,適合做這類小規模對比實驗。
OpenAI 165 類工作活動數據 Key Takeaways
- 統計對象是活動而非職業:165 類指 O*NET 工作活動,含 1 個“其他”合併類別。
- 用途更分散:74 國前十活動平均佔比從 56.0% 降至 51.1%。
- 視覺設計增幅最大:第三方計算顯示從 3.1% 升至 7.9%。
- 編程佔比下降但需謹慎解讀:樣本排除了 Codex 與企業賬戶。
- 營銷需求穩定:營銷推廣材料佔比基本維持在 5% 左右。
- 消息佔比不等於產出:不能推出崗位替代、工時節省或成功率。
- 分類方法可複用:藉助 API易 apiyi.com 多模型接口可快速搭建自己的任務分類分析。
總結
OpenAI 165 類工作活動 ChatGPT 使用數據的核心信息:
- 數據性質:一套免費開放、按季度追蹤的研究數據,統計的是個人賬戶中“用 ChatGPT 做什麼工作活動”。
- 主要發現:工作用途正在變得更分散,視覺設計、諮詢建議和創造性思考上升,通用編程消息佔比下降。
- 解讀邊界:數據不含企業賬戶和 Codex,消息佔比不能等同於工作量、崗位影響或經濟價值。
這份數據真正揭示的,不是哪 165 種職業即將消失,而是 AI 正以更細緻、更多樣的方式進入不同工作流程,並且因國家和任務類型而有所不同。對開發者來說,與其追問“AI 會替代誰”,不如看清用戶實際在用 AI 完成哪些活動,再爲這些活動選對模型和工作流。
推薦通過 API易 apiyi.com 快速驗證不同模型在你業務場景中的表現,平臺提供免費測試額度和多模型統一接口。
📚 參考資料
- OpenAI 官方公告:ChatGPT’s expanding world of work:本次發佈的核心出處
- 鏈接:
openai.com/index/chatgpt-expanding-world-of-work -
說明:165 類活動、近 100 國、56.0% 到 51.1% 等官方結論
-
OpenAI Signals 數據下載與方法說明:原始 CSV 與數據字典入口
- 鏈接:
openai.com/signals/data-download -
說明:樣本範圍、隱私處理與 CC BY 4.0 授權說明
-
PPC Land:Writing drops from 34% to 21% of ChatGPT requests since July 2024:第三方 CSV 分析
- 鏈接:
ppc.land/writing-drops-from-34-to-21-of-chatgpt-requests-since-july-2024 -
說明:具體活動排名、視覺設計與編程佔比變化
-
PPC Land:Americans use ChatGPT at work most to make decisions:美德交互圖表讀取
- 鏈接:
ppc.land/americans-use-chatgpt-at-work-most-to-make-decisions-1-in-5-requests -
說明:寬泛工作活動的國家對比數據
-
O*NET 官方網站:工作活動與職業分類體系
- 鏈接:
onetcenter.org -
說明:理解 IWA 定義與 332 個參考條目
-
OpenAI Enterprise Signals:企業賬戶使用數據
- 鏈接:
openai.com/signals/enterprise-data - 說明:用於區分個人與企業數據口徑
作者:APIYI 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心




