作者注:用 curl 和 SDK 計時拆解 DNS、TLS、首 token 與整體耗時,4 步判斷國內調用大模型 API 的瓶頸出在“跨境鏈路”還是“模型推理”。
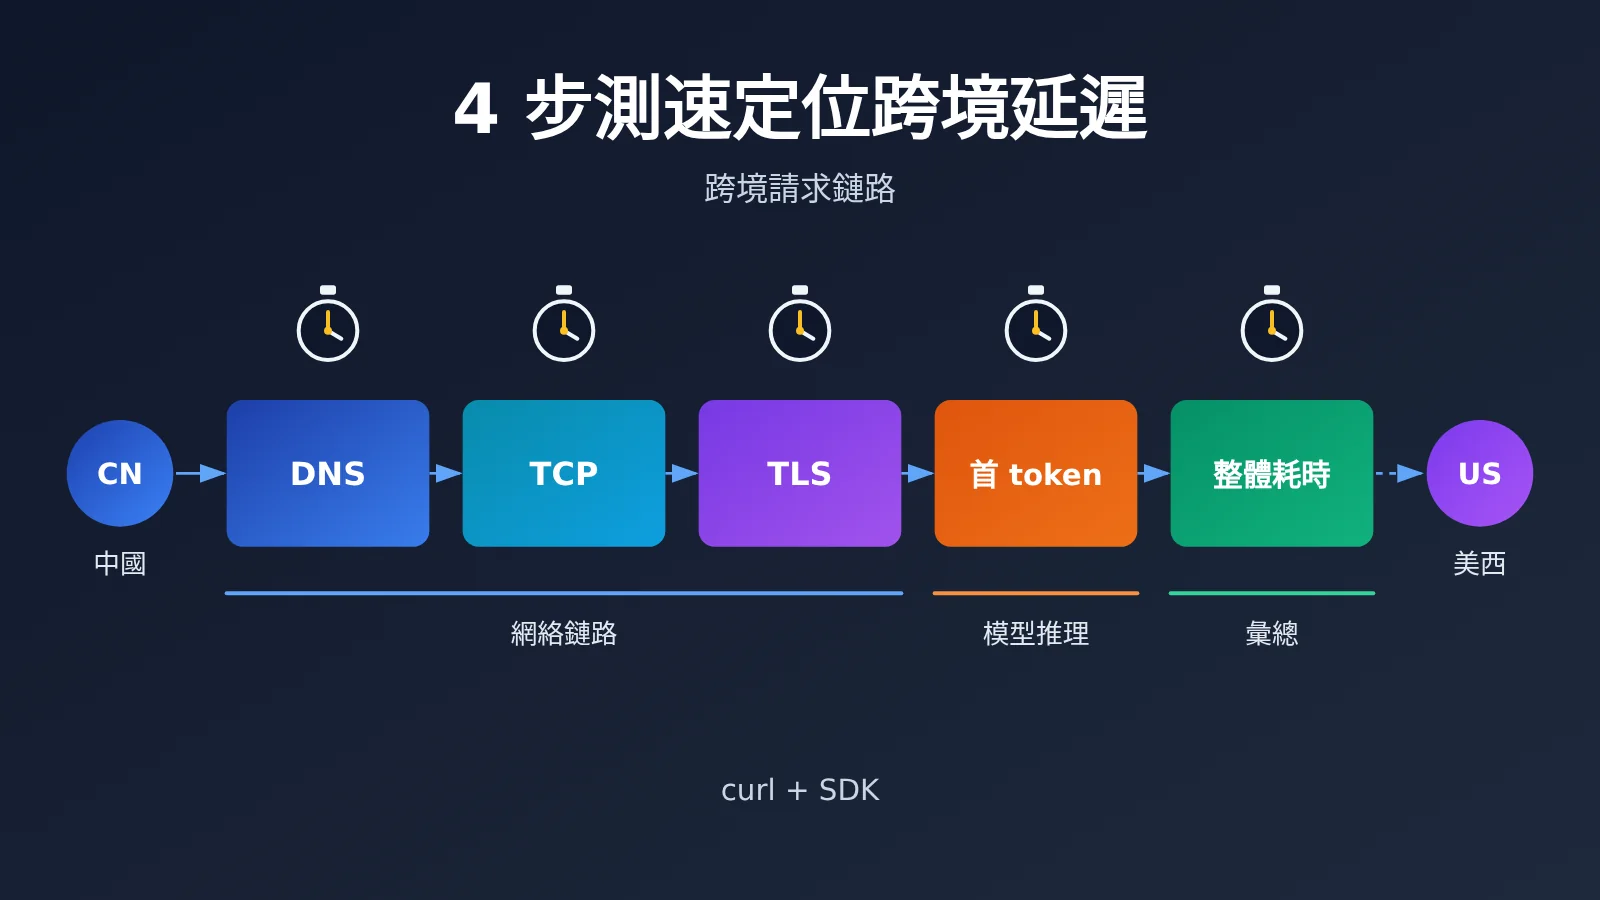
“接口怎麼這麼慢?”這是國內開發者接入大模型 API 時最常說的一句話。問題在於,“慢”只是表面現象,它可能來自 DNS 解析、跨境 TLS 握手、模型排隊,也可能只是模型本身在認真思考。本文將介紹一套 4 步測速定位法,幫你把一次請求的耗時拆開來看,準確判斷國內調用大模型 API 慢的根源。
這不是一篇“換個節點試試”的玄學指南,而是基於真實接入諮詢整理的可復現排查流程。我們常被問到:業務部署在美國服務器上,接入地址該怎麼填?國內訪問會不會因爲跨境而卡頓?圖片、視頻這類大結果能不能完整回傳?下文會逐一給出答案。
核心價值:讀完本文,你將學會用 curl 和 Python SDK 分段計時,區分網絡鏈路和模型推理的耗時,並根據部署區域選對 base_url。
國內調用大模型 API 慢的核心要點
在動手測速之前,先建立一個基本認知:一次大模型 API 調用的總耗時,是“網絡耗時”和“模型耗時”疊加的結果。跨境延遲隻影響前者,而很多人感覺到的“慢”,其實大部分來自後者。
| 步驟 | 測什麼 | 工具 | 能回答的問題 |
|---|---|---|---|
| 第 1 步 | DNS、TCP、TLS 建連耗時 | curl -w 參數 |
跨境鏈路本身是否通暢 |
| 第 2 步 | 首 token 延遲(TTFT) | SDK 流式調用 | 模型開始響應要等多久 |
| 第 3 步 | 整體耗時與吞吐 | SDK 非流式 + 多輪統計 | 長輸出、大響應體回傳是否穩定 |
| 第 4 步 | 對照診斷 | 診斷矩陣 | 瓶頸在網絡、模型還是代碼 |
跨境延遲由哪幾段構成
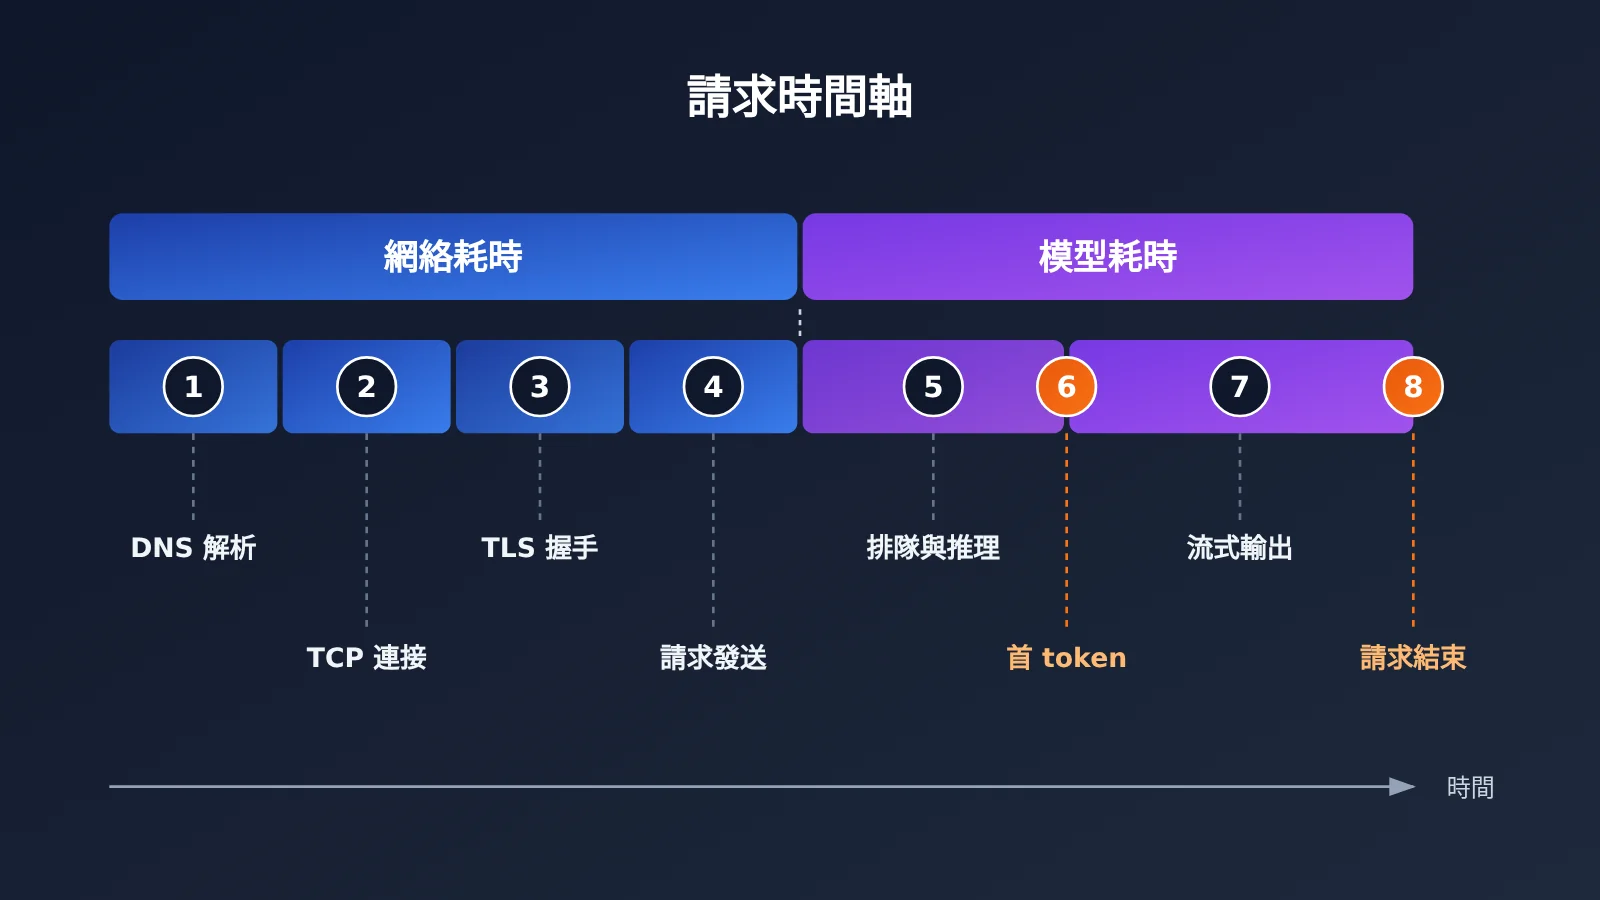
一個 HTTPS 請求從你的服務器發出,要依次經歷 DNS 解析、TCP 三次握手、TLS 握手,然後才發送請求體。跨境場景下,TCP 和 TLS 握手都需要多次往返,物理距離帶來的往返時延會被放大好幾倍,這就是“建連慢”的來源。好在建連通常只發生在第一次請求,複用連接後這部分成本會大幅下降。
請求到達服務端後,進入模型推理階段。對於對話模型,首 token 出現前的等待取決於模型大小、輸入長度和當前負載;首 token 之後,輸出速度取決於模型的生成速率。圖片和視頻生成則不同,它們往往是同步返回大體積結果,回程鏈路的帶寬與穩定性會直接影響結果能否完整送達。
網絡慢還是模型慢的判斷原則
判斷原則其實很簡單:建連階段慢,看網絡;首 token 慢,看模型和輸入;輸出階段慢且波動大,看回程鏈路和響應體大小。 只要把這三段數字測出來,大多數“慢”的問題都能在幾分鐘內定性。
4 步測速定位跨境延遲快速上手
下面的示例都以 OpenAI 兼容接口爲例。無論你的服務部署在國內還是海外,只需要修改 base_url 即可接入,代碼其他部分保持不變。
第 1 步:用 curl 拆解跨境鏈路建連耗時
curl 自帶的 -w 參數可以輸出每個階段的時間點,是排查跨境延遲最快的工具。建議請求 /v1/models 這類輕量接口,避免模型推理時間干擾網絡測量。
export API_KEY="YOUR_API_KEY"

curl -o /dev/null -s \
  -H "Authorization: Bearer $API_KEY" \
  -w "DNS解析:   %{time_namelookup}s\nTCP連接:   %{time_connect}s\nTLS握手:   %{time_appconnect}s\n首字節:    %{time_starttransfer}s\n總耗時:    %{time_total}s\n" \
  https://api.apiyi.com/v1/models
需要特別注意,curl 輸出的每個值都是從請求開始累計的時間點,而不是單個階段的獨立耗時。各字段的含義和計算方式如下:
| curl 字段 | 含義 | 單段耗時計算 | 偏高時的常見原因 |
|---|---|---|---|
time_namelookup |
DNS 解析完成 | 直接讀取 | 本地 DNS 慢、解析到較遠節點 |
time_connect |
TCP 連接建立 | connect − namelookup | 跨境往返時延高、丟包 |
time_appconnect |
TLS 握手完成 | appconnect − connect | 鏈路抖動、握手多次往返 |
time_starttransfer |
收到首字節 | starttransfer − appconnect | 服務端處理、排隊 |
time_total |
請求結束 | total − starttransfer | 響應體大、回程帶寬不足 |
建議連續執行 5 到 10 次,觀察數值是否穩定。如果 TCP 和 TLS 兩段耗時波動很大,說明鏈路質量不穩定;如果數值穩定且處於可接受範圍,網絡大概率不是主要瓶頸。
第 2 步:用 SDK 流式調用測量首 token 延遲
建連沒問題,下一步就要看模型開始響應的速度。首 token 延遲(Time To First Token,TTFT)是對話類應用體感最強的指標,用戶盯着屏幕等第一個字出現,每一秒都很漫長。
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 國內、海外部署均可使用
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句話介紹你自己"}],
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(f"首 token 延遲: {time.perf_counter() - start:.2f}s")
        break
拿到 TTFT 後,把它和第 1 步的建連耗時相減,剩下的部分基本就是模型排隊與推理的時間。如果這部分佔了絕大頭,那麼優化網絡收效有限,更應該考慮換用更快的模型、縮短輸入上下文或開啓流式輸出。
第 3 步:多輪統計整體耗時與大響應體回傳
單次測量容易受偶發波動影響,生產環境評估應該做多輪統計,並關注中位數和最大值。下面的完整腳本會自動測量 DNS、TCP、TLS、TTFT 和整體耗時,並輸出彙總結果。
查看完整測速腳本
import socket
import ssl
import statistics
import time
from urllib.parse import urlparse

import openai

BASE_URL = "https://api.apiyi.com/v1"  # 統一接入地址
API_KEY = "YOUR_API_KEY"
MODEL = "gpt-4o-mini"
ROUNDS = 5


def measure_handshake(url: str) -> dict:
    """分段測量 DNS、TCP、TLS 耗時"""
    host = urlparse(url).hostname
    t0 = time.perf_counter()
    ip = socket.gethostbyname(host)
    t1 = time.perf_counter()
    sock = socket.create_connection((ip, 443), timeout=10)
    t2 = time.perf_counter()
    ctx = ssl.create_default_context()
    tls = ctx.wrap_socket(sock, server_hostname=host)
    t3 = time.perf_counter()
    tls.close()
    return {"dns": t1 - t0, "tcp": t2 - t1, "tls": t3 - t2}


def measure_llm(client: openai.OpenAI) -> dict:
    """測量首 token 延遲與整體耗時"""
    start = time.perf_counter()
    ttft = None
    chars = 0
    stream = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "寫一段 200 字左右的產品介紹"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            if ttft is None:
                ttft = time.perf_counter() - start
            chars += len(chunk.choices[0].delta.content)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": chars}


def summarize(name: str, values: list) -> None:
    print(f"{name:<8} 中位數 {statistics.median(values):.3f}s  "
          f"最大 {max(values):.3f}s  最小 {min(values):.3f}s")


def main():
    client = openai.OpenAI(api_key=API_KEY, base_url=BASE_URL, timeout=120)
    records = {"dns": [], "tcp": [], "tls": [], "ttft": [], "total": []}

    for i in range(ROUNDS):
        hs = measure_handshake(BASE_URL)
        llm = measure_llm(client)
        for k in ("dns", "tcp", "tls"):
            records[k].append(hs[k])
        records["ttft"].append(llm["ttft"])
        records["total"].append(llm["total"])
        print(f"第 {i + 1} 輪完成,輸出 {llm['chars']} 字")

    print("\n===== 測速彙總 =====")
    for k, v in records.items():
        summarize(k.upper(), v)


if __name__ == "__main__":
    main()
對於圖片接口,需要額外關注一點:圖片生成通常是同步調用,最終返回的響應體比文本大得多。如果整體耗時遠大於首字節時間,或者偶發連接中斷,問題往往出在回程鏈路上,而不是模型生成慢。這時應適當調大客戶端超時時間,並對中斷做冪等重試。
第 4 步:對照診斷矩陣判斷瓶頸
拿到前三步的數據後,用下面的矩陣對號入座,基本就能定位問題。
| 現象 | 最可能的瓶頸 | 優先處理方式 |
|---|---|---|
| DNS 階段明顯偏高 | 本地 DNS 解析 | 更換穩定的 DNS 服務、啓用解析緩存 |
| TCP、TLS 偏高且波動大 | 跨境鏈路質量 | 複用連接、選擇有線路優化的接入服務 |
| 建連正常、TTFT 很高 | 模型推理或輸入過長 | 換更快模型、精簡上下文、開啓流式 |
| TTFT 正常、整體耗時長 | 輸出過長或生成速率低 | 限制 max_tokens、拆分任務 |
| 圖片視頻偶發中斷 | 大響應體回傳不穩 | 調大超時、冪等重試、異步輪詢 |
| 首次慢、後續快 | 冷啓動建連 | 使用長連接、全局複用 client |
🚀 快速開始:如果你想馬上跑一遍上面的測速腳本,推薦先在 API易 apiyi.com 註冊獲取 API Key,新用戶有免費測試額度,足夠完成多輪測速對比,不需要額外部署任何代理。
不同部署區域如何選擇 base_url
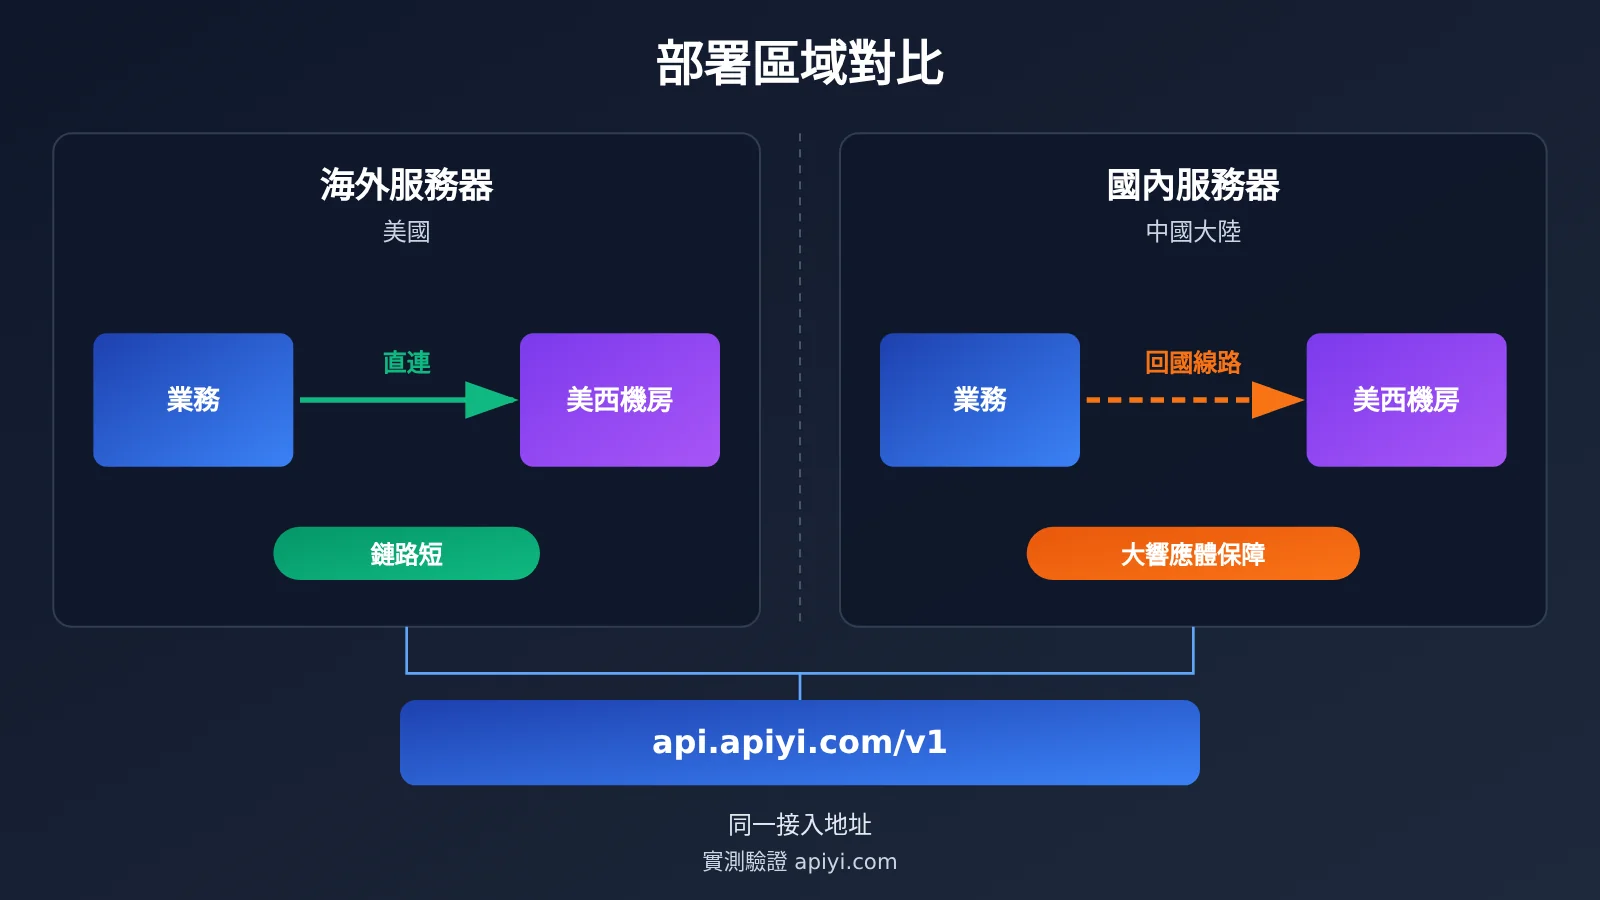
很多開發者會糾結:業務部署在海外和部署在國內,是否需要填寫不同的接入地址?答案是不需要。API易 的服務器本身位於美西,海外服務直接訪問鏈路天然較短;同時平臺爲國內訪問做了回國線路加速,重點保障圖片、視頻這類大響應體業務的回傳穩定性。因此無論部署在哪裏,統一使用同一個 base_url 即可。
| 部署位置 | 鏈路特點 | 測速關注重點 | 接入建議 |
|---|---|---|---|
| 美國 / 美西 | 與服務端同區域,往返時延低 | 重點看 TTFT 與模型耗時 | 直接使用統一接入地址 |
| 歐洲 / 亞太海外 | 跨洋但國際鏈路通常穩定 | 關注 TLS 握手與連接複用 | 統一接入地址 + 長連接 |
| 中國大陸 | 跨境鏈路,已有回國線路加速 | 關注建連波動和大響應體回傳 | 統一接入地址 + 合理超時 |
| 混合部署 | 多區域同時調用 | 分區域分別測速對比 | 同一份代碼,無需分支配置 |
這種設計的好處是,同一份代碼可以在測試環境(國內)和生產環境(海外)之間無縫遷移,不用維護多套配置。真正需要做的,是在各自的部署環境裏跑一遍前面的 4 步測速,確認實際表現符合業務預期。
大響應體跨境調用的優化建議
圖片和視頻接口對跨境鏈路最敏感,建議在代碼層面做好以下幾件事:
- 全局複用 client:避免每次請求都重新建連,跨境場景下能省掉大量握手時間。
- 按業務類型設置超時:文本對話可以較短,圖片生成和視頻結果拉取應給足餘量。
- 對中斷做冪等重試:使用指數退避,避免短時間內重複提交生成任務。
- 視頻任務採用異步輪詢:提交任務後定期查詢狀態,結果就緒再下載,降低長連接中斷風險。
- 記錄分段耗時日誌:把 TTFT 和整體耗時寫入監控,出問題時能快速回溯。
常見問題 FAQ
Q1:什麼是跨境延遲,它和模型推理延遲有什麼區別?
跨境延遲是請求在國內與海外服務器之間傳輸產生的網絡耗時,主要體現在 TCP、TLS 建連和數據回傳階段。模型推理延遲則是服務端生成內容所花的時間,體現在首 token 等待和輸出速度上。兩者需要分開測量,才能找準優化方向。
Q2:業務部署在美國服務器上,調用 API易 該填哪個地址?
直接使用 `https://api.apiyi.com/v1` 即可。API易 的服務器位於美西,美國部署的業務訪問鏈路很短,無需額外配置。具體接入步驟可以參考 API易 apiyi.com 文檔中心的快速開始說明,三步就能完成。
Q3:服務器在美西,爲什麼國內訪問也比較流暢?
因爲平臺針對國內訪問做了回國線路加速,主要用於保障圖片、視頻這類大響應體業務的回傳穩定性。你可以用本文第 1 步的 curl 命令在國內服務器上實測,觀察 TCP 和 TLS 階段的耗時與波動情況。
Q4:首 token 延遲很高,是不是網絡有問題?
不一定。先看 curl 測出的建連耗時,如果建連正常,那麼 TTFT 高通常是模型本身較大、輸入上下文過長或推理較複雜導致的。此時可以嘗試換用輕量模型、精簡提示詞,或者開啓流式輸出改善用戶體感。
Q5:如何快速對比不同模型的響應速度?
推薦使用支持多模型的聚合接口進行測試:
1. 在 API易 apiyi.com 註冊賬號並獲取 API Key
2. 使用本文完整測速腳本,只修改 `MODEL` 變量
3. 對每個模型跑相同輪次,比較 TTFT 和整體耗時的中位數
由於一個 Key 即可調用 OpenAI、Claude、Gemini 等多種模型,對比時網絡條件保持一致,結論更可信。
Q6:圖片 API 偶爾連接中斷怎麼排查?
圖片接口是同步調用,響應體較大,中斷多發生在結果回傳階段。建議先調大客戶端超時,再觀察 curl 的 `time_total` 與 `time_starttransfer` 差值。如果差值大且不穩定,說明回程鏈路是瓶頸,可加入冪等重試並避開高峯時段批量提交。
Q7:這套測速方法有哪些侷限?
測速結果只反映測量時刻和測量位置的網絡狀態,不同運營商、不同時段可能差異明顯。另外,模型負載會隨時間變化,單次 TTFT 不能代表長期表現。建議在生產環境長期記錄分段耗時,用趨勢而非單點數據做決策。
國內調用大模型 API 測速核心要點 Key Takeaways
- 先拆分再優化:總耗時等於網絡耗時加模型耗時,必須分段測量。
- curl 測建連:用
-w參數拿到 DNS、TCP、TLS 累計時間點。 - SDK 測 TTFT:流式調用記錄首 token 時間,判斷模型響應速度。
- 多輪看中位數:單次結果易受波動影響,至少統計 5 輪以上。
- 大響應體看回程:圖片視頻關注整體耗時與首字節的差值。
- 統一接入地址:通過 API易 apiyi.com 接入,國內海外共用同一 base_url。
總結
國內調用大模型 API 慢的排查覈心要點:
- 4 步定位法:建連測速、首 token 測速、整體耗時統計、診斷矩陣對照,層層縮小範圍。
- 區分兩類延遲:跨境延遲靠連接複用和線路優化解決,模型延遲靠選型和精簡輸入解決。
- 大響應體單獨關注:圖片、視頻業務要配置合理超時、冪等重試和異步輪詢。
- base_url 無需按區域區分:海外直連美西機房,國內有回國線路加速,一套配置即可。
與其憑感覺判斷“慢”,不如花幾分鐘跑一遍測速腳本,讓數據告訴你瓶頸在哪裏。推薦通過 API易 apiyi.com 獲取免費測試額度,在自己的部署環境中完成實測,再決定模型選型和超時策略。
📚 參考資料
- API易 文檔中心:接入地址與三步接入流程說明
- 鏈接:
docs.apiyi.com -
說明:包含 OpenAI 兼容模式配置、圖片 API 調用須知與連接中斷排查
-
curl 官方手冊:
-w寫出變量完整說明 - 鏈接:
curl.se/docs/manpage.html -
說明:查閱
time_namelookup、time_appconnect等計時字段的權威定義 -
OpenAI Python SDK:官方開源倉庫
- 鏈接:
github.com/openai/openai-python - 說明:流式調用、超時與重試參數的使用方式
作者:APIYI 技術團隊
技術交流:測速過程中遇到問題,歡迎在 API易 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心