“gpt-4o-mini 是不是快要被淘汰了”,是最近技術社區裏反覆出現的問題。這個疑問的直接觸發點是 Azure OpenAI Service 陸續發佈的模型退役公告,再加上 gpt-4o-mini 在各類跑分榜單上的排名持續走低,讓不少團隊開始重新評估自己的模型選型。
本文基於 OpenAI 官方文檔、Microsoft Learn 退役公告和 Artificial Analysis 權威跑分數據,先澄清 gpt-4o-mini 下線傳聞中的信息混淆,再從定價和性能兩個維度,對比 GPT-5 mini、GPT-5 nano、Gemini 2.5 Flash-Lite、DeepSeek V4 Flash、Claude Haiku 4.5 等 5 款價格接近的替代模型,幫助你判斷是否需要遷移,以及遷移到哪個模型收益最大。
核心價值:讀完本文,你將清楚知道 gpt-4o-mini 到底是“部分下線”還是被過度解讀,以及在預算基本不變的前提下,哪款替代模型能帶來更明顯的效果提升。
這類誤解之所以傳播很廣,很大程度上是因爲 Azure 側的退役公告、ChatGPT 網頁端的模型下架,以及社區裏“OpenAI 要淘汰舊模型”的籠統說法被混在一起討論,缺少一個按平臺、按部署類型拆開的清晰版本。下文會把這幾條時間線分開說明,避免你爲了一個還沒真正生效的傳聞倉促遷移,也避免真正緊迫的 Azure 退役日期被忽略。
gpt-4o-mini 現狀:跑分僅7分,下線傳聞是否屬實
先說結論:gpt-4o-mini 的下線傳聞存在明顯的信息混淆,Azure 和 OpenAI 官方 API 是兩套完全不同的時間表,不能一概而論地說“gpt-4o-mini 要下線了”。
gpt-4o-mini 當前定價與性能
| 指標 | 數值 | 說明 |
|---|---|---|
| Input 定價 | $0.15 / 1M tokens | OpenAI 官方 API 價格 |
| Cached Input 定價 | $0.075 / 1M tokens | 命中緩存時價格減半 |
| Output 定價 | $0.60 / 1M tokens | OpenAI 官方 API 價格 |
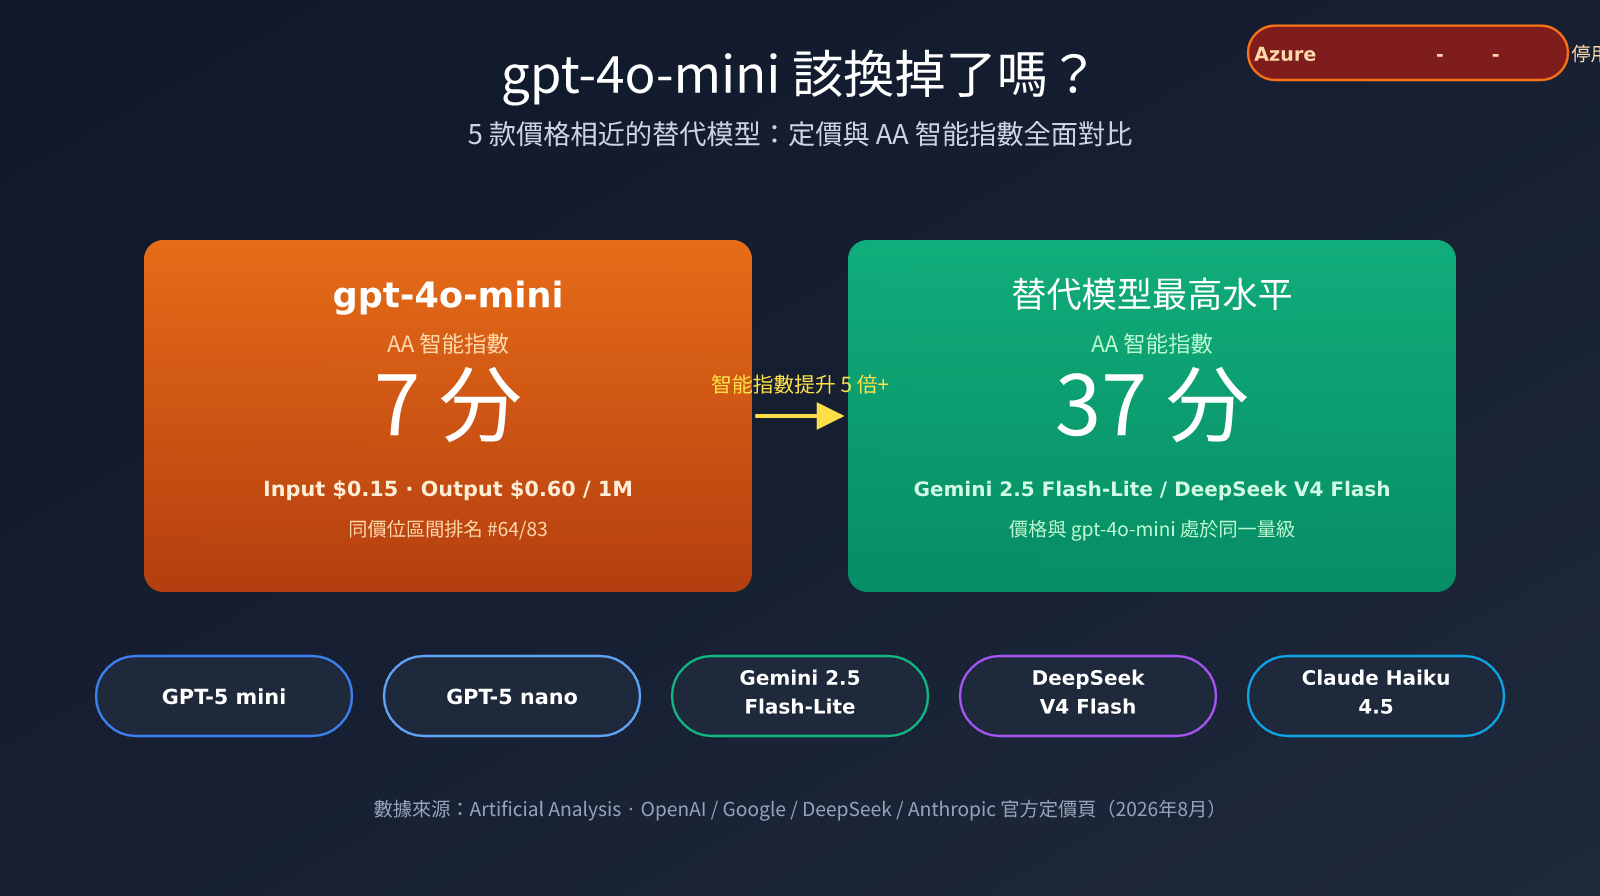
| AA 智能指數 | 7 分 | Artificial Analysis 評測,同價位區間排名 #64/83 |
| 輸出速度 | 100.9 tokens/s | 低於同類模型均值 102.1 tokens/s |
gpt-4o-mini 之所以在 2026 年被頻繁質疑,核心原因並不是價格變了,而是它的 Artificial Analysis 智能指數只有 7 分,在同價位區間的 83 款模型裏排名第 64,明顯低於該價位段的中位數水平。換句話說,gpt-4o-mini 依舊便宜,但“便宜”已經不再等於“高性價比”——同樣的預算,現在能買到聰明得多的模型。
這裏補充說明一下 AA 智能指數的參考價值:它由 Artificial Analysis 綜合多項公開評測(涵蓋推理、代碼、數學等能力維度)加權計算得出,好處是覆蓋模型廣、更新頻率高,可以在同一把尺子下橫向比較不同廠商的模型;侷限是它反映的是通用能力的平均水平,不能完全替代你在自己業務數據上的實測結果。把它當作篩選候選模型的第一道過濾器,而不是最終的選型依據,會更穩妥。
gpt-4o-mini 下線時間表:Azure 和 OpenAI API 完全不同
| 平臺 / 部署方式 | 狀態 | 退役日期 |
|---|---|---|
| OpenAI 官方 API(gpt-4o-mini 本體) | 未設定退役日期 | 暫無 |
| OpenAI 微調版 ft-gpt-4o-mini | 已公佈計劃 | 訓練截止不早於 2027-04-01,部署截止 2027-10-01 |
| Azure OpenAI Standard 部署 | 已退役 | 2026-03-31 |
| Azure Provisioned / Global Standard / Data Zone Standard | 即將退役 | 2026-10-01 |
需要特別澄清的是,2026 年 2 月 13 日 OpenAI 確實從 ChatGPT 產品界面下線了 GPT-4o、GPT-4.1、GPT-4.1 mini 和 o4-mini,但這是 ChatGPT 網頁端模型選擇器的調整,官方公告明確說明 API 端沒有變化,而且 gpt-4o-mini 本身也不在這份下線名單裏。真正需要認真對待的是 Azure 側的時間表:Azure OpenAI 的 gpt-4o-mini Standard 部署已經在 2026 年 3 月 31 日退役,Provisioned、Global Standard 和 Data Zone Standard 部署也將在 2026 年 10 月 1 日統一停止服務,距現在只剩不到兩個月,屆時調用會直接返回 410 Gone 錯誤。如果你的業務跑在 Azure 上,這份時間表比“OpenAI 是否下線”更值得優先關注。
另一個容易被忽略的細節是:即便是同一個“gpt-4o-mini”名字,Azure 上不同的部署方式(Standard、Provisioned、Global Standard、Data Zone Standard)退役時間並不統一,混用團隊很容易因爲只查了其中一種部署的公告,就誤判整體的下線節奏。建議在排查這件事之前,先在 Azure 門戶裏確認自己具體用的是哪一種部署,再對照上表逐一覈實退役日期,避免“聽說下線了”和“實際還能用多久”出現偏差。
gpt-4o-mini vs 5 款替代模型:價格與跑分全對比
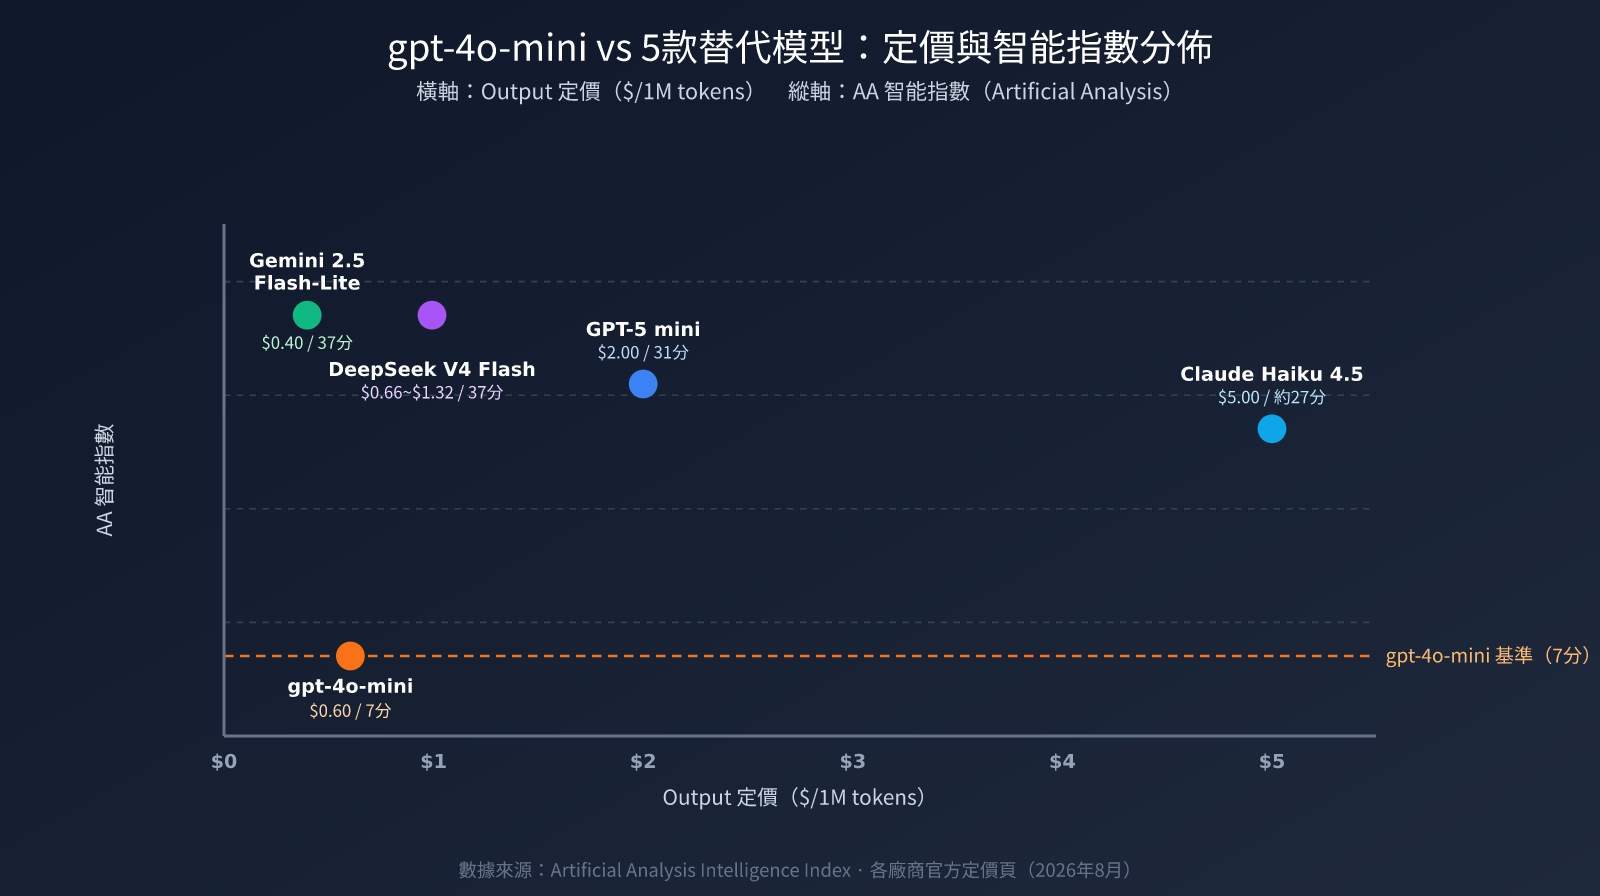
如果你正在評估遷移方案,下面這張對比表彙總了 5 款定價接近 gpt-4o-mini、且有官方或權威三方數據支撐的替代模型,方便你按預算和性能需求快速篩選。
| 模型 | Input / Output($/1M) | AA 智能指數 | 核心優勢 |
|---|---|---|---|
| gpt-4o-mini(基準) | $0.15 / $0.60 | 7 分(#64/83) | 生態成熟,兼容性好 |
| GPT-5 nano | $0.05 / $0.40 | 官方未單獨公佈跑分 | 同系列裏成本最低的選項 |
| GPT-5 mini | $0.25 / $2.00 | 31 分(medium 推理檔位) | OpenAI 生態內最直接的官方平替 |
| Gemini 2.5 Flash-Lite | $0.10 / $0.40 | 37 分 | 價格與 gpt-4o-mini 接近,智能指數提升明顯 |
| DeepSeek V4 Flash | $0.22~$0.44 / $0.66~$1.32(峯谷定價) | 37 分(高推理強度) | 分時段定價,緩存命中最低可到 $0.007/1M |
| Claude Haiku 4.5 | $1.00 / $5.00 | 約 24~30 分(視推理檔位) | 長上下文與工具調用能力更突出 |
🎯 技術建議:在實際選型時,我們建議通過 API易 apiyi.com 平臺對上述模型逐一進行接口測試,該平臺以統一的 API 接口同時支持 gpt-4o-mini、GPT-5 系列、Gemini、DeepSeek 和 Claude 等主流模型調用,便於在同一套代碼裏快速切換和對比效果。
以上 5 款之外,阿里雲 Qwen3.5 Flash 也是一個價格區間接近的選項,第三方比價渠道給出的價格在 $0.10 / $0.40 附近,但由於並非從 DashScope 官方定價頁直接確認,建議在正式遷移前以官方控制檯價格爲準,避免因區域或匯率差異產生誤差。同樣,GPT-5 nano 目前沒有查到官方或 Artificial Analysis 公佈的獨立跑分,這裏如實標註爲“未公佈”,而不是給出一個編造的數字。
整體來看,Gemini 2.5 Flash-Lite 是最值得優先測試的選項:價格只比 gpt-4o-mini 略高一點,AA 智能指數卻從 7 分跳到 37 分,是同價位區間裏性價比提升最明顯的一款。如果你更看重和 OpenAI 生態的兼容性,GPT-5 mini 雖然價格是 gpt-4o-mini 的一倍多,但換來的性能提升同樣顯著;預算極度敏感的場景則可以看看 GPT-5 nano 和 DeepSeek V4 Flash 的非高峯時段定價。
DeepSeek V4 Flash 的定價機制值得單獨說明一下:它採用峯谷兩套價格,非高峯時段的 Input/Output 只要 $0.22/$0.66,高峯時段則漲到 $0.44/$1.32,如果命中緩存還能進一步降到 $0.007~$0.014 每百萬 token。對於可以錯峯跑批的離線任務(比如夜間批量摘要、日誌分析),這套定價往往比固定單價的模型更划算,但如果業務是白天高峯期的實時請求,就需要按高峯價重新覈算成本。Claude Haiku 4.5 則走的是另一條路線:單價明顯高於 gpt-4o-mini,但換來了更強的長上下文穩定性和工具調用能力,更適合需要處理長文檔、多輪工具編排的場景,而不是單純的短問答替換。
場景推薦:不同需求該選哪個模型
| 應用場景 | 推薦模型 | 理由 |
|---|---|---|
| 高併發客服 / FAQ 機器人 | Gemini 2.5 Flash-Lite | 價格與 gpt-4o-mini 持平,智能指數提升 5 倍以上 |
| 複雜推理 / 多步驟 Agent 任務 | GPT-5 mini | 與 OpenAI 生態兼容性最好,推理能力明顯優於 gpt-4o-mini |
| 超低成本批量處理(內容打標、摘要) | GPT-5 nano / DeepSeek V4 Flash 非高峯時段 | 單價可低至 gpt-4o-mini 的三分之一左右 |
| 長文檔 / 長上下文分析 | Claude Haiku 4.5 | 長上下文穩定性和工具調用能力更突出 |
| 預算極度敏感的原型驗證 | DeepSeek V4 Flash 緩存命中場景 | 緩存命中價格可壓到極低水平 |
💡 選擇建議:選擇哪個模型主要取決於你的具體應用場景和質量要求。我們建議通過 API易 apiyi.com 平臺進行實際測試,在同一套預算下對比不同模型在你真實業務數據上的表現差異,而不是隻參考公開跑分做決策。
需要注意的是,上表給出的是“默認推薦”,實際選型還要結合上下文長度、併發量和延遲要求做調整。例如同樣是客服場景,如果對話歷史很長、需要頻繁引用之前的上下文,Gemini 2.5 Flash-Lite 的性價比優勢可能會被更長的 prompt 消耗掉一部分,這時候不妨把 Claude Haiku 4.5 也拉進來做一次並排測試;而複雜 Agent 任務如果對響應延遲要求很高,也要實測 GPT-5 mini 在你具體工具鏈下的端到端耗時,而不是隻看官方公佈的智能指數分數。
快速遷移:從 gpt-4o-mini 切換到替代模型只需兩步
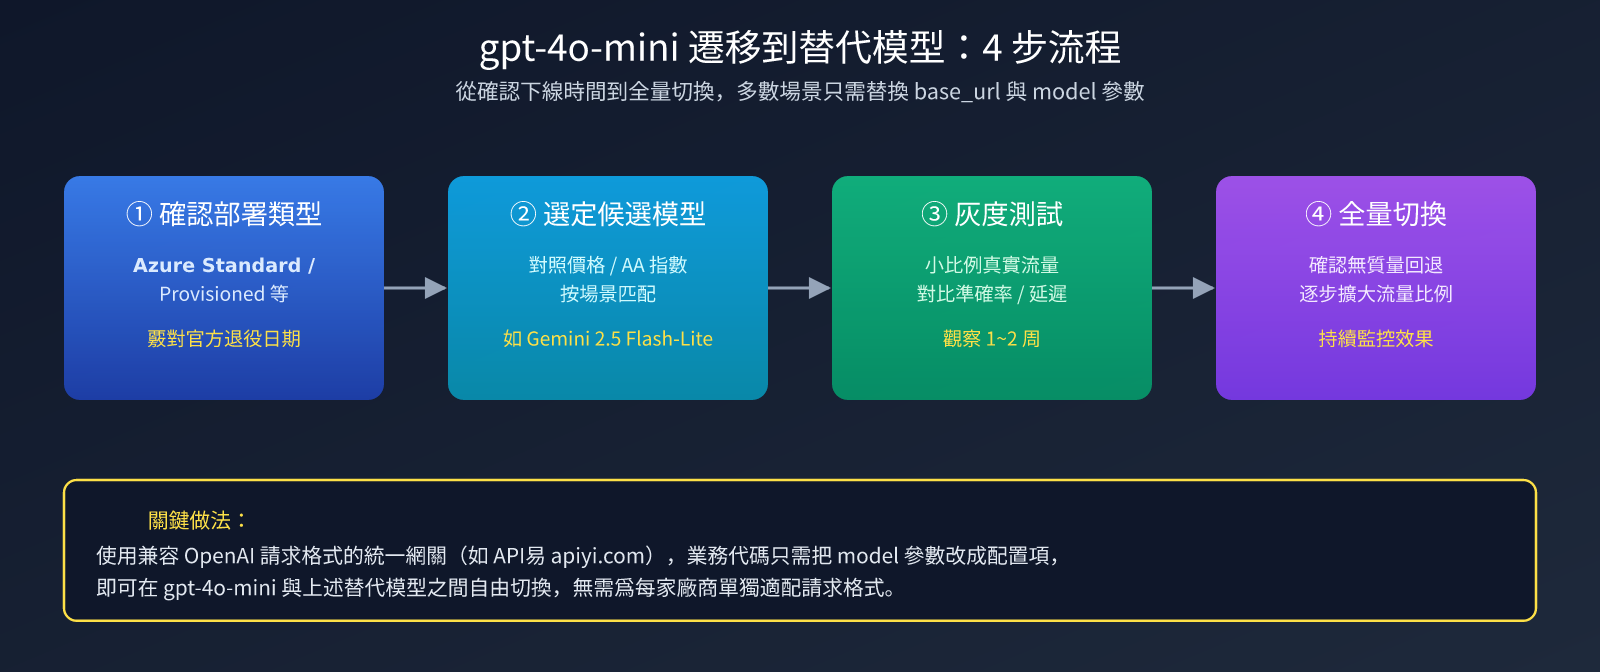
多數遷移工作只需要修改 base_url 和 model 兩個參數。如果你原本使用的是 OpenAI SDK 或兼容格式的客戶端,不需要重寫任何業務邏輯。
真正麻煩的地方通常不在代碼層面,而在於不同廠商的原生接口在消息格式、工具調用字段、速率限制策略上並不完全一致:直接切換到 Gemini 或 Claude 的原生 SDK,往往需要重寫請求體和響應解析邏輯。使用兼容 OpenAI 請求格式的統一網關,可以把這部分差異屏蔽掉,讓業務代碼只維護一套調用方式,這也是下面示例裏把 model 做成可配置參數、而不是爲每家單獨寫一套客戶端的原因。
極簡示例
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易統一接口,一次接入可切換多家模型
)

response = client.chat.completions.create(
    model="gemini-2.5-flash-lite",  # 從 gpt-4o-mini 切換到替代模型
    messages=[{"role": "user", "content": "Hello!"}]
)
print(response.choices[0].message.content)
查看完整遷移代碼(含模型切換開關和錯誤重試)
import openai
import os

MODEL_MAP = {
    "baseline": "gpt-4o-mini",
    "openai-upgrade": "gpt-5-mini",
    "budget": "gpt-5-nano",
    "gemini": "gemini-2.5-flash-lite",
    "deepseek": "deepseek-v4-flash",
    "claude": "claude-haiku-4-5",
}

client = openai.OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # API易統一接口,兼容 OpenAI SDK 調用格式
)

def call_model(prompt: str, profile: str = "gemini", max_retries: int = 2):
    model = MODEL_MAP[profile]
    for attempt in range(max_retries + 1):
        try:
            response = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                timeout=30,
            )
            return response.choices[0].message.content
        except Exception:
            if attempt == max_retries:
                raise
    return None

if __name__ == "__main__":
    print(call_model("總結一下 gpt-4o-mini 的下線時間表", profile="gemini"))
🚀 快速開始:推薦使用 API易 apiyi.com 平臺完成遷移前的對比測試,平臺內置多模型統一計費,不需要爲每個新模型單獨申請密鑰和賬戶,幾分鐘內就能跑通上表中的全部候選模型。
常見問題
Q1:我現在用的是 Azure OpenAI 上的 gpt-4o-mini,還能繼續用多久?
要看具體部署類型。如果是 Standard 部署,已經在 2026 年 3 月 31 日退役,目前應該已經無法調用;如果是 Provisioned、Global Standard 或 Data Zone Standard 部署,退役日期是 2026 年 10 月 1 日,距現在只剩不到兩個月。建議儘快通過 API易 apiyi.com 之類支持多模型切換的平臺完成遷移測試,避免到期後業務中斷。
Q2:我用的是 OpenAI 官方 API,是不是也必須馬上遷移?
不是必須的。根據 OpenAI 官方 Deprecations 頁面,gpt-4o-mini 本體目前沒有被列入退役名單,只有它的微調版本 ft-gpt-4o-mini 有更晚的時間表。如果你更看重成本,可以繼續觀望;但考慮到 gpt-4o-mini 的 AA 智能指數只有 7 分,通過 API易 apiyi.com 平臺做一次同價位模型的效果對比,通常能在不增加預算的前提下換來明顯的質量提升。
Q3:遷移到新模型之後,怎麼確認效果沒有變差?
不要只憑主觀感覺判斷,建議先固定一批有代表性的真實業務樣本(而不是隨手寫的幾條測試用例),讓 gpt-4o-mini 和候選模型跑同一批輸入,再從準確率、格式合規率、平均響應時長三個維度對比結果。灰度切換階段可以讓新模型只承接一小部分真實流量,觀察一到兩週的線上表現,確認沒有明顯的質量或延遲迴退後,再逐步把流量比例提高到全量。
總結與決策建議
| 檢查項 | 說明 |
|---|---|
| 確認部署類型 | Azure Standard / Provisioned / Global Standard / Data Zone Standard 退役時間不同 |
| 覈實官方定價 | 定價可能隨區域、峯谷時段浮動,以官方頁面爲準 |
| 對比 AA 智能指數 | 優先參考 Artificial Analysis 等第三方公開榜單,避免只看廠商宣傳 |
| 灰度切換 | 先在非核心鏈路驗證效果,再逐步擴大流量比例 |
| 統一接口調用 | 使用兼容 OpenAI SDK 格式的中轉平臺,降低多模型切換成本 |
綜合來看,gpt-4o-mini 並沒有被 OpenAI 官方 API 整體下線,但 Azure 側的退役時間表已經非常緊迫,而它在跑分上的落後也是客觀事實。對大多數場景而言,Gemini 2.5 Flash-Lite 和 GPT-5 mini 是價格接近、性能提升明顯的兩個優先選項;預算極度敏感的場景可以再看看 GPT-5 nano 和 DeepSeek V4 Flash 的峯谷定價。
也要提醒一句:不建議只因爲“便宜”或者“聽說要下線”就倉促切換模型,價格和跑分只是篩選候選池的第一步,真正決定要不要遷移、遷移到哪一款,還是要看它在你自己業務數據上的實測表現。把評估週期拉長到一到兩週、覆蓋足夠多的真實場景,比追逐榜單上的分數變化更可靠。最終推薦通過 API易 apiyi.com 平臺完成一次真實業務數據下的橫向測試,再決定遷移到哪個模型。
如果你在遷移過程中遇到具體問題,歡迎通過 API易 apiyi.com 技術支持通道交流,我們會持續跟蹤 gpt-4o-mini 和各替代模型的官方定價變化,並同步更新本文數據。