作者注:按終端與代碼倉、辦公長任務、多模態長文檔、成本四類任務,對比 Qwen4-Max 與 Claude Opus 5.5 的跑分、規格、緩存價與遷移成本,並給出可執行的選型建議。
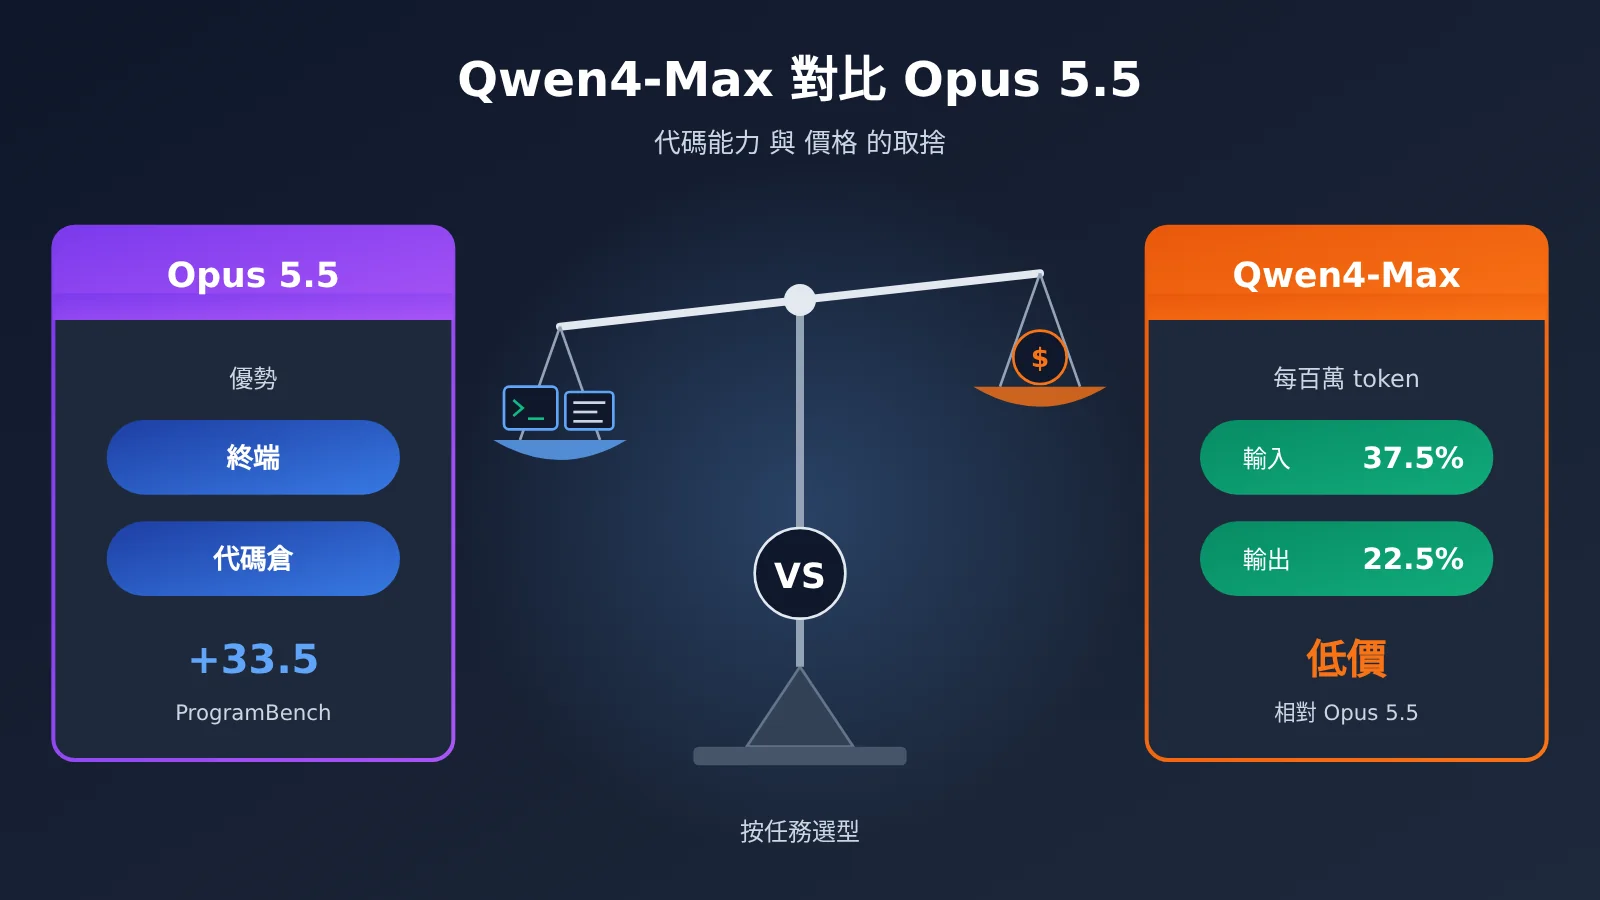
如果你的團隊已經把 Claude Opus 5.5 當主力,在 Claude Code 或自建 agent 裏跑生產,那麼 2026-11-16 發佈的 Qwen4-Max 會讓你重新算一遍賬:它的輸入價只有 Opus 5.5 的 37.5%,輸出價只有 22.5%。
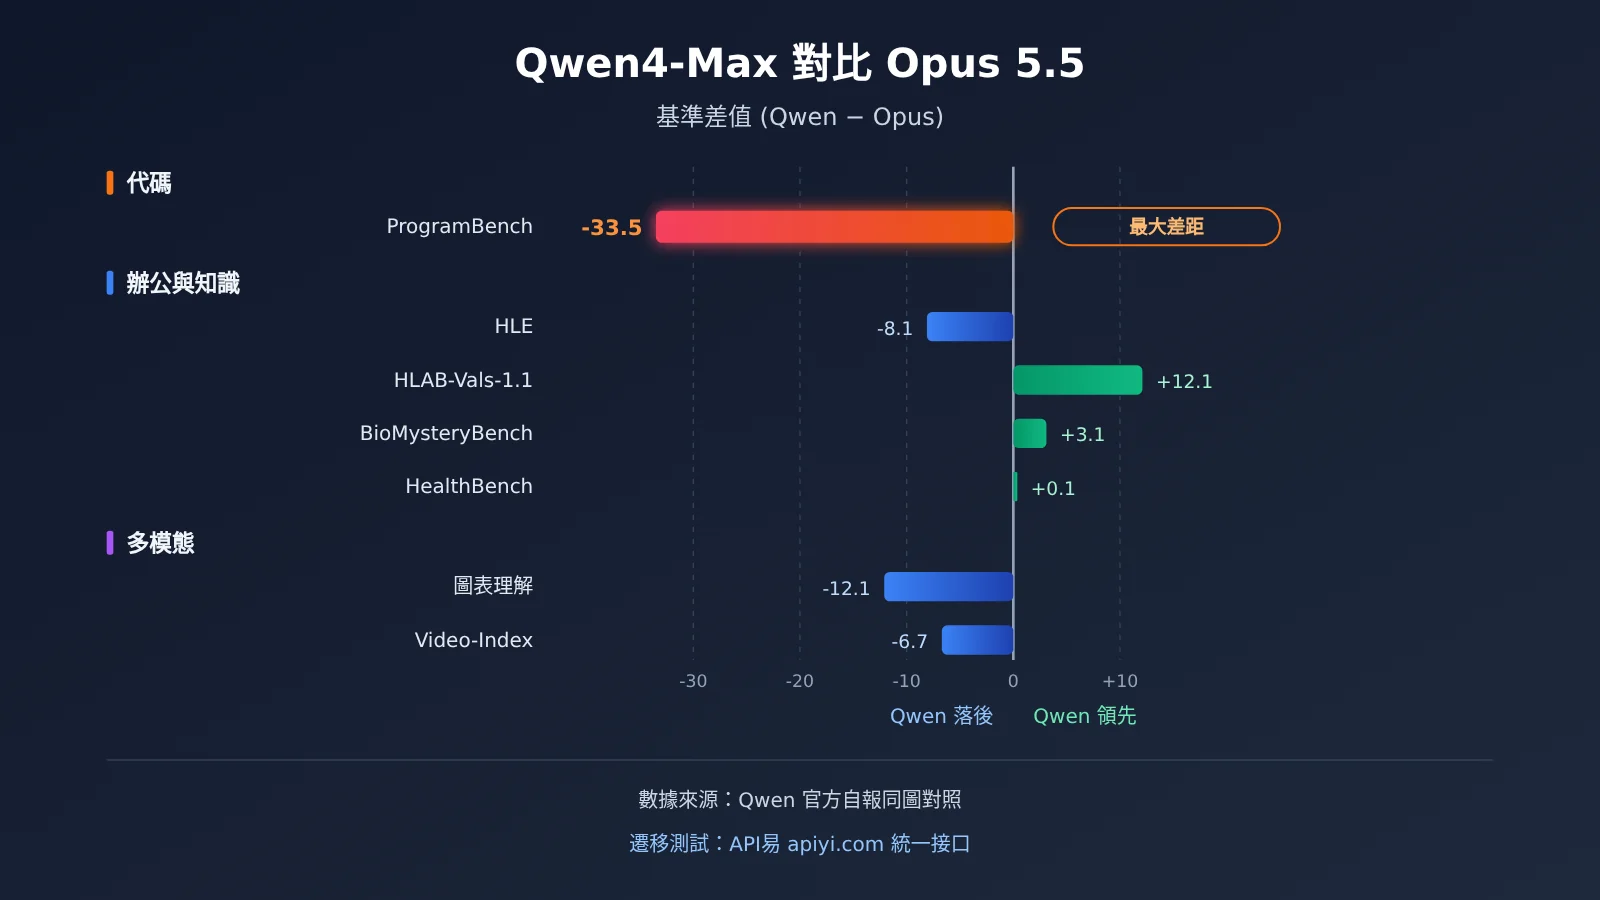
先給結論,不做折中:終端操作與倉庫級重構繼續留在 Opus 5.5,Qwen4-Max 在 ProgramBench 上落後 33.5 分,這是本次對比裏最大的短板;工作流自動化、成本敏感的高併發 agent、超長輸出的文檔任務,可以優先試 Qwen4-Max;辦公交付物和圖表、視頻理解類任務,Opus 5.5 仍有明顯優勢。
核心價值:讀完本文,你會拿到一張按任務劃分的取捨表,並清楚兩邊緩存價、默認推理檔位和實際遷移步驟的差別。
Qwen4-Max 對比 Opus 5.5 核心差異速覽
先說清楚數據口徑。本文的數字來自三套互不相同的來源,不能混着讀:
- Qwen 官方自報的同圖對照:阿里在發佈博客裏用同一張圖列出 Qwen4-Max 與 Opus 5.5 的分數,屬於廠商自跑,並非第三方復現。
- 公開榜快照,2026-11-14:arena.ai 的 Code Arena WebDev 榜,基於公開投票。
- Anthropic 文檔原文:Opus 5.5 的規格與價格取自 Anthropic 官方模型頁和價目頁。
下面這張表是全文的結論濃縮,後續章節逐項展開依據。
| 任務類型 | 推薦 | 關鍵依據 | 一句話理由 |
|---|---|---|---|
| 終端操作與倉庫級重構 | Opus 5.5 | Terminal-Bench 低 11.1,ProgramBench 低 33.5 | 多步命令鏈和整倉改動是 Qwen4-Max 最弱的一環 |
| 單個 issue 修復類編碼 | Qwen4-Max 可試 | DeepSWE 高 1.5 | 局部修復能力已持平,價格優勢明顯 |
| 辦公交付物與長任務 | Opus 5.5 | AA-Briefcase 低 115 Elo,JobBench 低 6.9 | 文檔、報告類產出質量差距可感知 |
| 工作流自動化 | Qwen4-Max | AutomationBench 高 3.0 | 規則清晰的流程任務不輸,成本更低 |
| 圖表與視頻理解 | Opus 5.5 | Chartography 低 12.1,Video-Index 低 6.7 | 多模態讀圖仍有差距 |
| 成本敏感高併發 agent | Qwen4-Max | 輸入 37.5%、輸出 22.5% | 量大時賬單差距會成倍放大 |
Qwen4-Max 與 Opus 5.5 規格差異
規格層面,兩者上下文都是 1M,但輸出與推理默認值差別很大:
- Qwen4-Max:2.4T 主幹、71B 激活,外加 328B N-gram Embedding;原生視覺;最大輸出 393K,最大思維鏈 262K;默認
reasoning_effort爲 high。 - Opus 5.5(Anthropic 文檔原文):定位長跑 agentic 編碼與知識工作;最大輸出 128K;默認 effort 爲 medium;知識截止 2026 年 6 月。
默認檔位這一條很容易被忽略。Qwen4-Max 默認就開到 high,思考過程會按輸出計費,所以真實賬單的差距通常小於標價上的 22.5%,後文價格部分會給出一個公開榜上的旁證。
Qwen4-Max 對比 Opus 5.5:終端與代碼倉任務
這是現有 Opus 用戶最關心的部分,也是 Qwen4-Max 最需要謹慎對待的部分。
| 基準(Qwen 官方自報的同圖對照) | Qwen4-Max | Opus 5.5 | 差值 |
|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 74.2 | Qwen 高 1.5 |
| CodeArena WebDev Elo | 1750 | 1816 | Qwen 低 66 |
| Terminal-Bench 4.0 | 48.5 | 59.6 | Qwen 低 11.1 |
| ProgramBench | 31.5 | 65.0 | Qwen 低 33.5 |
逐項看它們對實際工作意味着什麼:
- DeepSWE 高 1.5:在給定 issue 做定點修復這類任務上,Qwen4-Max 已經和 Opus 5.5 站在同一水平,1.5 分基本可視爲持平,適合拿來跑低風險的 bug 修復隊列。
- WebDev 低 66 Elo:前端頁面生成的整體觀感,用戶投票更偏向 Opus,做落地頁、組件原型時差距能被肉眼看到。
- Terminal-Bench 低 11.1:在終端裏連續執行命令、讀輸出、再決定下一步的能力明顯落後,這正是 Claude Code 類工作流的日常,換過去意味着更多中途卡住或需要人工接管。
- ProgramBench 低 33.5:這是本次對比中最大的短板,分數接近腰斬。從零構建或大範圍改寫程序的任務,Qwen4-Max 目前不適合作爲 Opus 5.5 的替身。
公開榜也給出了相近的位置信息。按公開榜快照,2026-11-14,arena.ai Code Arena WebDev 共 1,007,405 票、159 個模型:Opus 5.5(Max)1816 分排第 2,Qwen4-Max(xHigh)1750 分排第 6,但後者只有 1,814 票,仍標記爲 Preliminary,排名還會波動。
代碼倉場景的 Qwen4-Max 使用建議
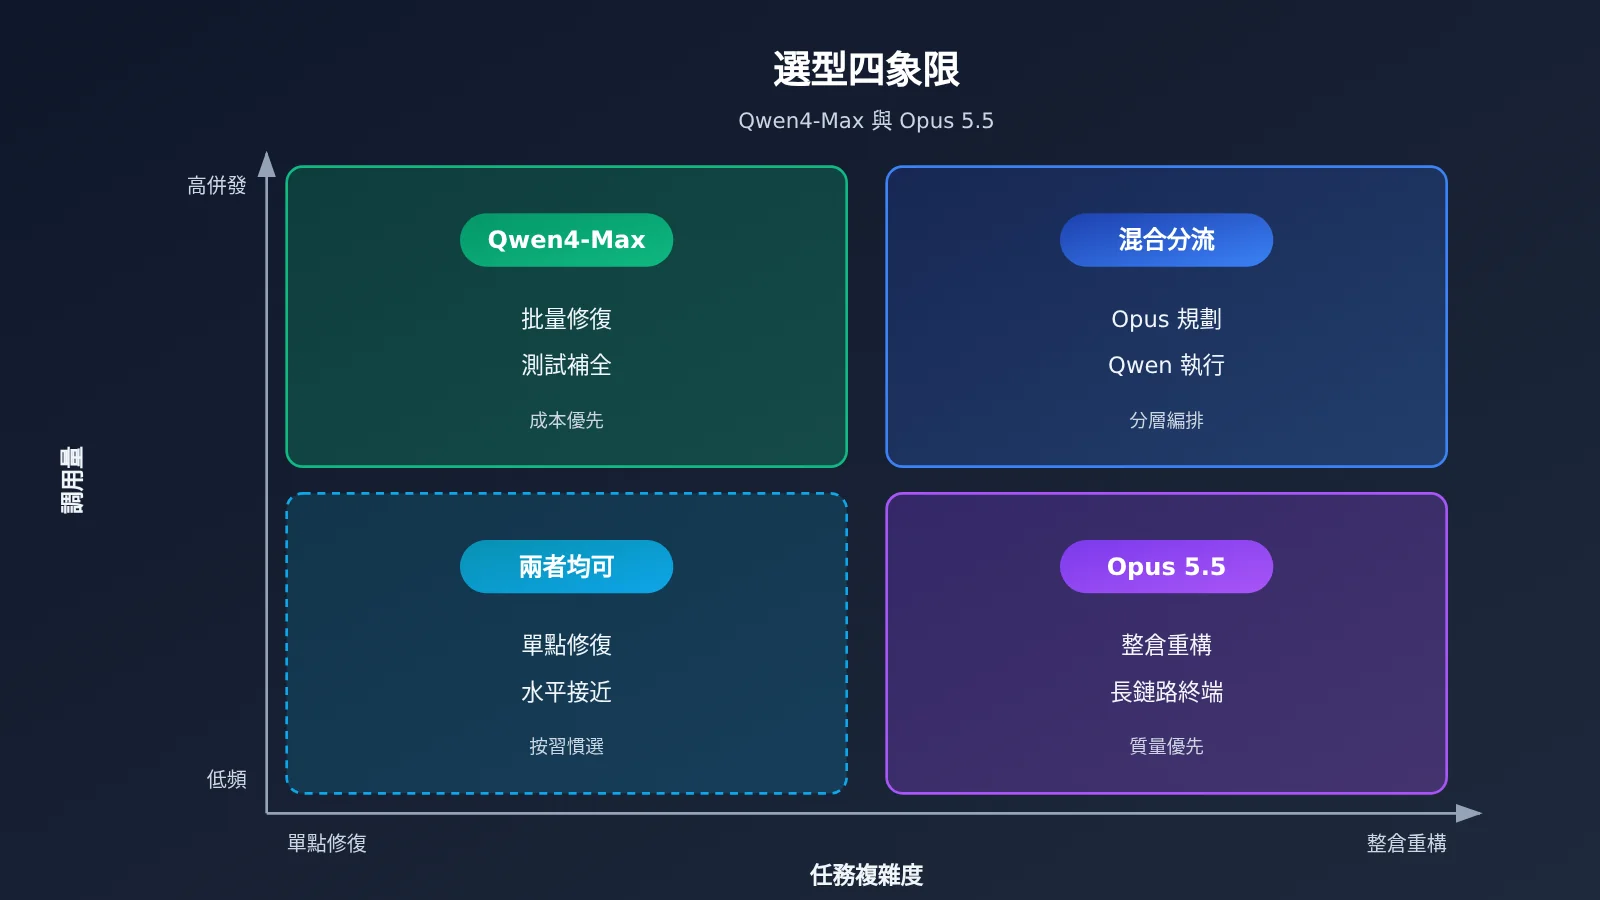
如果你的 agent 主要做整倉重構、跨模塊遷移或長鏈路終端操作,建議保持 Opus 5.5 不動。如果你把任務拆成了“規劃 + 執行”兩層,可以考慮讓 Opus 5.5 負責規劃與關鍵改動,把單文件修復、測試補全這類局部任務分流給 Qwen4-Max。
Qwen4-Max 對比 Opus 5.5:辦公與長任務
辦公類和長時 agent 任務的結果比編碼更分化,有輸有贏。
| 基準(Qwen 官方自報的同圖對照) | Qwen4-Max | Opus 5.5 | 差值 |
|---|---|---|---|
| AA-Briefcase v1.1 Elo | 1686 | 1801 | Qwen 低 115 |
| JobBench | 68.5 | 75.4 | Qwen 低 6.9 |
| APEX-Agents v1.1 | 72.1 | 73.5 | Qwen 低 1.4 |
| AutomationBench-AA | 72.5 | 69.5 | Qwen 高 3.0 |
| AgentArena Net Improvement | 7.5 | 18.2 | Qwen 低 10.7 |
對應到實際工作:
- AA-Briefcase 低 115 Elo:報告、方案、表格這類辦公交付物,Opus 5.5 的成品更容易被直接採用,這是辦公場景裏差距最大的一項。
- JobBench 低 6.9:貼近真實崗位任務的綜合完成度仍是 Opus 領先,意味着端到端交付時返工率可能更高。
- APEX-Agents 低 1.4:通用 agent 任務基本打平,換模型不會帶來明顯體驗落差。
- AutomationBench 高 3.0:規則明確的流程自動化反而是 Qwen4-Max 的強項,表單處理、數據搬運、定時任務編排適合優先遷移。
- AgentArena Net Improvement 低 10.7:在多輪迭代中持續改進的能力較弱,長任務越往後越依賴模型自我修正時,Opus 更穩。
另外,Qwen4-Max 的 393K 最大輸出和 262K 思維鏈上限,對需要一次性產出超長內容的長任務是實打實的優勢,Opus 5.5 的最大輸出是 128K。
Qwen4-Max 對比 Opus 5.5:中文與多模態長文檔
需要先說明:參考資料中的對照圖沒有中文專項基準,所以本文無法用數字回答“中文誰更好”。如果中文質量是你的核心指標,請用自己的樣本集做 A/B,不要依賴任何二手結論。
能用數字說話的是多模態和知識類任務:
| 基準(Qwen 官方自報的同圖對照) | Qwen4-Max | Opus 5.5 | 差值 |
|---|---|---|---|
| Chartography | 54.2 | 66.3 | Qwen 低 12.1 |
| Video-Index | 68.1 | 74.8 | Qwen 低 6.7 |
| Humanity’s Last Exam | 51.7 | 59.8 | Qwen 低 8.1 |
| HLAB-Vals-1.1 | 21.3 | 9.2 | Qwen 高 12.1 |
| BioMysteryBench | 85.0 | 81.9 | Qwen 高 3.1 |
| HealthBench Professional | 60.0 | 59.9 | 基本打平 |
這些數字的實際含義是:讀圖表、抽取財報和研報中的圖形數據,Qwen4-Max 落後 12.1 分,容易漏讀或誤讀座標;視頻理解也有 6.7 分差距;高難度綜合知識題(HLE)落後 8.1 分。反過來,生物推理和醫療專業問答上 Qwen4-Max 持平甚至略佔優,HLAB-Vals 領先 12.1 分。
所以長文檔任務要再細分:以文字爲主、需要超長輸出的文檔,Qwen4-Max 可以作爲首選候選;圖表密集的 PDF 或含視頻素材的資料,仍建議走 Opus 5.5。
Qwen4-Max 與 Opus 5.5 每百萬 token 價格與緩存賬
價格是 Qwen4-Max 最有力的論據。下表單位均爲每 1M tokens,官方價分別取自 QwenCloud 與 Anthropic 文檔原文,API易 現價取自 docs.apiyi.com/models,取數日期 2026-11-16。
| 計費項($/1M tokens) | Qwen4-Max 官方 | Opus 5.5 官方 | Qwen/Opus | API易 qwen3.8-max |
API易 claude-opus-5-5 |
|---|---|---|---|---|---|
| 輸入 | 1.5 | 4 | 37.5% | 1.65 | 4 |
| 輸出 | 4.5 | 20 | 22.5% | 4.95 | 20 |
| 緩存讀 | 0.075 | 0.20 | 37.5% | 0.20625 | 0.2 |
| 5 分鐘緩存寫 | 1.875 | 5 | 37.5% | 以平臺列表爲準 | 以平臺列表爲準 |
| 1 小時緩存寫 | 3 | 8 | 37.5% | 以平臺列表爲準 | 以平臺列表爲準 |
兩家的緩存結構其實完全同構:緩存讀都是輸入價的 5%,5 分鐘緩存寫都是輸入價的 1.25 倍,1 小時緩存寫都是 2 倍。這意味着你在 Opus 上設計的緩存策略可以原樣搬到 Qwen4-Max,賬單按 37.5% 等比縮小。需要留意的是,API易 上 qwen3.8-max 的緩存讀是輸入價的 12.5%,比例與 Qwen4-Max 官方不同,遷移時請按實際型號單獨覈算。
一筆具體的賬
以 1 億輸入 + 1000 萬輸出爲例:Qwen4-Max 約 $195(150 + 45),Opus 5.5 約 $600(400 + 200)。差額約 $405,相當於 Opus 賬單的三分之二。
但標價不等於實付。公開榜快照,2026-11-14 給出了單任務成本 P50:Opus 5.5(Max)$8.99,Qwen4-Max(xHigh)$4.18,比值約 46%,而不是標價的 22.5%。原因在於兩者推理檔位不同,Qwen4-Max 默認就是 high,思維鏈按輸出計費,token 消耗更多。實際省多少,取決於你的任務長度和推理檔位,建議用自己的流量回放測一遍。
💰 成本建議:對比賬單時,請同時記錄輸入、輸出、緩存讀寫四項 token 量,而不只看單價。通過 API易 apiyi.com 在同一賬戶下並行調用兩個模型,用量明細在一處就能對齊。
Qwen4-Max 對比 Opus 5.5 決策建議與遷移三步
把一條 agent 從 Opus 換到 Qwen,繞不開查型號、對價格、對協議三步。
第一步:查型號。 截至 2026-11-16,Qwen4-Max 在 API易 暫未上架,我們會盡快上架這個模型;當前 Qwen 側最強的是 qwen3.8-max。Opus 側可用 claude-opus-5-5,另有 claude-opus-5-5-thinking,價格相同。型號與價格以 apiyi.com 文檔中心的型號列表爲準,上架前可以先用 qwen3.8-max 搭好灰度鏈路。
第二步:對價格。 按上一節的方法,用一週真實流量估算兩邊成本,並把推理檔位對齊後再比。API易 apiyi.com 的型號列表把輸入、輸出、緩存讀都列在同一張總表裏,適合直接拿來做覈算表的數據源。
第三步:對協議。 API易 提供 OpenAI 兼容接口,端點爲 https://api.apiyi.com/v1,切換模型時只需改 model 字段,例如從 claude-opus-5-5 改爲 qwen3.8-max,api_key 與 base_url 保持不變。需要額外檢查兩處:推理強度參數在 Qwen 側叫 reasoning_effort,默認 high,若想與 Opus 的 medium 對齊要顯式設置;緩存的寫入時長與命中規則也要按目標模型重新驗證。
🎯 灰度建議:不要整條 agent 一次切換。推薦把同一個
base_url(https://api.apiyi.com/v1)下的流量按任務類型分流,先遷移自動化和局部修復任務,終端與整倉任務保留在 Opus 5.5,觀察兩週返工率再決定下一步。
常見問題 FAQ
Q1:Qwen4-Max 和 Opus 5.5 誰更適合做 coding agent?
看任務粒度。單 issue 修復(DeepSWE)兩者持平,可用 Qwen4-Max 省錢;終端多步操作和整倉構建(Terminal-Bench、ProgramBench)Opus 5.5 明顯領先,尤其 ProgramBench 差 33.5 分,這類任務繼續用 Opus。
Q2:阿里圖上的分數和 arena 榜能放在一起比嗎?
不能當同一口徑。前者是 Qwen 官方自報的同圖對照,後者是公開榜快照(2026-11-14),而且 Qwen4-Max 在榜上僅 1,814 票、仍爲 Preliminary。兩者可以互相參照趨勢,但不應合併成一個“領先多少分”的結論。
Q3:換到 Qwen4-Max 實際能省多少錢?
標價上輸入省 62.5%、輸出省 77.5%。但公開榜上的單任務成本 P50 比值約爲 46%,因爲 Qwen4-Max 默認推理檔位更高、思考 token 更多。實際節省需要用你的流量回放測算。
Q4:現在能在 API易 上調用 Qwen4-Max 嗎?
暫時不能,Qwen4-Max 尚未上架,我們會盡快上架。當前可用 `qwen3.8-max` 搭建遷移鏈路,上架後只需改 `model` 字段。型號狀態請以 API易 apiyi.com 的型號列表爲準。
Q5:從 Opus 切到 Qwen 需要改多少代碼?
若已使用 OpenAI 兼容接口,`base_url` 指向 `https://api.apiyi.com/v1` 後只需改模型名,並按需設置 `reasoning_effort`。註冊 API易 apiyi.com 後可用新用戶免費測試額度先跑一輪對比。
Q6:Qwen4-Max 有哪些已知限制?
終端與整倉編碼是最大短板,圖表理解落後 12.1 分,辦公交付物 Elo 低 115,多輪自我改進能力也偏弱。此外,所有對照分數均爲廠商自報,尚無第三方復現,中文能力也缺少專項基準數據。
Qwen4-Max 對比 Opus 5.5 核心要點 Key Takeaways
- 最大短板:ProgramBench 低 33.5 分,整倉構建與重構繼續用 Opus 5.5。
- 持平區域:DeepSWE、APEX-Agents、HealthBench 基本打平,可優先分流。
- Qwen 優勢:工作流自動化、生物醫療推理、393K 超長輸出。
- 價格結構:輸入 37.5%、輸出 22.5%,緩存四項比例與 Opus 完全同構。
- 實付差距:默認推理檔位爲 high,公開榜單任務成本比約 46%。
- 遷移路徑:在 API易 apiyi.com 用同一端點先跑
qwen3.8-max,Qwen4-Max 上架後直接替換。
總結
Qwen4-Max 對比 Opus 5.5 的選擇可以歸納爲三點:
- 終端與代碼倉留給 Opus 5.5:Terminal-Bench 與 ProgramBench 的差距,價格差覆蓋不了返工成本。
- 自動化與高併發交給 Qwen4-Max:能力持平或領先的任務上,三到五成的賬單就是純收益。
- 按任務分流,而不是整體替換:同一套接口、按任務類型路由,是風險最低的遷移方式。
建議先在 API易 apiyi.com 用 qwen3.8-max 與 claude-opus-5-5 跑一輪自己的任務回放,Qwen4-Max 上架後再做最終切換決策。
📚 參考資料
-
Qwen4-Max 發佈博客:模型規格與官方自報基準對照
- 鏈接:
qwen.ai/blog?id=qwen4-max - 說明:包含架構參數、上下文與輸出上限及同圖對照分數
- 鏈接:
-
Anthropic 模型概覽:Opus 5.5 規格說明
- 鏈接:
platform.claude.com/docs/en/about-claude/models/overview.md - 說明:上下文、最大輸出、默認 effort 與知識截止
- 鏈接:
-
Anthropic 價格頁:Opus 5.5 輸入輸出與緩存價
- 鏈接:
platform.claude.com/docs/en/about-claude/pricing.md - 說明:含 5 分鐘與 1 小時緩存寫價格
- 鏈接:
-
API易 型號列表:平臺現價與可用型號
- 鏈接:
docs.apiyi.com/models - 說明:遷移前核對型號上架狀態與價格
- 鏈接:
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心