作者注:Fable 5.5 與 GPT-6.2 Astra 都有公開 demo,但沒有同題對比。本文梳理 6 個 demo 的證據等級,對比現役旗艦 Fable 5.1 與 GPT-6 Astra 的官方規格和價格,並給出一套可重跑的選型評測方法。
先給結論:Fable 5.5 和 GPT-6.2 Astra 誰更強,目前沒有答案。兩個模型都沒有正式發佈。截至 2026-11-03,Anthropic 模型目錄裏仍是 Fable 5.1,OpenAI 模型目錄裏仍是 GPT-6 Astra(來源:兩家官方模型頁,證據等級:官方文檔)。兩者的公開 demo 都放在同一個第三方測試站 Model Tests 上,作者是 @notjazii,但做的不是同一道題。Fable 5.5 有遊戲、短片、SVG、WebGL 等 5 個作品,GPT-6.2 Astra 只有 1 條像素動畫 GIF。任務不同,就談不上誰贏。
所以本文不排名次,只回答三個問題:這些 demo 能證明什麼、不能證明什麼;現在能拿來比的 Fable 5.1 和 GPT-6 Astra 在官方規格上差在哪裏;以及怎樣準備一套 20 到 50 條任務的自有評測,等新模型上線後只換模型名就能重跑。其他傳聞線(如 Mythos 5.5、Gemini 4 Carbon)本文不展開。
這不是一篇“看起來各有千秋”的折中稿。證據不夠的地方會直接寫明不夠,能下判斷的地方會直接給建議。
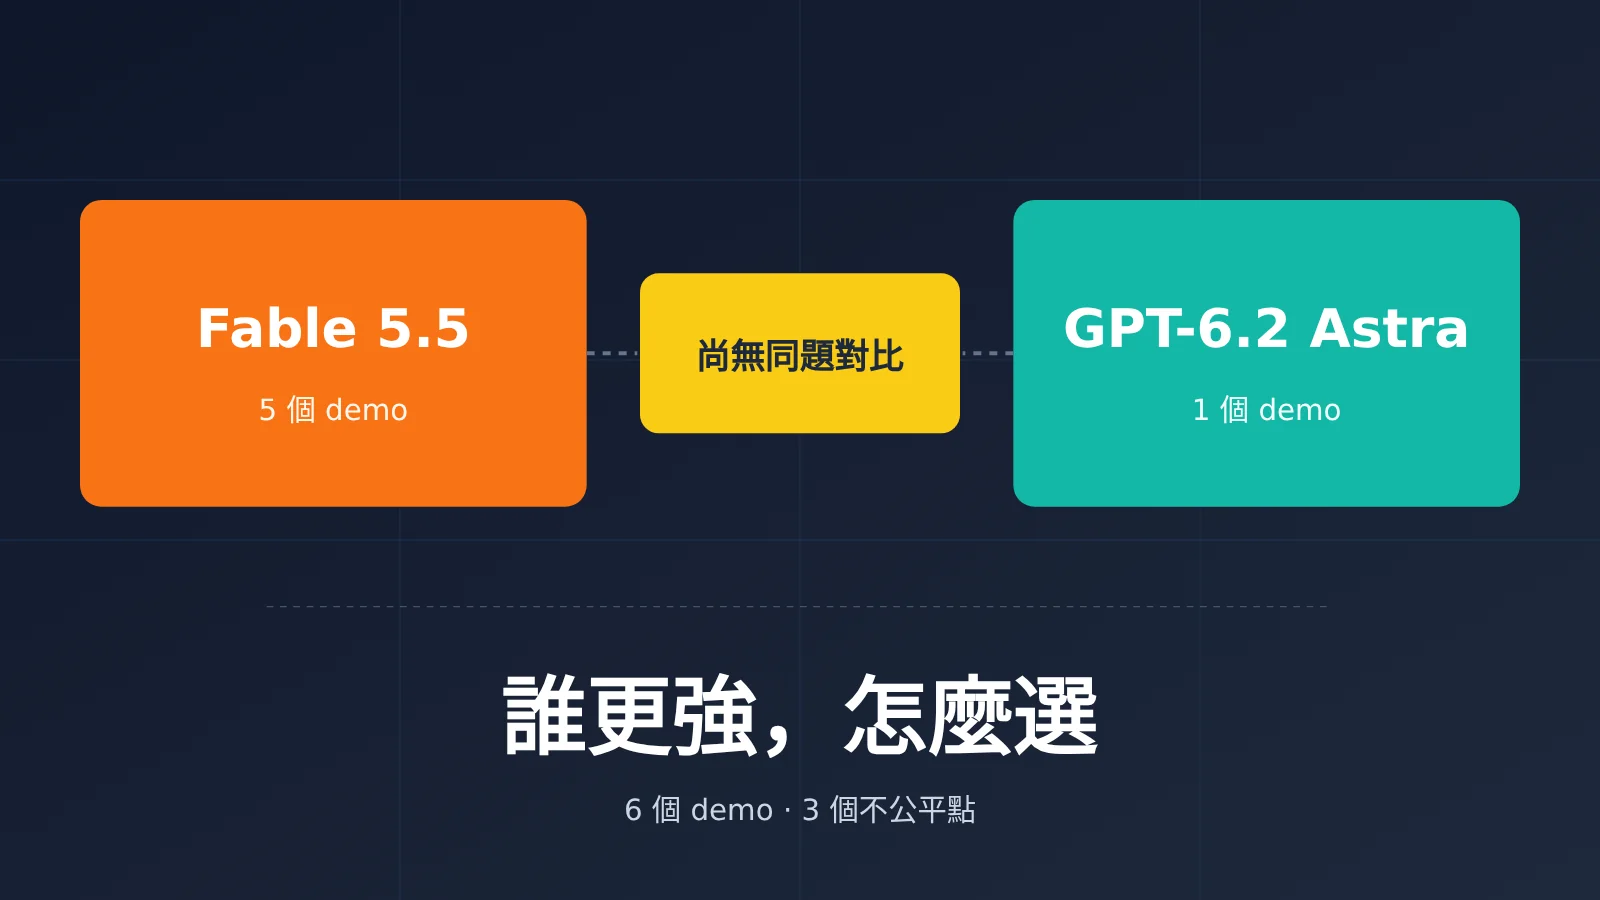
Fable 5.5 vs GPT-6.2 Astra 的公開 demo 清單
判斷:demo 能證明模型可以產出可運行的成品,但兩邊題目、數量、檔位都不一樣,不能直接拿來比。
Model Tests 站點共收錄 11 個項目、8 個模型,每條都標註了日期、模型和類型(來源:站點頁面,證據等級:社區自述)。下表把 Fable 5.5 和 GPT-6.2 Astra 名下的全部 6 個作品,以及站內可以當基線的幾條放在一起。模型歸屬全部是作者自稱。
| 作品 | 作者標註 | 類型 | 日期 | 內容要點 |
|---|---|---|---|---|
| VoxelCraft | Fable 5.5 xhigh | 可玩 HTML 遊戲 | 2026-11-01 | 單文件《我的世界》克隆,含生存/創造、合成、熔爐、附魔、紅石、村民、多生物羣系、下界與末地 |
| The Last Page | Fable 5.5 xhigh | 66 秒有聲短片 | 2026-11-02 | 狐狸、月光圖書館、書頁風暴、飛向雲層 |
| Open Me | Fable 5.5 xhigh | WebGL 交互體驗 | 2026-11-02 | raymarched WebGL2 加生成式音樂,需要獨立 GPU |
| Acorn Bread on a Stick | Fable 5.5 xhigh | 手寫 SVG | 2026-11-02 | 橡子麪包插畫 |
| Fruit Basket | Fable 5.5 max | 純矢量靜物 | 2026-11-02 | 3000×2400,無位圖,寫實水果籃 |
| Tsukimi Moon Ferry | GPT 6.2 Astra Max | 像素動畫 GIF | 2026-11-02 | 滿月下的日式河鎮:城堡、富士山、紅橋、飛鯉、浮燈、渡船 |
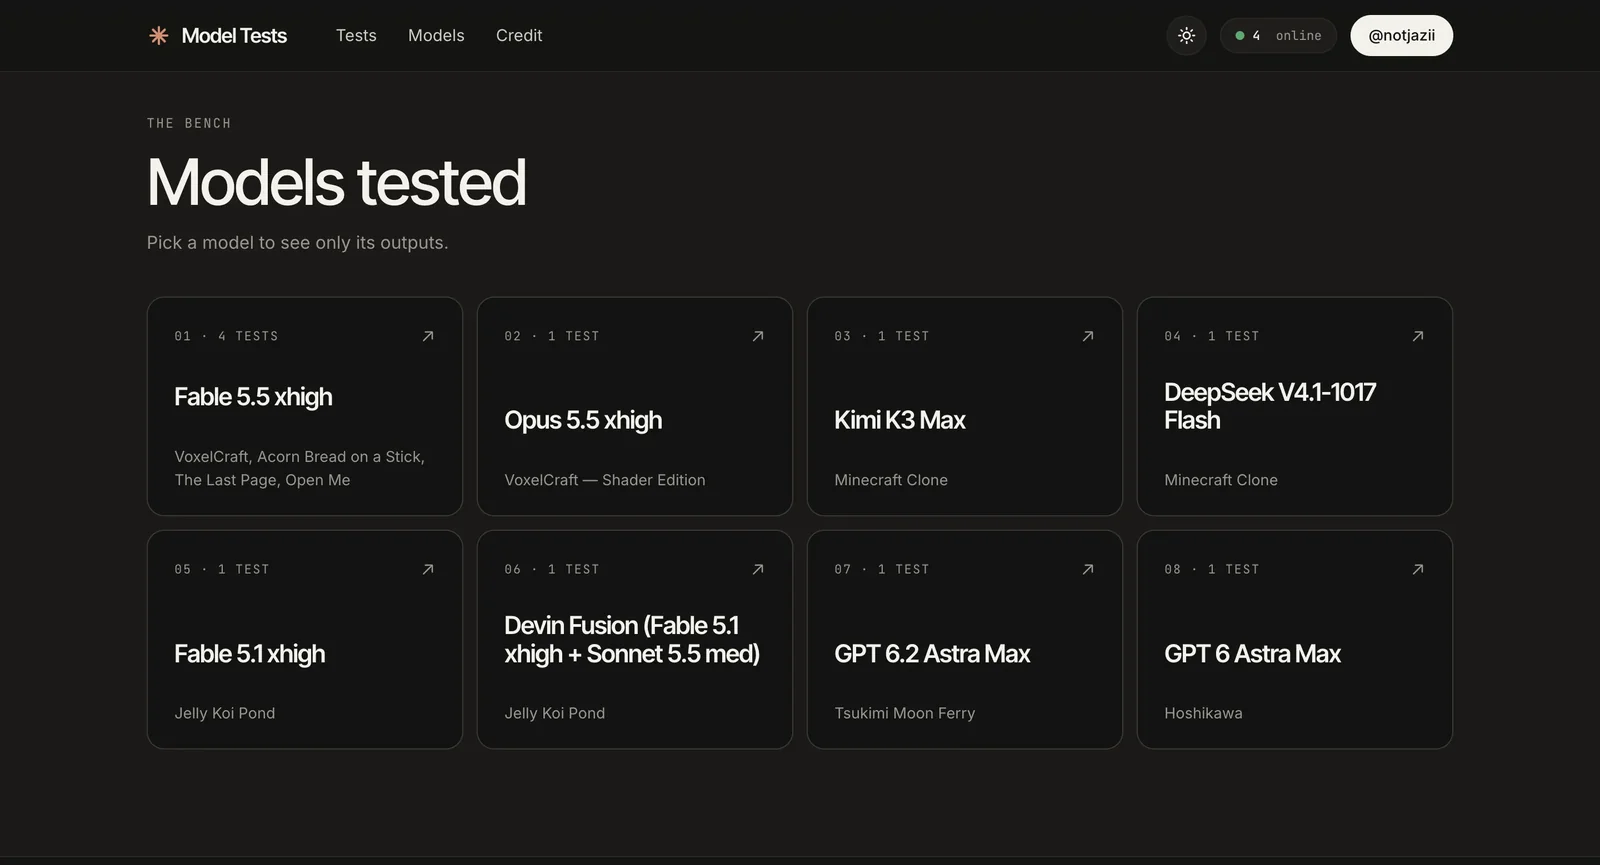
圖注:Model Tests 的模型列表。Fable 5.5 xhigh 名下 4 條測試,GPT-6.2 Astra Max 只有 1 條,GPT-6 Astra Max 也是 1 條(截圖 2026-11-03)。
站內還有幾條可以當參照的作品。Hoshikawa 標註爲 GPT 6 Astra Max,同樣是滿月下的日式小鎮像素動畫(2026-11-02),風格和 Tsukimi Moon Ferry 接近,是站內唯一接近同題的 OpenAI 新舊版本對照。VoxelCraft — Shader Edition 標註爲 Opus 5.5 xhigh(2026-11-01),和 Fable 5.5 的 VoxelCraft 是同一道題。此外,Kimi K3 Max 和 DeepSeek V4.1-1017 Flash 也各做過一個 Minecraft 克隆(2026-10-17)。
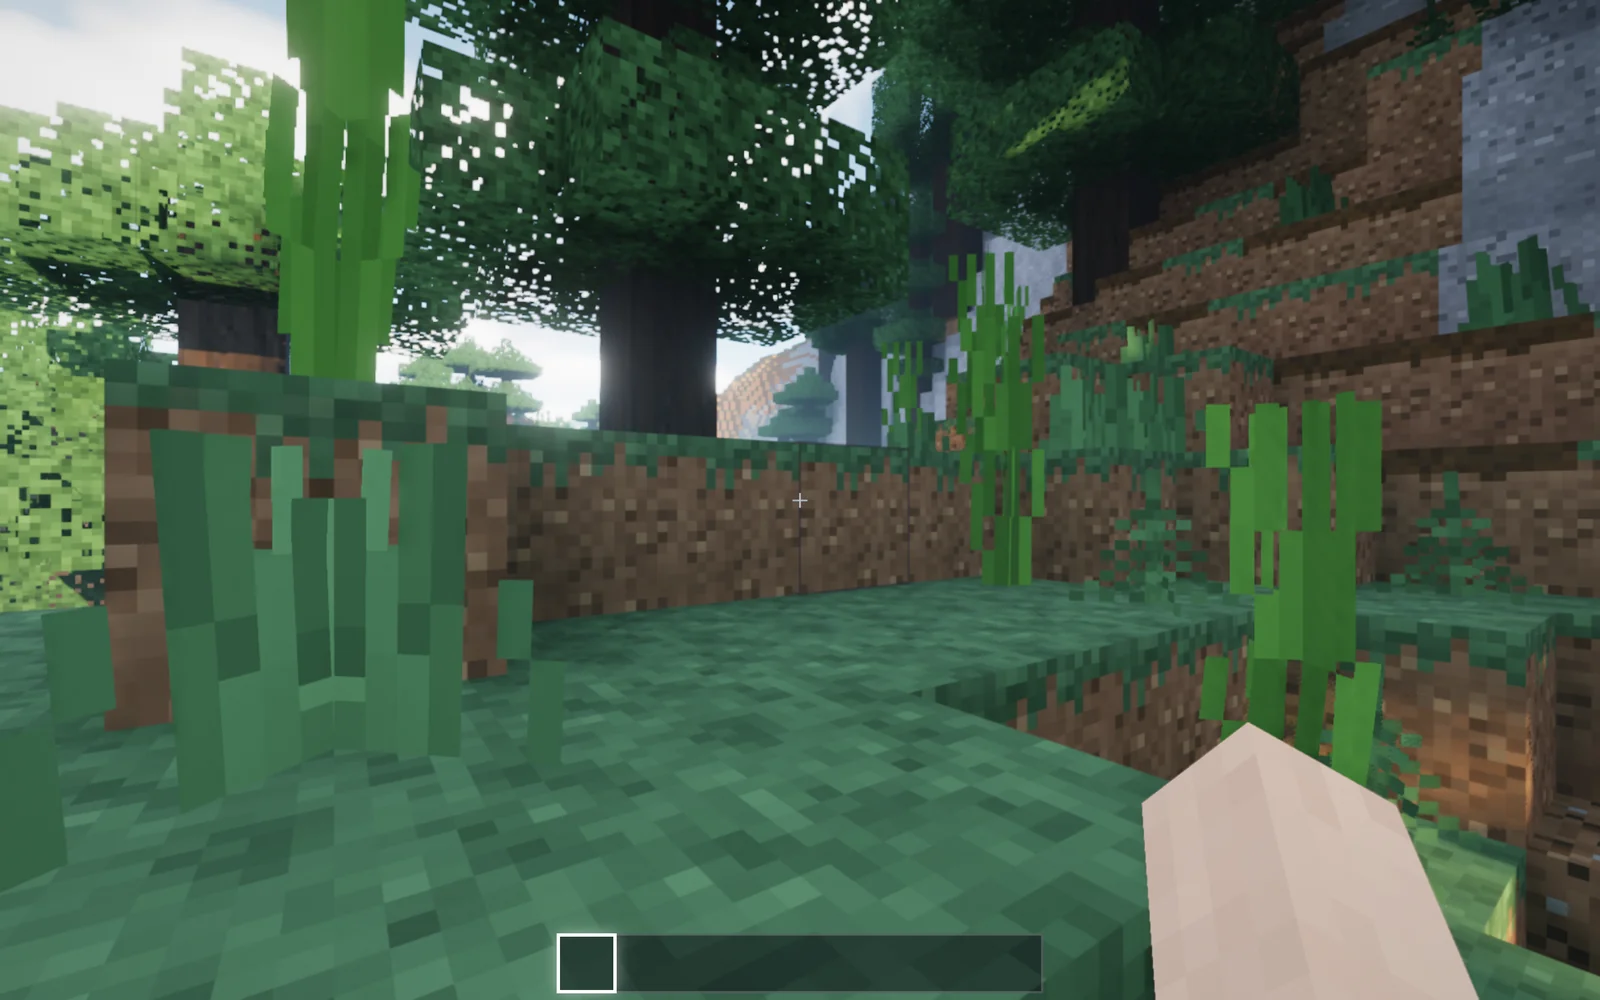
圖注:Fable 5.5 xhigh 的 VoxelCraft,單文件《我的世界》克隆,點開就能走(截圖 2026-11-03)。
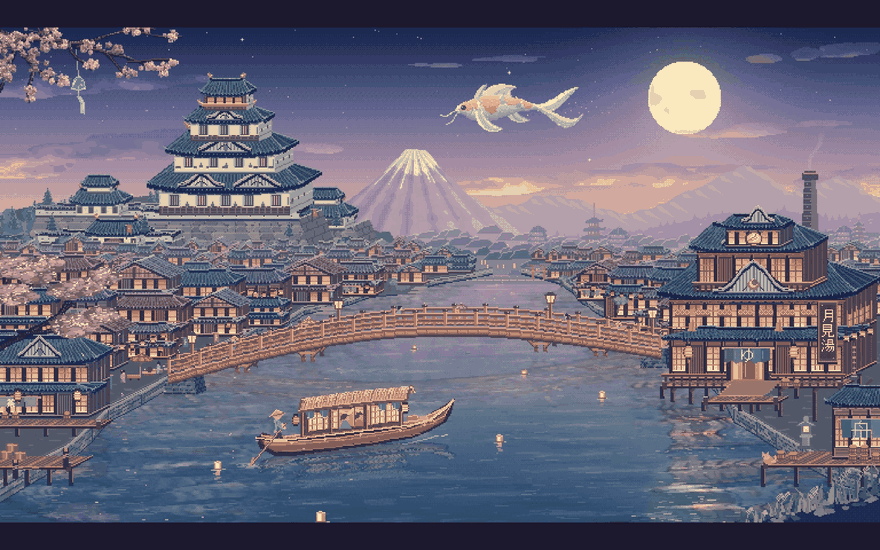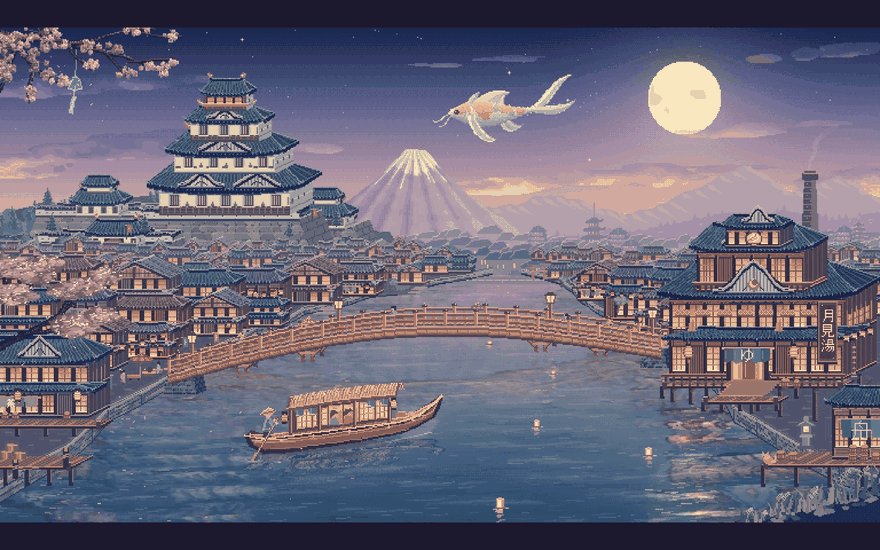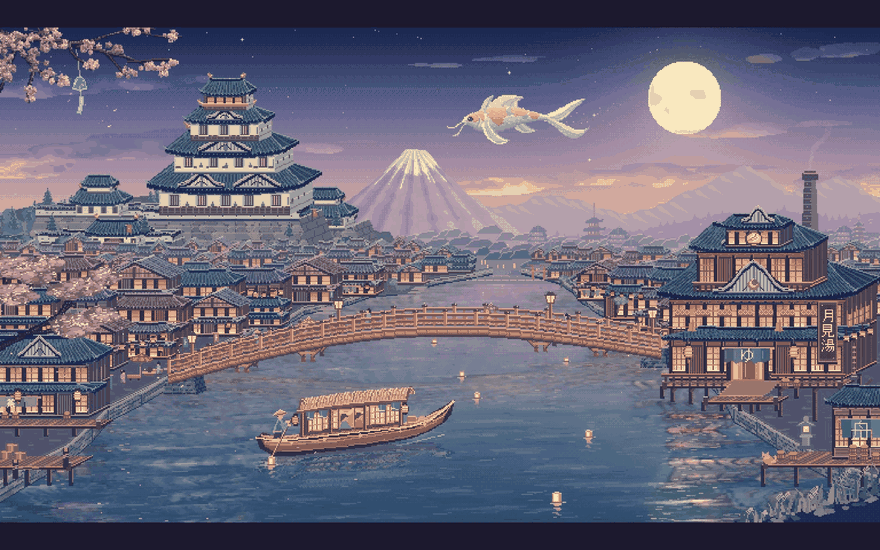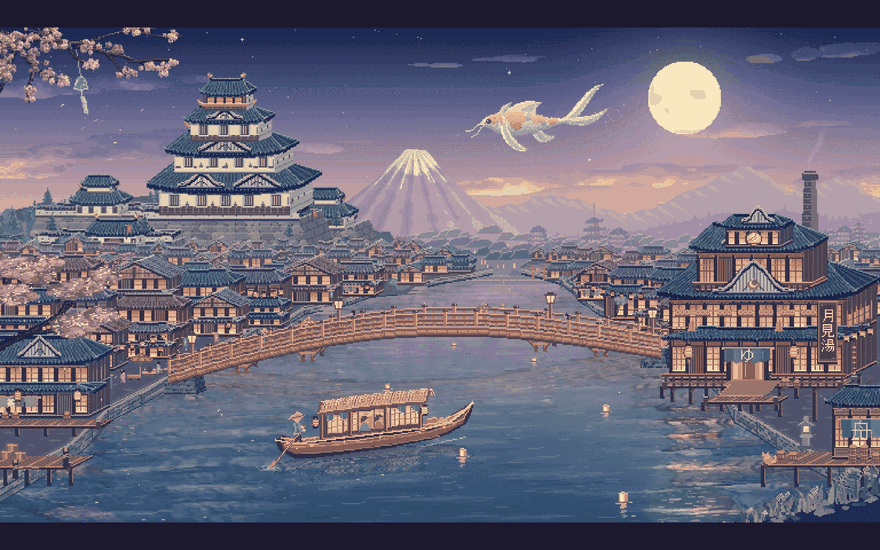
圖注:GPT-6.2 Astra Max 的 Tsukimi Moon Ferry,像素動畫 GIF,滿月下的日式河鎮(錄屏 2026-11-03)。
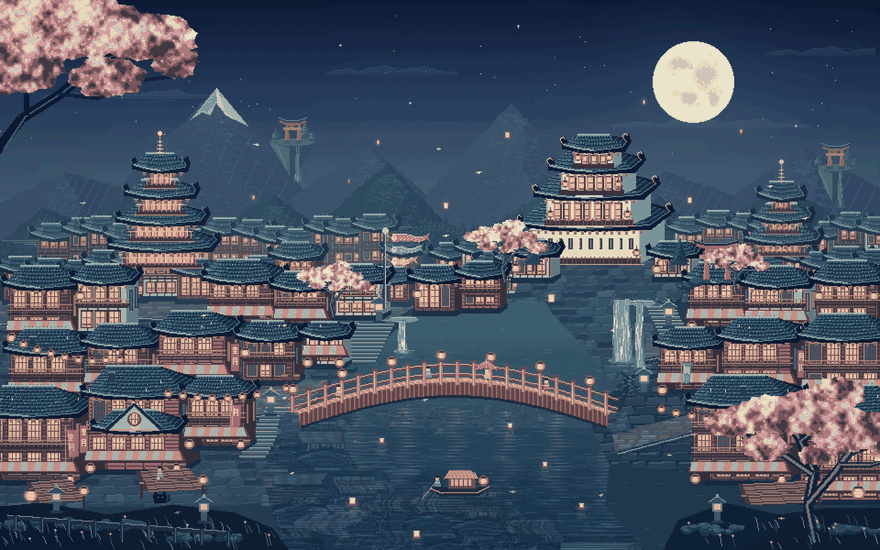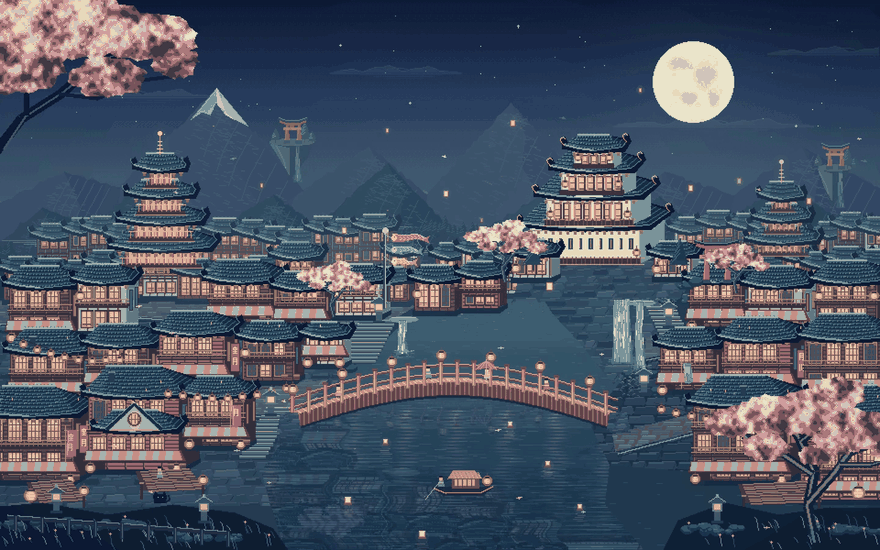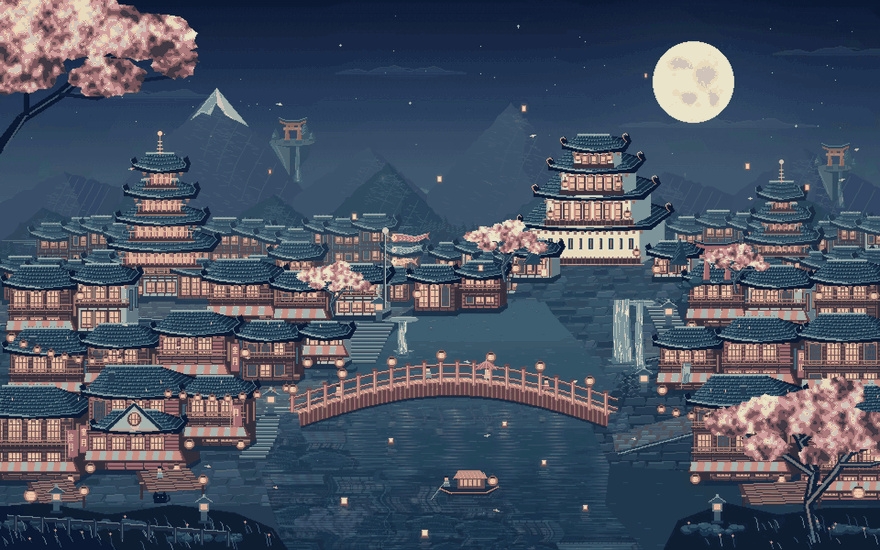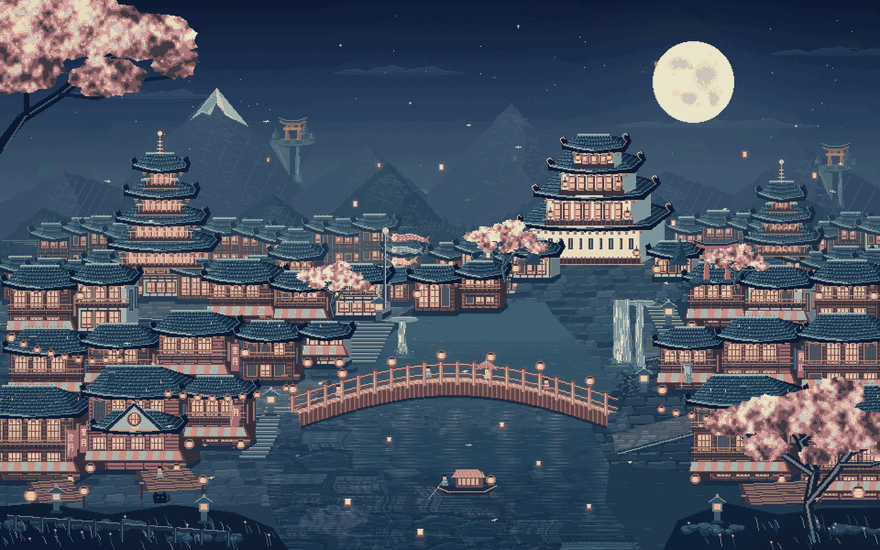
圖注:對照組,GPT-6 Astra Max 的 Hoshikawa,同站同風格,用來對照 6.2 的像素動畫(錄屏 2026-11-03)。
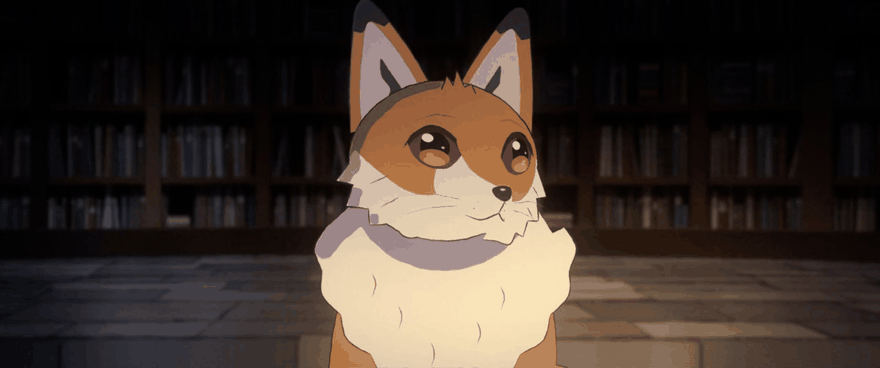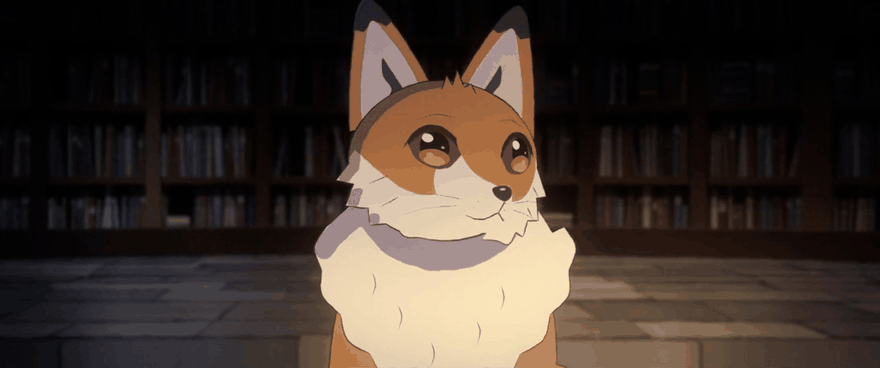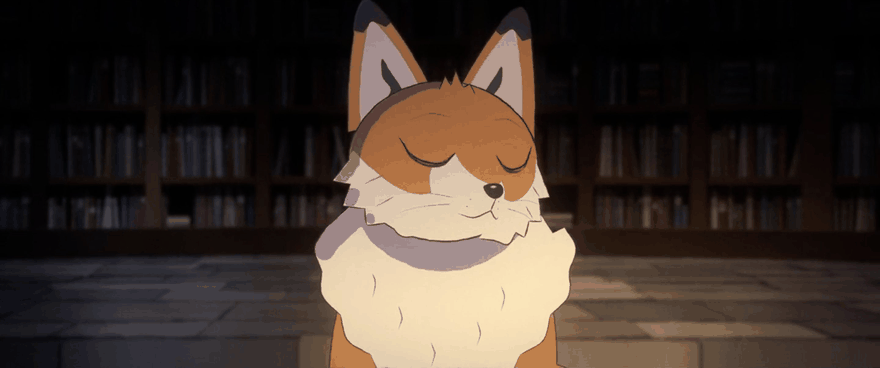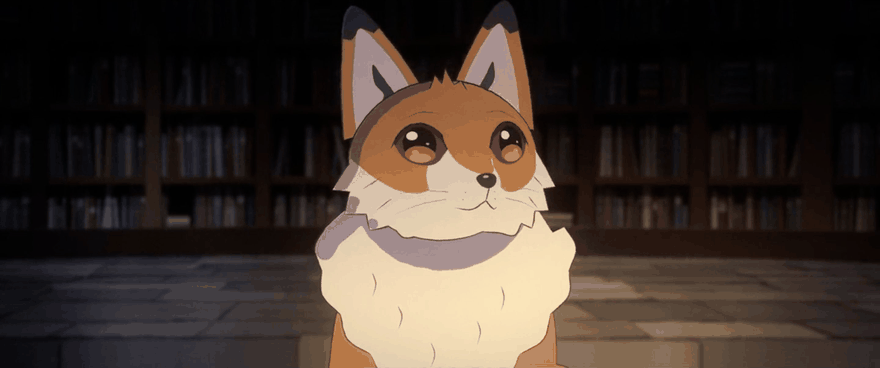
圖注:Fable 5.5 xhigh 的 66 秒有聲短片 The Last Page,狐狸在月光圖書館的一段(GIF 截取 2026-11-03,無聲音)。
站內唯一帶成本和耗時的是 Jelly Koi Pond。Fable 5.1 xhigh 版本約耗時 1 小時 40 分、成本 $25;Devin Fusion 組合(Fable 5.1 xhigh 加 Sonnet 5.5 med)約耗時 1 小時、成本 $11(日期 2026-10-21,證據等級:社區自述)。除這一條之外,站內沒有任何作品公開耗時或成本,本文也不做推算。
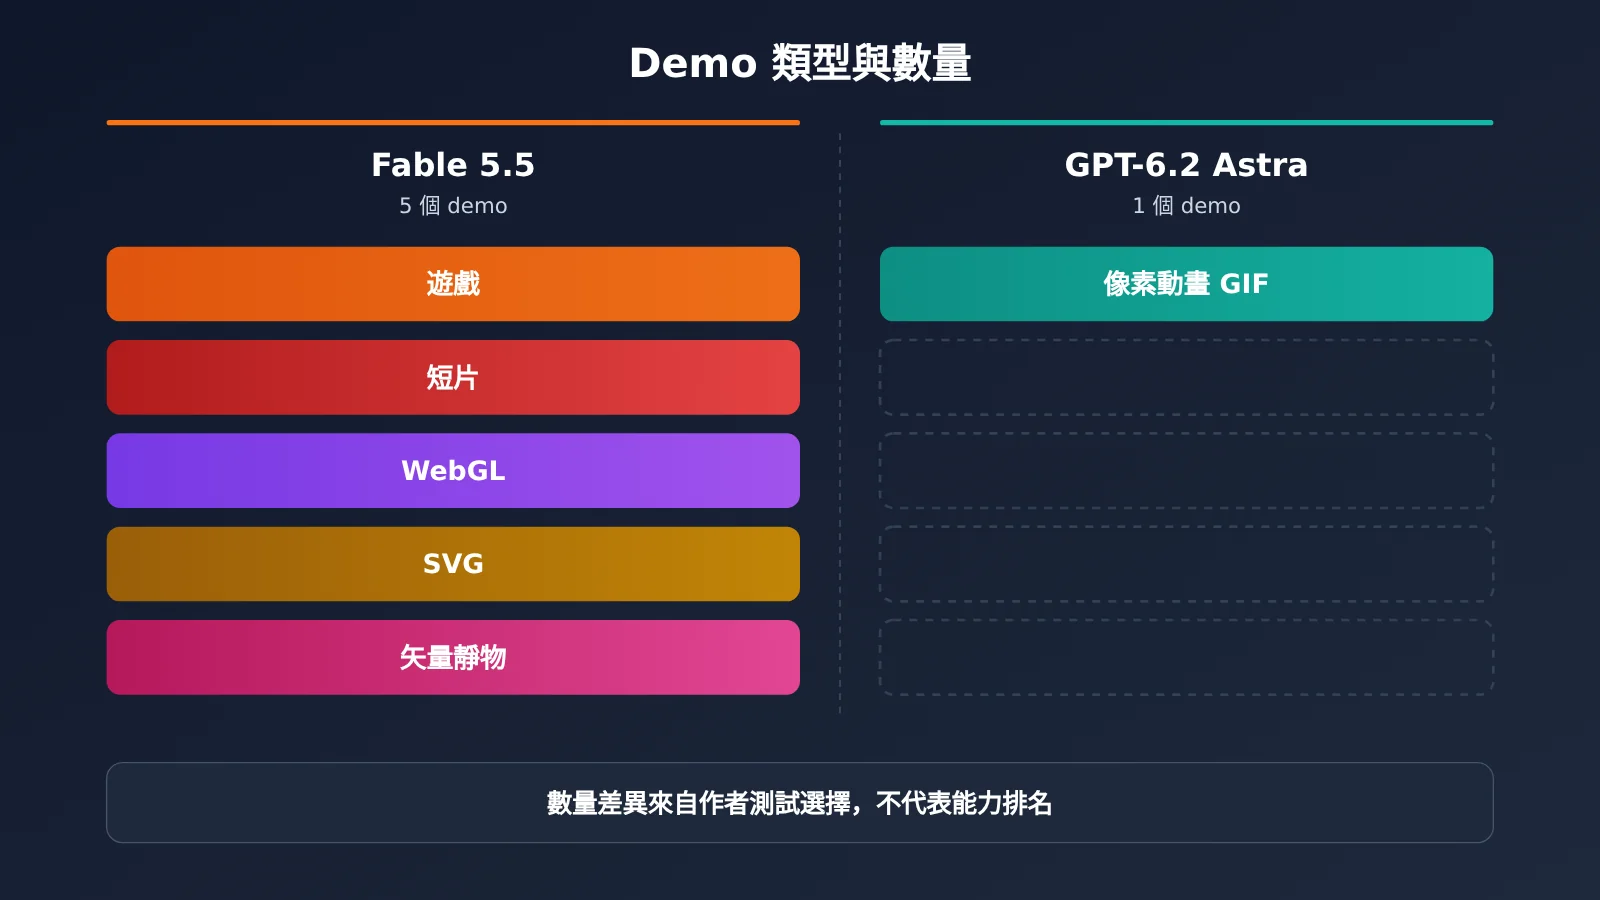
上圖展示的是 demo 類型和數量的分佈,不是能力排名。如果想在自己的任務上看兩家現役旗艦的真實差距,可以在 API易 apiyi.com 用同一個 Key 分別調用 claude-fable-5-1 和 gpt-6-astra。
Fable 5.5 vs GPT-6.2 Astra:三個“看起來公平其實不公平”的點
判斷:同一個站、同一個作者,容易讓人以爲這是一次橫評,實際上至少有三處不對等。
不公平點一:題目完全不同
Fable 5.5 的 5 個作品覆蓋遊戲、短片、WebGL、SVG 四類,GPT-6.2 Astra 只有像素動畫一類。沒有任何一道題兩者都做過。像素動畫考的是構圖和逐幀一致性,單文件遊戲考的是長代碼組織和狀態管理,兩者沒法互相換算。真要做縱向參考,GPT-6.2 Astra 只能對照同站的 GPT-6 Astra(Hoshikawa),Fable 5.5 只能對照 Opus 5.5(VoxelCraft — Shader Edition)。
不公平點二:推理檔位、日期、數量都不對等
Fable 5.5 的作品多數標註 xhigh,只有 Fruit Basket 是 max;GPT-6.2 Astra 標註的是 Max。不同檔位意味着推理預算不同,產出質量自然不能直接比。數量上也是 5 比 1,這只是作者選擇測什麼,不是官方評測結果。把 demo 數量當成能力強弱,是這次討論裏最常見的誤讀。
不公平點三:模型歸屬無法覈驗
所有 demo 都沒有公開提示詞、調用日誌或模型卡,模型歸屬完全依賴作者標註。ByteForward 在 11-02 的核查中提到,部分標註爲“Fable 5.5”的演示,可能是 Opus 5.5 請求被路由到新模型,模型選擇器裏仍顯示 Opus 5.5(證據等級:單一媒體報道)。在這個前提下,只能寫“作者自稱 Fable 5.5”,不能寫“Fable 5.5 做出了”。
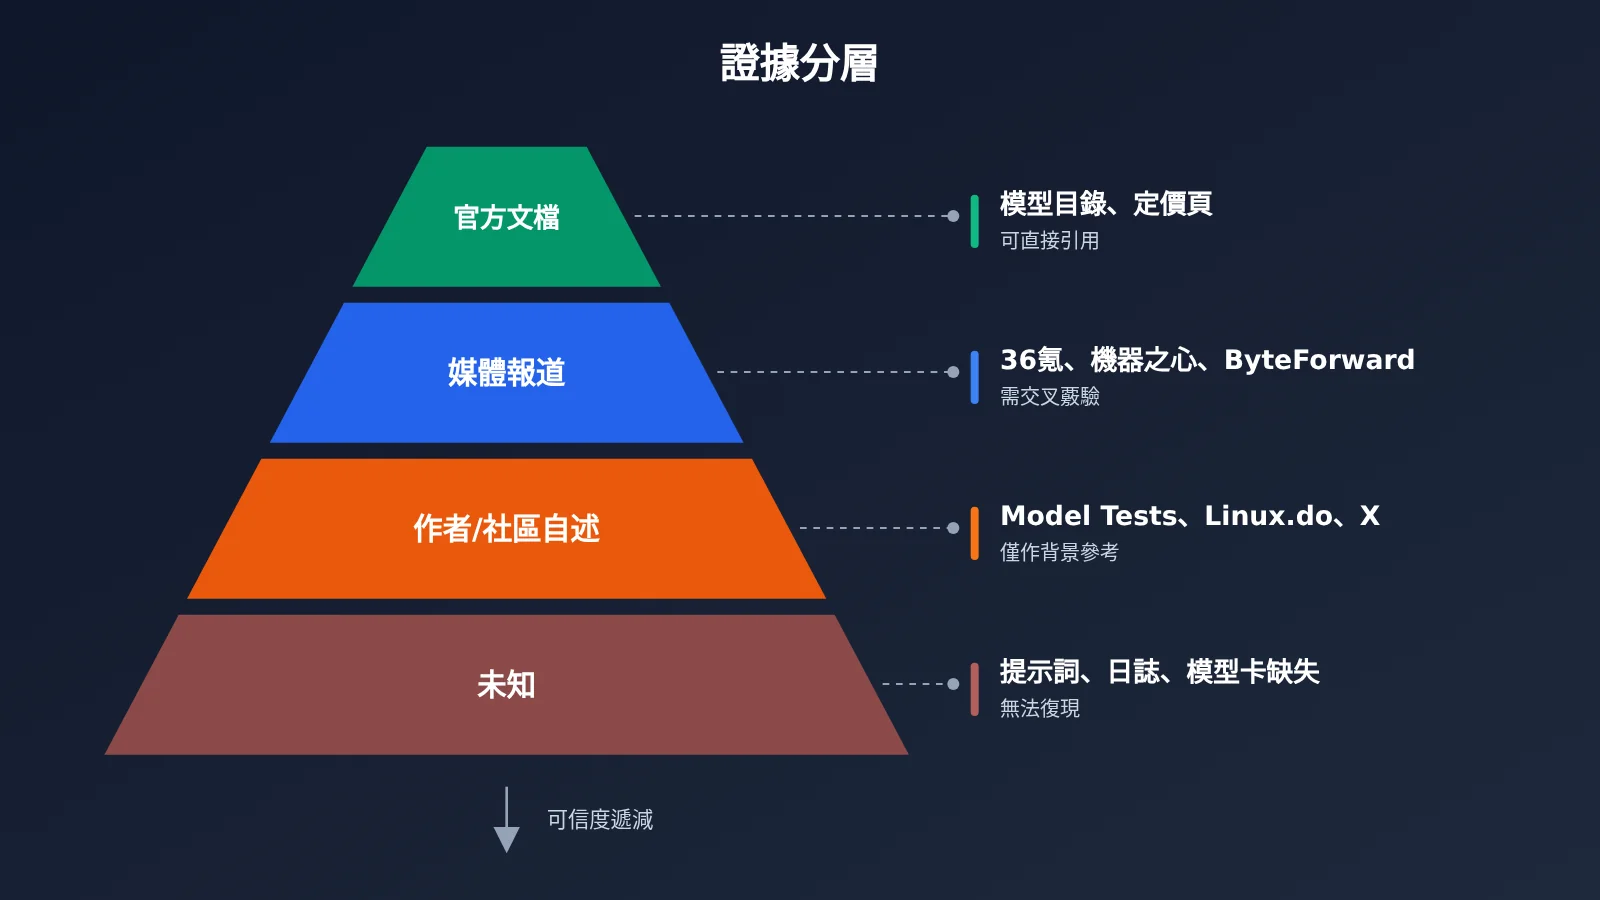
下表按證據等級整理目前和這兩個模型相關的說法。建議讀者在團隊內部轉述時,也保留證據等級這一列。
| 說法 | 來源 | 日期 | 證據等級 |
|---|---|---|---|
| Anthropic 目錄仍爲 Fable 5.1,無 Fable 5.5 | Anthropic 定價頁與新聞頁 | 11-03 讀取 | 官方文檔 |
| OpenAI 目錄仍爲 GPT-6 Astra,無 GPT-6.2 Astra | OpenAI 模型目錄 | 11-03 讀取 | 官方文檔 |
LiteLLM 加入 azure_ai/claude-fable-5-5 價目項 |
TestingCatalog 記錄 | 10-13 | 第三方記錄 |
| Fable 5.5 支持 1M 輸入、12.8 萬輸出 | 36 氪/新智元 | 11-02 | 單一媒體報道 |
| GPT-6.2 Astra 彙總評價“顯著躍升” | 機器之心/新浪 | 11-02 | 媒體彙總,無 benchmark |
| 用量明細中 gpt-6.2-astra 佔 1.6% | Linux.do @fourfour | 11-01 | 社區自述 |
| 用量明細中 gpt-6.2-astra 佔 19.8% | X @TokenGremlin | 11-01 | 社區自述 |
| Model Tests 上的 demo 模型歸屬 | 作者 @notjazii | 11-01 至 11-02 | 作者自稱 |
| 部分 Fable 5.5 demo 實爲 Opus 5.5 被路由 | ByteForward | 11-02 | 單一媒體報道 |
關於 GPT-6.2 Astra 的流量數據需要特別說明。Linux.do 帖子曬的是 10/25 到 10/31 的 Codex 用量分佈,97.7% 仍是 gpt-6-astra,gpt-6.2-astra 只佔 1.6%;同帖 13 行賬單裏有 12 行仍是 gpt-6-astra,速度在 44 到 73 tok/s 之間。X 上 TokenGremlin 曬出的版本是 19.8%,傳播更廣(約 15.5 萬瀏覽)。這兩個數字都是個人賬號截圖,不是官方數據。機器之心自己也寫明,截圖只能證明“有用戶報告獲得訪問權限”。另外,GPT-6.2 Betelgeuse / Bel 是更早流傳的另一個基座代號,和 6.2 Astra 不是同一回事。
社區體感也互相矛盾。有人認爲 Fable 5.5 更強,也有人認爲它和 Opus 5.5 打平;關於 GPT-6.2 Astra,有人說它不如 Opus 5.5,有人說只是增量改進,也有人說它多個維度超過 Opus 5.5。這些說法都沒有 benchmark 和樣本量,只能當作背景參考。
Fable 5.1 vs GPT-6 Astra 官方規格與價格對比
判斷:新模型還沒有官方規格,能對齊比較的只有現役旗艦。兩者單價相同,真正的差別在長輸入計費、知識截止和推理檔位。
Fable 5.1 和 GPT-6 Astra 的官方單價都是輸入 $10、輸出 $50(每百萬 tokens),最大輸出都是 128K,上下文是 1M 對 1.05M。下表數據來自兩家官方模型頁,讀取時間爲 2026-11-03,證據等級爲官方文檔。
| 規格項 | Fable 5.1 | GPT-6 Astra |
|---|---|---|
| 模型 ID | Anthropic 官方 Fable 5.1 | gpt-6-astra |
| 上下文窗口 | 1M | 1.05M |
| 最大輸出 | 128K | 128K |
| 知識截止 | 2026-06 | 2026-04-30 |
| 推理控制 | Adaptive thinking 常開,默認 effort 爲 high | low / medium / high / xhigh / max |
| 工具能力 | 以官方文檔爲準 | 函數調用、網頁搜索、文件搜索、computer use |
推理控制的差異會直接影響評測設計。Fable 5.1 的 Adaptive thinking 常開,默認 effort 爲 high;GPT-6 Astra 提供五檔可選。兩者的檔位命名不對應,所謂“同檔”只能儘量對齊,不能完全等價。評測時建議把檔位作爲記錄字段,而不是假設 high 等於 high。
價格方面,官方單價相同,但計費細節差別很大。下表同時列出官方價格和 API易 平臺的在架價格(每百萬 tokens,美元)。
| 計費項 | Fable 5.1 官方 | GPT-6 Astra 官方 | API易 apiyi.com 在架 |
|---|---|---|---|
| 輸入 | $10 | $10 | claude-fable-5-1 $10;gpt-6-astra 0 到 272,000 tokens 爲 $10 |
| 長輸入 | 1M 內維持 $10 | 以官方頁爲準 | gpt-6-astra 272,001 到 1,050,000 tokens 爲 $20 |
| 輸出 | $50 | $50 | 兩者均爲 $50 |
| 緩存命中/讀取 | $0.25 | 以官方頁爲準 | claude-fable-5-1 $0.25;gpt-6-astra $1 |
| 緩存寫入 | 5 分鐘 $12.50,1 小時 $20 | 以官方頁爲準 | 以平臺型號列表爲準 |
| 端點 | messages | responses、chat | claude-fable-5-1:chat / messages;gpt-6-astra:responses / chat |
對做長文檔分析、大型代碼庫理解的團隊來說,這張表比“誰更強”更有用。單次輸入超過 27.2 萬 tokens 時,gpt-6-astra 的輸入價會翻倍到 $20;claude-fable-5-1 在 1M 範圍內一直是 $10。緩存讀取價也差 4 倍($0.25 對 $1)。如果你的場景反覆調用同一份長上下文,這兩項差異在賬單上會很明顯。型號與價格以平臺型號列表爲準。
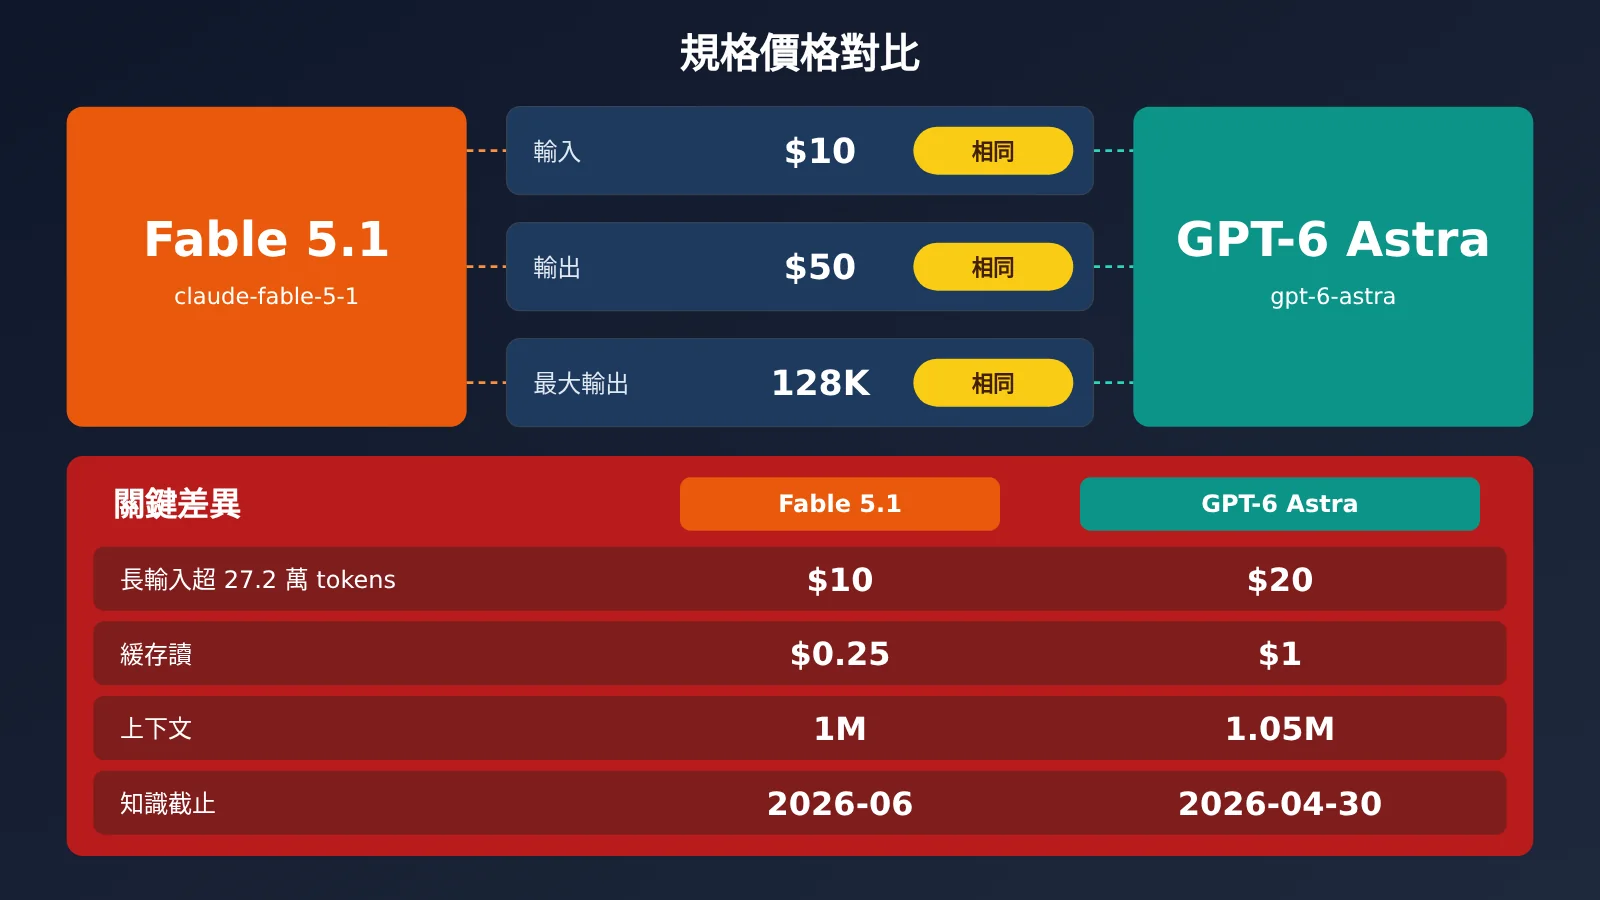
圖中價格來自官方模型頁和 API易 apiyi.com 平臺價格接口,讀取時間爲 2026-11-03。
Fable 5.5 與 GPT-6.2 Astra 上線前,現在能用什麼
判斷:新模型沒有官方 API,現在能做的是用兩家現役旗艦跑基線,把評測框架先搭起來。
截至 2026-11-03,API易 平臺的型號接口返回 259 個型號,價格接口共 277 個型號。其中包含 gpt-6-astra、gpt-6.1-sol、gpt-6.1-terra、gpt-6-luna 和 claude-fable-5-1,沒有 gpt-6.2-astra,也沒有 claude-fable-5-5。也就是說,兩家現役旗艦已經可以在同一個 Key 下同臺跑基線。同日用 claude-fable-5-1 發起一次 max_tokens 爲 32 的 messages 請求,返回 HTTP 200,接口可用。
接入方式和 OpenAI SDK 兼容。把 base_url 設爲 https://api.apiyi.com/v1,模型名分別填 claude-fable-5-1 和 gpt-6-astra 即可。如果需要 Anthropic 原生的 messages 格式,claude-fable-5-1 同樣支持;gpt-6-astra 則可以走 responses 或 chat 端點。
🚀 快速開始:在 API易 apiyi.com 註冊後使用新用戶免費測試額度,先用 3 到 5 條任務試跑
claude-fable-5-1和gpt-6-astra,確認輸出格式和 token 記錄都正常,再擴展到完整題庫。
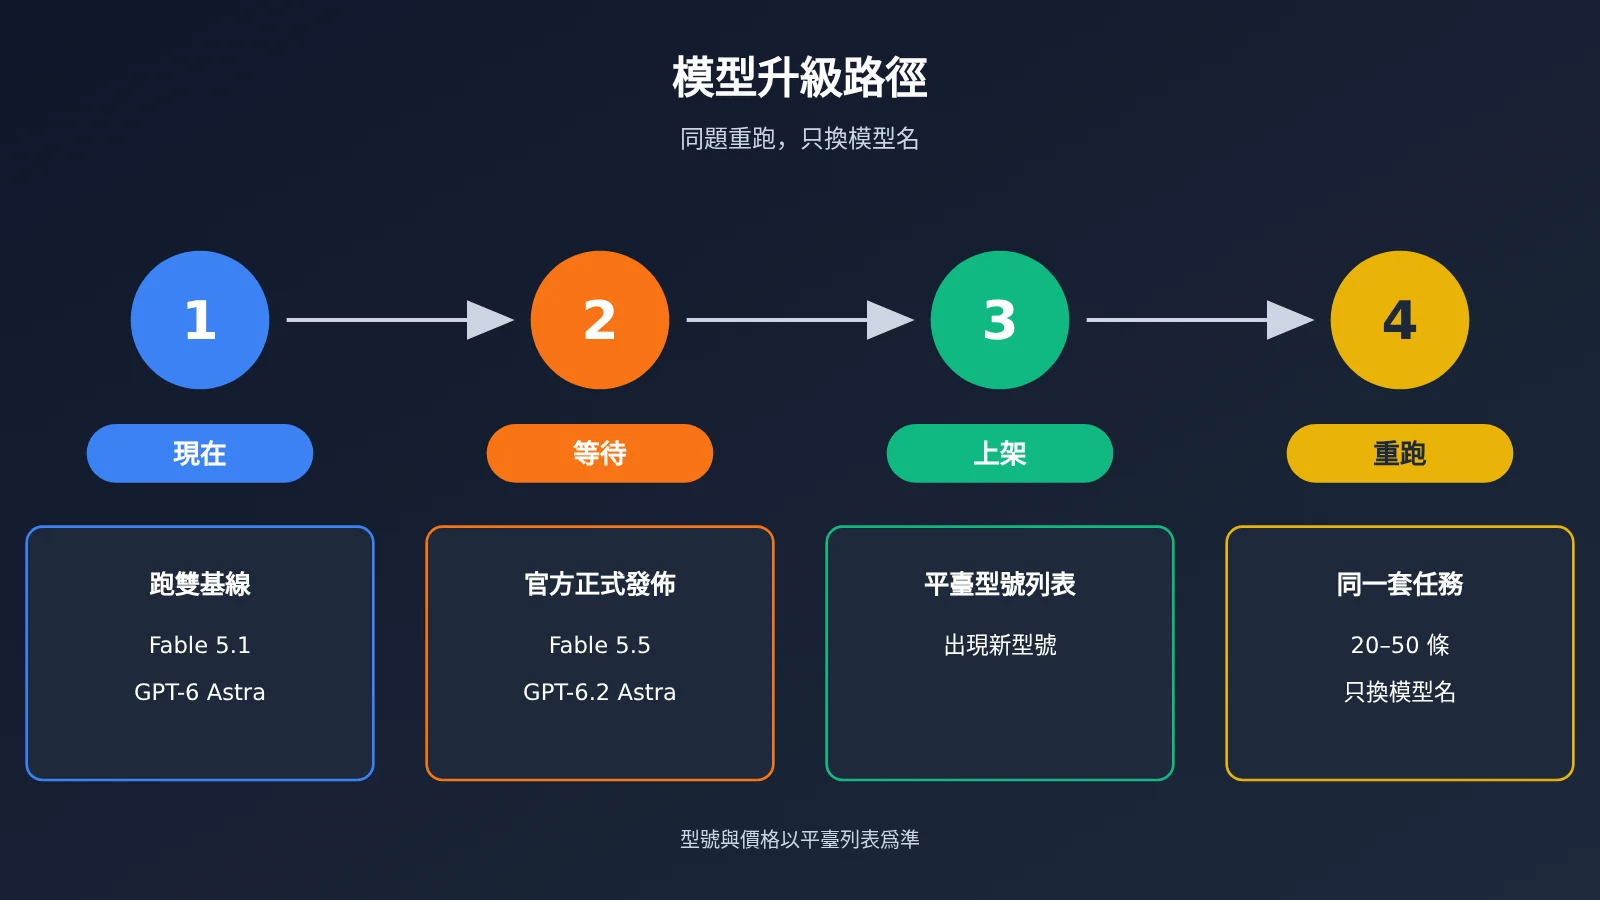
這一步的價值不在於提前知道新模型的表現,而在於提前準備好題庫、評分標準和記錄表。等 Fable 5.5 或 GPT-6.2 Astra 正式上線,團隊只需要改一個模型名,就能在一兩天內拿到自己場景下的結論,不必再依賴別人的 demo 和截圖。
Fable 5.5 vs GPT-6.2 Astra 怎麼選、怎麼測
判斷:現在不必等新模型,先用現役旗艦定基線;選型結論應該來自自己的 20 到 50 條任務,而不是公開 demo。
截至 2026-11-03,Fable 5.5 與 GPT-6.2 Astra 都還沒在 API易 上架,模型一旦發佈,我們會盡快上架這兩個模型;型號與價格以平臺型號列表爲準。在此之前,可以按下面的場景先做初步判斷:
- 長文檔、大代碼庫、重複長上下文:優先評估
claude-fable-5-1。1M 內輸入價不變,緩存讀取只要 $0.25,成本更可預測。 - 需要細調推理預算、依賴網頁搜索或 computer use:優先評估
gpt-6-astra。五檔推理可選,官方列出的工具能力更完整。 - 前端單文件、創意可視化類任務:兩邊都有參考作品,但都是作者自稱,只能當靈感來源,必須用自己的題目驗證。
- 對知識時效敏感:Fable 5.1 的知識截止爲 2026-06,GPT-6 Astra 爲 2026-04-30,差距約兩個月,可結合檢索工具彌補。
自有評測的搭建方法
評測的核心是“固定一切,只換模型名”。具體步驟如下:
- 從真實業務中抽取 20 到 50 條任務,覆蓋代碼、長文檔、結構化輸出等主要類型,每條寫明通過標準。
- 固定系統提示詞、用戶提示詞、最大輸出 token 和推理檔位;Fable 5.1 記錄 effort,GPT-6 Astra 記錄檔位名稱。
- 每條任務記錄 input tokens、output tokens、端到端耗時,以及人工判定是否通過。
- 單獨標出輸入超過 27.2 萬 tokens 的任務,按實際階梯價計算成本。
- 先跑
claude-fable-5-1和gpt-6-astra兩條基線;等新模型上線後,只換模型名,用同一套題重跑。
記錄表建議至少包含以下字段,方便後續橫向和縱向對比:
| 字段 | 記錄內容 | 用途 |
|---|---|---|
| 任務 ID 與類型 | 代碼 / 長文檔 / 結構化等 | 按場景拆分通過率 |
| 模型名與推理檔 | 如 gpt-6-astra high |
保證重跑時條件一致 |
| input / output tokens | 平臺返回的 usage | 計算真實單題成本 |
| 耗時 | 從請求到完整返回 | 評估交互體驗 |
| 人工通過 | 是 / 否 + 原因 | 最終質量指標 |
💡 選擇建議:同一個 Key 下跑兩家模型,可以避免多賬號帶來的網絡、限流差異干擾結果。通過 API易 apiyi.com 統一調用,記錄的 usage 字段格式一致,彙總表更容易對齊。
常見問題與行動建議
Q1:Model Tests 上的 demo 能說明 Fable 5.5 比 GPT-6.2 Astra 強嗎?
不能。兩者沒有做過同一道題,推理檔位、日期和作品數量也不同,模型歸屬又是作者自稱。它最多說明,按作者的說法,兩邊都能產出可運行或可觀看的成品。
Q2:Fable 5.5 和 GPT-6.2 Astra 發佈了嗎?什麼時候能用?
截至 2026-11-03,兩家官方模型目錄裏都沒有這兩個型號,也沒有可靠的發佈日期。截至 2026-11-03,Fable 5.5 與 GPT-6.2 Astra 都還沒在 API易 上架,我們會盡快上架這兩個模型;型號與價格以平臺型號列表爲準。上架後可以直接在 API易 apiyi.com 的型號列表裏查到。
Q3:19.8% 的流量截圖可信嗎?
它來自 X 用戶 TokenGremlin 的個人截圖,更早的 Linux.do 帖子顯示只有 1.6%,而且模型選擇器仍顯示 GPT-6 Astra,不同用戶的報告也不一致。兩個數字都是社區自述,不是官方數據,只能說明部分賬號的用量明細出現過這個型號名。
Q4:現在應該等新模型,還是先用現役旗艦?
建議先用現役旗艦。Fable 5.1 和 GPT-6 Astra 單價相同,能力都在一線,現在就能用於生產。更重要的是先把評測題庫搭起來,新模型上線時就能快速得出結論。在 API易 apiyi.com 可以用免費測試額度先跑小樣本,驗證評測流程。
Q5:兩家現役旗艦價格一樣,成本還會有差別嗎?
會。`gpt-6-astra` 單次輸入超過 272,000 tokens 後,輸入價從 $10 漲到 $20;緩存讀取 $1,而 `claude-fable-5-1` 爲 $0.25。長上下文、高緩存命中的場景差異最明顯,建議按真實 token 分佈計算。
行動建議
對本月正在做選型的團隊,建議按三步走:本週從業務中整理 20 到 50 條任務和通過標準;接着在 API易 apiyi.com 用同一個 Key 跑 claude-fable-5-1 與 gpt-6-astra 雙基線,記錄 token、耗時和人工通過率;等 Fable 5.5 或 GPT-6.2 Astra 正式發佈並上架後,只換模型名重跑同一套題。到那時,你手裏會有一份基於自己任務、條件一致的對比數據,比任何 demo 或截圖都更可靠。型號與價格以平臺型號列表爲準。
參考資料
- OpenAI 模型目錄:GPT-6 Astra 官方規格與價格
- 鏈接:
developers.openai.com/api/docs/models - 說明:2026-11-03 讀取,目錄中無 GPT-6.2 Astra
- Anthropic 平臺定價與模型頁:Fable 5.1 官方規格、價格與緩存計費
- 鏈接:
platform.claude.com - 說明:2026-11-03 讀取,定價頁與新聞頁中無 Fable 5.5
- Model Tests 第三方測試站:作者 @notjazii 的公開 demo 合集
- 鏈接:
model-tests.vercel.app - 說明:模型歸屬爲作者自稱,無提示詞與調用日誌
作者:APIYI 技術團隊
技術交流:歡迎訪問 API易 apiyi.com 首頁聯繫我們,型號與接入文檔可在 docs.apiyi.com 查閱