Claude Fable 5.2 於 2026 年 11 月 9 日發佈,標準 API 單價比 5.1 低 20%。
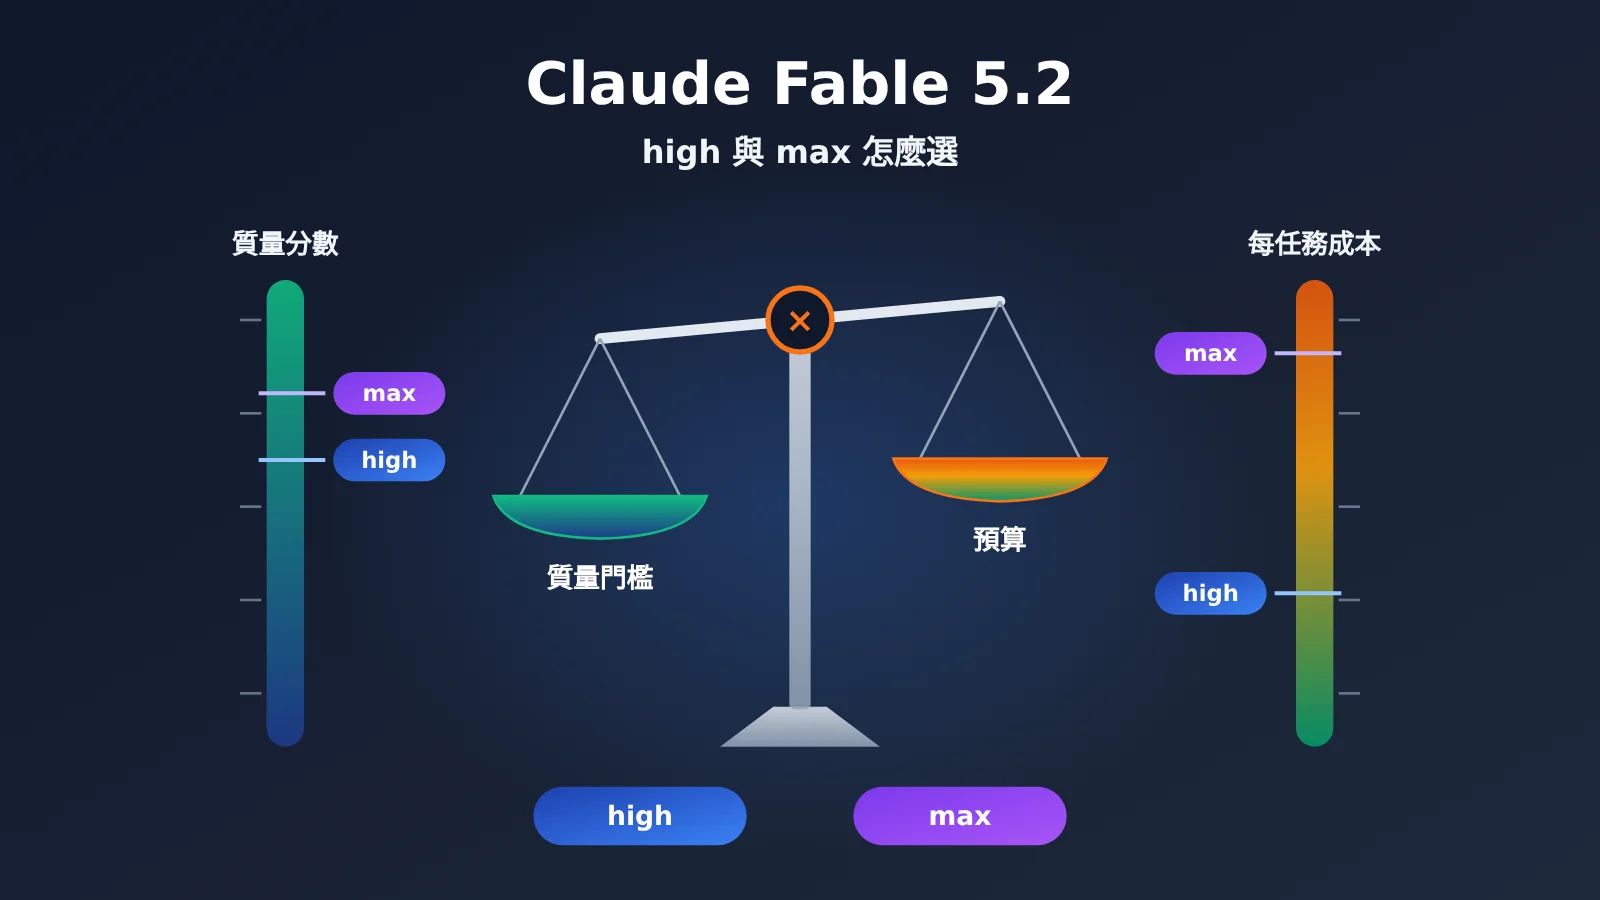
很多團隊隨即會問:既然變便宜了,能不能直接開到 max?
本文把 Fable 5.2 high 和 Fable 5.2 max 放在同一個框架下比較,同時看質量和每任務成本。
核心價值:讀完本文,你會知道 Fable 5.2 的 high 和 max 分別在什麼條件下適用,也能拿到一份可以直接用來做升級驗收的記錄清單。
目錄
- to know:Fable 5.2 檔位選擇相關術語
- 1 Fable 5.2 的 high 和 max 改變的不是同一個單價
- 2 在同一張表內看 Fable 5.2 質量與成本
- 3 用獨立機構數據檢查 Fable 5.2 檔位趨勢
- 4 按任務用途選擇 Fable 5.2 檔位
- 5 用自己的驗收決定 Fable 5.2 是否升級到 max
- 常見問題 FAQ / Key Takeaways / 總結
to know
| 術語 | 含義 | 閱讀本文時要注意 |
|---|---|---|
| Effort | 控制模型思考投入的設置 | Fable 5.2 的 API 默認值爲 high |
| Adaptive thinking | 模型自動分配思考量的機制 | Fable 5.2 中始終開啓 |
| Harness | 給模型提供工具、會話和執行規則的運行環境 | Cursor 與 AA 的 Harness 不同 |
| Intelligence Index | AA 將多項評測加權得到的綜合指數 | 是指數,不是正確率 |
| 百分點 | 兩個百分數相減得到的絕對差 | 56.9% 到 60.0% 是 3.1 個百分點 |
| 每任務成本 | 在某個測試條件下分攤到單個任務的模型費用 | 不等於你的 API 賬單 |
| 驗收門檻 | 任務必須達到的質量要求 | 先過門檻,再比較預算 |
| 任務分層 | 按難度和失敗代價給任務分組 | 不同層級適用不同檔位 |
1 Fable 5.2 的 high 和 max 改變的不是同一個單價
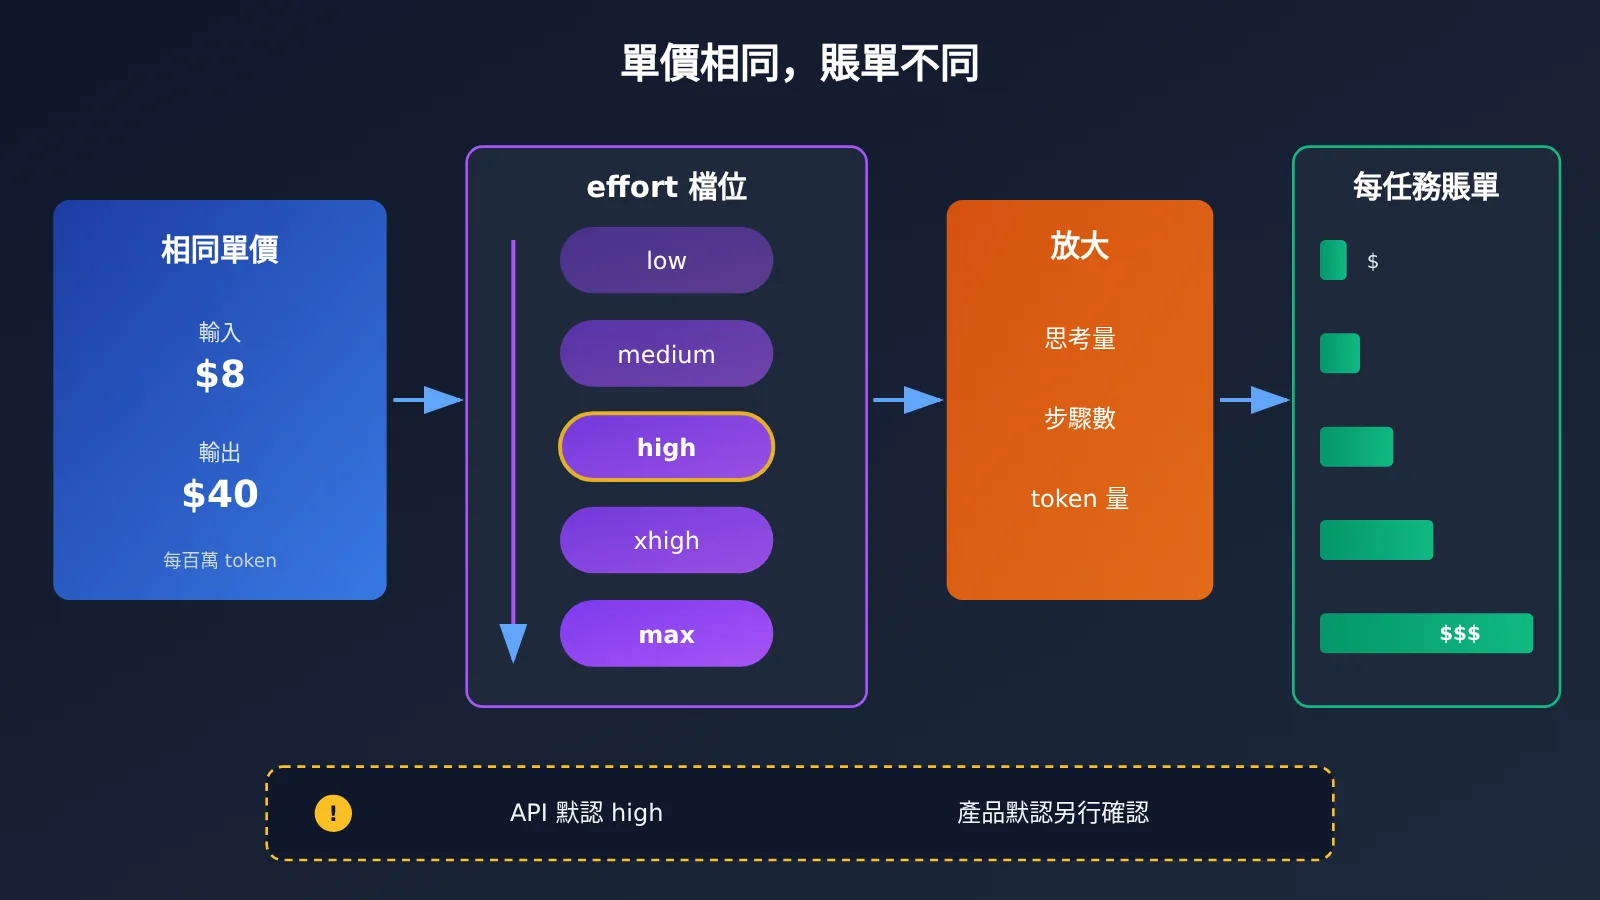
不少人以爲檔位越高,單價越貴。實際上,在 Anthropic 官方標準費率下,Fable 5.2 的輸入是每百萬 token 8 美元,輸出是每百萬 token 40 美元,這個單價不隨檔位變化。
effort 改變的是模型在一個任務上投入多少思考,以及走多少步、耗多長時間、消耗多少 token。所以單價相同,任務賬單可以差好幾倍。
Fable 5.2 檔位如何影響賬單
在 Fable 5.2 中,自適應思考始終開啓,effort 決定的是思考投入的上限和傾向。檔位提高後,模型通常會做更多推理和工具調用,計費 token 隨之增加。
同樣是 10 萬輸入 token,如果輸出從 2 萬 token 增加到 4 萬 token,5.2 標準模式的費用會從 1.60 美元升到 2.40 美元,反而比 5.1 在原用量下的 2 美元還高。
另外要分清兩種”默認值”。官方模型文檔寫明 API 默認 effort 爲 high。Cursor 這類產品有自己的配置層,例如它的默認上下文是 300K,與 API 文檔中的 1M 規格不在同一層面。
還有一點:官方提示指南提醒,同名檔位在不同版本里的思考量可能不同,5.1 時期的檔位經驗不能原樣沿用到 5.2。
2 在同一張表內看 Fable 5.2 質量與成本
CursorBench 4.0 是 Cursor 在自有任務和工具環境中做的評測,不屬於通用獨立複測,但它把五個檔位放在同一個 Harness 下比較,適合觀察各檔位之間的相對變化。以下數據讀取於 2026 年 11 月 10 日。
| Fable 5.2 檔位 | 得分 | 每任務成本(美元) | tokens(聚合字段) | 步數 |
|---|---|---|---|---|
| Low | 53.2% | 3.94 | 36,616 | 30 |
| Medium | 54.8% | 4.66 | 44,103 | 35 |
| High | 56.9% | 9.70 | 99,259 | 69 |
| Extra High | 56.3% | 15.48 | 161,251 | 108 |
| Max | 60.0% | 32.79 | 352,794 | 218 |
注:tokens 列是基準頁面的聚合字段,不能理解爲只包含輸出量。來源:CursorBench 4.0。
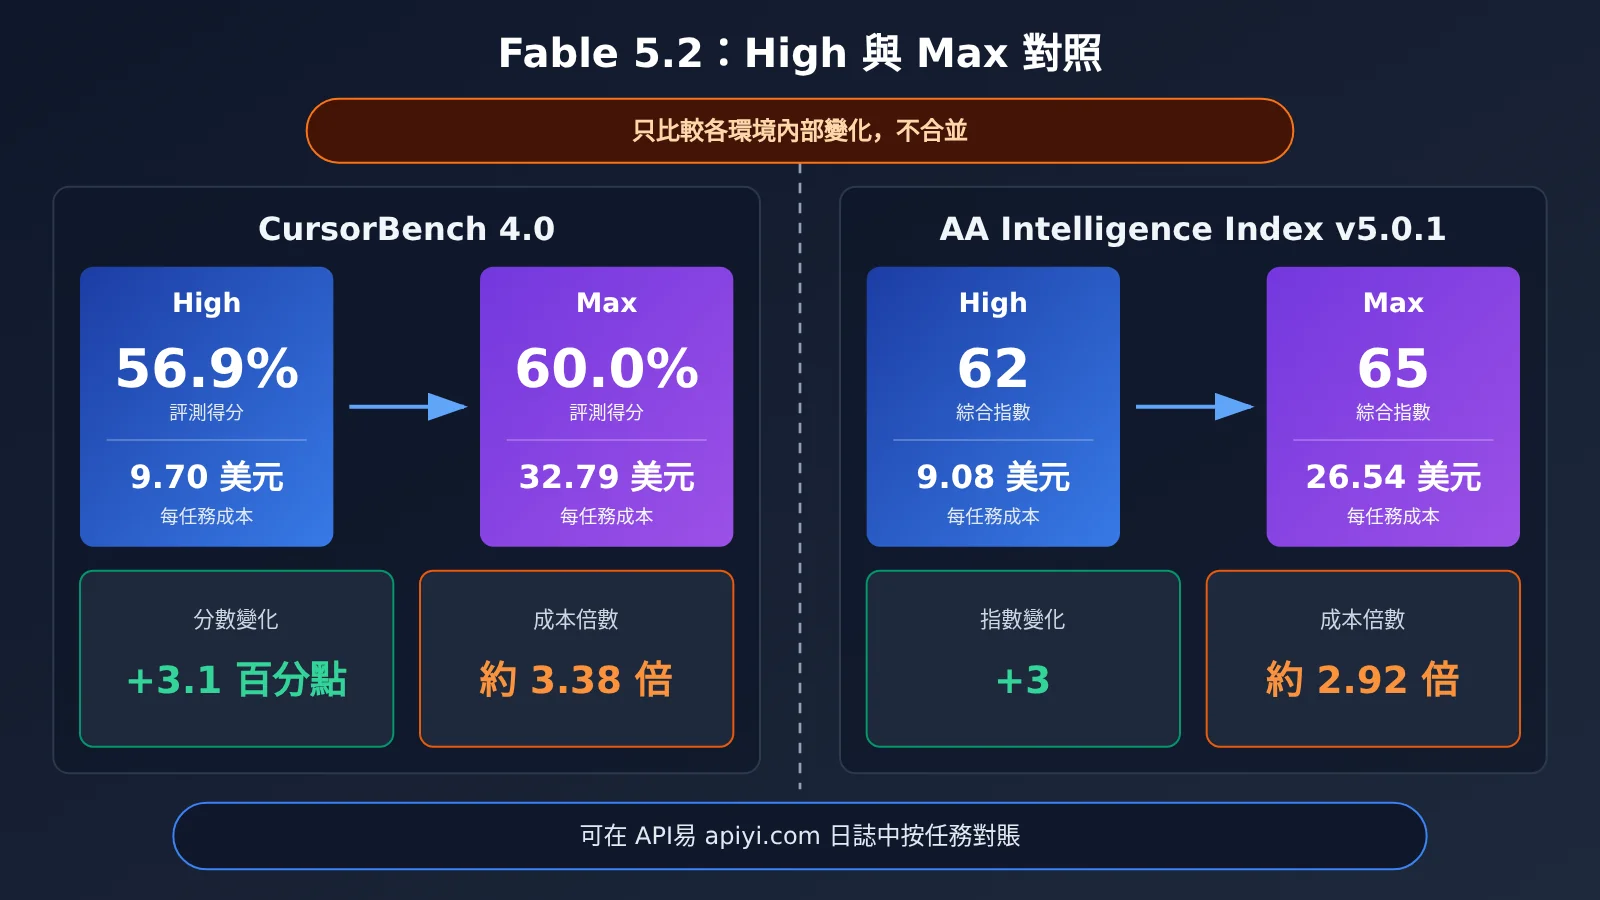
Fable 5.2 high 到 max:3.1 個百分點與約 3.38 倍成本
在這張表裏,High 到 Max 的得分從 56.9% 升到 60.0%,提高了 3.1 個百分點。每任務成本從 9.70 美元升到 32.79 美元,約爲 3.38 倍,即增加了約 238%。
按本文計算,tokens 字段增加到約 3.55 倍,步數從 69 步增加到 218 步,約 3.16 倍。成本上漲主要來自思考和執行步驟的增加,與單價無關。
這組數據只能說明,在這個環境裏更高得分伴隨着明顯更高的花費。
Extra High 的反常結果怎麼讀
表中還有一個值得注意的現象:Extra High 比 High 貴約六成,得分卻低 0.6 個百分點。
💡 選擇建議:同一張表裏,檔位之間的差距纔可以比較;不同評測之間的數字不能拼在一起。如果你想在自己的任務上覆現類似對照,可以通過 API易 apiyi.com 的統一接口和調用日誌做對賬,前提是先確認平臺當日的模型 ID 與檔位支持情況。
3 用獨立機構數據檢查 Fable 5.2 檔位趨勢
只看一個評測環境,結論容易受環境本身影響。AA 是獨立評測機構,它的榜單可以用來檢查 Cursor 中觀察到的趨勢是否也出現在另一個環境裏。以下爲 2026 年 11 月 10 日的動態快照,方法版本爲 Intelligence Index v5.0.1。
| 配置 | Intelligence Index | 每任務成本(美元) |
|---|---|---|
| Fable 5.2 medium | 56 | 3.80 |
| Fable 5.2 high | 62 | 9.08 |
| Fable 5.2 xhigh | 62 | 14.83 |
| Fable 5.2 max | 65 | 26.54 |
| Opus 5.5 max | 59 | 10.04 |
65 不是 65% 正確率
AA 方法頁說明,v5.0.1 版指數由 9 項評測組成,四類能力各佔 25%。所以 65 是綜合指數分數,不是 65% 的正確率。在 AA 環境中,high 到 max 指數增加 3,每任務成本約爲 2.92 倍。high 和 xhigh 都是 62,只代表綜合分相同,不代表兩者逐任務的行爲完全一致。
兩個環境只能各自內部比較
兩個環境都呈現”max 分數更高、成本約爲 high 的 3 倍左右”的方向,這可以作爲趨勢上的相互印證。但 AA 和 Cursor 的任務、評分方式和成本算法都不同,不能把 AA 的 65 和 Cursor 的 60.0% 合併成一個正確率。
4 按任務用途選擇 Fable 5.2 檔位
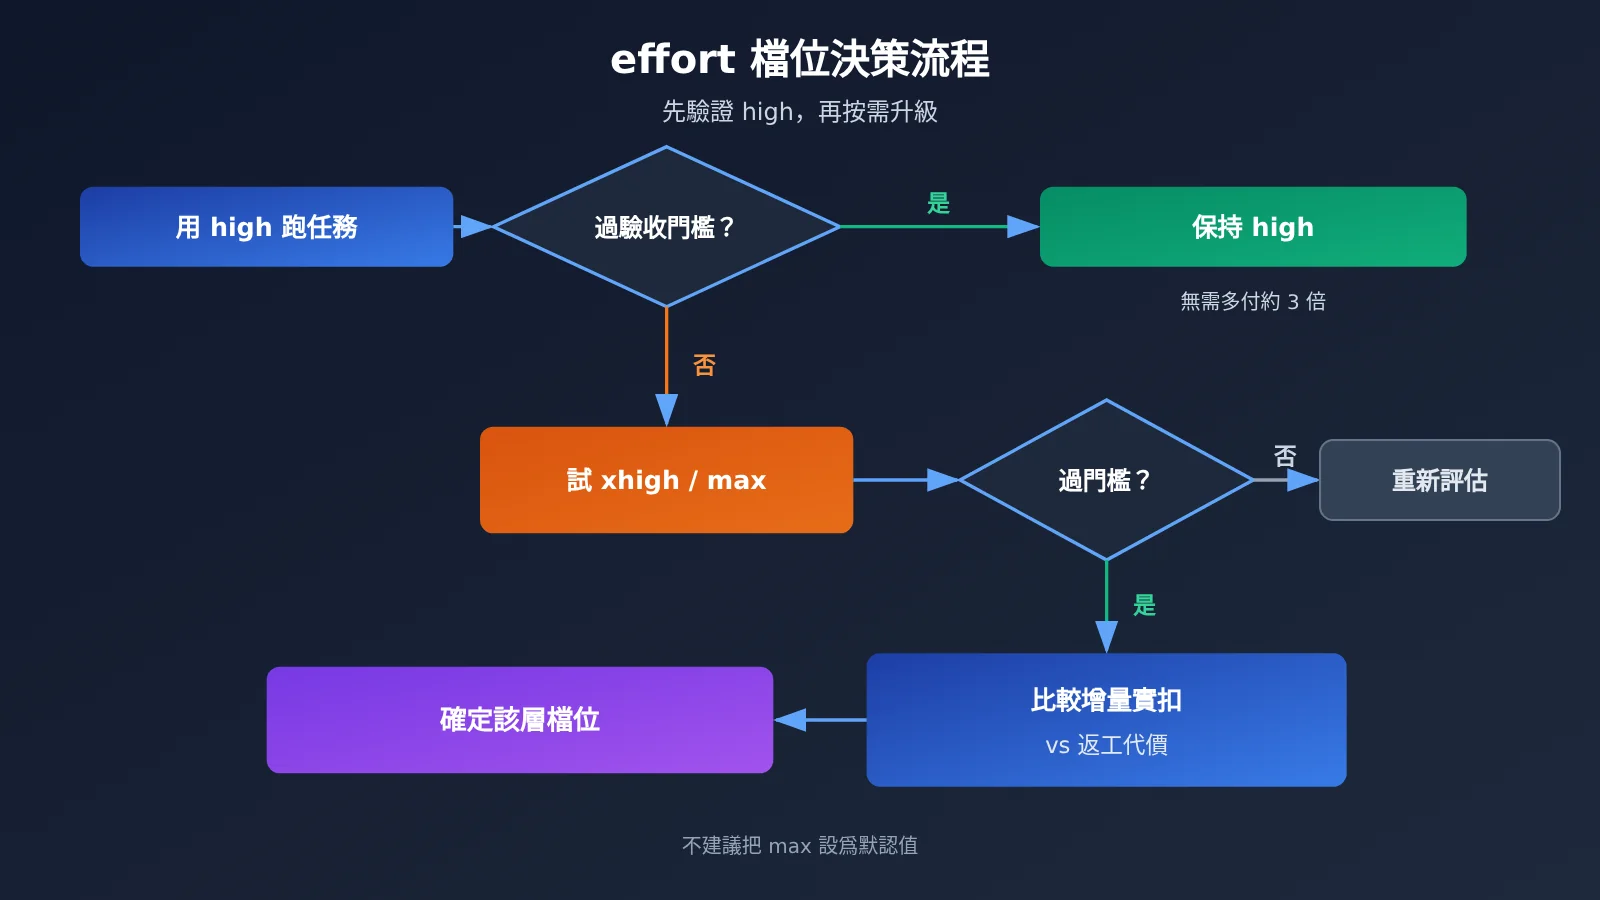
官方提示指南給出了一套起步邏輯:API 從默認的 high 開始,根據自己的評估結果上調或下調;medium 偏向交互場景;xhigh 留給已經證明有額外收益的困難長任務;max 用於能力上限評估,或時間與 token 都不重要的少數任務。低檔位還要注意任務提前結束的風險。
Fable 5.2 場景推薦表
下面三種情景是假設情景,用來說明選擇思路。
| 假設情景 | 建議起點 | 何時考慮上調 | 不建議的做法 |
|---|---|---|---|
| 需求變更(改字段、調接口、補測試) | Medium 評估,必要時 High | Medium 出現提前結束或遺漏改動 | 爲小改動默認開 max |
| 複雜修復(跨模塊 bug、併發問題) | High | High 的通過率達不到驗收門檻 | 未驗證就直接跳到 xhigh |
| 長程研究(開放問題、方案探索) | High 起步 | 問題價值高、失敗代價大,且已用評估證明 max 有收益 | 把 max 設爲全量請求默認 |
選擇 Fable 5.2 high 的場景
- 大多數需要較強推理的 API 任務,並且已有明確的驗收標準;
- 團隊尚未建立檔位評估體系,需要一個官方推薦的起點;
- 請求量大、對單任務成本敏感的生產鏈路。
選擇 Fable 5.2 max 的場景
- 評估模型在某類問題上的能力上限;
- 少數失敗代價遠高於模型費用的開放問題;
- 已經用自己的樣本證明 max 能把通過率提到門檻以上,而 high 做不到。
🎯 技術建議:檔位選擇以任務分層爲單位,不需要爲每個請求單獨決定。官方推薦的最佳實踐是先用 high 跑通一批代表性任務。如果打算通過 API易 apiyi.com 統一接入,正式開跑前應先在平臺確認當日的模型 ID、分組、端點以及 effort 支持情況。
5 用自己的驗收決定 Fable 5.2 是否升級到 max
公開評測只能告訴你趨勢,是否值得升級要由你自己的驗收結果決定。下面的記錄清單可以直接使用,核心原則是每次只改變檔位這一個變量。
| 記錄項 | 要求 |
|---|---|
| 任務與輸入 | 同一批任務、同一份輸入、同一個 system 提示詞 |
| 工具權限 | 工具集與權限完全一致 |
| 模型與檔位 | 記錄模型 ID 與 effort,每輪只改檔位 |
| 通過標準 | 事先寫好驗收門檻,不在看到結果後再調整 |
| usage | 輸入、緩存寫入/讀取、輸出分開記錄 |
| 耗時與重試 | 記錄總耗時、重試次數、提前結束次數 |
| 實扣 | 以平臺日誌實扣爲準,不用官方費率估算代替 |
| 失敗案例 | 保留原始輸出,分析 max 修好了哪些問題 |
Fable 5.2 快速上手:先記錄 usage
下面的極簡示例只演示如何發起調用並記錄 usage。本文不提供 effort 參數的透傳寫法:Fable 5.2 是否已在平臺上線、effort 是否支持透傳,都需要以平臺當日文檔爲準。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # 填寫平臺當日確認可用的模型 ID
    messages=[{"role": "user", "content": "按驗收標準修復以下函數……"}]
)
print(resp.usage)  # 記錄 usage,用於後續對賬
查看完整記錄與對賬代碼
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Anthropic 官方標準費率(美元/百萬 token),僅用於估算,不代表實扣
RATE_IN, RATE_OUT = 8.0, 40.0

def run_task(task_id: str, prompt: str, model: str, effort_label: str, passed_fn):
    """跑一個任務並返回一條驗收記錄。effort_label 只是記錄用的標籤。"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}]
    )
    text = resp.choices[0].message.content
    u = resp.usage
    est_usd = u.prompt_tokens / 1e6 * RATE_IN + u.completion_tokens / 1e6 * RATE_OUT
    return {
        "task_id": task_id,
        "model": model,
        "effort": effort_label,
        "passed": passed_fn(text),          # 事先寫好的驗收函數
        "prompt_tokens": u.prompt_tokens,
        "completion_tokens": u.completion_tokens,
        "est_usd": round(est_usd, 4),       # 估算值
        "seconds": round(time.time() - start, 1),
        "output": text,                     # 保留失敗案例原文
    }

def quota_to_usd(quota: int) -> float:
    """平臺日誌中 quota ÷ 500000 即美元實扣。"""
    return quota / 500000
API易 的日誌文檔列出了 model_name、prompt_tokens、completion_tokens、quota、duration_for_view、request_id 等字段,其中 quota÷500000 就是美元實扣,other 字段包含分組倍率等補充信息。用 request_id 把驗收記錄和日誌關聯起來,就能按”通過的任務”計算實際花費,而不是隻看單次請求的費用。
🚀 快速開始:如果想先用小樣本驗證流程,可以在 API易 apiyi.com 註冊後使用新用戶免費測試額度,跑通”同任務、單變量、記實扣”這套記錄方法,再決定是否擴大樣本。
最終判斷原則是:先看 high 是否滿足質量門檻。滿足的話,就不需要爲高出的那幾個百分點支付約 3 倍的費用。只有 high 達不到門檻、max 能達到時,纔去比較 max 多出的成本是否低於失敗或返工的代價。不建議把 max 設爲所有請求的默認值。
常見問題 FAQ
Q1: Claude Fable 5.2 的 effort 檔位是什麼?
effort 是控制模型思考投入的設置,可選檔位從 low 到 max。它不改變 token 單價,改變的是思考量、步驟數、耗時和 token 用量,因此同一任務在不同檔位下的賬單可能相差數倍。API 默認檔位是 high。
Q2: Fable 5.2 high 和 max 差多少?
在 CursorBench 4.0 中,high 爲 56.9%、9.70 美元,max 爲 60.0%、32.79 美元,相差 3.1 個百分點,成本約爲 3.38 倍。在 AA 中,high 爲 62、9.08 美元,max 爲 65、26.54 美元,成本約爲 2.92 倍。兩組數據只能分別在各自環境內部比較。
Q3: 這些數據是什麼時候的?會變嗎?
Fable 5.2 於 2026 年 11 月 9 日發佈,本文數據爲 11 月 10 日讀取的快照。AA 和 Cursor 的頁面都是動態更新的,後續版本、任務集或成本算法變化後,數字可能隨之改變,引用時應註明讀取日期。
Q4: Extra High 比 High 分數還低,是不是不該用?
這只是 CursorBench 4.0 這一次的結果,不能推出 xhigh 在所有任務上都更差。官方建議把 xhigh 留給在你自己的評估中已經測出收益的困難長任務。沒有測出收益之前,不必默認開啓。
Q5: 如何通過 API 對比 Fable 5.2 不同檔位的成本?
建議用同一批任務、只改檔位,記錄 usage 和平臺實扣。通過 API易 apiyi.com 的統一接口調用時,可以用日誌中的 quota÷500000 換算美元實扣。開跑前請確認平臺當日的模型 ID、分組和 effort 支持情況,本文不提供未經驗證的透傳寫法。
Q6: 公開評測數據有哪些侷限?
CursorBench 是工具提供商在自有環境中的評測,AA 指數是加權綜合分。兩者都不等於你的業務通過率,3 個百分點左右的差距也無法據此判斷是否顯著。社交平臺上的首日評價只能作爲線索,最終結論應該來自你自己的驗收樣本。
Q7: API 降價 20% 後,用 max 是不是就划算了?
不一定。降價只在用量不變時對應同比例省錢。max 的 token 用量和步數可能是 high 的 3 倍以上,單價下降很容易被用量增長抵消。應該比較”通過一個任務的實扣”,而不是隻看單價。
Fable 5.2 high 和 max 核心要點 Key Takeaways
- 單價不變,賬單會變:effort 改變思考量和步驟數,同價位下任務成本可能相差數倍
- API 默認 high:官方建議從 high 起步,再按自己的評估結果上調或下調
- Cursor 對照:high 到 max 提高 3.1 個百分點,成本約爲 3.38 倍
- AA 對照:指數從 62 升到 65,成本約爲 2.92 倍;65 不是正確率
- 環境不能合併:兩組評測只能各自在內部比較,不能拼成統一的性價比分
- max 留給少數任務:適用於能力上限評估和高價值開放問題
- 用實扣驗收:同任務、單變量、記錄 usage,可藉助 API易 apiyi.com 日誌對賬
總結
Fable 5.2 high 和 max 的選擇可以歸納爲三點:
- 區分單價與任務賬單:檔位不改變單價,改變的是投入量。
- 在同一環境內讀數據:Cursor 與 AA 都顯示 max 分數略高、成本約爲 high 的 3 倍左右,但兩者不能合併比較。
- 以驗收門檻爲準:high 能過門檻就保持 high;只有 high 不達標而 max 能達標時,才比較增量成本與返工代價。
對大多數團隊來說,比較穩妥的做法是先在 high 上建立任務分層和驗收記錄,再挑出少數高價值任務單獨評估 max。推薦通過 API易 apiyi.com 用統一接口和調用日誌在自己的樣本上快速驗證,確認模型與檔位支持後再擴大規模。
📚 參考資料
- Anthropic 發佈公告:Fable 與 Mythos 5.2 的發佈範圍與廠商自評
- 鏈接:
anthropic.com/claude-fable-and-mythos-5-2 -
說明:發佈日期爲 2026-11-09,包含速度口徑與評測表
-
Claude API 定價:官方標準費率
- 鏈接:
platform.claude.com/docs/en/about-claude/pricing -
說明:Fable 5.2 輸入/輸出爲 8 / 40 美元每百萬 token
-
Fable 5.2 模型規格:上下文、輸出上限與默認 effort
- 鏈接:
platform.claude.com/docs/en/models/fable-5-2/overview -
說明:自適應思考始終開啓,API 默認 high
-
Fable 5.2 提示指南:官方的檔位選擇建議
- 鏈接:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
說明:medium、high、xhigh、max 各自的適用場景
-
CursorBench 4.0:Cursor 自有環境中的五檔評測
- 鏈接:
prod.cursor.com/evals -
說明:工具提供商自有評測,不屬於通用獨立複測
-
Artificial Analysis 模型榜單:獨立機構動態榜單
- 鏈接:
artificialanalysis.ai/leaderboards/models -
說明:Intelligence Index 與每任務成本
-
Artificial Analysis 評測方法:Intelligence Index v5.0.1 的構成
- 鏈接:
artificialanalysis.ai/methodology/intelligence-benchmarking -
說明:9 項評測,四類能力各佔 25%
-
Cursor 如何比較模型質量:舊版基準的方法博客
- 鏈接:
prod.cursor.com/blog/cursorbench -
說明:僅用於理解設計思想,不適用於 4.0 的統計結論
-
API易 日誌查詢 API:日誌字段與實扣換算
- 鏈接:
docs.apiyi.com/api-capabilities/log-query - 說明:quota÷500000 爲美元實扣
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心