作者注:拆解大模型 API 賬單中的輸入、輸出、緩存、推理 Token 與多模態計費口徑,給出按調用日誌覈對用量、識別“費用突變”和應對價格變化的實操方法。
月底打開賬單,發現某個模型的費用比上月多出一截,但調用次數幾乎沒變。這是很多已經把大模型 API 用到生產環境的團隊都遇到過的情況。本文介紹一套 按計費項拆解 + 按調用日誌對賬 的方法,幫你看懂並覈對大模型 API 賬單。
這不是一篇價格彙總。各廠商價格變動頻繁,本文不列具體單價,只講長期適用的計費口徑和核對思路。
一個可以參考的行業信號是:2026 年 11 月,有 AI 基礎設施公司在招聘大模型平臺運營崗位。該崗位的職責中明確寫着“成本與計費覈驗”,要求覈驗輸入/輸出 Token、緩存 Token、推理 Token 及圖片、音視頻等計費口徑,並及時發現異常賬單、價格變化和計費偏差。平臺方需要專人做這件事,說明計費口徑本身就足夠複雜。作爲調用方,你同樣需要一套自己的對賬習慣。
核心價值:讀完本文,你能分清大模型 API 賬單裏每一類計費項的來源,知道如何用調用日誌覈對用量,並能快速定位“同一請求費用突變”的原因。
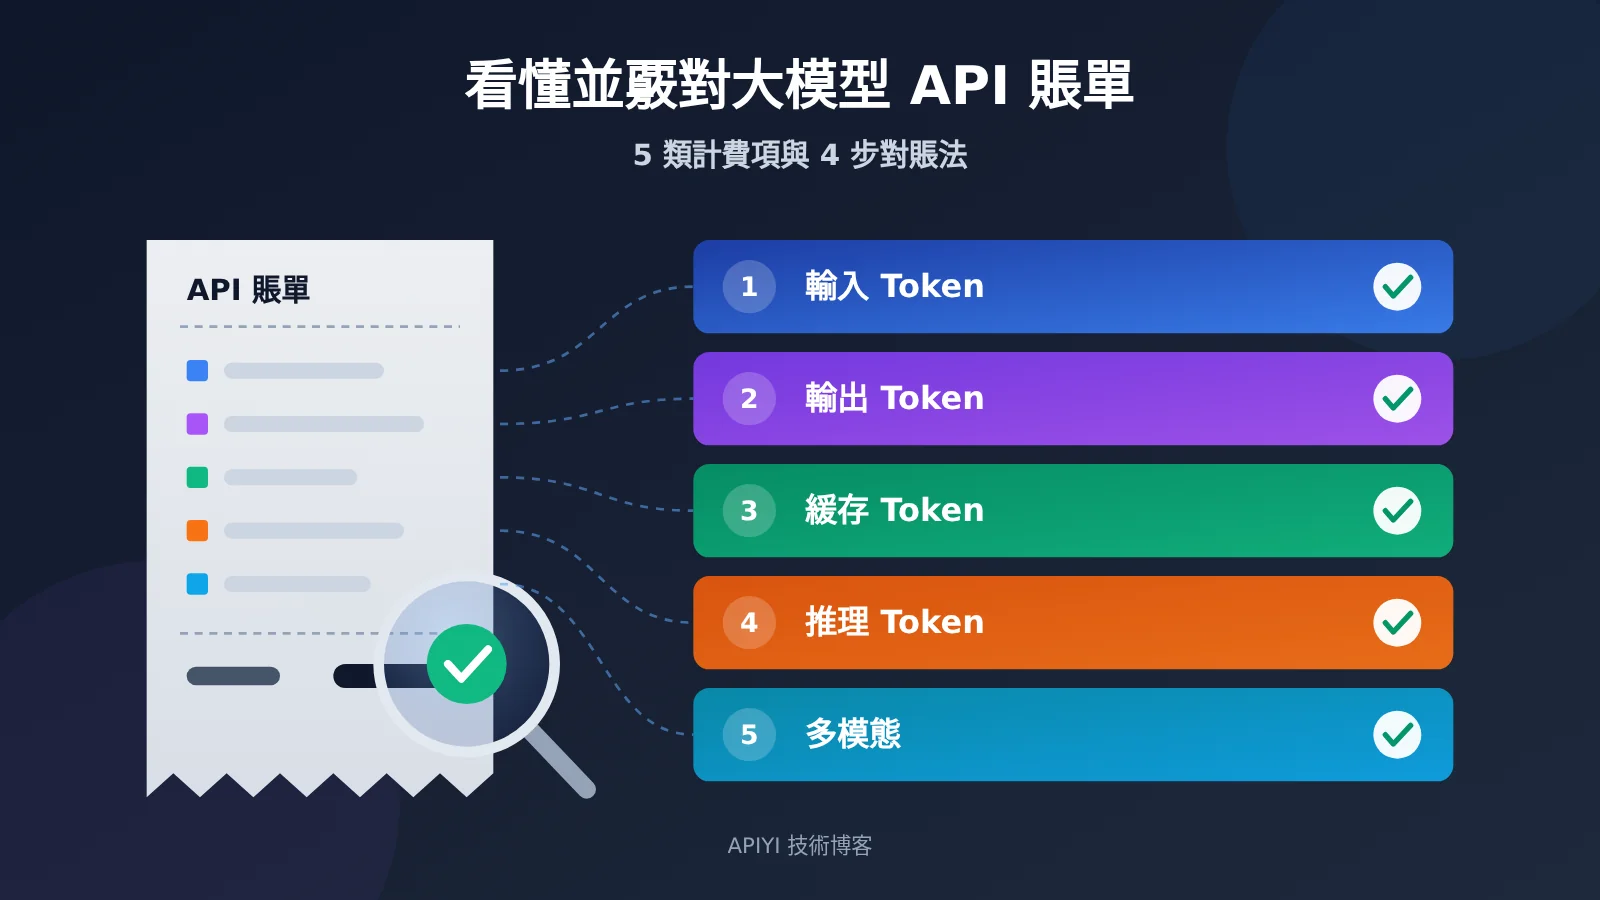
大模型 API 賬單核心要點:5 類計費項
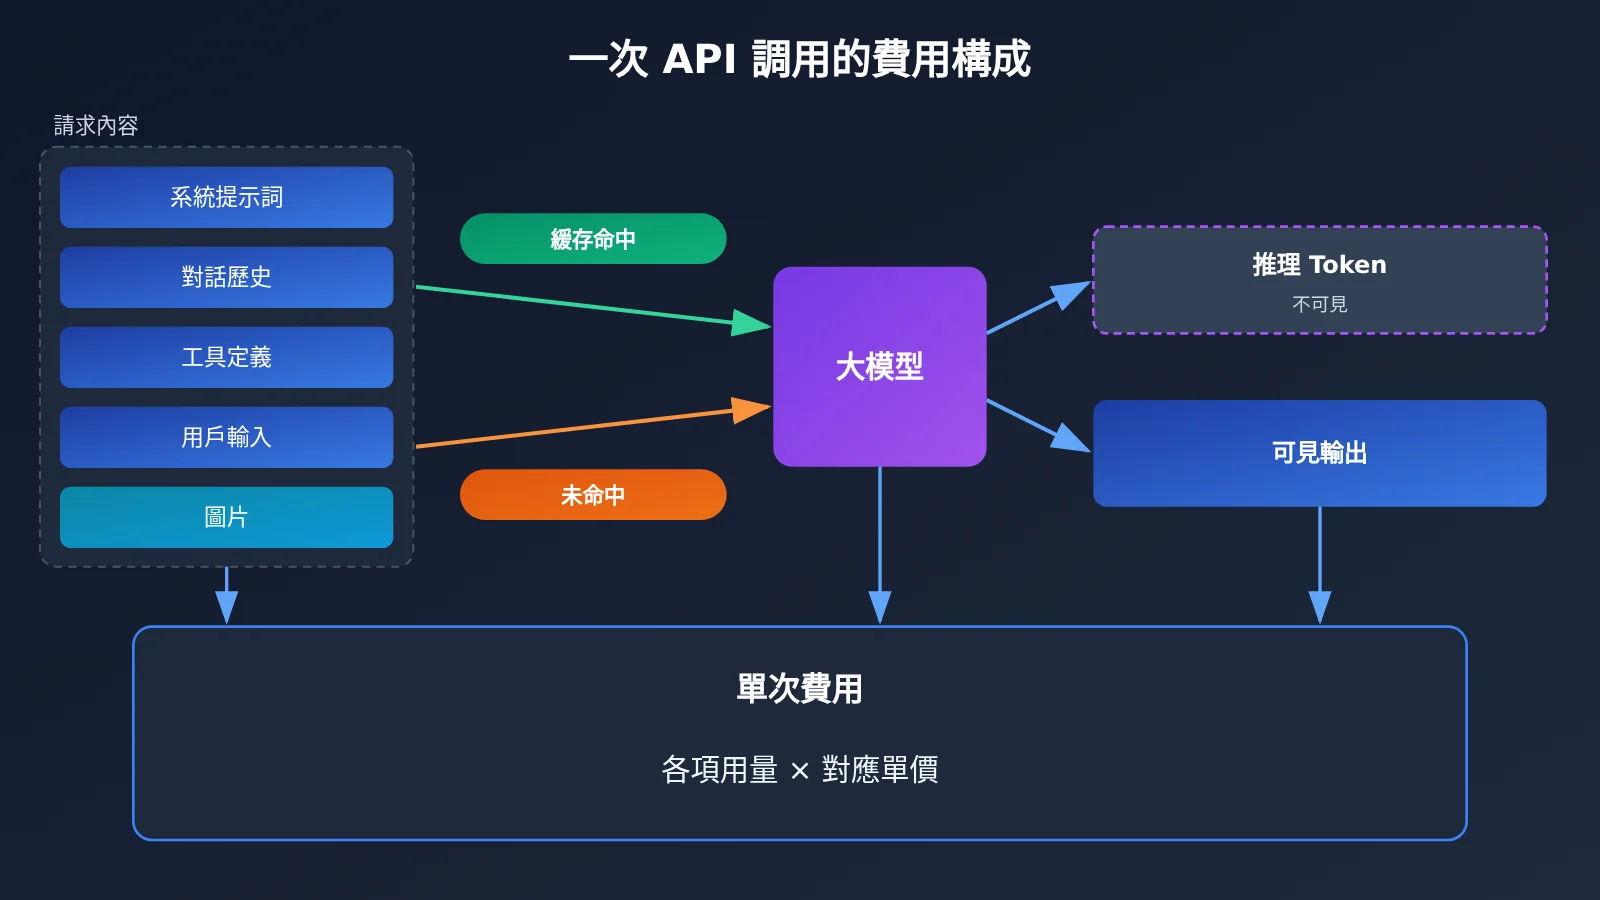
一次模型調用的費用,通常不是“調用次數 × 單價”這麼簡單。不同計費項單價不同,來源也不同。混在一起看,很容易誤判成本結構。
| 計費項 | 來自哪裏 | 常見計價特點 | 對賬關注點 |
|---|---|---|---|
| 輸入 Token | 系統提示詞、歷史對話、工具定義、檢索文檔、用戶輸入 | 按 Token 計,通常比輸出便宜 | 上下文是否在悄悄變長 |
| 輸出 Token | 模型生成的可見回覆 | 按 Token 計,單價通常高於輸入 | 回覆長度、max_tokens 設置 |
| 緩存 Token | 被緩存命中的輸入前綴 | 命中部分常有折扣,部分廠商對寫入另行計價 | 命中率是否下降 |
| 推理 Token | 推理模型的內部思考過程 | 通常按輸出計價,但不一定出現在回覆裏 | 推理長度是否增長 |
| 多模態計費 | 圖片、音頻、視頻的輸入或生成 | 按張、按秒、按分辨率或折算 Token | 規格參數是否改變 |
大模型 API 賬單爲什麼容易“對不上”
第一個原因是看不見的 Token。你在代碼裏只寫了一句用戶提問,但實際發出的請求可能包含幾千 Token 的系統提示詞、多輪歷史和工具 Schema。推理模型還會產生大量用戶看不到的思考 Token。這些都會進入賬單,卻不會出現在界面上。
第二個原因是口徑不統一。同樣是“圖片輸入”,有的廠商按張計價,有的按分辨率折算成 Token。同樣是“緩存”,有的廠商自動緩存,有的需要顯式聲明,有的只對讀取打折,有的還對寫入額外收費。跨模型、跨廠商對比時,必須先把口徑對齊。
第三個原因是變量會漂移。模型別名可能指向了新版本,提示詞前綴的一次小改動可能讓緩存全部失效,推理模型面對更難的問題會思考得更久。單價沒變,賬單也可能變。
大模型 API 賬單各計費項詳解
輸入 Token:最容易被低估的部分
輸入 Token 是模型在本次請求中“讀到”的全部內容,而不只是用戶那句話。多輪對話場景下,每一輪都會把之前的歷史重新發送一次。對話越長,單輪輸入成本越高,總成本接近按輪數平方增長。
RAG 應用也是輸入 Token 的大戶。檢索召回的文檔片段數量、每段長度,都直接決定輸入成本。Function Calling 場景下,工具定義的 JSON Schema 每次請求都會計入輸入,工具越多,固定開銷越大。
另外要注意,不同模型的分詞器不同。同一段中文在不同模型下的 Token 數可能差別明顯,不能用一個模型的 Token 數去估算另一個模型的費用。
輸出 Token:單價更高,受參數直接控制
輸出 Token 是模型生成的回覆內容。多數廠商的輸出單價明顯高於輸入單價,所以“讓模型少說廢話”往往比壓縮輸入更省錢。
max_tokens 是輸出成本的上限,但不是保證。如果回覆被截斷,已經生成的部分仍然計費。流式輸出中途斷開時,各平臺對已生成 Token 的處理方式也可能不同,需要以官方說明爲準。
緩存 Token:命中才省錢
提示詞緩存的原理是:當多個請求共享相同的前綴(比如同一份系統提示詞或同一份長文檔)時,廠商可以複用已經處理過的部分,並對這部分輸入給予折扣。
緩存有幾個常見規則需要逐一確認:
- 是否自動啓用:有的廠商默認開啓,有的需要在請求中顯式標記緩存位置;
- 前綴匹配要求:通常要求從開頭起逐字一致,前綴裏任何一處變化都會導致後面全部失效;
- 最小長度與有效期:太短的前綴可能不緩存,緩存過期後需要重新寫入;
- 寫入是否收費:部分廠商對首次寫入緩存按高於普通輸入的價格計費,只有後續讀取才便宜。
對賬時,要把“緩存讀取 Token”和“普通輸入 Token”分開統計,否則會把命中率下降誤判爲調用量增長。
推理 Token:看不見但要付錢
推理模型在給出答案前會進行內部思考,這部分 Token 通常按輸出單價計費。很多情況下,推理內容不會完整返回給你,你只能從用量字段中看到它的數量。
推理 Token 的數量隨問題難度、推理強度參數而變化。同一個接口,用戶提的問題變難了,賬單就可能上漲。如果業務只需要簡單分類或格式轉換,用推理模型往往是在爲不需要的思考買單。
多模態計費:先確認“按什麼計”
多模態的計費口徑差異最大,也最需要逐個模型查看官方定價頁。下表是常見的計價方式,具體規則以各廠商當前公佈爲準。
| 類型 | 常見計價方式 | 影響費用的關鍵參數 | 覈對建議 |
|---|---|---|---|
| 圖片輸入(理解) | 按分辨率折算 Token,或按張計價 | 圖片尺寸、細節等級參數 | 記錄上傳前後的實際分辨率 |
| 圖片生成 | 按張計價,或按輸出 Token 計價 | 尺寸、質量檔位、生成數量 | 記錄每次請求的規格參數 |
| 音頻輸入/輸出 | 按時長計價,或折算爲音頻 Token | 音頻時長、採樣處理方式 | 記錄音頻真實時長 |
| 語音合成 | 按字符數或按 Token 計價 | 文本長度、音色檔位 | 記錄合成文本長度 |
| 視頻生成/理解 | 按秒、按幀或按分辨率檔位計價 | 時長、分辨率、幀率 | 記錄時長與分辨率組合 |
| Embedding | 按輸入 Token 計價 | 文本長度、批量大小 | 與普通輸入單價分開統計 |
🎯 技術建議:多模態場景最好統一走一個入口,便於把不同計費口徑集中管理。API易 apiyi.com 的官方介紹中提到,平臺上的模型使用統一餘額,並提供用量統計和調用日誌。你可以先在控制檯確認日誌裏展示了哪些字段,再決定對賬表需要補記哪些參數。
大模型 API 賬單快速上手:4 步對賬法
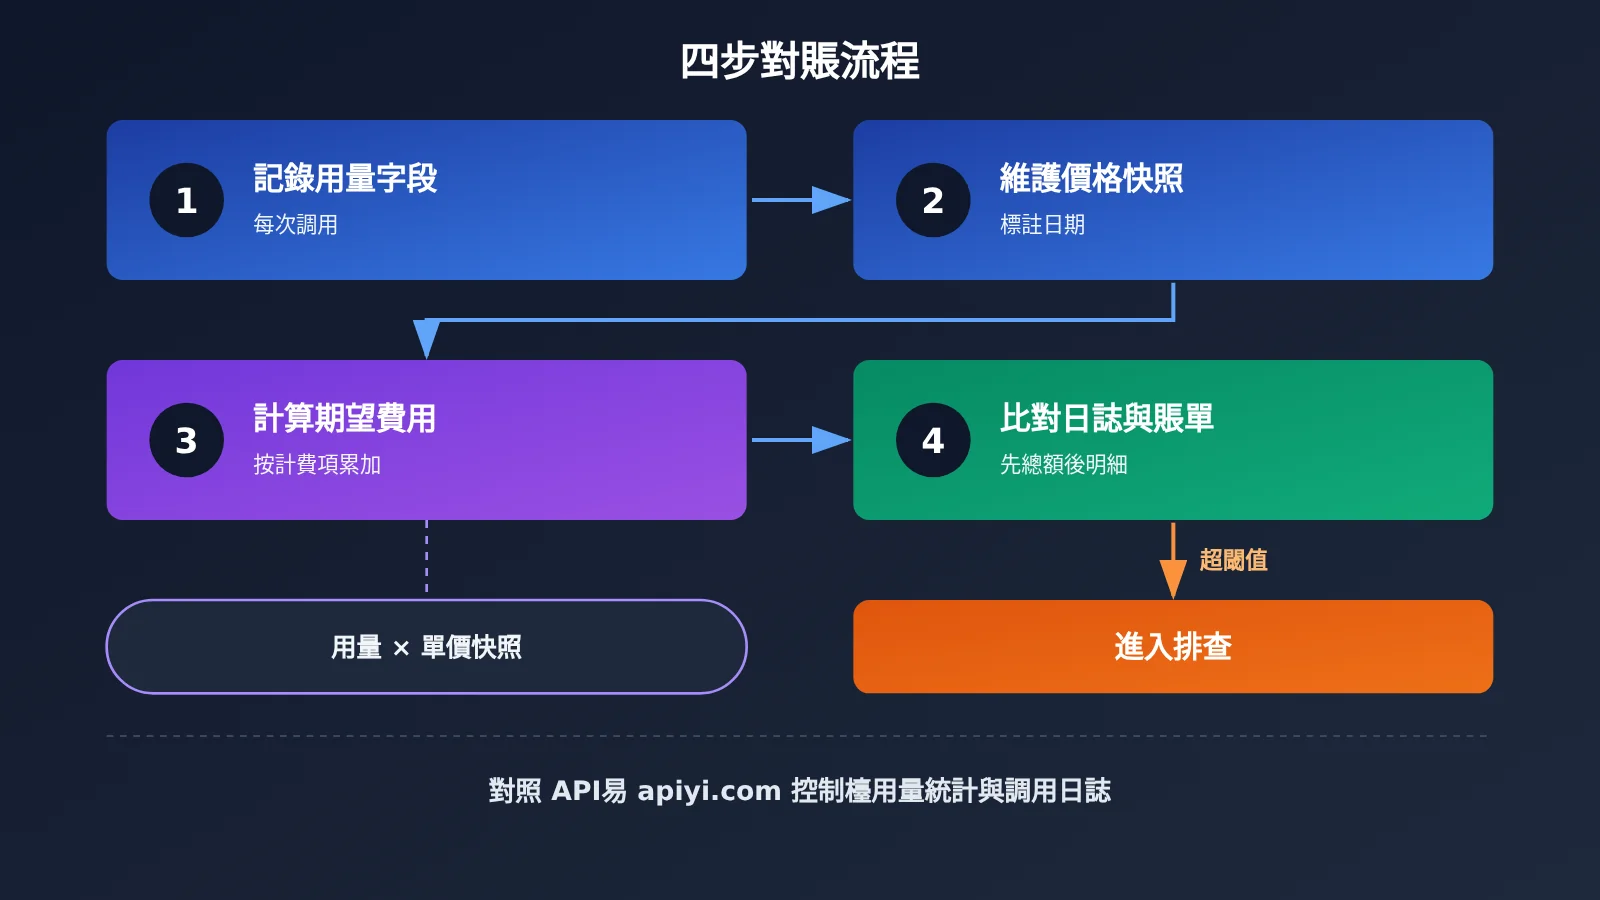
對賬的核心思路是:用自己記錄的用量 × 自己記錄的單價快照,得到期望費用,再與平臺賬單對比。差異超出容忍範圍,就逐項排查。
第 1 步:在每次調用後記錄用量字段
OpenAI 兼容格式的接口通常會在響應中返回 usage 對象。常見字段及其含義如下,不同模型和平臺的返回情況可能有差異,接入前需要實際請求一次確認。
| 字段(OpenAI 兼容格式常見寫法) | 含義 | 對應計費項 |
|---|---|---|
prompt_tokens |
本次請求的輸入 Token 總數 | 輸入(含緩存部分) |
prompt_tokens_details.cached_tokens |
輸入中命中緩存的部分 | 緩存讀取 |
completion_tokens |
輸出 Token 總數 | 輸出(可能含推理部分) |
completion_tokens_details.reasoning_tokens |
輸出中的推理部分 | 推理 |
model |
實際響應的模型名稱 | 用於識別版本變化 |
建議每次調用至少落庫以下信息:
- 請求時間、請求 ID、業務場景標識;
- 請求中指定的模型名 和 響應中返回的
model; - 上表中的全部用量字段,缺失的字段記爲空而不是 0;
- 多模態請求的規格參數,如圖片尺寸、音頻時長、生成數量;
- 是否流式、是否重試、是否被截斷(
finish_reason)。
注意 prompt_tokens 和 completion_tokens 往往是“總數”,緩存和推理是其中的明細。計算費用時要先把明細從總數里減出來,再分別乘以對應單價,否則會重複計費或漏算折扣。
第 2 步:維護帶日期的價格快照
不要在代碼裏硬編碼單價。建議維護一張價格快照表,每一行記錄模型名、計費項、單價、幣種、生效日期和來源(官方定價頁或平臺公告)。
價格調整時新增一行,而不是覆蓋舊值。這樣回溯任意一天的賬單時,都能用當時的價格重新計算。如果你通過 API易 這類聚合平臺調用,單價應以平臺當前公佈的價格爲準,並同樣標註查詢日期。
第 3 步:計算期望費用
單次期望費用可以拆成幾項相加:
- 未命中緩存的輸入 Token × 輸入單價;
- 緩存讀取 Token × 緩存讀取單價(如有緩存寫入計費,另加寫入部分);
- 可見輸出 Token × 輸出單價;
- 推理 Token × 推理對應單價(多數情況下與輸出相同,以官方說明爲準);
- 多模態部分按各自口徑單獨計算。
按天、按模型、按業務場景彙總後,就得到了一份“你認爲應該花多少錢”的賬本。
第 4 步:與平臺日誌和賬單比對
把自己的賬本和平臺的用量統計、調用日誌放在一起對比。先比總額,再比分模型金額,最後定位到具體請求。
建議設一個容忍閾值。由於匯率、計費精度、統計時區等原因,小幅差異很常見;超過閾值的部分才需要逐項排查。
🚀 快速開始:如果你已經在 API易 apiyi.com 上調用模型,可以先導出一段時間的調用日誌,與自己記錄的
usage字段逐條對齊。日誌中是否單獨區分緩存 Token 和推理 Token,以平臺當前提供的字段爲準;如果沒有單獨列出,就以你本地記錄的響應字段作爲明細依據。
大模型 API 賬單異常信號:費用突變怎麼查
同一類請求的費用突然變化,是最值得警惕的信號。下表列出了常見原因和排查方向。
| 異常現象 | 可能原因 | 排查方法 |
|---|---|---|
| 單次費用上漲,調用量不變 | 模型別名指向了新版本,單價或 Token 消耗不同 | 對比響應中的 model 字段前後變化 |
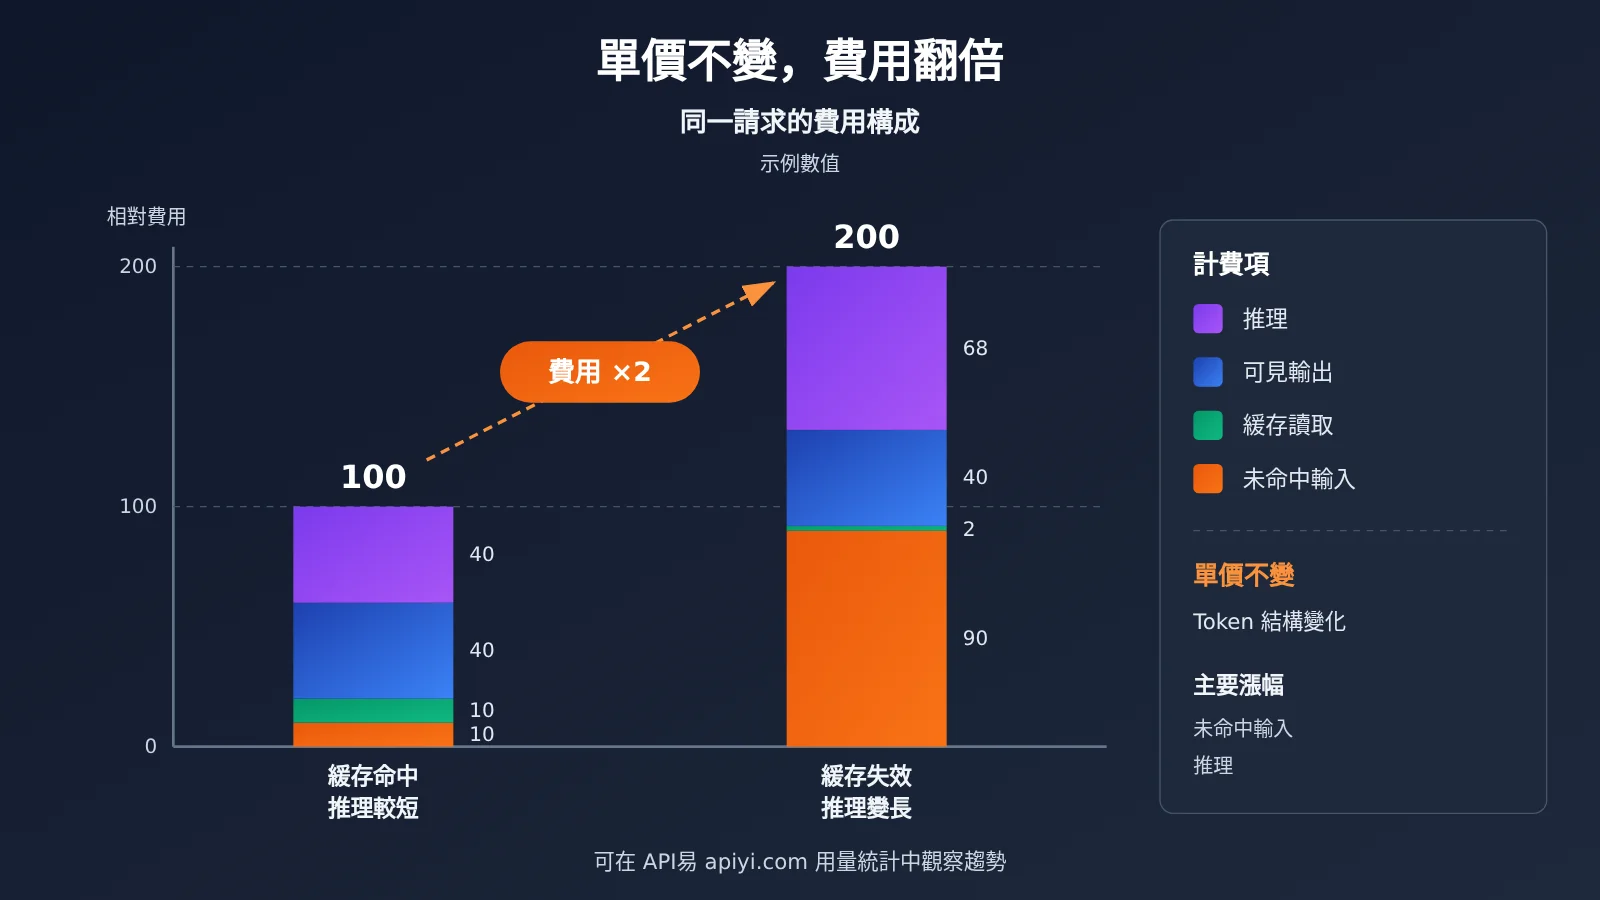
| 輸入費用上漲,輸入 Token 總數不變 | 緩存命中率下降 | 查看 cached_tokens 佔比,檢查提示詞前綴是否被改動 |
| 輸出費用上漲,可見回覆長度不變 | 推理 Token 增長 | 查看 reasoning_tokens 趨勢,檢查推理強度參數 |
| 輸入 Token 持續緩慢上升 | 對話歷史未截斷、檢索片段變多、工具定義增加 | 抽樣查看完整請求體 |
| 調用次數比業務量多 | 客戶端重試、超時後重發 | 按請求 ID 和業務 ID 去重統計 |
| 圖片或視頻費用突增 | 分辨率、質量檔位或生成數量被改大 | 對比請求中的規格參數 |
| 賬單單價與快照不一致 | 官方或平臺調價 | 查閱定價頁和公告,更新價格快照 |
緩存失效:最隱蔽的成本上漲
緩存失效常常來自一次“看起來無害”的改動。比如在系統提示詞開頭加了當前日期,或者把用戶 ID 插在了前綴裏。這樣每個請求的前綴都不同,緩存會全部失效,輸入成本直接回到原價。
正確做法是把固定內容放在最前面,把變化的內容放在最後面。改動提示詞模板後,第二天就去看緩存命中佔比有沒有變化。
推理長度漂移:難度變化也會影響賬單
推理模型的費用和問題難度相關。如果某天用戶突然集中提了一批覆雜問題,推理 Token 會明顯上升,這屬於正常波動。但如果推理 Token 在請求類型不變的情況下持續增長,就要檢查是否換了模型版本或推理參數。
大模型 API 賬單應對價格變化的檢查習慣
價格變化本身不可控,但發現得早晚可以控制。下面是一套可以長期堅持的檢查習慣:
- 每週:看一次分模型的費用趨勢和單次平均成本,關注突變點;
- 每月:完整對賬一次,差異超過閾值的逐項定位原因;
- 每次改提示詞模板後:觀察 1-2 天的緩存命中佔比;
- 每次切換或升級模型前:用小流量對比新舊模型的 Token 消耗和費用;
- 關注公告:訂閱所用廠商或平臺的價格與模型更新公告,收到後立即更新價格快照;
- 鎖定版本:生產環境儘量使用帶具體版本號的模型名,避免別名自動升級帶來意外。
💡 選擇建議:如果業務同時用到多個廠商的模型,分散在多個賬戶裏對賬會非常耗時。通過 API易 apiyi.com 統一接入,可以在同一個餘額、同一套日誌裏查看不同模型的用量,方便橫向對比單次成本。具體能看到的明細維度,建議先在控制檯覈實。
常見問題 FAQ
Q1:什麼是大模型 API 賬單裏的 Token?
Token 是模型處理文本的基本單位,可以理解爲分詞後的片段。一箇中文字可能對應一個或多個 Token,具體取決於模型的分詞器。賬單通常按輸入、輸出、緩存、推理等不同類別的 Token 數量分別計價。
Q2:緩存 Token 和普通輸入 Token 有什麼區別?
兩者都屬於輸入,但緩存 Token 是命中了已緩存前綴的部分,通常享受折扣。普通輸入 Token 按原價計費。部分廠商還對首次寫入緩存單獨收費,因此對賬時三者要分開統計。
Q3:推理 Token 爲什麼在回覆裏看不到?
推理 Token 是模型內部思考產生的,很多模型不會把完整推理過程返回給調用方,只在用量字段中給出數量。它通常按輸出單價計費,所以即使回覆很短,費用也可能不低。
Q4:同一個請求的費用爲什麼會突然變化?
最常見的原因有三個:模型別名指向了新版本、提示詞前綴變化導致緩存失效、推理長度增加。其次是重試導致的重複計費,以及多模態規格參數被調大。按本文的異常信號表逐項檢查即可定位。
Q5:如何藉助平臺日誌覈對自己的大模型 API 賬單?
先在自己的系統裏記錄每次響應的 `usage` 字段和請求 ID,再導出平臺的調用日誌按請求逐條對齊。以 API易 apiyi.com 爲例,可以在控制檯查看用量統計和調用日誌,先確認日誌中包含哪些字段,再與本地記錄合併對賬。
Q6:多模態模型的費用應該怎麼估算?
先查官方定價頁確認計價方式:按張、按秒,還是按分辨率折算 Token。然後在請求日誌中記錄對應的規格參數,例如圖片尺寸、音頻時長、視頻分辨率和時長,用這些參數乘以單價估算。
Q7:對賬發現差異時,先查哪裏?
先確認價格快照是否最新,排除調價因素。再比對調用次數,排除重試和重複請求。最後按模型、按計費項拆分差異,找出是輸入、緩存、推理還是多模態部分出了偏差。
Q8:這套對賬方法有哪些侷限?
它依賴響應中返回的用量字段,如果某些模型或接口不返回緩存、推理明細,就只能依賴平臺賬單。另外匯率、計費精度和統計時區會造成小幅差異,需要設置合理閾值,而不是追求分毫不差。
大模型 API 賬單核心要點 Key Takeaways
- 費用由多類計費項構成:輸入、輸出、緩存、推理和多模態單價各不相同,需分開統計。
- 輸入 Token 遠不止用戶提問:系統提示詞、歷史、檢索文檔、工具定義都計入輸入。
- 緩存命中靠前綴一致:固定內容放前面,變量放後面,改模板後檢查命中率。
- 推理 Token 看不見但收費:簡單任務避免用推理模型,關注推理長度趨勢。
- 多模態先問“按什麼計”:按張、按秒或按分辨率折算,以官方定價頁爲準。
- 對賬四步走:記錄用量、維護價格快照、計算期望費用、與日誌賬單比對。
- 統一入口便於對賬:可藉助 API易 apiyi.com 的統一餘額與調用日誌集中核對多模型用量。
總結
看懂並覈對大模型 API 賬單的關鍵在於三點:
- 拆開看:把一次調用的費用拆成輸入、緩存、輸出、推理、多模態幾部分,分別對應來源;
- 自己記:每次調用落庫用量字段和規格參數,維護帶日期的價格快照;
- 定期比:每週看趨勢,每月對總賬,費用突變時按模型版本、緩存命中、推理長度、重試、規格參數逐項排查。
平臺運營方會專門覈驗這些計費口徑,作爲調用方,建立自己的對賬習慣同樣必要。如果你的業務需要同時調用多家模型,推薦通過 API易 apiyi.com 統一接入,在一個控制檯裏查看用量與調用日誌,再結合本文方法完成核對。
📚 參考資料
- V2EX 招聘帖:AI Agent 基礎設施公司大模型平臺運營崗位:崗位職責中列出“成本與計費覈驗”
- 鏈接:
v2ex.com/t/1254263 -
說明:2026-11-03 發佈,描述了平臺側需覈驗輸入/輸出 Token、緩存 Token、推理 Token 及圖片、音視頻等計費口徑,並發現異常賬單、價格變化和計費偏差
-
各模型廠商官方定價頁:具體單價與計費規則的唯一權威來源
- 鏈接:請在所用廠商官網的定價或文檔欄目中查詢
- 說明:價格變動頻繁,引用時務必記錄查詢日期
作者:APIYI 技術團隊
技術交流:對大模型 API 賬單核對有疑問,歡迎通過 API易 apiyi.com 首頁聯繫我們,更多接入資料可查閱 docs.apiyi.com 文檔中心