Примечание автора: разберём, как в API больших языковых моделей тарифицируются входные, выходные, кэшированные и reasoning-токены, а также мультимодальные данные. Покажем, как сверять расход по логам вызовов, находить причины резкого роста затрат и реагировать на изменение цен.
В конце месяца вы открываете счёт и видите, что расходы на одну из моделей заметно выросли, хотя число вызовов почти не изменилось. С такой ситуацией сталкиваются многие команды, которые уже используют API больших языковых моделей в продакшене. В этой статье разберём метод разбивки по статьям расходов и сверки с логами вызовов, который поможет разобраться в счёте и проверить его.
Это не обзор цен. Тарифы поставщиков часто меняются, поэтому мы не будем приводить конкретные ставки. Вместо этого поговорим о принципах тарификации и подходах к сверке, которые сохраняют актуальность.
Вот показательный пример из отрасли: в ноябре 2026 года одна компания, занимающаяся ИИ-инфраструктурой, искала специалиста по эксплуатации платформы больших языковых моделей. Среди обязанностей прямо указывалась «проверка затрат и начислений»: нужно было проверять тарификацию входных и выходных токенов, кэшированных токенов, reasoning-токенов, а также изображений, аудио и видео. Кроме того, специалист должен был своевременно выявлять аномальные счета, изменения цен и расхождения в начислениях. Если поставщику нужен отдельный человек для этой работы, значит, сама система тарификации достаточно сложна. Вам как пользователю API тоже стоит выработать привычку регулярно сверять расходы.
Что вы получите: после прочтения вы будете понимать, из чего складывается каждая статья расходов в счёте за API больших языковых моделей, как сверять использование по логам вызовов и как быстро находить причину резкого изменения стоимости одного и того же запроса.
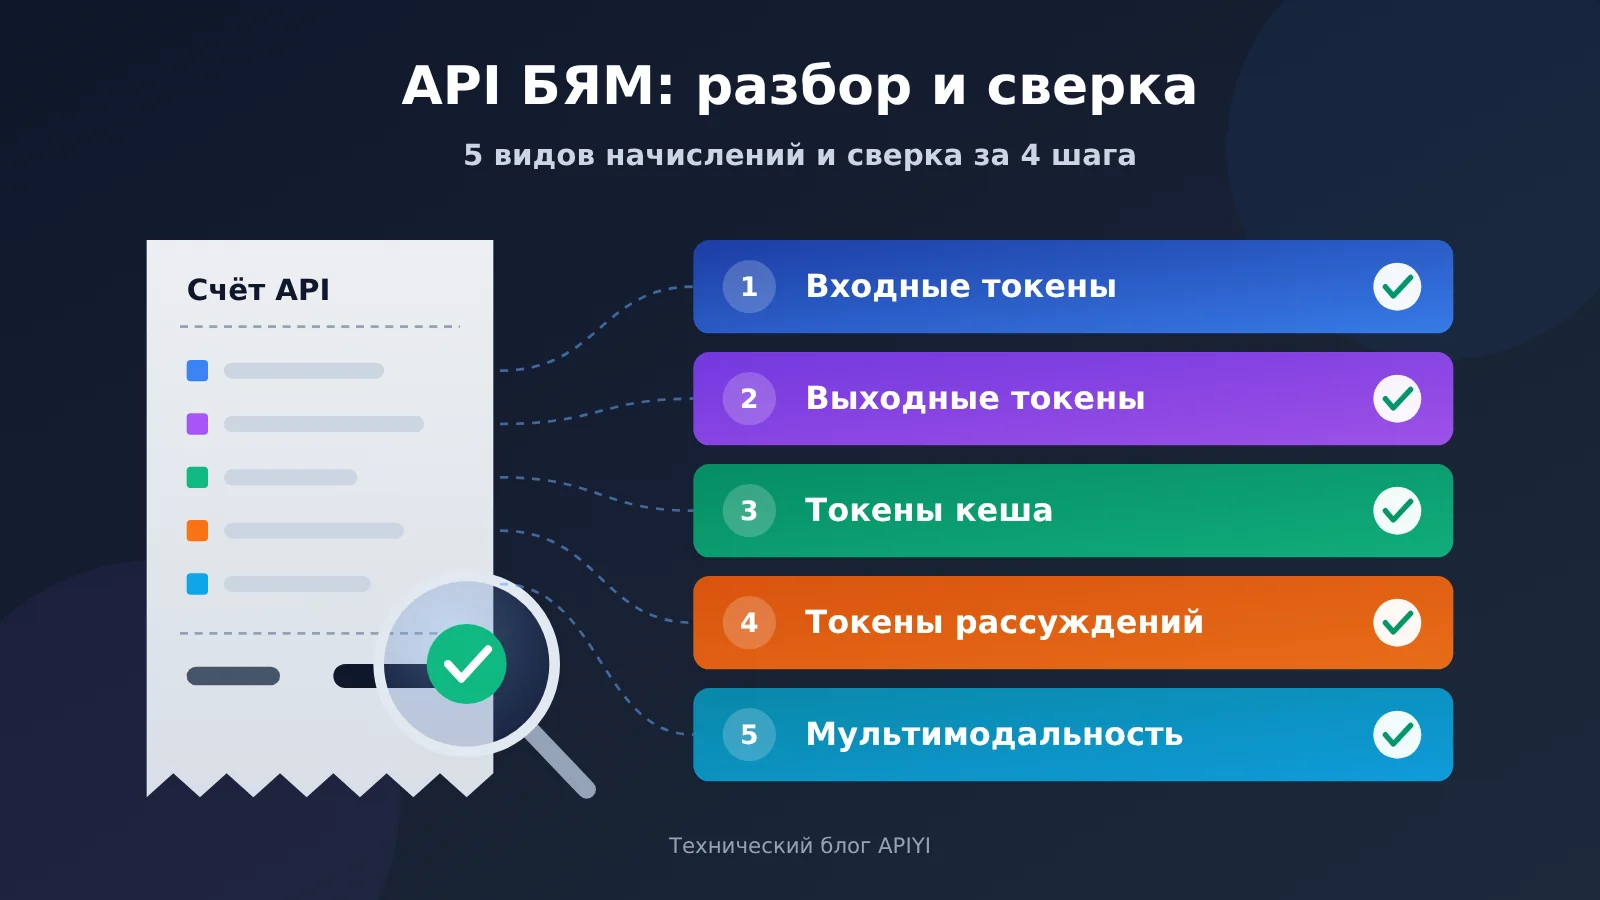
Главное о счетах за API больших языковых моделей: 5 видов расходов
Стоимость вызова модели обычно не сводится к формуле «количество вызовов × цена». Разные компоненты тарифицируются по-разному и возникают по разным причинам. Если смотреть только на общую сумму, легко ошибиться в оценке структуры расходов.
| Статья расходов | Источник | Особенности тарификации | На что обратить внимание при сверке |
|---|---|---|---|
| Входные токены | Системный промпт, история диалога, определения инструментов, документы из поиска, ввод пользователя | Оплата за токены, обычно дешевле выходных | Не растёт ли незаметно длина контекста |
| Выходные токены | Видимый ответ, сгенерированный моделью | Оплата за токены, цена обычно выше, чем у входных | Длина ответа, настройка max_tokens |
| Кэшированные токены | Входной префикс, найденный в кэше | На кэшированную часть часто действует скидка, некоторые поставщики отдельно тарифицируют запись | Не снижается ли частота попаданий в кэш |
| Токены рассуждений | Внутренний процесс рассуждения модели | Обычно тарифицируются как выходные, но могут не отображаться в ответе | Не растёт ли длина рассуждений |
| Мультимодальная тарификация | Ввод или генерация изображений, аудио и видео | Оплата за изображения, секунды, разрешение или в пересчёте на токены | Не изменились ли параметры |
Почему счёт за API большой языковой модели бывает сложно сверить
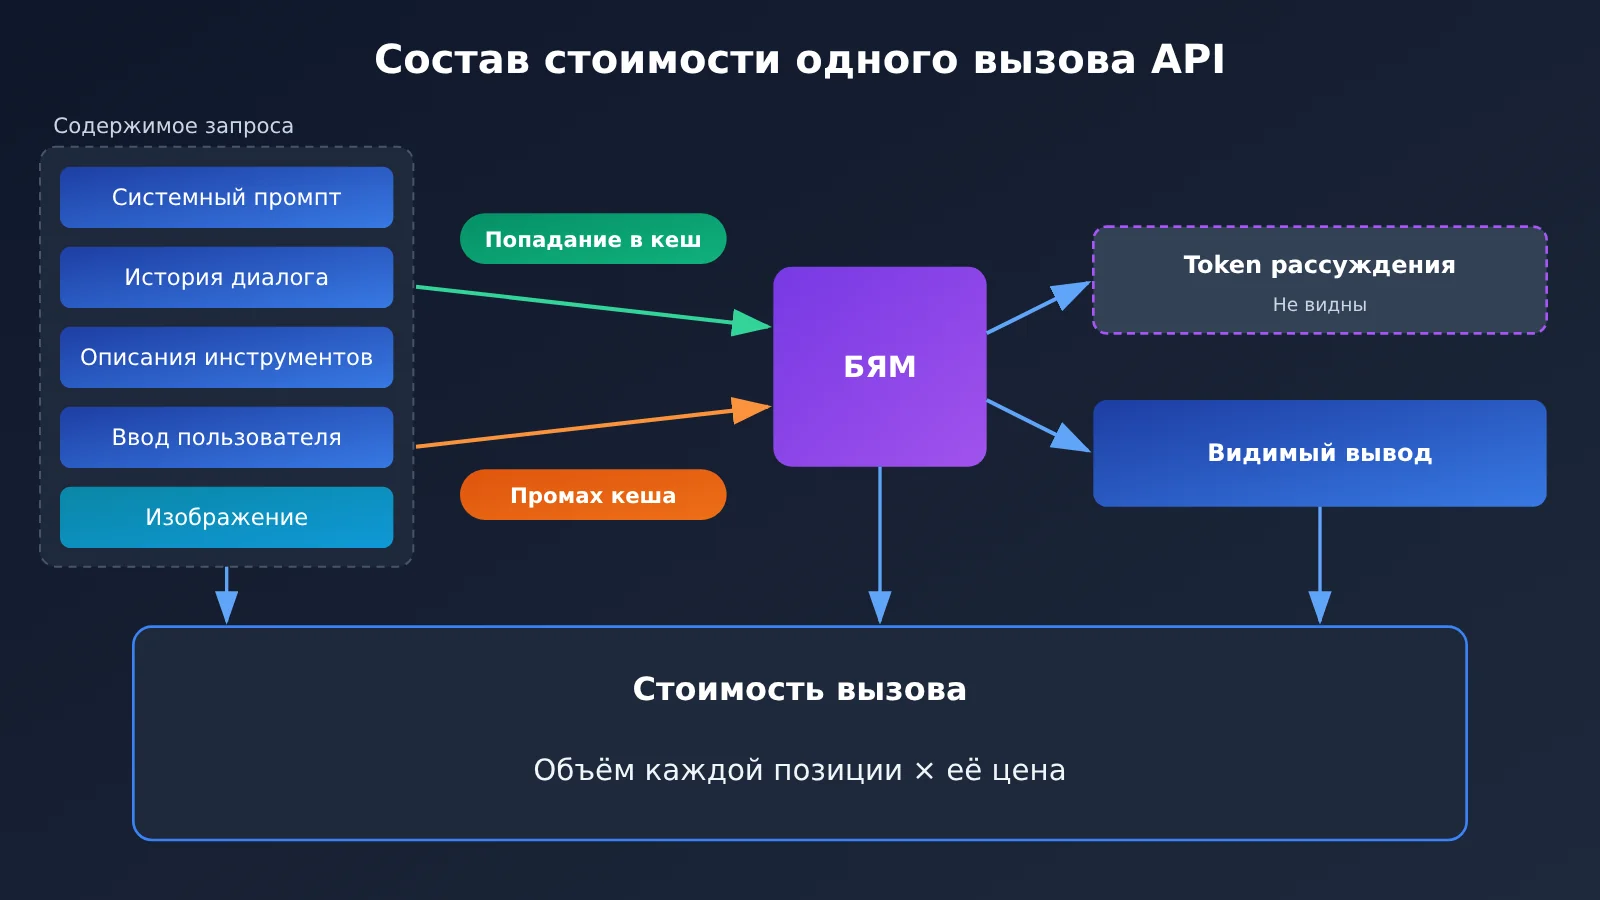
Первая причина — невидимые токены. В коде вы могли написать всего один вопрос пользователя, но фактический запрос может включать системный промпт на несколько тысяч токенов, историю диалога и схемы инструментов. Рассуждающие модели также генерируют множество токенов рассуждений, которые пользователь не видит. Всё это попадает в счёт, хотя и не отображается в интерфейсе.
Вторая причина — разные подходы к тарификации. Например, за ввод изображений одни поставщики берут плату за каждое изображение, а другие пересчитывают разрешение в токены. С кэшем тоже по-разному: одни поставщики кэшируют данные автоматически, другие требуют явно указать, что нужно кэшировать; одни дают скидку только на чтение, другие дополнительно взимают плату за запись. Прежде чем сравнивать модели и поставщиков, нужно привести условия к общему знаменателю.
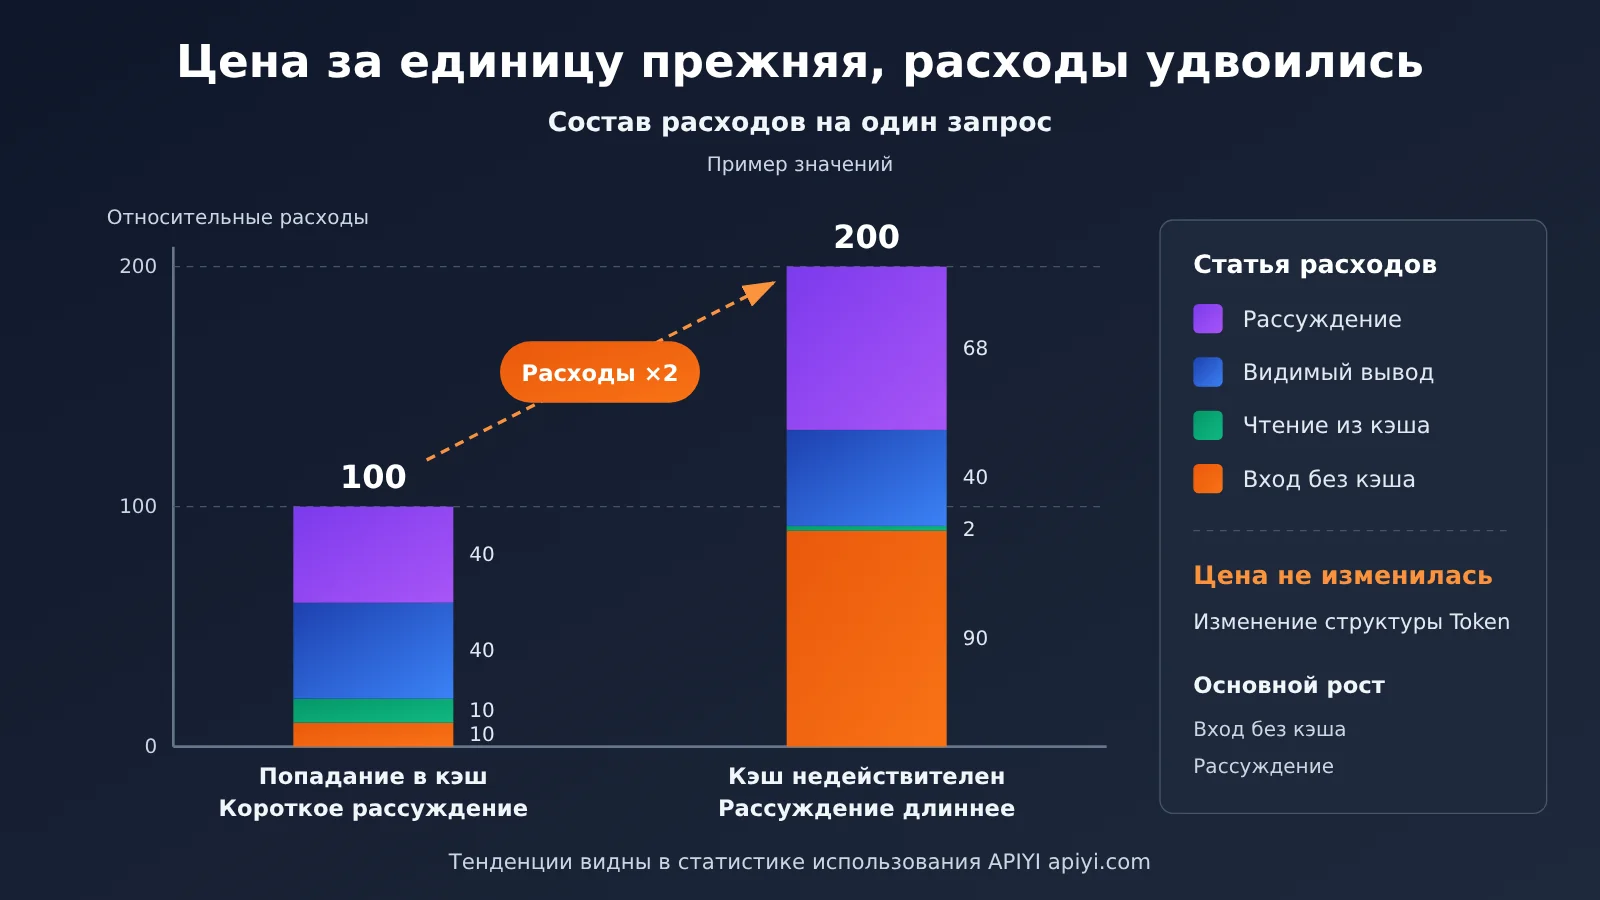
Третья причина — изменение параметров. Псевдоним модели может начать указывать на новую версию, небольшое изменение префикса промпта — сделать весь кэш недействительным, а над более сложной задачей рассуждающая модель будет думать дольше. Цена за единицу может остаться прежней, а счёт всё равно изменится.
Из чего складывается счёт за API большой языковой модели
Входные токены: расходы, которые легко недооценить
Входные токены — это всё содержимое, которое модель «прочитала» в рамках запроса, а не только сообщение пользователя. В многошаговом диалоге при каждом новом запросе история переписки отправляется заново. Чем длиннее диалог, тем выше стоимость входных токенов на каждом шаге, а общие расходы растут почти пропорционально квадрату числа шагов.
RAG-приложения тоже расходуют много входных токенов. Стоимость напрямую зависит от количества извлечённых фрагментов документов и длины каждого из них. При использовании Function Calling JSON Schema с определениями инструментов учитывается во входных токенах при каждом запросе. Чем больше инструментов, тем выше постоянные расходы.
Также стоит помнить, что у разных моделей разные токенизаторы. Один и тот же текст на китайском языке может занимать заметно разное количество токенов в зависимости от модели. Поэтому нельзя оценивать расходы на одну модель по числу токенов, рассчитанному для другой.
Выходные токены: дороже и напрямую управляются параметрами
Выходные токены — это ответ, который генерирует модель. У большинства провайдеров цена за выходные токены заметно выше, чем за входные, поэтому просьба «не лить воду» часто экономит больше, чем сокращение входных данных.
max_tokens задаёт верхнюю границу затрат на вывод, но не гарантирует её достижения. Если ответ обрезан, уже сгенерированная часть всё равно оплачивается. При прерывании потокового вывода платформы могут по-разному учитывать уже сгенерированные токены — уточняйте это в официальной документации.
Кешированные токены: экономия только при попадании в кеш
Кеширование промптов работает так: когда несколько запросов используют один и тот же префикс — например, одинаковый системный промпт или длинный документ, — провайдер может повторно использовать уже обработанную часть и предоставить скидку на соответствующие входные токены.
Стоит заранее проверить несколько типичных правил кеширования:
- Автоматическое включение: одни провайдеры включают кеширование по умолчанию, у других нужно явно указать место кеширования в запросе;
- Требования к совпадению префикса: обычно он должен посимвольно совпадать с самого начала; любое изменение в нём приводит к тому, что вся последующая часть не используется из кеша;
- Минимальная длина и срок действия: слишком короткий префикс может не кешироваться, а после истечения срока действия кеш нужно записывать заново;
- Плата за запись: некоторые провайдеры берут за первую запись в кеш больше, чем за обычные входные токены; экономия появляется только при последующем чтении.
При сверке расходов учитывайте токены, прочитанные из кеша, отдельно от обычных входных токенов. Иначе снижение доли попаданий в кеш можно ошибочно принять за рост числа вызовов.
Токены рассуждений: их не видно, но за них нужно платить
Модели с рассуждением обдумывают ответ, прежде чем его выдать. Эти токены обычно тарифицируются как выходные. Во многих случаях рассуждения возвращаются не полностью, и узнать количество потраченных на них токенов можно только из данных об использовании.
Число токенов рассуждений зависит от сложности задачи и параметра интенсивности рассуждений. Даже при работе с одним и тем же API счёт может вырасти, если пользователи начнут задавать более сложные вопросы. Если для бизнеса нужна только простая классификация или преобразование формата, использование модели с рассуждением часто означает оплату ненужных размышлений.
Тарификация мультимодальных моделей: сначала выясните, за что именно платите
Подходы к тарификации мультимодальных моделей различаются сильнее всего, поэтому важно сверяться с официальной страницей цен каждой модели. В таблице ниже приведены распространённые способы расчёта; точные правила зависят от актуальных условий каждого поставщика.
| Тип | Распространённый способ тарификации | Ключевые параметры, влияющие на стоимость | Что стоит проверять |
|---|---|---|---|
| Входное изображение (понимание) | Пересчёт разрешения в токены или оплата за изображение | Размер изображения, параметр уровня детализации | Записывайте фактическое разрешение до и после загрузки |
| Генерация изображений | Оплата за изображение или за выходные токены | Размер, уровень качества, количество изображений | Записывайте параметры каждого запроса |
| Аудиовход/аудиовыход | Оплата по длительности или пересчёт в аудиотокены | Длительность аудио, способ обработки и дискретизации | Записывайте фактическую длительность аудио |
| Синтез речи | Оплата по количеству символов или токенов | Длина текста, категория голоса | Записывайте длину текста для синтеза |
| Генерация/понимание видео | Оплата за секунды, кадры или по категории разрешения | Длительность, разрешение, частота кадров | Записывайте сочетание длительности и разрешения |
| Embedding | Оплата за входные токены | Длина текста, размер пакета | Учитывайте отдельно от обычных входных токенов |
🎯 Технический совет: для мультимодальных сценариев лучше использовать единую точку входа — так проще централизованно управлять разными способами тарификации. В официальном описании APIYI apiyi.com указано, что на платформе для моделей используется единый баланс, а также доступны статистика использования и логи вызовов. Сначала проверьте в консоли, какие поля отображаются в логах, а затем решите, какие параметры нужно дополнительно записывать в таблицу для сверки расходов.
Как быстро разобраться со счётом за API большой языковой модели: сверка в 4 шага
Суть сверки проста: умножьте записанный объём использования на сохранённые тарифы, чтобы получить ожидаемую стоимость, а затем сравните её со счётом платформы. Если расхождение превышает допустимый предел, проверьте каждую статью по отдельности.
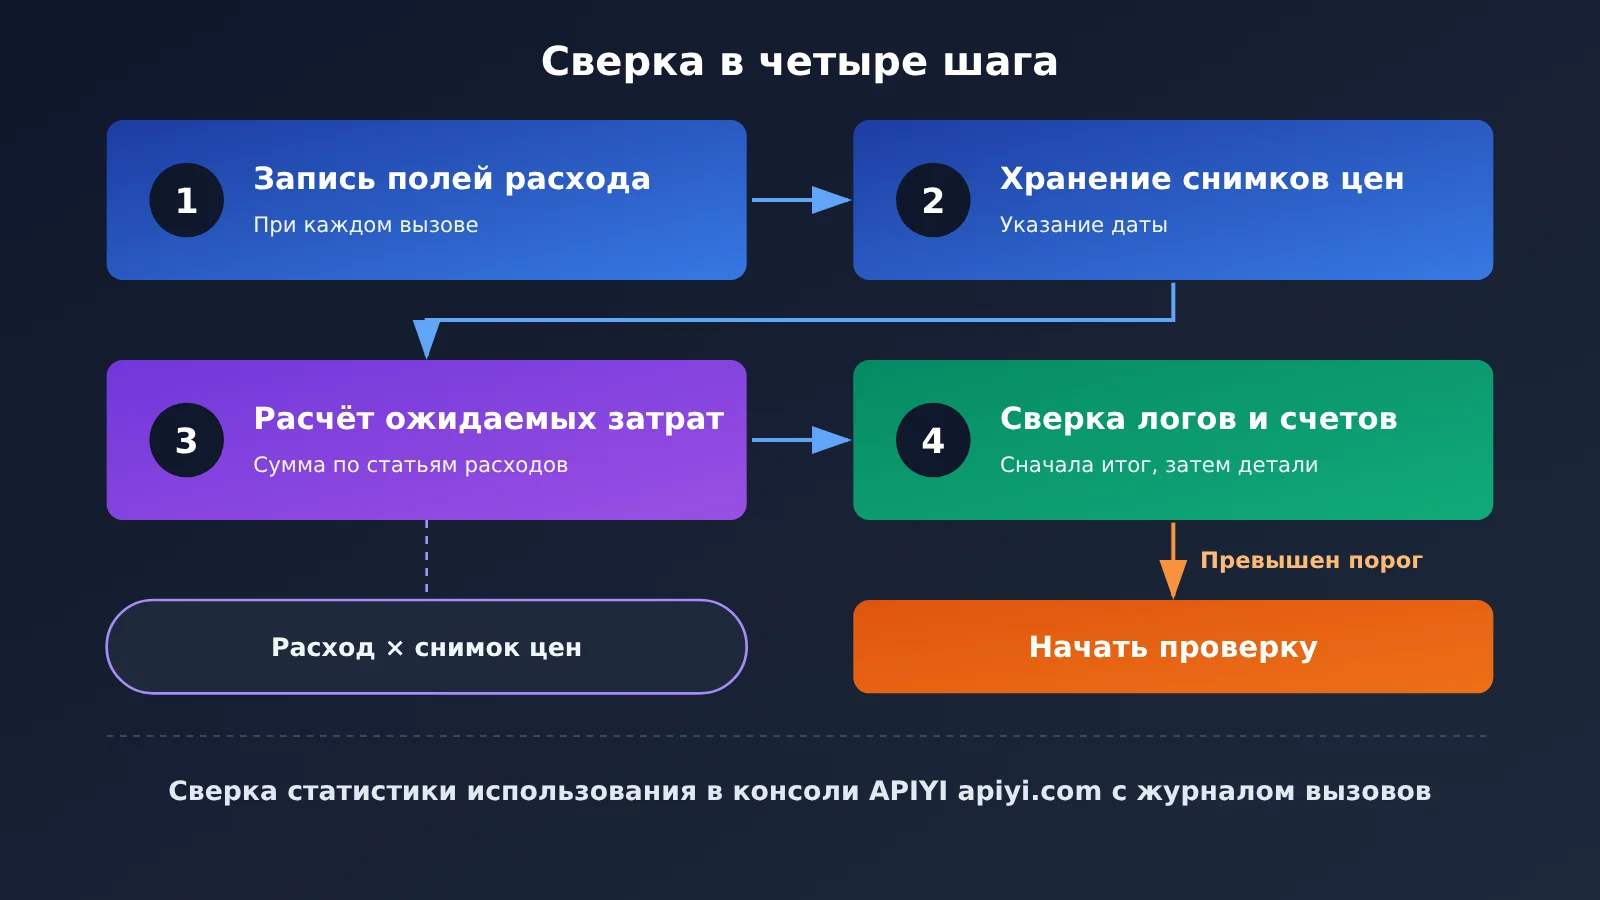
Шаг 1. Записывайте данные об использовании после каждого вызова
Интерфейсы в формате, совместимом с OpenAI, обычно возвращают в ответе объект usage. Ниже приведены распространённые поля и их значения. Ответы могут различаться в зависимости от модели и платформы, поэтому перед подключением стоит отправить тестовый запрос и проверить их.
| Поле (распространённое название в формате, совместимом с OpenAI) | Значение | Статья тарификации |
|---|---|---|
prompt_tokens |
Общее число входных токенов в запросе | Входные токены (включая кэшированные) |
prompt_tokens_details.cached_tokens |
Часть входных токенов, найденная в кэше | Чтение из кэша |
completion_tokens |
Общее число выходных токенов | Выходные токены (могут включать токены рассуждений) |
completion_tokens_details.reasoning_tokens |
Часть выходных токенов, относящаяся к рассуждениям | Рассуждения |
model |
Название модели, фактически вернувшей ответ | Помогает отслеживать смену версии |
Для каждого вызова рекомендуется сохранять в базе как минимум:
- время и ID запроса, идентификатор бизнес-сценария;
- название модели, указанное в запросе, и
model, возвращённое в ответе; - все поля использования из таблицы выше; отсутствующие поля оставляйте пустыми, а не записывайте как 0;
- параметры мультимодальных запросов, например размер изображения, длительность аудио и количество генерируемых объектов;
- выполнялся ли запрос в потоковом режиме, были ли повторные попытки и был ли ответ обрезан (
finish_reason).
Обратите внимание: prompt_tokens и completion_tokens обычно содержат общее количество токенов, а токены кэша и рассуждений входят в эти суммы. При расчёте стоимости сначала вычтите их из общего количества, а затем умножьте каждую категорию на соответствующий тариф. Иначе вы рискуете посчитать часть токенов дважды или не учесть скидку.
Шаг 2: Ведите таблицу цен с указанием дат
Не задавайте цены жёстко в коде. Лучше вести таблицу, где для каждой позиции указаны модель, тарифицируемая операция, цена за единицу, валюта, дата вступления в силу и источник — официальная страница с ценами или объявление платформы.
Когда цена меняется, добавляйте новую строку, а не перезаписывайте старую. Так при проверке счёта за любой день вы сможете пересчитать расходы по действовавшим тогда ценам. Если вы вызываете модели через платформу-агрегатор вроде APIYI, используйте цены, опубликованные платформой на текущий момент, и также указывайте дату проверки.
Шаг 3: Рассчитайте ожидаемые расходы
Ожидаемую стоимость одного вызова можно рассчитать как сумму нескольких составляющих:
- Входные токены, не найденные в кэше × цена за единицу входных токенов;
- Токены, считанные из кэша × цена за единицу чтения из кэша (если запись в кэш тарифицируется отдельно, добавьте и её стоимость);
- Видимые выходные токены × цена за единицу выходных токенов;
- Токены рассуждения × соответствующая цена за единицу (чаще всего она совпадает с ценой выходных токенов, но лучше свериться с официальной документацией);
- Мультимодальные данные рассчитываются отдельно по соответствующим правилам тарификации.
Сгруппировав результаты по дням, моделям и бизнес-сценариям, вы получите таблицу ожидаемых расходов — того, сколько, по вашим расчётам, вы должны были потратить.
Шаг 4. Сверьте данные с логами и счетами платформы
Сопоставьте свои записи со статистикой использования и логами вызовов платформы. Сначала сравните общие суммы, затем расходы по моделям и, наконец, найдите конкретные запросы, по которым возникли расхождения.
Рекомендуем установить допустимый порог расхождений. Небольшие различия из-за обменного курса, точности расчётов или часового пояса статистики — обычное дело. Проверять каждую запись нужно только в том случае, если расхождение превышает порог.
🚀 Быстрый старт: если вы уже вызываете модели через APIYI apiyi.com, экспортируйте логи вызовов за выбранный период и построчно сопоставьте их с записанными у себя полями
usage. Разделение токенов кэша и токенов рассуждения в логах зависит от того, какие поля сейчас предоставляет платформа. Если они не указаны отдельно, используйте для детализации поля ответов, сохранённые локально.
Признаки аномалий в счёте за API больших языковых моделей: как разобраться в резком изменении расходов
Если стоимость однотипных запросов внезапно изменилась, это повод насторожиться. В таблице ниже собраны частые причины и способы их проверки.
| Признак аномалии | Возможная причина | Как проверить |
|---|---|---|
| Стоимость одного запроса выросла, а число вызовов не изменилось | Псевдоним модели указывает на новую версию с другой ценой или расходом токенов | Сравните значения поля model в ответах до и после изменения |
| Расходы на ввод выросли, а общее число входных токенов не изменилось | Снизилась доля попаданий в кэш | Проверьте долю cached_tokens и выясните, не изменился ли префикс промпта |
| Расходы на вывод выросли, а длина видимого ответа не изменилась | Увеличилось число токенов рассуждения | Проследите динамику reasoning_tokens и проверьте параметр интенсивности рассуждений |
| Число входных токенов постепенно растёт | История диалога не обрезается, увеличилось число фрагментов поиска или определений инструментов | Выборочно изучите полные тела запросов |
| Вызовов больше, чем ожидается с учётом объёма операций | Клиент повторяет запросы или отправляет их заново после тайм-аута | Подсчитайте запросы без дубликатов по ID запроса и ID бизнес-операции |
| Расходы на изображения или видео резко выросли | Увеличили разрешение, уровень качества или количество генерируемых материалов | Сравните параметры в запросах |
| Цена за единицу в счёте не совпадает с сохранёнными ценами | Официальный поставщик или платформа изменили цены | Проверьте страницу с ценами и объявления, обновите сохранённые цены |
Потеря попаданий в кэш: самый незаметный рост расходов
Потеря попаданий в кэш часто становится результатом изменения, которое кажется безобидным. Например, в начало системного промпта добавили текущую дату или вставили в префикс ID пользователя. Из-за этого префикс каждого запроса отличается, кэш перестаёт работать, а стоимость ввода сразу возвращается к полной цене.
Лучше размещать постоянное содержимое в начале, а изменяемое — в конце. После изменения шаблона промпта уже на следующий день проверьте, не изменилась ли доля попаданий в кэш.
Изменение длины рассуждений: сложность задач тоже влияет на счёт
Расходы на модели с рассуждениями зависят от сложности вопросов. Если в какой-то день пользователи зададут много сложных вопросов, число токенов рассуждения заметно вырастет — это нормальное колебание. Но если оно продолжает расти при неизменном типе запросов, проверьте, не изменились ли версия модели или параметры рассуждений.
Как отслеживать изменения цен в счетах за API больших языковых моделей
На изменение цен повлиять нельзя, но можно вовремя его заметить. Вот несколько привычек, которые помогут держать расходы под контролем:
- Каждую неделю: проверяйте динамику расходов по моделям и среднюю стоимость одного вызова, обращая внимание на резкие изменения;
- Каждый месяц: проводите полную сверку счетов и выясняйте причины каждого расхождения, превышающего заданный порог;
- После каждого изменения шаблона промпта: в течение 1–2 дней следите за долей попаданий в кэш;
- Перед каждым переходом на другую модель или обновлением модели: сравнивайте расход токенов и стоимость старой и новой моделей на небольшой доле трафика;
- Следите за объявлениями: подпишитесь на новости об изменениях цен и обновлениях моделей у своих поставщиков или платформ и сразу обновляйте сохранённые данные о ценах;
- Фиксируйте версии: в продакшене по возможности используйте имена моделей с конкретным номером версии, чтобы автоматическое обновление модели, связанной с алиасом, не стало неожиданностью.
💡 Совет по выбору: если вы используете модели нескольких поставщиков, сверка счетов в разных аккаунтах может занимать много времени. Единое подключение через APIYI apiyi.com позволяет просматривать использование разных моделей с одним балансом и в общей системе логов — так проще сравнивать стоимость вызовов. Какие именно данные доступны, лучше заранее проверить в консоли.
Частые вопросы FAQ
Q1: Что такое токены в счёте за API большой языковой модели?
Токен — базовая единица текста, которую обрабатывает модель. Его можно представить как фрагмент, полученный при разбиении текста. Одному китайскому иероглифу может соответствовать один или несколько токенов — это зависит от токенизатора модели. В счёте количество токенов обычно тарифицируется отдельно по категориям: входные, выходные, кешированные, токены рассуждений и другие.
Q2: Чем кешированные токены отличаются от обычных входных?
И те и другие относятся к входным токенам, но кешированные токены — это часть запроса, совпавшая с уже сохранённым в кеше префиксом. На них обычно действует скидка. Обычные входные токены оплачиваются по полной цене. Некоторые поставщики также отдельно взимают плату за первоначальную запись в кеш, поэтому при сверке все три категории нужно учитывать раздельно.
Q3: Почему токены рассуждений не видны в ответе?
Токены рассуждений возникают в процессе внутренней работы модели. Многие модели не возвращают полный ход рассуждений, а указывают только количество таких токенов в поле с данными об использовании. Обычно они оплачиваются по тарифу выходных токенов, поэтому даже короткий ответ может оказаться недешёвым.
Q4: Почему стоимость одного и того же запроса может внезапно измениться?
Самые частые причины — три: псевдоним модели стал указывать на новую версию, изменился префикс промпта и кеш перестал срабатывать или увеличилась длина рассуждений. Другие возможные причины — повторное списание из-за повторных попыток и увеличение параметров мультимодального запроса. Чтобы найти причину, проверьте по очереди признаки из таблицы аномалий в этой статье.
Q5: Как сверить счёт за API большой языковой модели с помощью логов платформы?
Сначала записывайте в своей системе поле `usage` и ID запроса для каждого ответа. Затем выгрузите логи вызовов платформы и сопоставьте их с записями по каждому запросу. Например, в консоли APIYI apiyi.com можно посмотреть статистику использования и логи вызовов. Сначала убедитесь, какие поля есть в логах, а затем объедините их с локальными записями для сверки.
Q6: Как оценить стоимость работы мультимодальной модели?
Сначала проверьте на официальной странице цен, как рассчитывается стоимость: за изображение, за секунду или через пересчёт разрешения в токены. Затем записывайте в логах запросов соответствующие параметры, например размер изображения, длительность аудио, разрешение и длительность видео. Чтобы оценить расходы, умножьте эти значения на цену за единицу.
Q7: Что проверить в первую очередь, если при сверке обнаружилось расхождение?
Сначала убедитесь, что снимок цен актуален, чтобы исключить изменение тарифов. Затем сравните количество вызовов и проверьте, не было ли повторных попыток и дублирующих запросов. Наконец, разбейте расхождения по моделям и статьям тарификации, чтобы выяснить, где возникла разница: во входных, кешированных токенах, токенах рассуждений или мультимодальной части.
Q8: Какие ограничения есть у этого метода сверки?
Он зависит от полей с данными об использовании, возвращаемых в ответе. Если некоторые модели или интерфейсы не возвращают подробные данные о кеше и токенах рассуждений, остаётся полагаться только на счёт платформы. Кроме того, курсы валют, точность расчётов и часовые пояса статистики могут приводить к небольшим расхождениям. Поэтому стоит установить разумный порог отклонения, а не добиваться абсолютной точности.
Ключевые выводы о счетах за API больших языковых моделей
- Стоимость складывается из нескольких частей: входные, выходные, кешированные и токены рассуждений, а также мультимодальные данные тарифицируются по-разному. Их нужно учитывать отдельно.
- Входные токены — это не только вопрос пользователя: в них входят системный промпт, история диалога, найденные документы и определения инструментов.
- Попадание в кеш зависит от совпадения префикса: размещайте постоянное содержимое в начале, а переменное — в конце. После изменения шаблона проверяйте долю попаданий в кеш.
- Токены рассуждений не видны, но за них взимается плата: для простых задач не используйте модели с рассуждениями и следите за изменением длины рассуждений.
- Для мультимодальных данных сначала выясните единицу тарификации: стоимость может рассчитываться за изображение, секунду или с учётом разрешения. Ориентируйтесь на официальную страницу с ценами.
- Сверка в четыре шага: записывайте данные об использовании, сохраняйте цены на определённую дату, рассчитывайте ожидаемые расходы и сравнивайте их с журналами и счётом.
- Единая точка доступа упрощает сверку: единый баланс и журналы вызовов APIYI apiyi.com помогут централизованно проверить использование нескольких моделей.
Итоги
Чтобы разобраться в счёте за API больших языковых моделей и проверить его, важно соблюдать три правила:
- Разбивайте расходы: разделяйте стоимость каждого вызова на входные и выходные токены, кеш, рассуждения и мультимодальные данные, определяя источник каждой статьи;
- Ведите свой учёт: сохраняйте в базу данные об использовании и параметры каждого вызова, а также снимки цен с указанием даты;
- Регулярно сверяйте данные: каждую неделю проверяйте динамику, каждый месяц сверяйте итоговый счёт. При резком изменении расходов последовательно проверяйте версию модели, попадания в кеш, длину рассуждений, повторные попытки и параметры запросов.
Операторы платформ отдельно проверяют принципы тарификации, но и пользователям API важно выработать привычку самостоятельно сверять расходы. Если вашему бизнесу нужно одновременно обращаться к моделям разных поставщиков, можно подключить их через APIYI apiyi.com, просматривать использование и журналы вызовов в одной консоли, а затем проверять расходы описанным в статье способом.
📚 Источники
- Вакансия на V2EX: специалист по эксплуатации платформы больших языковых моделей в компании, разрабатывающей инфраструктуру AI-агентов: среди обязанностей указана «проверка расходов и начислений»
- Ссылка:
v2ex.com/t/1254263 -
Описание: опубликована 2026-11-03. В вакансии говорится о необходимости проверять правила тарификации входных и выходных токенов, токенов кэша и рассуждений, а также изображений, аудио и видео; выявлять аномалии в счетах, изменения цен и расхождения в начислениях
-
Официальные страницы с тарифами поставщиков моделей: единственный авторитетный источник конкретных цен и правил тарификации
- Ссылка: ищите в разделе тарифов или документации на официальном сайте используемого поставщика
- Описание: цены часто меняются, поэтому при цитировании обязательно указывайте дату проверки
Автор: техническая команда APIYI
Технические вопросы: если у вас есть вопросы о проверке счетов за API больших языковых моделей, свяжитесь с нами через главную страницу APIYI apiyi.com. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com