作者注:從 f(t) 渲染原理和 SenseNova 6.8 Code2Video 案例出發,用 4 個問題判斷視頻該走代碼生成還是像素生成。
做科普講解、公式推導或數據動畫時,很多創作者都遇到過同樣的麻煩:畫面看起來不錯,文字卻錯了,公式也變了形,重新生成一次又帶來新的問題。本文將介紹 代碼生成視頻 vs 像素生成視頻的選型方法,幫你判斷哪些視頻應該讓 AI 寫代碼,哪些不應該。
這不是一篇“代碼路線取代一切”的宣傳稿。 本文以 2026 年 11 月 3 日一篇開源模型實踐分享帖介紹的 SenseNova 6.8 Code2Video 爲案例,拆解原理和流程,也會說明資料尚未證實的部分。
核心價值:讀完本文,你將理解代碼生成視頻如何從時間函數 f(t) 變成 MP4,並能用 4 個問題判斷自己的視頻類型適合哪條路線。
代碼生成視頻 vs 像素生成視頻核心要點
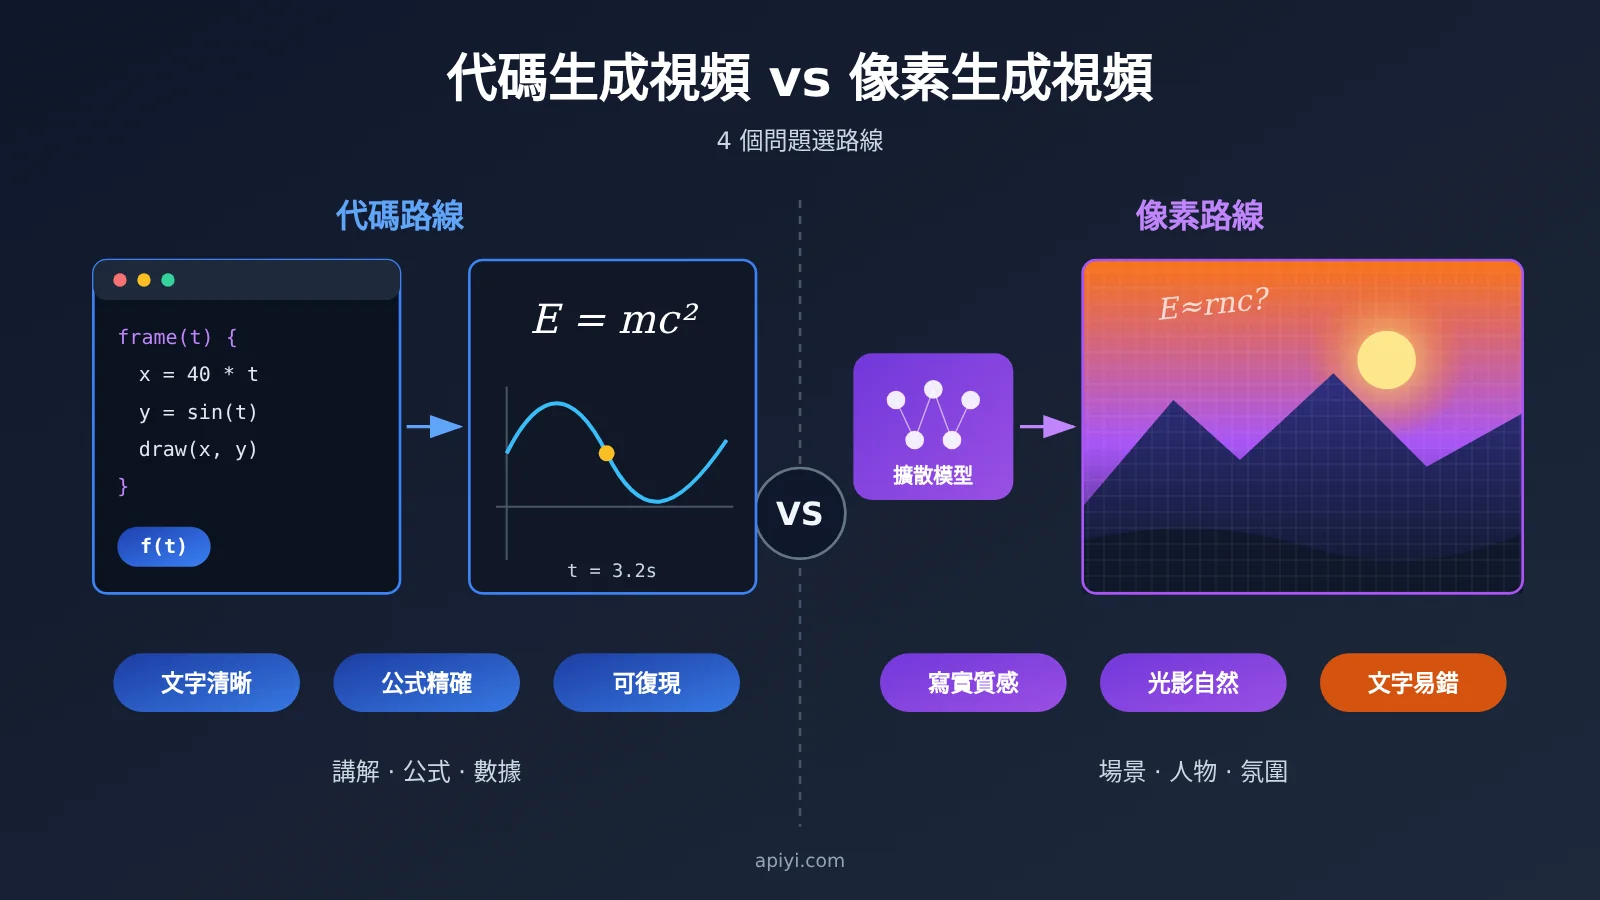
兩條路線的根本差異不在模型大小,而在模型最終產出什麼。像素路線直接產出畫面,代碼路線則產出一個能夠渲染畫面的程序。
| 對比維度 | 代碼生成視頻 | 像素生成視頻 |
|---|---|---|
| 模型產出 | HTML/CSS、Canvas、SVG、Three.js、Manim、p5.js 等可執行代碼 | 直接生成每一幀的像素 |
| 文字與公式 | 以字符和輸入數據的形式渲染 | 由模型生成圖像,分享帖作者稱常見亂碼和變形 |
| 修改方式 | 修改規格或源碼後重新渲染 | 通常要調整提示詞後重新生成 |
| 復現能力 | 同一份純函數代碼可重複渲染 | 取決於具體模型和工具 |
| 主要風險 | 寫實質感可能不足,需要搭建渲染環境 | 精確信息難以保證,需要反覆篩選 |
需要說明的是,“像素擴散模型常見文字亂碼、公式變形、物理穿模”來自分享帖作者的概括,並沒有附帶對比測試。可以把它當作選型時的風險提示,正式決策前最好用自己的素材各跑一遍。
代碼生成視頻的工作原理:畫面是時間的純函數
Code2Video 的核心是把每一幀寫成時間參數 t 的純函數。給定任意時間點,程序都能算出所有元素的位置、形變和色彩。由於畫面不依賴系統實時時鐘,同一份代碼重複渲染,結果應當保持一致。
完整的渲染鏈路可以拆成 4 步:
- 寫時間函數:模型把構圖、運動和節奏寫成隨 t 變化的代碼。
- 逐幀步進:Playwright 啓動無頭 Chromium,按幀率依次設置時間點。以 12 秒、30fps 爲例,總共需要渲染 360 幀。
- 截圖生成序列幀:每到一個時間點就截取一張高清畫面。
- FFmpeg 合成:把序列幀和音軌合成爲最終的 MP4。
這與錄屏有本質區別。錄屏受設備實時性能影響,而逐幀渲染即使某一幀計算得慢,也不會改變它在時間軸上的位置。實踐中還要注意,未固定種子的隨機數或不同機器上的字體差異,都可能破壞這種確定性。
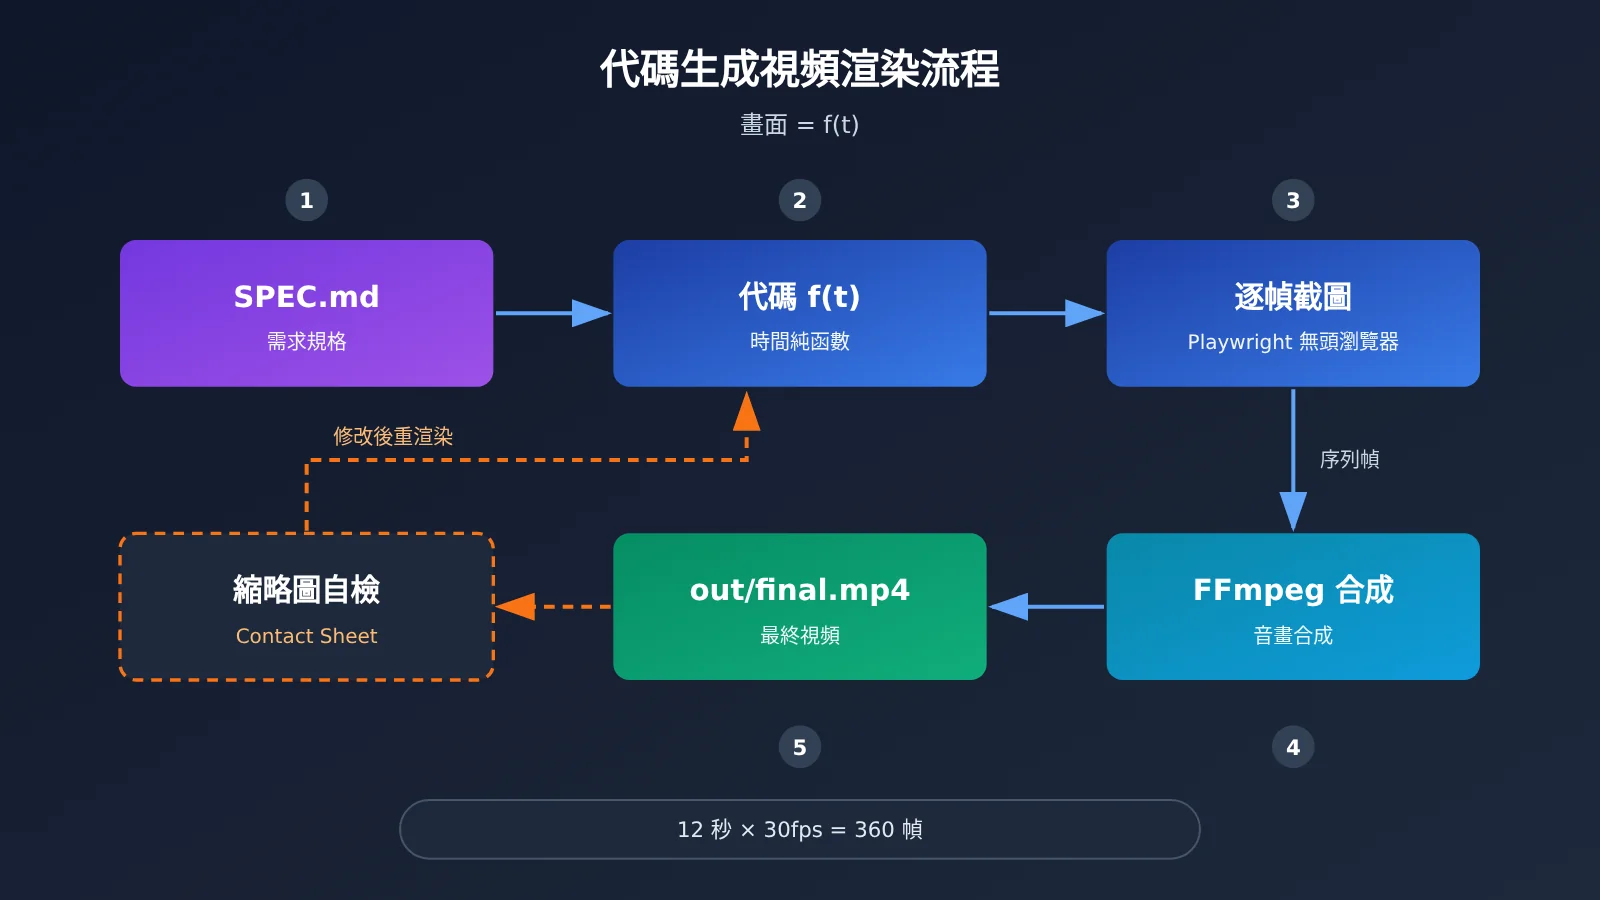
代碼生成視頻的確定性來自規格,而不只是代碼
分享帖認爲,普通模型一句話生成的代碼動畫容易粗糙,關鍵差別在工作流。Code2Video 配合 code-video Skill,會先把需求轉成可覈查的 SPEC.md,確定構圖、配色、緩動曲線和分鏡時間軸。自然語言修改也主要作用於這份規格,因此多輪調整後風格和邏輯更容易保持一致。
初版渲染後,模型會抽取關鍵幀生成 Contact Sheets,檢查文字重疊、元素出畫和節奏問題,然後修改代碼並重新渲染。據帖子介紹,單次任務可支撐 10 小時以上、超過 2,000 輪工具調用,最終輸出 VERIFY.md 和 out/final.mp4。這些數字屬於項目方向的說法,模型參數和能力請以官方倉庫及模型卡爲準。
💡 技術建議:如果暫時不想部署大模型,可以先通過 API易 apiyi.com 的統一接口,讓不同文本模型基於同一份需求生成
SPEC.md,比較分鏡和約束寫得是否清楚。這一步不涉及渲染,卻能較快驗證需求是否足夠明確。
用 4 個問題判斷代碼生成視頻 vs 像素生成視頻
選型時不必先爭論哪種模型更強,先拆解視頻中最不能出錯的要素。下面 4 個問題可以按順序回答:
- 有沒有必須一字不差的內容? 例如術語、公式、價格、圖表數值。
- 有沒有必須精確控制的數值? 例如座標、時長、運鏡路徑、音樂卡點。
- 會不會反覆局部修改? 例如只換配色、只加一個標註,其餘內容必須保持不變。
- 畫面價值是否依賴真實質感? 例如真實人物、實拍環境、自然光影。
前 3 個問題中有 2 個以上回答“是”,且第 4 個回答“否”,優先考慮代碼路線。第 4 個回答“是”時,代碼路線很可能不是首選。不過這只是基於原理的推斷,參考資料沒有提供寫實風格的對比證據,建議自行測試。
| 視頻要素 | 依賴的能力 | 建議路線 | 判斷理由 |
|---|---|---|---|
| 字幕與排版 | 字符準確、佈局穩定 | 代碼優先 | 文字以字符方式排版 |
| 公式與圖表 | 數據和結構準確 | 代碼優先 | 內容可直接來自輸入 |
| 鏡頭與節拍 | 時間點和路徑精確 | 代碼優先 | 時長、節拍和路徑都是數字 |
| 物理與粒子模擬 | 方程驅動 | 代碼優先 | 運動可由數學和物理公式計算 |
| 真人與實拍質感 | 真實感和細節 | 像素或實拍優先 | 代碼路線的效果尚缺證據,需要實測 |
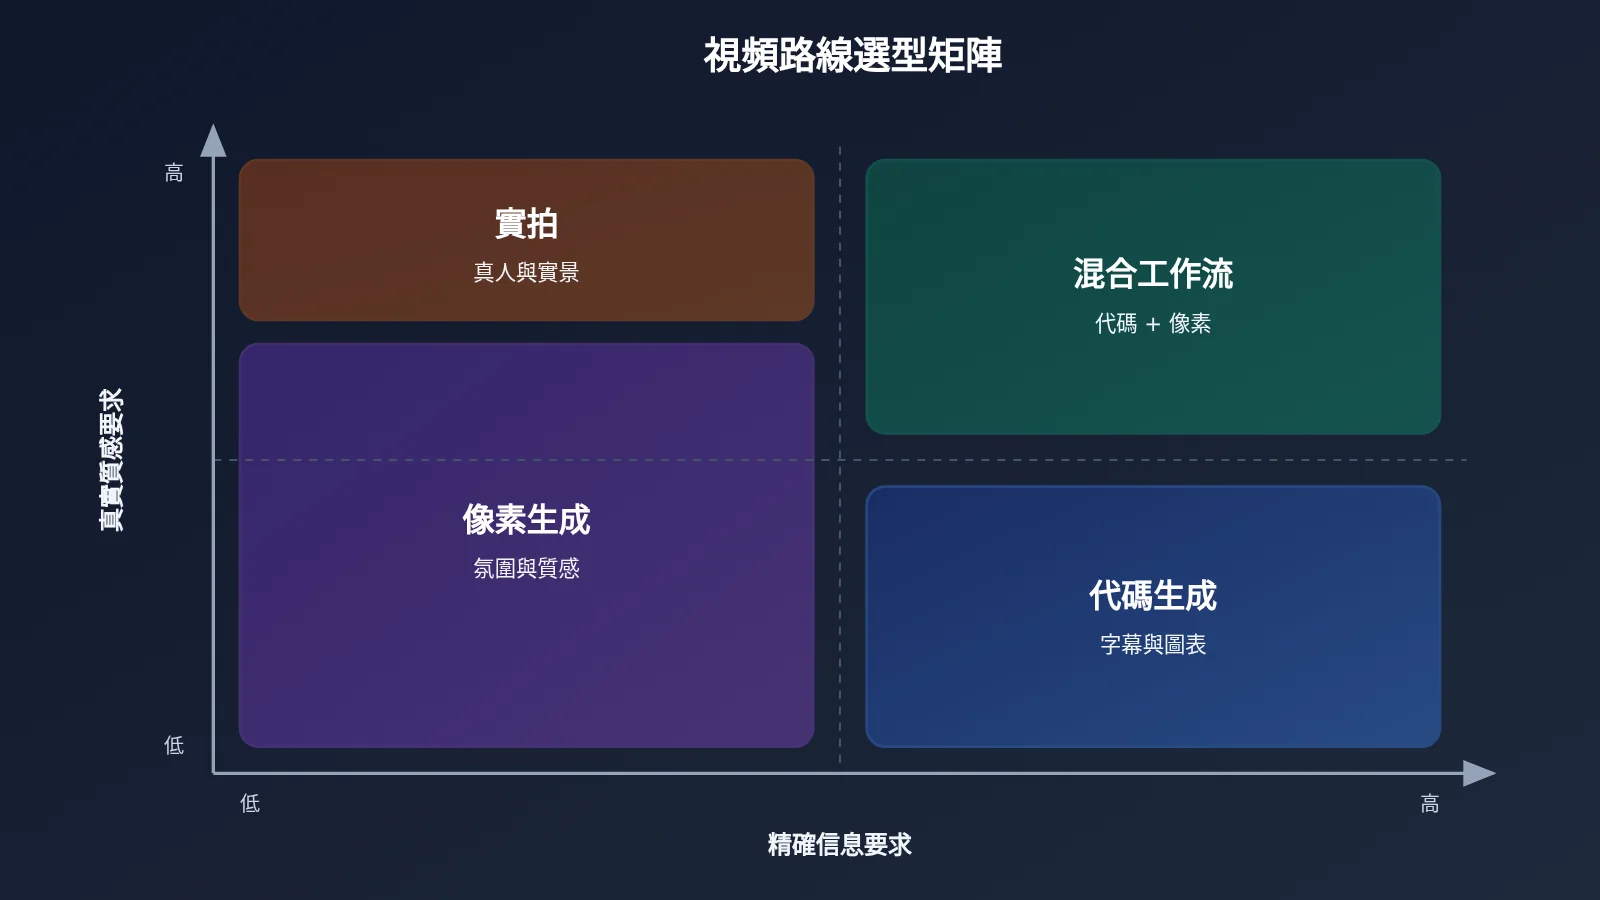
如果想爲上圖補充自己的判斷依據,可以固定同一份腳本,通過 API易 apiyi.com 接入可用的文本和視頻模型做小樣對比。具體模型是否可用,以平臺當前列表爲準。
代碼生成視頻適合的 6 類場景
code-video Skill 提供了 8 個領域的工藝指南,其中可以歸納出這些比較適合優先嚐試的場景。表中的“適合程度”是本文根據原理作出的判斷,並非官方評級。
| 視頻類型 | 對應指南 | 適合程度 | 注意事項 |
|---|---|---|---|
| 科普與數據可視化 | explainer-diagrams.md |
高 | 輸入數據要先校對 |
| 動態排版與 UI 動效 | motion-graphics-and-promos.md |
高 | 需提前準備所需字體 |
| 音樂卡點短片 | music-and-beat-sync.md |
高 | 需明確節拍和切鏡時間 |
| 粒子與物理模擬 | simulations-and-generative.md |
高 | 要約束參數和種子 |
| 3D 產品展示 | threejs-scenes-and-cameras.md |
中 | 質感需看樣片判斷 |
| 風格化角色動畫 | character-and-creature-motion.md |
中 | 不等於寫實人物表演 |
需要警惕的是,代碼路線保證的是“按輸入精確呈現”,而不是“內容一定正確”。如果腳本把公式寫錯了,它也會把錯誤公式清晰地渲染出來,所以事實校對仍然要由人負責。
代碼生成視頻快速上手:以 Code2Video 爲例
以下流程整理自分享帖,適合已有 GPU 環境的工作流搭建者。部署參數可能隨版本變化,操作前請先對照官方 README。
第 1 步:準備代碼生成視頻環境
建議提前裝好依賴,避免 Agent 首次運行時花大量時間配置環境。
| 組件 | 要求 | 作用 |
|---|---|---|
| 編程 Agent | Codex 或 Claude Code 等 | 執行寫碼、渲染和修復循環 |
| Node.js | 18 及以上 | 運行前端渲染工程 |
| Python 3 | 安裝倉庫 requirements.txt 依賴 |
處理音頻和輔助腳本 |
| FFmpeg / FFprobe | 系統可調用 | 合成視頻並校驗媒體流 |
| Playwright | 包含 Chromium 和對應語言字體 | 無頭瀏覽器逐幀截圖 |
第 2 步:部署模型並安裝 Skill
- 下載權重:
huggingface-cli download sensenova/SenseNova-6.8-Code2Video --local-dir /path/to/SenseNova-6.8-Code2Video - 啓動服務:帖子使用 vLLM 容器提供 OpenAI 兼容接口,並以 4 卡張量並行爲例。關鍵參數包括
--tensor-parallel-size 4和--max-model-len 524288。 - 克隆倉庫:
git clone https://github.com/OpenSenseNova/SenseNova-6.8-Code2Video.git - 創建隔離目錄:
mkdir -p ~/video_tasks/methane_explainer/.claude/skills。Agent 會自動執行 Shell 命令,請不要在重要工程目錄中運行。 - 複製 Skill:
cp -r SenseNova-6.8-Code2Video/skills/code-video ~/video_tasks/methane_explainer/.claude/skills/code-video - 聲明上下文:帖子給出的環境變量爲
CODEX_MAX_CONTEXT_TOKENS=524288、CODEX_AUTOCOMPACT_PCT=80和CODEX_MAX_OUTPUT_TOKENS=64000。
帖子裏同時出現了 .claude/skills 和 .codex/skills 兩種路徑,實際目錄應按所用 Agent 和官方說明確認。
如果團隊還處在評估階段,不必一開始就投入多卡環境。可以先用 API易 apiyi.com 接入現有編程模型,跑通規格書和簡單 Canvas 動畫的流程,再決定是否部署專用模型。這樣能先驗證需求和工作流,但成片效果不能直接代表 Code2Video 的能力。
第 3 步:把一句話擴寫成代碼生成視頻 Brief
帖子的示例是一條 12 秒的甲烷燃燒科普短片。一句話需求會被擴寫爲結構化 Brief,也可以使用倉庫 prompts/ 目錄下的 Enhance Prompt 模板生成 dense_prompt.md。一份合格的 Brief 至少應寫清以下內容:
- 基礎規格:分辨率 1920×1080、幀率 30fps、時長 12 秒、程序化音效。
- 教學目標:說明化學反應只重排原子,不創造也不消滅原子。
- 時間軸:0–3 秒展示反應物,3–7 秒斷鍵,7–10 秒重組,10–12 秒顯示配平方程式。
- 硬約束:右上角計數器全程鎖定爲
C: 1 | H: 4 | O: 4。
最後一條最能體現代碼路線的優勢。計數器不需要模型“記住”它的外觀,只需在程序中固定渲染這組值,就能全程保持一致。
第 4 步:用自然語言精修代碼生成視頻
首版成片通常只是起點。帖子建議在同一任務目錄中使用 --continue 繼續修改,並掌握 3 個提示詞技巧:
- 先鎖定不變項:開頭寫明
Keep the molecular coordinates, bond-breaking timing...,防止改樣式時重寫時間軸。 - 給出精確時間點:例如
At 3.5s when bonds break...,方便模型定位到對應時間段。 - 要求原地修改:結尾寫上
Edit the existing source in place and overwrite out/final.mp4.,避免另起一份新工程。
沒有源碼時,還可以把參考視頻放入項目目錄,讓模型分析佈局、轉場和運動軌跡,再重構爲可編輯工程。這一能力適合學習結構和節奏,但用於發佈前,應確認參考素材的版權和授權範圍。
🚀 流程建議:長程任務開始前,可以先通過 API易 apiyi.com 調用文本模型,複覈腳本中的公式、術語和旁白,再把定稿內容寫入
SPEC.md。在渲染前修正事實錯誤,通常比成片後返工更省事。
代碼生成視頻 vs 像素生成視頻常見問題 FAQ
Q1:什麼是代碼生成視頻?
代碼生成視頻是指由 AI 編寫可執行的圖形或前端代碼,再把代碼逐幀渲染成視頻。模型不直接生成像素,而是定義每個時間點的畫面規則。
Q2:代碼生成視頻和像素生成視頻最大的區別是什麼?
區別在於產物和修改方式。代碼路線留下可編輯的工程,適合控制文字、公式和節拍;像素路線直接輸出畫面。至於真實感表現和綜合成本,目前資料不足,需要按項目實測。
Q3:代碼生成視頻能完全替代 Sora、Runway 這類工具嗎?
目前不能這樣下結論。資料主要展示了科普、動效和風格化案例,並未證明代碼路線能勝任實拍質感。更穩妥的做法是根據視頻中最關鍵的要素選擇路線,必要時再嘗試混合製作。
Q4:代碼生成視頻一定比像素生成視頻便宜嗎?
不一定。分享帖開頭提到的高額成本沒有給出來源,本文不將其作爲依據。代碼路線的成本取決於模型調用、硬件和迭代輪數,長程任務也可能消耗不少資源,建議先做短片小樣再估算。
Q5:沒有多卡 GPU,如何驗證代碼生成視頻工作流?
可以先做一段 10 秒左右的 SVG 或 Canvas 動畫,重點驗證規格書、渲染腳本和修改流程。通過 API易 apiyi.com 接入兼容接口後,只需切換模型名即可比較不同模型的代碼質量。接口配置和可用模型請查閱 docs.apiyi.com。
Q6:Code2Video 有哪些限制需要提前瞭解?
帖子只給出了 4 卡並行示例,未說明最低硬件配置,INT4 和 INT8 量化權重也要等待後續發佈。此外,資料缺少渲染耗時和客觀成片樣例,寫實表現也有待驗證。Agent 會自動執行命令,務必在隔離目錄中運行。
Q7:兩條路線可以混合使用嗎?
從工作流上可以嘗試,例如用實拍或像素模型製作背景素材,再用代碼疊加標題、公式和圖表。參考資料沒有驗證這種做法,需要先測試素材嵌入和逐幀渲染是否同步。比較素材模型時,也可以通過 API易 apiyi.com 查看當前可接入的選項。
代碼生成視頻 vs 像素生成視頻 Key Takeaways
- 核心差異:代碼路線生成可渲染的程序,像素路線直接生成畫面。
- 確定性來源:畫面是 f(t) 的純函數,並由無頭瀏覽器逐幀渲染。
- 優先場景:文字、公式、數據、座標和節拍要求精確時優先考慮代碼。
- 工作流關鍵:
SPEC.md、縮略圖自檢和原地修改共同保證多輪一致性。 - 主要邊界:寫實和實拍質感缺少證據,不能默認代碼路線同樣擅長。
- 上手建議:先用短片小樣和 API易 統一接口驗證需求,再投入專用部署。
總結:什麼視頻該讓 AI 寫代碼
選擇代碼生成視頻 vs 像素生成視頻時,可以記住 3 個要點:
- 看要素:畫面中的文字、公式、數據和時間點越不能出錯,越適合代碼路線。
- 看修改:需要多輪局部調整且保持其餘內容不變時,可編輯工程更有優勢。
- 看質感:真實人物和實拍氛圍是核心價值時,不要默認代碼路線能夠勝任。
下一步可以選一條 10–15 秒的現有視頻,用 4 個問題拆解後分別製作小樣,比較準確性、修改次數和實際耗時。需要同時評估多個模型時,可以通過 API易 apiyi.com 用統一接口完成腳本擴寫和代碼生成測試,再根據結果決定是否部署 Code2Video。
📚 參考資料
- 分享帖 – SenseNova 6.8 Code2Video 實踐介紹:本文的原理、流程和案例來源
- 鏈接:
v2ex.com/t/1254274 -
說明:發佈於 2026 年 11 月 3 日,其中部分比較和成本說法缺少獨立驗證。
-
GitHub – SenseNova 6.8 Code2Video:官方倉庫與 code-video Skill
- 鏈接:
github.com/OpenSenseNova/SenseNova-6.8-Code2Video -
說明:部署方式、目錄結構和功能更新應以此爲準。
-
Hugging Face – SenseNova 6.8 Code2Video:模型權重發布頁
- 鏈接:
huggingface.co/sensenova/SenseNova-6.8-Code2Video - 說明:用於覈實模型規格、權重版本和量化進度。
作者:APIYI 技術團隊
技術交流:如需瞭解多模型統一接入方式,可訪問 API易 apiyi.com 或 docs.apiyi.com 文檔中心