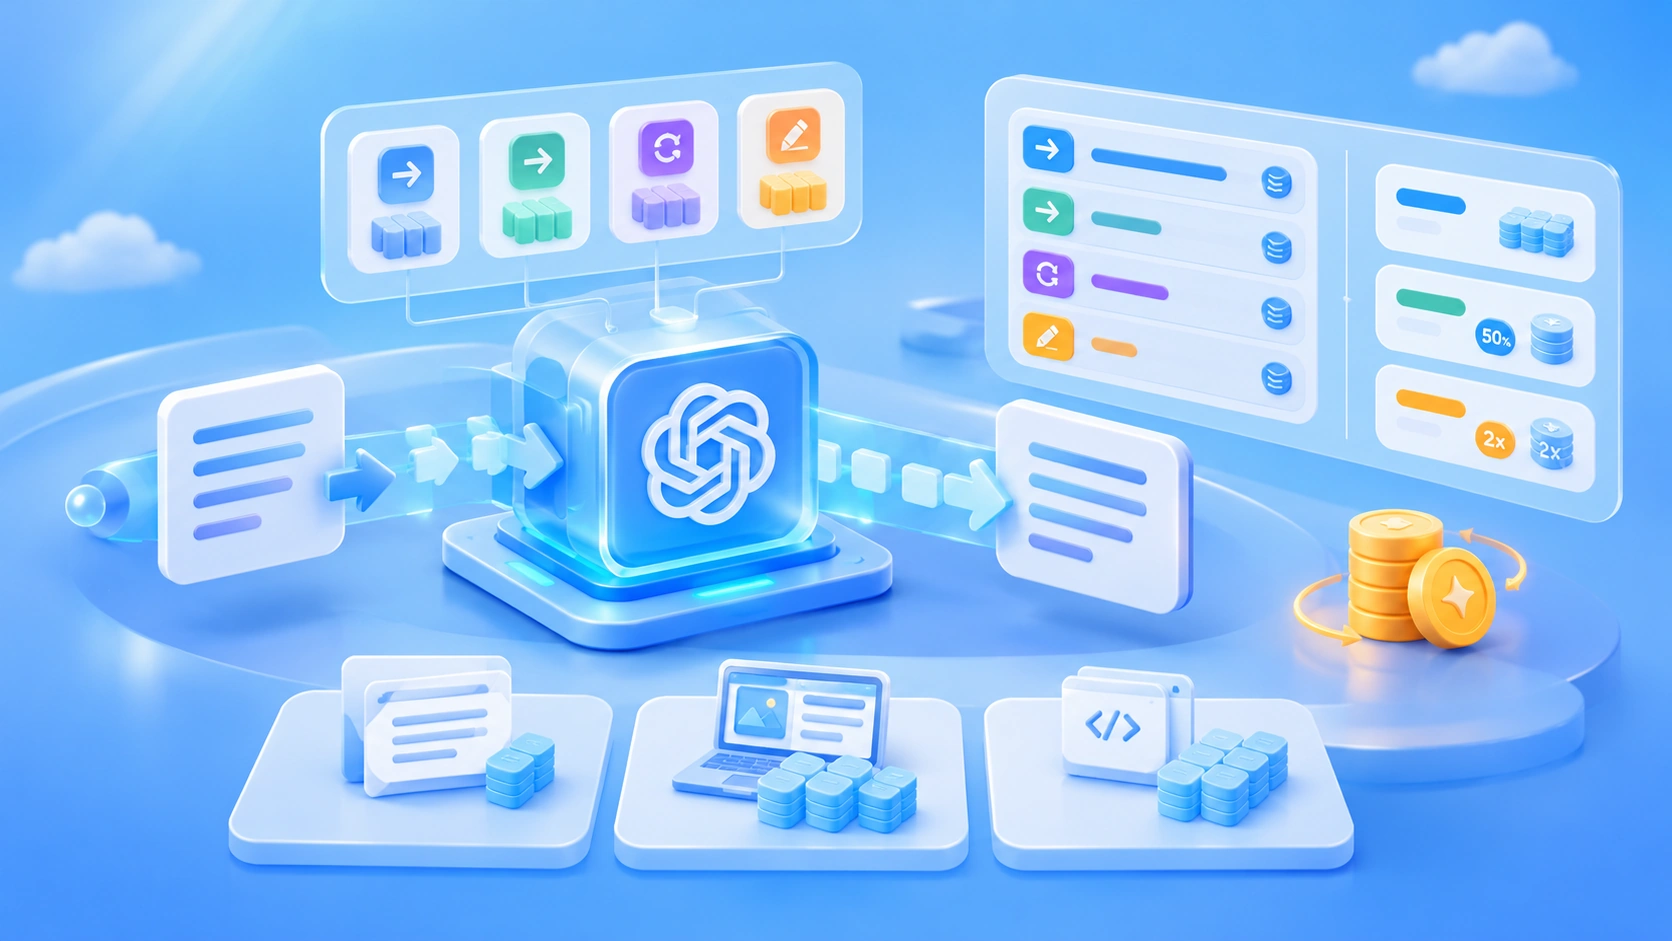
Catatan penulis: Artikel ini membahas komponen tagihan API Model Bahasa Besar—token input, output, cache, penalaran, dan multimodal—serta cara memeriksa penggunaan, menemukan lonjakan biaya, dan menyikapi perubahan harga.
Di akhir bulan, Anda membuka tagihan dan mendapati biaya suatu model naik cukup besar dibandingkan bulan lalu, padahal jumlah pemanggilannya hampir tidak berubah. Situasi ini sering dialami tim yang sudah menggunakan API Model Bahasa Besar di lingkungan produksi. Artikel ini membahas cara menguraikan komponen biaya dan mencocokkannya dengan log pemanggilan agar Anda bisa memahami dan memeriksa tagihan API Model Bahasa Besar.
Ini bukan rangkuman harga. Harga dari tiap penyedia sering berubah, jadi artikel ini tidak mencantumkan tarif spesifik. Fokusnya adalah dasar penagihan dan cara pemeriksaan yang tetap relevan dalam jangka panjang.
Ada satu sinyal industri yang patut diperhatikan: pada November 2026, sebuah perusahaan infrastruktur AI membuka lowongan untuk posisi operasional platform Model Bahasa Besar. Tanggung jawabnya secara jelas mencakup “verifikasi biaya dan penagihan”: memeriksa dasar penagihan token input/output, token cache, token penalaran, serta gambar, audio, dan video. Posisi tersebut juga bertugas mendeteksi tagihan tidak wajar, perubahan harga, dan selisih penagihan. Jika penyedia platform saja membutuhkan orang khusus untuk tugas ini, berarti dasar penagihannya memang cukup rumit. Sebagai pengguna API, Anda juga perlu membiasakan diri memeriksa tagihan.
Manfaat utama: Setelah membaca artikel ini, Anda bisa memahami asal setiap komponen biaya dalam tagihan API Model Bahasa Besar, memeriksa penggunaan lewat log pemanggilan, dan dengan cepat menemukan penyebab “lonjakan biaya untuk permintaan yang sama”.
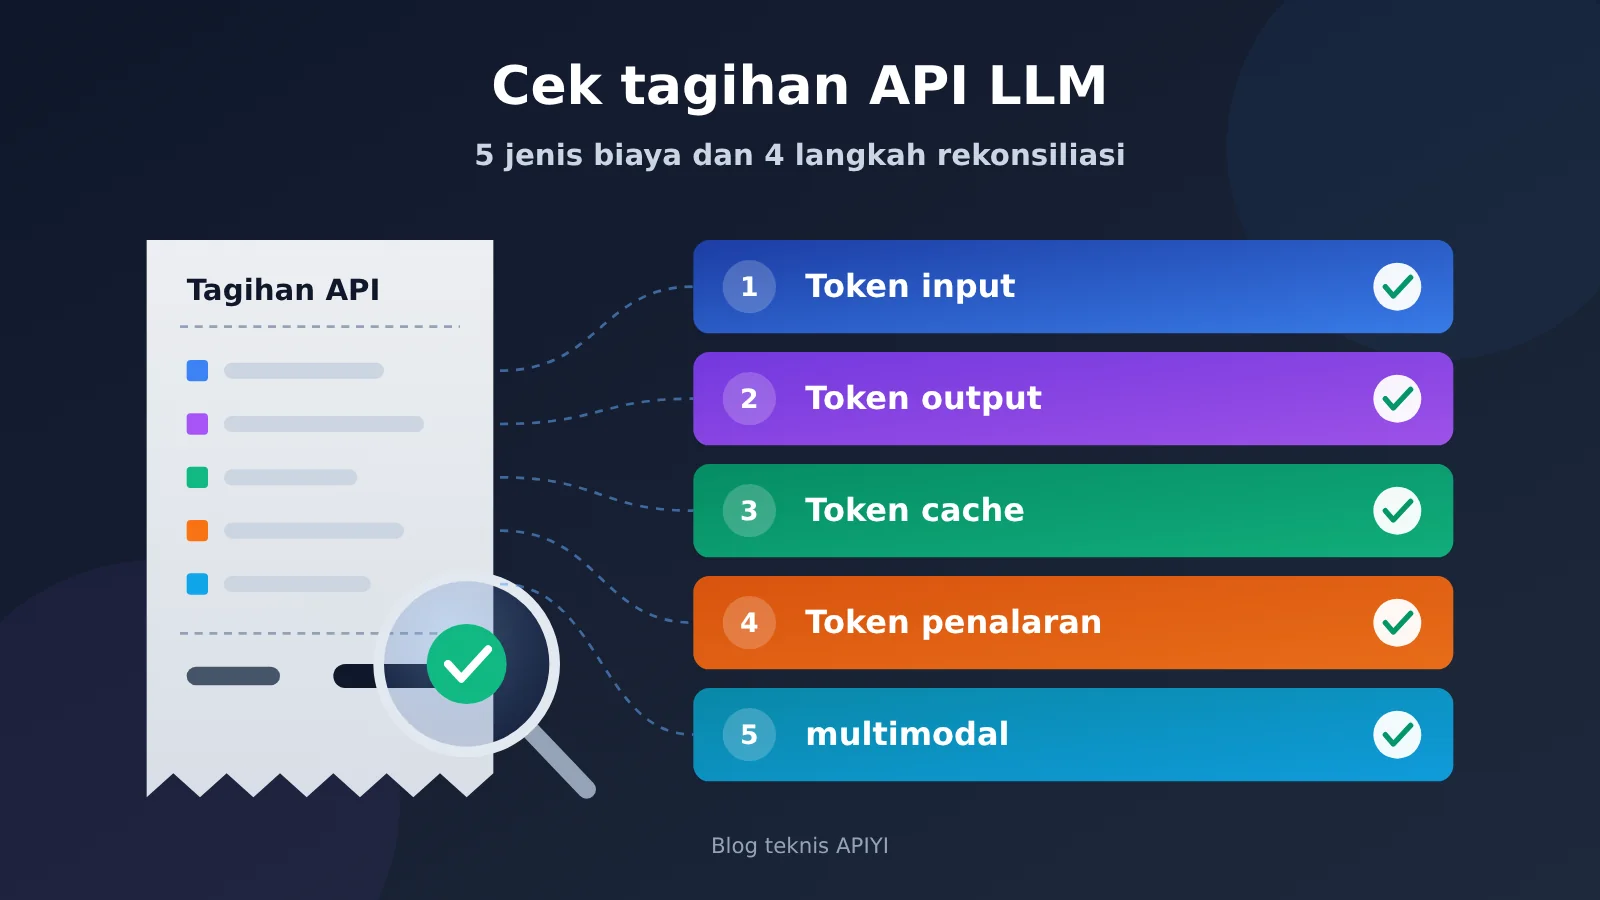
Poin Utama Tagihan API Model Bahasa Besar: 5 Jenis Biaya
Biaya sekali pemanggilan model biasanya tidak sesederhana “jumlah pemanggilan × harga satuan”. Setiap jenis biaya punya tarif dan sumber yang berbeda. Jika semuanya dilihat sebagai satu angka, struktur biayanya mudah disalahartikan.
| Jenis biaya | Sumber | Karakteristik harga umum | Hal yang perlu diperhatikan saat mencocokkan tagihan |
|---|---|---|---|
| Token input | Petunjuk sistem, riwayat percakapan, definisi alat, dokumen hasil pencarian, input pengguna | Dihitung per Token, biasanya lebih murah daripada output | Apakah konteks makin panjang tanpa disadari |
| Token output | Respons yang terlihat dan dihasilkan model | Dihitung per Token, tarifnya biasanya lebih tinggi daripada input | Panjang respons, pengaturan max_tokens |
| Token cache | Prefiks input yang ditemukan dalam cache | Bagian yang terkena cache biasanya mendapat diskon; beberapa penyedia mengenakan biaya terpisah untuk penulisan cache | Apakah tingkat cache hit menurun |
| Token penalaran | Proses berpikir internal model penalaran | Biasanya dihitung dengan tarif output, tetapi belum tentu muncul dalam respons | Apakah proses penalaran makin panjang |
| Biaya multimodal | Input atau pembuatan gambar, audio, dan video | Dihitung per gambar, per detik, berdasarkan resolusi, atau dikonversi menjadi Token | Apakah parameter spesifikasi berubah |
Mengapa Tagihan API Model Bahasa Besar Sering “Tidak Cocok”
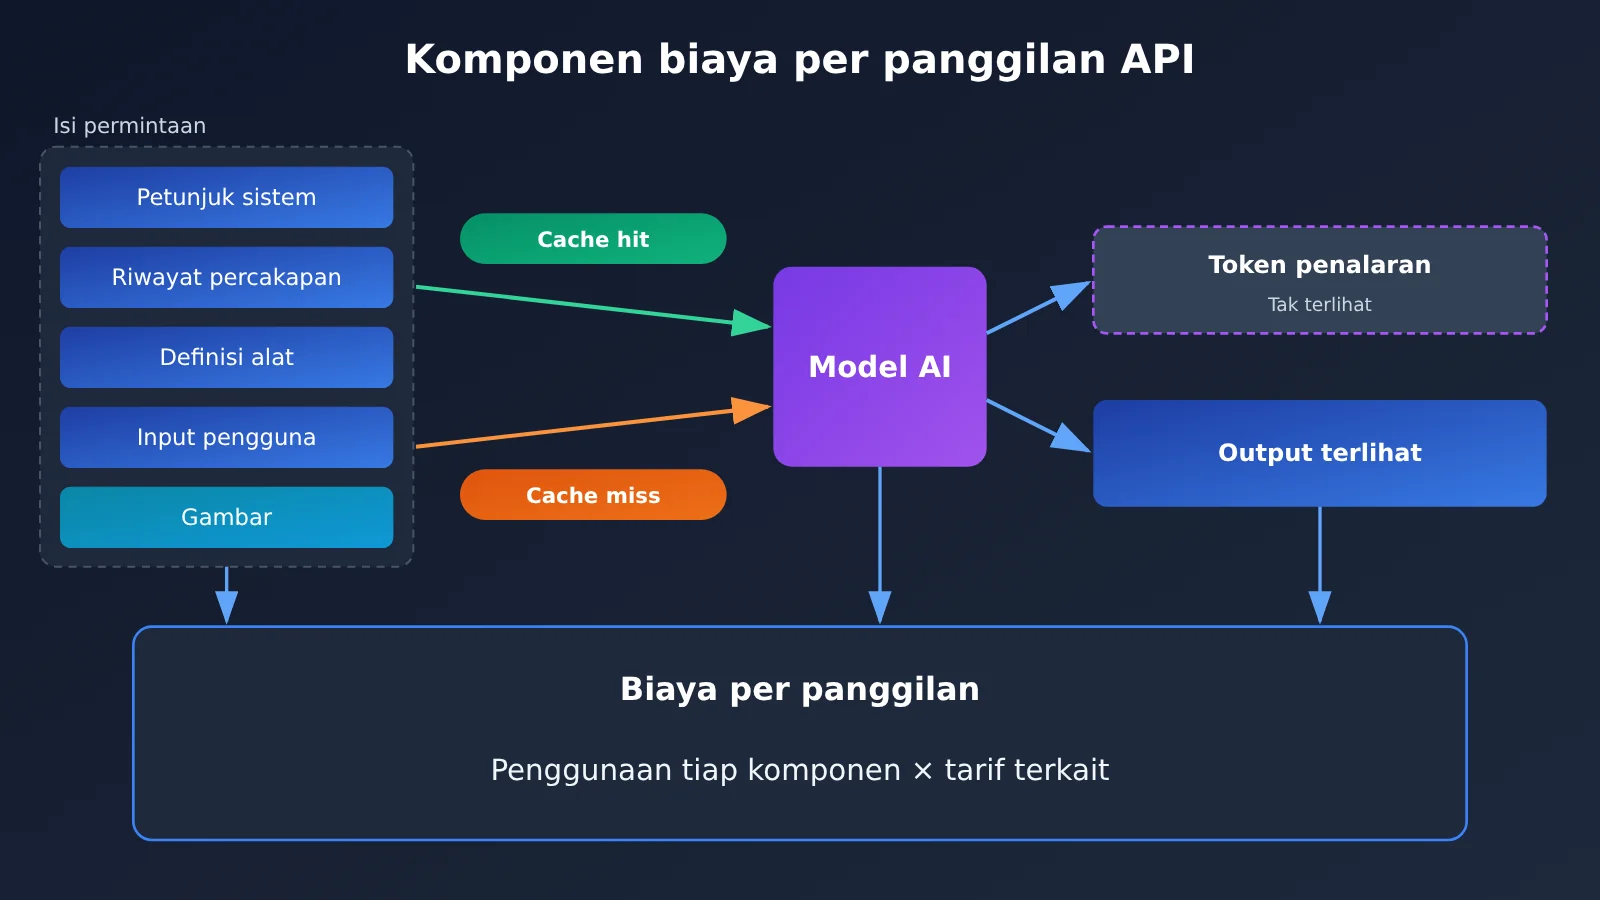
Alasan pertama adalah Token yang tidak terlihat. Di dalam kode, kamu mungkin hanya menulis satu pertanyaan pengguna. Namun, permintaan yang sebenarnya dikirim bisa mencakup ribuan Token petunjuk sistem, riwayat percakapan beberapa putaran, dan Schema alat. Model penalaran juga menghasilkan banyak Token pemikiran yang tidak terlihat oleh pengguna. Semuanya masuk ke tagihan, meski tidak muncul di antarmuka.
Alasan kedua adalah dasar perhitungan yang tidak seragam. Untuk “input gambar”, misalnya, ada penyedia yang menghitung biaya per gambar dan ada yang mengonversinya menjadi Token berdasarkan resolusi. Untuk “cache”, ada penyedia yang menerapkannya secara otomatis dan ada yang mengharuskannya dinyatakan secara eksplisit. Ada juga yang hanya memberi diskon untuk pembacaan cache, sementara yang lain mengenakan biaya tambahan untuk penulisannya. Saat membandingkan model atau penyedia, samakan dulu dasar perhitungannya.
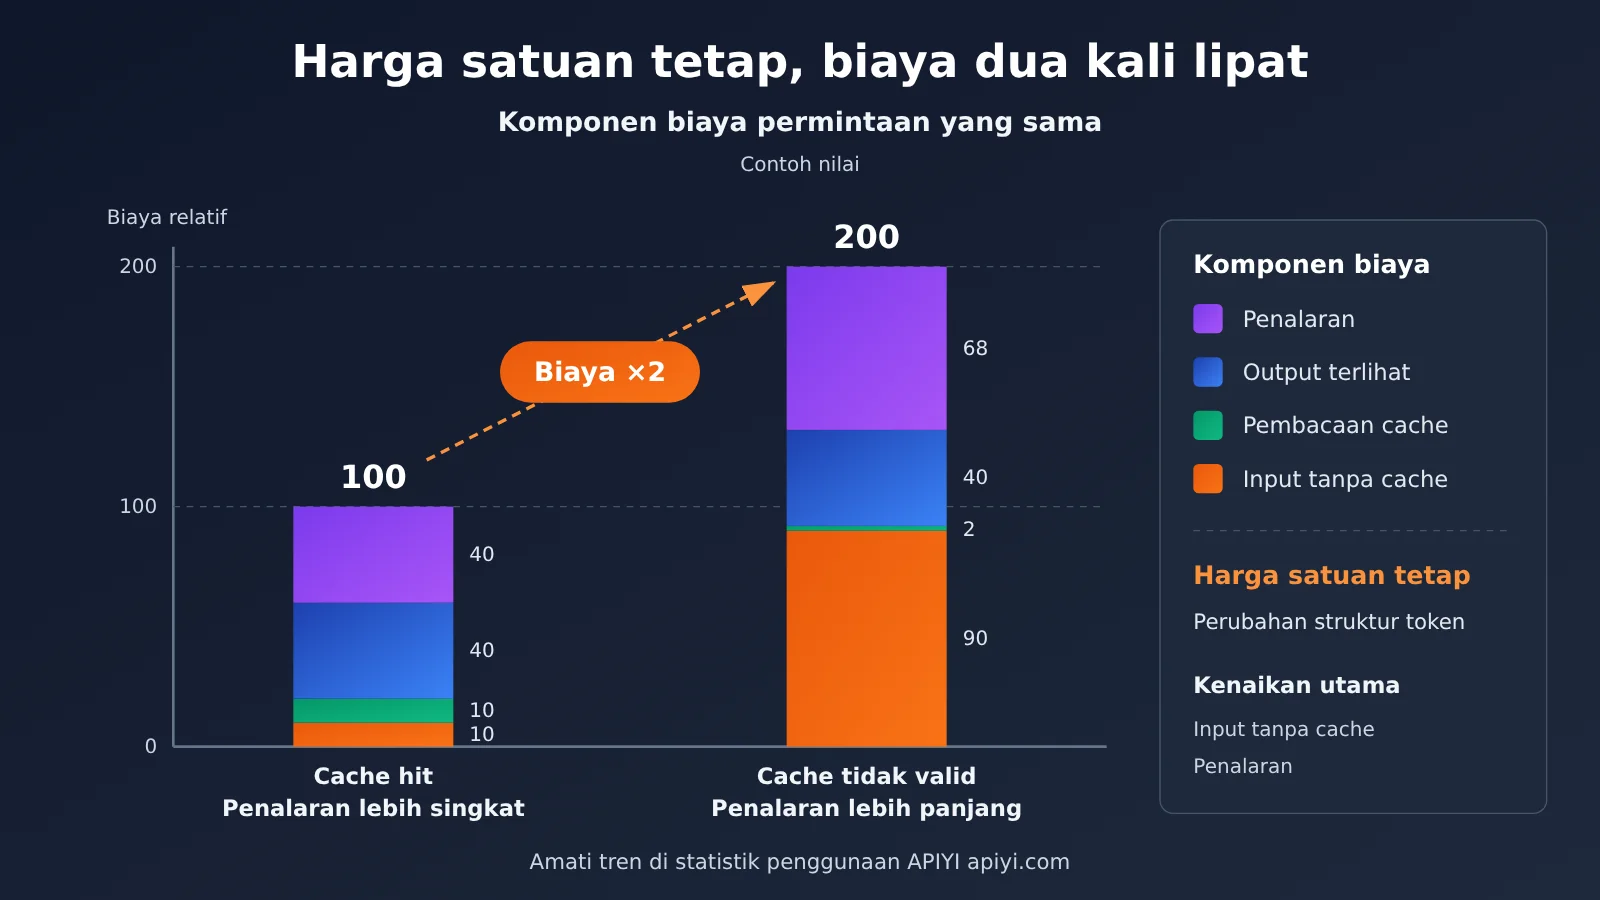
Alasan ketiga adalah variabel yang bisa berubah. Alias model bisa saja menunjuk ke versi baru, perubahan kecil pada prefiks petunjuk bisa membuat seluruh cache tidak berlaku, dan model penalaran akan berpikir lebih lama saat menghadapi masalah yang lebih sulit. Meski harga satuan tidak berubah, tagihan tetap bisa berubah.
Penjelasan Komponen Biaya pada Tagihan API Model Bahasa Besar
Token Input: Bagian yang Paling Sering Diremehkan
Token input mencakup seluruh konten yang “dibaca” model dalam satu permintaan, bukan hanya pesan pengguna. Dalam percakapan multi-putaran, riwayat sebelumnya dikirim ulang pada setiap putaran. Semakin panjang percakapan, semakin tinggi biaya input per putaran; total biayanya pun tumbuh mendekati kuadrat jumlah putaran.
Aplikasi RAG juga menghabiskan banyak Token input. Jumlah dan panjang potongan dokumen yang diambil saat pencarian langsung menentukan biaya input. Dalam skenario Function Calling, JSON Schema yang mendefinisikan alat turut dihitung sebagai input di setiap permintaan. Semakin banyak alat, semakin besar biaya tetapnya.
Perlu diingat juga bahwa setiap model menggunakan tokenizer yang berbeda. Jumlah Token untuk teks bahasa Mandarin yang sama bisa berbeda jauh antar-model. Jadi, jumlah Token dari satu model tidak bisa digunakan untuk memperkirakan biaya model lain.
Token Output: Tarif Lebih Tinggi, Dikendalikan Langsung oleh Parameter
Token output adalah konten respons yang dihasilkan model. Tarif output sebagian besar penyedia jauh lebih tinggi daripada tarif input. Jadi, meminta model menjawab tanpa bertele-tele sering kali lebih hemat daripada memampatkan input.
max_tokens menentukan batas atas biaya output, tetapi bukan jaminan biaya tertentu. Jika respons terpotong, bagian yang sudah dihasilkan tetap dikenakan biaya. Ketika streaming terputus di tengah jalan, setiap platform juga bisa memiliki cara berbeda dalam menghitung Token yang sudah dihasilkan. Periksa penjelasan resmi masing-masing platform.
Token Cache: Hemat Hanya Saat Cache Cocok
Prinsip cache petunjuk adalah sebagai berikut: ketika beberapa permintaan menggunakan prefiks yang sama, misalnya petunjuk sistem atau dokumen panjang yang sama, penyedia dapat menggunakan kembali bagian yang sudah diproses dan memberikan diskon untuk input tersebut.
Ada beberapa aturan umum cache yang perlu diperiksa satu per satu:
- Apakah aktif secara otomatis: sebagian penyedia mengaktifkannya secara default, sementara yang lain meminta Anda menandai posisi cache secara eksplisit dalam permintaan;
- Persyaratan kecocokan prefiks: biasanya prefiks harus sama persis sejak awal. Perubahan di satu titik dapat membuat seluruh bagian setelahnya tidak lagi cocok;
- Panjang minimum dan masa berlaku: prefiks yang terlalu pendek mungkin tidak disimpan dalam cache. Setelah cache kedaluwarsa, isinya harus ditulis ulang;
- Biaya penulisan: sebagian penyedia mengenakan tarif penulisan pertama ke cache yang lebih tinggi daripada input biasa. Penghematan baru diperoleh saat cache dibaca kembali.
Saat merekonsiliasi tagihan, hitung “Token pembacaan cache” dan “Token input biasa” secara terpisah. Dengan begitu, penurunan tingkat kecocokan cache tidak keliru dianggap sebagai peningkatan jumlah pemanggilan.
Token penalaran: tidak terlihat, tetapi tetap dikenakan biaya
Model penalaran melakukan proses berpikir internal sebelum memberikan jawaban. Token untuk proses ini biasanya ditagih dengan tarif output. Dalam banyak kasus, isi penalaran tidak dikembalikan secara lengkap; kamu hanya bisa melihat jumlahnya di kolom penggunaan.
Jumlah token penalaran berubah sesuai tingkat kesulitan pertanyaan dan parameter intensitas penalaran. Pada antarmuka yang sama, tagihan bisa naik ketika pertanyaan pengguna menjadi lebih sulit. Jika kebutuhan bisnis hanya berupa klasifikasi sederhana atau konversi format, penggunaan model penalaran sering kali berarti membayar proses berpikir yang sebenarnya tidak diperlukan.
Biaya multimodal: pastikan dulu “dihitung berdasarkan apa”
Metode perhitungan biaya multimodal sangat beragam, jadi penting untuk memeriksa halaman harga resmi setiap model satu per satu. Tabel berikut merangkum metode penetapan harga yang umum. Aturan spesifik tetap mengacu pada informasi terbaru dari masing-masing penyedia.
| Jenis | Metode penetapan harga umum | Parameter utama yang memengaruhi biaya | Saran pemeriksaan |
|---|---|---|---|
| Input gambar (pemahaman) | Dikonversi menjadi token berdasarkan resolusi, atau dihitung per gambar | Ukuran gambar, parameter tingkat detail | Catat resolusi aktual sebelum dan sesudah diunggah |
| Pembuatan gambar | Dihitung per gambar atau berdasarkan token output | Ukuran, tingkat kualitas, jumlah gambar yang dibuat | Catat parameter spesifikasi setiap permintaan |
| Input/output audio | Dihitung berdasarkan durasi atau dikonversi menjadi token audio | Durasi audio, metode pemrosesan sampel | Catat durasi audio sebenarnya |
| Sintesis suara | Dihitung berdasarkan jumlah karakter atau token | Panjang teks, tingkat kualitas suara | Catat panjang teks yang disintesis |
| Pembuatan/pemahaman video | Dihitung per detik, per frame, atau berdasarkan tingkat resolusi | Durasi, resolusi, frame rate | Catat kombinasi durasi dan resolusi |
| Embedding | Dihitung berdasarkan token input | Panjang teks, ukuran batch | Catat terpisah dari tarif input biasa |
🎯 Saran teknis: Untuk kebutuhan multimodal, sebaiknya gunakan satu titik masuk agar berbagai metode perhitungan biaya bisa dikelola secara terpusat. Dalam penjelasan resminya, APIYI apiyi.com menyebutkan bahwa model di platformnya menggunakan saldo bersama serta menyediakan statistik penggunaan dan log pemanggilan. Kamu bisa memeriksa terlebih dahulu kolom yang ditampilkan dalam log di konsol, lalu menentukan parameter apa saja yang perlu dicatat tambahan dalam tabel rekonsiliasi.
Panduan cepat rekonsiliasi tagihan API Model Bahasa Besar: 4 langkah
Inti rekonsiliasi adalah: kalikan penggunaan yang Anda catat dengan snapshot harga satuan yang Anda simpan untuk mendapatkan biaya perkiraan, lalu bandingkan dengan tagihan platform. Jika selisihnya melampaui batas toleransi, periksa setiap komponen satu per satu.
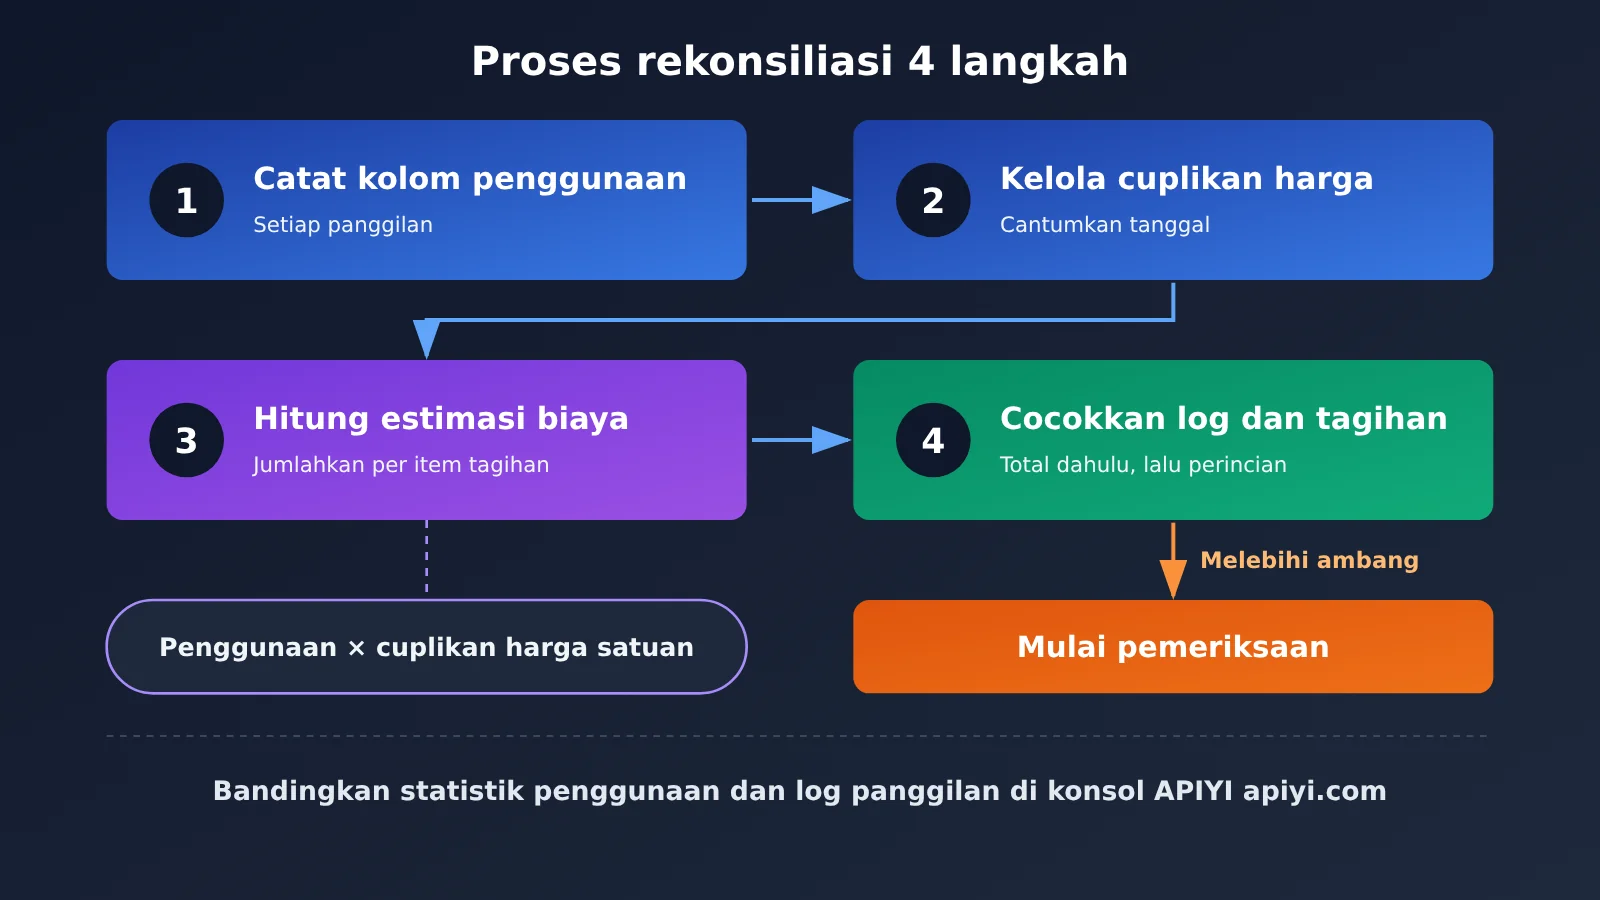
Langkah 1: Catat field penggunaan setelah setiap pemanggilan
API dengan format yang kompatibel dengan OpenAI biasanya mengembalikan objek usage dalam respons. Berikut field yang umum ditemukan dan artinya. Respons dapat berbeda menurut model dan platform, jadi lakukan satu permintaan untuk memastikannya sebelum integrasi.
| Field (penulisan umum dalam format kompatibel OpenAI) | Arti | Komponen penagihan |
|---|---|---|
prompt_tokens |
Jumlah total token input untuk permintaan ini | Input (termasuk bagian yang di-cache) |
prompt_tokens_details.cached_tokens |
Bagian input yang ditemukan dalam cache | Pembacaan cache |
completion_tokens |
Jumlah total token output | Output (mungkin termasuk bagian penalaran) |
completion_tokens_details.reasoning_tokens |
Bagian penalaran dalam output | Penalaran |
model |
Nama model yang benar-benar memberikan respons | Untuk mengenali perubahan versi |
Sebaiknya simpan setidaknya informasi berikut ke database setiap kali melakukan pemanggilan:
- Waktu permintaan, ID permintaan, dan penanda skenario bisnis;
- Nama model yang ditentukan dalam permintaan dan
modelyang dikembalikan dalam respons; - Semua field penggunaan pada tabel di atas; catat field yang tidak tersedia sebagai kosong, bukan 0;
- Parameter spesifikasi untuk permintaan multimodal, seperti ukuran gambar, durasi audio, dan jumlah yang dihasilkan;
- Apakah pemanggilan menggunakan streaming, dicoba ulang, atau terpotong (
finish_reason).
Perhatikan bahwa prompt_tokens dan completion_tokens biasanya merupakan “total”, sedangkan cache dan penalaran adalah bagian di dalamnya. Saat menghitung biaya, kurangi bagian-bagian tersebut dari total terlebih dahulu, lalu kalikan masing-masing dengan harga satuan yang sesuai. Jika tidak, Anda bisa menghitung biaya dua kali atau melewatkan diskon.
Langkah 2: Kelola snapshot harga dengan tanggal
Jangan hard-code harga satuan di dalam kode. Sebaiknya, kelola tabel snapshot harga yang setiap barisnya mencatat nama model, komponen penagihan, harga satuan, mata uang, tanggal berlaku, dan sumbernya (halaman harga resmi atau pengumuman platform).
Saat harga berubah, tambahkan baris baru alih-alih menimpa nilai lama. Dengan begitu, kamu bisa menghitung ulang tagihan untuk tanggal mana pun menggunakan harga yang berlaku saat itu. Jika melakukan pemanggilan model melalui platform agregator seperti APIYI, gunakan harga satuan yang saat ini diumumkan platform dan cantumkan juga tanggal pengecekannya.
Langkah 3: Hitung perkiraan biaya
Perkiraan biaya untuk satu kali pemanggilan dapat dihitung dengan menjumlahkan beberapa komponen:
- Token input yang tidak ditemukan di cache × harga satuan input;
- Token yang dibaca dari cache × harga satuan pembacaan cache (jika penulisan ke cache dikenai biaya, tambahkan juga komponen tersebut);
- Token output yang terlihat × harga satuan output;
- Token penalaran × harga satuan penalaran yang berlaku (biasanya sama dengan harga output, tetapi tetap mengacu pada keterangan resmi);
- Komponen multimodal dihitung secara terpisah sesuai ketentuan masing-masing.
Setelah dirangkum berdasarkan hari, model, dan skenario bisnis, kamu akan mendapatkan catatan “berapa biaya yang seharusnya dikeluarkan”.
Langkah 4: Bandingkan dengan log dan tagihan platform
Bandingkan catatan biaya Anda dengan statistik penggunaan dan log pemanggilan di platform. Mulai dari jumlah total, lalu biaya per model, dan terakhir telusuri hingga ke permintaan tertentu.
Sebaiknya tetapkan ambang toleransi. Selisih kecil umum terjadi karena kurs, presisi perhitungan biaya, zona waktu statistik, dan faktor lain. Perbedaan yang melampaui ambang tersebut baru perlu diperiksa satu per satu.
🚀 Mulai cepat: Jika sudah memanggil model melalui APIYI apiyi.com, Anda bisa mengekspor log pemanggilan untuk periode tertentu, lalu mencocokkannya satu per satu dengan kolom
usageyang Anda catat. Periksa apakah platform menyediakan kolom terpisah untuk Token cache dan Token penalaran. Jika tidak, gunakan kolom respons yang Anda catat secara lokal sebagai dasar perinciannya.
Tanda anomali tagihan API Model Bahasa Besar: cara menyelidiki lonjakan biaya
Perubahan biaya mendadak untuk jenis permintaan yang sama adalah tanda yang paling perlu diwaspadai. Tabel berikut merangkum penyebab umum dan cara memeriksanya.
| Gejala anomali | Kemungkinan penyebab | Cara memeriksa |
|---|---|---|
| Biaya per permintaan naik, jumlah pemanggilan tetap | Alias model mengarah ke versi baru dengan harga satuan atau konsumsi Token yang berbeda | Bandingkan perubahan kolom model pada respons |
| Biaya input naik, total Token input tetap | Tingkat hit cache turun | Periksa proporsi cached_tokens dan apakah prefiks petunjuk berubah |
| Biaya output naik, panjang jawaban yang terlihat tetap | Token penalaran bertambah | Periksa tren reasoning_tokens dan parameter tingkat penalaran |
| Token input terus naik perlahan | Riwayat percakapan tidak dipotong, cuplikan hasil pencarian bertambah, atau definisi tool bertambah | Periksa sampel isi permintaan secara lengkap |
| Jumlah pemanggilan lebih banyak daripada volume aktivitas bisnis | Klien mencoba ulang atau mengirim ulang setelah timeout | Hitung setelah menghapus duplikasi berdasarkan ID permintaan dan ID aktivitas bisnis |
| Biaya gambar atau video melonjak | Resolusi, tingkat kualitas, atau jumlah yang dihasilkan meningkat | Bandingkan parameter spesifikasi dalam permintaan |
| Harga satuan pada tagihan berbeda dari snapshot | Penyedia resmi atau platform mengubah harga | Periksa halaman harga dan pengumuman, lalu perbarui snapshot harga |
Cache tidak lagi hit: kenaikan biaya yang paling sulit terlihat
Cache yang tidak lagi hit sering kali disebabkan oleh perubahan yang “tampak tidak berbahaya”. Misalnya, tanggal saat ini ditambahkan di awal petunjuk sistem, atau ID pengguna disisipkan ke dalam prefiks. Akibatnya, prefiks setiap permintaan berbeda, seluruh cache tidak lagi hit, dan biaya input langsung kembali ke harga normal.
Cara yang tepat adalah menempatkan konten tetap di bagian paling depan dan konten yang berubah di bagian paling akhir. Setelah mengubah templat petunjuk, periksa keesokan harinya apakah proporsi hit cache berubah.
Pergeseran panjang penalaran: perubahan tingkat kesulitan juga memengaruhi tagihan
Biaya model penalaran berkaitan dengan tingkat kesulitan pertanyaan. Jika pada suatu hari pengguna tiba-tiba mengajukan banyak pertanyaan kompleks, Token penalaran akan meningkat secara signifikan. Ini termasuk fluktuasi normal. Namun, jika Token penalaran terus bertambah meski jenis permintaannya tetap, periksa apakah versi model atau parameter penalaran berubah.
Kebiasaan memeriksa tagihan API Model Bahasa Besar saat harga berubah
Perubahan harga memang tidak bisa dikendalikan, tetapi kita bisa mengatur seberapa cepat perubahan itu terdeteksi. Berikut kebiasaan pemeriksaan yang bisa dilakukan secara rutin:
- Setiap minggu: Periksa tren biaya per model dan biaya rata-rata per pemanggilan, lalu cari perubahan mendadak;
- Setiap bulan: Lakukan rekonsiliasi tagihan secara menyeluruh dan telusuri satu per satu penyebab selisih yang melampaui ambang batas;
- Setiap kali mengubah templat petunjuk: Pantau persentase cache hit selama 1-2 hari;
- Sebelum beralih atau meningkatkan model: Bandingkan konsumsi Token dan biaya model lama dan baru menggunakan sebagian kecil lalu lintas;
- Pantau pengumuman: Berlangganan pengumuman perubahan harga dan pembaruan model dari penyedia atau platform yang digunakan, lalu segera perbarui snapshot harga setelah menerima pengumuman;
- Kunci versi: Di lingkungan produksi, sebisa mungkin gunakan nama model dengan nomor versi spesifik agar pembaruan otomatis pada alias tidak menimbulkan kejutan.
💡 Saran: Jika bisnis menggunakan model dari beberapa penyedia sekaligus, rekonsiliasi tagihan di banyak akun bisa sangat memakan waktu. Dengan akses terpadu melalui APIYI apiyi.com, penggunaan berbagai model dapat dilihat melalui saldo dan log yang sama, sehingga biaya per pemanggilan lebih mudah dibandingkan. Sebaiknya periksa terlebih dahulu di konsol untuk memastikan rincian apa saja yang tersedia.
Pertanyaan Umum FAQ
Q1: Apa itu Token dalam tagihan API Model Bahasa Besar?
Token adalah satuan dasar yang digunakan model untuk memproses teks, berupa potongan hasil pemisahan teks. Satu karakter Mandarin dapat mewakili satu atau beberapa Token, tergantung pada tokenizer model. Tagihan biasanya dihitung secara terpisah berdasarkan jumlah Token dalam kategori seperti input, output, cache, dan penalaran.
Q2: Apa perbedaan Token cache dan Token input biasa?
Keduanya termasuk input, tetapi Token cache adalah bagian yang cocok dengan prefiks yang sudah tersimpan di cache dan biasanya mendapat potongan harga. Token input biasa dikenai tarif penuh. Beberapa penyedia juga mengenakan biaya tersendiri saat pertama kali menulis ke cache, jadi ketiganya perlu dihitung secara terpisah saat rekonsiliasi.
Q3: Mengapa Token penalaran tidak terlihat dalam respons?
Token penalaran dihasilkan selama proses berpikir internal model. Banyak model tidak mengembalikan proses penalaran lengkap kepada pemanggil, melainkan hanya mencantumkan jumlahnya dalam kolom penggunaan. Token ini biasanya dikenai tarif output, sehingga biayanya bisa tetap tinggi meskipun responsnya singkat.
Q4: Mengapa biaya untuk permintaan yang sama bisa tiba-tiba berubah?
Ada tiga penyebab yang paling umum: alias model mengarah ke versi baru, perubahan prefiks petunjuk menyebabkan cache tidak lagi cocok, atau panjang penalaran bertambah. Penyebab lainnya adalah penagihan berulang akibat percobaan ulang dan peningkatan parameter spesifikasi multimodal. Periksa satu per satu menggunakan tabel sinyal anomali dalam artikel ini untuk menemukan penyebabnya.
Q5: Bagaimana cara menggunakan log platform untuk memeriksa tagihan API Model Bahasa Besar?
Pertama, catat kolom `usage` dan ID permintaan dari setiap respons di sistem Anda. Lalu, ekspor log pemanggilan dari platform dan cocokkan setiap permintaan satu per satu. Sebagai contoh, di APIYI apiyi.com, Anda dapat melihat statistik penggunaan dan log pemanggilan melalui konsol. Pastikan dulu kolom apa saja yang tersedia dalam log, lalu gabungkan dengan catatan lokal untuk rekonsiliasi.
Q6: Bagaimana cara memperkirakan biaya model multimodal?
Pertama, periksa halaman harga resmi untuk memastikan cara penagihannya: per gambar, per detik, atau berdasarkan resolusi yang dikonversi menjadi Token. Kemudian, catat parameter spesifikasi terkait dalam log permintaan, seperti ukuran gambar, durasi audio, serta resolusi dan durasi video. Gunakan parameter tersebut dan tarif satuannya untuk memperkirakan biaya.
Q7: Apa yang harus diperiksa terlebih dahulu jika ditemukan selisih saat rekonsiliasi?
Pastikan dulu snapshot harga yang digunakan sudah terbaru untuk menyingkirkan kemungkinan perubahan harga. Lalu, bandingkan jumlah pemanggilan untuk memeriksa apakah ada percobaan ulang atau permintaan duplikat. Terakhir, uraikan selisih berdasarkan model dan komponen tagihan untuk menemukan apakah perbedaannya berasal dari input, cache, penalaran, atau multimodal.
Q8: Apa keterbatasan metode rekonsiliasi ini?
Metode ini bergantung pada kolom penggunaan yang dikembalikan dalam respons. Jika model atau antarmuka tertentu tidak menyediakan rincian cache dan penalaran, Anda hanya bisa mengandalkan tagihan platform. Selain itu, kurs, presisi penagihan, dan zona waktu statistik dapat menyebabkan selisih kecil. Karena itu, tetapkan ambang batas yang wajar, alih-alih mengharapkan hasil yang sama persis.
Poin Penting Tagihan API Model Bahasa Besar
- Biaya terdiri dari beberapa komponen: Tarif input, output, cache, penalaran, dan multimodal berbeda-beda dan perlu dihitung secara terpisah.
- Token input bukan hanya pertanyaan pengguna: Petunjuk sistem, riwayat, dokumen hasil pencarian, dan definisi alat juga dihitung sebagai input.
- Cache hit bergantung pada kesamaan prefiks: Letakkan konten tetap di depan dan variabel di belakang. Periksa tingkat hit setelah mengubah templat.
- Token penalaran tidak terlihat, tetapi tetap dikenakan biaya: Hindari model penalaran untuk tugas sederhana dan pantau tren panjang penalaran.
- Untuk multimodal, tanyakan dulu “dihitung berdasarkan apa?”: Biaya dapat dihitung per gambar, per detik, atau berdasarkan resolusi. Rujuk halaman harga resmi.
- Empat langkah rekonsiliasi: Catat penggunaan, simpan snapshot harga, hitung perkiraan biaya, lalu bandingkan dengan log dan tagihan.
- Satu akses memudahkan rekonsiliasi: Manfaatkan saldo terpadu dan log pemanggilan APIYI apiyi.com untuk memeriksa penggunaan berbagai model di satu tempat.
Kesimpulan
Ada tiga kunci untuk memahami dan memeriksa tagihan API Model Bahasa Besar:
- Pisahkan komponennya: Uraikan biaya setiap pemanggilan menjadi input, cache, output, penalaran, dan multimodal, lalu identifikasi sumber masing-masing;
- Catat sendiri: Simpan data penggunaan dan parameter spesifikasi setiap pemanggilan ke dalam basis data, serta kelola snapshot harga yang disertai tanggal;
- Bandingkan secara berkala: Pantau tren setiap minggu dan cocokkan total tagihan setiap bulan. Jika biaya berubah drastis, periksa versi model, cache hit, panjang penalaran, percobaan ulang, dan parameter spesifikasi satu per satu.
Pengelola platform memang memverifikasi dasar perhitungan biaya ini secara khusus, tetapi sebagai pengguna API, kita juga perlu membangun kebiasaan rekonsiliasi sendiri. Jika bisnis Anda perlu menggunakan model dari berbagai penyedia sekaligus, Anda bisa mengaksesnya melalui APIYI apiyi.com dan melihat penggunaan serta log pemanggilan dalam satu konsol. Setelah itu, gunakan metode dalam artikel ini untuk memeriksa tagihan.
📚 Referensi
- Lowongan V2EX: posisi operasional platform Model Bahasa Besar di perusahaan infrastruktur AI Agent: Tanggung jawabnya mencakup “verifikasi biaya dan tagihan”
- Tautan:
v2ex.com/t/1254263 -
Keterangan: Diterbitkan pada 2026-11-03. Posisi ini mencakup verifikasi dasar penagihan token input/output, token cache, token penalaran, serta gambar, audio, dan video, juga pendeteksian tagihan yang tidak wajar, perubahan harga, dan selisih penagihan.
-
Halaman harga resmi masing-masing penyedia model: Satu-satunya sumber resmi untuk harga per unit dan aturan penagihan
- Tautan: Cari di bagian harga atau dokumentasi pada situs resmi penyedia yang digunakan
- Keterangan: Harga sering berubah, jadi pastikan untuk mencatat tanggal pengecekan saat mengutipnya.
Penulis: Tim Teknis APIYI
Diskusi teknis: Jika ada pertanyaan tentang pemeriksaan tagihan API Model Bahasa Besar, hubungi kami melalui halaman utama APIYI apiyi.com. Panduan integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com.