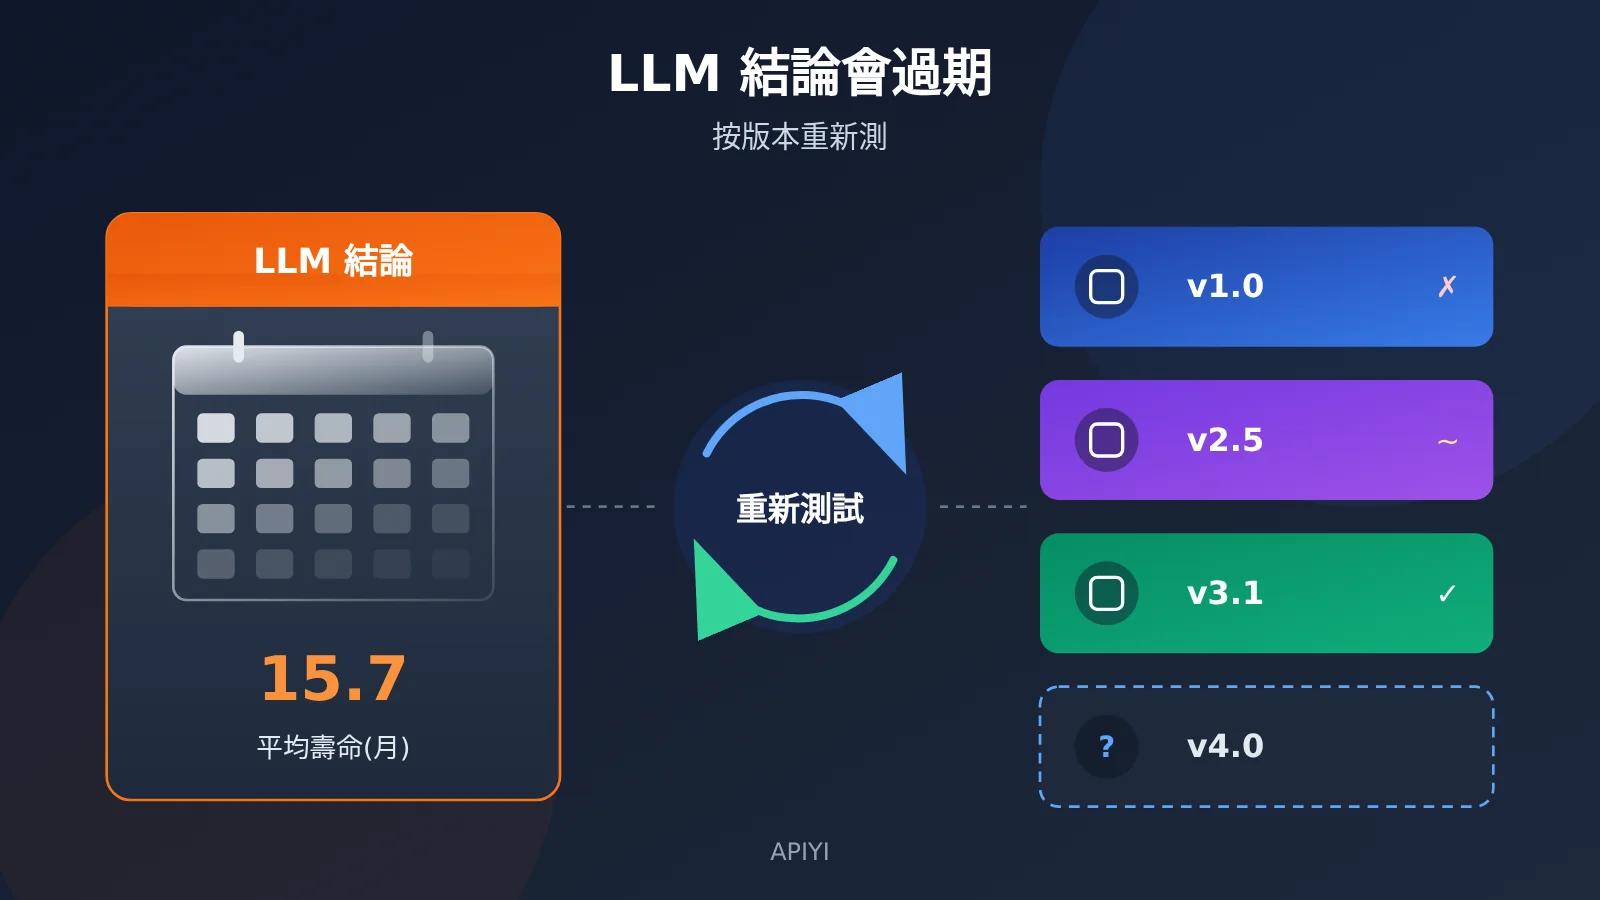
作者注:斯坦福研究發現 44% 的 LLM 流行結論已經過期,平均壽命只有 15.7 個月。本文把這項研究轉化爲開發團隊可以直接使用的模型選型複測清單。
“某模型數不清 strawberry 裏有幾個 r”“長上下文中間的信息會丟”“模型愛編造參考文獻”,這些說法你可能在論文、技術羣和選型會上反覆聽過。斯坦福研究者 Owen Queen 和 James Zou 用 20 個模型重新檢驗了 50 條被廣泛引用的 LLM 結論,發現 44% 已經過期,有估算過期時間的結論平均只能維持 15.7 個月。
這不是又一篇“模型越來越強”的泛泛感慨。 研究給出了明確的數據:哪類結論過期最快,哪類更持久,以及同一代模型之間差距有多大。本文會把研究者寫給學術界的建議,改寫成開發團隊選模型時可以照着執行的流程。
核心價值:讀完本文,你會知道哪些“模型不擅長 X”的說法最不可靠,並建立一套“記錄模型名、版本、日期,保留提示詞,在目標模型上覆測”的選型習慣。
LLM 結論過期研究核心要點
先用一張表看清這項研究最關鍵的幾個數字。研究使用的模型發佈於 2024 年 7 月至 2026 年 9 月,來自 8 家不同的開發方,相關報道發佈於 2026 年 11 月 3 日。
| 要點 | 研究數據 | 對選型的意義 |
|---|---|---|
| 結論過期比例 | 50 條結論中 44% 已過期,34% 明顯減弱 | 網上流傳的模型缺陷,多數已不能直接引用 |
| 仍然成立的比例 | 僅 16% 保持,6% 反而增強 | 少數“頑固”傾向值得長期關注 |
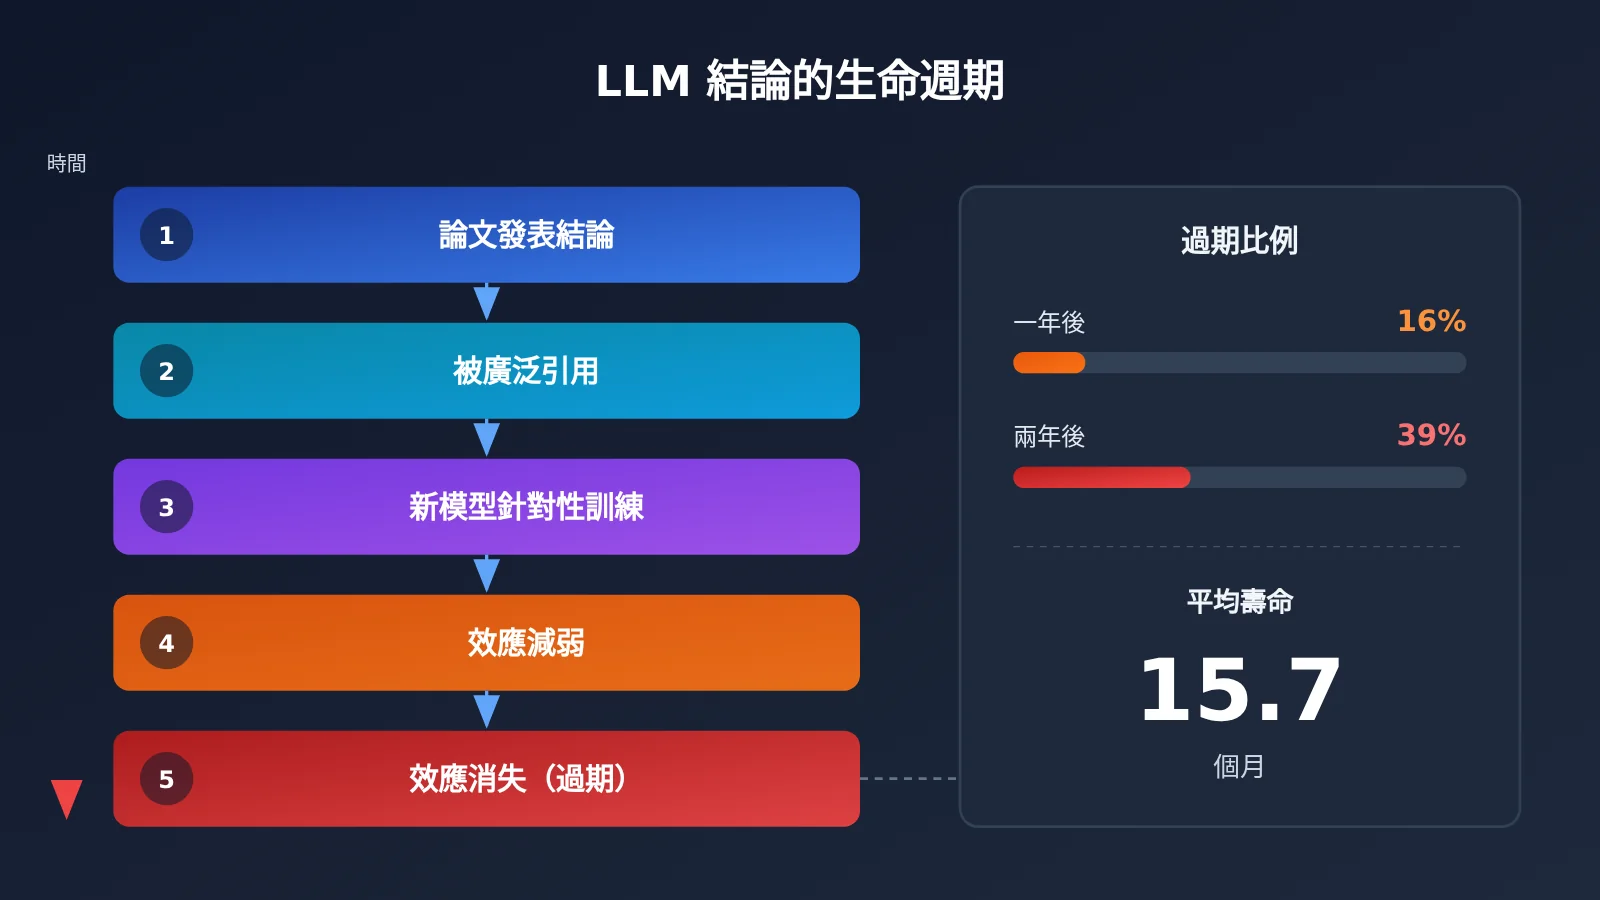
| 平均壽命 | 22 條可估算過期時間的結論,平均 15.7 個月 | 一年多前的測評結論需要默認打折扣 |
| 隨時間累積 | 一年後 16% 過期,兩年後升至 39% | 結論越老,越需要複測 |
| 同代模型差異 | 2026 年 7–9 月發佈的模型,過期結論數從 11 到 30 不等 | 不能用發佈時間推斷能力 |
LLM 結論過期的兩個關鍵發現
第一個關鍵發現是“過期”的含義。研究中的“過期”指的是,原始結論背後的效應在新模型上已經基本消失,而不只是程度上有所改善。另有 34% 的結論處於“明顯減弱”狀態,說明問題還在,但幅度已經遠不如原始論文描述的那樣嚴重。把兩者加起來,接近八成的流行結論已經不能按原樣用於今天的模型。
第二個關鍵發現是,結論的“壽命”和它的類型強相關。描述模型“做不到什麼”的能力缺陷類結論過期最快,描述模型“傾向於怎麼做”的偏好類結論則更持久。研究者的解釋是:能力類錯誤通常有一個“正確答案”,開發方有明確的訓練目標可以去優化;偏好和傾向則沒有標準答案,自然更難被“修掉”。
哪些 LLM 結論最容易過期
理解結論類型,是決定複測優先級的前提。下面這張表根據研究報道內容,把典型結論分成“容易過期”和“相對持久”兩類。
| 結論類型 | 典型例子 | 研究中的狀態 | 複測優先級 |
|---|---|---|---|
| 推理與能力缺陷 | 數 strawberry 中的字母、陌生進制下的算術、長上下文中間信息丟失、被用戶反駁後放棄正確答案 | 9 條推理結論中 5 條過期,沒有一條保持或增強 | 最高:引用前必須複測 |
| 事實性與幻覺 | 編造科學參考文獻 | 部分模型已降至接近 0,個別模型仍很高 | 高:差異極大,必須逐個測 |
| 組合推理 | 兩跳問題、“反轉詛咒”、成對時間問題答案矛盾 | 已減弱但仍可檢測 | 中高:問題仍在,幅度變化大 |
| 作爲評審者的偏好 | 偏愛自己的答案、對錄用和拒稿論文打分相近、被醫學摘要的措辭包裝影響 | 保持或增強 | 中:長期風險,但需定期確認 |
| 諂媚與迎合用戶 | 順着用戶觀點說話 | 在保持或增強的結論中佔比較高 | 中:涉及客服、顧問類應用時優先 |
| 輸出分佈傾向 | 左傾政治偏向、開放問題答案高度雷同、生成隨機數分佈不均 | 保持或增強 | 中:做內容生成、抽樣時需注意 |
需要說明的是,關於推理類結論,報道正文寫的是“9 條中 5 條過期,且沒有一條保持或增強”,圖注則稱“全部 9 條均已消退”。兩者結合起來理解,應當是 5 條已過期、其餘幾條也已減弱,沒有一條維持原樣。由於我們未能看到原論文的完整 50 條結論清單和複測方法,具體分類以原論文爲準。
LLM 偏好類結論爲什麼更持久
在 11 條保持或增強的結論裏,有 3 條和“LLM 當評審者”有關,3 條和諂媚迎合有關,其餘涉及政治傾向、開放問題回答雷同以及隨機數分佈不均。這些問題有一個共同點:很難定義什麼是“對”的輸出,因此也很難通過針對性訓練消除。
對開發團隊來說,這意味着一種反直覺的風險排序。大家最常掛在嘴邊的“模型數不清字母”往往早已不是問題,而真正值得警惕的,反倒是那些不那麼顯眼的系統性傾向。如果你在用 LLM 做自動評審、打分或推薦,偏好類問題應當被列入常規迴歸測試。
社會偏見類 LLM 結論是混合情況
研究者特別指出,社會偏見類結論的走向並不一致。左傾政治偏向依然存在,性別刻板印象和內隱聯想偏見已經減弱,而針對非裔美國人英語使用者的偏見在趨勢數據中甚至出現了方向反轉。這再次說明,任何“模型普遍存在某種偏見”的籠統說法,都必須落到具體模型、具體時間點上纔有意義。
爲什麼不能按廠商或發佈時間推斷 LLM 表現
很多團隊選型時有一種樸素直覺:新模型一定比舊模型好,同一家廠商的模型表現會相近,大模型一定比小模型穩。研究數據直接否定了這種推斷方式。
最典型的案例是參考文獻編造測試。2023 年 Walters 和 Wilder 的原始研究中,GPT-3.5 編造了 55% 的參考文獻。斯坦福研究者用同樣的提示詞測試當前模型,GPT-6.1 Sol 爲 0%,Claude Sonnet 5.5 爲 1%,而同爲 2026 年發佈的 Qwen3.7-Flash 仍有 69% 的參考文獻是編造的,甚至高於三年前的 GPT-3.5。
同一發佈窗口內的差異同樣驚人。在 2026 年 7 月至 9 月發佈的模型中,被“推翻”的結論數量從 DeepSeek V4 Pro 的 11 條到 GPT-6.1 Sol 的 30 條不等。研究明確指出,發佈日期、廠商和模型規模都不能可靠地預測這種模式。
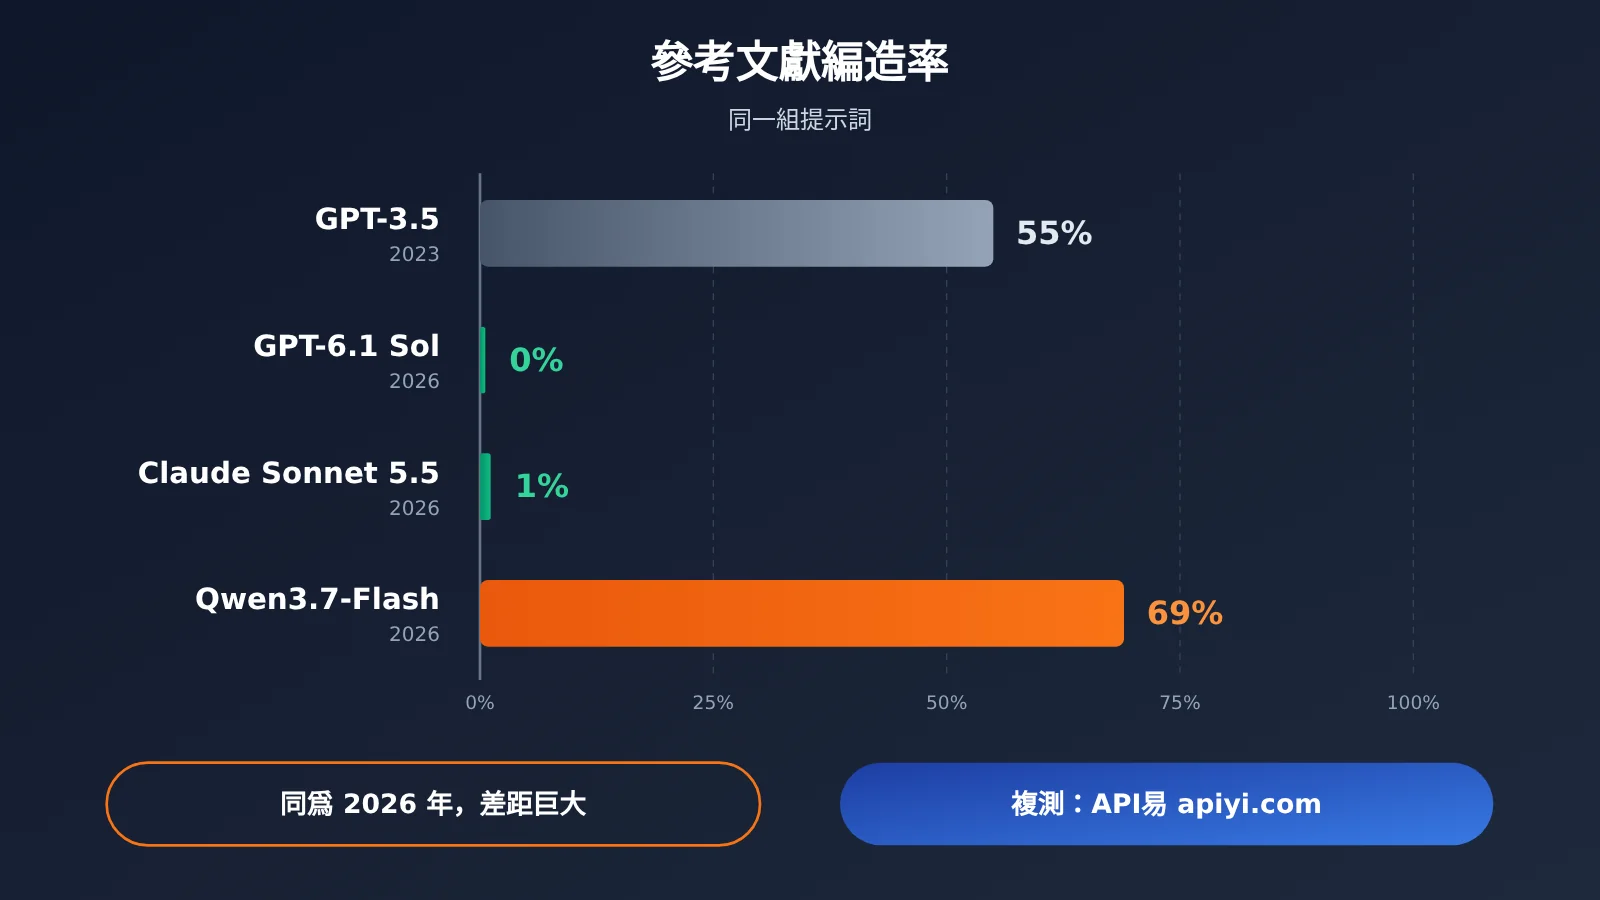
這張對比圖想傳達的核心信息是:同一年代的模型,在同一項測試上可能處於兩個極端。如果你要在團隊內部復現這類對比,可以通過 API易 apiyi.com 這類統一接口平臺,用同一組提示詞在多個候選模型上跑一遍,具體可用模型請以平臺官方模型列表爲準。
此外,研究者也提醒不要把改善讀成“問題已徹底解決”。在兩跳問題(需要組合兩個已知事實)上,Claude Sonnet 5.5 在能分別答對兩個子問題的情況下,仍有約 10% 的組合問題答錯,而原始論文報告的 ChatGPT 數據是 43%。數字確實大幅下降了,但如果你的業務依賴多步事實組合,這 10% 依然足以造成線上事故。
LLM 選型複測快速上手:5 步清單
研究者給學術界的建議是:把關於 LLM 的經驗結論當作“對特定模型在特定時間點的觀察”,而不是普遍真理;論文應記錄模型、版本和日期,並公開提示詞和分析代碼,方便在未來模型上覆測。這套建議幾乎可以原樣搬到開發團隊的選型流程中。
第 1 步:給每條 LLM 結論補齊元數據
無論結論來自論文、博客、同事經驗還是你自己的測試,都要先補齊下表中的字段。缺少關鍵字段的結論,只能作爲“待驗證線索”,不能作爲決策依據。
| 元數據字段 | 記錄內容 | 爲什麼必須記錄 |
|---|---|---|
| 模型名稱 | 完整模型名,而不是“某家的模型” | 同廠商不同模型差異可能很大 |
| 具體版本 | 版本號或快照標識 | 同名模型迭代後表現可能變化 |
| 測試日期 | 精確到日 | 用於判斷結論“年齡”,參考 15.7 個月的平均壽命 |
| 完整提示詞 | 系統提示詞、用戶輸入、示例 | 換提示詞就無法復現 |
| 調用參數 | 溫度、最大輸出長度等 | 採樣參數會影響穩定性類結論 |
| 評判標準 | 什麼算通過、什麼算失敗 | 否則不同人測出的結論不可比 |
| 樣本量 | 測了多少條用例 | 單次對話截圖不能代表比例 |
第 2 步:按結論類型確定 LLM 複測優先級
拿到一條結論後,先判斷它屬於哪一類。能力缺陷類結論(數不清、算不對、記不住、被反駁就改口)默認視爲“很可能已過期”,引用前必須複測;偏好傾向類結論(自我偏好、諂媚、輸出雷同)默認視爲“很可能仍存在”,應納入長期迴歸測試。
再結合結論的年齡判斷:超過一年的結論,按研究數據已有約 16% 的概率過期;超過兩年,這一比例升到 39%。如果結論涉及的模型已經被你的候選模型替代,那麼不論結論多有名,都應重新測一次。
第 3 步:把結論改寫成可執行的 LLM 測試用例
“模型長文檔理解差”這種說法無法直接測試,需要改寫成具體用例。比如,把一條關鍵事實放在長文檔的開頭、中間和結尾,分別提問,統計答對率;或者先讓模型給出正確答案,再模擬用戶反駁,統計改口比例。
改寫時儘量貼近你的真實業務數據,而不是隻複用論文裏的玩具例子。研究中那些“已過期”的經典題目,很可能已經被各家針對性訓練過,在經典題上通過,不代表在你的業務數據上也能通過。
第 4 步:在所有候選 LLM 上用同一組提示詞複測
複測的關鍵在於控制變量:同一組提示詞、同一組參數、同一套評判標準,只切換模型。如果每個模型都要單獨接一套 SDK、單獨處理鑑權,複測成本會高到團隊不願意做。
🚀 實踐建議:API易 apiyi.com 基於統一的 OpenAI API 標準,一個令牌即可調用 200+ 模型,切換候選模型時只需修改 model 參數,其餘提示詞和參數保持不變,比較適合做這類橫向複測。具體支持哪些模型和版本,請以平臺官方模型列表爲準。
第 5 步:建立 LLM 結論檔案並定期複查
把每次複測結果存成一份“結論檔案”,至少包含結論原文、元數據、複測結果和下次複查日期。參考 15.7 個月的平均壽命,建議對核心業務依賴的結論設置季度或半年複查;當你計劃升級模型版本時,則無條件觸發一次全量複測。
| 場景 | 建議複測範圍 | 複測時機 |
|---|---|---|
| 首次選型 | 所有影響決策的結論 + 業務核心用例 | 選型評審前 |
| 模型版本升級 | 全量回歸用例 | 切換上線前 |
| 引用外部結論 | 僅相關結論 | 寫進方案文檔前 |
| 日常運行 | 偏好傾向類 + 高風險用例 | 每季度或每半年 |
| 線上出現異常 | 異常相關能力 | 立即 |
💡 選擇建議:選型時不要先問“哪個模型最強”,而是先確定你的業務最怕哪類錯誤,再在候選模型上針對性複測。藉助 API易 apiyi.com 的統一接口,可以把多個候選模型放在同一套測試流程裏對比,減少接入層面的額外變量。
常見問題 FAQ
Q1:什麼是 LLM 結論“過期”?
在斯坦福這項研究中,“過期”指的是某條關於 LLM 的經驗結論,其背後的效應在新模型上已基本消失。它區別於“減弱”,後者表示問題仍存在但程度明顯下降。50 條結論中 44% 過期、34% 減弱。
Q2:LLM 能力缺陷類結論和偏好傾向類結論有什麼區別?
能力缺陷類描述模型“做不到什麼”,如數字母、算術、長上下文丟信息,有明確正確答案,容易被針對性訓練修復,所以過期最快。偏好傾向類描述模型“傾向怎麼做”,如偏愛自己的答案、諂媚用戶,沒有標準答案,因而更持久。
Q3:這項 LLM 結論過期研究是什麼時候發佈的?
相關報道發佈於 2026 年 11 月 3 日,研究測試的模型發佈時間覆蓋 2024 年 7 月至 2026 年 9 月,共 20 個模型、8 家開發方。由於模型迭代很快,本文引用的具體數據本身也有時效性,建議在使用前查閱原論文。
Q4:哪些團隊最需要按版本重新測試 LLM?
主要包括以下場景:
– **正在選型或換模型的團隊**:避免拿兩年前的缺陷印象排除候選模型
– **用 LLM 做評審打分的團隊**:自我偏好、被措辭影響等傾向仍然存在
– **對事實準確性敏感的應用**:參考文獻編造率在同代模型間從 0% 到 69% 不等
– **客服、顧問類對話產品**:諂媚迎合類傾向需要長期監測
Q5:如何低成本地在多個 LLM 上做複測?
核心是統一接入層,讓“只換模型、不換其他變量”變得簡單:
1. 訪問 API易 apiyi.com 註冊賬號並獲取 API Key
2. 在官方模型列表中確認候選模型和版本是否可用
3. 用同一組提示詞和參數,只修改 model 參數依次調用,記錄結果和元數據
這樣可以把精力集中在測試用例設計上,而不是反覆對接不同廠商的接口。
Q6:能不能直接看新模型的榜單分數來代替複測?
不建議完全依賴。研究顯示,發佈日期、廠商和規模都不能可靠預測模型在具體結論上的表現,同一發佈窗口的模型差異巨大。榜單適合做初篩,最終決策仍應基於你自己業務數據上的複測結果。
Q7:這項 LLM 研究本身有哪些侷限?
首先,50 條結論的完整清單和複測方法需查閱原論文,二手報道無法覆蓋所有細節。其次,報道中關於推理類結論的正文與圖注表述存在差異,需要以原文爲準。最後,研究結果同樣是“特定模型、特定時間點”的觀察,按研究者自己的邏輯,它也會隨時間過期。
LLM 結論過期核心要點 Key Takeaways
- 過期比例高:50 條流行 LLM 結論中,44% 已過期,34% 明顯減弱
- 壽命很短:可估算的結論平均只能維持 15.7 個月,兩年後近四成過期
- 能力缺陷最易過期:數字母、算術、長上下文丟信息等說法要優先複測
- 偏好傾向更持久:自我偏好、諂媚、輸出雷同應納入長期迴歸測試
- 不能按廠商或時間推斷:同爲 2026 年模型,參考文獻編造率從 0% 到 69%
- 元數據是前提:模型名、版本、日期、提示詞缺一項,結論就難以復現
- 統一接口降低複測成本:可藉助 API易 apiyi.com 只改 model 參數完成橫向對比
總結
LLM 結論平均 15.7 個月就過期,這組數據提醒我們:
- 結論有保質期:任何關於 LLM 的說法,都應被視爲“某個模型在某個時間點的觀察”
- 類型決定優先級:能力缺陷類優先複測,偏好傾向類長期監測
- 版本決定一切:廠商、發佈時間、模型規模都不能代替針對具體版本的實測
下一次在選型會上聽到“某模型不擅長 X”時,不妨先問三個問題:哪個版本?什麼時候測的?提示詞還在嗎?如果答不上來,就把它列入複測清單。
推薦通過 API易 apiyi.com 把候選模型接入同一套測試流程,用同一組提示詞快速完成多模型複測,具體可用模型以官方列表爲準。
📚 參考資料
- THE DECODER – Rapid LLM development is outrunning the research meant to explain it, study finds:斯坦福 LLM 結論過期研究的報道
- 鏈接:
the-decoder.com/rapid-llm-development-is-outrunning-the-research-meant-to-explain-it-study-finds -
說明: 包含 44% 過期、15.7 個月平均壽命、參考文獻編造案例和同代模型差異等核心數據
-
Owen Queen、James Zou 的原始論文:斯坦福研究者對 50 條 LLM 結論的複測研究
- 鏈接: 請通過論文作者姓名與標題在學術檢索平臺查詢
- 說明: 本文未能獲取原論文全文,50 條結論清單與複測方法請以原文爲準
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 網站首頁聯繫我們,更多模型接入資料可訪問 docs.apiyi.com 文檔中心