Anmerkung des Autors: Dieser Artikel erklärt die Abrechnung von Eingabe-, Ausgabe-, Cache- und Reasoning-Token sowie multimodalen Inhalten und zeigt, wie Sie die Nutzung anhand von Aufrufprotokollen prüfen, Kostensprünge erkennen und auf Preisänderungen reagieren.
Am Monatsende öffnen Sie die Rechnung und stellen fest: Die Kosten für ein Modell sind gegenüber dem Vormonat deutlich gestiegen, obwohl sich die Zahl der Aufrufe kaum verändert hat. Das kennen viele Teams, die APIs für große Sprachmodelle bereits produktiv einsetzen. Dieser Artikel stellt eine Methode vor, mit der Sie Abrechnungspositionen aufschlüsseln und mit Aufrufprotokollen abgleichen können. So verstehen und überprüfen Sie Ihre API-Rechnungen.
Dies ist keine Preisübersicht. Die Preise der Anbieter ändern sich häufig. Deshalb nennt dieser Artikel keine konkreten Einzelpreise, sondern erklärt Abrechnungsgrundlagen und Prüfmethoden, die langfristig gelten.
Ein Anhaltspunkt aus der Branche: Im November 2026 suchte ein KI-Infrastrukturunternehmen Personal für den Betrieb einer Plattform für große Sprachmodelle. Zu den ausdrücklich genannten Aufgaben gehörte die „Prüfung von Kosten und Abrechnungen“: Abrechnungsgrundlagen für Eingabe-, Ausgabe-, Cache- und Reasoning-Token sowie für Bilder, Audio und Video prüfen und auffällige Rechnungen, Preisänderungen und Abrechnungsabweichungen zeitnah erkennen. Dass Plattformanbieter dafür eigenes Personal brauchen, zeigt, wie komplex die Abrechnung ist. Auch als API-Nutzer sollten Sie sich deshalb angewöhnen, Ihre Rechnungen systematisch abzugleichen.
Das nehmen Sie mit: Nach der Lektüre wissen Sie, wie die einzelnen Positionen auf einer API-Rechnung für große Sprachmodelle zustande kommen, wie Sie die Nutzung anhand von Aufrufprotokollen überprüfen und wie Sie die Ursache finden, wenn „dieselbe Anfrage plötzlich mehr kostet“.
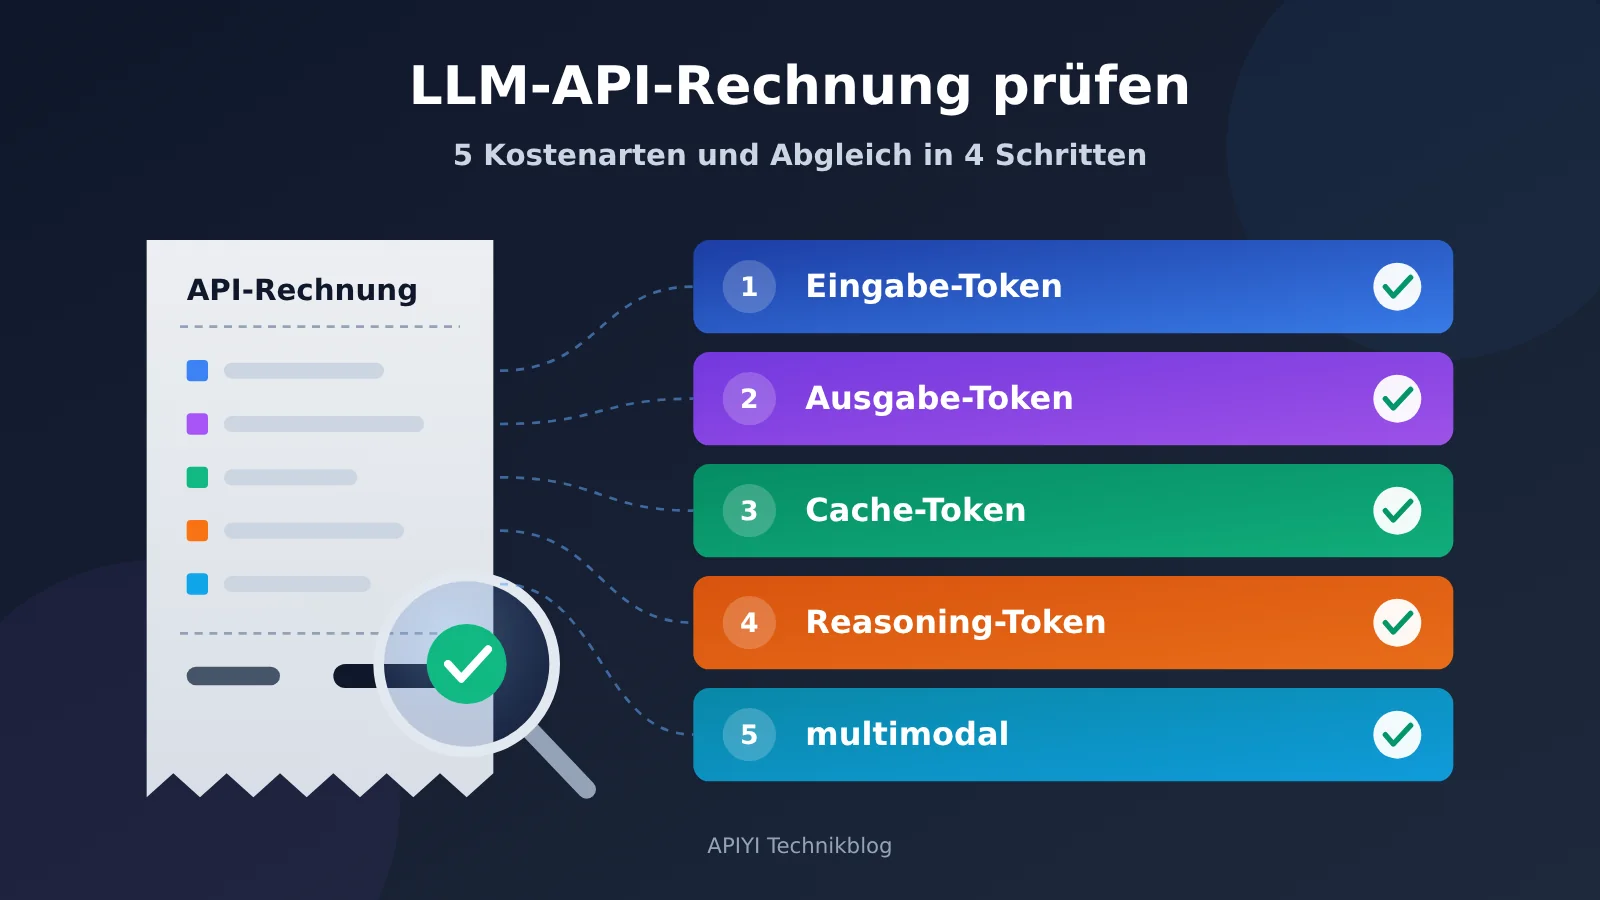
Das Wichtigste zur API-Abrechnung für große Sprachmodelle: 5 Kostenarten
Die Kosten für einen Modellaufruf ergeben sich meist nicht einfach aus „Anzahl der Aufrufe × Stückpreis“. Die einzelnen Kostenarten entstehen auf unterschiedliche Weise und haben unterschiedliche Preise. Wer sie zusammen betrachtet, schätzt die Kostenstruktur leicht falsch ein.
| Kostenart | Entstehung | Typische Abrechnung | Worauf bei der Abrechnung achten? |
|---|---|---|---|
| Eingabe-Token | System-Eingabeaufforderung, Gesprächsverlauf, Tool-Definitionen, abgerufene Dokumente, Nutzereingabe | Pro Token, meist günstiger als Ausgabe-Token | Wird der Kontext unbemerkt länger? |
| Ausgabe-Token | Sichtbare Antwort des Modells | Pro Token, meist teurer als Eingabe-Token | Antwortlänge, Einstellung von max_tokens |
| Cache-Token | Eingabepräfix, das im Cache gefunden wird | Für Cache-Treffer gibt es oft Rabatte; manche Anbieter berechnen das Schreiben separat | Sinkt die Cache-Trefferquote? |
| Reasoning-Token | Interner Denkprozess von Reasoning-Modellen | Meist zum Ausgabepreis abgerechnet, aber nicht unbedingt in der Antwort sichtbar | Nimmt die Länge des Reasonings zu? |
| Multimodale Abrechnung | Eingabe oder Erzeugung von Bildern, Audio und Video | Pro Bild, pro Sekunde, nach Auflösung oder in Token umgerechnet | Haben sich die Spezifikationen geändert? |
Warum API-Abrechnungen für große Sprachmodelle oft nicht aufgehen
Der erste Grund sind unsichtbare Token. Im Code steht vielleicht nur eine einzige Nutzerfrage. Die tatsächliche Anfrage kann aber mehrere Tausend Token für die System-Eingabeaufforderung, den Gesprächsverlauf und Tool-Schemas enthalten. Reasoning-Modelle erzeugen zudem oft viele Denk-Token, die Nutzende nicht sehen. All das wird abgerechnet, ohne auf der Oberfläche zu erscheinen.
Der zweite Grund sind unterschiedliche Abrechnungsgrundlagen. Bei Bildeingaben berechnen manche Anbieter pro Bild, andere rechnen die Auflösung in Token um. Auch beim Cache gibt es Unterschiede: Manche Anbieter cachen automatisch, andere verlangen eine ausdrückliche Angabe. Manche gewähren nur beim Lesen einen Rabatt, andere berechnen zusätzlich das Schreiben. Wer Modelle und Anbieter vergleicht, muss deshalb zuerst eine gemeinsame Grundlage schaffen.
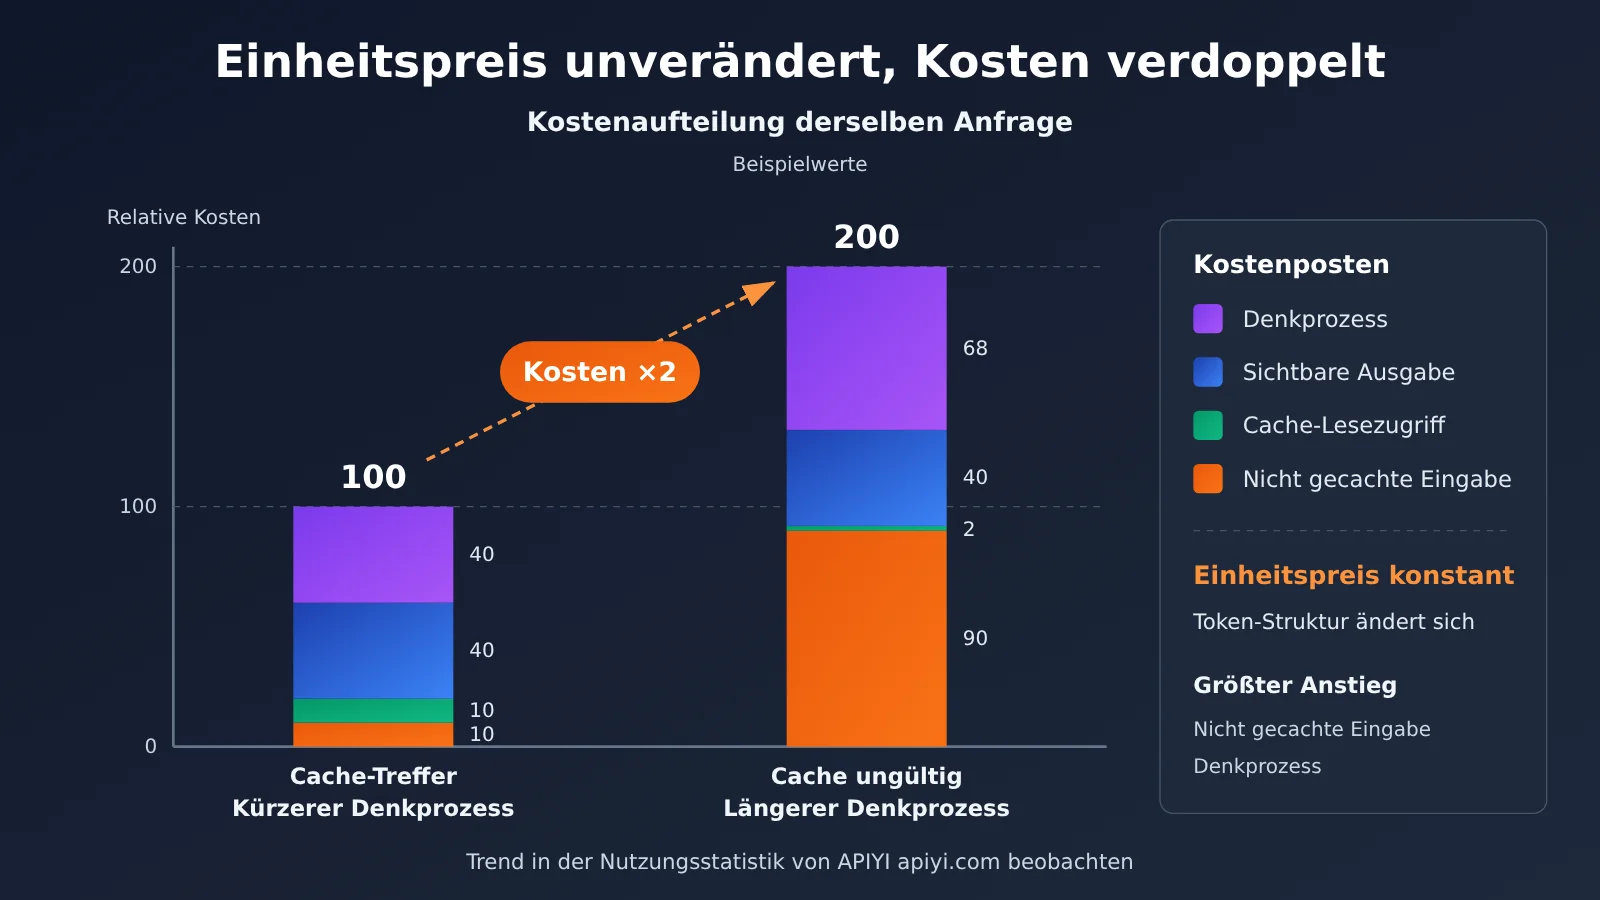
Der dritte Grund sind veränderliche Faktoren. Ein Modellalias kann auf eine neue Version verweisen, eine kleine Änderung am Präfix der Eingabeaufforderung kann den gesamten Cache ungültig machen, und bei schwierigeren Fragen denken Reasoning-Modelle länger nach. Die Preise können gleich bleiben und die Kosten trotzdem steigen.
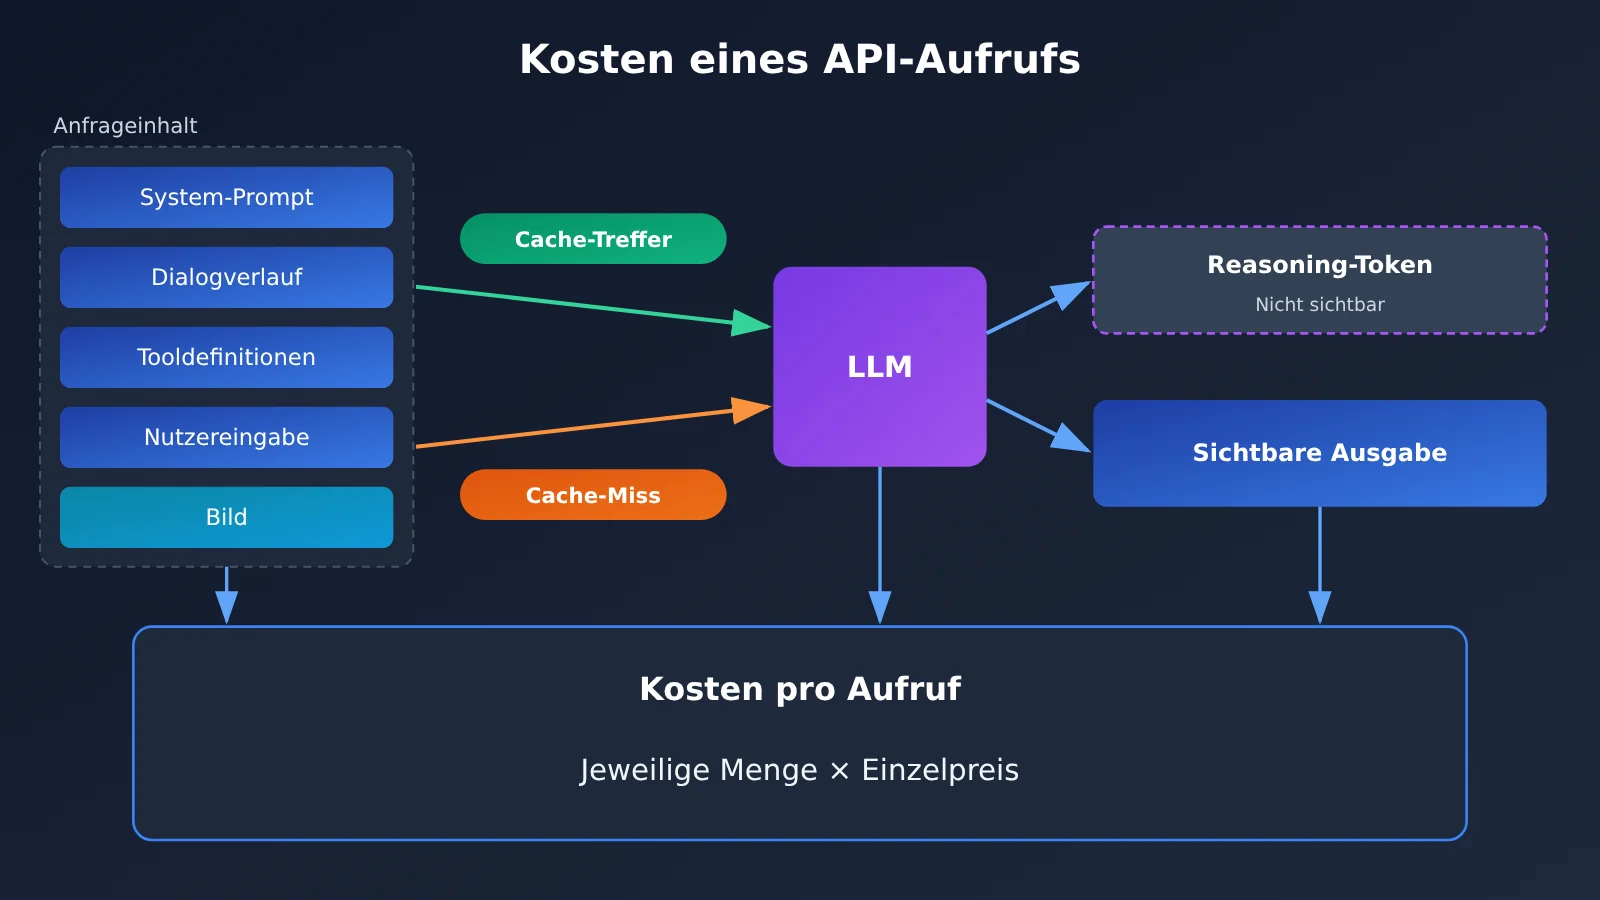
Die einzelnen Kostenpositionen auf der API-Rechnung für große Sprachmodelle
Eingabe-Token: Der am häufigsten unterschätzte Kostenfaktor
Eingabe-Token umfassen alles, was das Modell bei einer Anfrage „liest“ – nicht nur die letzte Nachricht des Nutzers. Bei Gesprächen über mehrere Runden wird der bisherige Verlauf in jeder Runde erneut gesendet. Je länger das Gespräch, desto höher die Eingabekosten pro Runde. Die Gesamtkosten wachsen dabei annähernd quadratisch mit der Zahl der Runden.
Auch RAG-Anwendungen verbrauchen viele Eingabe-Token. Die Anzahl und Länge der abgerufenen Dokumentabschnitte bestimmen die Eingabekosten direkt. Beim Function Calling wird das JSON-Schema der Tool-Definitionen bei jeder Anfrage als Eingabe mitgezählt. Je mehr Tools eingebunden sind, desto höher ist dieser feste Kostenanteil.
Außerdem verwenden verschiedene Modelle unterschiedliche Tokenizer. Derselbe chinesische Text kann je nach Modell in deutlich unterschiedlich viele Token zerlegt werden. Die Token-Anzahl eines Modells eignet sich daher nicht, um die Kosten eines anderen Modells zu schätzen.
Ausgabe-Token: höherer Stückpreis, direkt durch Parameter gesteuert
Ausgabe-Token sind die Inhalte der Antwort, die das Modell erzeugt. Bei den meisten Anbietern ist der Stückpreis für Ausgabe-Token deutlich höher als für Eingabe-Token. Das Modell zu knapperen Antworten anzuhalten, spart daher oft mehr Geld als das Kürzen der Eingabe.
max_tokens begrenzt die Ausgabekosten nach oben, garantiert aber keine vollständige Antwort. Wird eine Antwort abgeschnitten, wird der bereits erzeugte Teil trotzdem berechnet. Auch wenn eine Streaming-Ausgabe vorzeitig abbricht, können die Plattformen bereits erzeugte Token unterschiedlich behandeln. Maßgeblich sind die Angaben des jeweiligen Anbieters.
Cache-Token: Nur ein Cache-Treffer spart Geld
Das Caching von Eingabeaufforderungen funktioniert so: Wenn mehrere Anfragen dasselbe Präfix teilen, etwa dieselbe System-Eingabeaufforderung oder dasselbe lange Dokument, kann der Anbieter den bereits verarbeiteten Teil wiederverwenden und für diese Eingabe einen Rabatt gewähren.
Bei Caches sollten Sie einige gängige Regeln einzeln prüfen:
- Automatische Aktivierung: Manche Anbieter aktivieren das Caching standardmäßig, bei anderen muss die Cache-Position in der Anfrage ausdrücklich markiert werden;
- Anforderungen an die Präfixübereinstimmung: In der Regel muss das Präfix vom Anfang an wortwörtlich übereinstimmen. Jede Änderung darin macht den gesamten nachfolgenden Teil ungültig;
- Mindestlänge und Gültigkeitsdauer: Zu kurze Präfixe werden möglicherweise nicht zwischengespeichert. Nach Ablauf des Caches müssen sie erneut geschrieben werden;
- Kosten für das Schreiben: Manche Anbieter berechnen für das erstmalige Schreiben in den Cache einen höheren Preis als für normale Eingaben. Erst spätere Lesezugriffe sind günstiger.
Bei der Kostenabrechnung sollten Sie „Cache-Lese-Token“ und „normale Eingabe-Token“ getrennt erfassen. Andernfalls kann eine sinkende Cache-Trefferquote fälschlich wie ein Anstieg der Anzahl der Aufrufe aussehen.
Reasoning-Token: unsichtbar, aber kostenpflichtig
Reasoning-Modelle führen vor ihrer Antwort interne Denkschritte aus. Die dafür verwendeten Token werden meist zum Ausgabepreis berechnet. Häufig wird das Reasoning nicht vollständig zurückgegeben; seine Token-Anzahl ist dann nur in den Nutzungsdaten sichtbar.
Wie viele Reasoning-Token anfallen, hängt von der Schwierigkeit der Aufgabe und dem Parameter für die Reasoning-Intensität ab. Werden die Fragen der Nutzer komplexer, kann also auch bei derselben Schnittstelle die Rechnung steigen. Wenn eine Anwendung nur einfache Klassifizierungen oder Formatumwandlungen benötigt, bezahlt man bei einem Reasoning-Modell oft für Denkschritte, die gar nicht nötig sind.
Multimodale Abrechnung: Erst die Berechnungsgrundlage prüfen
Bei multimodalen Modellen unterscheiden sich die Abrechnungsgrundlagen besonders stark. Deshalb lohnt sich für jedes Modell ein Blick auf die offizielle Preisseite. Die folgende Tabelle zeigt gängige Abrechnungsarten; massgeblich sind die jeweils aktuellen Angaben der Anbieter.
| Typ | Gängige Abrechnungsart | Wichtige Kostenfaktoren | Empfehlung zur Prüfung |
|---|---|---|---|
| Bildeingabe (Bildverständnis) | Umrechnung der Auflösung in Token oder Abrechnung pro Bild | Bildgrösse, Detailstufe | Tatsächliche Auflösung vor und nach dem Hochladen erfassen |
| Bilderzeugung | Abrechnung pro Bild oder nach Ausgabe-Token | Grösse, Qualitätsstufe, Anzahl der erzeugten Bilder | Spezifikationen jeder Anfrage erfassen |
| Audioeingabe und -ausgabe | Abrechnung nach Dauer oder Umrechnung in Audio-Token | Audiodauer, Verarbeitung der Abtastrate | Tatsächliche Audiodauer erfassen |
| Sprachsynthese | Abrechnung nach Zeichen oder Token | Textlänge, Stimmstufe | Länge des synthetisierten Textes erfassen |
| Videoerzeugung und -verständnis | Abrechnung pro Sekunde, pro Frame oder nach Auflösungsstufe | Dauer, Auflösung, Bildrate | Kombination aus Dauer und Auflösung erfassen |
| Embedding | Abrechnung nach Eingabe-Token | Textlänge, Batch-Grösse | Getrennt vom regulären Eingabepreis erfassen |
🎯 Technischer Tipp: Für multimodale Anwendungen empfiehlt sich ein einheitlicher Zugang, um die unterschiedlichen Abrechnungsgrundlagen zentral zu verwalten. Laut der offiziellen Beschreibung von APIYI auf apiyi.com nutzen die Modelle auf der Plattform ein gemeinsames Guthaben; ausserdem stehen Nutzungsstatistiken und Aufrufprotokolle zur Verfügung. Prüfen Sie zunächst in der Konsole, welche Felder die Protokolle anzeigen. Entscheiden Sie dann, welche Parameter Sie für den Abrechnungsabgleich zusätzlich erfassen müssen.
API-Abrechnungen für große Sprachmodelle: Abgleich in 4 Schritten
Das Grundprinzip ist einfach: Multiplizieren Sie die selbst erfasste Nutzung mit dem gespeicherten Preisstand, um die erwarteten Kosten zu berechnen. Vergleichen Sie diese anschließend mit der Plattformrechnung. Liegt die Abweichung außerhalb des Toleranzbereichs, prüfen Sie die einzelnen Positionen.
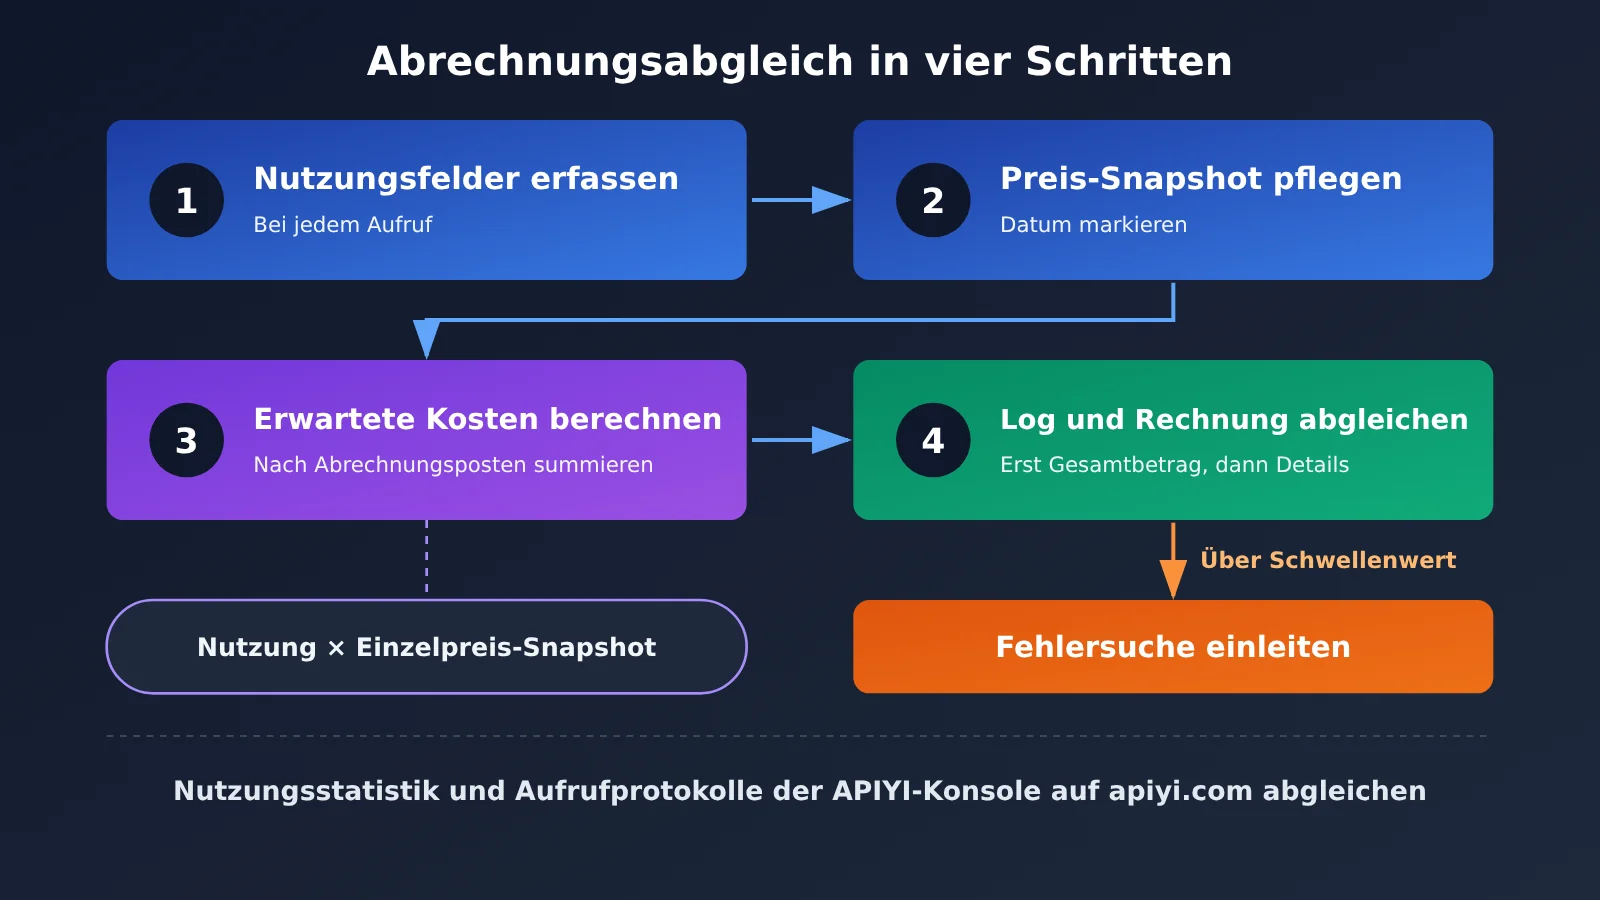
Schritt 1: Nutzungsfelder nach jedem Aufruf erfassen
Schnittstellen im OpenAI-kompatiblen Format geben in ihrer Antwort normalerweise ein usage-Objekt zurück. Die folgende Tabelle zeigt häufige Felder und ihre Bedeutung. Da sich die Rückgaben je nach Modell und Plattform unterscheiden können, sollten Sie sie vor der Integration mit einer Testanfrage prüfen.
| Feld (häufige Schreibweise im OpenAI-kompatiblen Format) | Bedeutung | Zugehörige Abrechnungsposition |
|---|---|---|
prompt_tokens |
Gesamtzahl der Eingabe-Token für diese Anfrage | Eingabe (einschließlich zwischengespeichertem Anteil) |
prompt_tokens_details.cached_tokens |
Anteil der Eingabe, der aus dem Cache gelesen wurde | Cache-Lesezugriff |
completion_tokens |
Gesamtzahl der Ausgabe-Token | Ausgabe (kann Reasoning-Anteil enthalten) |
completion_tokens_details.reasoning_tokens |
Reasoning-Anteil der Ausgabe | Reasoning |
model |
Name des Modells, das tatsächlich geantwortet hat | Zur Erkennung von Versionsänderungen |
Speichern Sie bei jedem Aufruf mindestens die folgenden Informationen:
- Anfragezeitpunkt, Anfrage-ID und Kennung des Anwendungsszenarios;
- den in der Anfrage angegebenen Modellnamen und das in der Antwort zurückgegebene
model; - alle Nutzungsfelder aus der Tabelle; fehlende Felder als leer statt als 0 speichern;
- Spezifikationen multimodaler Anfragen, etwa Bildgröße, Audiodauer und Anzahl der erzeugten Elemente;
- ob der Aufruf gestreamt, wiederholt oder abgeschnitten wurde (
finish_reason).
Beachten Sie, dass prompt_tokens und completion_tokens häufig Gesamtzahlen sind. Cache- und Reasoning-Token sind darin bereits enthalten. Ziehen Sie diese Anteile bei der Kostenberechnung zunächst von den Gesamtzahlen ab und multiplizieren Sie sie dann jeweils mit dem passenden Einzelpreis. Andernfalls berechnen Sie Kosten möglicherweise doppelt oder übersehen Rabatte.
Schritt 2: Datierte Preis-Snapshots pflegen
Hinterlegen Sie Stückpreise nicht fest im Code. Pflegen Sie stattdessen eine Tabelle mit Preis-Snapshots. Jede Zeile enthält den Modellnamen, die Abrechnungsposition, den Stückpreis, die Währung, das Gültigkeitsdatum und die Quelle – etwa die offizielle Preisseite oder eine Ankündigung der Plattform.
Fügen Sie bei Preisänderungen eine neue Zeile hinzu, statt den alten Wert zu überschreiben. So können Sie Rechnungen für jeden beliebigen Tag mit den damals gültigen Preisen nachberechnen. Wenn Sie Modelle über eine Aggregationsplattform wie APIYI aufrufen, gelten die aktuell von der Plattform veröffentlichten Preise. Notieren Sie auch hier das Abfragedatum.
Schritt 3: Erwartete Kosten berechnen
Die erwarteten Kosten eines einzelnen Aufrufs setzen sich aus mehreren Positionen zusammen:
- Eingabe-Token ohne Cache-Treffer × Eingabepreis pro Token;
- aus dem Cache gelesene Token × Preis pro gelesenen Cache-Token; falls das Schreiben in den Cache berechnet wird, kommen diese Kosten hinzu;
- sichtbare Ausgabe-Token × Ausgabepreis pro Token;
- Reasoning-Token × entsprechender Preis pro Token; meist entspricht dieser dem Ausgabepreis, massgeblich sind die offiziellen Angaben;
- multimodale Bestandteile werden nach ihren jeweiligen Abrechnungsregeln separat berechnet.
Nach Tag, Modell und Geschäftsszenario zusammengefasst, ergibt sich daraus eine Übersicht der Kosten, die Sie erwarten würden.
Schritt 4: Mit Plattformlogs und Abrechnung abgleichen
Vergleiche deine eigenen Aufzeichnungen mit den Nutzungsstatistiken und Aufruflogs der Plattform. Prüfe zuerst die Gesamtsumme, dann die Kosten pro Modell und gehe schliesslich einzelnen Anfragen nach.
Lege am besten eine Toleranzschwelle fest. Kleine Abweichungen sind durch Wechselkurse, die Genauigkeit der Abrechnung oder unterschiedliche Zeitzonen bei der Auswertung üblich. Erst bei grösseren Abweichungen lohnt sich eine detaillierte Prüfung.
🚀 Schnellstart: Wenn du bereits Modelle über APIYI apiyi.com aufrufst, kannst du zunächst die Aufruflogs für einen bestimmten Zeitraum exportieren und Eintrag für Eintrag mit den selbst aufgezeichneten
usage-Feldern abgleichen. Ob Cache-Token und Reasoning-Token in den Logs getrennt ausgewiesen werden, hängt von den aktuell verfügbaren Feldern der Plattform ab. Falls sie nicht separat aufgeführt sind, nutze die lokal protokollierten Antwortfelder als Detailgrundlage.
Warnsignale in API-Abrechnungen für grosse Sprachmodelle: So prüfst du plötzliche Kostenänderungen
Wenn sich die Kosten für dieselbe Art von Anfrage plötzlich ändern, solltest du besonders aufmerksam werden. Die Tabelle zeigt häufige Ursachen und mögliche Prüfschritte.
| Auffälligkeit | Mögliche Ursache | Prüfmethode |
|---|---|---|
| Kosten pro Aufruf steigen, Anzahl der Aufrufe bleibt gleich | Der Modellalias verweist auf eine neue Version mit anderem Preis oder Token-Verbrauch | Änderungen am Feld model in den Antworten vergleichen |
| Eingabekosten steigen, Gesamtzahl der Eingabe-Token bleibt gleich | Cache-Trefferquote sinkt | Anteil von cached_tokens prüfen und kontrollieren, ob das Präfix der Eingabeaufforderung geändert wurde |
| Ausgabekosten steigen, sichtbare Antwortlänge bleibt gleich | Zahl der Reasoning-Token steigt | Entwicklung von reasoning_tokens und Parameter für die Reasoning-Intensität prüfen |
| Zahl der Eingabe-Token steigt langsam, aber stetig | Gesprächsverlauf wird nicht gekürzt, mehr Retrieval-Fragmente oder zusätzliche Tool-Definitionen | Vollständige Anfrage-Bodys stichprobenartig prüfen |
| Anzahl der Aufrufe ist höher als das Geschäftsvolumen | Clientseitige Wiederholungsversuche oder erneutes Senden nach Timeouts | Statistik anhand von Anfrage-ID und Geschäfts-ID deduplizieren |
| Bild- oder Videokosten steigen sprunghaft | Auflösung, Qualitätsstufe oder Anzahl der erzeugten Inhalte wurde erhöht | Spezifikationsparameter in den Anfragen vergleichen |
| Stückpreis auf der Rechnung stimmt nicht mit dem Preis-Snapshot überein | Offizieller Anbieter oder Plattform hat Preise geändert | Preisseite und Ankündigungen prüfen, Preis-Snapshot aktualisieren |
Cache-Ausfall: Der unauffälligste Kostentreiber
Ein Cache-Ausfall geht oft auf eine scheinbar harmlose Änderung zurück. Zum Beispiel wird das aktuelle Datum an den Anfang der System-Eingabeaufforderung gesetzt oder die Nutzer-ID in das Präfix eingefügt. Dadurch unterscheidet sich das Präfix bei jeder Anfrage, der Cache greift nicht mehr und die Eingabekosten steigen wieder auf den regulären Preis.
Besser ist es, feste Inhalte an den Anfang und variable Inhalte ans Ende zu setzen. Prüfe am Tag nach einer Änderung am Template der Eingabeaufforderung, ob sich die Cache-Trefferquote verändert hat.
Drift bei der Reasoning-Länge: Auch der Schwierigkeitsgrad beeinflusst die Rechnung
Die Kosten für Reasoning-Modelle hängen vom Schwierigkeitsgrad der Fragen ab. Wenn Nutzer an einem Tag gehäuft komplexe Fragen stellen, steigt die Zahl der Reasoning-Token deutlich an – das ist eine normale Schwankung. Nimmt sie dagegen bei gleichbleibendem Anfragetyp stetig zu, solltest du prüfen, ob sich die Modellversion oder die Reasoning-Parameter geändert haben.
So behalten Sie Preisänderungen bei APIs für Große Sprachmodelle im Blick
Preisänderungen selbst lassen sich nicht kontrollieren – wohl aber, wie schnell Sie sie bemerken. Diese Prüfroutine lässt sich dauerhaft beibehalten:
- Wöchentlich: Prüfen Sie die Kostenentwicklung pro Modell und die durchschnittlichen Kosten pro Aufruf. Achten Sie auf sprunghafte Veränderungen;
- Monatlich: Gleichen Sie die Abrechnung vollständig ab und untersuchen Sie jede Abweichung, die den festgelegten Schwellenwert überschreitet;
- Nach jeder Änderung an einer Vorlage für Eingabeaufforderungen: Beobachten Sie ein bis zwei Tage lang die Cache-Trefferquote;
- Vor jedem Modellwechsel oder -Upgrade: Vergleichen Sie bei geringem Anfragevolumen den Token-Verbrauch und die Kosten des alten und des neuen Modells;
- Ankündigungen verfolgen: Abonnieren Sie Preis- und Modellupdates der verwendeten Anbieter oder Plattformen und aktualisieren Sie nach jeder Meldung Ihren Preis-Snapshot;
- Versionen festlegen: Verwenden Sie in der Produktionsumgebung möglichst Modellnamen mit konkreter Versionsnummer, um Überraschungen durch automatische Upgrades von Aliasnamen zu vermeiden.
💡 Tipp zur Auswahl: Wenn Sie Modelle mehrerer Anbieter nutzen, kann der Abgleich über mehrere Konten hinweg viel Zeit kosten. Über APIYI apiyi.com können Sie unterschiedliche Modelle einheitlich anbinden und ihre Nutzung mit einem gemeinsamen Guthaben und in denselben Logs einsehen. So lassen sich die Kosten pro Aufruf leichter vergleichen. Prüfen Sie am besten vorab in der Konsole, welche Details dort tatsächlich verfügbar sind.
Häufig gestellte Fragen (FAQ)
Q1: Was sind Token auf der API-Rechnung für ein Großes Sprachmodell?
Token sind die grundlegenden Einheiten, in denen ein Modell Text verarbeitet. Man kann sie sich als Textfragmente vorstellen. Ein chinesisches Schriftzeichen kann einem oder mehreren Token entsprechen – je nach Tokenizer des Modells. Auf der Rechnung werden Token üblicherweise nach Kategorien wie Eingabe, Ausgabe, Cache und Reasoning getrennt abgerechnet.
Q2: Was ist der Unterschied zwischen Cache-Token und normalen Eingabe-Token?
Beide gehören zur Eingabe. Cache-Token sind jedoch der Teil, der mit einem bereits zwischengespeicherten Präfix übereinstimmt, und werden meist günstiger abgerechnet. Für normale Eingabe-Token gilt der volle Preis. Manche Anbieter berechnen auch das erstmalige Schreiben in den Cache separat. Beim Rechnungsabgleich sollten deshalb alle drei Kategorien getrennt erfasst werden.
Q3: Warum sind Reasoning-Token in der Antwort nicht sichtbar?
Reasoning-Token entstehen bei der internen Verarbeitung des Modells. Viele Modelle geben den vollständigen Reasoning-Prozess nicht an den Aufrufer zurück, sondern nennen lediglich die Anzahl im Nutzungsfeld. Sie werden in der Regel zum Ausgabepreis berechnet. Deshalb können die Kosten auch bei einer kurzen Antwort relativ hoch sein.
Q4: Warum ändern sich die Kosten für dieselbe Anfrage plötzlich?
Dafür gibt es drei häufige Gründe: Der Modellalias verweist auf eine neue Version, eine Änderung am Präfix der Eingabeaufforderung verhindert einen Cache-Treffer oder der Reasoning-Prozess ist länger geworden. Weitere Ursachen sind wiederholte Abrechnung durch erneute Versuche und höher eingestellte Parameter für multimodale Inhalte. Gehen Sie die Tabelle mit den Auffälligkeiten in diesem Artikel Schritt für Schritt durch, um die Ursache zu finden.
Q5: Wie lässt sich die API-Rechnung für ein Großes Sprachmodell anhand der Plattform-Logs prüfen?
Erfassen Sie zunächst in Ihrem eigenen System für jede Antwort das Feld `usage` und die Anfrage-ID. Exportieren Sie dann die Aufruf-Logs der Plattform und gleichen Sie sie Anfrage für Anfrage ab. Bei APIYI apiyi.com können Sie beispielsweise Nutzungsstatistiken und Aufruf-Logs in der Konsole einsehen. Prüfen Sie zuerst, welche Felder die Logs enthalten, und führen Sie sie dann für den Rechnungsabgleich mit Ihren lokalen Aufzeichnungen zusammen.
Q6: Wie lassen sich die Kosten für multimodale Modelle schätzen?
Prüfen Sie zunächst auf der offiziellen Preisseite, wie abgerechnet wird: pro Bild, pro Sekunde oder durch Umrechnung der Auflösung in Token. Erfassen Sie dann die entsprechenden Parameter im Anfrage-Log, etwa Bildgrösse, Audiodauer sowie Auflösung und Dauer von Videos. Multiplizieren Sie diese Werte mit dem jeweiligen Einzelpreis, um die Kosten zu schätzen.
Q7: Wo sollte man zuerst nachsehen, wenn der Rechnungsabgleich Abweichungen zeigt?
Prüfen Sie zuerst, ob der gespeicherte Preisstand aktuell ist, um Preisänderungen als Ursache auszuschliessen. Vergleichen Sie dann die Anzahl der Aufrufe, um erneute Versuche und doppelte Anfragen auszuschliessen. Schlüsseln Sie die Abweichung zuletzt nach Modell und Abrechnungsposten auf, um festzustellen, ob sie bei der Eingabe, dem Cache, dem Reasoning oder den multimodalen Inhalten entstanden ist.
Q8: Welche Grenzen hat diese Methode zum Rechnungsabgleich?
Sie ist auf die Nutzungsfelder angewiesen, die in der Antwort zurückgegeben werden. Wenn bestimmte Modelle oder Schnittstellen keine Details zu Cache und Reasoning liefern, bleibt nur die Plattformrechnung als Grundlage. Ausserdem können Wechselkurse, die Abrechnungsgenauigkeit und die Zeitzone der Auswertung kleine Abweichungen verursachen. Legen Sie daher sinnvolle Toleranzgrenzen fest, statt auf eine bis ins letzte Detail exakte Übereinstimmung zu bestehen.
API-Abrechnungen für Große Sprachmodelle: Das Wichtigste auf einen Blick
- Die Kosten setzen sich aus mehreren Posten zusammen: Für Eingabe, Ausgabe, Cache, Reasoning und multimodale Inhalte gelten unterschiedliche Preise. Erfassen Sie diese getrennt.
- Eingabe-Token umfassen weit mehr als die Nutzerfrage: Auch System-Eingabeaufforderungen, Gesprächsverlauf, abgerufene Dokumente und Tool-Definitionen zählen zur Eingabe.
- Cache-Treffer hängen von einem identischen Präfix ab: Platzieren Sie feste Inhalte vorne und variable Inhalte hinten. Prüfen Sie nach Änderungen an der Vorlage die Trefferquote.
- Reasoning-Token sind unsichtbar, werden aber berechnet: Vermeiden Sie Reasoning-Modelle für einfache Aufgaben und beobachten Sie die Entwicklung der Reasoning-Länge.
- Bei multimodalen Inhalten zuerst die Abrechnungseinheit klären: Ob pro Bild, pro Sekunde oder nach Auflösung abgerechnet wird, steht auf der offiziellen Preisseite.
- Abgleich in vier Schritten: Nutzung erfassen, Preisstände pflegen, erwartete Kosten berechnen und mit Protokollen und Rechnungen vergleichen.
- Ein einheitlicher Zugang erleichtert den Abgleich: Mit dem zentralen Guthaben und den Aufrufprotokollen von APIYI apiyi.com lässt sich die Nutzung mehrerer Modelle gesammelt prüfen.
Fazit
Um API-Abrechnungen für Große Sprachmodelle zu verstehen und zu prüfen, sind drei Dinge entscheidend:
- Aufschlüsseln: Teilen Sie die Kosten eines Aufrufs in Eingabe, Cache, Ausgabe, Reasoning und multimodale Inhalte auf und ordnen Sie die jeweiligen Ursachen zu.
- Selbst erfassen: Speichern Sie bei jedem Aufruf die Nutzungsdaten und Spezifikationsparameter in einer Datenbank und pflegen Sie datierte Preisstände.
- Regelmäßig vergleichen: Prüfen Sie wöchentlich die Entwicklung und gleichen Sie monatlich die Gesamtabrechnung ab. Bei plötzlichen Kostenänderungen untersuchen Sie Modellversion, Cache-Trefferquote, Reasoning-Länge, Wiederholungsversuche und Spezifikationsparameter.
Plattformbetreiber prüfen diese Abrechnungsgrundlagen gezielt. Auch als Nutzer ist es wichtig, sich einen eigenen Abgleich anzugewöhnen. Wenn Ihre Anwendung Modelle mehrerer Anbieter nutzt, empfiehlt sich ein einheitlicher Zugang über APIYI apiyi.com: Dort können Sie Nutzung und Aufrufprotokolle in einer Konsole einsehen und anschließend mit den Methoden aus diesem Artikel abgleichen.
📚 Quellen
- V2EX-Stellenanzeige: Plattformbetrieb für Große Sprachmodelle bei einem KI-Agent-Infrastrukturunternehmen: Zu den Aufgaben gehört die „Prüfung von Kosten und Abrechnung“.
- Link:
v2ex.com/t/1254263 -
Hinweis: Die Anzeige wurde am 03.11.2026 veröffentlicht. Sie beschreibt, dass die Plattform die Abrechnungsgrundlagen für Eingabe- und Ausgabe-Token, Cache-Token, Reasoning-Token sowie Bilder, Audio und Video prüfen und ungewöhnliche Rechnungen, Preisänderungen und Abweichungen bei der Abrechnung erkennen muss.
-
Offizielle Preisseiten der Modellanbieter: Die einzige maßgebliche Quelle für konkrete Einzelpreise und Abrechnungsregeln
- Link: Auf der Website des jeweiligen Anbieters im Bereich „Preise“ oder „Dokumentation“
- Hinweis: Preise ändern sich häufig. Halten Sie beim Zitieren daher unbedingt das Abrufdatum fest.
Autor: APIYI-Technikteam
Technischer Austausch: Bei Fragen zur Prüfung von API-Rechnungen für Große Sprachmodelle können Sie uns über die APIYI-Startseite apiyi.com kontaktieren. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.