Примечание автора: Alphabet сообщила, что её API собственных моделей обрабатывает почти 32 миллиарда токенов в минуту. В этой статье мы сравним Gemini 4 Argon, 3.8 Flash и 3.5 Flash-Lite с помощью официальных цен, независимых тестов и моделирования расходов — и разберёмся, сколько на самом деле стоит каждое успешно выполненное задание.
28 октября 2026 года генеральный директор Alphabet Сундар Пичаи сообщил в отчёте за третий квартал, что API собственных моделей компании сейчас обрабатывает почти 32 миллиарда токенов в минуту — более чем в 4 раза больше, чем годом ранее. Эта цифра отражает общий спрос на Gemini API среди разработчиков и компаний, а не результат какой-то одной модели.
Это не очередная статья с советом «просто берите самую мощную модель». По мере роста числа вызовов вопросы стоимости и выбора модели становятся всё важнее. Если выбрать неподходящую модель, ежемесячный счёт может вырасти в несколько раз. А если её возможностей окажется недостаточно, придётся повторять запросы — и в итоге расходы тоже вырастут.
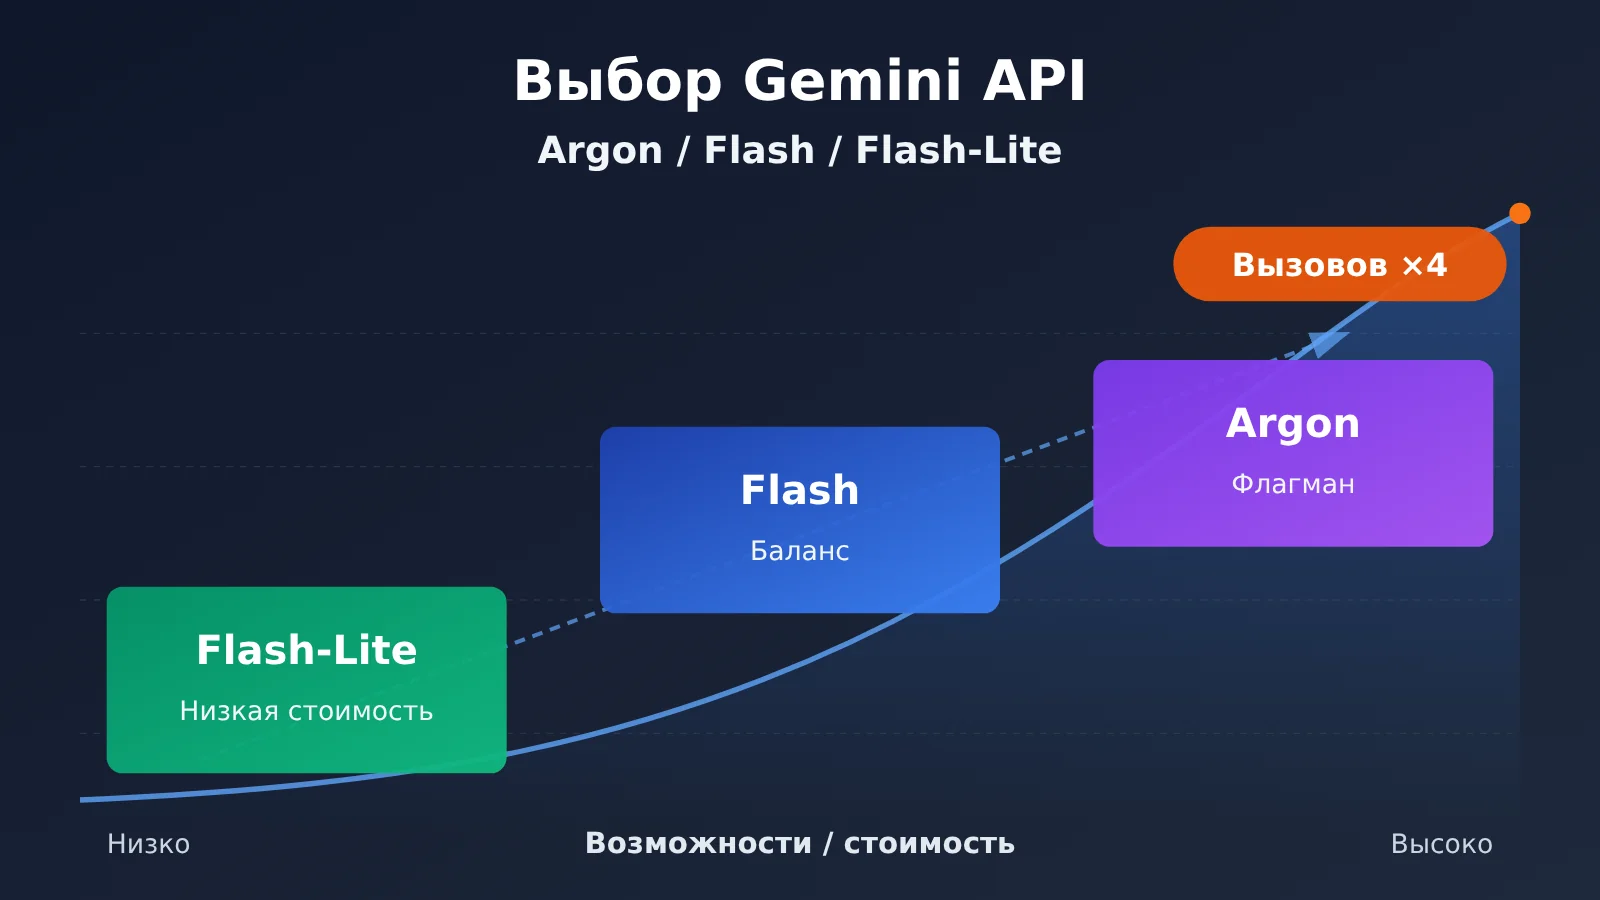
Что вы узнаете: прочитав статью, вы поймёте, чем три модели Gemini — Argon, Flash и Flash-Lite — отличаются по возможностям, цене, скорости и сценариям применения. Мы также предложим готовый способ протестировать модели на ваших бизнес-задачах и сделать предварительный выбор.
Резкий рост использования Gemini API: главное
| Параметр | Подробности |
|---|---|
| Дата публикации | 28 октября 2026 года (финансовый отчёт Alphabet за III квартал 2026 года) |
| Источник | Генеральный директор Alphabet Сундар Пичаи |
| Ключевые данные | API собственных моделей обрабатывает почти 32 млрд токенов в минуту. Это примерно на 40% больше ранее раскрытого показателя и более чем в 4 раза больше, чем годом ранее |
| Основные модели API | Gemini 4 Argon, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite |
| Кого это касается | Всех разработчиков и компаний, которые создают приложения с помощью Gemini Developer API |
Что 32 млрд токенов в минуту значат для разработчиков Gemini API
Резкий рост использования показывает, что модели уже широко применяются в работающих продуктах. Но это не значит, что каждому проекту нужна самая дорогая флагманская модель. При выборе стоит учитывать сложность задачи, требования к качеству ответа, количество запросов, скорость отклика, расход токенов, допустимость ошибок для бизнеса, необходимость длинного контекстного окна и вызова инструментов, а также возможные изменения цен.
Обратите внимание: в этой статье под Flash подразумевается Gemini 3.8 Flash, а под Flash-Lite — Gemini 3.5 Flash-Lite. Не путайте их с более ранней серией Gemini 2.5 Flash. Кроме того, каким бы большим ни был объём вызовов во всём мире, это не означает, что квоты отдельных разработчиков не ограничены. О лимитах вызовов мы поговорим отдельно ниже.
Позиционирование трёх моделей Gemini: Argon, Flash и Flash-Lite
Google предлагает три уровня моделей для задач с разными требованиями к стоимости и возможностям. Таблица составлена по официальным страницам со спецификациями моделей:
| Параметр | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| API ID | gemini-4-argon |
gemini-3.8-flash |
gemini-3.5-flash-lite |
| Официальное позиционирование | Флагманская модель для рассуждений | Баланс эффективности и возможностей | Низкая задержка, низкая стоимость, высокая пропускная способность |
| Контекст | Около 1 млн токенов | 1048576 входных токенов | 1048576 входных токенов |
| Лимит вывода по умолчанию | 65536 токенов (можно расширить с помощью механизма длинного вывода) | 65536 токенов | 65536 токенов |
| Уровни размышления | low / medium / high, по умолчанию medium | low / medium / high, по умолчанию medium | minimal / low / medium / high, по умолчанию minimal |
| Работа с инструментами | Вызов функций, структурированный вывод, Search Grounding, выполнение кода | Вызов функций, структурированный вывод, выполнение кода, поиск по файлам, Search Grounding | Структурированный вывод, вызов функций, кэширование |
| Входные модальности | Текст, изображения, аудио, видео, PDF | Текст, изображения, аудио, видео, PDF | Текст, изображения, аудио, видео, PDF |
| Бесплатный уровень API | Не предоставляется | Ограниченный бесплатный уровень | Ограниченный бесплатный уровень |
Возможности и ограничения трёх моделей Gemini
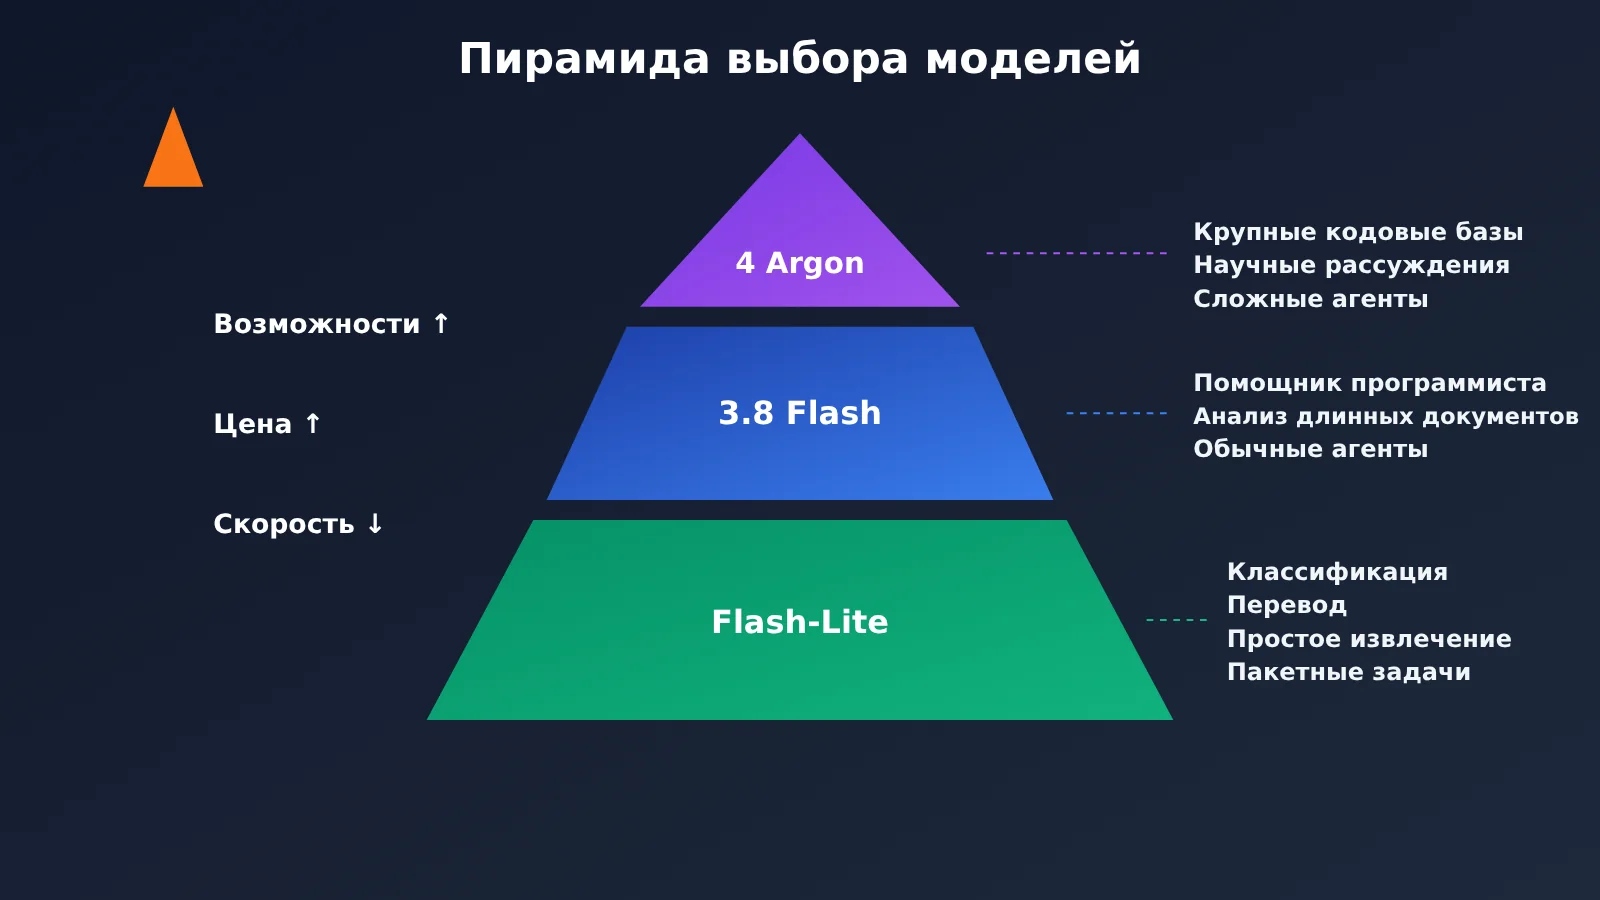
Argon официально вышла 13 октября 2026 года. Модель предназначена прежде всего для сложных задач разработки ПО, математических и научных рассуждений, автономных многошаговых агентов и генерации длинных ответов. Для длинного вывода нужны специальный механизм и настройки выполнения — это не значит, что модель может сразу вернуть 1 млн токенов в каждом запросе.
3.8 Flash умеет рассуждать — это не «дешёвая версия, которая не думает». Она подходит для обычных помощников по программированию, анализа длинных документов, написания текстов и типовых рабочих процессов с агентами. 3.5 Flash-Lite вышла 21 июля 2026 года и оптимизирована для классификации, перевода, простого извлечения данных, разбора документов и несложных подзадач внутри агентов. Она также справляется с некоторыми задачами программирования и рассуждения. От более продвинутых моделей её отличают прежде всего возможности и стабильность при решении сложных задач, а также соотношение стоимости и результата.
Официальные цены Gemini API: разница в стоимости Argon, Flash и Flash-Lite
Ниже приведены официальные цены стандартного платного тарифа Gemini Developer API в долларах за 1 миллион токенов. Наценки сторонних платформ, корпоративные контракты и плата за вызов инструментов не учитываются.
| Модель | Входные токены | Выходные токены | Входные токены при попадании в кэш | Срок действия цены |
|---|---|---|---|---|
| Gemini 4 Argon (текущая цена) | $2.00 | $10.00 | $0.10 | До 30 ноября 2026 года включительно |
| Gemini 4 Argon (после повышения) | $4.00 | $20.00 | $0.20 | С 1 декабря 2026 года |
| Gemini 3.8 Flash (текущая цена) | $0.75 | $3.75 | $0.075 | До 31 декабря 2026 года включительно |
| Gemini 3.8 Flash (после повышения) | $1.50 | $7.50 | $0.15 | С 1 января 2027 года |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | $0.03 | Дата удвоения цены официально не указана |
По текущим ценам входные токены Argon примерно в 2,67 раза дороже, чем у Flash, а входные токены Flash — в 2,5 раза дороже, чем у Flash-Lite. Выходные токены Argon стоят в 4 раза дороже, чем у Flash-Lite. Сейчас на Argon и Flash действуют промо-цены: они заканчиваются 30 ноября и 31 декабря 2026 года соответственно, после чего тарифы удвоятся. При расчёте годового бюджета для долгосрочных проектов нужно учитывать цены после повышения.
Есть ещё одна деталь, которую легко упустить: Google тарифицирует токены внутреннего рассуждения модели как выходные. Итоговый счёт зависит не только от длины ответа, который видит пользователь: высокий уровень рассуждения может заметно увеличить расходы на выходные токены. Если задача не требует ответа в реальном времени, можно использовать Batch API: входные и выходные токены всех трёх моделей обойдутся на 50% дешевле стандартного тарифа. Однако режим выполнения и ограничения очереди отличаются от запросов в реальном времени.
Независимые тесты и сравнение скорости трёх моделей Gemini
Данные взяты с независимой платформы Artificial Analysis. Все оценки рассчитаны по единой системе Intelligence Index v5.0 — результаты старой версии v4.x здесь не используются:
| Показатель | Gemini 4 Argon(High) | Gemini 3.8 Flash(High) | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| Общий индекс возможностей v5.0 | 50 | 31 | 12 |
| AutomationBench-AA | 78% | 60% | 25% |
| Terminal-Bench 4.0 | 57% | 20% | 1% |
| FrontierCode 2.0 | 26% | 19% | 6% |
| Наблюдаемая скорость вывода | Более 80 токенов/с | Около 120–140 токенов/с | Более 400 токенов/с |
| Где доступны | Официальный API Google, APIYI apiyi.com | Официальный API Google, APIYI | Официальный API Google, APIYI |
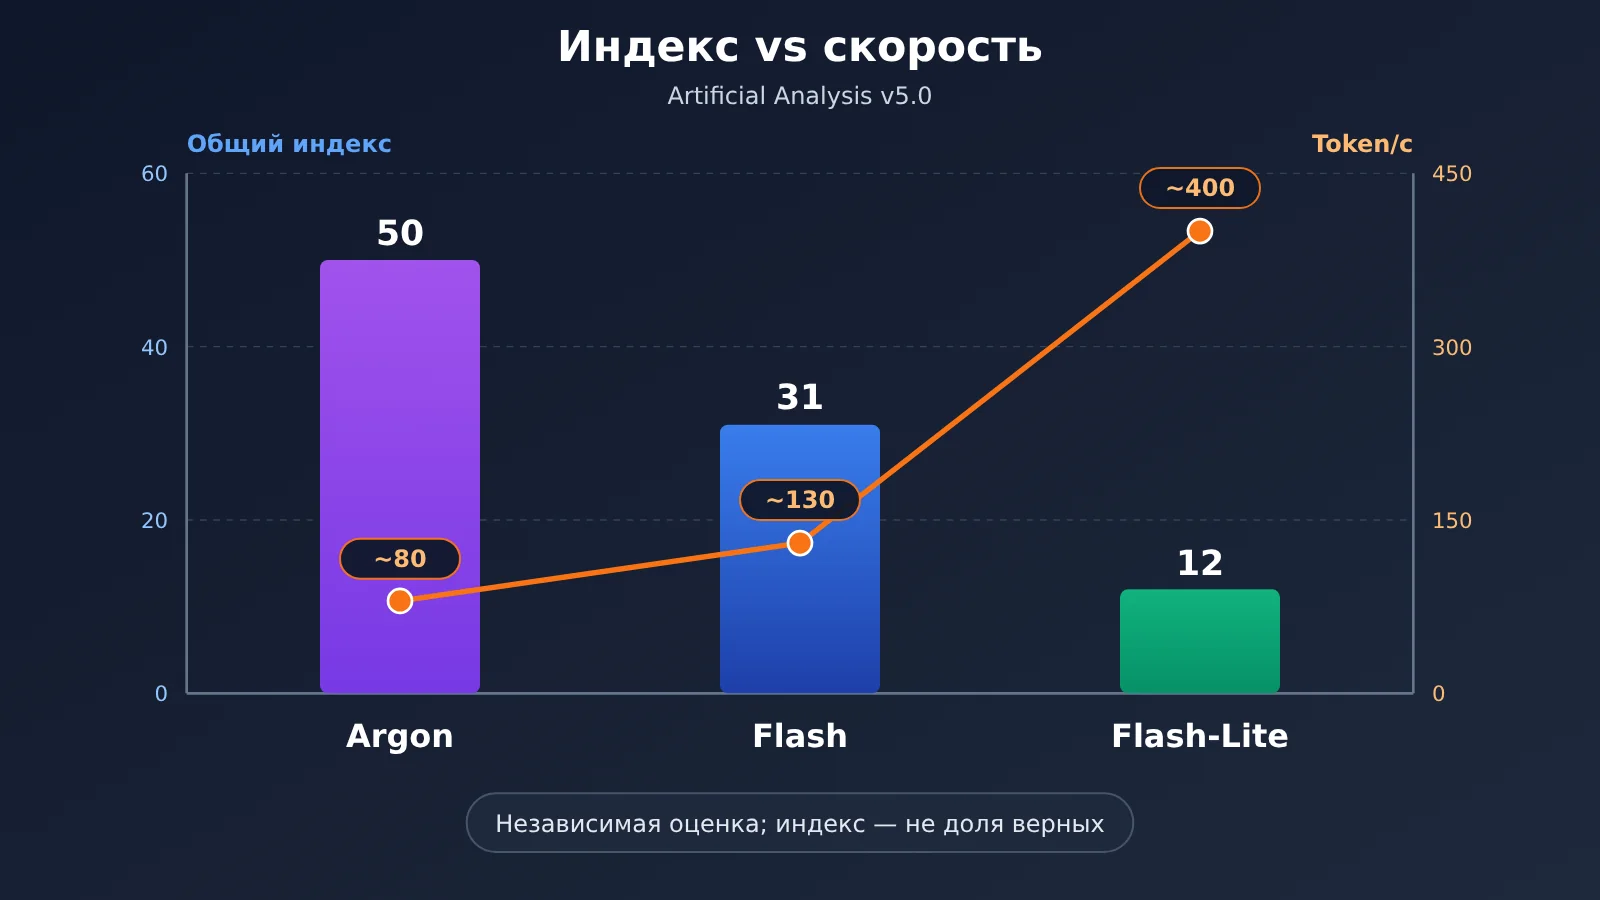
Чтобы правильно понять эти данные, стоит учесть три момента:
- Индекс — не доля правильных ответов: 50, 31 и 12 — это баллы внутри системы оценки, а не процент правильных ответов.
- На сложных задачах разница заметна: в тестах на сложное программирование и автоматизацию лидирует Argon, за ней идёт Flash, а Flash-Lite показывает более скромные результаты. Но это не значит, что Argon лучше справится с любой простой бизнес-задачей: для классификации или форматирования текста возможностей всех трёх моделей может быть достаточно.
- Скорость нельзя напрямую пересчитать во время выполнения: скорость вывода зависит от состояния сервиса, а на общее время также влияют время на размышление, задержка первого токена, вызовы инструментов, очередь и состояние сети.
💡 О сравнении: результаты тестов показывают лишь примерную разницу в возможностях моделей. Окончательный ориентир — их результаты на ваших задачах. Через APIYI apiyi.com можно переключаться между тремя моделями Gemini с одним API-ключом и сравнить их на собственных данных.
Расчёт стоимости Gemini API: насколько отличаются счета за Argon, Flash и Flash-Lite
Ниже приведён теоретический пример, а не реальный счёт. Предположим, что выходные токены включают все токены, потраченные на рассуждения, а затраты на кеширование, поисковые инструменты и повторные попытки не учитываются. Расчёт выполнен по стандартным тарифам на октябрь 2026 года:
| Сценарий | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| A: 1000 запросов в день, каждый — 5000 входных / 1000 выходных токенов (стоимость в день) | $20.00 | $7.50 | $4.00 |
| A: то же в течение 30 дней | около $600 | около $225 | около $120 |
| B: классификация 100 000 записей, каждая — 1000 входных / 200 выходных токенов | $400 | $150 | $80 |
| B с использованием Batch API (цена за токен вдвое ниже) | около $200 | около $75 | около $40 |
Сценарий B показывает только разницу в цене при одинаковом расходе токенов. На практике модели тратят разное количество токенов на рассуждения, выдают ответы разной длины и требуют разного числа повторных попыток. Нельзя просто считать, что Flash-Lite за $80 обеспечит то же качество, что и Argon за $400. Кроме того, после окончания промоакции для Argon и Flash суммы в этих двух столбцах удвоятся.
Анализ влияния: почему при оценке Gemini API нельзя смотреть только на цену токенов
Что это значит для разработчиков
У «цены» модели есть как минимум три уровня. Первый — цена за токен. Второй — фактический расход токенов на задачу, включая ввод, вывод, рассуждения, повторную передачу контекста и повторные попытки. Третий — полная стоимость выполнения задачи с приемлемым результатом. Здесь также нужно учитывать долю успешных попыток, ручную проверку, повторные попытки после ошибок, время выполнения и возможные потери для бизнеса из-за ошибок.
Если Flash-Lite уже соответствует требованиям бизнеса при простой классификации, переход на Argon будет пустой тратой денег. И наоборот: если Flash-Lite раз за разом не справляется со сложной задачей программирования, а Argon решает её за меньшее число попыток, то в целом Argon может оказаться выгоднее. Это условный пример принципа выбора модели, а не статистический вывод о доле успешных попыток трёх моделей.
Отзывы сообщества тоже обращают внимание на эту проблему. Один пользователь Reddit применял Argon High для реверс-инжиниринга в среде OpenCode: за один запуск было потрачено около 900 тысяч токенов, но задача так и не была выполнена. Это личный опыт, и его нельзя считать средним показателем по отрасли. Тем не менее он напоминает: сложные агентные сценарии могут расходовать огромное количество токенов без гарантии успеха. Другой пользователь сообщил, что при использовании Argon в потребительской подписке быстро достигает лимита. Однако этот опыт относится к подписке Gemini и не означает, что те же лимиты действуют в Developer API.
Что это значит для отрасли
- Многоуровневая архитектура с несколькими моделями становится стандартом: Google Cloud уже рассказал об оркестрации нескольких моделей и Smart Routing — распределение задач между моделями помогает компаниям снижать расходы.
- Фокус оценки смещается с «цены за единицу» на «стоимость задачи с приемлемым результатом»: чем больше объём вызовов, тем важнее выбирать модель на основе тестового набора бизнес-задач, а не ориентироваться на рейтинги.
- Период бюджетного планирования сокращается: сроки действия промоцен постепенно истекают, поэтому командам нужно каждый квартал пересматривать набор моделей и бюджет.
Как разработчику выбрать между Argon, Flash и Flash-Lite
Универсально лучшей модели нет — выбор зависит от задачи и результатов тестирования:
- Массовая классификация данных (например, распределение 100 тысяч новостей об ИИ по категориям «релизы», «обновления», «цены», «политика»): начните с Flash-Lite. Если точность и соблюдение формата на тестовой выборке не соответствуют требованиям, переходите на 3.8 Flash.
- Структурирование длинных документов (преобразование финансовых отчётов и технической документации в таблицы фактов): начните с 3.8 Flash. Она лучше понимает содержание, чем Lite, и стоит дешевле Argon. Для поиска противоречий между документами и сложных рассуждений подключайте Argon.
- Сложные проекты по разработке (изучение больших кодовых баз, многоэтапный рефакторинг): начните с Argon. По официальному позиционированию и независимым тестам программирования она сильнее, но успешность, выполнение действий с инструментами и затраты всё равно нужно проверить на реальном проекте.
- Массовый простой перевод: начните с Flash-Lite. Для узкоспециализированных текстов, например юридических или медицинских, обязательно нужна дополнительная проверка качества. Низкая цена — не повод использовать перевод без проверки человеком.
- Корпоративные агенты: не стоит ограничиваться одной моделью. Flash-Lite можно поручить классификацию, извлечение данных и стандартизацию формата, 3.8 Flash — обычное планирование и многоэтапные рабочие процессы, а Argon — сложные рассуждения и поиск причин проблем. Это рекомендуемый инженерный подход, а не обязательное требование Google.
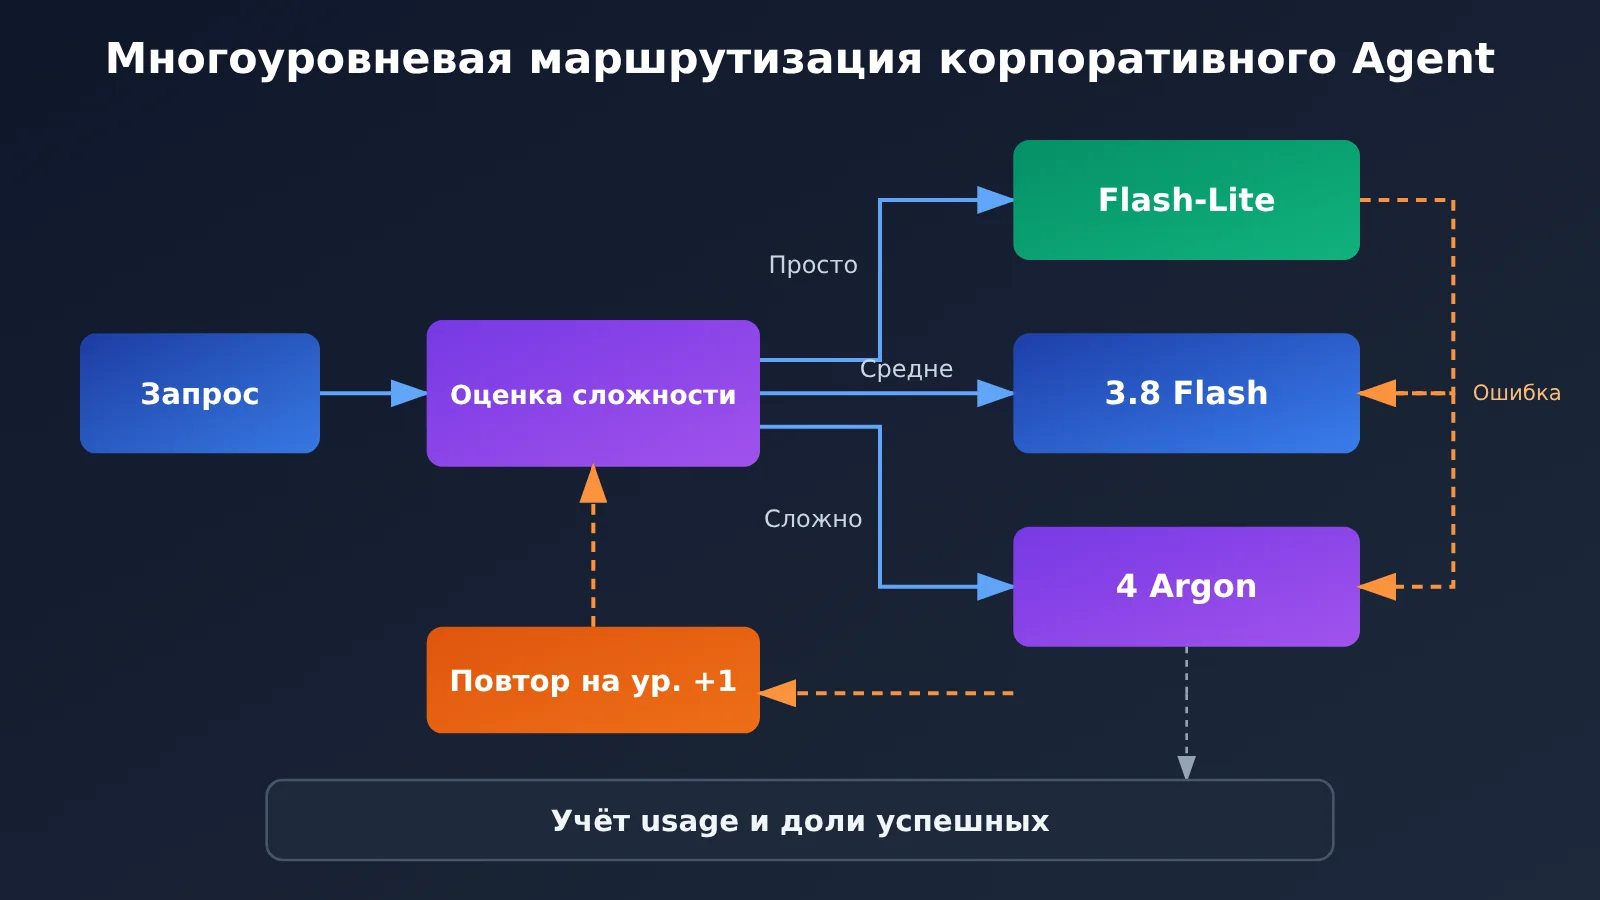
🎯 Рекомендация: главное в многоуровневой маршрутизации — возможность без лишних затрат переключаться между тремя моделями. APIYI apiyi.com предоставляет OpenAI-совместимый интерфейс: чтобы сменить модель, достаточно изменить параметр
model. Это удобно для небольших сравнительных тестов.
Быстрый старт: вызов трёх моделей Gemini через API
Минимальный пример
Для вызова можно использовать OpenAI SDK. Чтобы переключиться между Argon, Flash и Flash-Lite, достаточно изменить model:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",
    messages=[{"role": "user", "content": "把这条新闻分类为:模型发布/产品更新/价格变化/行业政策"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # 以实际计费 Token 为准,而非可见字数
Полный код маршрутизации по уровням и оценки стоимости
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Google 官方标准价(美元/100万Token,2026年10月),仅用于估算
PRICE = {
    "gemini-3.5-flash-lite": (0.30, 2.50),
    "gemini-3.8-flash": (0.75, 3.75),    # 2027-01-01 起翻倍
    "gemini-4-argon": (2.00, 10.00),     # 2026-12-01 起翻倍
}
TIERS = ["gemini-3.5-flash-lite", "gemini-3.8-flash", "gemini-4-argon"]

def estimate_cost(model: str, usage) -> float:
    pin, pout = PRICE[model]
    # completion_tokens 应包含思考 Token,具体以返回字段为准
    return usage.prompt_tokens / 1e6 * pin + usage.completion_tokens / 1e6 * pout

def run(prompt: str, start_tier: int = 0, validator=None):
    """从低档模型开始,不合格则升级一档,记录每次成本"""
    total = 0.0
    for model in TIERS[start_tier:]:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        text = resp.choices[0].message.content
        cost = estimate_cost(model, resp.usage)
        total += cost
        print(f"{model}: tokens={resp.usage.total_tokens}, cost≈${cost:.5f}")
        if validator is None or validator(text):
            return {"model": model, "output": text, "total_cost": total}
    return {"model": None, "output": None, "total_cost": total}

result = run(
    "从以下文本抽取公司名和金额,输出JSON:...",
    validator=lambda t: t.strip().startswith("{"),
)
print(result)
🚀 Быстрый старт: рекомендуем сначала получить бесплатный тестовый лимит для новых пользователей на APIYI apiyi.com и сравнить модели всех трёх уровней на 100–300 типичных примерах. Затем выберите уровень по умолчанию для рабочего окружения. Учтите, что цены, лимиты и поддержка кэширования на сторонних платформах могут отличаться от условий прямого доступа к Google. Ориентируйтесь на действующие правила платформы.
Что учесть перед запуском Gemini API
- Ограничения запросов: Gemini API ограничивает число запросов в минуту (RPM), токенов в минуту (TPM) и запросов в день (RPD). Лимиты действуют на уровне проекта, а не отдельного ключа. Превышение любого из них вызовет ошибку.
- Токены размышления: стоимость вывода включает токены размышления. Проверяйте метаданные использования и не оценивайте стоимость по длине видимого ответа.
- Кэширование: Argon поддерживает только неявное кэширование, но не явное. Flash и Flash-Lite поддерживают кэширование, а его стоимость зависит от конфигурации.
- Данные на бесплатном уровне: они могут использоваться для улучшения продукта. Не отправляйте конфиденциальные корпоративные данные через бесплатный уровень и перед запуском проверьте условия предоставления сервиса.
- Метрики тестирования: фиксируйте долю успешных запросов, фактическую точность, соответствие структуре, число галлюцинаций, среднюю и хвостовую задержку, фактическое число токенов, количество повторных попыток и стоимость успешно выполненной задачи. Уровни размышления по умолчанию различаются, поэтому указывайте в отчёте фактически использованную конфигурацию.
Частые вопросы о выборе модели Gemini API
Q1: Что представляют собой Gemini 4 Argon, 3.8 Flash и 3.5 Flash-Lite?
Это три основные модели Gemini API от Google для разных задач: Argon — флагманская модель для рассуждений, 3.8 Flash сочетает производительность и эффективность, а 3.5 Flash-Lite отличается низкой задержкой, невысокой стоимостью и высокой пропускной способностью. Все три поддерживают входной контекст примерно на миллион токенов и выдают текст.
Q2: Когда заканчиваются льготные цены на Argon и Flash?
Текущие цены на Argon действуют до 30 ноября 2026 года. С 1 декабря цены на входные и выходные токены, а также на кэширование удвоятся. Для 3.8 Flash текущие цены действуют до 31 декабря 2026 года, а с 1 января 2027 года удвоятся. Для Flash-Lite Google пока не объявляла подобной даты.
Q3: Означают ли 50 баллов в Artificial Analysis, что модель правильно отвечает в 50% случаев?
Нет. Значения 50, 31 и 12 — это сводные оценки Intelligence Index v5.0, а не процент правильных ответов. Они помогают примерно сравнить уровни моделей, но их нельзя напрямую пересчитать в показатель успешности для ваших задач.
Q4: Как с небольшими затратами сравнить три модели Gemini?
Рекомендуем использовать OpenAI-совместимый интерфейс с поддержкой нескольких моделей. Зарегистрируйтесь на APIYI apiyi.com, получите API-ключ и бесплатный лимит, а затем поочерёдно подставьте три API ID в поле `model` из примера в статье. Запускайте модели на одном и том же наборе данных и записывайте расход токенов и долю ответов, соответствующих вашим требованиям.
Q5: На Reddit пишут, что лимит Argon исчерпывается за несколько запросов. С API будет так же?
Этот отзыв относится к подписке на потребительский продукт Gemini и не описывает лимиты Developer API. Квоты API зависят от платёжного уровня, статуса проекта и модели и рассчитываются по показателям RPM/TPM/RPD. При вызове через платформу-агрегатор также нужно учитывать её собственные правила предоставления лимитов. Доступные модели и условия оплаты можно посмотреть в консоли APIYI apiyi.com.
Q6: Какие известные недостатки есть у этих моделей?
У Argon самая высокая цена и самая низкая скорость; обычного бесплатного уровня для неё нет, а сложные задачи для ИИ-агентов могут потреблять много токенов. 3.8 Flash заметно уступает Argon в самых сложных тестах на работу с терминалом и программирование. Flash-Lite слабее справляется со сложными задачами программирования и автоматизации, а переводы узкоспециализированных текстов требуют проверки человеком.
Выбор Gemini API: главное
- Контекст: API собственных моделей Google обрабатывают почти 32 млрд токенов в минуту. Это общий показатель роста, а не результат одной модели.
- Три уровня моделей: Argon решает сложные задачи на рассуждение, 3.8 Flash — сбалансированный вариант для основных задач, а Flash-Lite подходит для лёгких задач с высокой нагрузкой.
- Разница в цене: текущий тариф на входящие токены — $2 / $0,75 / $0,30 соответственно. После окончания акции цены на Argon и Flash удвоятся.
- Как читать результаты тестов: показатели AA v5.0 — 50 / 31 / 12. Это значения индекса, а не процент правильных ответов; на простых задачах разница может быть незаметна.
- Скрытые расходы: токены рассуждений учитываются как выходные. Кэширование, повторные попытки и использование инструментов тоже влияют на итоговый счёт.
- С чего начать: в APIYI apiyi.com можно переключаться между тремя моделями с одним API-ключом и сравнить их на 100–300 примерах.
Итоги
Резкий рост числа вызовов Gemini API показывает, что большие языковые модели уже используются в производственных системах в крупном масштабе. Но главный вопрос при выборе модели остаётся прежним:
- Подбирайте модель под задачу: для классификации и перевода сначала попробуйте Flash-Lite, для структурирования документов — 3.8 Flash, для сложного кода и продвинутых агентов — Argon.
- Считайте стоимость успешно выполненной задачи: оптимизировать нужно общую стоимость каждой задачи с приемлемым результатом, а не искать самую низкую цену за миллион токенов.
- Следите за сроками акции: для Argon она заканчивается 30 ноября, для Flash — 31 декабря. Рассчитывайте бюджет с учётом будущих цен.
Разработчикам нужны не обязательно самые мощные или самые дешёвые модели, а сочетание моделей, которое стабильно решает бизнес-задачи по приемлемой цене. Для начала можно сравнить все три модели на бесплатном лимите через APIYI apiyi.com, а затем определить стратегию маршрутизации запросов в производственной среде.
📚 Источники
- Обращение CEO в отчёте Alphabet за III квартал 2026 года: источник данных о 32 млрд токенов в минуту
- Ссылка:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
Описание: контекст новости и первоначальная публикация данных о росте использования API
-
Официальные цены Gemini API: стандартные цены, цены на кэширование и Batch для трёх моделей
- Ссылка:
ai.google.dev/gemini-api/docs/pricing -
Описание: сроки действия акционных цен и правила тарификации токенов рассуждения
-
Документация по моделям Gemini: Argon / 3.8 Flash / 3.5 Flash-Lite
- Ссылка:
ai.google.dev/gemini-api/docs/models/gemini-4-argon -
Описание: контекстное окно, лимит вывода, уровни рассуждения и возможности работы с инструментами
-
Сравнение моделей Artificial Analysis: независимые сторонние тесты v5.0
- Ссылка:
artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-3-8-flash -
Описание: сводный индекс, специализированные бенчмарки и результаты измерения скорости
-
Лимиты вызовов Gemini API и механизм рассуждения: RPM/TPM/RPD и настройки рассуждения
- Ссылка:
ai.google.dev/gemini-api/docs/rate-limits -
Описание: квоты и правила для токенов рассуждения, с которыми стоит ознакомиться перед запуском
-
Оркестрация нескольких моделей в Google Cloud: Smart Routing и управление расходами на агентов
- Ссылка:
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - Описание: официальный подход к многоуровневой маршрутизации для компаний
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com