Примечание автора: разбираем три момента, когда запускается автоматическое сжатие контекста агента, стратегии сохранения информации в сводке и рабочий код. Это поможет контролировать расход токенов в длинных диалогах, не теряя важных сведений о задаче.
После нескольких часов непрерывной работы с кодинг-агентом вроде Codex многие разработчики задаются одним вопросом: рядом с полем ввода видны только режим разрешений и текущая модель, а сколько контекста уже использовано — непонятно. Так когда же пора открывать новое окно? Чем длиннее диалог, тем больше истории приходится передавать с каждым запросом и тем быстрее расходуется лимит. В этой статье мы разберём моменты запуска автоматического сжатия контекста агента (Context Compaction) и стратегии создания сводки. Это поможет понять, как устроены инструменты вроде Codex, и реализовать такую же функцию в собственном агенте.
Это не очередной общий совет «не забывайте очищать историю чата», а практическое решение на основе механизмов сжатия, описанных в официальной документации OpenAI и Anthropic, и опыта разработки.
Что вы получите: узнаете, когда запускается автоматическое сжатие контекста агента, что стоит сохранить в сводке, а что можно отбросить, а также получите реализацию на Python, которую можно адаптировать под свои задачи.
Главное об автоматическом сжатии контекста агента
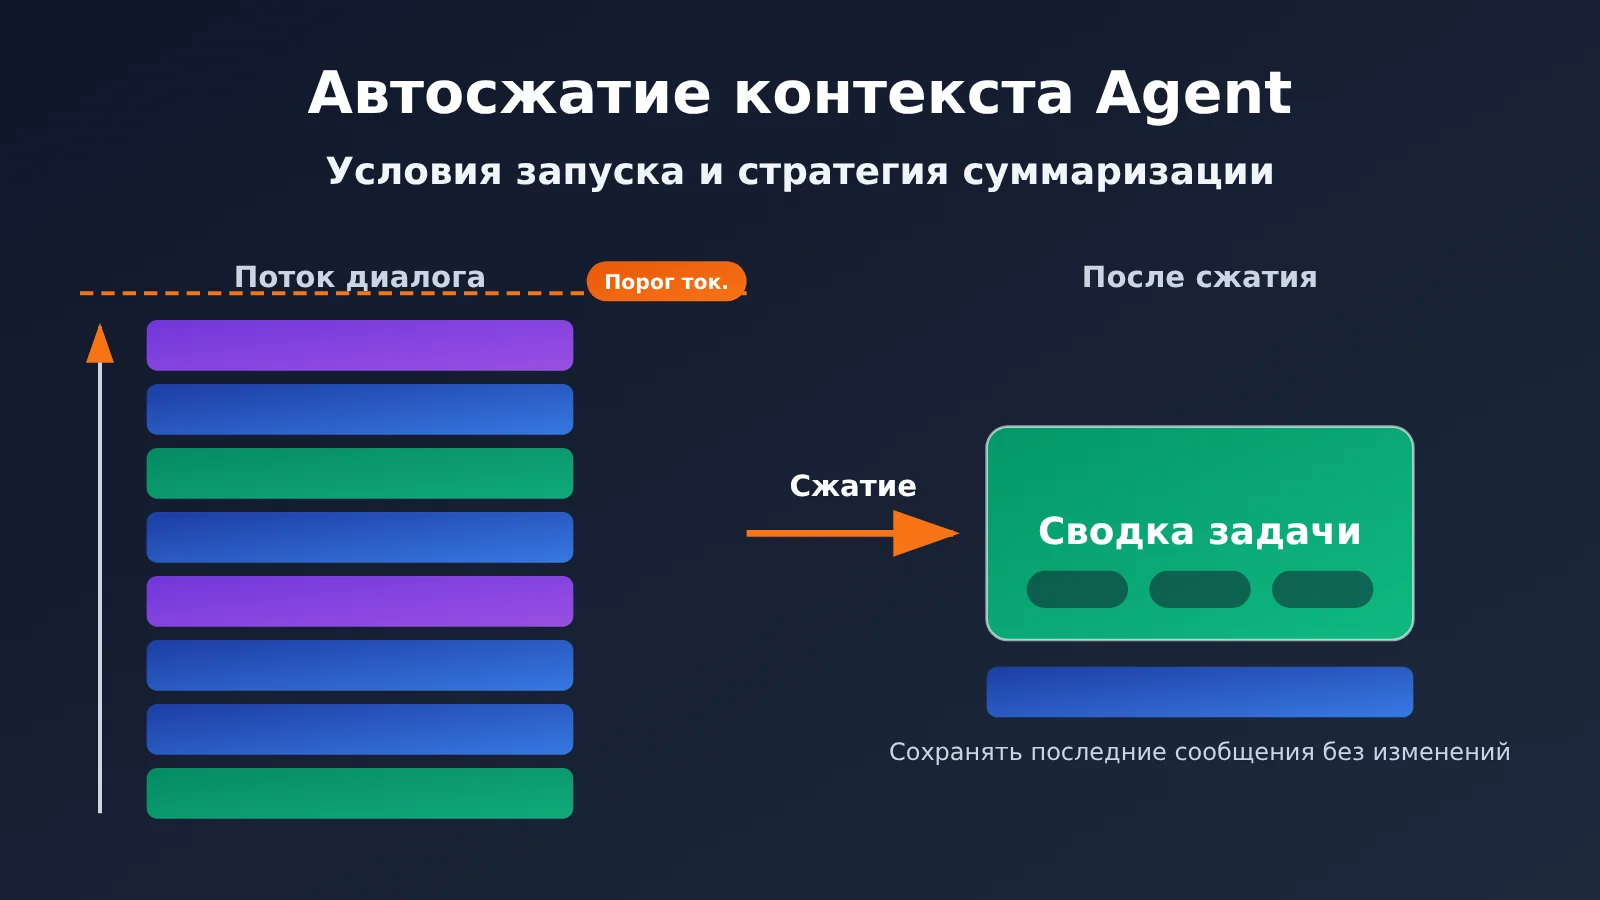
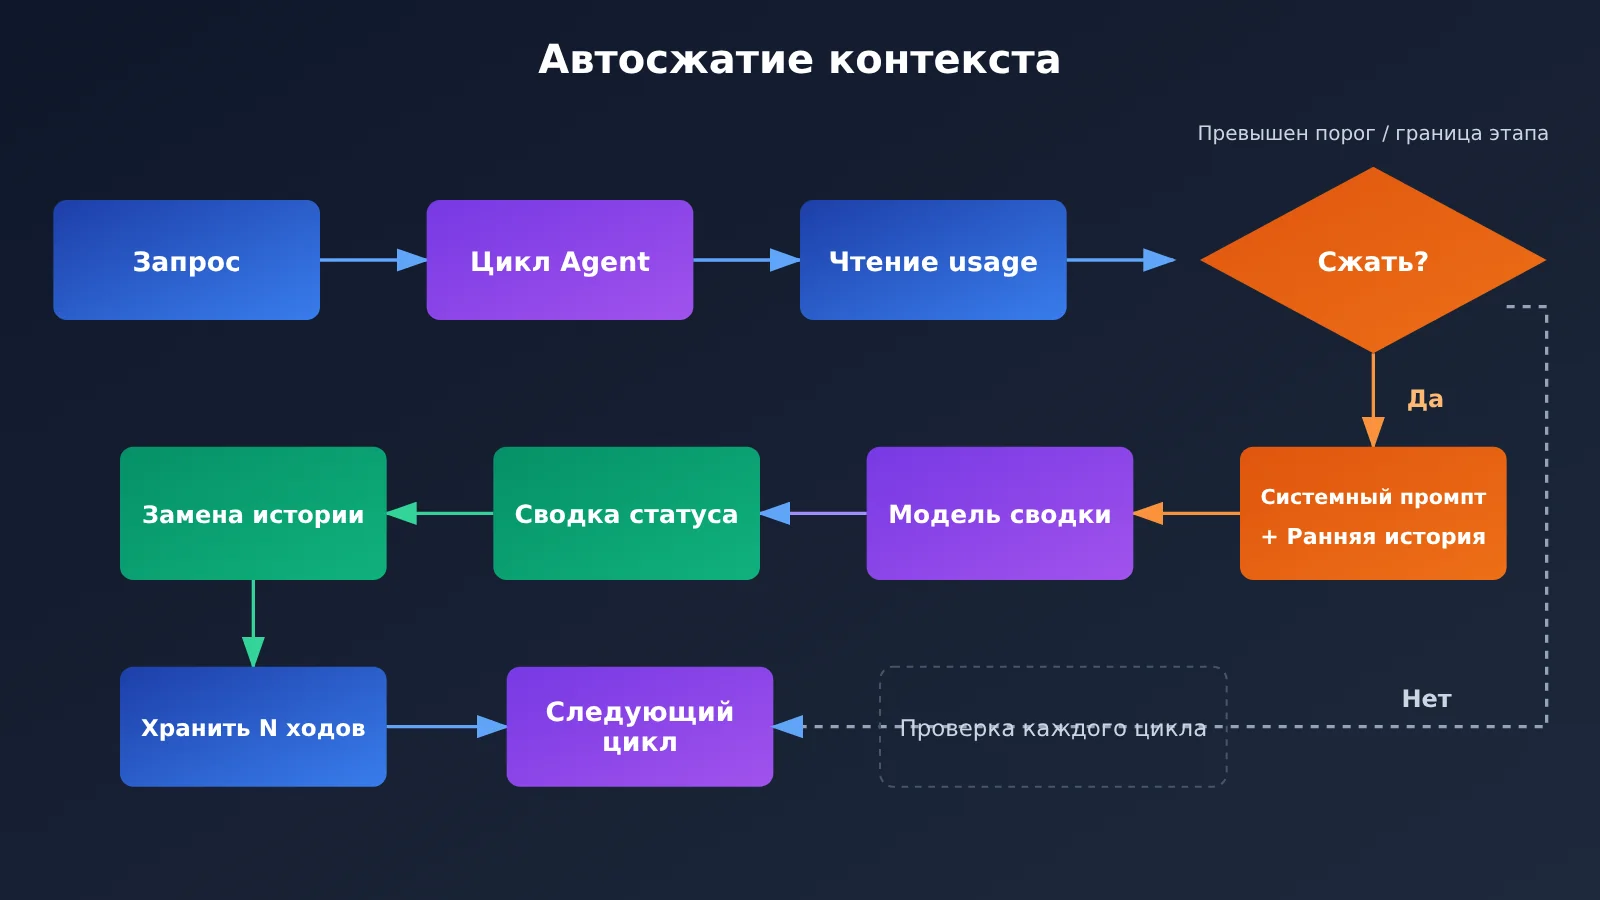
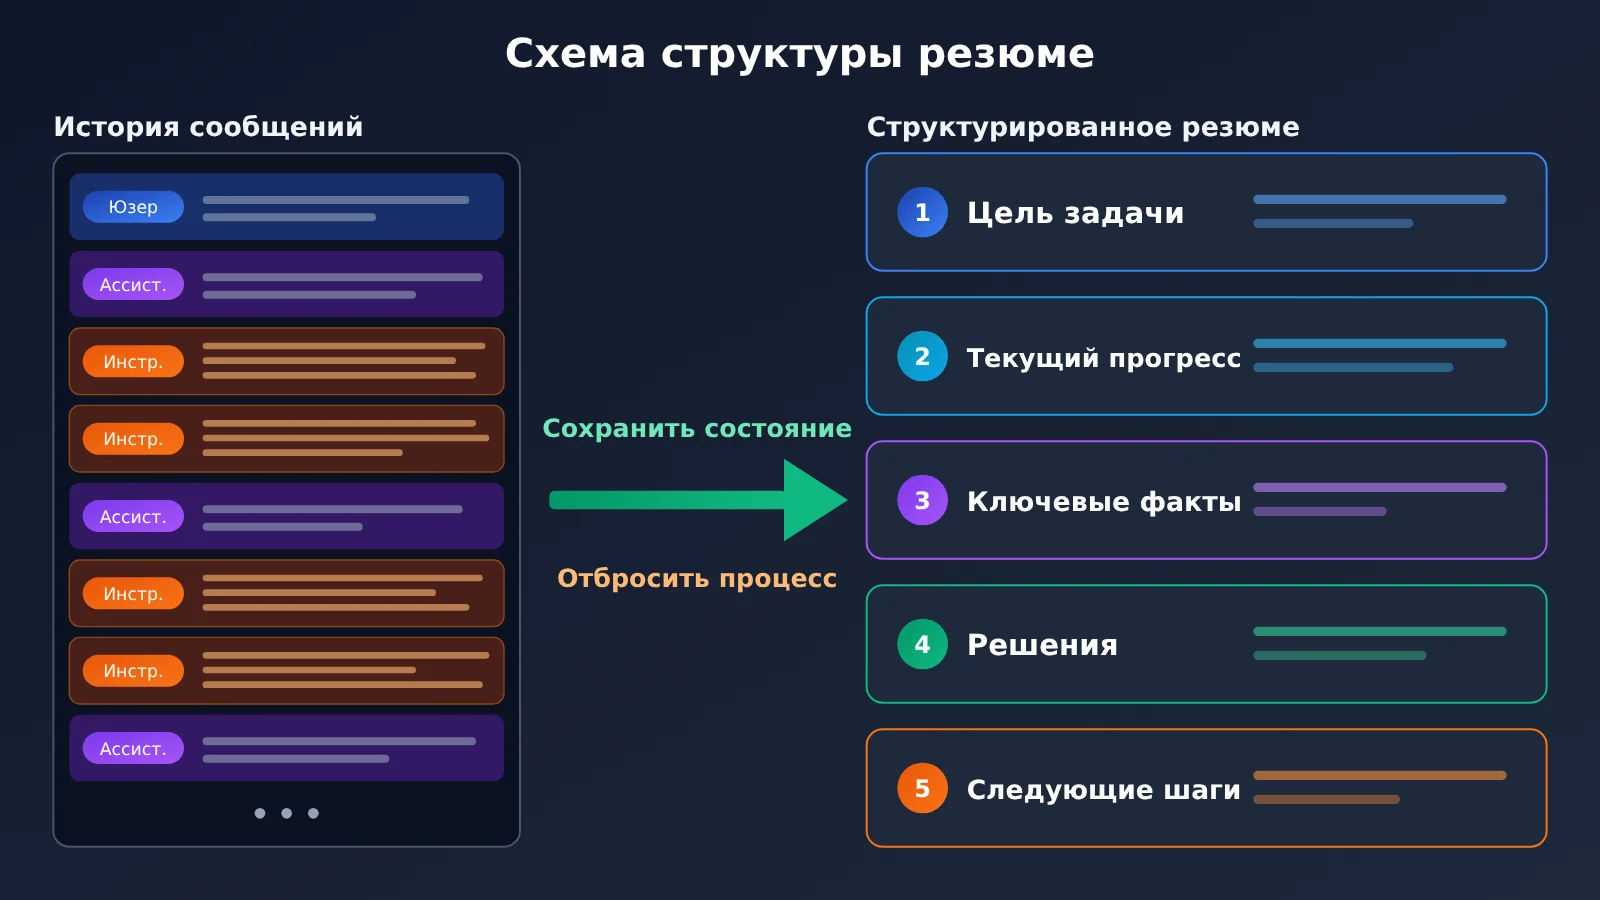
Коротко: автоматическое сжатие обычно срабатывает, когда контекст достигает заданного порога токенов. Ранние диалоги и записи вызовов инструментов сводятся к описанию состояния, с которым агент может продолжить работу. Цель не просто сократить историю, а сохранить прогресс, важные факты, выполненные действия, ключевые решения и следующие шаги, убрав лишние подробности процесса.
| Принцип | Как работает | Польза |
|---|---|---|
| Срабатывание по порогу токенов | Контекст автоматически сжимается при достижении заданного числа токенов | Не требует ручного вмешательства и помогает не переполнить окно |
| Инициативное сжатие | Приложение запускает сжатие в определённый момент, например после завершения этапа задачи | Сжатие происходит на смысловой границе, что сводит потери информации к минимуму |
| Автоматическое управление фреймворком | SDK или среда выполнения агента принимает решение в зависимости от заполненности контекста | Работает из коробки и подходит для быстрого запуска |
| Сводка вместо усечения | Сохраняются прогресс, факты, решения и следующие шаги | После сжатия агент может продолжить работу |
| Сжатие по этапам | Не рекомендуется сжимать контекст после каждого шага | Помогает сохранить баланс между использованием кеша и полнотой информации |
Зачем агенту автоматическое сжатие контекста
API большой языковой модели сам по себе не хранит состояние. «Многоходовый диалог» означает, что на каждом шаге модели заново отправляется полная история сообщений. Поэтому 50-й запрос содержит всё, что произошло за предыдущие 49 шагов, а число входных токенов растёт линейно или даже быстрее. Для агента ситуация ещё сложнее: результаты вызовов инструментов — содержимое файлов, вывод терминала, результаты поиска — часто бывают очень длинными. Всего несколько таких вызовов могут занять большую часть контекстного окна.
Это создаёт две проблемы. Во-первых, растут расходы: чем больше входных токенов в каждом запросе, тем быстрее расходуется лимит. Во-вторых, страдает качество: в слишком длинном контексте модели сложнее учитывать важную информацию из начала истории, а при превышении размера окна запрос и вовсе завершится ошибкой. Автоматическое сжатие помогает найти баланс: пока информация ещё полна, а окно не заполнено, история «сворачивается» в краткую сводку состояния, чтобы последующие запросы стали легче.
Почему Codex не показывает использование контекста
Мы не видели официального объяснения того, почему клиент больше не показывает размер контекстного окна, поэтому не будем строить догадки. Известно, что в Codex встроен механизм сжатия контекста: в длинном диалоге исходная история не накапливается бесконечно. Если нужно точно отслеживать расход на каждом шаге, надёжнее всего смотреть логи вызовов на уровне API. Далее мы расскажем, как это сделать.
3 момента для автоматического сжатия контекста агента
Многие считают, что контекст нужно сжимать, когда он заполнен на 80%, но это не официальное правило. В документации API условия срабатывания обычно задаются пороговым количеством токенов, а не фиксированным процентом окна. Кроме того, ждать приближения к лимиту необязательно: и OpenAI, и Anthropic поддерживают сжатие по инициативе приложения.
Сравнение официальных правил срабатывания
| Реализация | Правило автоматического срабатывания | Официальное описание |
|---|---|---|
| OpenAI Responses API | Число токенов после формирования контекста достигает compact_threshold |
Порог можно настроить; сжатие автоматически выполняется на сервере |
| OpenAI Agents SDK | При высокой нагрузке на контекст или по явно заданному порогу | Поддерживает автоматическое сжатие, сжатие по фиксированному порогу и принудительное сжатие |
| Anthropic Messages API | Число входных токенов достигает trigger.value |
По умолчанию 150 000, минимум 50 000 |
| Anthropic Tool Runner | Достигнут context_token_threshold |
По умолчанию 100 000 |
| Сжатие Anthropic по запросу | Приложение инициирует сжатие | Можно вызвать после завершения полного раунда диалога |
Из таблицы видно общее правило: автоматическое сжатие почти всегда срабатывает по количеству входных токенов, а порог можно настроить. При этом приложение также может само решать, когда запустить сжатие.
Момент первый: достижение порога токенов
Это базовый механизм подстраховки. После каждого вызова считывайте количество входных токенов из ответа API и запускайте сжатие, если оно превышает заданный порог. Не стоит устанавливать порог вплотную к лимиту окна: для сжатия старую историю нужно ещё раз отправить модели, которая составит сводку, а для вывода инструментов в следующем раунде тоже понадобится запас места.
На практике можно ориентироваться на значения Anthropic по умолчанию: для моделей с большим контекстным окном установить порог на уровне порядка ста тысяч токенов и убедиться, что после его достижения останется достаточно места для полного результата вызова инструмента.
Момент второй: сжатие на границе этапа задачи
Такой подход позволяет свести потерю информации к минимуму. OpenAI рекомендует сжимать контекст после завершения значимого этапа работы, а не после каждого раунда. Например, агент только что прошёл весь цикл: «найти баг → изменить код → успешно запустить тесты». Промежуточные попытки уже не представляют ценности — достаточно запомнить, какой файл изменён, почему и что тесты прошли.
На границе этапа проще составить точную сводку: задача находится в «чистом» состоянии, без незавершённых вызовов инструментов.
Момент третий: управление контекстом средствами фреймворка
Если вы используете фреймворк вроде Agents SDK или Tool Runner, можно просто включить встроенную стратегию сжатия. Среда выполнения сама решит, когда его запускать, исходя из нагрузки на контекст. Это удобно, но даёт меньше контроля над содержанием сводки, поэтому такой подход подходит для прототипов и типовых сценариев.
🎯 Техническая рекомендация: три варианта не исключают друг друга. Рекомендуем в основном сжимать контекст на границах этапов, а порог токенов использовать для подстраховки. Если хотите проверить настройки порога на разных моделях, через APIYI apiyi.com можно переключаться между OpenAI, Claude, Gemini и другими моделями с одним ключом и сравнивать результаты.
Стратегия суммаризации при автоматическом сжатии контекста агента
Порог срабатывания определяет, когда сжимать контекст, а стратегия суммаризации — что должно остаться после сжатия. Чаще всего ошибка проявляется так: агент забывает исходные ограничения пользователя или повторно выполняет уже сделанные действия. Причина в том, что резюме фиксирует лишь «о чём говорили», но не «в каком состоянии находится задача».
Что сохранять в резюме, а что можно отбросить
| Категория | Сохранить | Можно отбросить |
|---|---|---|
| Цель задачи | Исходный запрос пользователя, жёсткие ограничения, критерии приёмки | Приветствия, повторные подтверждения |
| Ход работы | Выполненные шаги, текущий этап | Подробный ход рассуждений на каждом шаге |
| Важные факты | Пути к файлам, имена функций, значения конфигурации, ключевые строки ошибок | Полное содержимое файлов, длинные логи |
| Ключевые решения | Какой вариант выбран и почему | Подробное обсуждение отклонённых вариантов |
| Следующие действия | Список задач, нерешённые вопросы | Детали завершённой работы, которые больше ни на что не влияют |
Стратегия суммаризации за 5 шагов
- Всегда сохраняйте системный промпт: он не участвует в сжатии и остаётся в самом начале массива messages.
- Сохраняйте последние N раундов диалога без изменений: они обычно тесно связаны с текущими действиями, поэтому сжимайте только более раннюю часть.
- Используйте структурированный шаблон резюме: попросите модель выводить результат по пяти разделам — «цель / прогресс / факты / решения / следующие шаги». Это поможет избежать пропусков из-за свободного пересказа.
- Сначала сокращайте результаты инструментов: из слишком длинных ответов оставляйте только ключевые фрагменты, например первые и последние строки ошибки, заголовки и выводы из результатов поиска.
- Отдельно сохраняйте слова пользователя: явные ограничения, например «не изменяйте публичный интерфейс», лучше сохранять дословно, не поручая модели их перефразировать.
Структурированный шаблон — самый важный шаг. При свободной суммаризации модель склонна передавать общий характер беседы, а структурированные разделы заставляют её проверить каждый пункт и сохранить информацию о состоянии задачи, необходимую для дальнейшей работы.
Автоматическое сжатие контекста агента: быстрый старт
Реализуем универсальный вариант с ручным управлением messages на стороне клиента. Он подойдёт для любого OpenAI-совместимого интерфейса. Идея проста: после каждого вызова считываем число входных токенов из usage.prompt_tokens. Если порог превышен, передаём раннюю историю модели, которая сожмёт её в краткое резюме.
Минимальный пример
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "system", "content": "你是一个编码助手。"}]
messages.append({"role": "user", "content": "帮我检查这个函数的边界条件"})

resp = client.chat.completions.create(model="gpt-4o-mini", messages=messages)
messages.append({"role": "assistant", "content": resp.choices[0].message.content})

# 每轮记录输入 Token,作为是否压缩的判断依据
print("本轮输入 Token:", resp.usage.prompt_tokens)
Посмотреть полный код автоматического сжатия контекста агента
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MAIN_MODEL = "gpt-4o-mini"      # 主任务模型,可按需替换
SUMMARY_MODEL = "gpt-4o-mini"   # 摘要模型,可用更便宜的模型
TOKEN_THRESHOLD = 100_000       # 输入 Token 阈值,兜底触发
KEEP_RECENT = 6                 # 保留最近 N 条消息原文

SUMMARY_PROMPT = """请把以下 Agent 对话历史压缩为任务状态摘要,严格按五个栏目输出:
【任务目标】用户原始需求与硬性约束(约束请逐字保留)
【当前进度】已完成的步骤与当前阶段
【关键事实】文件路径、函数名、配置值、关键报错
【已做决策】采用的方案及原因
【下一步行动】待办事项与未解决问题
不要记录寒暄和推理过程,不要编造历史中没有的信息。"""


def compact(messages: list) -> list:
    """把早期历史压缩为一条摘要消息,保留系统提示与最近对话。"""
    system_msg = messages[0]
    old = messages[1:-KEEP_RECENT]
    recent = messages[-KEEP_RECENT:]
    if not old:
        return messages

    history_text = "\n".join(f"[{m['role']}] {m['content']}" for m in old)
    resp = client.chat.completions.create(
        model=SUMMARY_MODEL,
        messages=[
            {"role": "system", "content": SUMMARY_PROMPT},
            {"role": "user", "content": history_text},
        ],
    )
    summary = resp.choices[0].message.content
    summary_msg = {"role": "user", "content": f"(以下为之前对话的压缩摘要)\n{summary}"}
    return [system_msg, summary_msg] + recent


class CompactingAgent:
    def __init__(self, system_prompt: str):
        self.messages = [{"role": "system", "content": system_prompt}]
        self.last_prompt_tokens = 0

    def chat(self, user_input: str) -> str:
        # 时机一:上一轮输入 Token 超过阈值时先压缩
        if self.last_prompt_tokens > TOKEN_THRESHOLD:
            self.messages = compact(self.messages)

        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MAIN_MODEL, messages=self.messages)
        reply = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": reply})
        self.last_prompt_tokens = resp.usage.prompt_tokens
        return reply

    def finish_stage(self):
        # 时机二:完成一个任务阶段后主动压缩
        self.messages = compact(self.messages)
        self.last_prompt_tokens = 0


agent = CompactingAgent("你是一个严谨的编码助手。")
print(agent.chat("帮我定位登录接口偶发 500 的原因"))
agent.finish_stage()  # 修复完成后,在阶段边界主动压缩
🚀 Быстрый старт: зарегистрируйтесь на APIYI apiyi.com, чтобы получить бесплатный тестовый лимит. Для запуска кода выше достаточно заменить API-ключ. Платформа предоставляет интерфейс, совместимый с OpenAI, а для основной модели и модели суммаризации можно выбрать разных поставщиков — это поможет контролировать расходы.
Сравнение способов автоматического сжатия контекста агента
| Способ | Основные особенности | Когда подходит | Доступные платформы |
|---|---|---|---|
| Ручное сжатие на клиенте | Разработчик сам формирует messages и полностью контролирует логику создания сводки |
Собственные агенты, задачи с настраиваемым шаблоном сводки | APIYI apiyi.com, официальные API |
| Сжатие на сервере по порогу | Например, compact_threshold в Responses API |
Когда хочется сократить объём управления состоянием на клиенте | Платформы, поддерживающие этот интерфейс |
| Встроенное сжатие во фреймворке | Agents SDK и Tool Runner управляют контекстом автоматически | Создание прототипов, типовые задачи | Зависит от конкретного SDK |
| Новый сеанс | Сводка создаётся вручную, после чего открывается новое окно | Повседневная работа в клиентах вроде Codex | Любой клиент |
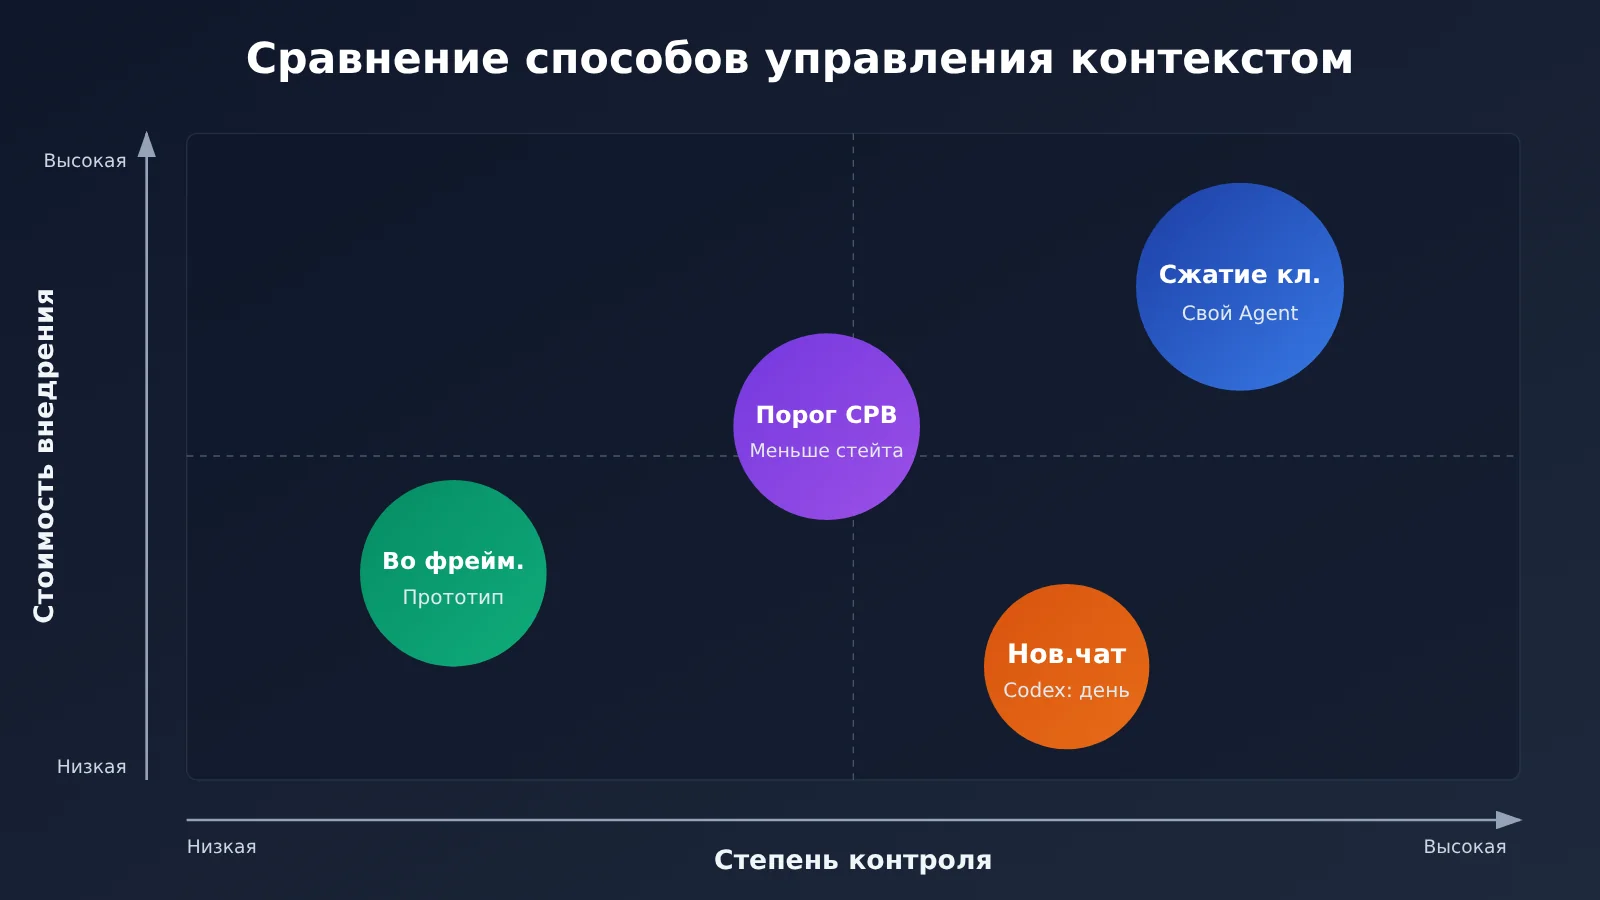
Ручное сжатие на клиенте даёт больше всего контроля, но требует самостоятельно считать токены и следить за качеством сводки. Серверное сжатие избавляет от необходимости собирать историю, но детали сводки остаются для разработчика непрозрачными. Для собственного агента обычно надёжнее сочетать структурированную сводку на клиенте со сжатием по порогу в качестве подстраховки.
Как автоматическое сжатие контекста агента влияет на расходы с учётом кеширования
На первый взгляд сжатие всегда помогает сэкономить, но нужно учитывать и кеширование промптов (Prompt Caching). Согласно условиям тарификации кеша OpenAI в APIYI, токены на входе, для которых произошло попадание в кеш, стоят 10% от обычной цены. В длинном диалоге неизменный префикс истории легко попадает в кеш, поэтому в каждом новом запросе относительно немного токенов оплачивается по полной цене.
После сжатия префикс сообщений заменяется новым кратким изложением истории. Кеш для следующего запроса больше не подходит, и входные токены приходится заново обработать по полной цене. Именно поэтому в официальных рекомендациях не советуют сжимать контекст после каждого шага: частое сжатие постоянно сбрасывает кеш и иногда обходится дороже, чем работа без сжатия. Разумнее дать истории постепенно расти в течение этапа, максимально используя кеш, а затем сжать её один раз — в конце этапа или при приближении к пороговому значению.
Частые вопросы FAQ
Q1: Что такое автоматическое сжатие контекста агента?
Когда контекст достигает определённого объёма в токенах или заканчивается очередной этап задачи, ранние сообщения и записи вызовов инструментов сжимаются в краткое описание состояния задачи. Оно заменяет исходную историю. Это позволяет сократить количество входных токенов на каждом шаге, сохранив сведения о прогрессе, фактах, решениях и дальнейших действиях, чтобы агент мог продолжить работу.
Q2: Чем сжатие контекста отличается от простого обрезания истории?
При обрезании самые ранние сообщения просто удаляются. Это легко реализовать, но первоначальные требования и ограничения пользователя могут потеряться. При сжатии модель превращает историю в структурированное резюме, поэтому сохраняется гораздо больше информации. Обратная сторона — дополнительный вызов модели для создания резюме и необходимость заново сформировать кэш после сжатия.
Q3: Существует ли общее правило «сжимать при заполнении на 80%»?
Нет. В официальной документации условия запуска обычно определяются порогом в токенах: например, для Anthropic Messages API значение по умолчанию — 150 000, минимальное — 50 000, а для Tool Runner значение по умолчанию — 100 000. Порог стоит выбирать с учётом размера контекстного окна модели и объёма результата отдельного вызова инструмента.
Q4: Когда в Codex стоит открыть новое окно?
Рекомендуется открывать новое окно после завершения целого этапа задачи — например, когда функция разработана и прошла тестирование. Перед этим можно попросить агента составить резюме по пунктам «цель / прогресс / факты / решения / следующие шаги» и вставить его в начало новой сессии. Если вы переходите к теме, не связанной с текущей задачей, тоже стоит открыть новое окно, чтобы нерелевантная история не расходовала лимит.
Q5: Как следить за расходом токенов, если клиент не показывает использование контекста?
Это можно сделать на уровне API. Согласно документации по сценариям использования OpenAI Codex, после настройки подключения Codex через APIYI каждый вызов фиксируется в подробных логах и статистике использования в личном кабинете APIYI на apiyi.com. Так можно наглядно увидеть, как растёт число входных токенов на каждом шаге длинного диалога, и решить, когда сжать контекст или открыть новую сессию.
Q6: Как быстро проверить эффективность своей стратегии сжатия?
Возьмите полный код из статьи и выполните одну и ту же многошаговую задачу в трёх режимах: «без сжатия», «сжатие по порогу» и «сжатие по этапам». Затем сравните общий расход токенов и качество выполнения задачи. Через APIYI на apiyi.com с одним ключом можно использовать модели разных поставщиков для основной работы и для создания резюме. Это поможет найти баланс между стоимостью и качеством.
Q7: Какие ограничения сжатия контекста известны?
Во-первых, в сводке можно упустить детали — например, малозаметное значение параметра в коде. Во-вторых, каждое сжатие делает кеш недействительным, поэтому частое сжатие повышает расходы. В-третьих, модель для создания сводок иногда «додумывает» несуществующие сведения. Чтобы снизить эти риски, используйте структурированный шаблон, сохраняйте ограничения пользователя дословно и записывайте ключевые факты, например пути к файлам, в отдельный файл с заметками о задаче, а не полагайтесь только на сводку.
Автоматическое сжатие контекста агента: главное
- Суть сжатия: преобразовать длинную историю в описание текущего состояния задачи, с которым можно продолжить работу, а не просто сократить записи.
- Три момента для сжатия: при достижении порога токенов, заранее на границе этапов и по мере роста нагрузки на контекст под управлением фреймворка.
- Правила 80% нет: официальный подход опирается на порог числа токенов, который нужно выбирать с учётом размера окна и объёма данных, возвращаемых инструментами.
- Структурированная сводка: используйте пять разделов — цель, прогресс, факты, решения и следующие шаги. Ограничения пользователя сохраняйте дословно.
- Не сжимайте контекст после каждого шага: частое сжатие мешает повторному использованию кеша. Сжимать контекст по завершении этапов экономнее.
- Используйте логи, чтобы не упустить важное: если клиент не показывает расход, отслеживайте рост числа токенов на каждом шаге в логах вызовов APIYI на apiyi.com.
Итоги
Главное об автоматическом сжатии контекста агента:
- Когда запускать: сжимайте контекст на границах этапов, а порог числа токенов используйте как запасной механизм. Встроенные стратегии фреймворков подойдут для быстрого старта.
- Что сохранять: оставляйте системный промпт и несколько последних раундов диалога без изменений, а раннюю историю сжимайте в структурированное резюме из пяти разделов.
- Как управлять затратами: сжатие приводит к сбросу кеша, поэтому лучше придерживаться такого ритма: «стабильный рост контекста внутри этапа, сжатие в конце».
Если вы пользуетесь Codex, можно сжимать контекст вручную: завершать этап резюме и открывать новое окно. Если разрабатываете собственного агента, адаптируйте код из этой статьи. Быстро проверить результат можно через APIYI на apiyi.com: платформа предоставляет бесплатный тестовый лимит и единый интерфейс для работы с разными моделями, а в логах вызовов видно, как меняется число токенов до и после сжатия.
📚 Справочные материалы
- Документация OpenAI Responses API: сжатие контекста и настройка
compact_threshold - Ссылка:
platform.openai.com/docs/api-reference/responses -
Описание: официальное руководство по автоматическому сжатию на стороне сервера и управлению состоянием
-
Документация OpenAI Agents SDK: стратегии управления контекстом во время работы агента
- Ссылка:
openai.github.io/openai-agents-python -
Описание: настройка автоматического сжатия, сжатия по фиксированному порогу и принудительного сжатия
-
Документация Anthropic по сжатию контекста: параметры запуска сжатия в Messages API и Tool Runner
- Ссылка:
docs.anthropic.com - Описание: значения
trigger.valueиcontext_token_thresholdпо умолчанию, а также сжатие по запросу
Автор: техническая команда APIYI
Обсуждение технических вопросов: свяжитесь с нами на главной странице сайта APIYI. Дополнительные материалы по настройке Codex, многораундовым диалогам и тарификации кеширования доступны в центре документации docs.apiyi.com