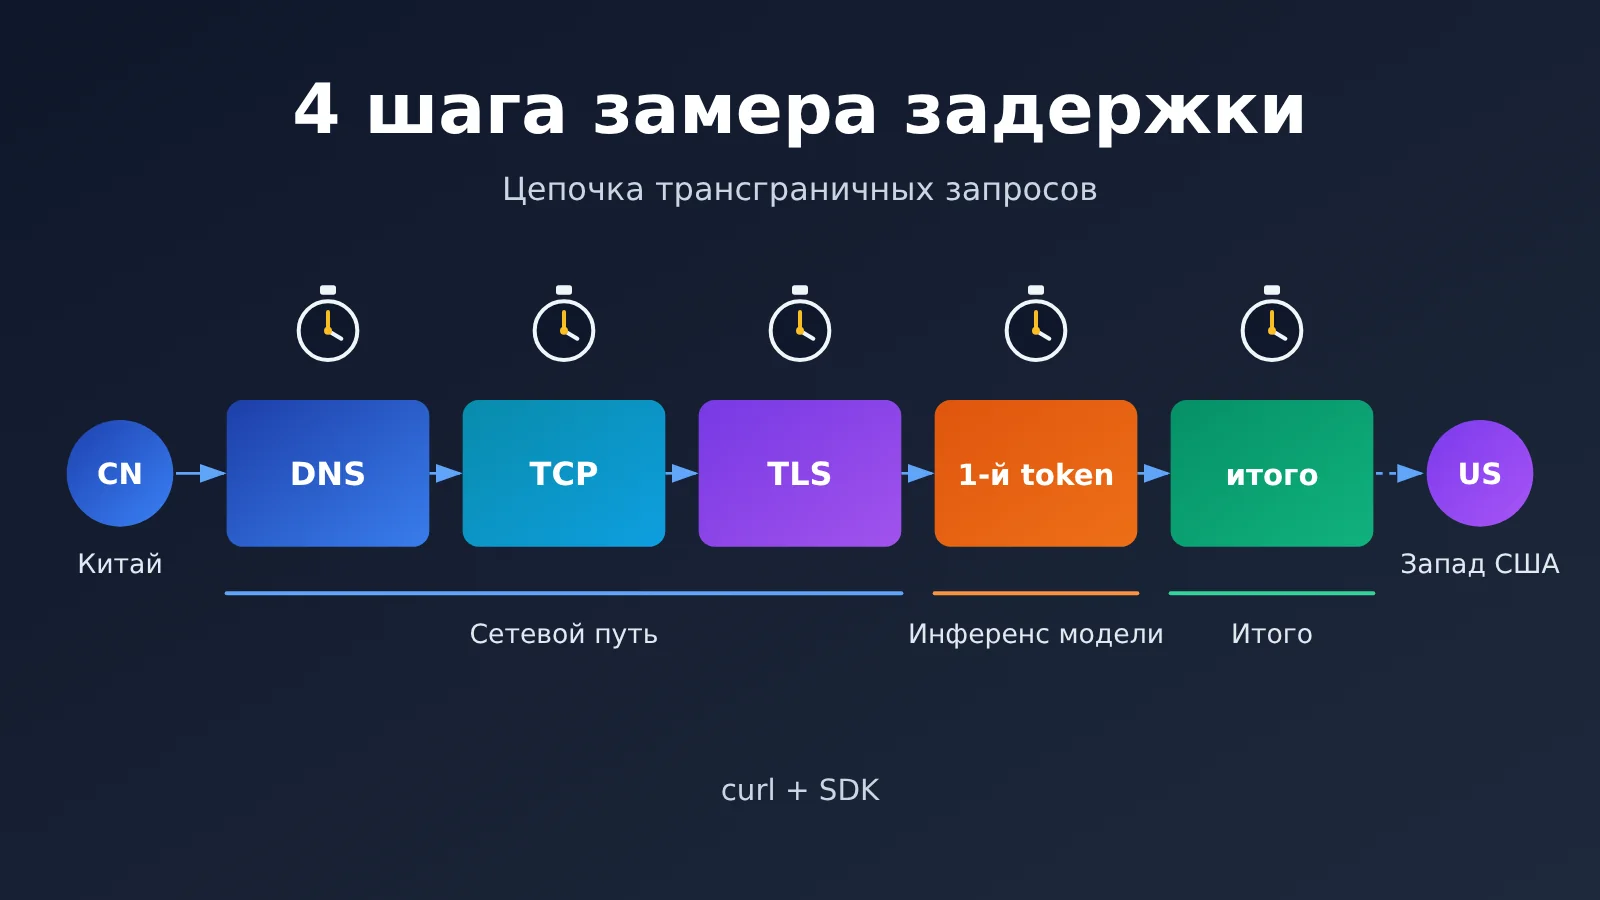
Примечание автора: замеряем с помощью curl и SDK время на DNS, TLS, первый токен и весь запрос — 4 шага, чтобы понять, где узкое место при вызове API большой языковой модели из Китая: в «трансграничном канале» или в «инференсе модели».
«Почему API такой медленный?» — это, пожалуй, самый частый вопрос от разработчиков в Китае, которые подключаются к API больших языковых моделей. Проблема в том, что «медленно» — лишь внешний симптом. Причина может быть в разрешении DNS, в трансграничном TLS-рукопожатии, в очереди к модели, а может, модель просто старательно думает. В этой статье разберём 4-шаговый метод замера и локализации, который поможет разложить время одного запроса на составляющие и точно определить, откуда растёт задержка при вызове API большой языковой модели из Китая.
Это не мистическое руководство в духе «поменяй узел и попробуй ещё раз», а воспроизводимая процедура диагностики, собранная по реальным обращениям о подключении. Нас часто спрашивают: если бизнес развёрнут на серверах в США, какой адрес указывать для подключения? Не будет ли тормозить доступ из Китая из-за пересечения границы? Смогут ли полностью вернуться такие крупные результаты, как изображения и видео? Ниже отвечаем на всё по порядку.
Главное: после этой статьи вы научитесь делать посегментный замер времени через curl и Python SDK, отличать задержку сетевого канала от задержки инференса модели и правильно выбирать base_url в зависимости от региона развёртывания.
Почему вызовы API больших языковых моделей из Китая работают медленно: главное
Прежде чем браться за замеры скорости, зафиксируем базовое понимание: общее время одного вызова API большой языковой модели складывается из «сетевого времени» и «времени модели». Трансграничная задержка влияет только на первое, а то «медленно», которое ощущает большинство людей, на самом деле в основном идёт от второго.
| Шаг | Что измеряем | Инструмент | На какой вопрос отвечает |
|---|---|---|---|
| Шаг 1 | Время установки соединения DNS, TCP, TLS | параметр -w в curl |
Исправен ли сам трансграничный канал |
| Шаг 2 | Задержка первого токена (TTFT) | потоковый вызов через SDK | Сколько ждать, пока модель начнёт отвечать |
| Шаг 3 | Общее время и пропускная способность | не-потоковый вызов SDK + статистика по нескольким запросам | Стабильно ли передаются длинные ответы и большие тела ответов |
| Шаг 4 | Контрольная диагностика | диагностическая матрица | Где узкое место: в сети, в модели или в коде |
Из чего складывается трансграничная задержка
HTTPS-запрос уходит с вашего сервера и последовательно проходит через разрешение DNS, трёхстороннее рукопожатие TCP, рукопожатие TLS — и только потом отправляется тело запроса. В трансграничном сценарии и TCP, и TLS требуют нескольких round-trip, а задержка, обусловленная физическим расстоянием, умножается в несколько раз — отсюда и берётся «медленная установка соединения». Хорошая новость: соединение обычно устанавливается только при первом запросе, а при переиспользовании соединения эта стоимость резко падает.
После того как запрос дошёл до сервера, начинается этап инференса модели. Для диалоговых моделей ожидание перед первым токеном зависит от размера модели, длины входа и текущей нагрузки; после первого токена скорость вывода определяется скоростью генерации модели. С генерацией изображений и видео всё иначе: они, как правило, синхронно возвращают объёмный результат, и пропускная способность и стабильность обратного канала напрямую влияют на то, дойдёт ли результат целиком.
Как понять, что тормозит: сеть или модель
Принцип на самом деле простой: медленно на этапе установки соединения — смотрите на сеть; медленно на первом токене — смотрите на модель и вход; медленно на этапе вывода и с большим разбросом — смотрите на обратный канал и размер тела ответа. Достаточно снять цифры по этим трём отрезкам, и большинство проблем «медленно» можно локализовать за пару минут.
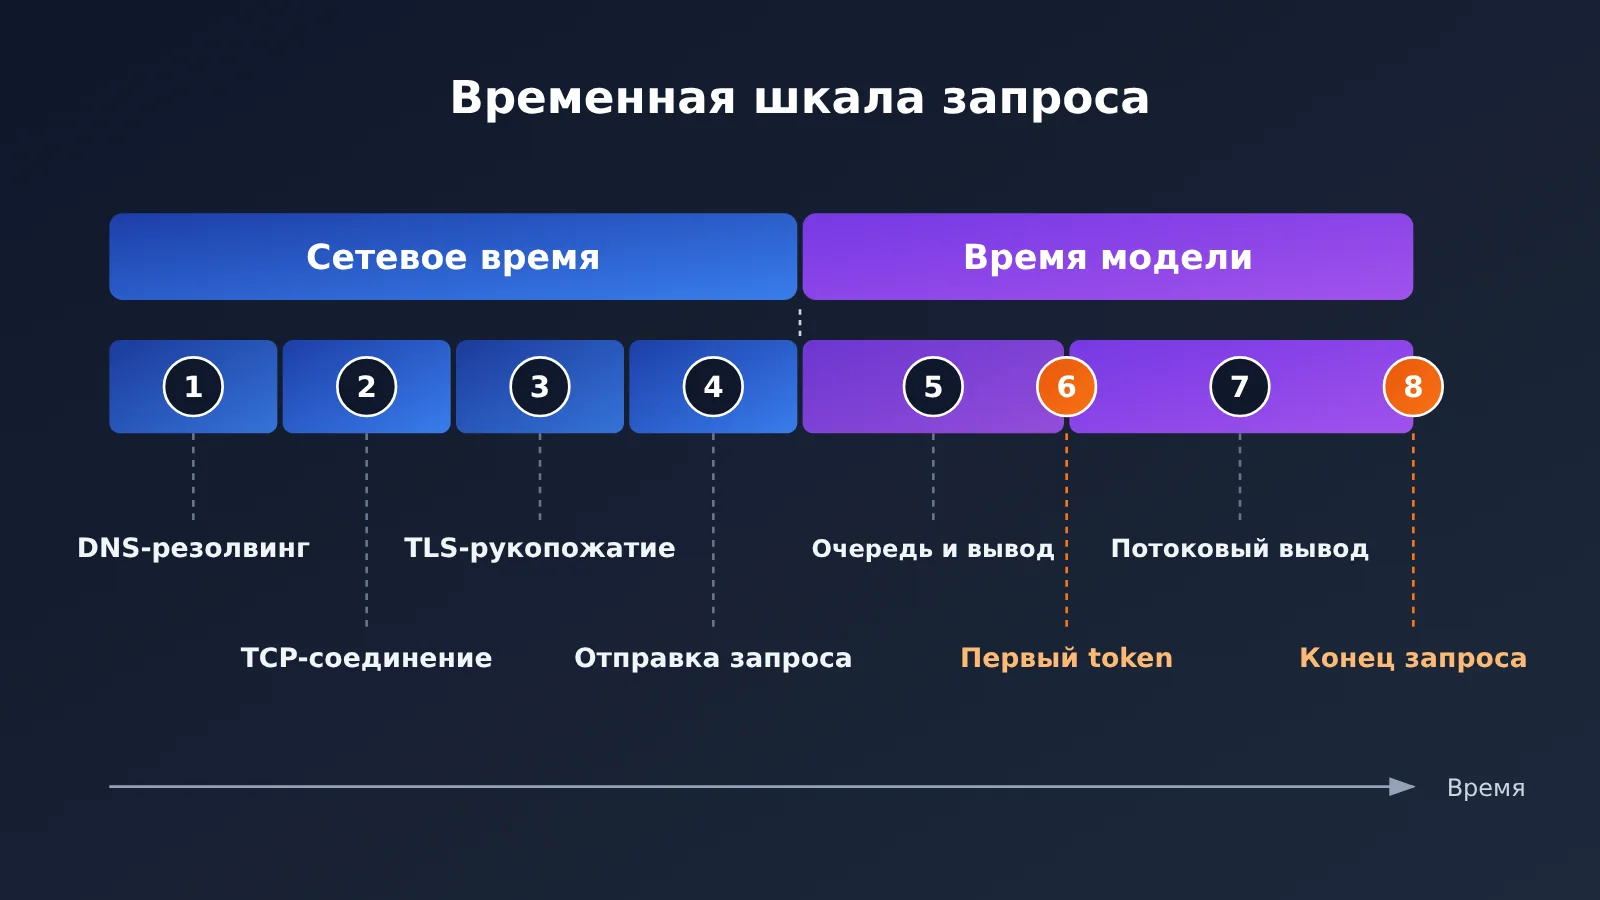
Быстрая диагностика межстрановых задержек: 4 шага
Все примеры ниже — на OpenAI-совместимом интерфейсе. Где бы ни был развёрнут ваш сервис, в вашей стране или за рубежом, достаточно поменять base_url, а остальной код останется тем же.
Шаг 1: разбираем время установки соединения с помощью curl
Параметр -w в curl выводит тайминги по каждому этапу — это самый быстрый способ разобраться, где именно теряется время при трансграничных запросах. Лучше дёргать лёгкий эндпоинт вроде /v1/models, чтобы время инференса модели не мешало измерять сеть.
export API_KEY="YOUR_API_KEY"

curl -o /dev/null -s \
  -H "Authorization: Bearer $API_KEY" \
  -w "DNS-резолвинг: %{time_namelookup}s\nTCP-соединение: %{time_connect}s\nTLS-рукопожатие: %{time_appconnect}s\nПервый байт:    %{time_starttransfer}s\nВсего:          %{time_total}s\n" \
  https://api.apiyi.com/v1/models
Обратите внимание: каждое значение в выводе curl — это время с накоплением от начала запроса, а не длительность отдельного этапа. Что означают поля и как считать по ним:
| Поле curl | Что означает | Как посчитать длительность этапа | Частые причины завышенного значения |
|---|---|---|---|
time_namelookup |
DNS-резолвинг завершён | берём как есть | медленный локальный DNS, резолвинг в удалённый узел |
time_connect |
TCP-соединение установлено | connect − namelookup | высокий RTT между странами, потери пакетов |
time_appconnect |
TLS-рукопожатие завершено | appconnect − connect | нестабильный канал, несколько round-trip на рукопожатие |
time_starttransfer |
получен первый байт | starttransfer − appconnect | обработка на стороне сервера, очередь |
time_total |
запрос завершён | total − starttransfer | большой ответ, не хватает полосы на обратном пути |
Советую прогнать команду 5–10 раз подряд и посмотреть, стабильны ли цифры. Если время на TCP и TLS сильно скачет — канал нестабилен. Если значения ровные и укладываются в разумные пределы, то сеть, скорее всего, не главное узкое место.
Шаг 2: измеряем задержку первого токена потоковым вызовом через SDK
С подключением всё в порядке. Теперь посмотрим, как быстро модель начинает отвечать. Задержка до первого токена (Time To First Token, TTFT) — самый заметный для пользователя показатель в диалоговых приложениях: человек смотрит в экран и ждёт, когда появится первый символ, и каждая секунда тянется очень долго.
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # подходит для развертывания в Китае и за рубежом
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "Расскажи о себе в одном предложении"}],
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(f"Задержка первого токена: {time.perf_counter() - start:.2f}s")
        break
Получив TTFT, вычтите из него время установки соединения из шага 1. Остаток — это в основном время ожидания в очереди и инференса модели. Если именно эта часть занимает почти всё время, оптимизация сети даст немного: лучше подумать о более быстрой модели, сокращении входного контекста или включении потокового вывода.
Шаг 3: Многораундовая статистика общего времени и передача больших тел ответов
Однократное измерение легко искажается случайными колебаниями, поэтому для оценки в продакшене стоит делать несколько раундов и смотреть на медиану и максимум. Полный скрипт ниже автоматически измеряет DNS, TCP, TLS, TTFT и общее время, а затем выводит сводку.
Посмотреть полный скрипт замера скорости
import socket
import ssl
import statistics
import time
from urllib.parse import urlparse

import openai

BASE_URL = "https://api.apiyi.com/v1"  # Единый адрес подключения
API_KEY = "YOUR_API_KEY"
MODEL = "gpt-4o-mini"
ROUNDS = 5


def measure_handshake(url: str) -> dict:
    """Поэтапно измеряет время DNS, TCP и TLS"""
    host = urlparse(url).hostname
    t0 = time.perf_counter()
    ip = socket.gethostbyname(host)
    t1 = time.perf_counter()
    sock = socket.create_connection((ip, 443), timeout=10)
    t2 = time.perf_counter()
    ctx = ssl.create_default_context()
    tls = ctx.wrap_socket(sock, server_hostname=host)
    t3 = time.perf_counter()
    tls.close()
    return {"dns": t1 - t0, "tcp": t2 - t1, "tls": t3 - t2}


def measure_llm(client: openai.OpenAI) -> dict:
    """Измеряет задержку первого токена и общее время"""
    start = time.perf_counter()
    ttft = None
    chars = 0
    stream = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "写一段 200 字左右的产品介绍"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            if ttft is None:
                ttft = time.perf_counter() - start
            chars += len(chunk.choices[0].delta.content)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": chars}


def summarize(name: str, values: list) -> None:
    print(f"{name:<8} 中位数 {statistics.median(values):.3f}s  "
          f"最大 {max(values):.3f}s  最小 {min(values):.3f}s")


def main():
    client = openai.OpenAI(api_key=API_KEY, base_url=BASE_URL, timeout=120)
    records = {"dns": [], "tcp": [], "tls": [], "ttft": [], "total": []}

    for i in range(ROUNDS):
        hs = measure_handshake(BASE_URL)
        llm = measure_llm(client)
        for k in ("dns", "tcp", "tls"):
            records[k].append(hs[k])
        records["ttft"].append(llm["ttft"])
        records["total"].append(llm["total"])
        print(f"第 {i + 1} 轮完成,输出 {llm['chars']} 字")

    print("\n===== 测速汇总 =====")
    for k, v in records.items():
        summarize(k.upper(), v)


if __name__ == "__main__":
    main()
Для API генерации изображений есть дополнительный нюанс: генерация обычно вызывается синхронно, а итоговое тело ответа заметно больше, чем у текста. Если общее время сильно превышает время до первого байта или соединение периодически обрывается, проблема чаще в обратном пути, а не в медленной генерации модели. В таком случае стоит увеличить таймаут на клиенте и делать идемпотентные повторные попытки при обрывах.
Шаг 4. Определяем узкое место по диагностической матрице
Когда данные из первых трёх шагов собраны, просто сопоставьте их с матрицей ниже — чаще всего этого достаточно, чтобы найти проблему.
| Симптом | Наиболее вероятное узкое место | Что делать в первую очередь |
|---|---|---|
| Заметно завышенное время на этапе DNS | Локальное разрешение DNS | Сменить DNS-сервис на более стабильный, включить кеширование разрешения |
| Высокие и нестабильные TCP и TLS | Качество трансграничного канала | Переиспользовать соединения, выбрать провайдера с оптимизированными маршрутами |
| Соединение устанавливается нормально, но TTFT очень высокий | Инференс модели или слишком длинный ввод | Взять более быструю модель, сократить контекст, включить стриминг |
| TTFT в норме, но общее время большое | Слишком длинный вывод или низкая скорость генерации | Ограничить max_tokens, разделить задачу на части |
| Периодические обрывы при генерации изображений и видео | Нестабильная передача больших тел ответа | Увеличить таймаут, добавить идемпотентные повторы, использовать асинхронный опрос |
| Первый запрос медленный, последующие быстрые | Холодный старт и установка соединения | Использовать постоянные соединения, переиспользовать client глобально |
🚀 Быстрый старт: если хотите сразу прогнать скрипт замера скорости выше, рекомендую сначала зарегистрироваться на APIYI apiyi.com и получить API-ключ. Новым пользователям дают бесплатную тестовую квоту — её хватит на несколько раундов сравнительных замеров, и никаких дополнительных прокси разворачивать не нужно.
Как выбрать base_url для разных регионов развёртывания
Многие разработчики ломают голову: если бизнес развёрнут за рубежом и в Китае, нужно ли указывать разные адреса подключения? Ответ — нет. Серверы APIYI находятся на западе США, поэтому для зарубежных сервисов маршрут до них изначально короткий. При этом платформа ускоряет обратный маршрут для доступа из материкового Китая — в первую очередь чтобы стабильно передавать большие ответы в задачах с изображениями и видео. Так что независимо от региона развёртывания достаточно одного и того же base_url.
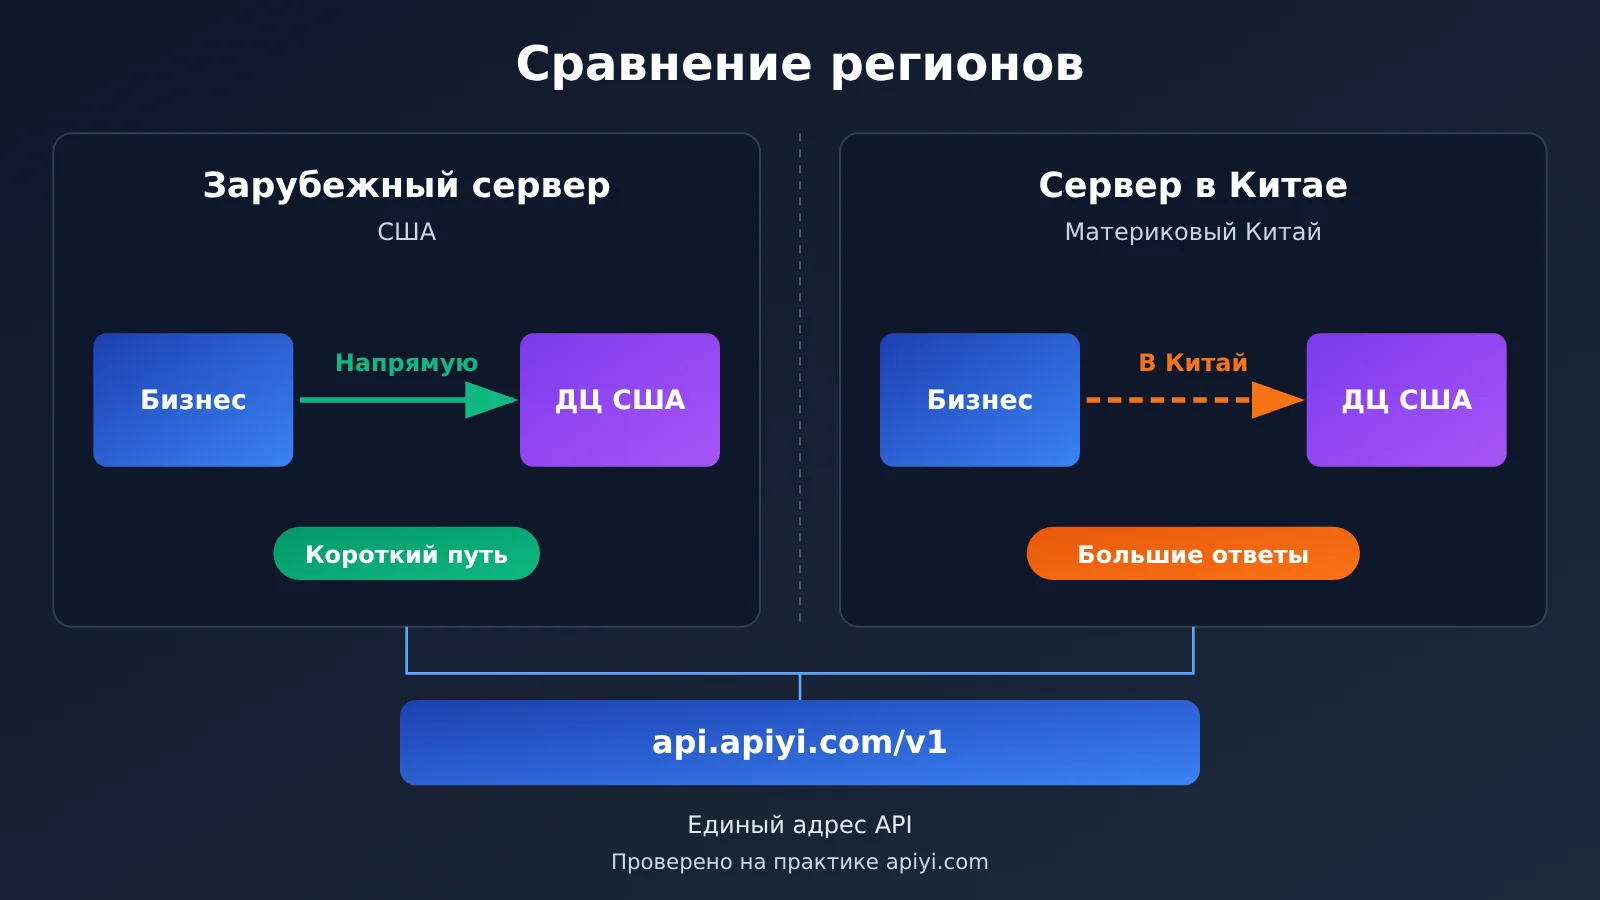
| Регион развёртывания | Особенности маршрута | На что смотреть при тестировании скорости | Рекомендация по подключению |
|---|---|---|---|
| США / запад США | Тот же регион, что и серверы, низкая задержка туда-обратно | В первую очередь TTFT и время работы модели | Использовать единый адрес подключения |
| Европа / АТР за пределами Китая | Межконтинентальный маршрут, но международные каналы обычно стабильны | TLS-рукопожатие и переиспользование соединений | Единый адрес подключения + постоянные соединения |
| Материковый Китай | Трансграничный маршрут, уже есть ускорение обратного маршрута | Стабильность установки соединения и передача больших ответов | Единый адрес подключения + разумные таймауты |
| Гибридное развёртывание | Вызовы из нескольких регионов одновременно | Тестировать скорость отдельно по регионам и сравнивать | Один и тот же код, без отдельных конфигураций |
Такой подход удобен тем, что один и тот же код можно без проблем переносить из тестовой среды (в Китае) в продакшен (за рубежом) и не поддерживать несколько наборов конфигураций. Реально нужно сделать другое — в каждом окружении развёртывания прогнать те же 4 шага тестирования скорости и убедиться, что фактическое поведение соответствует ожиданиям бизнеса.
Рекомендации по оптимизации трансграничных вызовов с большими ответами
Интерфейсы изображений и видео особенно чувствительны к трансграничным маршрутам. На уровне кода стоит сделать следующее:
- Переиспользуйте client глобально: не создавайте соединение заново на каждый запрос — в трансграничных сценариях это экономит заметное время на рукопожатиях.
- Задавайте таймауты по типу задачи: для текстовых диалогов можно короче, а для генерации изображений и получения результатов видео оставляйте достаточный запас.
- Делайте идемпотентные повторы при обрывах: используйте экспоненциальную задержку, чтобы не отправлять одну и ту же задачу генерации несколько раз подряд.
- Для видео используйте асинхронный опрос: после отправки задачи периодически проверяйте статус и скачивайте результат только когда он готов — так меньше риск обрыва долгого соединения.
- Логируйте время по этапам: записывайте TTFT и общее время в мониторинг, чтобы при проблемах быстро восстановить картину.
Частые вопросы (FAQ)
Вопрос 1: Что такое межграничная задержка и чем она отличается от задержки инференса модели?
Межграничная задержка — это сетевое время, которое тратится на передачу запроса между китайскими и зарубежными серверами. Основная её часть приходится на установку TCP- и TLS-соединения и обратную передачу данных. Задержка инференса модели — это время, которое сервер тратит на генерацию содержимого; она проявляется в ожидании первого токена и в скорости вывода. Эти два показателя нужно измерять отдельно, иначе не получится понять, куда двигаться в оптимизации.
Вопрос 2: Сервис развёрнут на американском сервере — какой адрес указывать при вызове APIYI?
Можно сразу использовать `https://api.apiyi.com/v1`. Серверы APIYI находятся на западе США, поэтому для сервисов, развёрнутых в Америке, путь до них короткий и дополнительная настройка не нужна. Подробные шаги подключения описаны в разделе «Быстрый старт» в центре документации APIYI apiyi.com — всё делается за три шага.
Вопрос 3: Сервер в западной части США — почему тогда из Китая доступ тоже довольно плавный?
Потому что платформа ускоряет обратные маршруты для доступа из Китая. Это в первую очередь нужно для стабильной передачи больших ответов — изображений и видео. Можете сами проверить это с китайского сервера с помощью curl-команды из шага 1 этой статьи и посмотреть, сколько времени и с какими колебаниями занимают этапы TCP и TLS.
Вопрос 4: Задержка первого токена очень высокая — это проблема с сетью?
Не обязательно. Сначала посмотрите, сколько времени curl показывает на установку соединения. Если соединение устанавливается нормально, то высокий TTFT обычно связан с тем, что сама модель крупная, входной контекст слишком длинный или инференс сложнее обычного. В таком случае можно попробовать более лёгкую модель, сократить промпт или включить потоковый вывод, чтобы улучшить восприятие для пользователя.
Вопрос 5: Как быстро сравнить скорость отклика разных моделей?
Рекомендую тестировать через агрегированный интерфейс, поддерживающий несколько моделей:
1. Зарегистрируйте аккаунт на APIYI apiyi.com и получите API-ключ
2. Используйте полный скрипт замера скорости из этой статьи, меняя только переменную `MODEL`
3. Прогоните одинаковое число итераций для каждой модели и сравните медианные значения TTFT и общего времени
Поскольку один ключ позволяет вызывать OpenAI, Claude, Gemini и другие модели, при сравнении сетевые условия остаются одинаковыми — выводы получаются более надёжными.
Вопрос 6: API изображений иногда обрывает соединение — как разобраться?
Интерфейс изображений работает синхронно, ответ получается объёмным, и обрывы чаще всего происходят на этапе обратной передачи результата. Советую сначала увеличить таймаут на клиенте, а затем посмотреть разницу между `time_total` и `time_starttransfer` в curl. Если разница большая и нестабильная, значит узкое место — в обратном маршруте. Тогда стоит добавить идемпотентные повторные попытки и избегать пиковых часов при массовой отправке запросов.
Вопрос 7: Какие ограничения у этого метода замера скорости?
Результаты замера отражают состояние сети только в момент и в точке измерения — у разных операторов и в разное время суток разница может быть заметной. Кроме того, нагрузка на модели меняется со временем, и один замер TTFT не говорит о долгосрочной производительности. Советую в продакшене постоянно логировать время по этапам и принимать решения по тенденциям, а не по отдельным точкам данных.
Ключевые тезисы: тестирование скорости вызова API больших моделей из Китая
- Сначала разбить, потом оптимизировать: общее время складывается из времени сети и времени модели, поэтому измерения нужно проводить по сегментам.
- curl для проверки установки соединения: используйте параметр
-w, чтобы получить накопленные тайминги DNS, TCP и TLS. - SDK для замера TTFT: при потоковом вызове фиксируйте время до первого токена — так можно оценить скорость ответа модели.
- Несколько прогонов — смотрите медиану: одиночный результат сильно зависит от колебаний, поэтому делайте не менее 5 прогонов.
- Большой ответ — смотрите обратный путь: для изображений и видео обращайте внимание на разницу между общим временем и временем до первого байта.
- Единый адрес подключения: подключайтесь через APIYI apiyi.com — внутри Китая и за рубежом используется один и тот же
base_url.
Итоги
Ключевые моменты диагностики медленных вызовов API больших языковых моделей из Китая:
- Метод четырёх шагов: замер скорости установки соединения, замер времени до первого токена, подсчёт общего времени выполнения и сверка с диагностической матрицей — так вы шаг за шагом сужаете область поиска.
- Разделяйте два типа задержек: трансграничные задержки решаются переиспользованием соединений и оптимизацией маршрутов, а задержки модели — выбором подходящей модели и сокращением входных данных.
- Большие ответы — отдельная история: для работы с изображениями и видео нужно настроить разумные таймауты, идемпотентные повторы и асинхронный опрос.
- base_url не нужно различать по регионам: за рубежом подключение идёт напрямую к дата-центру на Западном побережье США, а из Китая есть ускоренные обратные маршруты — достаточно одной конфигурации.
Вместо того чтобы на глазок решать, что «всё медленно», потратьте пару минут на скрипт замера скорости — пусть данные покажут, где узкое место. Рекомендуем получить бесплатную тестовую квоту через APIYI apiyi.com, провести реальные замеры в своём окружении и уже потом выбирать модель и стратегию таймаутов.
📚 Справочные материалы
- Центр документации APIYI: адреса подключения и описание процесса подключения в три шага
- Ссылка:
docs.apiyi.com -
Описание: конфигурация режима, совместимого с OpenAI, требования к вызову image API и диагностика обрывов соединения.
-
Официальное руководство curl: полное описание переменных для
-w - Ссылка:
curl.se/docs/manpage.html -
Описание: авторитетные определения полей таймингов вроде
time_namelookupиtime_appconnect. -
OpenAI Python SDK: официальный открытый репозиторий
- Ссылка:
github.com/openai/openai-python - Описание: как использовать потоковые вызовы, таймауты и параметры повторов.
Автор: техническая команда APIYI
Техническая поддержка: если при замерах возникнут вопросы — напишите нам через главную страницу сайта APIYI, а больше материалов по подключению найдёте в центре документации docs.apiyi.com