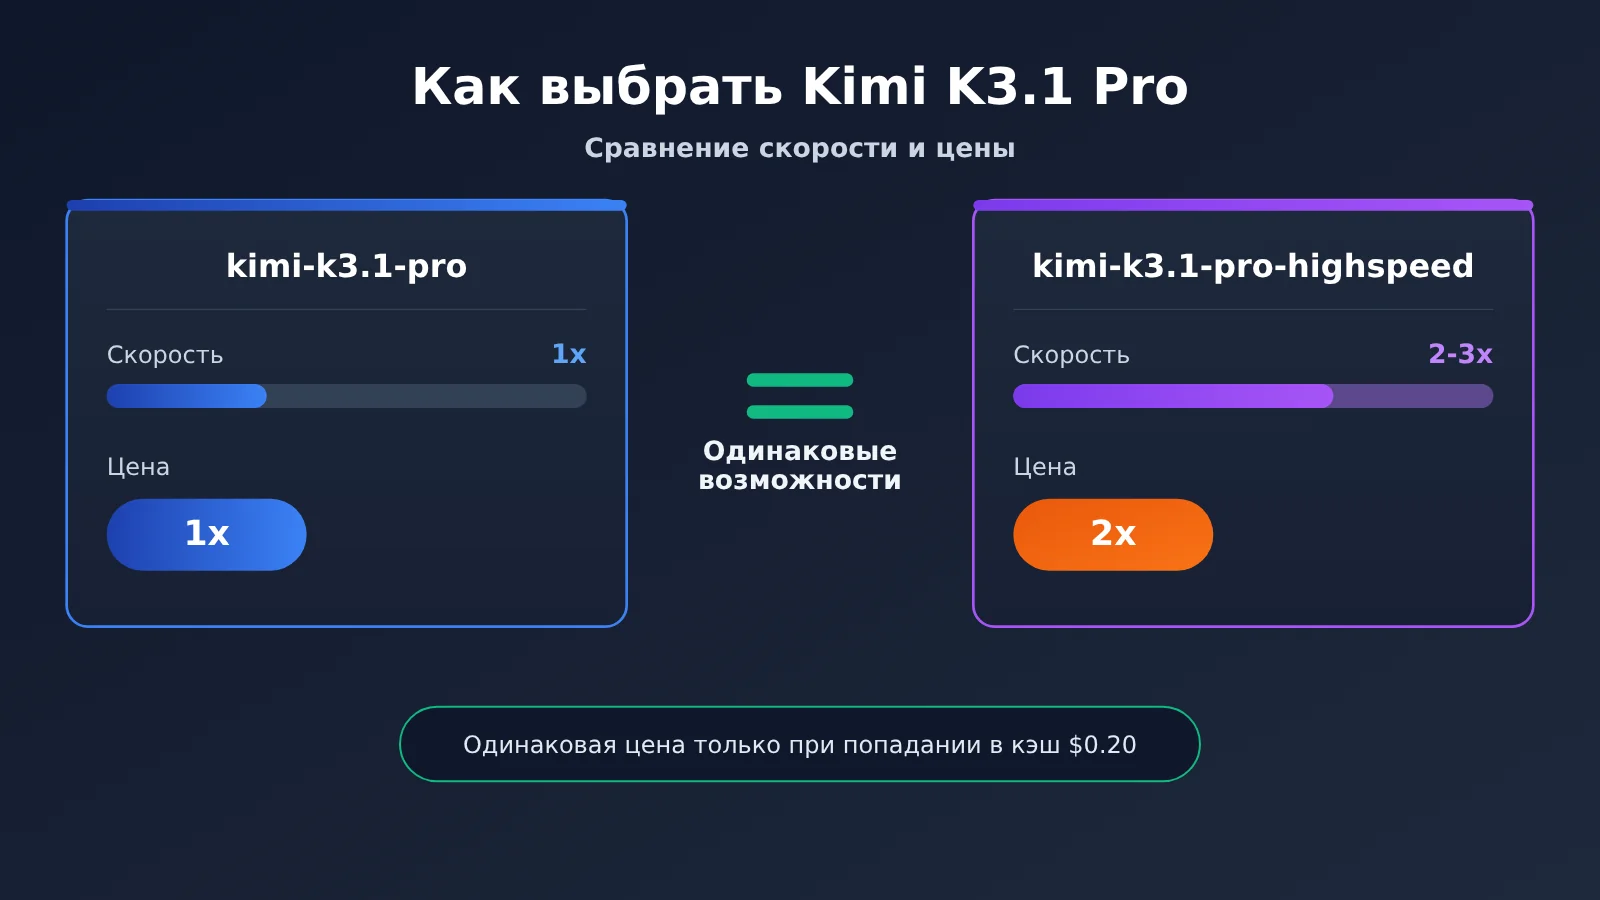
У моделей Kimi K3.1 Pro и Highspeed одинаковые возможности. Highspeed отличается только скоростью: по официальным данным, он работает в 2–3 раза быстрее. За это приходится платить почти вдвое больше по всем тарифам — кроме цены за попадание в кэш: она не изменилась и составляет $0.20 в обоих случаях. Поэтому Highspeed стоит выбирать, если вы ждёте результат у экрана, а стандартную версию — если запускаете задачи пакетно в фоновом режиме.
У этого вывода три основания: в официальном блоге Moonshot сказано, что у двух версий «одинаковые возможности»; на официальной странице с ценами указаны пять тарифов; в официальной документации Kimi Code сказано, что Highspeed расходует примерно вдвое больше квоты. Ниже у каждого факта указан источник по одной из трёх категорий: «заявление компании», «сторонний источник» или «не проверено». Если данных нет, я прямо так и пишу, а не выдаю расчёты за реальные замеры.
В этой статье мы не сравниваем, какая модель умнее. У двух версий одинаковые возможности, поэтому вопрос только в том, что выгоднее: заплатить вдвое больше, чтобы получить результат того же качества быстрее, или нет.
Что вы узнаете из статьи: увидите таблицу с пятью тарифами, поймёте, как перевести время ожидания в деньги, сможете проверить два расчёта и найдёте таблицу с рекомендациями для шести типов задач.
1. Главное отличие Kimi K3.1 Pro от Highspeed: возможности одинаковые, разница только в скорости и цене
Для начала — общая картина. В таблице собраны параметры, по которым можно сравнить две модели. В последнем столбце указан уровень источника информации. Контекст — это общий объём текста, который модель может «видеть» за один раз; он измеряется в токенах. Токен — базовая единица расчётов и вычислений модели. Грубо говоря, это фрагмент слова или текста.
| Параметр сравнения | kimi-k3.1-pro (стандартная версия) | kimi-k3.1-pro-highspeed | Уровень источника |
|---|---|---|---|
| Возможности модели | Базовый уровень | Такие же, как у стандартной версии | По заявлению компании |
| Длина контекста | 1,048,576 токенов | 1,048,576 токенов | По заявлению компании |
| Скорость генерации | Базовый уровень | По заявлению компании, в 2–3 раза выше | По заявлению компании, без подробных данных |
| Цена за единицу | Базовая цена | В 2 раза выше, кроме случаев попадания в кэш | Официальный прайс |
| Требования для использования Kimi Code | Подписка Plus или выше (для контекста на 1 млн токенов нужна Pro или выше) | Подписка Pro или выше | Официальная документация |
| Расход квоты в Kimi Code | Базовый уровень | Примерно в 2 раза выше | Официальная документация |
| Официальные каналы доступа | kimi.ai, Kimi Work, Kimi Code, Kimi API | Те же | Официальный блог |
Вывод простой: кроме скорости, цены и требований к подписке, модели ничем не отличаются. Если выбрать не ту версию, качество результата не пострадает — вы лишь потратите больше денег или времени.
1.1 Сравнение цен Kimi K3.1 Pro и Highspeed (все пять категорий)
Цены ниже собраны 24.10.2026, в долларах за миллион токенов, без налогов; источник — официальные тарифы. Сначала разберёмся, за что взимается плата. «Ввод» — это содержимое, которое вы отправляете модели, а «вывод» — ответ модели. «Кэш» позволяет платформе временно сохранять префикс запроса, например код проекта, который вы передаёте снова и снова. Если в следующем запросе этот префикс совпадает с сохранённым, он повторно используется — это называется «попаданием в кэш» и тарифицируется по сниженной ставке. Первое сохранение содержимого в кэш оплачивается отдельно — есть два варианта срока хранения: 5 минут и 1 час.
| Статья расходов | kimi-k3.1-pro | kimi-k3.1-pro-highspeed | Коэффициент |
|---|---|---|---|
| Ввод (без попадания в кэш) | $2.00 | $4.00 | в 2 раза выше |
| Вывод | $10.00 | $20.00 | в 2 раза выше |
| Ввод при попадании в кэш | $0.20 | $0.20 | без изменений — единственная цена, которая не выросла |
| Запись в кэш (5 минут) | $2.00 | $4.00 | в 2 раза выше |
| Запись в кэш (1 час) | $4.00 | $8.00 | в 2 раза выше |
Публичные данные стороннего разработчика Саймона Уиллисона (Simon Willison) тоже это подтверждают: Highspeed стоит вдвое дороже, но ввод при попадании в кэш тарифицируется так же, как в стандартной версии. Этот нюанс повлияет на дальнейшие расчёты. Если большая часть ввода в ваших запросах попадает в кэш, фактическая общая стоимость Highspeed будет меньше, чем «ровно в два раза» выше: самый большой сегмент ввода не дорожает.
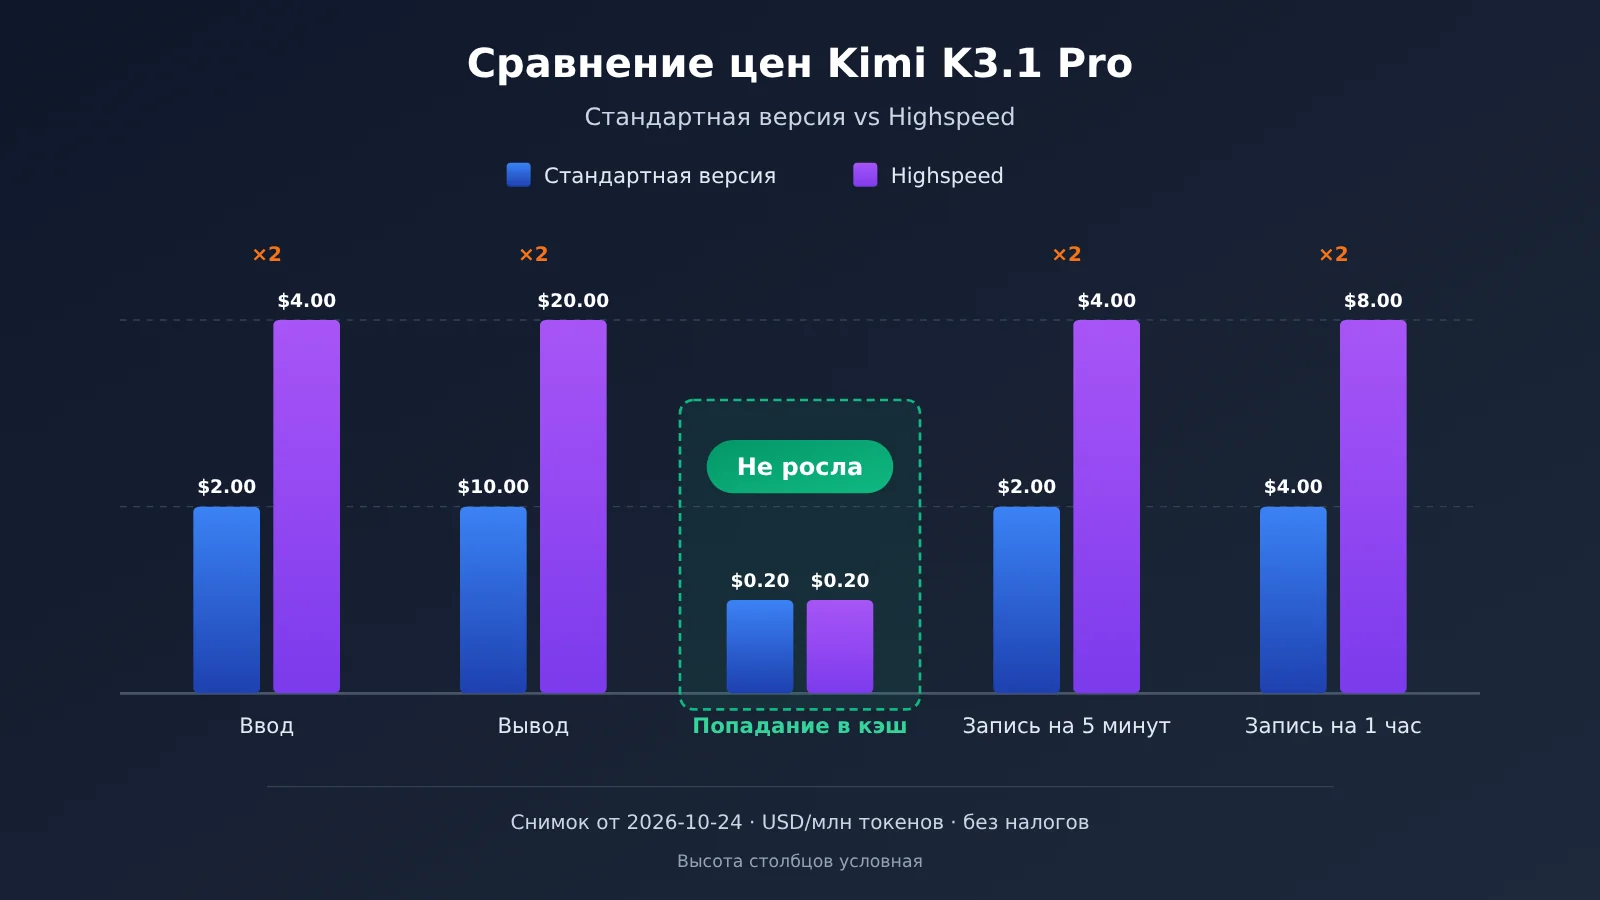
Примечание о ценах: цены на диаграмме и в таблице приведены согласно официальным тарифам. Если вы вызываете модели через APIYI apiyi.com, ориентируйтесь на названия моделей и цены в списке моделей на платформе. Эти две модели пока подключаются — мы постараемся добавить их как можно скорее.
2. Насколько быстрее Kimi K3.1 Pro Highspeed
Скажем прямо: достоверных данных о скорости пока очень мало. В официальных материалах указан только диапазон ускорения, а сторонние тесты охватывают лишь стандартную версию. В открытом доступе нет ни одного бенчмарка, который измерял бы скорость Highspeed в токенах в секунду. Токенов в секунду — это количество токенов, которое модель генерирует за секунду. Чем выше показатель, тем быстрее появляется готовый ответ.
| Показатель | Значение | Надёжность источника | Примечание |
|---|---|---|---|
| Скорость Highspeed относительно стандартной версии | В 2–3 раза выше | Данные производителя | Условия тестирования и подробные результаты не опубликованы |
| Скорость генерации стандартной версии | 80,7 токена/с | Сторонний источник (Artificial Analysis) | Оценка 2 из 4 возможных уровней |
| Скорость генерации Highspeed | Нет данных | Не подтверждено | Сторонние специалисты ещё не проводили отдельные измерения |
| Средний объём генерации стандартной версии на одну задачу | Около 55 тыс. токенов | Сторонний источник (Artificial Analysis) | Речь о задачах в тесте Intelligence Index |
| Стоимость одной задачи для стандартной версии | Около $1,98 (на странице модели указано $2,11) | Сторонний источник (Artificial Analysis) | То же |
Поэтому на вопрос «сколько токенов в секунду выдаёт Highspeed?» сейчас нет надёжного ответа. В статьях, где приводят конкретные цифры, либо описывают собственные замеры — тогда важно смотреть на условия тестирования, — либо просто умножают показатель 80,7 на 2 или 3. Мы не будем приводить такую цифру, а предложим способ оценить скорость без опоры на бенчмарки.
2.1 Как выбрать Kimi K3.1 Pro: переведите время ожидания в деньги
Сама по себе скорость ничего не стоит. Важно, сколько времени люди благодаря ей не тратят на ожидание. Если никто не ждёт, неважно, насколько быстрее работает модель. Чтобы оценить, есть ли смысл переплачивать, пройдите четыре шага:
- Оцените время ожидания одного ответа: количество выходных токенов ÷ скорость. Например, стандартная версия выдаёт 80,7 токена в секунду. Ответ объёмом 1 500 токенов появится примерно за 19 секунд. Учтите, что обе модели всегда работают в режиме рассуждений, а на сам процесс рассуждений тоже требуется время. Фактическое ожидание будет дольше — насколько именно, зависит от задачи.
- Оцените, сколько времени сэкономит Highspeed: если ориентироваться на заявленное ускорение в 2–3 раза, тот же ответ придётся ждать около 6–10 секунд. Экономия составит примерно 10 секунд на запрос. Это расчёт, а не результат тестирования — проверьте его на собственных запросах.
- Умножьте экономию на число запросов и стоимость рабочего времени: если за день вы обращаетесь к модели 100 раз и каждый раз ждёте на 10 секунд меньше, это примерно 17 минут. Умножьте это время на стоимость вашего часа или часа работы команды.
- Сравните результат с дополнительными расходами: посчитайте по методу из раздела 3, во сколько в день обойдётся Highspeed. Если стоимость сэкономленного времени превышает доплату, переход оправдан.
Важно не попасться на распространённую ошибку: ускорение в 3 раза не означает, что работа будет выполняться в 3 раза быстрее. Ответ модели — лишь часть рабочего процесса. Время на чтение кода, размышления, правки и запуск тестов от этого не сократится. Вы экономите только те несколько секунд, пока ждёте модель. Поэтому на третьем шаге ориентируйтесь на реальное время ожидания, а не умножайте продуктивность на коэффициент ускорения.
3. Считаем расходы на Kimi K3.1 Pro и Highspeed в двух сценариях
Оба расчёта основаны на официальных тарифах. Я привожу все формулы, чтобы вы могли подставить свои значения токенов и пересчитать расходы.
3.1 Сценарий A: 20 итераций интерактивного редактирования кода
Условия: каждый запрос содержит 30 000 входных токенов, из них 25 000 — контекст репозитория, который передаётся повторно, а 5 000 — новый материал. Каждый ответ — 1 500 токенов. Всего отправляется 20 запросов с интервалом менее 5 минут, поэтому кэш всё это время остаётся активным.
Стандартная версия:
- Первый запрос: входные данные —
30000 × $2 / 1 млн = $0.06, из них 25 000 токенов записываются в кэш; запись этой части стоит25000 × $2 / 1 млн = $0.05 - Каждый последующий запрос с попаданием в кэш:
25000 × $0.2 / 1 млн = $0.005 - Новый материал в каждом запросе:
5000 × $2 / 1 млн = $0.01 - Ответ в каждом запросе:
1500 × $10 / 1 млн = $0.015 - Итого за запрос:
$0.005 + $0.01 + $0.015 = $0.03
Highspeed:
- Цена попадания в кэш не меняется и остаётся равной
$0.005 - Новый материал стоит вдвое дороже:
5000 × $4 / 1 млн = $0.02 - Ответ стоит вдвое дороже:
1500 × $20 / 1 млн = $0.03 - Итого за запрос:
$0.005 + $0.02 + $0.03 = $0.055, то есть примерно $0.06
С учётом разовых расходов на запись в кэш при первом запросе 20 итераций обойдутся примерно в $0.66 для стандартной версии и $1.26 для Highspeed. Если сравнивать стоимость одного запроса, Highspeed примерно в 1,8 раза дороже стандартной версии — то есть не ровно вдвое, потому что цена попадания в кэш не увеличивается.
Вывод: стоимость примерно вдвое выше, зато ожидание по официальным данным сокращается больше чем наполовину. Дополнительные $0.6 дают несколько сэкономленных минут за 20 итераций — для большинства разработчиков это оправданная трата.
3.2 Сценарий B: пакетная обработка в офлайн-режиме — 1 000 запросов
Условия: каждый запрос содержит 8 000 входных токенов и 600 выходных. Всего выполняется 1 000 запросов, между которыми нет общего префикса, поэтому кэш не поможет.
- Стандартная версия, один запрос:
(8000 × $2 + 600 × $10) / 1 млн = $0.016 + $0.006 = $0.022; за 1 000 запросов —$22. - Highspeed, один запрос:
(8000 × $4 + 600 × $20) / 1 млн = $0.032 + $0.012 = $0.044; за 1 000 запросов —$44.
Вывод: чистый убыток. Никто не ждёт ответа на каждый запрос, а общая длительность обработки обычно зависит от числа параллельных задач и очереди. Доплата в $22 не даст ощутимой пользы.
| Параметр | Сценарий A: интерактивное редактирование кода | Сценарий B: пакетная обработка в офлайн-режиме |
|---|---|---|
| Число запросов | 20 | 1 000 |
| Можно ли попасть в кэш | Да, повторно используются 25 000 токенов | Нет |
| Общая стоимость стандартной версии | Около $0.66 | $22 |
| Общая стоимость Highspeed | Около $1.26 | $44 |
| Фактическая разница в цене | Примерно в 1,8–1,9 раза | В 2 раза |
| Кто-то ждёт ответа | Да | Нет |
| Вывод | Вдвое дороже, зато ожидание сокращается более чем наполовину — того стоит | Чистый убыток: выбирайте стандартную версию |
4. Как выбрать Kimi K3.1 Pro или Highspeed для разных задач
Если применить описанный выше подход к типичным сценариям, получится такая таблица. Учитывать нужно всего два фактора: ждёт ли кто-то результат и можно ли использовать кэш.
| Сценарий | Рекомендация | Причина |
|---|---|---|
| Интерактивная разработка | Highspeed | Разработчик ждёт изменений у экрана, а контекст репозитория можно взять из кэша — фактическая наценка не достигает 2× |
| Диалоговый агент | Highspeed | В цепочке много коротких запросов и вызовов инструментов, поэтому задержки на каждом шаге заметно сказываются на ощущениях пользователя |
| Демонстрация, прямой эфир | Highspeed | На ответ смотрят зрители: задержка может испортить впечатление от трансляции, а разницей в стоимости нескольких десятков вызовов можно пренебречь |
| Пакетная очистка данных | Стандартная версия | Никто не ждёт результата по каждой записи, поэтому скорость не даёт дополнительной ценности, а двукратная цена — только лишние расходы |
| Офлайн-оценка | Стандартная версия | При оценке важно только качество результата. Возможности обеих версий одинаковы, и скорость на оценку не влияет |
| Задачи по расписанию | Стандартная версия | Задачи выполняются ночью или в фоновом режиме, поэтому нет разницы, завершатся они на несколько минут раньше или позже. Здесь важнее стоимость |
Если в продукте есть оба типа сценариев, их можно сочетать: запросы для прямого взаимодействия с пользователями направлять в kimi-k3.1-pro-highspeed, а фоновые задачи — сводки, архивирование и пакетную обработку — в kimi-k3.1-pro. Возможности моделей одинаковы, поэтому при переключении между ними не нужно менять промпты.
5. Третий способ ускорить Kimi K3.1 Pro: reasoning_effort и квоты Kimi Code
Прежде чем платить больше, стоит попробовать бесплатный способ ускорить работу. Обе модели всегда «думают»: перед ответом они выполняют внутренние рассуждения. Их продолжительность задаёт параметр reasoning_effort — по сути, он определяет, насколько глубоко модель будет обдумывать задачу. Чем ниже уровень, тем меньше времени уходит на рассуждения и тем быстрее появляется результат. Ниже — сведения из официальной документации:
reasoning_effortподдерживает три уровня:low,highиmax. По умолчанию используетсяmax.- Чтобы ускорить стандартную версию, сначала попробуйте установить
low. Если скорость вас устраивает и качество приемлемое, переплачивать за Highspeed не нужно. - При снижении уровня модель рассуждает менее глубоко — вы меняете качество на скорость. В случае с Highspeed вы платите за скорость, не снижая качество. Это разные компромиссы.
- Эти способы можно сочетать: Highspeed с уровнем
lowподойдёт для задач, где важна минимальная задержка и не требуется сложный анализ.
Есть и ещё один момент, о котором легко забыть: квоты в Kimi Code. Kimi Code — инструмент Moonshot для программирования, расход которого учитывается в рамках квоты подписки. Согласно официальной документации Kimi Code:
- Для
k3.1-proнужна подписка Plus или выше; чтобы использовать контекстное окно на 1M, нужна подписка Pro или выше. - Для
k3.1-pro-highspeedнужна подписка Pro или выше. - Версия Highspeed расходует примерно вдвое больше квоты. При одинаковом лимите подписки с Highspeed можно выполнить примерно вдвое меньше работы.
При вызове API также обратите внимание на несколько фиксированных параметров: по требованиям официальной документации их нужно просто опустить в запросе, а не указывать вручную:
temperatureфиксирован на уровне1.0top_pфиксирован на уровне0.95nфиксирован на уровне1presence_penaltyиfrequency_penaltyфиксированы на уровне0max_completion_tokensпо умолчанию равен131072, максимальное значение —1048576
6. Как удобнее работать с Kimi K3.1 Pro: подключение через APIYI
Официальный API одновременно поддерживает форматы OpenAI и Anthropic, включая интерфейсы Chat Completions, Responses и Messages. Совместимость с OpenAI означает, что существующий код на OpenAI SDK почти не придётся менять: достаточно заменить адрес и ключ, а также указать другое имя модели.
Разработчики из России могут использовать APIYI apiyi.com, чтобы обращаться к моделям разных поставщиков с одним API-ключом. Оплата взимается по факту использования, а новым пользователям доступен бесплатный тестовый лимит. Подключение:
- Формат OpenAI: укажите
https://api.apiyi.com/v1в параметреbase_url - Формат Anthropic: укажите
https://api.apiyi.comв качестве базового адреса - В параметре
modelукажите соответствующее имя модели из списка на платформе
Важно: по состоянию на 2026-10-24 в списке моделей APIYI уже есть модели серии Kimi: kimi-k2.5, kimi-k2.6, kimi-k2.7-code, kimi-k3 и другие. Модели kimi-k3.1-pro и kimi-k3.1-pro-highspeed пока не представлены. Актуальные имена и цены этих моделей на платформе смотрите в её списке моделей. Мы постараемся добавить их как можно скорее. Пока можно проверить работу цепочки вызовов и стратегии кэширования на доступных моделях Kimi, а после появления новинок просто заменить имя модели.
7. Рекомендации по выбору между Kimi K3.1 Pro и Highspeed
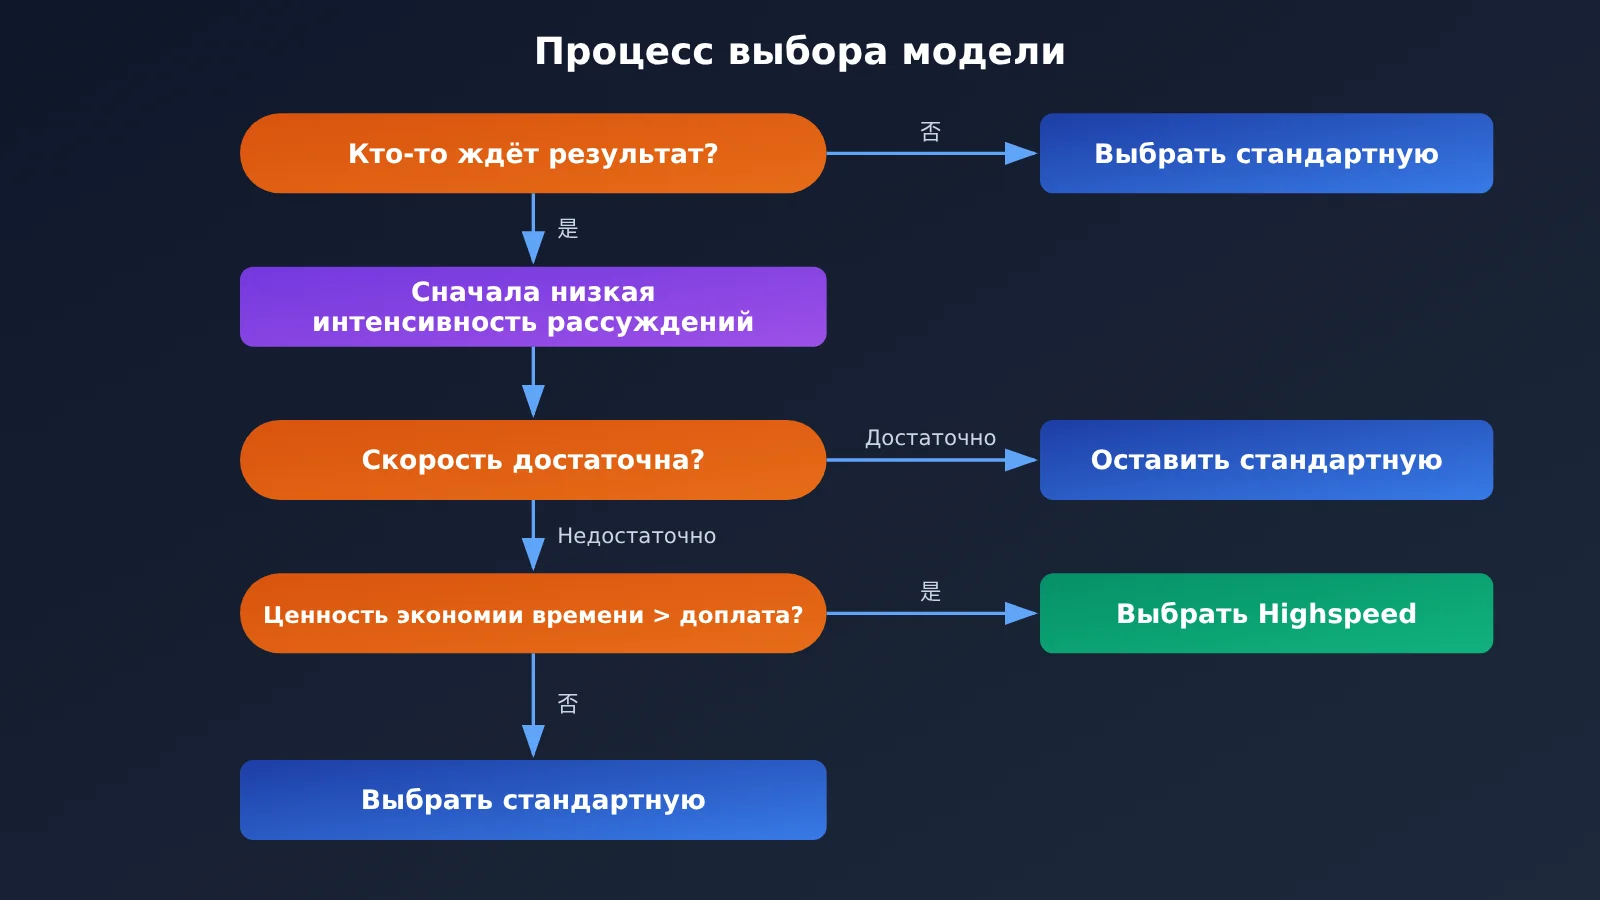
Как выбрать: сначала спросите себя: «Кто-нибудь ждёт ответа?» Если нет — выбирайте стандартную версию. Если ждёт — сначала попробуйте снизить
reasoning_effortдоlow. Если модель всё ещё работает медленно, переходите на Highspeed. Чтобы понять, оправдана ли переплата, пересчитайте сэкономленное время ожидания в деньги по методу из раздела 2 и сравните результат с разницей в цене из раздела 3. Советуем провести небольшое сравнение на реальных запросах через APIYI (apiyi.com). Доступные версии K3.1 Pro и их цены смотрите в списке моделей на платформе. Мы постараемся как можно скорее добавить эту модель.
Несколько простых правил:
- По умолчанию используйте стандартную версию, а Highspeed включайте по мере необходимости, а не оставляйте в настройках постоянно
- Чем чаще переиспользуется префикс, тем выгоднее Highspeed, поскольку цена при попадании в кэш не удваивается
- Если команда использует обе версии, распределяйте запросы по сценариям: интерактивные задачи — на Highspeed, фоновые — на стандартную версию
- При использовании Highspeed в Kimi Code учитывайте расход квоты: он примерно вдвое выше
Часто задаваемые вопросы
Вопрос 1: Что такое Kimi K3.1 Pro Highspeed?
Это высокоскоростная версия Kimi K3.1 Pro, которую Moonshot выпустила одновременно с основной моделью. Её идентификатор — `kimi-k3.1-pro-highspeed`. По заявлению разработчиков, она работает в 2–3 раза быстрее K3.1 Pro при тех же возможностях и контекстном окне на 1 048 576 токенов.
Вопрос 2: Highspeed отвечает хуже стандартной версии или, наоборот, лучше?
По официальной информации, возможности у моделей одинаковые. То есть более высокая скорость не означает, что модель стала «глупее», а более высокая цена — что она стала «умнее». На качество ответов влияет настройка `reasoning_effort`, а не выбор версии.
Вопрос 3: Насколько Highspeed быстрее? Есть точные данные в токенах в секунду?
Разработчики указали только диапазон — «в 2–3 раза», без подробных данных. По измерениям стороннего сервиса Artificial Analysis, стандартная версия выдаёт 80,7 токена в секунду, но Highspeed отдельно не тестировали. Точные показатели Highspeed пока не подтверждены — рекомендуем проверить скорость на собственных запросах.
Вопрос 4: Почему Highspeed на практике не обязательно обходится ровно вдвое дороже?
Цена входных токенов при попадании в кэш у обеих версий одинаковая — $0,20 за миллион токенов. Если запрос содержит много повторяющегося префикса, который попадает в кэш, эта часть не дорожает, поэтому итоговая стоимость будет менее чем вдвое выше. В сценарии A из этой статьи один запрос обходится примерно в 1,8 раза дороже, чем в стандартной версии.
Вопрос 5: Как использовать Kimi K3.1 Pro и Highspeed из России?
Можно воспользоваться официальным Kimi API или вызывать модели через APIYI — совместимый с OpenAI интерфейс на apiyi.com. Для этого замените `base_url` на `https://api.apiyi.com/v1`. Названия моделей и цены в APIYI уточняйте в списке моделей платформы. Сейчас модель ещё подключается — мы постараемся добавить её как можно скорее.
Вопрос 6: Какие известные ограничения есть у серии Kimi K3.1 Pro?
— Обе модели всегда работают в режиме рассуждений. Полностью отключить его нельзя — можно только менять уровень с помощью `reasoning_effort`.
— Параметры `temperature`, `top_p` и другие зафиксированы. Их нужно опускать из запроса, поэтому управлять стилем с помощью параметров сэмплирования не получится.
— В Kimi Code для доступа к Highspeed нужна подписка Pro или выше; модель расходует примерно вдвое больше квоты.
— Разработчики обещали опубликовать полные веса модели до 2026-11-04, но пока этого не сделали.
Ключевые выводы: Kimi K3.1 Pro или Highspeed
- Возможности одинаковые: Highspeed даёт только скорость, но не повышает качество ответов.
- Цена вдвое выше: ввод, вывод и оба тарифа на запись в кэш стоят в 2 раза дороже. Исключение — попадание в кэш: цена та же, $0.20.
- Данных о скорости мало: по заявлению производителя, модель работает в 2–3 раза быстрее. Сторонние тесты измерили только стандартную версию — 80,7 токена/с.
- Решение зависит от времени ожидания: переведите время ожидания человека в деньги и сравните с разницей в цене. Не считайте, что двукратный прирост скорости означает двукратный прирост эффективности.
- Для интерактивных задач выбирайте Highspeed: он подойдёт для программирования в диалоге, диалоговых агентов и демонстраций в прямом эфире.
- Для пакетной обработки выбирайте стандартную версию: в пакетной очистке данных, офлайн-оценке и запланированных задачах Highspeed — просто лишние расходы.
- Сначала попробуйте снизить уровень, а потом доплачивать:
reasoning_effortсо значениемlow— бесплатный способ ускорить работу.
Итоги
При выборе между Kimi K3.1 Pro и Highspeed важны три момента:
- Возможности у версий одинаковые: выбор не влияет на качество ответов. Разница только в скорости, цене и требованиях к подписке.
- У более высокой цены есть исключение: из пяти тарифов четыре стоят вдвое дороже. Цена попадания в кэш не меняется, поэтому чем чаще вы повторно используете префиксы, тем меньше фактическая переплата за Highspeed.
- Highspeed оправдан, если кто-то ждёт: в интерактивных сценариях вы платите примерно вдвое больше, чтобы сократить ожидание больше чем наполовину. Для пакетной обработки это просто дополнительные расходы.
На практике сначала протестируйте стандартную версию с reasoning_effort=low. Если скорость всё ещё не устраивает, переключитесь на Highspeed и проверьте затраты по формуле из раздела 3, подставив собственное количество токенов. При подключении через APIYI (apiyi.com) ориентируйтесь на модели и цены, указанные в списке платформы. Мы постараемся как можно скорее добавить эту модель.
Справочные материалы
- Официальный сайт и блог Kimi: информация о запуске K3.1 Pro и Highspeed, их возможностях и каналах доступа
- Ссылка:
kimi.ai -
Примечание: источник официального утверждения о том, что Highspeed работает в 2–3 раза быстрее при тех же возможностях
-
Artificial Analysis: независимые замеры скорости и стоимости моделей
- Ссылка:
artificialanalysis.ai -
Примечание: источник данных о скорости стандартной версии — 80,7 токена/с, объёме вывода для одной задачи и стоимости
-
Блог Саймона Уиллисона: публичные заметки разработчика
- Ссылка:
simonwillison.net -
Примечание: подтверждает, что Highspeed стоит вдвое дороже, а цена при попадании в кэш такая же, как у стандартной версии
-
Список моделей APIYI: доступные на платформе модели и цены
- Ссылка:
docs.apiyi.com/models - Примечание: информация о наличии моделей серии Kimi на платформе проверена 24 октября 2026 года
Автор: техническая команда APIYI
Технические вопросы: дополнительную информацию о подключении можно найти в центре документацииdocs.apiyi.com. Список доступных моделей серии Kimi K3.1 Pro и цены смотрите в перечне моделей на платформе. Мы постараемся добавить эту модель в ближайшее время.