После перехода с gemini-3.1-pro-preview на Gemini 4 Argon многие разработчики столкнулись с неожиданной проблемой: при одинаковых промптах Argon иногда «думает менее глубоко». Вероятная причина — значение по умолчанию для уровня рассуждений Gemini 4 Argon. Согласно официальной документации Google, для Gemini 4 Argon по умолчанию установлен уровень thinking_level medium, а не high. У gemini-3.1-pro-preview по умолчанию стоит максимальный уровень — high. Если в коде или клиенте уровень рассуждений не задан явно, после перехода модель незаметно начнёт рассуждать на один уровень слабее.
Ситуацию осложняет то, что популярные клиенты для общения с моделями, например Cherry Studio, нередко с запозданием добавляют поддержку параметров рассуждений новых моделей. Опции выбора уровня в интерфейсе может вообще не быть. В этой статье разберём доступные уровни рассуждений Gemini 4 Argon, значения по умолчанию и влияние на стоимость, а затем покажем три способа настройки: через нативный API, совместимый с OpenAI интерфейс и пользовательские параметры Cherry Studio.
Что вы узнаете: как задать нужный уровень рассуждений Gemini 4 Argon при любом способе вызова модели и избежать типичных ошибок при переходе — обрезания ответа из-за max_tokens и ошибок 400 из-за неподдерживаемых параметров.
Главное об уровне рассуждений Gemini 4 Argon
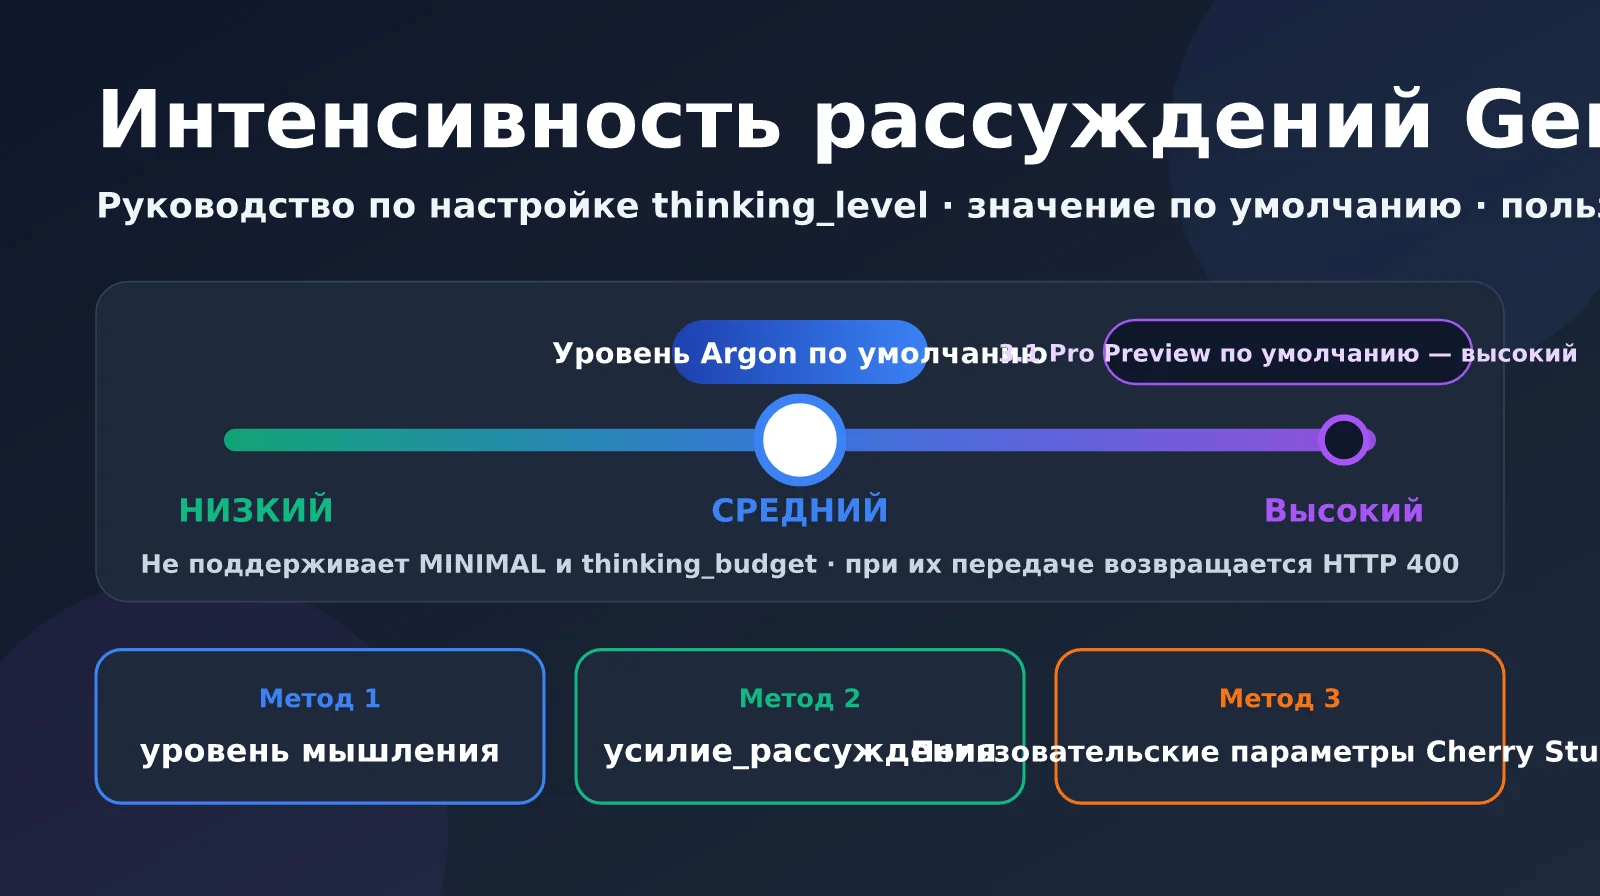
Уровень рассуждений Gemini 4 Argon задаётся параметром thinking_level. Поддерживаются только три значения: low, medium и high. В отличие от предыдущих моделей, Argon не поддерживает ни настройку thinking_budget по числу токенов, ни уровень minimal. При использовании этих параметров API сразу вернёт ошибку HTTP 400. В таблице ниже собраны официальные рекомендации по трём уровням из руководства Google Cloud для разработчиков.
| Уровень рассуждений | По умолчанию? | Рекомендуемые сценарии использования | Особенности |
|---|---|---|---|
| LOW | Нет | Классификация, суммаризация, извлечение метаданных | Минимальная задержка, почти не генерируются токены рассуждений |
| MEDIUM | ✅ По умолчанию для gemini-4-argon | Обычные задачи программирования, вызов инструментов, ответы на вопросы по документам, анализ видео | Оптимальный баланс скорости, стоимости и точности |
| HIGH | ✅ По умолчанию для версии cyber-permissive | Разработка ПО с несколькими файлами, формальные доказательства, проектирование архитектуры, поиск уязвимостей | Самые глубокие рассуждения, заметно выше задержка до первого токена и стоимость |
| MINIMAL | Не поддерживается | — | При настройке возвращается ошибка HTTP 400 |
| thinking_budget | Не поддерживается | — | В предыдущих моделях параметр преобразовывался без уведомления, Argon сразу возвращает ошибку 400 |
Важно: для версии gemini-4-argon-cyber-permissive, предназначенной для защитников сетей в рамках программы Fairwind, по умолчанию установлен уровень HIGH. У стандартной версии gemini-4-argon по умолчанию стоит MEDIUM. Кроме того, все результаты Argon в таблицах Google получены на максимальном уровне рассуждений. Если вы вызываете модель с уровнем medium по умолчанию, её фактические результаты могут оказаться ниже заявленных Google.
Уровень рассуждений Gemini 4 Argon по умолчанию: сравнение с предыдущими моделями
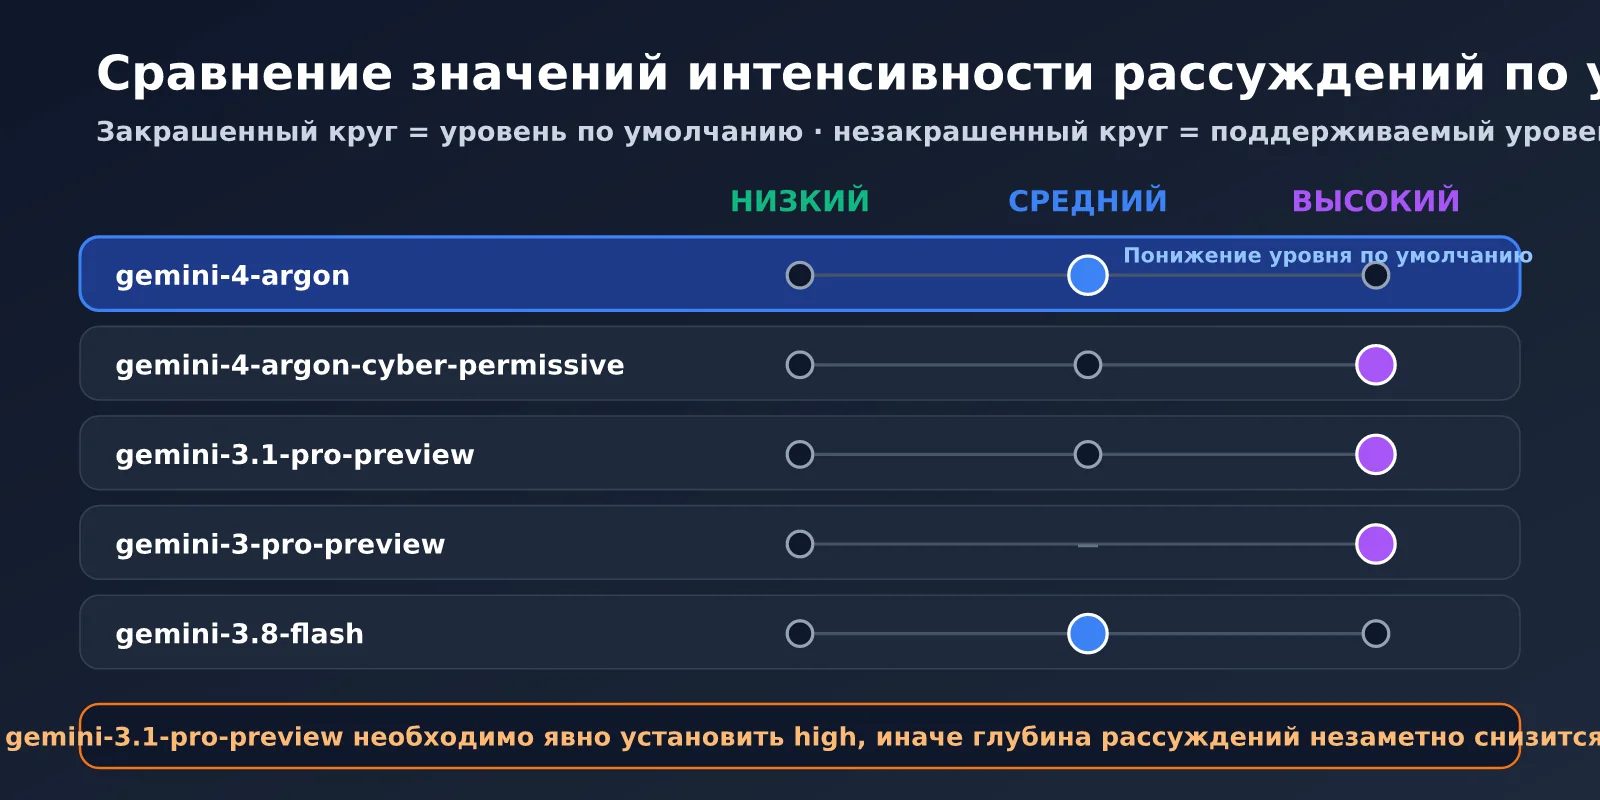
Сравнение настроек по умолчанию Gemini 4 Argon и нескольких недавних моделей Gemini наглядно показывает, где при переходе могут возникнуть проблемы. Данные взяты из официальной документации Google по thinking для Gemini API.
| Модель | Уровень рассуждений по умолчанию | Поддерживаемые уровни |
|---|---|---|
| gemini-4-argon | medium | low, medium, high |
| gemini-4-argon-cyber-permissive | high | low, medium, high |
| gemini-3.1-pro-preview | high | low, medium, high |
| gemini-3-pro-preview | high | low, high |
| gemini-3.8-flash | medium | low, medium, high |
| gemini-3-flash-preview | high | minimal, low, medium, high |
Как видно, в новых моделях Google постепенно снижает уровень рассуждений по умолчанию с high до medium. Это касается и Gemini 3.8 Flash, и Gemini 4 Argon. Такой подход снижает задержку и расходы по умолчанию, но пользователям, привыкшим к тому, что 3.1 Pro «всегда думает на полную», при переходе на Argon нужно явно указывать high, чтобы сохранить прежнюю глубину рассуждений.
🎯 Совет по переходу: при переходе с gemini-3.1-pro-preview на Gemini 4 Argon сначала явно задайте уровень рассуждений в коде, а затем сравните качество ответов обеих моделей. С помощью единого интерфейса платформы APIYI apiyi.com можно вызывать обе версии Gemini для A/B-тестирования — достаточно изменить параметр model.
Как уровень рассуждений Gemini 4 Argon влияет на стоимость
Уровень рассуждений влияет не только на качество ответа, но и непосредственно на счёт. Токены рассуждений Argon тарифицируются по цене выходных токенов: $10 за миллион токенов в период раннего доступа и $20 после его окончания. При этом по умолчанию пользователь не видит процесс рассуждений целиком. Иными словами, чем выше уровень, тем больше вы платите за «невидимые рассуждения».
Для грубой оценки: по цене раннего доступа один запрос с уровнем high, в котором модель сгенерировала 1500 токенов рассуждений, обойдётся примерно на $0,015 дороже только за счёт этой части. Если выполнять 10 000 таких запросов в день, за месяц дополнительные расходы составят около 4500 долларов. Это одна из причин, по которой Google установила для Argon уровень medium по умолчанию: большинству повседневных запросов не нужны самые глубокие рассуждения, а при уровне high пользователи платили бы за вычисления, которые им не требуются. Поэтому разумнее выбирать уровень под тип задачи, а не устанавливать high для всех запросов.
3 способа настроить интенсивность рассуждений Gemini 4 Argon
В зависимости от способа вызова для настройки интенсивности рассуждений Gemini 4 Argon можно использовать один из трёх параметров: thinking_level в нативном SDK Google, reasoning_effort в OpenAI-совместимом интерфейсе или нативные параметры Google, переданные через extra_body. Использовать их одновременно нельзя — запрос завершится ошибкой.
| Способ настройки | Расположение параметра | Допустимые значения | Где применяется |
|---|---|---|---|
Нативный thinking_level |
thinking_config.thinking_level |
LOW / MEDIUM / HIGH | Google GenAI SDK, Vertex AI |
OpenAI-совместимый reasoning_effort |
reasoning_effort на верхнем уровне тела запроса |
minimal / low / medium / high | OpenAI SDK и различные совместимые клиенты |
Передача через extra_body |
extra_body.google.thinking_config |
low / medium / high | Когда нужно включить дополнительные нативные параметры, например сводку рассуждений |
Параметр reasoning_effort в OpenAI-совместимом интерфейсе преобразуется в thinking_level Argon. Согласно официальной таблице соответствий Google, minimal и low преобразуются в low, medium — в medium, а high — в high. Однако Argon не распознаёт более высокие уровни xhigh и max, которые используются в OpenAI и Anthropic. Если передать их, API вернёт ошибку 400.
Способ 1: настройка thinking_level в нативном SDK
При использовании Google GenAI SDK достаточно указать нужный уровень в ThinkingConfig. Для конечной точки Vertex AI доступны три региона: global, us и eu.
from google import genai
from google.genai import types

client = genai.Client(enterprise=True, project="YOUR_PROJECT", location="global")

resp = client.models.generate_content(
    model="gemini-4-argon",
    contents="为多生产者单消费者场景设计一个无锁环形缓冲区",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="HIGH"),
        max_output_tokens=32768,
    ),
)
print(resp.text)
Способ 2: настройка reasoning_effort в OpenAI-совместимом интерфейсе
Если проект уже использует OpenAI SDK, вызов Argon через совместимый интерфейс потребует минимум изменений: достаточно добавить параметр reasoning_effort.
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gemini-4-argon",
    reasoning_effort="high",      # 映射为 thinking_level=high
    max_tokens=32000,             # 必须为思考 token 预留空间
    messages=[{"role": "user", "content": "审查这段并发代码的竞态条件"}],
)
print(resp.choices[0].message.content)
print(resp.usage)
Полный код: передача через extra_body и сравнение трёх уровней
import time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
PROMPT = "一个 Kubernetes Pod 一直处于 CrashLoopBackOff,请给出系统的排查步骤和命令"


def call_with_effort(level: str):
    """方式二:OpenAI 兼容的 reasoning_effort"""
    start = time.time()
    resp = client.chat.completions.create(
        model="gemini-4-argon",
        reasoning_effort=level,
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
    )
    return resp, time.time() - start


def call_with_extra_body(level: str):
    """方式三:extra_body 透传 Google 原生 thinking_config
    注意:不能与 reasoning_effort 同时使用"""
    return client.chat.completions.create(
        model="gemini-4-argon",
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
        extra_body={
            "google": {
                "thinking_config": {
                    "thinking_level": level,
                    "include_thoughts": True,
                }
            }
        },
    )


if __name__ == "__main__":
    for level in ("low", "medium", "high"):
        resp, cost_time = call_with_effort(level)
        u = resp.usage
        print(f"[{level:6}] 耗时 {cost_time:5.1f}s | 输出 {u.completion_tokens} token")
💡 Подсказка по вызову: OpenAI-совместимый интерфейс — самый простой способ подключить Gemini 4 Argon. Код на базе OpenAI SDK почти не придётся менять. Для тестирования можно получить пробный лимит через APIYI apiyi.com и запустить приведённый выше скрипт, чтобы сравнить результаты типичных задач при разной интенсивности рассуждений.
Настройка интенсивности рассуждений Gemini 4 Argon в Cherry Studio
В правом нижнем углу поля ввода Cherry Studio есть раскрывающееся меню интенсивности рассуждений. Но оно отображается только для моделей, которые клиент распознаёт как модели с поддержкой рассуждений. Судя по обсуждениям в issue сообщества, Cherry Studio определяет поддержку этой функции по встроенному каталогу моделей, который формируется при сборке на основе models.dev и OpenRouter. Информация о возможностях модели, полученная от интерфейса во время работы, при этом не учитывается. Поэтому для недавно выпущенной модели вроде Gemini 4 Argon меню может не отображаться, пока каталог клиента не обновят. Бывает и так, что нужный уровень можно выбрать, но он не влияет на запрос.
В такой ситуации надёжнее всего использовать функцию пользовательских параметров Cherry Studio. Согласно официальной документации, пользовательские параметры напрямую добавляются в тело запроса и имеют более высокий приоритет, чем встроенные параметры.
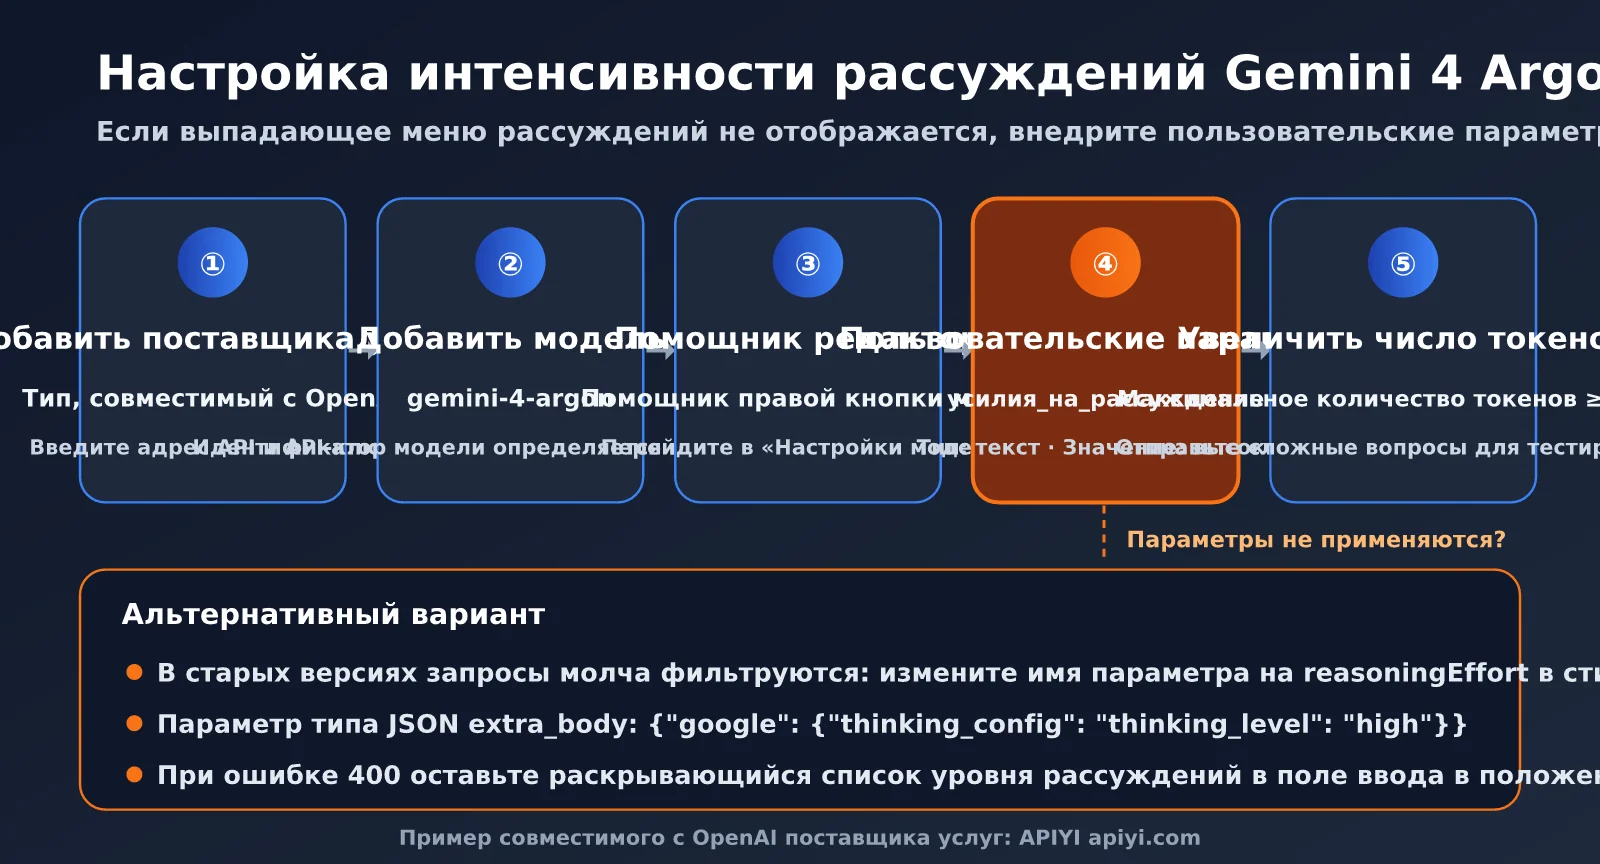
Как настроить пользовательские параметры в Cherry Studio
Ниже приведён полный порядок настройки для провайдера с OpenAI-совместимым интерфейсом:
- Добавьте провайдера: в настройках добавьте провайдера с поддержкой OpenAI-совместимого интерфейса и укажите адрес API и ключ, например
https://api.apiyi.comдля APIYI. - Добавьте модель: добавьте у провайдера модель с ID
gemini-4-argon. - Откройте настройки помощника: щёлкните правой кнопкой мыши по нужному помощнику в списке и выберите «Редактировать помощника», затем перейдите на вкладку «Настройки модели».
- Добавьте пользовательский параметр: укажите имя параметра
reasoning_effort, выберите тип «Текст» и задайте значениеhigh(илиlow,medium). - Увеличьте максимальный объём вывода: включите настройку «Максимальное количество токенов» и задайте более высокий лимит. Рекомендуется не менее 32000 токенов, чтобы оставить место для процесса рассуждений.
- Проверьте работу: задайте вопрос, требующий нескольких этапов рассуждения, и сравните время ответа и содержимое рассуждений до и после настройки.
Если после настройки интенсивность рассуждений не изменилась, проверьте распространённые причины:
| Что происходит | Возможная причина | Что делать |
|---|---|---|
После настройки reasoning_effort ничего не меняется |
Старые версии незаметно отбрасывают этот параметр в режиме OpenAI-совместимого интерфейса | Обновите Cherry Studio до последней версии или используйте имя параметра reasoningEffort |
| В поле ввода не отображается меню интенсивности рассуждений | Argon ещё не добавлена во встроенный каталог моделей | Используйте пользовательские параметры; опытные пользователи могут добавить сведения о поддержке рассуждений в конфигурацию модели |
| Запрос возвращает ошибку 400 | Клиент отправил неподдерживаемый Argon уровень, например max или xhigh |
Оставьте в меню значение «По умолчанию», а уровень low, medium или high задайте только через пользовательский параметр |
| Встроенная настройка перезаписывает параметр | Выбранный в поле ввода уровень рассуждений конфликтует с пользовательским параметром | Оставьте в поле ввода значение «По умолчанию», чтобы не настраивать оба параметра одновременно |
| Нужно передать нативные параметры | Требуется одновременно включить сводку рассуждений | Добавьте параметр типа JSON extra_body со значением {"google": {"thinking_config": {"thinking_level": "high"}}} |
Проблему, из-за которой reasoning_effort незаметно отбрасывался, Cherry Studio исправила в марте 2026 года с помощью PR. В новых версиях параметр автоматически преобразуется во внутренний reasoningEffort. Если у вас установлена старая версия, укажите имя параметра в формате camelCase: reasoningEffort.
В других популярных диалоговых клиентах принцип тот же: найдите раздел «Пользовательские параметры», «Дополнительное тело запроса» или «Расширенные параметры» и добавьте reasoning_effort на верхнем уровне тела запроса. Если клиент поддерживает только JSON, передайте нативный thinking_config через extra_body. После настройки сравните время ответа и расход токенов на одной и той же сложной задаче, чтобы убедиться, что параметр действительно работает.
🚀 Совет по выбору клиента: для подключения Gemini 4 Argon в Cherry Studio рекомендуется выбрать провайдера с OpenAI-совместимым интерфейсом — так параметры передаются надёжнее. APIYI apiyi.com предоставляет единый OpenAI-совместимый интерфейс. Достаточно настроить его в Cherry Studio один раз, чтобы использовать модели Gemini, Claude, GPT и других семейств.
Практические тесты уровня рассуждений Gemini 4 Argon и руководство по типичным ошибкам
Уровень рассуждений напрямую влияет на задержку, стоимость и качество ответа. Технический блог ComputingForGeeks провёл сравнительные тесты Argon на задачах администрирования — результаты полезны на практике.
| Показатель | По умолчанию (medium) | high | Разница |
|---|---|---|---|
| Среднее количество выходных токенов | 463 | 1,836 | Примерно в 4 раза |
| Средняя задержка | 5,5 секунды | 15,3 секунды | Примерно в 2,8 раза |
| Время до первого видимого токена | Около 4,3 секунды | 12–13 секунд | Сначала выдаётся около 1400 токенов рассуждений |
| Стоимость 9 вызовов (по стартовой цене) | $0.045 | $0.169 | Примерно в 3,8 раза |
| low / medium в сравнении с настройкой по умолчанию | Почти без отличий | — | На коротких задачах токены рассуждений не генерировались |
Эти данные показывают две вещи. Во-первых, на простых коротких задачах low, medium и настройка по умолчанию почти не отличаются: ни один из этих вариантов не генерирует токены рассуждений. По-настоящему «глубоко думать» модель начинает только на уровне high. Во-вторых, у режима high есть очевидная цена: стоимость возрастает почти в 4 раза, а задержка до первого токена — примерно на 8 секунд. Учтите, что тест охватывал только короткие промпты: на сложных и длинных задачах рассуждения могут появляться и при medium.
4 частые ошибки при настройке уровня рассуждений Gemini 4 Argon
Согласно руководству Google по миграции и тестам сообщества, при настройке уровня рассуждений Gemini 4 Argon чаще всего допускают следующие ошибки:
- Слишком маленькое значение max_tokens приводит к пустому ответу:
max_output_tokensучитывает и токены рассуждений, и токены основного ответа. В одном из тестов Argon на уровне high израсходовал все 1021 токен из лимитаmax_tokens, равного 1024, на рассуждения и в итоге вернул пустую строку. Причина завершения —MAX_TOKENS. При использовании high закладывайте не менее 16K–32K токенов. - Использование прежнего параметра thinking_budget вызывает ошибку:
gemini-3.1-pro-previewмолча преобразуетthinking_budgetв уровень рассуждений, а Argon возвращает ошибку 400. При миграции обязательно удалите этот параметр. - Параметры генерации, такие как temperature, игнорируются: в документации Google сказано, что бэкенд Argon игнорирует заданное вручную значение temperature. Параметры
frequency_penalty,presence_penaltyиcandidate_countприводят к ошибке 400. Для управления глубиной рассуждений используйте уровень рассуждений, а для задания формата ответа —response_schema. - Попытка снизить стоимость с помощью max_tokens даёт обратный эффект: Google рекомендует для снижения стоимости и задержки понижать уровень рассуждений, а не уменьшать
max_tokens, иначе ответ легко обрезать.
📊 Рекомендация по выбору уровня: для повседневных вопросов и простых задач программирования достаточно medium — настройки по умолчанию. Переключайтесь на high для сложного проектирования архитектуры, рефакторинга нескольких файлов и математических доказательств. Сравните расход токенов на разных уровнях в журнале вызовов платформы APIYI apiyi.com, чтобы найти оптимальный баланс качества и стоимости.
Часто задаваемые вопросы
Вопрос 1: У Gemini 4 Argon по умолчанию установлен уровень рассуждений high?
Нет. В стандартной версии `gemini-4-argon` по умолчанию используется medium. Уровень high по умолчанию включён только в `gemini-4-argon-cyber-permissive`, предназначенной для специалистов по киберзащите. Здесь Argon отличается от gemini-3.1-pro-preview, у которой по умолчанию установлен максимальный уровень high. Чтобы включить максимальные возможности рассуждения, явно задайте `thinking_level=»high»` или `reasoning_effort=»high»`.
Вопрос 2: Можно ли отключить рассуждения Gemini 4 Argon или установить уровень minimal?
Нет. Argon поддерживает только три уровня: low, medium и high. Если задать minimal или `thinking_budget`, сервер вернёт ошибку HTTP 400. При передаче `reasoning_effort=»minimal»` через совместимый с OpenAI интерфейс параметр преобразуется в low. Если нужна минимальная задержка, рассмотрите модели серии Gemini 3.x Flash и другие модели с уровнем minimal.
Вопрос 3: Что делать, если в Cherry Studio нет настройки уровня рассуждений?
Встроенный каталог моделей Cherry Studio пока не содержит Argon. Можно добавить пользовательский параметр `reasoning_effort` в разделе «Редактировать ассистента → Настройки модели», указав для него тип «Текст» и значение `high`. Пользовательские параметры имеют приоритет над встроенными. Для более стабильной передачи параметров рекомендуем использовать совместимых с OpenAI провайдеров, например APIYI apiyi.com.
Вопрос 4: Как проверить, что уровень рассуждений действительно применился?
Проще всего посмотреть количество выходных токенов в поле usage и время ответа: на уровне high их значения, а также задержка до первого токена, будут заметно выше, чем при настройках по умолчанию. В Cherry Studio также можно проверить, появляется ли содержимое рассуждений. Для сравнения задайте один и тот же сложный вопрос сначала на стандартном уровне, а затем на high.
Итоги
Главный вывод о настройке уровня рассуждений Gemini 4 Argon: по умолчанию используется medium, а не high. Это отличается от gemini-3.1-pro-preview, у которой по умолчанию включён максимальный уровень. При миграции, если не задать параметр явно, глубина рассуждений модели незаметно снизится на один уровень. Argon поддерживает только три уровня — low, medium и high. Параметры thinking_budget и minimal вызовут ошибку 400. При использовании уровня high нужно также выделить достаточно токенов на рассуждения в max_tokens.
Способ настройки зависит от интерфейса: в нативном SDK используется thinking_level, а в совместимом с OpenAI API — reasoning_effort. В клиентах вроде Cherry Studio, которые пока не поддерживают параметры рассуждений Argon, их можно передать через пользовательские параметры. Для повседневных задач рекомендуем оставить medium по умолчанию, а для сложных — при необходимости переключаться на high и выбирать уровень на основе результатов тестирования.
Мы рекомендуем подключаться к Gemini 4 Argon через платформу APIYI apiyi.com, используя совместимый с OpenAI интерфейс. Так в коде и клиентах вроде Cherry Studio можно гибко менять уровень рассуждений с помощью одного параметра — reasoning_effort.
Источники:
- Документация Google Gemini API по режиму Thinking: ai.google.dev/gemini-api/docs/thinking
- Документация Google Gemini API по совместимости с OpenAI: ai.google.dev/gemini-api/docs/openai
- Руководство для разработчиков Google Cloud по Gemini 4 Argon: docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-argon
- Документация Cherry Studio по настройке ассистента: docs.cherryai.com.cn
- GitHub Issues Cherry Studio #11987 и #19761: github.com/CherryHQ/cherry-studio
Автор: команда APIYI | Делимся практическим опытом подключения больших языковых моделей и настройки параметров. Больше руководств по подключению AI-моделей — на APIYI apiyi.com