Автор: когда телефоны и браузеры научились синтезировать речь локально, нужен ли облачный голосовой API? В статье разбираем вопрос по четырём критериям: офлайн-режим, приватность, качество звука и длинные тексты, выбор конкретной модели и единый счёт.
Всё больше мобильных систем и браузеров умеют озвучивать текст прямо на устройстве. Поэтому у команд, которые делают голосовые продукты, неизбежно встаёт вопрос: раз речь теперь синтезируется на устройстве, нужен ли ещё облачный голосовой API. Одни предлагают перейти целиком на локальный синтез и сэкономить на вызовах. Другие боятся, что локальных голосов не хватит для полноценного продукта.
Выбирать «или-или» тут не нужно. У локального и облачного синтеза свои границы. Всё зависит от того, нужен ли продукту офлайн-режим, насколько чувствительны ваши данные, какие требования к качеству звука и длинным текстам, и обязательно ли использовать конкретную модель.
Главная ценность: прочитав статью, вы сможете по четырём критериям решить, как разделить нагрузку между устройством и облаком в вашем продукте, без крайностей.
Речь на устройстве: главное коротко
Сначала разделим то, что можно утверждать, и то, что пока неизвестно. Общее направление понятно, но по задержке и качеству звука конкретных локальных моделей сопоставимых публичных цифр мало. Гадать не буду и везде помечаю такие пункты как неизвестные.
| Пункт | Подробности |
|---|---|
| Что изменилось | Системы смартфонов и браузеры умеют синтезировать речь из текста локально, без подключения к сети |
| Сильные стороны на устройстве | Работает офлайн, данные не покидают устройство, подходит для коротких фраз |
| Неизвестное для on-device | Единых публичных данных о задержке и оценках качества звука для разных решений нет, считаем неизвестными |
| Сильные стороны облака | Можно выбрать конкретную модель, один API-ключ для текстовых и голосовых моделей, стабильнее работает на длинных фрагментах |
| Облачные модели | По состоянию на 2026-11-12 в прайсе APIYI по-прежнему есть tts-1, tts-1-hd, gpt-realtime-2.1, gpt-realtime-2.1-mini |
| Кого касается | Продуктовые команды, которые делают озвучку, голосовых ассистентов и голосовой диалог в реальном времени |
Что речь на устройстве умеет, а что гарантировать не может
Главная польза от синтеза речи на устройстве проста: звук есть, даже когда нет сети. Навигационные подсказки, помощь при чтении, короткие звуковые уведомления в приложении — фразы короткие, запускаются часто, так что локального синтеза хватает, и к тому же не нужен сетевой запрос. Данные остаются на устройстве, а для продуктов, которые работают с чувствительными текстами (здоровье, финансы), это заметно снижает нагрузку по комплаенсу.
Но какие голоса и какое качество вы получите, зависит от самого устройства пользователя. Один и тот же продукт на смартфонах разных брендов и с разными версиями системы может звучать совершенно по-разному, и обеспечить единообразный опыт разработчику трудно. Насколько именно локальная модель медленнее облачной и насколько хуже по звуку, надёжных публичных цифр сейчас нет. Оценивать лучше на выборке реальных устройств вашего продукта.
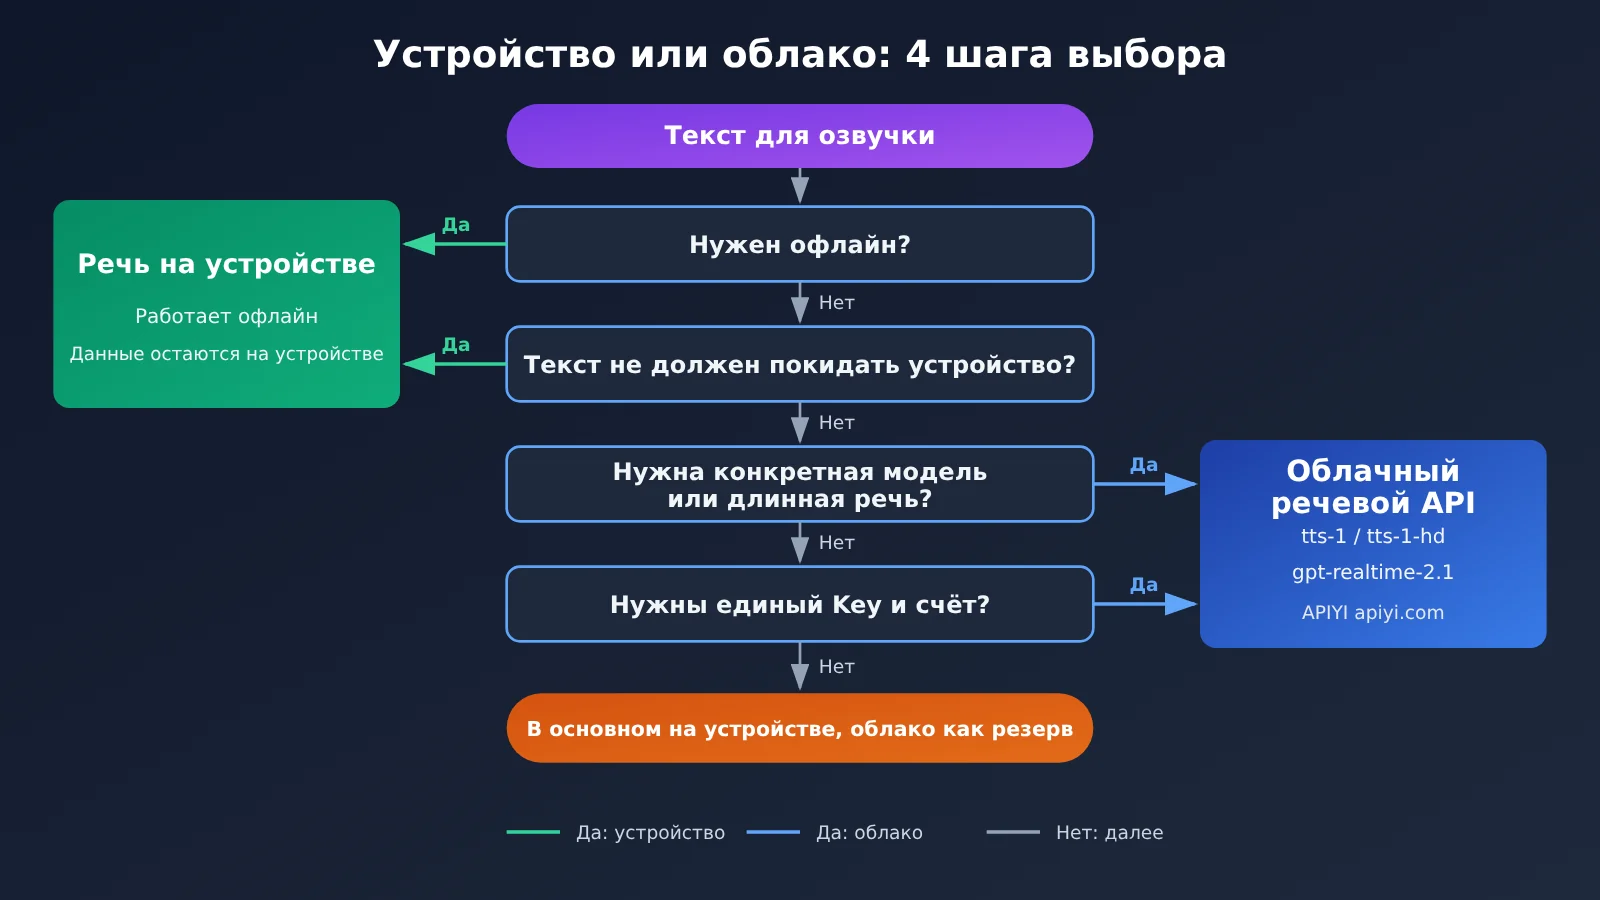
Как разделить задачи между голосом на устройстве и облачным голосовым API
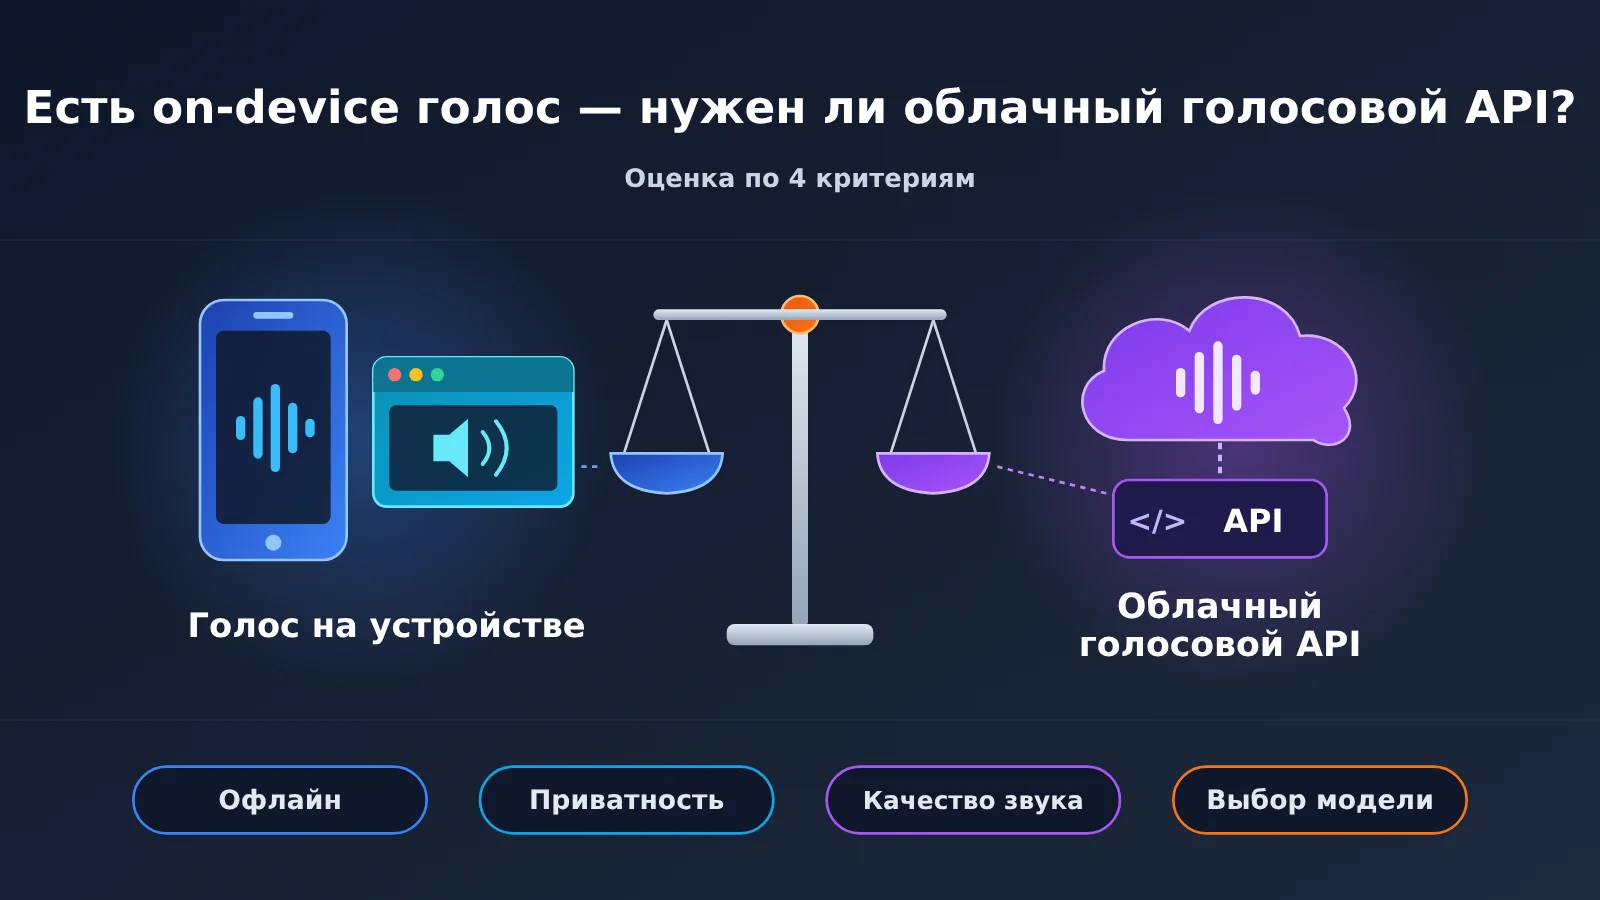
Если разбить вопрос на 4 измерения, это работает лучше, чем споры о том, «нужно ли оставлять облако». В таблице ниже для каждого измерения указано, какая сторона подходит лучше, и какой вопрос стоит себе задать при выборе.
| Измерение оценки | Лучше подходит голос на устройстве | Лучше подходит облачный голосовой API | Вопрос, который нужно задать |
|---|---|---|---|
| Офлайн | Нет сети или слабая сеть, но озвучка обязательна | Пользователи в основном онлайн | Должен ли продукт продолжать озвучку при отсутствии сети? |
| Приватность | Текст конфиденциален, выход за пределы устройства запрещён | Текст можно отправлять на обработку | Запрещают ли требования комплаенса передачу данных за пределы терминала? |
| Качество звука и длинная речь | Короткие фразы, звуковые подсказки, невысокие требования к тембру | Чтение длинных текстов, высокие требования к единообразию тембра | Допустимо ли, что разные устройства озвучивают текст разными голосами? |
| Конкретная модель и единый счёт | В этом нет необходимости | Нужно зафиксировать модель и использовать один ключ с текстовой моделью | Нужна ли конкретная модель вроде tts-1-hd или gpt-realtime-2.1? |
Офлайн и приватность: поле голоса на устройстве
Если ваш продукт часто используют в метро, в горах или в самолёте, офлайн-режим становится жёстким требованием, и основную озвучку должен брать на себя голос на устройстве. Аналогично, если по правилам бизнеса введённый пользователем текст нельзя загружать наружу, голос на устройстве — практически единственный вариант. В этих двух измерениях облачный голосовой API скорее «усиление при наличии сети», а не основное решение.
Качество звука, длинная речь и конкретная модель: поле облачного голосового API
Как только продукту нужен единый фирменный тембр, стабильное чтение длинных статей или голосовой диалог в реальном времени, заменить облако становится трудно. В облаке можно явно указать модель: например, tts-1 для обычной озвучки, tts-1-hd для более высокого качества, gpt-realtime-2.1 или gpt-realtime-2.1-mini для диалога в реальном времени. При этом все пользователи слышат результат одной и той же модели.
Ещё один момент, который часто упускают, — управление счетами и ключами. Помимо голоса, большинство продуктов вызывают текстовую большую языковую модель для понимания, суммаризации или генерации диалога. Если голос и текст работают через один и тот же ключ и один счёт, эксплуатация и сверка расходов заметно упрощаются.
Как подключить облачный голосовой API: оставляем один надёжный канал
Даже если вы решили делать ставку на обработку на устройстве, всё равно стоит оставить облачный канал — как запасной вариант и для усиления качества. APIYI использует OpenAI-совместимый интерфейс, так что подключение почти не отличается от работы с официальным SDK: нужно лишь заменить base_url.
Шаги подключения выглядят так:
- Инициализируем клиент:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Вызываем синтез речи:
client.audio.speech.create(model="tts-1", voice="alloy", input="您的订单已发货") - Если нужно более высокое качество звука, меняем model на
tts-1-hd, остальные параметры оставляем как есть - Текстовые модели тоже указывают на
https://api.apiyi.com/v1, голос и текст используют один и тот же ключ
Голосовой диалог в реальном времени (серия gpt-realtime-2.1) подключается иначе, чем обычный HTTP-запрос. Точные параметры подключения смотрите в документации APIYI.
| Модель | Тип | Типичное применение | Доступная платформа |
|---|---|---|---|
| tts-1 | Текст в речь | Обычное озвучивание, чтение уведомлений | APIYI apiyi.com |
| tts-1-hd | Текст в речь (высокое качество) | Озвучивание длинных текстов, фирменный голос | APIYI |
| gpt-realtime-2.1 | Голосовой диалог в реальном времени | Голосовые помощники, интерактивное общение | APIYI |
| gpt-realtime-2.1-mini | Голосовой диалог в реальном времени (лёгкая версия) | Сценарии реального времени, где важнее стоимость | APIYI |
🚀 Быстрый старт: если вы решаете, нужно ли оставлять облачную озвучку, зарегистрируйтесь на APIYI apiyi.com и используйте бесплатный тестовый лимит для новых пользователей. Отправьте один и тот же текст в tts-1 и tts-1-hd, а затем сравните результат с локальным озвучиванием на устройстве — так будет видно, стоит ли разница доплаты.
Анализ влияния: что изменится с появлением голоса на устройстве
Влияние на разработчиков
- Архитектура из «или-или» превращается в гибридную: в голосовом модуле нужен слой маршрутизации, который по состоянию сети, чувствительности и длине текста решает, куда отправить задачу: на устройство или в облако.
- Тестировать становится дороже: качество голоса на устройстве зависит от гаджета пользователя, поэтому нужно проверять выборку разных моделей телефонов и браузеров. Облачный вывод при этом остаётся относительно стабильным.
- Без запасного сценария не обойтись: если облако недоступно, система переключается на устройство, а если не работает голос на устройстве, возвращается в облако. Два канала страхуют друг друга.
Влияние на архитектуру продукта
Чаще всего гибридную архитектуру внедряют так: для каждого типа голосовых задач выбирают основной канал и резервный. Таблицу ниже можно взять как отправную точку для проектирования.
| Голосовая задача | Основной канал | Резервный канал | Причина |
|---|---|---|---|
| Короткие подсказки, голосовая навигация | Голос на устройстве | Облачный tts-1 | Короткие фразы вполне можно озвучить локально, а офлайн-режим обязан работать |
| Озвучка чувствительных текстов | Голос на устройстве | Без отката в облако | Данные не должны покидать устройство |
| Длинные статьи, аудиоконтент | Облачный tts-1-hd | Голос на устройстве | Одинаковый тембр и более стабильная озвучка длинных текстов |
| Голосовой диалог в реальном времени | Облачный gpt-realtime-2.1 | gpt-realtime-2.1-mini | Нужно явно указывать модель, а real-time-взаимодействие зависит от облака |
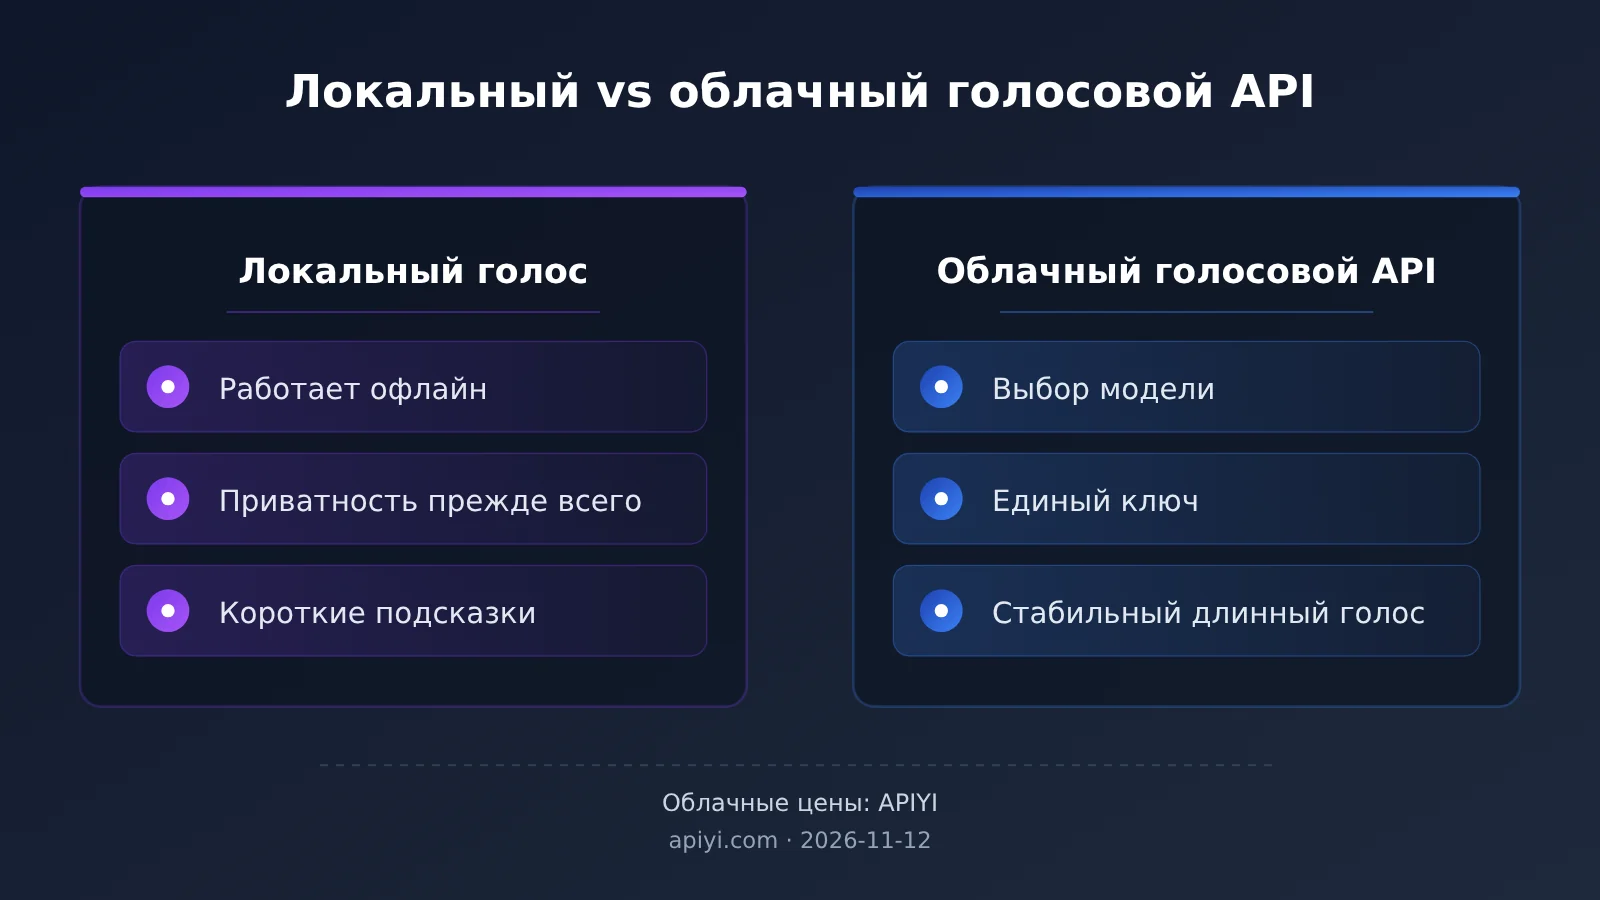
Влияние на расчёт затрат
Голос на устройстве не тарифицируется по вызовам, и именно поэтому многие команды хотят перенести всю озвучку на локальный уровень. Но экономия на вызовах может обернуться расходами на адаптацию и тестирование. Ещё часть пользователей уйдёт, если на слабых устройствах качество просядет. Разумнее перенести на устройство только частые короткие фразы, а задачи, чувствительные к качеству, оставить в облаке. Тогда нагрузка на облако снизится сама собой, а ключевой пользовательский опыт не пострадает.
Часто задаваемые вопросы (FAQ)
Q1: Если мы внедрили on-device-озвучку, можно ли сразу отключить облачный голосовой API?
Для большинства продуктов так делать не стоит. On-device решает вопросы офлайн-режима и приватности, но если нужна конкретная модель, стабильная работа с длинным аудио и единообразный тембр, без облака не обойтись. Надёжнее сделать on-device основным вариантом, а облако оставить как запасной и для улучшения качества.
Q2: Насколько on-device-озвучка уступает облачному голосовому API по качеству звука и задержке?
Единых публичных результатов тестов, на которые можно сослаться, сейчас нет, а качество on-device-решений сильно зависит от конкретного устройства. Поэтому мы считаем этот вопрос открытым. Рекомендуем выборочно прослушать результат на нескольких устройствах, которыми чаще всего пользуется ваша аудитория, и сравнить его с выводом облачных tts-1 и tts-1-hd.
Q3: Какие облачные голосовые модели сейчас можно вызывать?
По состоянию на 2026-11-12 в прайс-листе APIYI всё ещё доступны tts-1, tts-1-hd, а также модели для голоса в реальном времени gpt-realtime-2.1 и gpt-realtime-2.1-mini. Список моделей может меняться, поэтому ориентируйтесь на актуальный прайс-лист платформы.
Q4: Как вызывать голосовые и текстовые модели с одним ключом?
Получите один API-ключ на APIYI (apiyi.com) и укажите `base_url` равным `https://api.apiyi.com/v1`. Синтез речи, голос в реальном времени и текстовые модели вроде GPT, Claude и Gemini работают через одну точку входа. Счета тоже объединяются, так что расходы по факту использования удобно сверять.
Q5: Что делать, если в гибридной архитектуре облачный вызов завершился ошибкой?
Добавьте в слой маршрутизации голоса резервный сценарий. Если облачный запрос завис по таймауту или вернул ошибку, короткие неконфиденциальные фразы можно озвучить на устройстве, а для длинного аудио предложить пользователю повторить попытку позже. В сценариях диалога в реальном времени можно переключаться между gpt-realtime-2.1 и gpt-realtime-2.1-mini.
Ключевые выводы: голос на устройстве и облачный голосовой API
- Это не «или-или»: голос на устройстве и облачный голосовой API работают как разделение труда — каналы распределяются по задачам
- Устройство отвечает за офлайн и приватность: работает без сети, данные не покидают устройство — подходит для коротких фраз и звуковых подсказок
- Облако отвечает за качество и стабильность: длинную озвучку, фирменные голоса и диалог в реальном времени по-прежнему лучше доверить облачным моделям
- Конкретную модель можно выбрать только в облаке: чтобы зафиксировать tts-1-hd или gpt-realtime-2.1, придётся идти через API
- Данных о производительности на устройстве нет: там, где публичных цифр не существует, ориентируйтесь на выборочные замеры на собственных устройствах
- Единый ключ упрощает эксплуатацию: через APIYI (apiyi.com) голосовые и текстовые модели работают с одним API-ключом и одним счётом
Итоги
Нужен ли облачный голосовой API, если голос на устройстве уже запущен? Ответ зависит от четырёх параметров:
- Офлайн: задачи, которые должны работать без сети, отдаём голосу на устройстве
- Приватность: задачи, где текст не должен покидать устройство, обрабатываем только локально
- Качество звука и длинная озвучка: если важны единообразие и стабильность, оставляем эти задачи в облаке
- Конкретная модель и единый счёт: если нужно зафиксировать определённую модель и использовать один ключ вместе с текстовыми моделями, продолжаем работать через облачный API
Вывод простой: устройство закрывает офлайн и приватность, а выбор конкретной модели и единый счёт остаются за облаком. Рекомендую сначала перенести на устройство самые частые короткие фразы, а длинную озвучку и диалог в реальном времени оставить в облаке. Через APIYI (apiyi.com) можно единообразно вызывать tts-1, tts-1-hd и модели серии gpt-realtime-2.1. Проверьте результат на бесплатном тестовом лимите и только потом решайте, в какой пропорции распределять нагрузку между каналами.
📚 Справочные материалы
- Центр документации APIYI: описание синтеза речи и подключения к realtime-голосу
- Ссылка:
docs.apiyi.com -
Описание: параметры вызова и способы подключения моделей tts-1, gpt-realtime-2.1 и других
-
Справочный центр APIYI: руководства по работе с платформой и ответы на частые вопросы
- Ссылка:
help.apiyi.com - Описание: пригодится при первом подключении — там рассказано, как получить ключ, как устроено тарифицирование и где посмотреть список моделей
Автор: техническая команда APIYI
Обратная связь: пишите нам на главной странице сайта APIYI apiyi.com, а больше материалов найдёте в центре документации docs.apiyi.com