Примечание автора: когда вы обращаетесь к большой языковой модели через сторонний API, по качеству ответов невозможно понять, какая модель на самом деле работает. Эта статья — разбор открытого проекта Anthropic FlashProve: как он с помощью zkSNARK привязывает результат инференса к конкретным весам, во сколько это обходится, что доказательство подтверждает, а что нет, и насколько всё это далеко от повседневных вызовов API.
2 ноября 2026 года команда Anthropic Frontier Red Team вместе с исследователями из EPFL, MIT и других организаций выпустила FlashProve — открытый прототип доказуемого инференса для больших языковых моделей. На Llama 4 Maverick с 400 млрд параметров одно доказательство генерируется на единственной H100, весит около 19 МБ и проверяется на обычном CPU за десять с небольшим секунд.
Это не концепт-демо и не продукт для красивых презентаций. Вместе с ним Anthropic опубликовала технический отчёт, спецификацию протокола, рабочий код доказывающей стороны и сразу два варианта верификатора, а также формальное доказательство на Lean — всё под лицензией Apache 2.0. Правда, там же прямо сказано: это промежуточный результат исследования, и до полной цели ещё порядочно пути.
Что вы получите от статьи: станет понятно, почему при работе через сторонний API так трудно подтвердить «личность» модели, каким механизмом FlashProve это решает, в чём его реальная цена и где проходят границы его возможностей, и что вы как пользователь API можете сделать уже сейчас.
Почему при вызове через сторонние API возникает проблема доверия к идентичности модели
Когда вы отправляете запрос через любой API, в ответ приходит только кусок текста и поле с названием модели. Anthropic прямо пишет в своём исследовательском блоге: сегодня пользователь не может убедиться, что ответ действительно пришёл от той модели, которую заявляет разработчик. Её могут тихо подменить на стороне сервиса-прокси API ради экономии, а могут и вмешаться в поток токенов — например, это сделает атакующий.
Что важнее: высокое качество ответа ещё не означает, что модель настоящая. Дешёвая модель на некоторых вопросах тоже отвечает хорошо, а «урезанную» версию на глаз не всегда отличишь от оригинала. Даже если выложить в открытый доступ полную историю чата, теоретически её можно подделать с помощью более дешёвой модели, так что такие свидетельства не доказывают ничего наверняка.
Проверить подлинность по-настоящему тоже непросто. Веса передовых моделей в основном закрыты, а если бы они и были доступны, вычислений для повторного прогона инференса потребовалось бы намного больше, чем может позволить себе обычный пользователь или даже организация, занимающаяся оценкой моделей. Anthropic выделяет несколько типичных сценариев, где возникает эта проблема доверия:
- Сторонние сервисы-прокси API: клиент хочет убедиться, что полученные токены сгенерированы именно той моделью, за которую он заплатил.
- Независимая оценка: организациям, которые тестируют модели, нужно убедиться, что до и после релиза они проверяют ту самую модель, которая реально работает в продакшене.
- Обнаружение вмешательства: если сервер инференса взломан, атакующий может подмешивать вредоносные ответы и даже доставлять вредоносное ПО на компьютеры пользователей.
- Регулирование и комплаенс: регулятор может потребовать, чтобы развёртывались только модели, прошедшие проверку безопасности, или подтвердить, что оборудование действительно занимается инференсом, а не втайне обучает модель.
Цель доказуемого инференса (Provable Inference) — дать пользователю с ограниченными вычислительными ресурсами и без доступа к весам возможность проверить, что конкретный ответ действительно выдала запрошенная модель.
FlashProve: ключевые факты
| Параметр | Детали |
|---|---|
| Дата выхода | 2 ноября 2026 года |
| Разработчик | Anthropic Frontier Red Team совместно с исследователями из EPFL, MIT, StarkWare, Succinct и других организаций |
| Основная технология | zkSNARK (zero-knowledge succinct non-interactive argument of knowledge, «краткое доказательство знания с нулевым разглашением»), построенная на хеш-функциях и устойчивая к квантовым атакам |
| Тестовая модель | Llama 4 Maverick: 400B параметров, архитектура MoE, около 17B активных параметров на токен, открытые 4-битные квантованные веса |
| Что опубликовано | Исследовательский блог, технический отчёт, спецификация протокола, написанная Claude, код доказывающей стороны и двух верификаторов (на C++ и Lean), доказательства на Lean и инструменты визуализации |
| Лицензия | Apache 2.0 |
| Текущий статус | Исследовательский прототип: авторы делятся промежуточными результатами и будут рады внешним улучшениям |
Отдельно стоит отметить: по словам Anthropic, значительную часть оптимизаций в системе сделал сам Claude. Когда ИИ работает над большой и сложной системой, он принимает решения, которые трудно проверить. Чтобы подстраховаться, команда записала на Lean главные гарантии безопасности в виде утверждений, которые можно аудировать.
Как FlashProve доказывает, что ответ выдала именно указанная модель
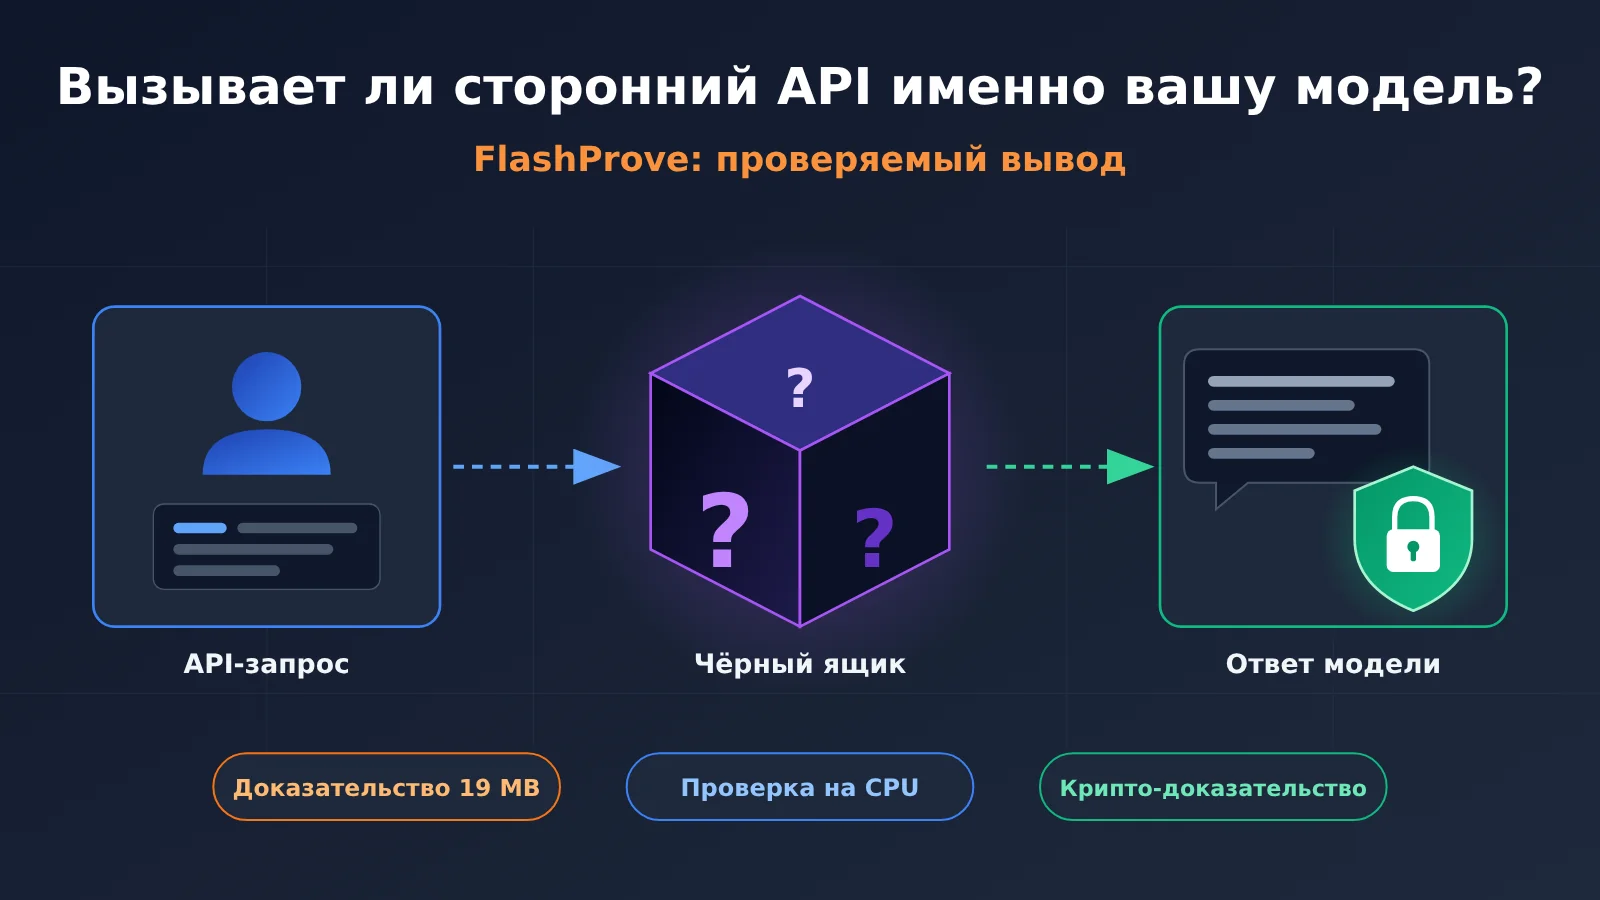
В FlashProve всего две роли: поставщик модели выступает доказывающим (Prover), а пользователь — проверяющим (Verifier). Процесс делится на офлайн- и онлайн-этап, плюс проверка на стороне пользователя.
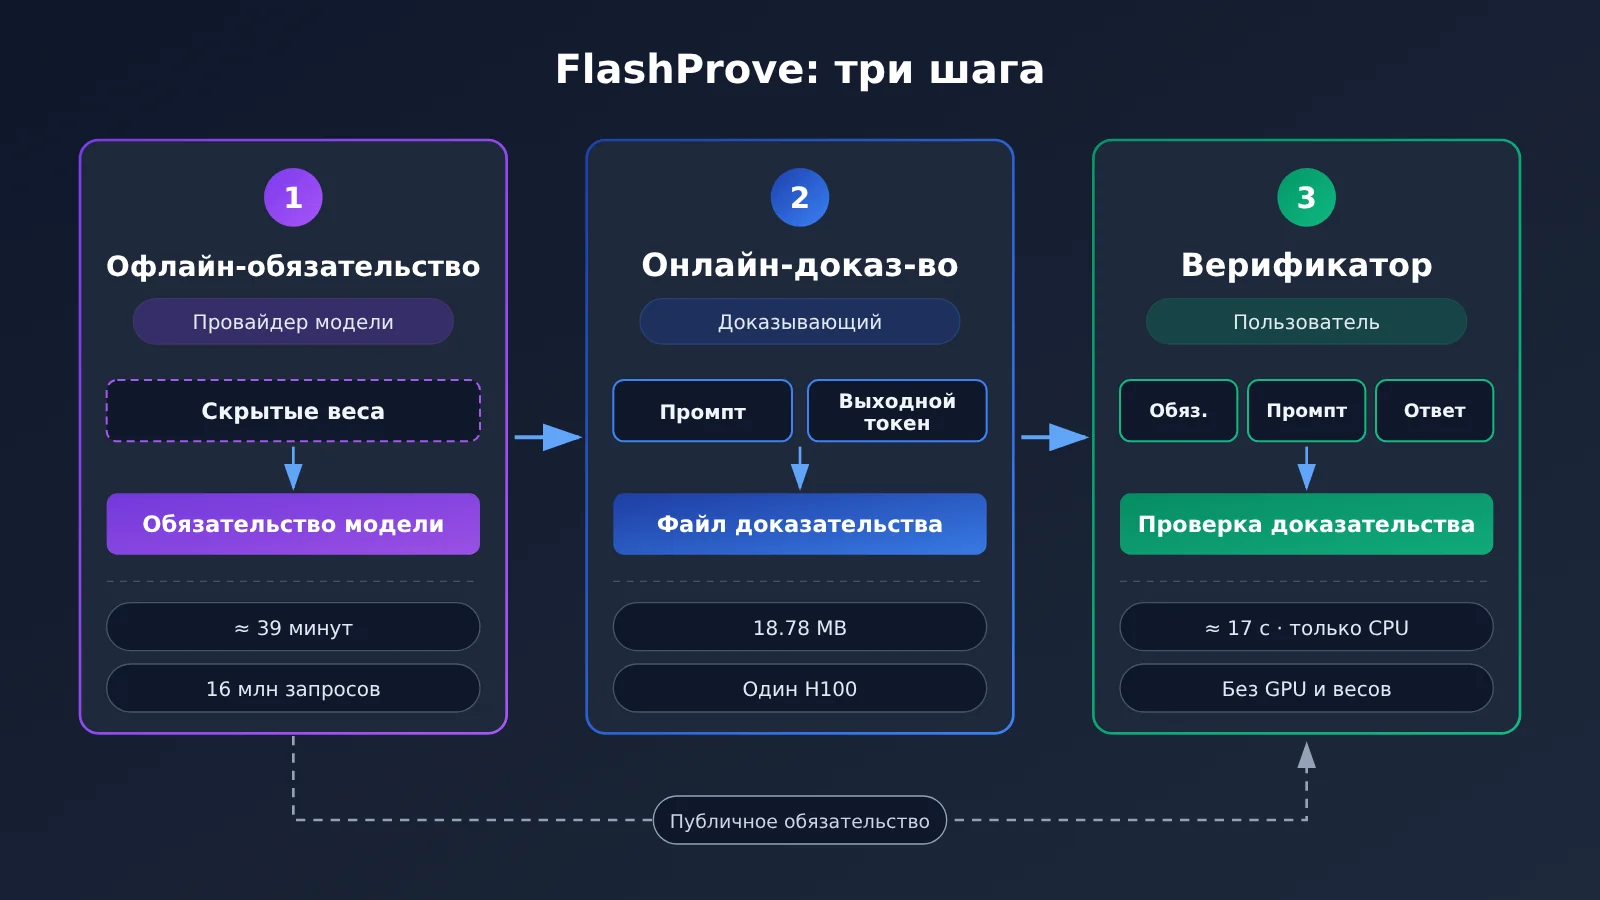
Три шага механизма FlashProve
- Офлайн-обязательство модели (Model Commitment): доказывающий публикует обязательство для весов модели — по сути, очень короткий «отпечаток». Он фиксирует конкретный набор весов, но сами веса остаются скрытыми. В тестах этот шаг выполняется один раз для каждой модели и занимает около 39 минут. Полученного обязательства хватает примерно на 16 млн запросов, после чего его нужно создавать заново.
- Генерация доказательства онлайн: получив запрос от проверяющего (промпт и соответствующие выходные токены), доказывающий создаёт файл доказательства. Утверждение, которое он подтверждает: «модель, на которую дано обязательство, при работе выдаёт именно эти выходные токены».
- Проверка на стороне пользователя: любой, у кого есть обязательство, промпт и ответ, может проверить доказательство. Веса для этого не нужны, хватит и скромных вычислительных ресурсов. В итоге можно быть уверенным, что зафиксированные веса на этом промпте дали ровно эти токены.
Четыре свойства безопасности FlashProve
Первые два свойства (полнота и надёжность) на самом деле обеспечит и сам верификатор: если он знает веса и у него хватает вычислительных мощностей, он просто пересчитает всё заново. Настоящий смысл системе придают два последних свойства:
- Полнота (Completeness): доказательство, сгенерированное честным доказывающим, всегда будет принято.
- Надёжность (Soundness): подделать корректное доказательство ложного утверждения так же сложно, как взломать широко признанные криптографические предположения. Поэтому верификатору не нужно доверять доказывающему.
- Нулевое разглашение (Zero Knowledge): верификатор не узнает ни веса, ни промежуточные значения вычислений, ни то, какие эксперты были активированы на каждом слое. Архитектура модели при этом не скрывается.
- Лаконичность (Succinctness): доказывается один прогон квантованной модели размером около 232 ГБ, а верификатор получает файл всего около 19 МБ, который можно проверить за несколько секунд на 24-ядерном CPU.
Как архитектура MoE снижает затраты на доказательство в FlashProve
Ускорение FlashProve во многом строится на структуре MoE (Mixture of Experts, смесь экспертов). В Llama 4 Maverick на каждый токен задействуется лишь около 17B параметров из 400B, и объём работы доказывающего пропорционален именно этим ~17B. При этом доказательство по-прежнему скрывает, какие именно эксперты были выбраны.
Ещё два инженерных решения тоже играют важную роль. Первое — пакетное доказательство постфактум: доказывающий, как при Prefill, за один раз параллельно читает уже готовый текст, и для каждого батча веса раскрываются (открывается обязательство на веса) лишь один раз. Второе — работа на одной карте: веса разбиваются на сегменты по слоям, и каждый сегмент доказывается по очереди. Сегменты потоково подгружаются из обычной оперативной памяти, так что хватает одной GPU на 80 ГБ и около 290 ГБ памяти на хосте.
FlashProve: реальные данные по стоимости доказательства
Стоимость — главный показатель, по которому можно понять, применимо ли доказуемое выполнение инференса (provable inference) на практике. Тестовая среда Anthropic выглядела так: на стороне доказательства — одна H100 и 24 ядра CPU, на стороне проверки — только CPU, а каждый запрос представлял собой окно в 1024 токена.
| Этап | Показатель | Измеренное значение |
|---|---|---|
| Офлайн-обязательство | Время / срок действия | около 39 минут / около 16 млн запросов |
| Онлайн-доказательство | Время на батч из 24 запросов | около 223 секунд |
| Онлайн-доказательство | Пропускная способность | около 110 токенов/с |
| Файл доказательства | Размер одного файла | 18,78 МБ |
| Загрузка на стороне проверки | Размер обязательства по весам | около 6,5 МБ |
| Время проверки | 24 потока / один поток | 17 секунд / 21 секунда (включая проверку офлайн-этапа) |
| Сравнение с vLLM | Кратность по времени на одной GPU | около 72× (66–77×), при максимальной нагрузке около 94× |
Базовая линия для сравнения — та же модель в версии FP8, запущенная через vLLM на 8 картах H100. Проще говоря, на доказательство батча запросов уходит в 70–95 раз больше GPU-времени, чем на обычную обработку того же батча. Это примерно два порядка дополнительных затрат.
110 токенов/с — это не доказательство полного ответа в реальном времени
Именно здесь FlashProve чаще всего понимают неправильно. В техническом отчёте прямо оговорено: каждое доказательство на самом деле проверяет всего один токен после промпта. Цифра 110 токенов/с — это пропускная способность обработки окна запроса на стороне доказательства, а не скорость пошаговой проверки каждого токена полного ответа.
| Способ подсчёта | Пропускная способность | Пояснение |
|---|---|---|
| Батч из 24 запросов, считая по объёму обработанных окон | около 110 токенов/с | Цифра из заголовка блога; каждое доказательство проверяет один токен |
| Проверка каждого токена ответа, считая по проверенным токенам | 39,1 токенов/с | Ближе к сценарию «проверить ответ целиком» |
| Доказательство одного запроса отдельно | 17,6 токенов/с | На одно доказательство уходит около 58 секунд, преимущество батчинга теряется |
Поэтому утверждение «FlashProve уже умеет доказывать полный ответ в реальном времени» неточно. Корректнее сказать так: в условиях батчинга, короткого контекста и доказательства постфактум система снизила стоимость доказуемого инференса до уровня, который раньше казался недостижимым.
FlashProve и существующие решения для доказуемого инференса
В академической среде доказуемый инференс обычно называют zkML. Anthropic в своём блоге разобрала, как продвигается эта область, и цифры там говорят сами за себя.
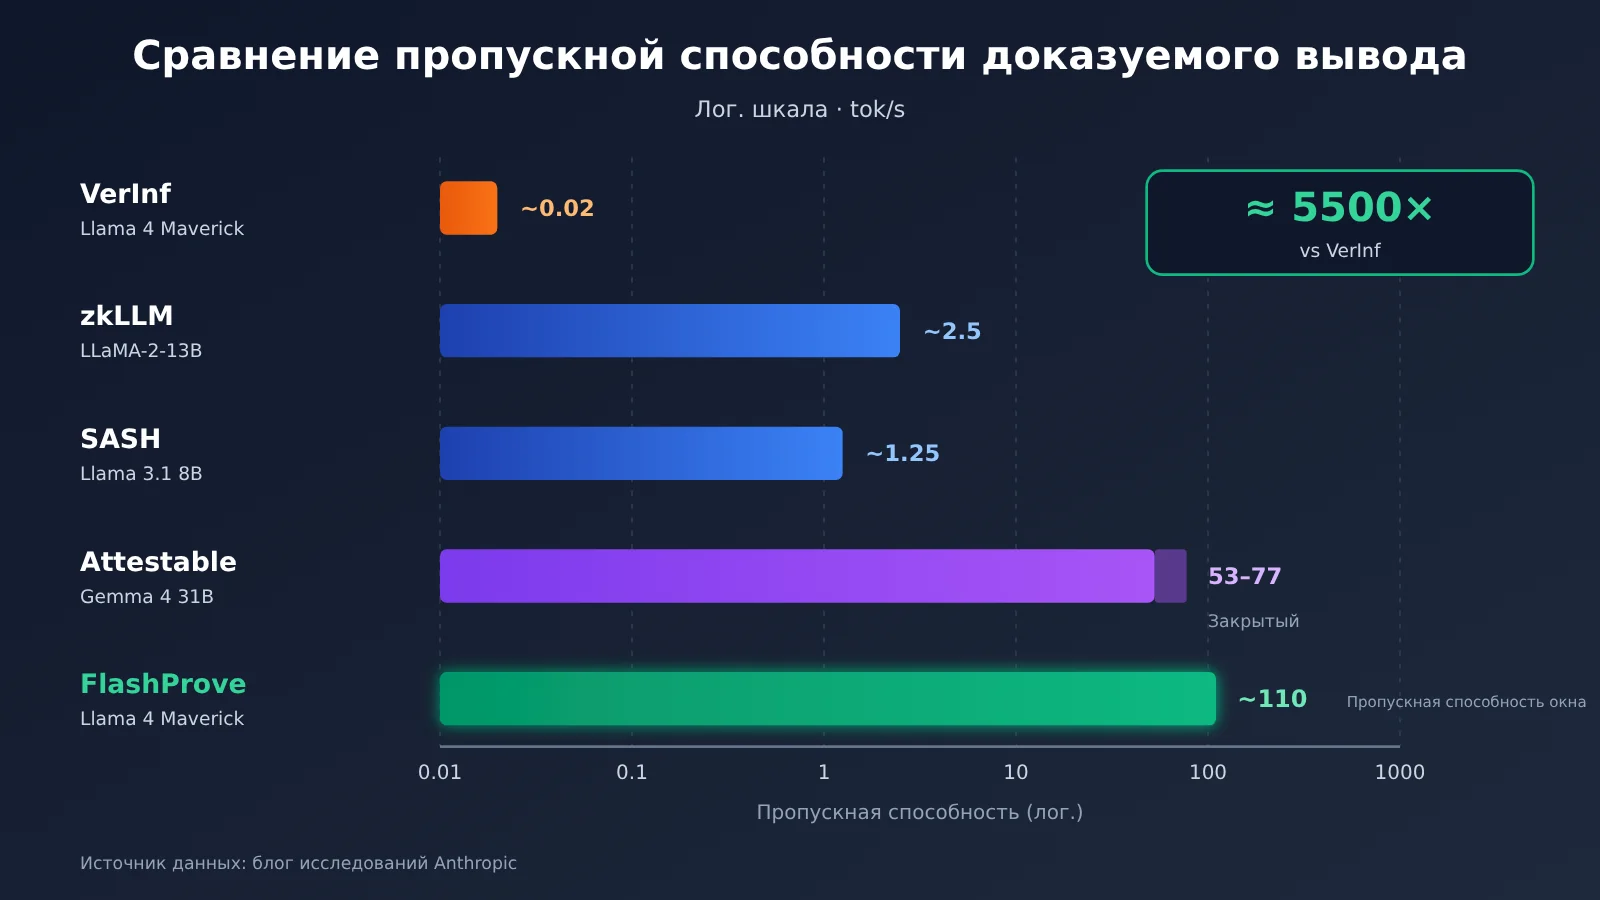
| Решение | Что доказывается | Пропускная способность / время | Примечания |
|---|---|---|---|
| VerInf | Llama 4 Maverick (400B MoE) | около 0,02 токенов/с, на 1000 токенов уходит 14,3 часа | Доказательство весит 93,6 ГБ, проверка занимает почти сутки |
| zkLLM (2024) | LLaMA-2-13B | в пакетном режиме около 2,5 токенов/с | Одна A100 |
| SASH (2026) | Llama 3.1 8B | около 1,25 токенов/с | Одна H100 |
| Attestable | Gemma 4 31B (плотная модель) | 53–77 токенов/с | Коммерческое решение, пока без открытого кода |
| FlashProve | Llama 4 Maverick (400B MoE) | около 110 токенов/с | Доказательство около 19 МБ, проверка за секунды, открытый код |
Сравнение с VerInf. VerInf — единственное из известных ранее решений, которое доказывало работу той же модели. Но доказательство весит 93,6 ГБ, а проверка длится почти сутки, так что на практике этим почти невозможно пользоваться. FlashProve сжимает доказательство примерно до 19 МБ, а проверку сокращает до десятка секунд. Благодаря этому сторонний аудит на обычном CPU впервые стал реально осуществимым.
Сравнение с Attestable. На плотных моделях Attestable показывает впечатляющие коммерческие результаты, но на момент написания блога соответствующей открытой библиотеки у него не было. Преимущество FlashProve в том, что код, доказательства на Lean и документация полностью открыты: любой может воспроизвести результат и улучшить его. Цена за это — сильная зависимость от MoE-архитектуры.
Что FlashProve может доказать, а что нет
Для пользователей сторонних API важно понимать не только возможности системы, но и её границы. В таблице ниже собраны ключевые ограничения из исследовательского блога и технического отчёта:
| Аспект | Что FlashProve умеет | Что FlashProve пока не умеет |
|---|---|---|
| Идентичность модели | Доказывает привязку к конкретному обязательству (commitment) на веса и подтверждает, что это «та самая модель, которая была заявлена» | Не может доказать, что обязательство соответствует модели под конкретным коммерческим названием, для этого нужно отдельное публичное обязательство |
| Корректность вывода | Доказывает, что проверяемые токены получены жадным декодированием (greedy decoding) целочисленной версии модели | Напрямую не покрывает вывод при использовании чисел с плавающей запятой и случайного сэмплирования (temperature больше 0) |
| Приватность | Само доказательство не раскрывает веса | Не скрывает архитектуру модели; атаки по побочным каналам, например по времени генерации, в зону защиты не входят |
| Длина контекста | Поддерживает контекст до 1024 токенов | Это намного меньше привычных для чатов десятков и сотен тысяч, а то и миллионов токенов |
| Момент защиты | Обнаруживает нарушения целостности постфактум | Не может помешать тому, чтобы подменённый ответ сначала дошёл до пользователя |
| Архитектура модели | Подходит для MoE-моделей | Плотные (dense) модели и другие архитектуры требуют дальнейших исследований |
Ограничения обнаружения у FlashProve при постфактумном доказательстве
FlashProve использует постфактумное доказательство (Post-hoc Proving): пользователь сначала получает ответ, затем независимый сервер-доказатель заново пересчитывает его и генерирует доказательство, а в конце результат проверяет верификатор. Такой подход позволяет доказательству работать помедленнее, зато не приходится искать компромисс между безопасностью и эффективностью. Цена за это — задержка в защите: если доказательство не проходит, оно лишь выявляет проблему, но не защищает пользователя до того, как он получил ответ.
В техническом отчёте также предупреждают: если сама система логирования находится под контролем злоумышленника, он может отправлять пользователю подменённое содержимое, а в логах оставлять только корректный результат. Поэтому FlashProve нужно использовать вместе с другими мерами безопасности — доверенным логированием, контролем доступа и так далее.
Что осталось незавершённым в формальной верификации FlashProve
Фразу «формальное доказательство в Lean» легко понять как «корректность всей системы доказана», но это не так. В техническом отчёте перечислены такие границы:
- Доказательство свойства нулевого разглашения в Lean сейчас охватывает только доказательство для одиночного запроса, пакетные доказательства пока не покрыты.
- Код GPU-доказателя сгенерирован ИИ на основе представления в Lean, и его эквивалентность этому представлению пока не доказана.
- Повседневно используемый быстрый верификатор на C++ тоже написан ИИ, формальных гарантий для него нет — известно лишь, что в тестах его выводы полностью совпали с выводами верификатора на Lean.
- Длинный документ со спецификацией протокола сгенерирован ИИ, авторы не проводили его детальную проверку, поэтому его стоит воспринимать отдельно от технического отчёта, написанного авторами.
Эти ограничения не обесценивают исследование. Они лишь показывают, что формальная верификация пока фиксирует математические свойства на уровне протокола, а разрыв между исполняемым кодом и протоколом по-прежнему приходится закрывать ручным аудитом или аудитом с помощью агентов.
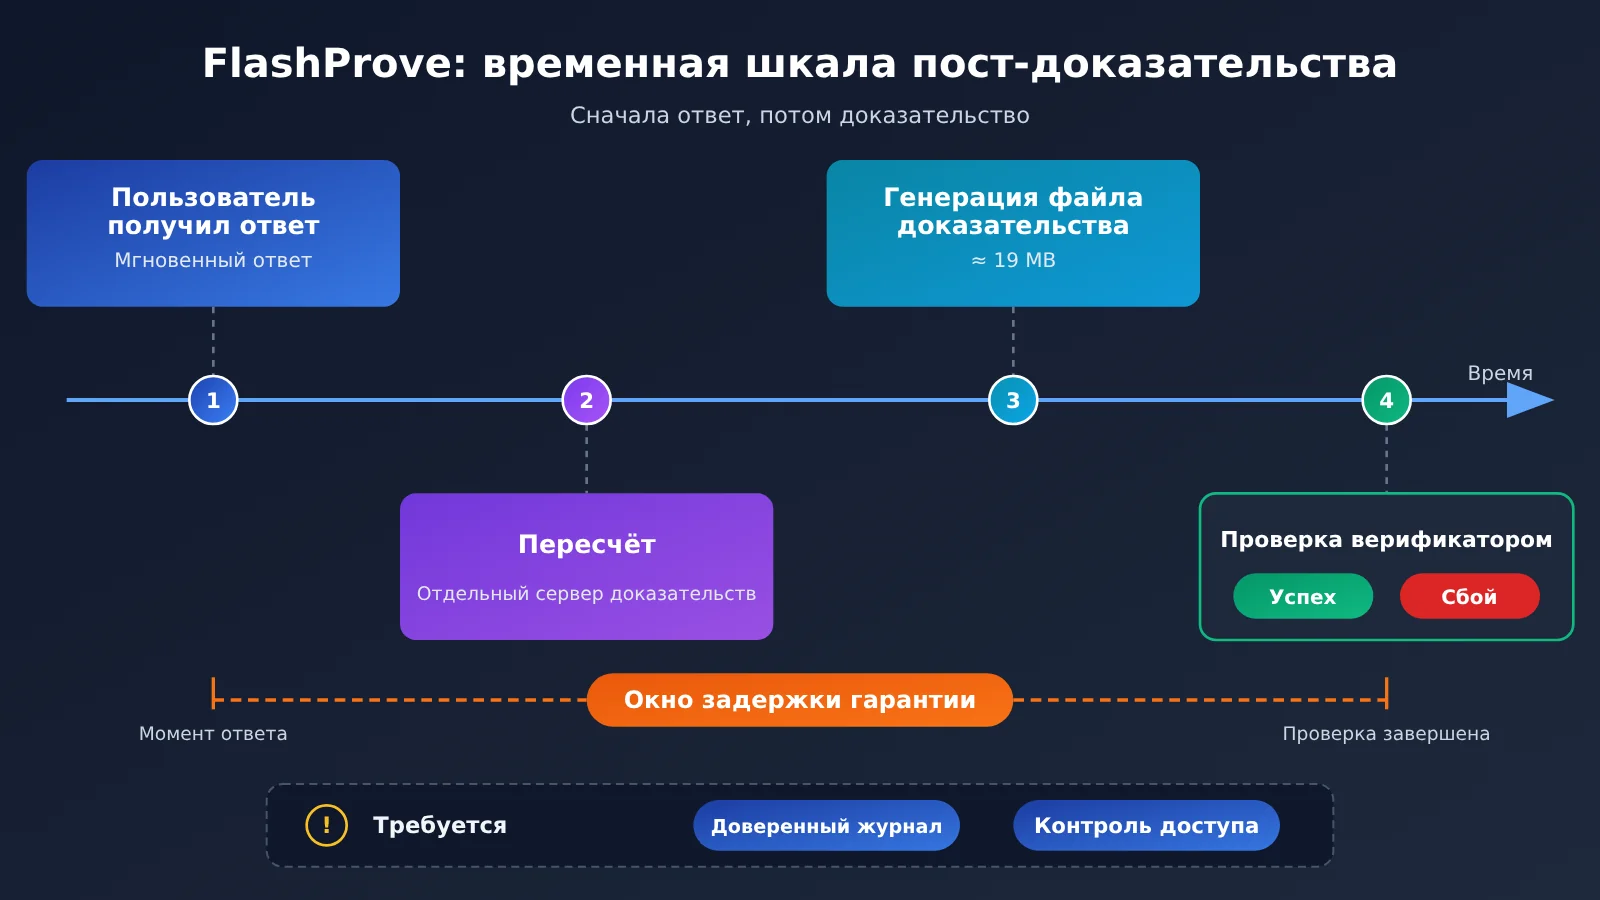
Анализ влияния: насколько FlashProve далёк от повседневных вызовов сторонних API
Что это значит для разработчиков и пользователей API
- В ближайшее время в обычную цепочку вызовов это не попадёт: накладные расходы на GPU примерно на два порядка выше, файл доказательства размером около 19 МБ на каждый запрос, ограничение контекста в 1024 токена — всё это мешает напрямую использовать систему в высоконагруженных диалоговых API.
- Область применения узкая: система предполагает архитектуру MoE, целочисленные (квантованные) модели и жадное декодирование, тогда как большинство продакшн-вызовов работает со случайным сэмплированием и вычислениями в плавающей точке — напрямую такой подход не переносится.
- Ценность скорее на уровне понимания: впервые «проверка личности модели» превратилась из невыполнимой задачи в инженерную. Разработчикам стоит осознать, что поле с именем модели в ответе, ID модели или обычные логи запросов — это не то же самое, что криптографическое доказательство.
💡 Совет по выбору: пока доказуемый инференс не повзрослел, при выборе стороннего сервиса важнее обращать внимание на прозрачность биллинга, прослеживаемость логов вызовов и воспроизводимость собственных тестов. При работе через агрегационные платформы вроде APIYI apiyi.com можно одновременно обращаться к нескольким моделям и сохранять полную историю вызовов — это удобно для собственных перекрёстных сравнений и аудита.
Что это значит для отрасли и регуляторов
- В наборе инструментов оценки и комплаенса появился ещё один вариант: регулятор может потребовать от провайдера прикладывать доказательства к запросам за определённый период — подтверждение того, что железо действительно обслуживает указанную модель, при этом не раскрывая проприетарные веса. Но Anthropic признаёт и другое: это не доказывает, что на том же железе не ведётся обучение на стороне.
- Программные решения и доверенное железо дополняют друг друга: доверенная среда исполнения (TEE) опирается на защиту от вмешательства со стороны производителя, zkSNARK — на сложность вычислительной задачи, так что подделать доказательство не выйдет, даже если взломаны железо и операционная система. Каждый подход найдёт своё место в своих сценариях.
- Anthropic в производственной проверке идёт другим путём: в обновлённом 19 октября 2026 года Frontier Safety Roadmap компания упоминает, что её проект верификации инференса уже имеет прототип, работающий на реальном продакшн-трафике: подпись покрывает внутренний поток токенов, а вычисления пересчитываются на доверенном сервере. Однажды удалось поймать крайне редкую и неумышленную аномалию целостности. Проект переименован в inference verification — это связанная с FlashProve, но отдельная инициатива, и путать их не стоит.
Что может сделать разработчик, который работает через сторонний API: вести собственный журнал вызовов
Криптографические доказательства пока недоступны, так что разработчикам остаётся сделать хотя бы «отслеживаемость». В примере ниже при вызове фиксируется temperature=0, а в локальный лог записываются время запроса, ID запроса, поле модели из ответа и хеш ответа. Это пригодится для последующих проверок на согласованность. Важно понимать: это лишь инженерная запись для аудита, а не криптографическое доказательство подлинности модели.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Совместимый с OpenAI интерфейс APIYI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话解释零知识证明"}],
    temperature=0
)
print(resp.model, resp.id)
print(resp.choices[0].message.content)
Показать полный код аудита вызовов
import hashlib
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Один ключ для вызова моделей разных провайдеров
)

def audited_call(prompt: str, model: str, log_path: str = "audit.jsonl") -> str:
    """Вызывает модель и записывает информацию для отслеживаемости (не криптографическое доказательство)"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        max_tokens=512,
    )
    content = resp.choices[0].message.content or ""
    record = {
        "ts": int(start),
        "latency_s": round(time.time() - start, 3),
        "requested_model": model,
        "returned_model": resp.model,   # Всего лишь заявленное сервером поле
        "request_id": resp.id,
        "prompt_sha256": hashlib.sha256(prompt.encode()).hexdigest(),
        "output_sha256": hashlib.sha256(content.encode()).hexdigest(),
        "usage": resp.usage.model_dump() if resp.usage else None,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return content

# Фиксируем набор пробных промптов, периодически перезапускаем и сравниваем хеши ответов и распределение задержек
probes = ["计算 37*43 并只输出结果", "列出三种排序算法的时间复杂度"]
for p in probes:
    for m in ["gpt-4o-mini", "claude-sonnet-4-5"]:
        print(m, audited_call(p, m)[:60])
🚀 Быстрый старт: на APIYI (apiyi.com) можно получить бесплатный тестовый лимит и с помощью скрипта с пробными промптами выше регулярно перепроверять сразу несколько моделей. Но учтите: такой подход лишь повышает отслеживаемость и не заменяет доказательства на уровне весов, как у FlashProve.
Помимо этого, пригодится ещё несколько практик: указывать конкретный ID модели, а не расплывчатый алиас; хранить набор пробных промптов и годами следить за изменением ответов и задержек; для критичных задач запрашивать сразу несколько моделей и сверять результаты; следить, не объявляют ли провайдеры публичные обязательства по весам или проверяемые механизмы.
Частые вопросы (FAQ)
Q1: Что такое FlashProve?
FlashProve — это исследовательский прототип доказуемого инференса, который Anthropic выложила в open source в ноябре 2026 года. Он построен на zkSNARK: провайдер модели сначала фиксирует обязательство по весам, а затем генерирует доказательство для результата инференса. Пользователю не нужны сами веса — достаточно CPU, чтобы проверить, что ответ действительно получен от той модели, по весам которой было дано обязательство.
Q2: Чем FlashProve отличается от проекта Anthropic по верификации инференса (inference verification)?
Цели у них похожие, а реализация разная. В проекте по верификации инференса прототип уже построен на реальном продакшен-трафике: там подписывается внутренний поток токенов, а затем он пересчитывается на доверенном сервере. FlashProve — это чисто программное криптографическое доказательство, и пока это по-прежнему исследовательский прототип. Путать эти две вещи не стоит.
Q3: Означают ли 110 tokens/s у FlashProve, что можно доказывать полный ответ в реальном времени?
Нет. 110 tokens/s — это пропускная способность обработки окон при батчинге, и каждое доказательство проверяет всего один токен. Если проверять каждый токен в ответе, пропускная способность составит 39,1 tokens/s, а при доказательстве на один запрос она падает до 17,6 tokens/s. Плюс ко всему процесс работает постфактум, уже после генерации.
Q4: APIYI уже предоставляет доказательства FlashProve для каждого ответа?
Нет. Сейчас нет никаких материалов, подтверждающих, что APIYI apiyi.com развернула FlashProve или выдаёт криптографические доказательства на уровне весов. Название модели в ответе и логи вызовов — это не то же самое, что криптографическое доказательство. На данном этапе практичнее другое: использовать единый интерфейс платформы и записи вызовов, чтобы самостоятельно перепроверять результаты и сравнивать их между собой.
Q5: Как быстро проверить согласованность нескольких моделей через API?
Удобнее всего через агрегатор, который поддерживает несколько моделей:
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ вместе с бесплатной тестовой квотой.
2. Укажите в коде из этой статьи `base_url` равным `https://api.apiyi.com/v1`.
3. Зафиксируйте `temperature=0`, регулярно прогоняйте пробные промпты и записывайте хеши выходных данных.
Такой подход помогает замечать аномальные колебания, но это инженерный аудит, а не подтверждение подлинности модели.
Q6: Какие известные ограничения есть у FlashProve?
Основные такие: накладные расходы на GPU примерно в 70–95 раз выше обычного инференса; контекстное окно ограничено 1024 токенами; нужна архитектура MoE, целочисленная модель и жадное декодирование; архитектура модели не скрывается, атаки по сторонним каналам в область охвата не входят; доказательство постфактум не мешает подменённому контенту дойти до пользователя раньше; формального доказательства эквивалентности между исполняемым кодом и протоколом на Lean пока нет.
Небольшое замечание от переводчика: утверждения о том, что Anthropic в ноябре 2026 года открыла исходники FlashProve, я подтвердить не могу — мне об этом ничего не известно. Перед публикацией стоит перепроверить первоисточник.
FlashProve: ключевые выводы (Key Takeaways)
- Разрыв в доверии реален: при работе через сторонние API высокое качество ответов не доказывает, что вам отвечает именно та модель, которую заявили.
- Основной механизм: офлайн-обязательство на веса (weight commitment) плюс онлайн-доказательство zkSNARK. Проверить его можно на обычном CPU.
- Стоимость заметно упала: пропускная способность на одном H100 в рамках окна — около 110 tokens/s, размер доказательства — примерно 19 МБ, проверка занимает около 17 секунд.
- Метрики нужно различать: при пошаговой (токен за токеном) проверке пропускная способность составляет 39,1 tokens/s, а для одиночного запроса — всего 17,6 tokens/s.
- Границы применимости чёткие: только MoE, целочисленное жадное декодирование, контекст до 1024 токенов и обнаружение постфактум.
- Как начать: сейчас можно воспользоваться единым интерфейсом к нескольким моделям на APIYI (apiyi.com), чтобы самостоятельно перепроверять результаты и проводить аудит.
Итоги
Значение FlashProve можно свести к трём пунктам:
- Проверка идентичности модели становится инженерной задачей. Раньше, чтобы доказать, что отвечает именно та же модель, требовалось больше десяти часов и почти сотня гигабайт доказательств. Теперь при пакетной обработке получается порядка сотен tokens/s, а доказательство занимает 19 МБ.
- До продакшена ещё далеко. Накладные расходы выше на два порядка, контекст короткий, есть ограничения по архитектуре и способу декодирования, а формальная верификация покрывает не всё. Поэтому пока это исследовательский прототип.
- Нужны другие механизмы защиты. Доказательство постфактум только обнаруживает подмену, но не блокирует её, так что без доверенного журналирования и контроля доступа не обойтись.
Если вы сегодня пользуетесь сторонними API, самая разумная позиция такая: не принимайте поле с названием модели за доказательство, но и не паникуйте. Сначала наладьте нормальный учёт вызовов, повторные проверки с помощью пробных запросов (probes) и перекрёстную сверку нескольких моделей, а заодно следите, как развивается доказуемый инференс. Через APIYI (apiyi.com) можно сравнивать сразу несколько моделей с одним ключом и на собственных рабочих данных собрать воспроизводимую базовую оценку качества.
📚 Справочные материалы
- Исследовательский блог Anthropic — Progress on provable inference for large language models: оригинальная статья о выходе FlashProve
- Ссылка:
anthropic.com/research/provable-inference -
Описание: дизайн системы, результаты замеров, сравнение с существующими решениями и разбор ограничений
-
Технический отчёт FlashProve: полные технические детали, приложенные к исследовательскому блогу
- Ссылка:
anthropic.com/research/provable-inference(на странице есть кнопка Read the technical report) -
Описание: как считается пропускная способность, ограничения доказательств постфактум, границы формальной верификации и другие важные оговорки
-
Anthropic Frontier Safety Roadmap: информация о ходе проекта по верификации инференса
- Ссылка:
anthropic.com - Описание: поможет понять, чем inference verification отличается от FlashProve
Автор: техническая команда APIYI
Обратная связь: пишите нам через главную страницу сайта APIYI. Больше материалов по подключению — в центре документации docs.apiyi.com