Примечание автора: разбираем, почему LongCat-2.5 не полагается только на контекстное окно в 1M токенов, а развивает способность Agent выполнять проект целиком по шести направлениям обучения. Также рассмотрим инженерные подходы, которые разработчики могут взять на вооружение.
Большинство разработчиков AI Agent сталкивались с такими ситуациями: посреди задачи возникает ошибка, Agent снова и снова пытается выполнить одну и ту же неверную команду, а в конце выдаёт с виду полный отчёт, в котором на деле не хватает нескольких ключевых результатов. В LongCat-2.5, официально выпущенной Meituan 2026-11-02, акцент сделан на способности Agent выполнять весь проект целиком, а не просто на контекстном окне в 1M токенов.
Это не рекламный материал о параметрах модели. В техническом блоге Meituan уже раскрыли, как устроено обучение с подкреплением для длительных задач, а независимые эксперты в день официального релиза проверили модель на практике. В статье мы разделим три типа информации: официальное описание обучения, официальные результаты бенчмарков и независимый практический опыт — и разберём, что каждый из них позволяет доказать, а что нет.
Главное: прочитав статью, вы поймёте, почему контекстное окно на миллион токенов не гарантирует успешного завершения проекта, какими методами LongCat-2.5 развивает способность справляться с длительными задачами и как применить эти идеи при разработке собственных Agent.
LongCat-2.5: главное
LongCat-2.5 — нативно мультимодальная большая языковая модель от команды LongCat компании Meituan, созданная для длительных агентных задач (Long-Horizon Agentic Tasks). По сравнению с LongCat-2.0 в неё добавили больше траекторий выполнения длительных задач, уделив особое внимание работе со сложными кодовыми базами и созданию проектов целиком.
| Параметр | Значение |
|---|---|
| Дата выпуска | Preview — 2026-09-25, финальная версия — 2026-11-02 |
| Разработчик | Команда LongCat компании Meituan |
| Размер модели | 1,6 трлн параметров, разреженная активация MoE: около 48 млрд параметров на токен |
| Контекстное окно | 1 048 576 токенов (около 1 млн), включая входные и выходные данные |
| Основные направления | Длительные агентные задачи, агентное программирование, визуальное программирование, многошаговые вызовы инструментов |
| Доступность | Официальный веб-интерфейс и API доступны; открытая публикация весов финальной версии пока не подтверждена |
Важно: по состоянию на 2026-11-03 APIYI уже опубликовал обзор LongCat-2.5, но указал, что модель пока недоступна на платформе и её планируется подключить позже. Актуальный список доступных для вызова моделей проверяйте на APIYI apiyi.com. Примеры кода в этой статье используют универсальный формат, совместимый с OpenAI, и подходят для любой подключённой модели.
Почему контекстного окна на миллион токенов недостаточно для долгих агентных задач
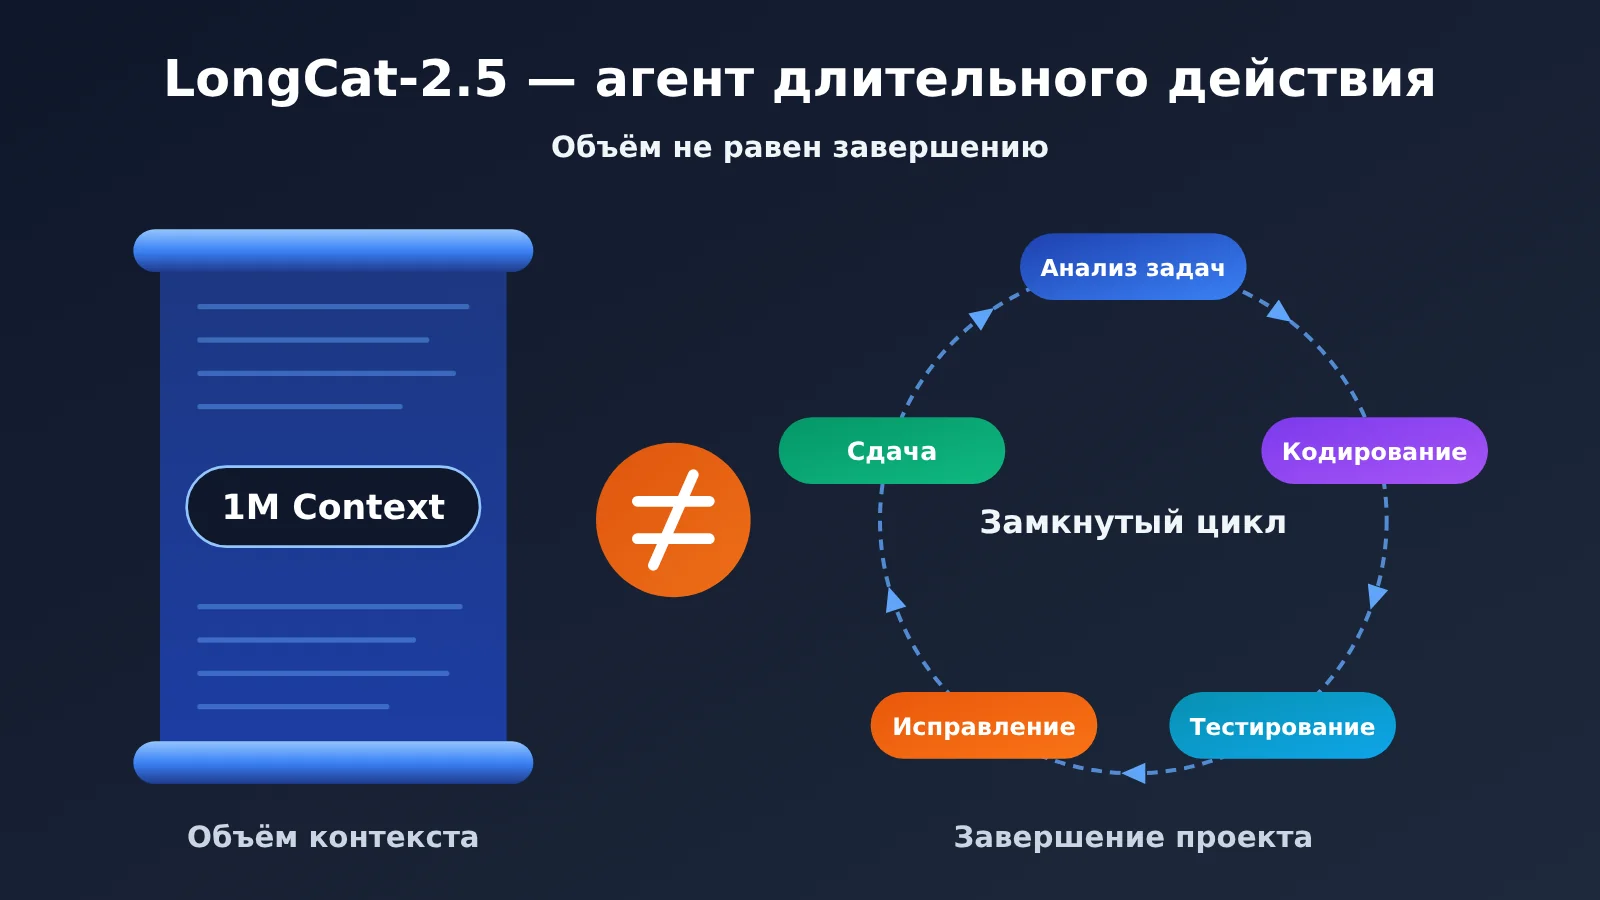
Длинный контекст (Long Context) — это общее количество токенов, которое помещается в один запрос. Окно на 1M токенов позволяет модели за раз прочитать больше исходного кода, документации и предыдущих сообщений. Это действительно помогает разбираться в крупных репозиториях. Но сам по себе этот параметр не гарантирует, что модель всегда точно найдёт нужное в длинном документе, успешно выполнит все вызовы инструментов и создаст правильные файлы.
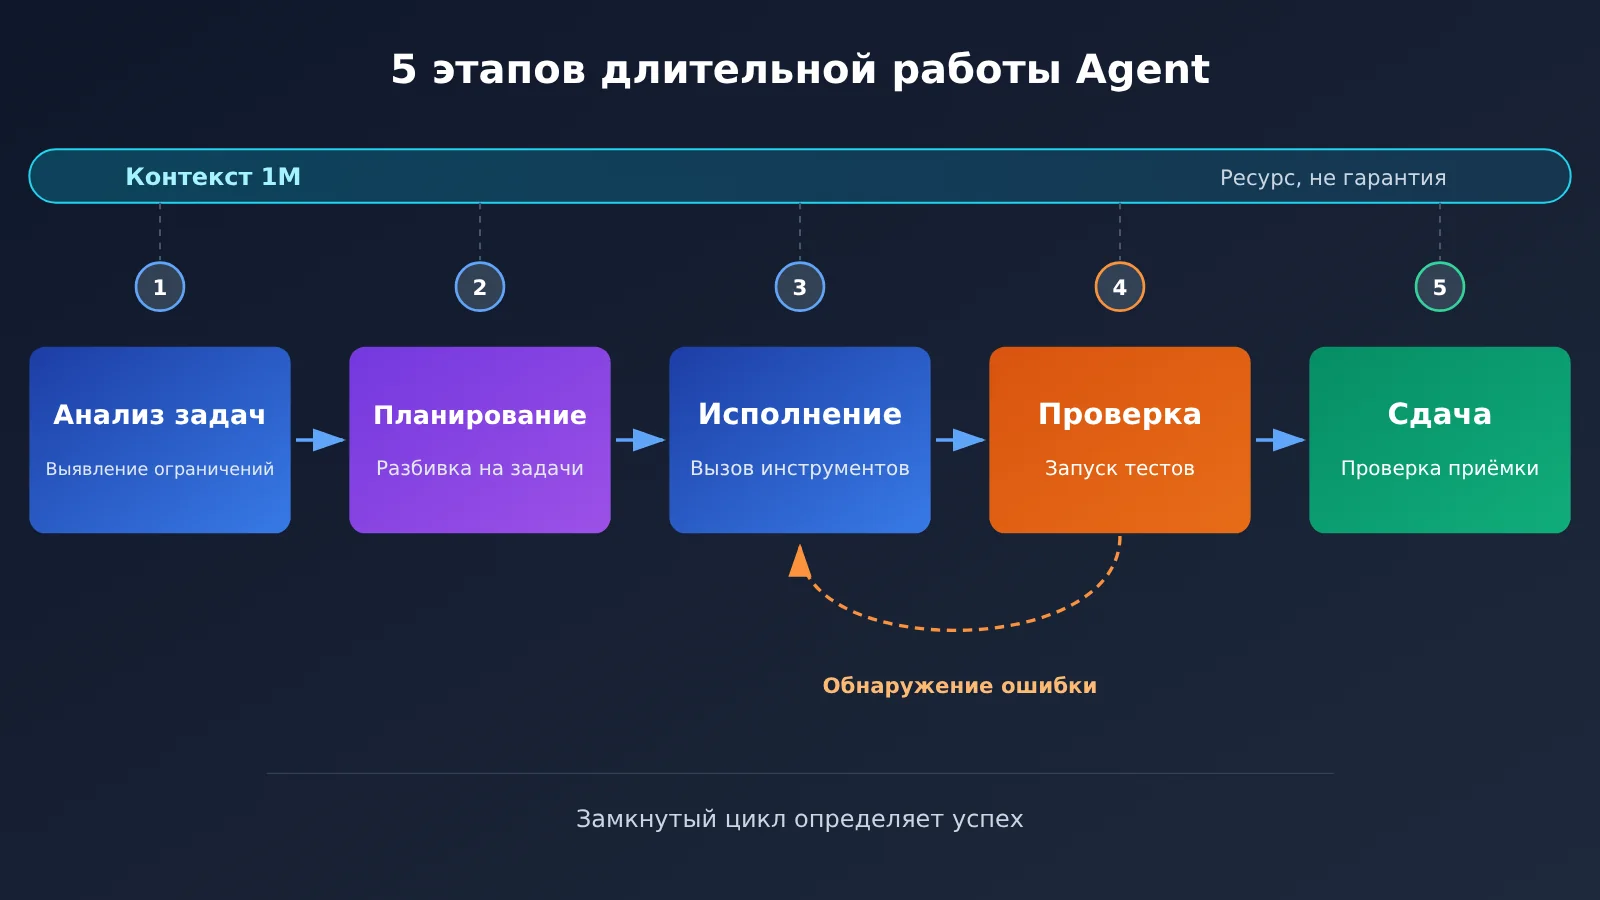
Долгие агентные задачи (Long-Horizon Agent) — совсем другое дело. Для их выполнения модель должна последовательно пройти множество взаимосвязанных шагов во внешней среде: изучить репозиторий, написать код, вызвать инструменты, запустить тесты, найти ошибки, исправить их, снова всё проверить и в итоге сдать результат. Ошибка на любом этапе может привести к тому, что все последующие действия будут опираться на неверное состояние.
| Критерий | Работа с длинным контекстом | Выполнение долгих агентных задач |
|---|---|---|
| Суть | Вместимость одного запроса | Надёжность выполнения множества последовательных шагов |
| Как измеряется | Сколько токенов помещается в запрос | Прошла ли задача итоговую проверку |
| От чего зависит | Механизм внимания и обучение на длинных текстах | Планирование, вызов инструментов, использование обратной связи об ошибках, решение о завершении |
| Типичные ошибки | Пропуск нужной информации при поиске в длинном тексте | Отклонение от цели, повторные вызовы, неполная сдача результата |
| Связь с успехом проекта | Один из необходимых ресурсов | Более напрямую определяет успех или провал |
Иными словами, контекст показывает, «насколько велик рабочий стол», а способность решать долгие задачи — «удастся ли довести работу до конца». Каким бы большим ни был стол, проект всё равно может застопориться, если модель не умеет корректировать план после неудачного теста или забывает об исходных ограничениях. Именно поэтому при обучении LongCat-2.5 особое внимание уделили долгим задачам.
Как изменились результаты LongCat-2.5 в бенчмарках длительных агентных задач
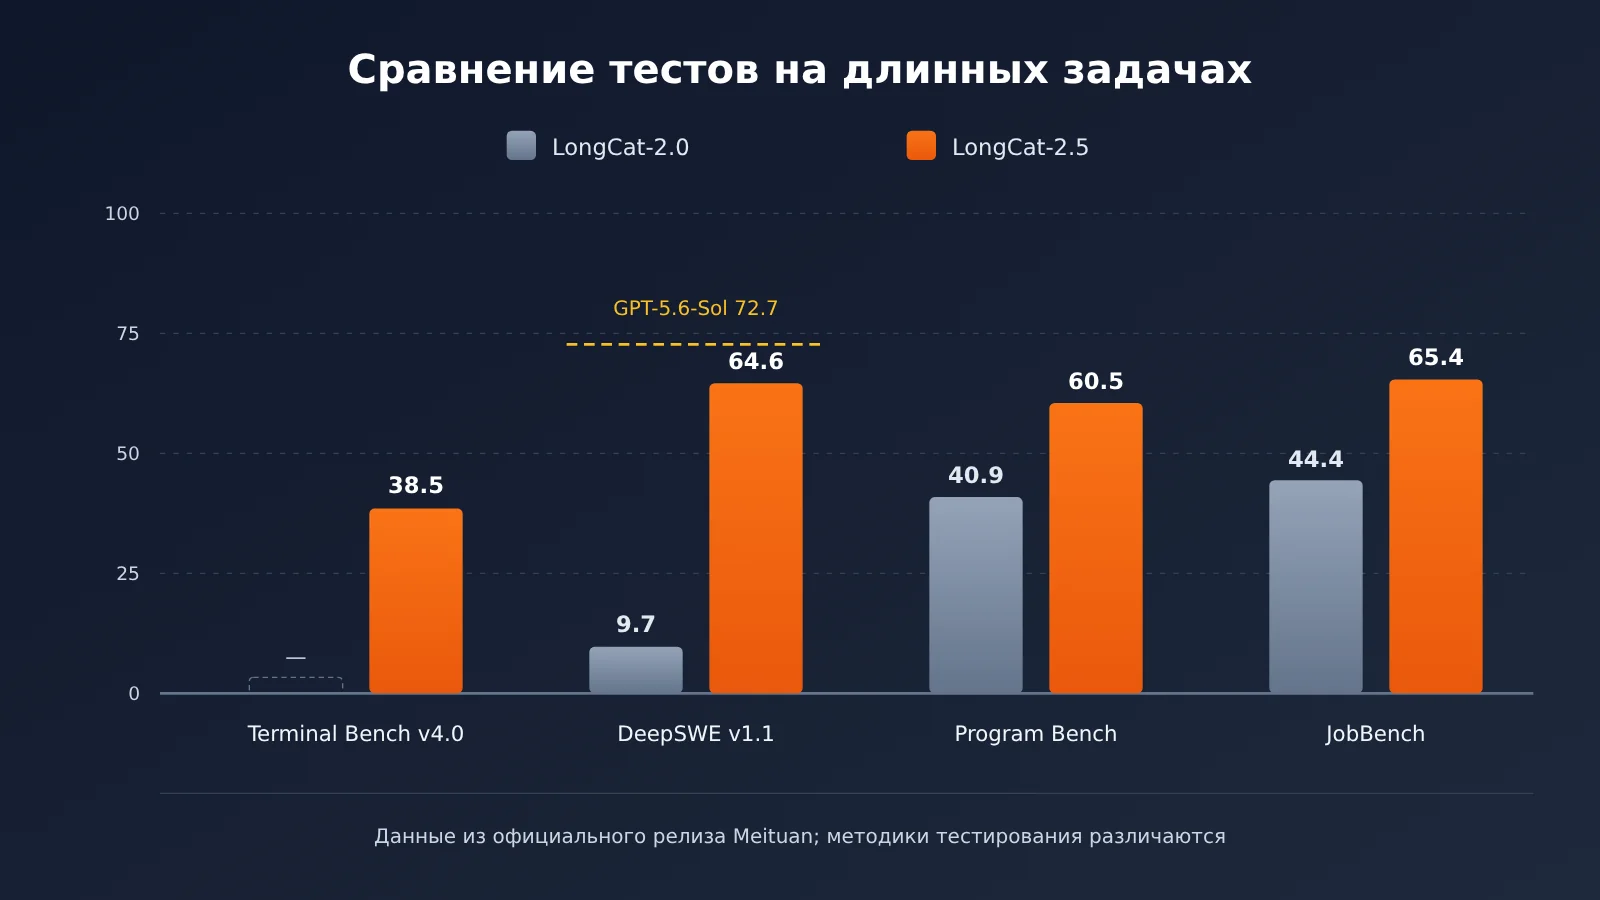
Meituan опубликовала сравнение LongCat-2.5 с предыдущим поколением модели в нескольких бенчмарках длительных агентных задач. Данные в таблице взяты из официальной публикации. Прирост — это разница в баллах, а не относительное изменение в процентах.
| Бенчмарк | LongCat-2.0 | LongCat-2.5 | Прирост | Что измеряет |
|---|---|---|---|---|
| Terminal Bench v2.1 | 70.8 | 88.4 | +17.6 | Выполнение реальных задач в терминале |
| Terminal Bench v4.0 | 3.0 | 38.5 | +35.5 | Более сложные длительные задачи в терминале |
| DeepSWE v1.1 | 9.7 | 64.6 | +54.9 | Длительные задачи по разработке ПО |
| Program Bench Almost Resolved | 2.5 | 25.5 | +23.0 | Насколько близко к завершению создание программы |
| NL2Repo | 40.9 | 60.5 | +19.6 | Создание репозитория по требованиям на естественном языке |
| MCP Atlas | 61.8 | 83.1 | +21.3 | Вызов нескольких инструментов |
| JobBench | 44.4 | 65.4 | +21.0 | Профессиональные результаты выполнения рабочих задач |
Прогресс заметен, но при интерпретации результатов важно учитывать несколько ограничений. В DeepSWE показатель вырос с 9.7 до 64.6, однако в официальном сравнении он всё ещё ниже 72.7 у GPT-5.6-Sol. В Terminal Bench v4.0 результат 38.5 немного выше, чем 37.3 у GPT-5.6-Sol, но на 15.4 балла ниже 53.9 у Claude Opus 5. Это показывает, что до решения сложных задач в терминале ещё далеко.
Условия тестирования тоже важны. В Terminal Bench используется Claude Code Harness, в DeepSWE — mini-swe-agent, а в JobBench ответы оцениваются по принципу LLM-as-Judge. Все результаты зависят от конкретной среды выполнения. В официальной таблице часть результатов конкурентов взята из публичных отчётов, а часть получена в собственных тестах Meituan, поэтому её нельзя считать независимым рейтингом с едиными условиями. Внутренний бенчмарк LongCat AppDev (47.7 → 73.7) также нельзя воспроизвести публично.
📊 О сравнении: Бенчмарк показывает результаты только в конкретной среде, поэтому окончательно оценивать модель нужно на собственных задачах. Через APIYI apiyi.com можно сравнить несколько доступных моделей с помощью одного набора тестовых сценариев, а затем учесть и официальные результаты при выборе.
Как LongCat-2.5 обучают доводить проекты до конца
Описанный в техническом блоге Meituan подход к обучению работе с длительными задачами можно разделить на 6 направлений. Чтобы понять каждое из них, важно разобраться, какие реальные ошибки при выполнении таких задач оно помогает устранить.
Реальная среда задач и проверка F2P/P2P в LongCat-2.5
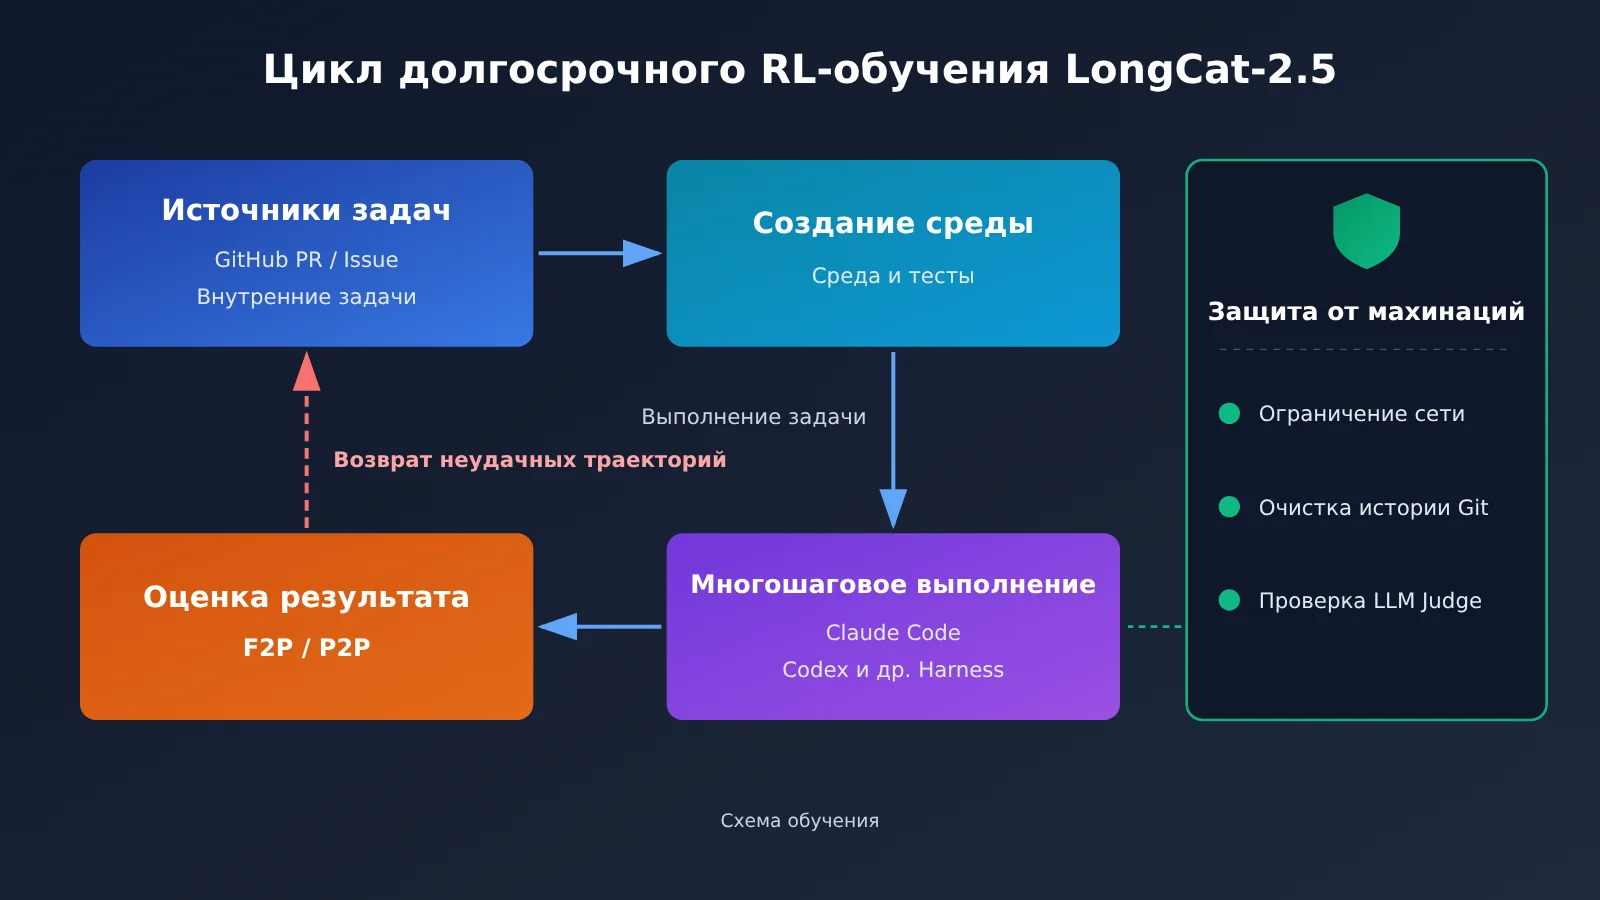
Обучающие данные берут из PR и связанных с ними Issue в публичных репозиториях GitHub, а также из реальных внутренних задач Meituan по работе с кодом. Сначала задачи отбирают и автоматически размечают с помощью агента, затем создают среду для работы с кодом и генерируют исполняемые тесты. После этого модель выполняет задачу, а её решение оценивают по фактическим результатам выполнения. В отличие от простого обучения на больших объёмах кода, такой подход даёт обратную связь о том, заработало решение или нет.
Для проверки используют два типа тестов: F2P (Fail-to-Pass) показывает, проходят ли после исправления тесты, которые раньше завершались с ошибкой, а P2P (Pass-to-Pass) — не перестали ли проходить те, что работали прежде. Первые помогают убедиться, что проблема действительно решена, вторые — что исправление не сломало что-то ещё. Meituan также анализирует траектории выполнения и долю успешных тестов, чтобы выявить ложноположительные и ложноотрицательные результаты самих тестов. Впрочем, эффективность проверки по-прежнему зависит от того, насколько полно тестовые случаи покрывают требования.
Обучение на неудачных траекториях и асинхронный Partial Rollout в LongCat-2.5
Разработчики преобразуют неудачные траектории реальных агентов в воспроизводимые и проверяемые задачи. Это помогает находить слабые места модели и дополнять обучающую среду. Такой подход похож на работу над ошибками: модель учится не только на успешных примерах. В открытых материалах не указаны ни количество неудачных траекторий, ни доля исправленных ошибок каждого типа.
Длительность выполнения задач может сильно различаться: одна сложная траектория способна замедлить обработку всего батча. Асинхронный Partial Rollout работает так: несколько задач выполняются параллельно, а когда батч сформирован, незавершённые траектории прерываются и сохраняются до следующего раунда. При этом группы примеров, где все попытки завершились либо успехом, либо неудачей, отфильтровываются, поскольку не дают полезного градиента.
При таком подходе токены одной траектории могут быть сгенерированы версиями модели на разных этапах обучения. Чтобы контролировать возникающее смещение, разработчики ограничивают разницу logprob и корректируют вклад в градиент с учётом накопленной разницы. Эта технология повышает эффективность обучения, но из этого нельзя сделать вывод, что задачи пользователей будут выполняться быстрее в той же пропорции.
Защита LongCat-2.5 от Reward Hacking и обучение в разных Harness
Reward Hacking — это ситуация, когда модель использует лазейки в системе вознаграждения, чтобы получить высокий балл, но на самом деле не выполняет задачу: например, подсматривает ответ или обходит тесты. Для борьбы с этим Meituan ограничивает доступ к сети в среде обучения, очищает историю Git и кэш файлов, использует LLM Judge для проверки траекторий и штрафует модель за повторяющиеся рассуждения, повторные вызовы инструментов и чрезмерные рассуждения. Это меры контроля риска, а не свидетельство того, что проблема полностью решена.
Harness — это внешняя система, которая организует выполнение задач моделью: инструменты, управление контекстом и правила цикла выполнения. На этапе холодного старта в обучение LongCat-2.5 добавили небольшое количество примеров адаптации к разным фреймворкам, а на этапе RL смешивали разные фреймворки, включая Claude Code и Codex, и типы задач. Это снижает риск того, что модель приспособится только к одному шаблону промпта, но не гарантирует полностью одинакового поведения в разных версиях инструментов.
| Метод обучения | Какую проблему решает | Известные ограничения |
|---|---|---|
| Реальная среда выполнения задач | Модель умеет писать код, но не может запустить его в среде | Зависит от качества созданной среды |
| Проверка F2P / P2P | Задача выполнена лишь на вид или появились ошибки регрессии | Ограничена покрытием тестов |
| Обучение на траекториях неудач | Повторение однотипных ошибок | Число примеров и доля исправлений не опубликованы |
| Асинхронный Partial Rollout | Низкая эффективность обучения на длительных задачах | Не означает ускорения инференса |
| Защита от Reward Hacking | Ложный успех за счёт лазеек | Не заявлено, что проблема решена полностью |
| Смешанное обучение в разных Harness | Модель перестаёт работать при смене Agent-фреймворка | Не гарантирует одинакового поведения в разных версиях |
Независимый тест: почему LongCat-2.5 не всегда доводит долгие задачи до конца
Помимо официального описания обучения и бенчмарков, есть и другой источник данных — независимые тесты. 2 ноября 2026 года TOKRACE подключила финальную версию LongCat-2.5 к Claude Code и выполнила 15 творческих задач с использованием Blender, браузера и других инструментов.
Удачным примером стал параметрический книжный шкаф: размеры версий с тремя секциями шириной 0,8 метра и четырьмя секциями шириной 1 метр, а также толщина панелей в 18 мм соответствовали требованиям. Модель также выдала шесть изображений с разных ракурсов. Работа заняла около 36 минут и потребовала 47 запросов. Но в других задачах проявились типичные сбои при длительной работе:
- Ошибки в конструкции и единицах измерения: для планетарного редуктора требовался размер 140 мм, но в созданном проекте использовалось 140 м. Видео также не было предоставлено.
- Неполный результат: в задаче на создание двора китайского храма за 60 минут модель выдала только три финальных изображения — часть ракурсов и видео отсутствовали.
- Проблемы с пространственными отношениями: в модели двухкомнатной квартиры не было проёмов для дверей и окон, а кровать пересекалась с перегородкой.
- Прерывание длительной работы: видео на математическую тему не было завершено из-за последовательных тайм-аутов запросов.
Эти примеры показывают: в длительных задачах недостаточно проверить, появился ли хоть какой-то результат, — нужно сверять его со всеми требованиями по пунктам. При этом в тесте действовали ограничения на количество запросов, время или бюджет выполнения, поэтому не стоит объяснять каждый неполный результат исключительно недостаточными возможностями модели. Кроме того, это не было строгим сравнительным экспериментом.
LongCat-2.5: влияние подхода к обучению длительным задачам
Что это значит для разработчиков агентов
- Критерии выбора меняются: при оценке модели длина контекстного окна играет всё меньшую роль. Больше внимания стоит уделять результатам на тестах длительных задач и доле реальных задач, выполненных до конца.
- Без собственной проверки не обойтись: даже если модель прошла обучение F2P/P2P, в рабочей среде по-прежнему нужны собственные тесты и приёмка. Это уже подтвердили независимые испытания.
- Проектирование Harness не менее важно: результаты сильно зависят от фреймворка выполнения. Если изменить цикл выполнения задач, одна и та же модель может показать совершенно другой результат.
Что это значит для индустрии больших языковых моделей
- Фокус обучения смещается на «процесс»: от генерации кода за один проход — к работе над целыми проектами и многоэтапными инженерными задачами. Способность создавать среды для обучения с подкреплением становится новым конкурентным преимуществом.
- Методикам оценки уделяют больше внимания: в Terminal-Bench 2.1 по сравнению с версией 2.0 исправили 28 из 89 задач. Это показывает, что сама версия теста может заметно влиять на результат, поэтому индустрии нужно прозрачнее описывать условия оценки.
Проектирование Agent для длительных задач по принципам LongCat-2.5
Методы обучения LongCat-2.5 дают разработчикам приложений полезную подсказку: если модель учится проверять этапы работы, восстанавливаться после ошибок и не искать обходные пути, то аналогичные механизмы стоит явно заложить и в систему Agent. Ниже приведены инженерные рекомендации, основанные на опубликованных методах обучения, а не функции, которые официально заявлены как реализованные.
| Инженерный механизм | Соответствующий подход к обучению | Реализация |
|---|---|---|
| Проверка этапов | Проверка F2P | Запускать проверочный скрипт после каждой подзадачи |
| Защита от регрессий | Проверка P2P | Запускать полный набор регрессионных тестов после каждого изменения |
| Запись ошибок | Обучение на неудачных траекториях | Записывать ошибки в файл прогресса и передавать их на следующую итерацию |
| Лимит бюджета | Штраф за повторные вызовы | Ограничивать число итераций и вызовов инструментов, а также устанавливать тайм-ауты |
| Приёмка результата | Защита от Reward Hacking | Проверять реальные файлы, а не только итоговое сообщение модели |
Ниже — минимальный пример цикла Agent с проверкой этапов. Он показывает, как записывать прогресс, передавать ошибки на следующую итерацию и ограничивать бюджет:
import json, subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)
MODEL = "gpt-4o-mini"  # Используйте ID модели, доступной в списке моделей платформы
MAX_ROUNDS = 8         # Лимит бюджета для предотвращения бесконечного цикла

def run_check(cmd: str) -> tuple[bool, str]:
    r = subprocess.run(cmd, shell=True, capture_output=True, text=True, timeout=300)
    return r.returncode == 0, (r.stdout + r.stderr)[-2000:]

def run_stage(stage: dict, progress: dict) -> bool:
    failures = []
    for i in range(MAX_ROUNDS):
        prompt = (f"阶段目标:{stage['goal']}\n"
                  f"已完成阶段:{progress['done']}\n"
                  f"历史失败(请避免重复):{failures[-3:]}")
        resp = client.chat.completions.create(
            model=MODEL, messages=[{"role": "user", "content": prompt}])
        # Здесь опущена обработка вывода модели и запись кода в файлы
        ok, log = run_check(stage["check"])          # Проверка этапа (аналог F2P)
        reg_ok, reg_log = run_check("pytest -q")     # Регрессионный тест (аналог P2P)
        if ok and reg_ok:
            progress["done"].append(stage["name"])
            return True
        failures.append(log if not ok else reg_log)
    progress["blocked"] = stage["name"]
    return False

progress = {"done": [], "blocked": None}
stages = [{"name": "api", "goal": "实现用户接口", "check": "pytest tests/test_api.py -q"}]
for s in stages:
    if not run_stage(s, progress):
        break
json.dump(progress, open("progress.json", "w"), ensure_ascii=False)
Ключевая идея этой структуры: у каждого этапа есть исполняемая команда для приёмки, журналы ошибок передаются в промпт на следующей итерации, а прогресс записывается в файл, а не хранится только в контексте. Даже при достаточно большом контекстном окне вынесение прогресса и ограничений в структурированное состояние может заметно снизить риск отклонения от цели в ходе длительной задачи.
🚀 Совет для быстрого старта: при создании прототипа агента можно сначала получить тестовый лимит через APIYI apiyi.com и с одним API-ключом переключаться между моделями, запуская описанный выше цикл поэтапной проверки. Так вы увидите, какая модель наиболее полно справляется с вашей задачей.
Если к надёжности проекта предъявляются высокие требования, можно также внедрить «перекрёстную приёмку»: поручить другой модели проверить итоговый результат по каждому пункту списка требований. Благодаря единому интерфейсу APIYI apiyi.com модель-исполнитель и модель для приёмки можно вызывать из одного и того же кода, поэтому переключаться между ними легко.
Частые вопросы FAQ
Q1: Означает ли контекстное окно LongCat-2.5 на 1M, что модель справится с крупным проектом?
Не совсем. Контекстное окно на 1M — это объём одного запроса, включая входные и выходные данные. Оно позволяет модели прочитать больше кода и документации. Но для завершения проекта также нужны планирование, вызов инструментов, исправление ошибок и проверка результата. Именно этим навыкам LongCat-2.5 специально обучали с помощью обучения с подкреплением для долгосрочных задач.
Q2: Как LongCat-2.5 справляется с долгосрочными задачами по сравнению с GPT-5.6-Sol и Claude Opus 5?
Согласно официальной таблице, LongCat-2.5 немного опережает GPT-5.6-Sol в BrowseComp (91.9) и Terminal Bench v4.0 (38.5), но в DeepSWE её результат — 64.6 против 72.7 у GPT-5.6-Sol. В Terminal Bench v4.0 она также уступает Claude Opus 5 на 15.4 балла. У тестов разные условия проведения, поэтому воспринимать эти результаты как единый рейтинг не стоит.
Q3: Когда вышла финальная версия LongCat-2.5? Открыты ли веса модели?
Версия Preview появилась на платформе API 2026-09-25, а финальная версия вышла 2026-11-02. Официальный веб-интерфейс и API уже доступны, но по состоянию на 2026-11-03 публикация весов финальной модели ещё не подтверждена. По заявлению разработчиков, они появятся на GitHub и Hugging Face позже.
Q4: Можно ли сейчас вызвать LongCat-2.5 через APIYI?
Согласно публичной информации от 2026-11-02, LongCat-2.5 ещё не была доступна в APIYI, но её подключение планировалось. Актуальный статус смотрите в списке моделей на APIYI apiyi.com. Пока можно построить Agent-фреймворк с проверкой промежуточных этапов и повторной передачей ошибок модели, используя уже доступные на платформе модели. После появления LongCat-2.5 останется только заменить ID модели.
Q5: Как недорого проверить способности модели выполнять долгосрочные задачи в качестве агента?
Подготовьте 3–5 многошаговых задач, близких к вашим рабочим сценариям, со скриптами автоматической приёмки. Для каждой модели записывайте долю полностью выполненных задач, среднее число раундов и типы ошибок. С помощью OpenAI-совместимого интерфейса APIYI apiyi.com можно сравнить несколько моделей в одном наборе скриптов с одним API-ключом. У новых пользователей также есть бесплатная квота для предварительного тестирования.
Q6: Какие известные ограничения есть у LongCat-2.5 при выполнении долгосрочных задач?
В независимых тестах встречались ошибки в единицах измерения и пространственных отношениях, случаи, когда модель не предоставляла готовое видео, а также прерывания из-за тайм-аута запроса. Разработчики также не утверждают, что проблема Reward Hacking полностью решена, а объём неудачных траекторий и доля их исправлений пока не раскрыты. Инженерные размеры, точность фактов и полноту результата по-прежнему нужно проверять вручную.
LongCat-2.5: главное о долгосрочных Agent-задачах
- Контекст ≠ завершённая работа: окно на 1 млн токенов — это объём, а не гарантия успешного завершения проекта. Работу над долгими задачами нужно тренировать отдельно.
- Обучение в реальных средах: исполняемые среды с обратной связью создаются на основе GitHub PR, Issue и внутренних задач.
- Проверка в обе стороны: F2P показывает, решена ли проблема, а P2P — не возникли ли регрессии.
- Обучение на ошибках: реальные траектории неудачных действий Agent преобразуются в проверяемые обучающие задачи.
- Результаты нужно оценивать с учётом условий: результаты бенчмарка сильно зависят от Harness, а независимые тесты всё ещё выявляют случаи, когда работа остаётся незавершённой.
- Систему тоже нужно проектировать с учётом долгих задач: необходимы поэтапная проверка, запись ошибок, ограничение бюджета и приёмка результата. Для сравнения моделей можно использовать APIYI apiyi.com.
Итоги
Главный сигнал от выхода LongCat-2.5 — не очередное окно на миллион токенов, а смещение фокуса обучения с вопроса «сколько модель может прочитать» на вопрос «может ли она завершить весь проект»:
- Проблема сформулирована точнее: в долгосрочных задачах Agent чаще ошибается на этапах выполнения, проверки и сдачи результата, а не из-за нехватки контекста.
- Методы обучения нацелены на конкретные проблемы: реальные среды задач, F2P/P2P, траектории ошибок, Partial Rollout, защита от обхода правил и работа с разными Harness — каждый из этих подходов отвечает на свой тип реальных сбоев.
- Важно понимать границы доказательств: официальные результаты заметно улучшились, но до лучших моделей ещё есть разрыв. Независимые тесты тоже показывают, что для полноценной сдачи работы по-прежнему нужен контроль человека.
Разработчикам практичнее перенести тот же подход в собственные Agent-системы и оценивать модели по исполняемым критериям приёмки, а не только по параметрам и позициям в рейтингах. Можно использовать APIYI apiyi.com, чтобы сравнить модели через единый интерфейс на реальных задачах и затем выбрать их сочетание для продакшена.
📚 Источники
- Техническая команда Meituan — статья о LongCat-2.5: подробное описание методов обучения агентов для длительных задач
- Ссылка:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
Описание: первоисточник решений для обучения, включая F2P/P2P, Partial Rollout и защиту от Reward Hacking
-
Официальный блог LongCat: результаты бенчмарков и методы оценки
- Ссылка:
longcat.ai/blog/longcat-2.5 -
Описание: полная таблица результатов, Harness и настройки параметров для каждого бенчмарка
-
Документация по параметрам моделей LongCat: описание контекста и параметров вывода
- Ссылка:
longcat.ai/platform/docs/zh/api/model-params -
Описание: параметры вызова, включая длину контекста, max_tokens и бюджет рассуждений
-
Terminal-Bench: бенчмарк для терминальных агентов
- Ссылка:
tbench.ai -
Описание: связь результатов с Agent Harness и различия между версиями
-
DeepSWE: бенчмарк агентов для длительных задач разработки ПО
- Ссылка:
deepswe.datacurve.ai -
Описание: структура тестирования — 113 оригинальных задач и 91 репозиторий с открытым исходным кодом
-
TOKRACE — результаты тестирования LongCat-2.5: независимая проверка на 15 творческих задачах
- Ссылка:
tokrace.com/zh-CN/guides/longcat-2-5-release - Описание: реальные примеры, включая частичное выполнение длительных задач и ошибки в единицах измерения
Автор: техническая команда APIYI
Обсуждение технических вопросов: заходите на главную страницу APIYI apiyi.com и свяжитесь с нами, чтобы обсудить разработку агентов для длительных задач и выбор моделей под разные задачи