Кратко: официальные веса Hy4 уже опубликованы. В этой статье мы поможем вам определить, какой набор весов использовать, какие GPU нужны для самостоятельного развёртывания и как честно сравнить затраты с прямым вызовом API.
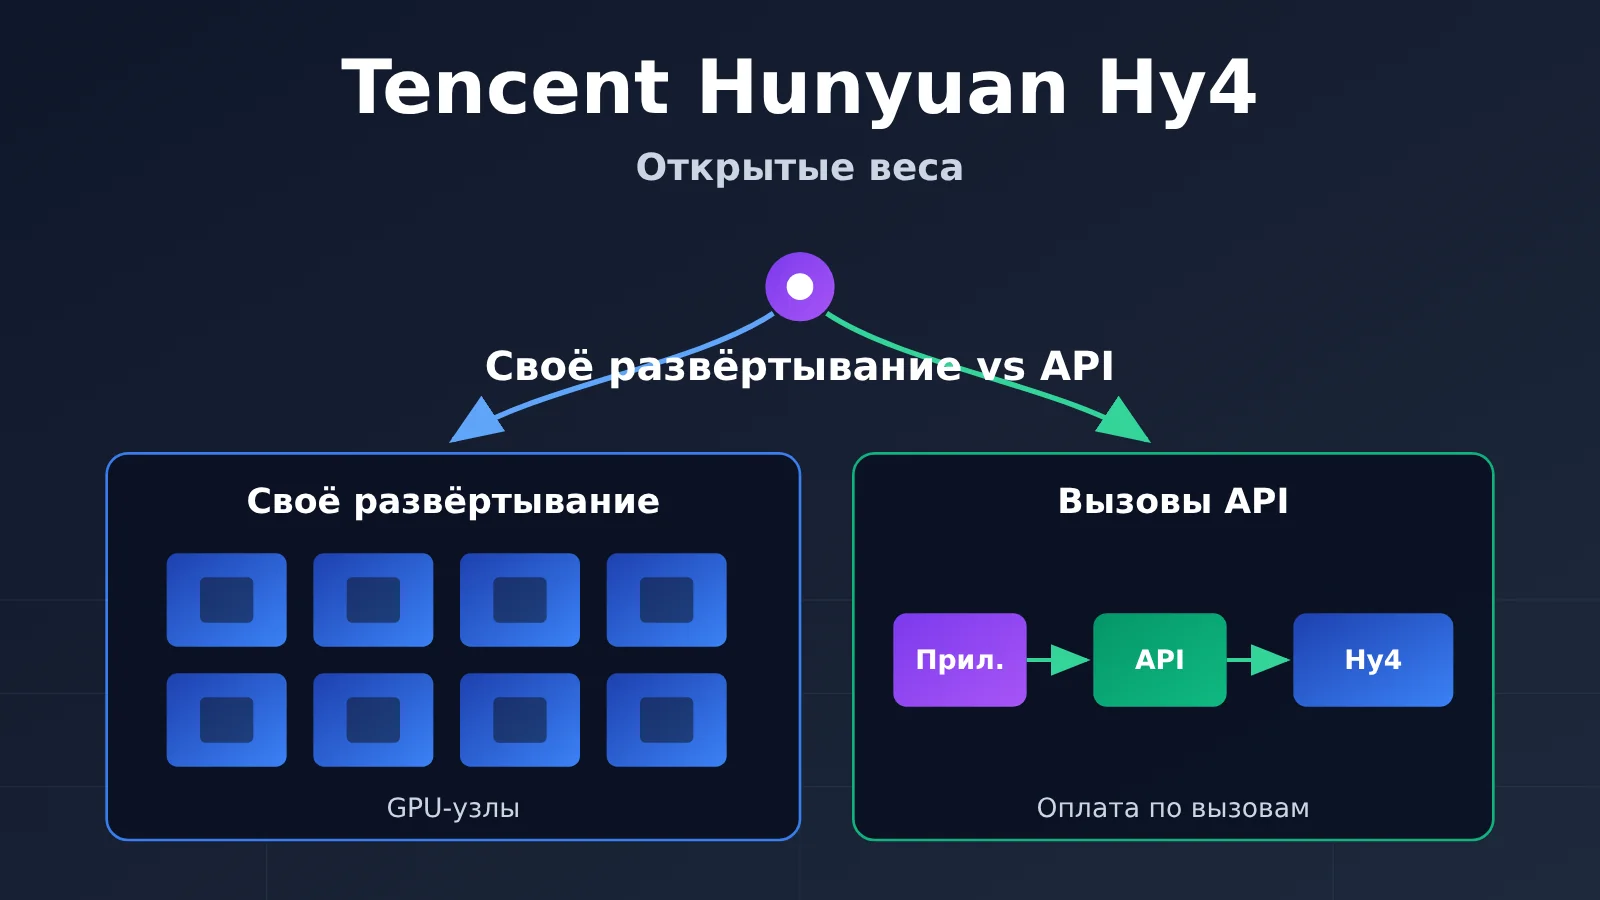
Вывод сразу: если комплаенс позволяет и ваша задача — сначала попробовать чисто текстовые сценарии, самый низкий порог входа у прямого вызова API. Самостоятельное развёртывание стоит рассматривать, только если нужна строгая изоляция данных или действительно требуется контроль над конфигурацией инференса. Порог для самостоятельного развёртывания немаленький: в примере конфигурации FP8 официального фреймворка инференса указаны 4× B300/GB300 или 8× H200/B200. К тому же это примеры, а не минимальный порог для всех конфигураций, и они не означают, что можно работать с полным контекстом в 1M. Если ресурсов не хватает, лучше пересмотреть модель поменьше, чем насильно внедрять Hy4.
Карта знаний по открытым весам Hy4 и индекс для чтения
| № | Что смотреть первым | Почему сначала это | Что получите |
|---|---|---|---|
| 1 | Версия и выбор весов | Ошибётесь с весами — и все последующие расчёты по железу придётся выбросить | Поймёте, что брать: Instruct BF16, Instruct FP8 или Base |
| 2 | Сколько карт нужно для развёртывания | Железо — главный барьер для самохостинга | Таблица сравнения по железу и чек-лист для инвентаризации |
| 3 | Стоимость на одной и той же партии задач | Сравнивать имеет смысл только при одинаковом качестве и задержке | Алгоритм расчёта стоимости одной задачи через API и из чего складывается стоимость самохостинга |
| 4 | Решение | Перенести выводы первых трёх разделов на свой сценарий | Идти через API, проверять самохостинг или взять модель поменьше |
1→2→3 — это цепочка: версия определяет файл весов, файл весов определяет железо, железо определяет стоимость. Раздел 4 сводит вместе выводы первых трёх разделов. Если вас интересует только стоимость, можно сразу начинать с раздела 3.
To Know: термины, без которых не разобраться в развёртывании Hy4
| Термин | Краткое объяснение |
|---|---|
| Открытые веса | Файлы параметров модели можно скачать и развернуть у себя, а условия использования определяются лицензией |
| Instruct / Base | Instruct — версия, выровненная по инструкциям, с ней можно общаться напрямую; Base — предобученная база, подходит для дальнейшего обучения |
| BF16 / FP8 | Числовая точность параметров. В FP8 каждый параметр занимает около 1 байта, в BF16 — около 2 байт |
| TP (тензорный параллелизм) | Разбиение модели на несколько GPU для совместных вычислений; TP8 означает разбиение на 8 частей |
| KV cache | Промежуточное состояние, сохраняемое при инференсе для контекста; растёт вместе с длиной контекста и числом параллельных запросов |
| Чтение из кэша | Входные токены в тарификации API, попавшие в кэш промпта; цена за единицу ниже, чем за некэшированный ввод |
1. Как выбрать версию Hy4 и открытые веса
1.1 Три ключевые даты Hy4
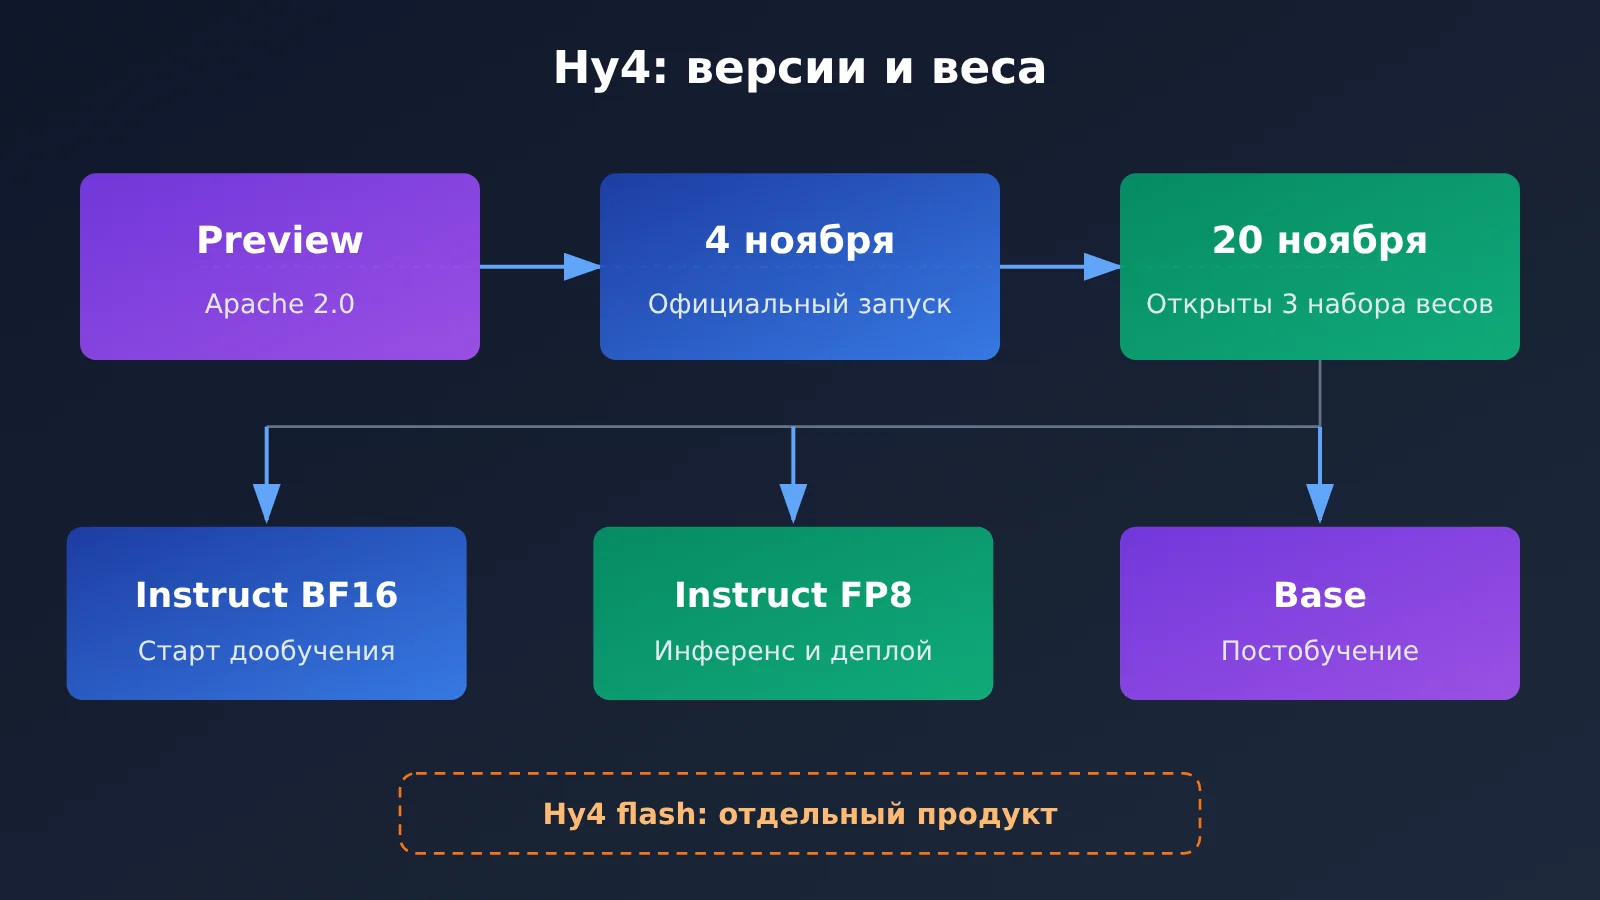
Публичный релиз Hy4 прошёл в три этапа. Первой появилась Preview-версия — её опубликовали на странице tencent/Hy4-preview в Hugging Face под лицензией Apache 2.0. 4 ноября 2026 года Tencent выпустила анонс и объявила официальный запуск Hy4. 20 ноября на Hugging Face выложили три набора весов финальной версии.
Разница между этими этапами напрямую влияет на ваш выбор. У Preview и официальной версии разные лицензии: официальная версия распространяется по Tencent Hy License 1.0, и в разделе 10 этой лицензии есть дополнительные условия для некоторых публично предоставляемых сервисов инференса общего назначения. Если вы планируете развернуть Hy4 как внешний сервис, попросите юридическую команду свер
иться с оригинальным текстом лицензии и принять решение самостоятельно — в этой статье мы не даём юридических выводов о том, как поступать конкретным компаниям.
1.2 Когда подходят три набора официальных весов Hy4
| Репозиторий весов | Содержимое | Когда подходит |
|---|---|---|
tencent/Hy4 |
Instruct, BF16 | Нужна максимальная численная точность или отправная точка для дообучения и квантования; самые высокие требования к видеопамяти |
tencent/Hy4-FP8 |
Instruct, FP8 | Для прямого развёртывания инференса; примеры конфигураций SGLang и vLLM основаны на нём |
tencent/Hy4-base |
Предобученная Base | Если вы собираетесь сами проводить посттренинг и продолженное обучение на домене; не подходит для прямого использования в диалоге |
Отдельно стоит подчеркнуть: официальная версия Hy4 — это не Hy4 flash, последний представляет собой отдельную продуктовую линейку. Всё, что в статье сказано о железе и затратах, относится только к официальной версии и не переносится на flash.
2. Сколько карт нужно для самостоятельного развёртывания Hy4
2.1 Сопоставление примеров конфигурации SGLang и vLLM
Оба ведущих фреймворка для инференса приводят примеры развёртывания Hy4. Ниже они приведены рядом:
| Фреймворк | Веса | Параллелизм | Пример GPU | Пояснение к примеру |
|---|---|---|---|---|
| SGLang | FP8 | TP4 | 4×B300 или 4×GB300 | Размер пула KV определяет фактический объём доступного контекста |
| SGLang | FP8 | TP8 | 8×H200 или 8×B200 | То же самое |
| vLLM | FP8 (по умолчанию) | TP8 | 8×B300 | В примере контекстное окно — 131,072; поддерживается только одно изображение, видео отключено |
При чтении этой таблицы стоит обратить внимание на три момента:
- Это примеры конфигураций, а не минимальные требования. В документации SGLang сказано, что пул KV ограничивает фактический объём контекста, который можно разместить; эти конфигурации также не являются минимальным порогом для любого набора параметров.
- Полные 1M не гарантируются. В карточке модели заявлено максимальное контекстное окно 1,048,576 токенов, но доступная длина при конкретной конфигурации сервиса требует отдельного расчёта. Пример vLLM рассчитан только на 131,072; ни один из документов не обещает, что будут доступны все 1M.
- Цифры двух производителей нельзя переносить друг на друга. Справочный объём видеопамяти, указанный в документации vLLM, применим только к этой конфигурации vLLM.
2.2 Связь 770B, 49B и видеопамяти
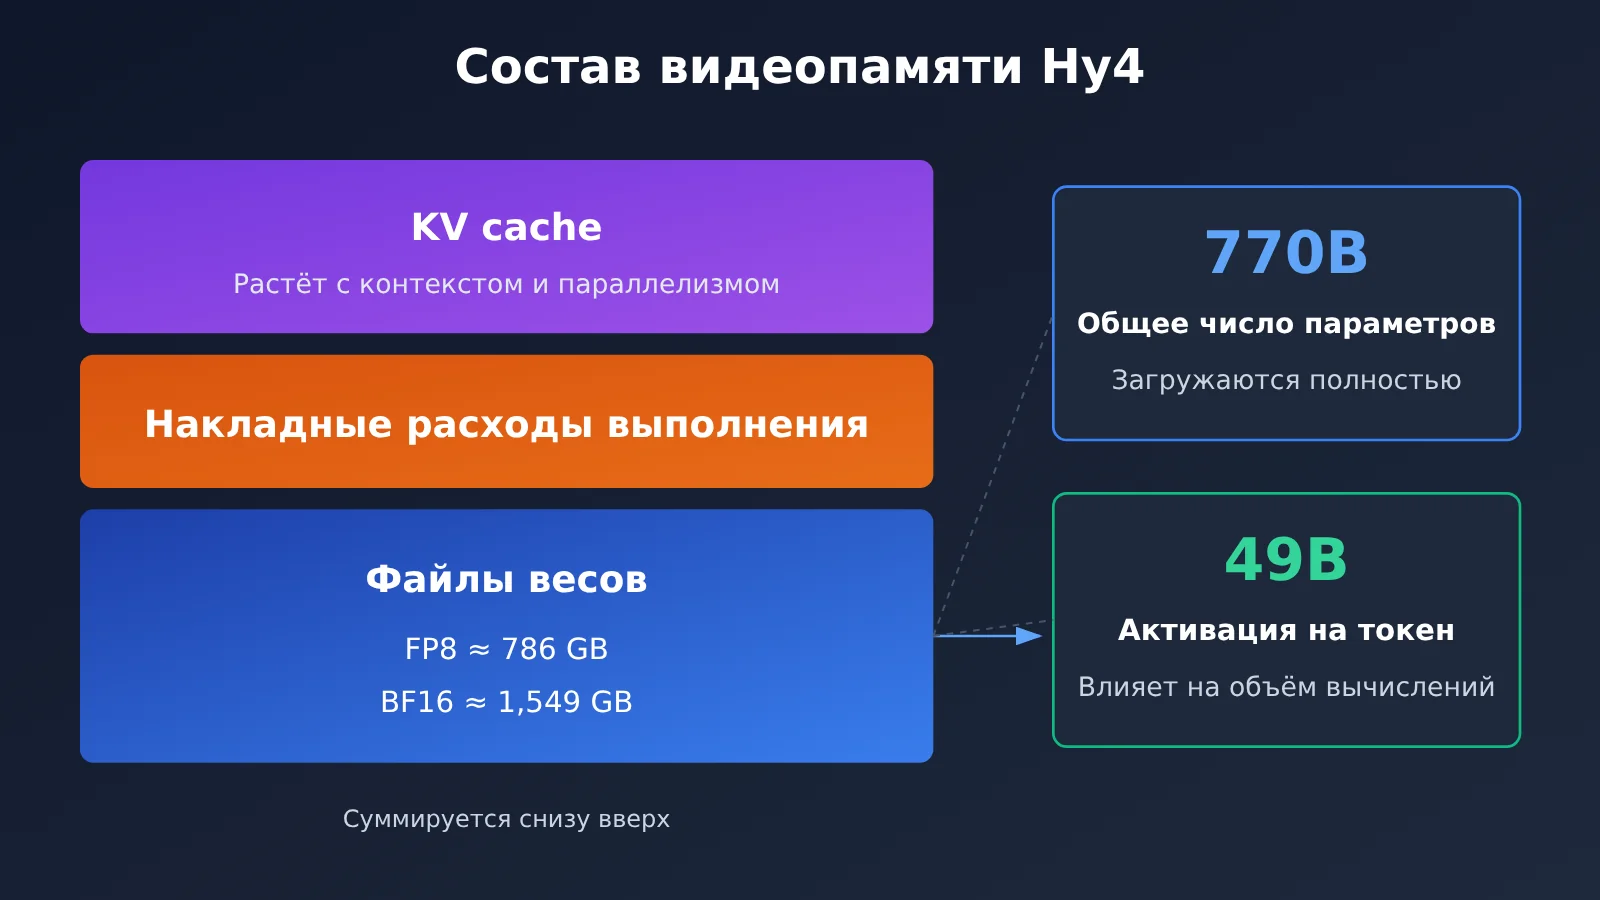
Когда говорят о Hy4, обычно упоминают две цифры: 770B — общее количество параметров языковой основы, 49B — количество текстовых параметров, активируемых на каждый token. Многие ошибочно воспринимают 49B как требование к видеопамяти, и это неверно. 49B определяет объём вычислений на каждый token; а чтобы в любой момент можно было обратиться к любому эксперту, все 770B параметров должны быть загружены в видеопамять.
Требования к видеопамяти стоит рассматривать на трёх уровнях:
- Размер файлов весов: согласно документации vLLM, для FP8 это около 786 GB, для BF16 — около 1,549 GB. Прежде всего это вопрос дискового пространства и пропускной способности при загрузке.
- Видеопамять во время работы: в примерах vLLM ориентировочный объём видеопамяти составляет около 944 GB (FP8) и 1,859 GB (BF16) — больше, чем сами файлы, потому что сюда входят накладные расходы времени выполнения и резерв под KV cache.
- KV cache и конкурентность: чем длиннее контекст и чем больше запросов обслуживается одновременно, тем больше занимает KV cache. Именно этот уровень определяет, какой поток запросов сможет обслуживать тот же самый набор оборудования после того, как «модель в него поместится».
Перед развёртыванием можно пройтись по такому чек-листу:
- [ ] Модели доступных GPU, их количество и объём видеопамяти на одну карту — можно ли собрать TP4 или TP8
- [ ] Удовлетворяет ли interconnect между картами требованиям к обмену данными при тензорном параллелизме
- [ ] Вмещает ли локальное хранилище веса объёмом около 786 GB (FP8) или около 1,549 GB (BF16), и какова скорость загрузки
- [ ] Целевая длина контекста: достаточно ли 131K или нужно больше
- [ ] Пиковая конкурентность и хватает ли при ней пула KV
- [ ] Нужен ли визуальный вход (в примере vLLM включено только одно изображение)
- [ ] Соответствует ли выбранная версия фреймворка инференса официальному cookbook или recipe
3. Считаем стоимость Hy4 на одной и той же партии задач
3.1 Как считается оплата по факту использования в API
Возьмём для примера страницу модели на APIYI: по состоянию на 21 ноября 2026 года официальная версия Hy4 имеет ID модели hy4, доступна в двух группах — Default и SVIP — и работает через интерфейс Chat Completions. Цена указана за миллион токенов: некэшированный ввод $0.85, вывод $2.55, чтение из кэша $0.045; фактическое списание смотрите в консоли. Стоит пояснить, что Hy4 появилась на APIYI раньше, чем открыли текущие веса; в анонсе упоминается поддержка зрения, но в расчётах ниже мы предполагаем только текст и не приравниваем заявленные в карточке модели контекстное окно 1M, видео или возможности Computer Use к реальным результатам работы хостингового сервиса.
При подсчёте все три типа токенов считаются по отдельности и не дублируются: один и тот же входной токен идёт либо как некэшированный ввод, либо как чтение из кэша — дважды за него не берут. Ниже пример гипотетического расчёта, а не реальные измерения:
| Пункт | Предполагаемый объём | Цена за миллион | Стоимость |
|---|---|---|---|
| Некэшированный ввод | 10 млн токенов | $0.85 | $8.50 |
| Вывод | 3 млн токенов | $2.55 | $7.65 |
| Чтение из кэша | 0 | $0.045 | $0 |
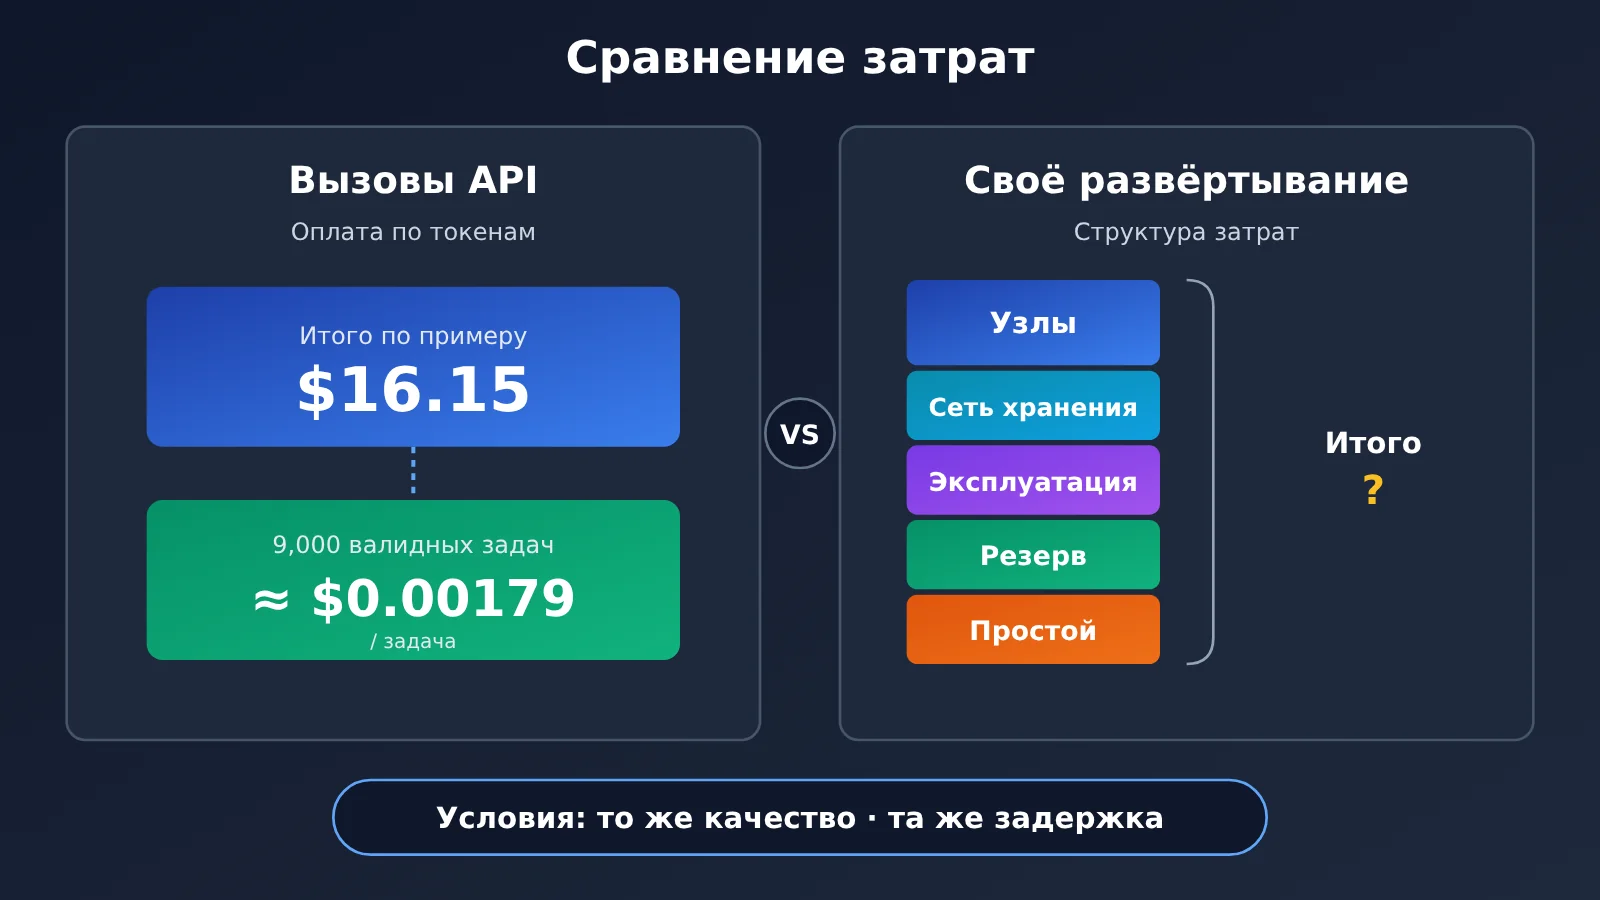
| Итого | — | — | $16.15 |
Предположим, из этой партии вызовов 9 000 результатов прошли вашу приёмку — тогда стоимость одной принятой задачи составит примерно $16.15 ÷ 9 000 ≈ $0.00179. Измерять лучше «стоимость одной принятой задачи», а не «стоимость одного вызова», потому что сюда должны входить и затраты на неудачные попытки, и на переделки. Это число стоит записывать вместе с реально наблюдаемой задержкой и с той конкурентностью, которую выдерживаете, — иначе сравнить его с вариантом самостоятельного развёртывания не получится.
3.2 Реальная структура затрат на самостоятельное развёртывание
Затраты на самостоятельное развёртывание далеко не ограничиваются самим GPU. В таблице ниже перечислены все статьи, которые нужно учитывать:
| Статья затрат | Содержание |
|---|---|
| Вычислительный узел | Стоимость покупки или аренды узла с 4 или 8 высокопроизводительными GPU |
| Хранение и сеть | Хранение весов почти терабайтного масштаба, пропускная способность загрузки, соединения между картами и между узлами |
| Эксплуатация | Людские ресурсы на обновление фреймворков инференса, мониторинг и оповещения, устранение сбоев |
| Резервирование | Резервные узлы для обеспечения доступности, которые обычно могут простаивать |
| Коэффициент использования | Стоимость простоя в периоды низкого трафика — она напрямую повышает цену за каждую задачу |
При сравнении двух вариантов нужно исходить из одинакового качества и одинаковой задержки: на одном и том же наборе задач, по одним и тем же критериям приёмки, при близких целевых показателях задержки и параллелизма отдельно рассчитать стоимость каждой прошедшей задачи. Поскольку цены на оборудование, коэффициент использования и стоимость рабочей силы сильно различаются от команды к команде, в этой статье мы не приводим единую «точку окупаемости». Вам нужно считать по своим ценам и кривой трафика.
4. Решение о развёртывании Hy4: API, самостоятельный хостинг или переход на модель поменьше
Если объединить выводы трёх предыдущих разделов, получаются три пути по условиям:
- Комплаенс позволяет + сначала пробуем чисто текстовые задачи → идём через API. Железо готовить не нужно: сначала на реальных задачах считаем стоимость и задержку каждого зачтённого результата — это будет базовой линией для дальнейших решений.
- Нужна жёсткая изоляция данных или действительно требуется свой контроль над конфигурацией инференса → инвентаризируем железо и проверяем самостоятельное развёртывание. Сначала сверяем ресурсы со списком из раздела 2.2, запускаем по примеру конфигурации для SGLang или vLLM, а затем на том же наборе задач, что и для API, сравниваем качество, задержку и стоимость. Перед тем как открывать сервис наружу, просим юристов проверить раздел 10 лицензии.
- Ресурсы не дотягивают до масштаба из примера → пересматриваем модель в сторону меньшей. Если не удаётся собрать 4 или 8 топовых GPU, то попытки сжать контекст или увеличить параллелизм скорее всего не дадут нужного качества и задержки — переход на модель поменьше обычно реалистичнее.
Карточка действий
- Выбираем веса: для инференса —
Hy4-FP8, для продолжения обучения —Hy4-base, и проверяем, что это неflash. - Готовим 200–500 реальных задач и заранее описываем критерии приёмки.
- Если данные можно передавать наружу, сначала прогоняем всё через API; если нет — тестируем на публичных или синтетических примерах, а реальные данные оставляем во внутреннем контуре. Фиксируем расход токенов, долю зачтённых результатов, задержку и поведение при параллельных запросах.
- Если нужен самостоятельный хостинг — сверяем железо со списком и повторяем замеры на той же партии задач.
- Финальное решение принимаем по одной метрике: «стоимость каждого зачтённого результата + задержка».
Справочные материалы
- Официальное объявление о запуске Tencent Hy4: https://www.tencent.com/tencent-launches-hy4-joining-the-ranks-of-the-worlds-leading-open-source-ai-models/
- Веса Hy4 Instruct (BF16): https://huggingface.co/tencent/Hy4
- Веса Hy4 Instruct (FP8): https://huggingface.co/tencent/Hy4-FP8
- Веса Hy4 Base: https://huggingface.co/tencent/Hy4-base
- Tencent Hy License 1.0: https://huggingface.co/tencent/Hy4/blob/main/LICENSE
- Hy4 Preview (Apache 2.0): https://huggingface.co/tencent/Hy4-preview
- SGLang Hy4 Cookbook: https://docs.sglang.io/cookbook/autoregressive/Tencent/Hy4
- vLLM Hy4 Recipe: https://recipes.vllm.ai/tencent/Hy4
- APIYI: описание запуска Hy4: https://docs.apiyi.com/news/hy4-launch
- APIYI: список моделей (Tencent): https://docs.apiyi.com/models#腾讯
- Обзор контекста Hy4 (исторический снимок; информация о весах и доступности — согласно этой статье): https://help.apiyi.com/tencent-hy4-770b-vision-computer-use-pricing.html