Кратко: статья сравнивает бюджет вывода, настройки рассуждения по умолчанию и схему тарификации Qwen4-Max-Preview и стабильной версии Qwen4-Max, а также приводит пошаговый чек-лист миграции, который можно выполнить до отключения Preview 25 ноября.
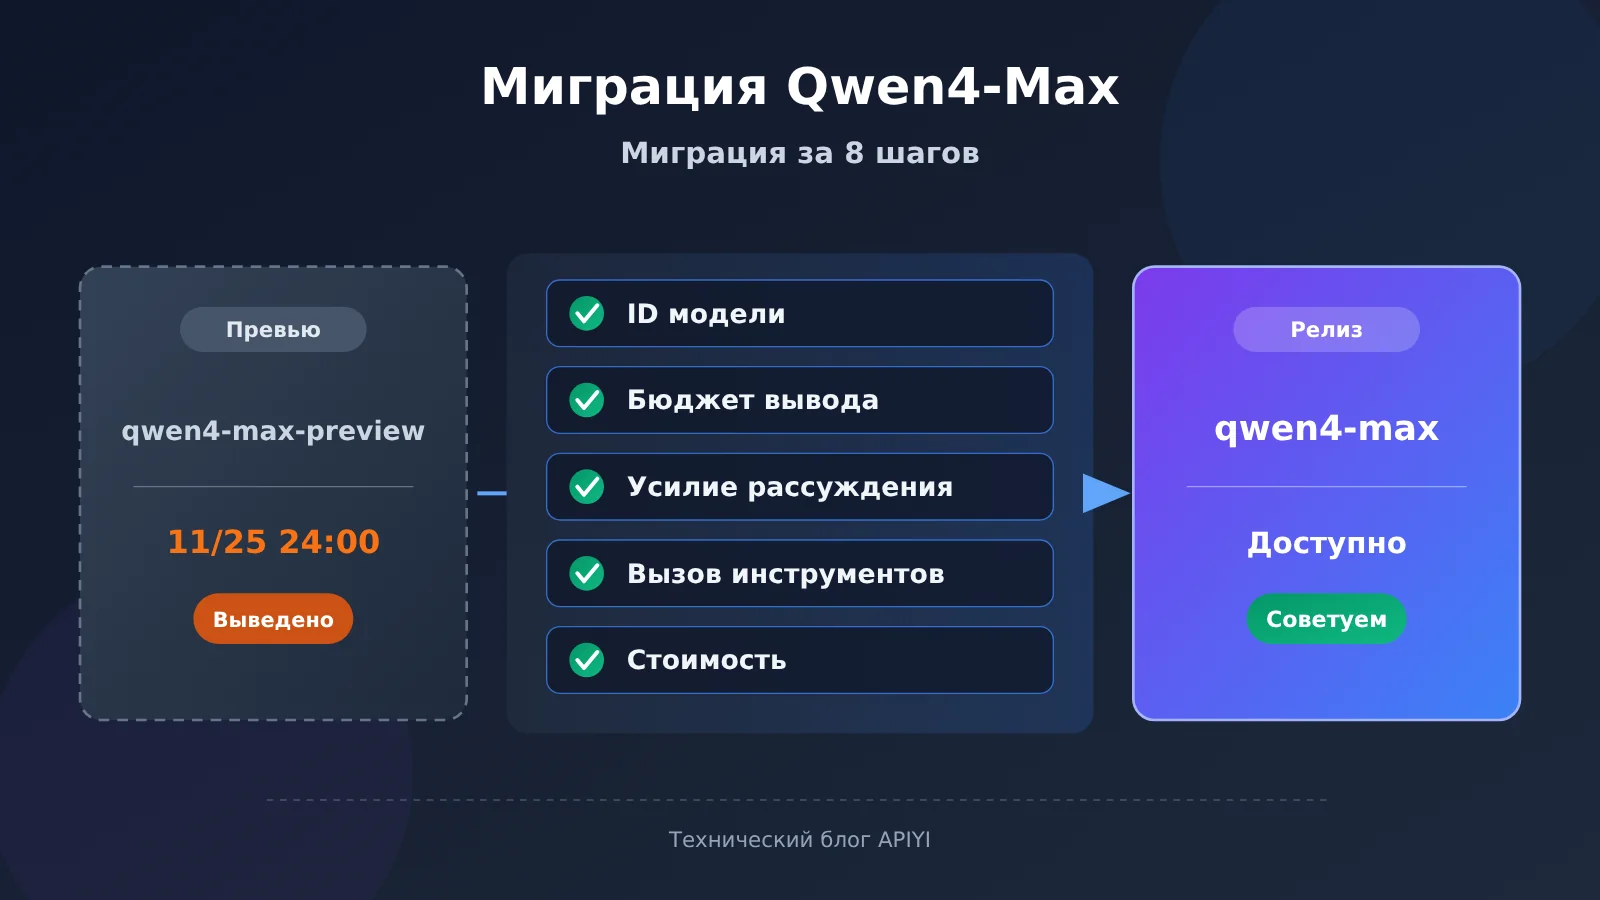
Qwen4-Max-Preview 25 ноября 2026 г. в 24:00 (UTC+8) завершит предпросмотр и будет выведена из эксплуатации. Стабильная версия Qwen4-Max вышла 16 ноября, её ID модели — qwen4-max. При миграции на стабильную версию нужно одновременно проверить пять пунктов: подключённый продукт, бюджет вывода, настройки рассуждения по умолчанию, поведение инструментов и стоимость. Обе версии предоставляют контекстное окно в 1 млн токенов, но в стабильной версии в режиме рассуждения лимит вывода снижается с 393,216 до 262,144, уровень рассуждения по умолчанию меняется с xhigh на high, а тарификация расширяется с Token Plan Credits до оплаты по факту использования. Одной смены ID модели недостаточно, чтобы гарантировать одинаковое поведение в производственных задачах.
Далее сначала разберём таймлайн и различия в спецификациях Preview и стабильной версии, затем опишем API-протокол, регионы, цены и кэширование стабильной версии. После этого дадим чек-лист миграции в порядке «сохранить базовые показатели, настроить интеграцию, параметры запроса, проверить функциональность, наблюдать за биллингом, поэтапно переключить трафик», а в конце перечислим критерии приёмки для длинных отчётов, генерации кода и многоходовых Agent-задач. После прочтения вы сможете превратить это переключение в повторяемый процесс управления версиями моделей для команды.
К сведению: термины миграции Qwen4-Max
| Термин | Объяснение |
|---|---|
| Model ID | Идентификатор, указываемый в запросе для выбора конкретной версии модели, например qwen4-max. |
| Base URL | Базовый URL-адрес API, который клиент использует для подключения к продукту или региональному сервису. |
| Контекстное окно | Общий объём, который модель может обработать за один запрос, включая входные данные, историю и сгенерированный текст. |
| Бюджет вывода | Максимальное число токенов, разрешённое для генерации в одном запросе. В режиме мышления рассуждения и итоговый ответ совместно используют этот бюджет. |
| reasoning_effort | Параметр запроса, управляющий интенсивностью рассуждений. Значение по умолчанию различается в Preview и в релизной версии. |
| thinking_budget | Параметр, управляющий бюджетом токенов на мышление. В Preview его нельзя задавать одновременно с reasoning_effort. |
| Token Plan | Подписной сервис Alibaba Cloud Bailian с расчётами в Credits; также единственный канал доступа к Preview. |
| Function Calling | Механизм, при котором модель на основе описания инструментов возвращает запрос на вызов, а приложение выполняет инструмент и возвращает результат. |
| JSON Schema | Спецификация, описывающая структуру, поля и ограничения JSON; используется для задания формата вывода модели. |
| TTL | Время хранения кэша; влияет на объём повторного использования кэша и соответствующую стоимость. |
| Регрессионная проверка | Проверка изменений функциональности, результатов и затрат после смены версии на существующих репрезентативных задачах. |
1 Когда завершится Qwen4-Max-Preview и когда выйдет официальная версия
1.1 Хронология версий Qwen4-Max
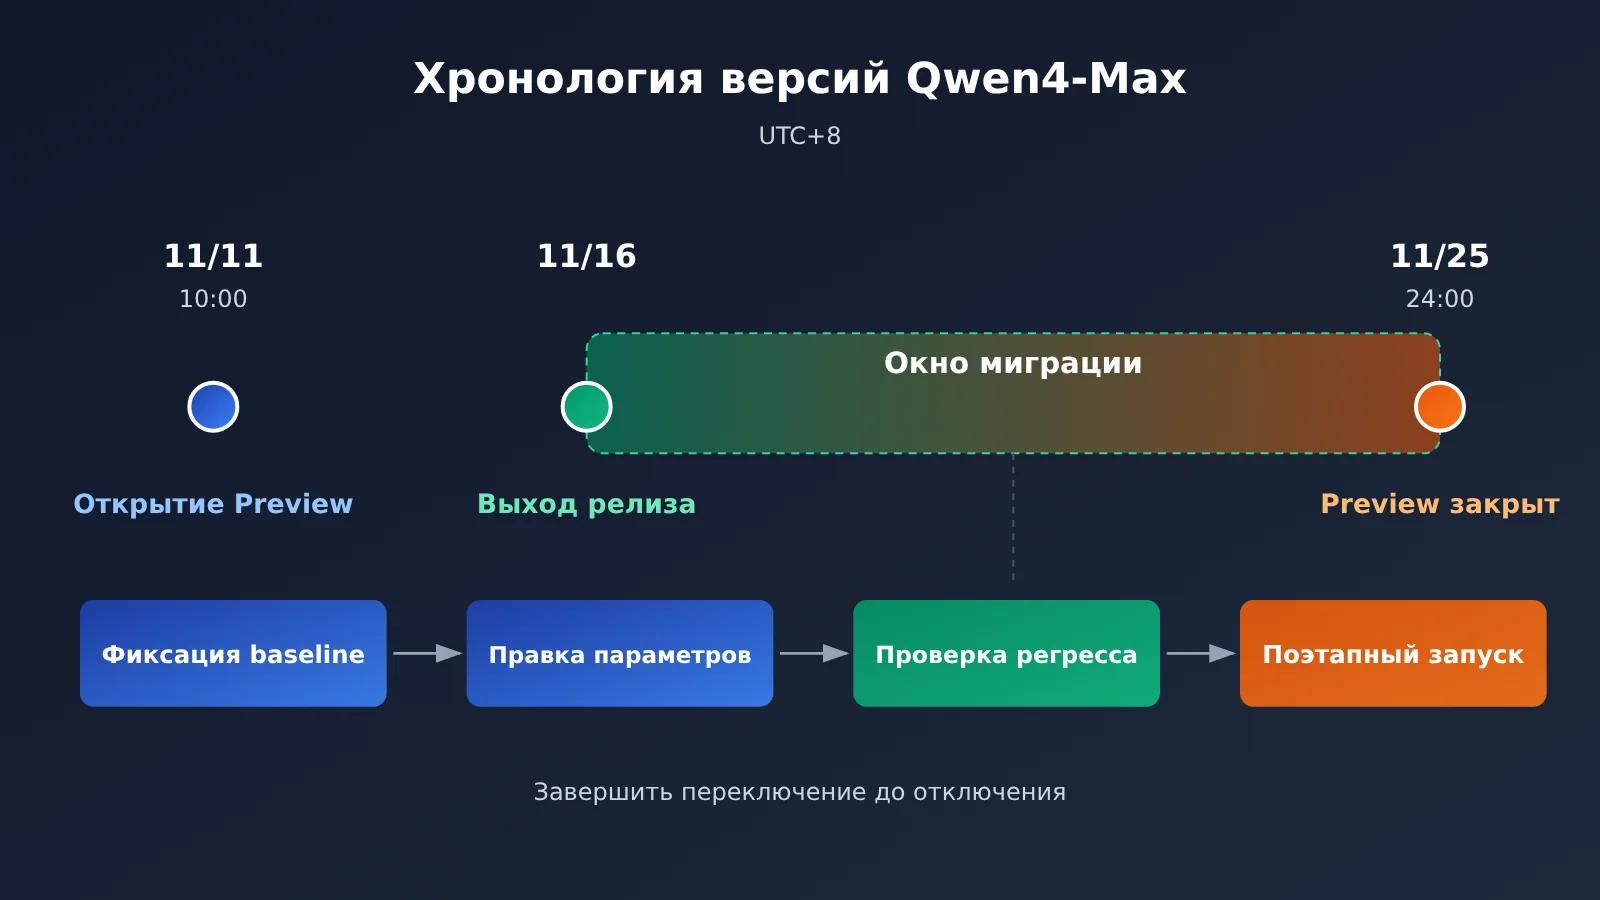
В журнале обновлений функций Alibaba Cloud Token Plan зафиксированы два отдельных события: 11 ноября открылся доступ к Preview, а 16 ноября вышла официальная версия. После выпуска официальной версии изначально запланированное время отключения Preview не изменилось. В верхней части официальной документации Preview также указано: «Официальная версия Qwen4-Max уже доступна, рекомендуем использовать её».
| Время (UTC+8) | Событие | Что это значит для разработчиков |
|---|---|---|
| 2026-11-11 10:00 | Открыт доступ к Qwen4-Max-Preview | Вызов возможен только через Token Plan для индивидуального или командного использования |
| 2026-11-16 | Выпущена официальная версия Qwen4-Max | Поддерживается API с оплатой по фактическому использованию, также доступна через Token Plan |
| 2026-11-25 24:00 | Завершение preview-периода и отключение Preview | qwen4-max-preview больше нельзя вызывать, и его нельзя использовать как запасной вариант |
1.2 Два ID модели и соответствующие им каналы
ID модели Preview — qwen4-max-preview, псевдоним — qwen4.0-max-preview. Через любой из этих двух ID можно выполнять вызовы, но в счёте они всегда отображаются как qwen4.0-max-preview. Для доступа к Preview используется выделенный API-ключ Token Plan и выделенный Base URL https://token-plan.cn-beijing.maas.aliyuncs.com; оплата по фактическому использованию не поддерживается.
ID официальной версии — qwen4-max. Для официальной версии есть два пути использования: первый — Token Plan для индивидуального или командного использования, второй — API Bailian с оплатой по фактическому использованию. У этих двух путей разные ключи, Base URL и правила тарификации, поэтому при миграции сначала нужно определить, какой из них использовать.
2 Различия в спецификациях Qwen4-Max-Preview и официальной версии
2.1 Сравнительная таблица характеристик Qwen4-Max
Данные ниже взяты из официальной документации моделей Preview и официальной версии.
| Технический показатель | Qwen4-Max-Preview | Qwen4-Max, официальная версия |
|---|---|---|
| ID модели | qwen4-max-preview |
qwen4-max |
| Контекстное окно | 1,000,000 | 1,000,000 |
| Максимальный вход (без рассуждений / с рассуждениями) | В документации отдельно не указано | 991,808 / 983,616 |
| Максимальный выход (режим без рассуждений) | В документации отдельно не указано | 131,072 |
| Максимум в сумме: рассуждения + ответ | 393,216 | 262,144 |
| Уровень рассуждений по умолчанию | xhigh | high |
| Бюджет рассуждений по умолчанию | Зависит от параметров API Preview | 131,072 |
| Протокол API | OpenAI Chat Completions, Responses, Anthropic Messages | Три перечисленных + DashScope |
| Способ оплаты | Только кредиты Token Plan | API с оплатой по факту использования либо Token Plan |
2.2 Разница между контекстом, входом, выходом и бюджетом рассуждений
Эти четыре числа описывают разные вещи, и при миграции их проще всего перепутать. Контекстное окно — это общий объём, который можно обработать за один запрос; в обеих версиях он составляет 1 миллион. Максимальный вход определяет, сколько материала можно передать за один раз. В официальной версии в режиме рассуждений он равен 983,616 — чуть меньше, чем в обычном режиме; запас оставлен под рассуждения. Максимальный выход определяет, сколько токенов можно сгенерировать за один раз, а бюджет рассуждений — сколько из них можно потратить на рассуждения.
Самое заметное изменение — на стороне вывода. В Preview рассуждения и ответ совместно используют 393,216 токенов, а в официальной версии в режиме рассуждений общий лимит составляет 262,144, при этом бюджет рассуждений по умолчанию — 131,072. Если считать по конфигурации по умолчанию, в официальной версии под финальный ответ остаётся около 130 тысяч токенов. Если ваш сценарий в Preview опирается на длинный вывод более чем в 200 тысяч токенов за один раз, после перехода придётся переработать схему вывода.
3. Возможности API и стоимость официальной версии Qwen4-Max
3.1 Протоколы и функции
Официальная версия поддерживает четыре протокола: OpenAI Chat Completions, OpenAI Responses, Anthropic Messages и DashScope. Что касается функций, официально заявлены Function Calling, параллельный вызов инструментов, поиск в интернете, JSON Object, JSON Schema, явное кеширование, неявное кеширование, а также сводка и шифрование цепочки рассуждений.
По сравнению с Preview в документации официальной версии появились протокол DashScope, параллельный вызов инструментов и описание двух типов кеширования. Если ваше приложение раньше обрабатывало только один tool_call, теперь нужно проверить, что код корректно справляется со случаем, когда в одном ответе возвращается несколько вызовов инструментов.
3.2 Регионы и оплата по факту использования
API официальной версии с оплатой по факту использования охватывает шесть регионов. При выборе региона помимо цены стоит учитывать сетевую задержку, требования к местонахождению данных и географию развёртывания бизнеса. Конкретные возможности каждого региона уточняйте в официальной матрице возможностей.
| Регион | Зона развёртывания | Ввод (юаней за миллион Token) | Вывод (юаней за миллион Token, включая рассуждения) |
|---|---|---|---|
| Северный Китай 2 (Пекин) | Материковый Китай | 10 | 30 |
| США (Вирджиния) | Глобальная | 10 | 30 |
| Германия (Франкфурт) | Глобальная | 10 | 30 |
| Япония (Токио) | Глобальная | 10 | 30 |
| Гонконг, Китай | Глобальная | 10 | 30 |
| Сингапур | Международная | 10.938 | 32.813 |
На официальной странице Пекинского региона указана бесплатная квота в 1 миллион Token со сроком действия 90 дней. Отсчёт начинается с самого позднего из условий: активация Bailian, публикация модели, одобрение заявки и т. п. Указанные цены действуют только для официальной версии. Ставки Preview — скидка 2 раза и наложение ночной скидки до 8 % — относятся к льготам Token Plan Credits и не переносятся на расчёт стоимости официальной версии.
3.3 Явное и неявное кеширование
В официальной версии кеширование оплачивается отдельно. Явное кеширование создаётся разработчиком вручную и подходит для системных промптов, описаний инструментов, постоянных справочных материалов и других неизменных префиксов. TTL можно выбрать 5 минут или 1 час; поддерживаются Chat Completions, Responses и Anthropic Messages. Неявное кеширование платформа обрабатывает автоматически по таким условиям, как повторяющийся префикс, и дополнительная настройка для него не требуется.
Многораундовый Agent на каждом раунде передаёт одни и те же определения инструментов и фоновые материалы, поэтому разумное использование кеша заметно снижает расходы на повторный ввод. TTL стоит выбирать исходя из интервалов между сессиями: для сессий с интенсивным взаимодействием — 5 минут, для пакетных процессов с большими паузами можно рассмотреть 1 час.
4. Шаги перехода с Qwen4-Max-Preview на официальную версию
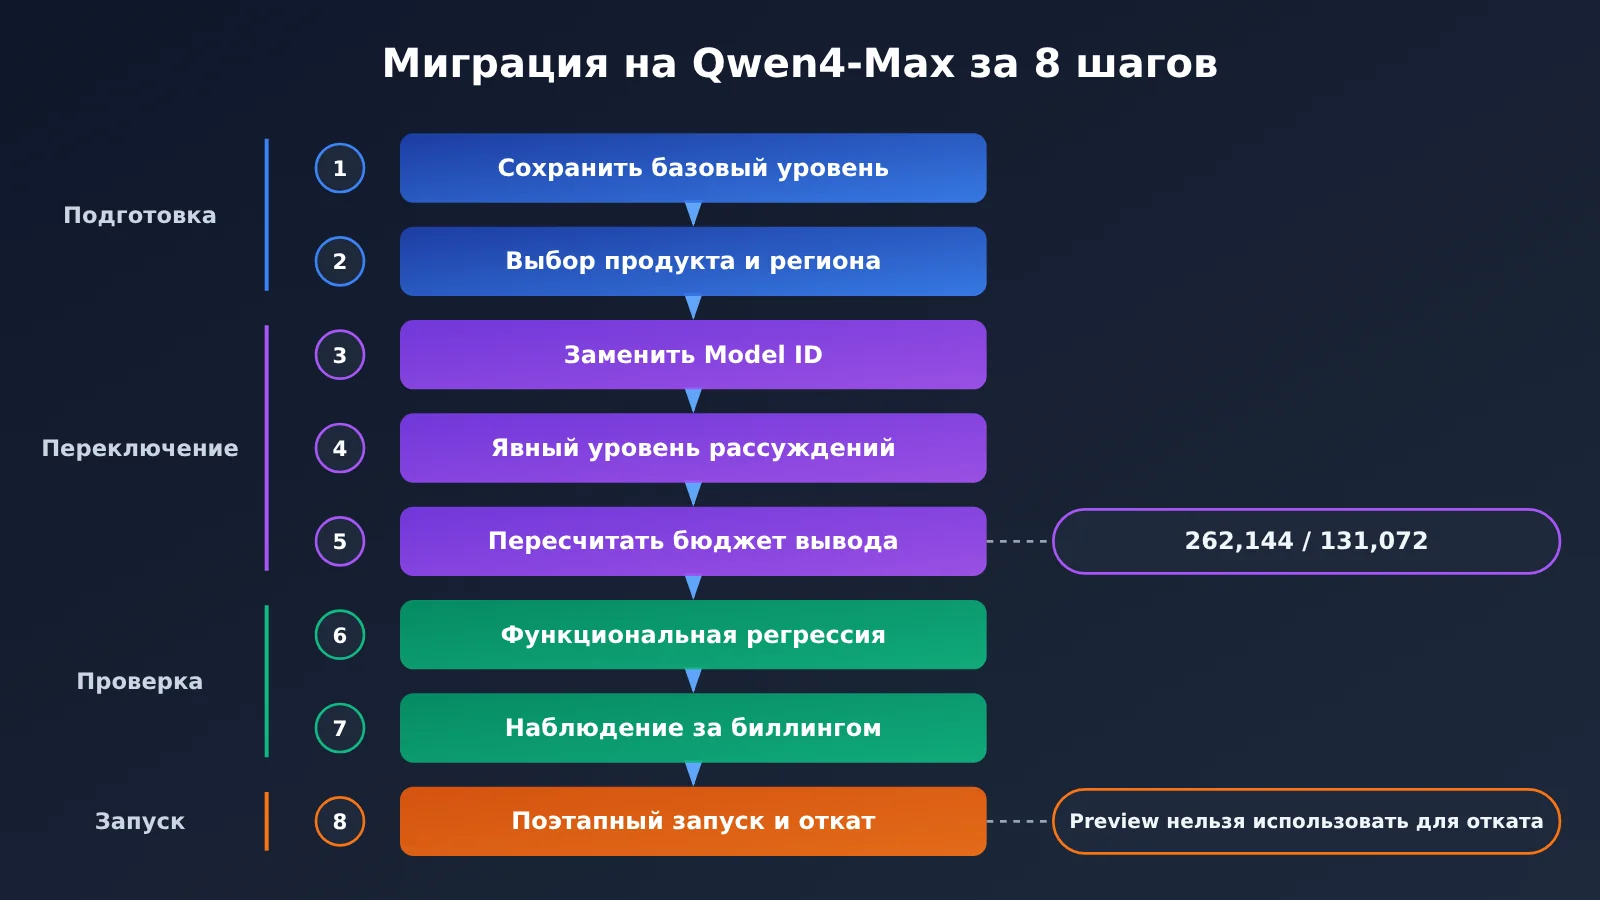
Ниже — 8 шагов проверки для разработчиков, составленных по официальной спецификации. Готового инструмента автоматической миграции официально нет, и официально не заявлено, что все параметры запросов переносятся без изменений, поэтому каждый шаг нужно реально проверить на своём проекте.
| Шаг | Что проверяем | Критерий приёмки |
|---|---|---|
| 1 | Сохраняем старую конфигурацию и репрезентативные задачи | Параметры запросов Preview, примеры вывода, время выполнения и расход уже сохранены в архиве |
| 2 | Выбираем продукт доступа, проверяем регион, Key, Base URL | Серверный сервис использует API с оплатой по факту, интерактивные инструменты — Token Plan |
| 3 | Меняем model на qwen4-max |
Тестовый запрос возвращает нормальный ответ, название модели в биллинге указано верно |
| 4 | Явно задаём силу рассуждения | Для каждой задачи прописываем reasoning_effort или соответствующее поле, не полагаемся на значения по умолчанию |
| 5 | Пересчитываем бюджет вывода | В режиме рассуждений суммарно ≤ 262,144, без рассуждений ≤ 131,072 |
| 6 | Проверяем вызов инструментов, структуру JSON, длинный вывод, многораундовую историю | Доля успешных прогонов репрезентативных задач не ниже базовой линии Preview |
| 7 | Наблюдаем за расходом и счетами за кэш | Затраты на вход, выход и кэш соответствуют ожиданиям |
| 8 | Переключаем небольшой поток трафика и готовим конфигурацию для отката | Целью отката должна быть всё ещё действующая модель; Preview в их число не входит |
4.1. Сохранение старой конфигурации и репрезентативных задач
До отключения Preview выгрузите конфигурацию всех текущих вызовов qwen4-max-preview: max_tokens, reasoning_effort или thinking_budget, определения инструментов, response_format и системный промпт. Заодно выберите 10–30 репрезентативных задач и сохраните выходные данные Preview, время выполнения и расход как базу для сравнения. После 25 ноября получить результаты Preview уже не удастся.
4.2. Выбор продукта для интеграции и проверка ключа и Base URL
Token Plan разрешает интерактивное использование только в инструментах для программирования или агентных инструментах — Claude Code, Cursor, Qwen Code, Qoder и подобных. Автоматические скрипты, собственные бэкенды приложений и массовые вызовы через workflow-платформы не разрешены: нарушение может привести к приостановке подписки или блокировке ключа. Если Preview используется только в Qoder или аналогичных инструментах, можно по-прежнему переключаться на официальную версию через Token Plan. Если же нужно подключить собственный бэкенд, переходите на API официальной версии с оплатой по факту использования и применяйте ключ и Base URL для нужного региона из консоли.
В персональной версии Token Plan также есть условие об использовании данных: во время работы вводимые и генерируемые данные применяются для улучшения сервиса. Командам, которые работают с конфиденциальными материалами, при выборе продукта для интеграции стоит учесть этот пункт.
4.3 Замена Model ID: быстрый старт с Qwen4-Max
Достаточно поменять Model ID на qwen4-max, и можно отправлять первый запрос. Ниже — минимальный пример через OpenAI-совместимый интерфейс: сначала убедитесь, что запрос проходит, а затем переходите к настройке параметров:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI; можно заменить на Base URL соответствующего региона Bailian
)

resp = client.chat.completions.create(
    model="qwen4-max",                   # Исходное значение — qwen4-max-preview
    messages=[{"role": "user", "content": "用三句话说明你的版本信息"}],
    reasoning_effort="high",             # Указываем явно, не полагаясь на значение по умолчанию
    max_tokens=8192
)
print(resp.choices[0].message.content)
Какие модели доступны в рамках того же OpenAI-совместимого интерфейса, смотрите в актуальном списке моделей платформы. В продакшене обязательно проверьте ещё раз перед релизом.
4.4 Явно задавайте параметры рассуждения
В Preview по умолчанию используется xhigh, в финальной версии — high. Если в прежнем коде сила рассуждения не была указана, после переключения она автоматически снизится, а качество, время выполнения и расход токенов на сложных задачах могут измениться. Лучше указывать силу рассуждения в зависимости от типа задачи: для сложного кода и научных рассуждений сначала возьмите ту же интенсивность, что и в Preview, в качестве базовой линии для сравнения, а для простого извлечения данных и форматирования попробуйте снизить её.
Документация Preview указывает, что reasoning_effort и thinking_budget нельзя задавать одновременно. Для финальной версии имена полей и значения в четырёх протоколах — Chat Completions, Responses, Anthropic Messages и DashScope — следует сверять с документацией соответствующего протокола. В Preview для многоходовых диалогов по умолчанию включён preserve_thinking, а исторические блоки рассуждений нужно возвращать в поле reasoning_content. Если ваше приложение передаёт обратно содержимое рассуждений, проверьте на финальной версии, что формат исторических сообщений корректно принимается.
4.5 Пересчитываем бюджет вывода под новые лимиты
В Preview max_tokens и max_completion_tokens эквивалентны: размышления и ответ делят общий бюджет в 393 216 токенов. В релизной версии общий бюджет режима размышлений — 262 144, а лимит вывода в режиме без размышлений — 131 072. Все запросы, в которых на Preview было выставлено больше 262 144, придётся уменьшить. А там, где бюджет и раньше был впритык, надо ещё учесть кусок, который заберёт бюджет размышлений по умолчанию — 131 072.
Посмотреть полный код конфигурации миграции (проверка бюджета + откат)
from openai import OpenAI

# Официальные лимиты релизной версии (в режиме размышлений — размышления плюс ответ)
LIMITS = {
    "qwen4-max": {"thinking": 262_144, "non_thinking": 131_072},
}

def plan_max_tokens(model: str, thinking: bool,
                    answer_tokens: int, thinking_tokens: int = 0) -> int:
    """Считает max_tokens по режиму; при выходе за официальный лимит сразу выдаёт ошибку, чтобы не было тихого обрезания"""
    limit = LIMITS[model]["thinking" if thinking else "non_thinking"]
    need = answer_tokens + (thinking_tokens if thinking else 0)
    if need > limit:
        raise ValueError(f"{model} 预算 {need} 超过上限 {limit},请拆分任务")
    return need

PRIMARY = {
    "model": "qwen4-max",
    "base_url": "https://api.apiyi.com/v1",  # OpenAI-совместимый адрес APIYI
    "reasoning_effort": "high",
}
# Цель отката должна быть моделью, которая всё ещё обслуживается:
# после отключения qwen4-max-preview использовать её нельзя
FALLBACK = {
    "model": "YOUR_FALLBACK_MODEL",
    "base_url": "https://api.apiyi.com/v1",
}

def call(cfg: dict, messages: list, max_tokens: int):
    client = OpenAI(api_key="YOUR_API_KEY", base_url=cfg["base_url"])
    kwargs = {"model": cfg["model"], "messages": messages, "max_tokens": max_tokens}
    if "reasoning_effort" in cfg:
        kwargs["reasoning_effort"] = cfg["reasoning_effort"]
    return client.chat.completions.create(**kwargs)

def run(messages: list, answer_tokens: int = 60_000, thinking_tokens: int = 131_072):
    budget = plan_max_tokens("qwen4-max", True, answer_tokens, thinking_tokens)
    try:
        resp = call(PRIMARY, messages, budget)
    except Exception as e:
        print(f"主模型失败,切换回退:{e}")
        resp = call(FALLBACK, messages, min(budget, 32_000))
    choice = resp.choices[0]
    if choice.finish_reason == "length":
        print("警告:输出因长度被截断,需要拆分任务或调整预算")
    print("用量:", resp.usage)
    return choice.message.content

if __name__ == "__main__":
    print(run([{"role": "user", "content": "生成一份模型迁移回归报告的大纲"}]))
4.6 Проверка вызова инструментов, структурированного вывода и длинных ответов
Прогоняем по пунктам на репрезентативных задачах: возвращает ли Function Calling те же имена инструментов и ту же структуру параметров, корректно ли код обрабатывает параллельные вызовы инструментов, проходит ли вывод JSON Schema через прежний валидатор, заканчивается ли длинный вывод с finish_reason == "length", остаётся ли контекст связным после передачи истории многораундового диалога. Каждый пункт сравниваем с базовой линией, сохранённой в 4.1, и фиксируем расхождения.
4.7 Наблюдение за использованием и биллингом кэша
После перехода с Credits на оплату по факту использования затраты нужно считать отдельно по трём статьям: вход, выход (включая рассуждения) и кэш. В официальной версии цена за выход в 3 раза выше, чем за вход, а токены рассуждений тоже идут в выход, так что настройка уровня рассуждений напрямую влияет на счёт. Можно сначала прогнать регрессию на бесплатном лимите в регионе Пекина, а затем оценить месячную стоимость по фактическому использованию.
4.8 Переключение малого трафика с сохранением конфигурации отката
Сначала направьте 5–10% трафика на qwen4-max, следите за долей ошибок, долей усечений и стоимостью одной задачи, и только убедившись в стабильности переключайте весь трафик. Конфигурация отката должна указывать на модель, которая всё ещё обслуживается, — например, на другую доступную версию из той же линейки или на уже проверенную модель другого провайдера. После вывода из эксплуатации Preview не может служить целью отката.
🎯 Технический совет: модель отката лучше проверить на той же выборке репрезентативных задач ещё до поэтапного развёртывания. Через OpenAI-совместимый интерфейс APIYI apiyi.com один Key позволяет переключаться между несколькими популярными моделями — достаточно изменить поле
model, чтобы провести учения по откату.
5 Самые частые проблемы после миграции на Qwen4-Max
5.1 Усечение вывода
Это самая частая проблема. Длинные отчёты или большие файлы, которые полностью генерировались на Preview, в стабильной версии могут обрезаться из-за лимита в 262 144 или из-за расхода бюджета на рассуждение по умолчанию. Решение — проверять finish_reason, генерировать сверхдлинные задачи по главам или по файлам, а также выделять явный бюджет на часть с ответом.
5.2 Снижение силы рассуждения по умолчанию
После понижения с xhigh до high поведение на сложных задачах может измениться, а время и стоимость на простых задачах могут снизиться. Код, в котором не заданы параметры рассуждения, незаметно меняет поведение. Вo всех производственных запросах стоит явно задавать силу рассуждения и через A/B-прогон определить подходящий уровень для каждого класса задач.
5.3 Вызов инструментов и различия протоколов
Стабильная версия явно поддерживает параллельные вызовы инструментов, и в одном ответе может появиться несколько запросов на вызов инструментов. Код, который читает только первый tool_call, пропустит выполнение инструментов и прервёт процесс Agent. При смене протокола — например, с Chat Completions на DashScope — надо заново сверять с документацией и названия полей, и способ передачи содержимого рассуждения обратно.
5.4 Изменения в учёте кэша и биллинга
Потребление Credits на Preview зависит от биллингового коэффициента, попаданий в кэш, вызовов инструментов и других факторов, поэтому его нельзя напрямую пересчитать в цену за миллион Token. В стабильной версии используется тариф в юанях за миллион Token, а кэш тарифицируется отдельно. Прежнюю модель бюджета, построенную на Credits, нужно перестроить — с учётом стоимости записи в явный кэш и выбора TTL.
6 Какие задачи обязательно нужно перепроверить в официальной версии Qwen4-Max
| Тип задачи | Что проверять в первую очередь | На какие параметры смотреть |
|---|---|---|
| Генерация длинных отчётов | нет ли обрезки, полны ли разделы, согласованы ли факты между собой | бюджет вывода, finish_reason |
| Генерация сложного кода | доля успешных компиляций и тестов, длина одного файла, согласованность между файлами | reasoning_effort, бюджет вывода |
| Многораундовый Agent | порядок вызовов инструментов, обработка параллельных вызовов, передача истории рассуждений обратно | tool_calls, reasoning_content |
| Поиск по длинным документам | точность связей между абзацами, не выходит ли вход за 983,616 или 991,808 | максимальный вход, попадание в кэш |
| Структурированный вывод JSON | доля успешных проверок по Schema, пропущенные поля и ошибки типов | response_format, JSON Schema |
С поиском по длинным документам нужно быть особенно внимательным: максимальный объём входа в официальной версии зависит от режима, и в режиме рассуждений он примерно на 8,000 токенов меньше, чем в обычном. Если задача забита под самый потолок, после смены режима можно вылететь за ограничение. Для задач с кодом лучше сразу переиспользовать готовый набор юнит-тестов и принимать результат по доле прохождений — это надёжнее, чем читать вывод глазами.
💡 Совет по выбору: если нужно сразу сравнить Qwen4-Max с другими флагманскими моделями на этих задачах, можно прогнать одну и ту же партию задач через единый интерфейс APIYI apiyi.com — это избавит от необходимости писать отдельный адаптерный код под каждого провайдера.
7 Частые вопросы по миграции Qwen4-Max-Preview
Вопрос 1: После отключения Qwen4-Max-Preview старые запросы будут автоматически перенаправляться на стабильную версию?
В официальной документации лишь сказано, что Preview будет отключён, и рекомендуется перейти на стабильную версию; об автоматическом перенаправлении там ничего нет. Пожалуйста, до 24:00 25 ноября вручную поменяйте model на `qwen4-max` и выполните проверки из раздела 4 этой статьи.
Вопрос 2: Достаточно ли просто изменить ID модели на qwen4-max?
Нет, недостаточно. Верхний лимит вывода, уровень рассуждений по умолчанию и способ тарификации изменились. Как минимум нужно пересчитать бюджет вывода, явно задать уровень рассуждений, а также провести регрессионную проверку вызова инструментов и структурированного вывода.
Вопрос 3: Действуют ли на стабильной версии скидки Preview — цена 20% от тарифа (2 折) и ночная скидка?
Эти две скидки распространяются только на расход Credits в Token Plan для Preview. Для API стабильной версии с оплатой по факту действует тариф в регионе Пекин: вход — 10 юаней, выход — 30 юаней за миллион токенов; стоимость нужно пересчитать заново.
Вопрос 4: Может ли бэкенд-сервис продолжать использовать ключ Token Plan?
Нет. Token Plan разрешает только интерактивное использование в указанных инструментах для программирования или агентах. Бэкенду собственного приложения следует перейти на API стабильной версии с оплатой по факту либо использовать агрегирующий сервис с оплатой по факту и OpenAI-совместимым интерфейсом, например APIYI apiyi.com.
Вопрос 5: Как быстро подготовить среду для регрессионного тестирования во время миграции?
Соберите репрезентативные задачи в фиксированный набор запросов — для воспроизведения достаточно переключать поле model в одном и том же коде. APIYI apiyi.com предоставляет новым пользователям бесплатный тестовый лимит, который можно использовать для проверки резервной модели и сравнения вариантов.
8. Заключение: как встроить управление версиями моделей в производственный процесс Qwen4-Max
Переход с Qwen4-Max-Preview на официальную версию затрагивает пять аспектов, которые нужно контролировать постоянно:
- ID модели: хранить централизованно в конфигурационном центре, не хардкодить в коде и подписаться на анонсы о жизненном цикле модели.
- Параметры интерфейса: усилие рассуждения, бюджет размышлений и response_format — всё задавать явно.
- Ограничения вывода: для каждой модели фиксировать четыре числа — контекст, максимальный вход, максимальный выход и бюджет размышлений — и проверять их перед отправкой запроса.
- Стоимость: отдельно отслеживать вход, выход и кэш; при изменении схемы тарификации перестраивать модель бюджета.
- Регрессионные тесты: хранить набор репрезентативных задач и базовые результаты и полностью прогонять его при каждой смене версии.
У Preview жизненный цикл всего две недели; у официальной версии тоже будут новые версии и планы по выводу из эксплуатации. Если закрепить процесс «сохранение базовой линии, явное задание параметров, поэтапное переключение и возможность отката», следующая смена версии займёт несколько дней. Команды, которым нужно подготовить план отката для нескольких моделей, могут проверить его через APIYI apiyi.com в рамках одного интерфейса.
Справочные материалы
-
Официальная документация Qwen4-Max (финальная версия): контекстное окно, лимиты ввода и вывода, уровень рассуждений по умолчанию, регионы, цены и кеширование
- Ссылка:
help.aliyun.com/zh/model-studio/qwen4-max - Пояснение: основной источник при миграции параметров
- Ссылка:
-
Официальная документация Qwen4-Max-Preview: характеристики Preview, способы подключения, дата вывода из эксплуатации
- Ссылка:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Пояснение: справочная база при сохранении старой конфигурации
- Ссылка:
-
Обновления функций Token Plan: записи о запуске Preview и финальной версии
- Ссылка:
help.aliyun.com/zh/model-studio/token-plan-product-updates - Пояснение: источник данных для хронологии версий
- Ссылка:
-
Права и правила использования Token Plan: границы интерактивного применения и запрещённые сценарии
- Ссылка:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Пояснение: основа для проверки соответствия при выборе продукта для подключения
- Ссылка:
-
Подписка и преимущества персональной версии Token Plan: тарифы, Credits и скидки Preview
- Ссылка:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - Пояснение: помогает различать скидки Preview и тарификацию финальной версии
- Ссылка:
Автор: техническая команда APIYI
Связь по техническим вопросам: пишите нам через главную страницу APIYI apiyi.com; больше материалов по подключению — в центре документации docs.apiyi.com