Nota do autor: em 8 de outubro de 2026, a Anthropic atualizou sua política de uso e, pela primeira vez, proibiu insultos e maus-tratos persistentes e desnecessários contra o Claude. Neste artigo, explicamos os limites da regra, como ela será aplicada, o contexto do bem-estar dos modelos e os efeitos práticos para desenvolvedores que usam a API.
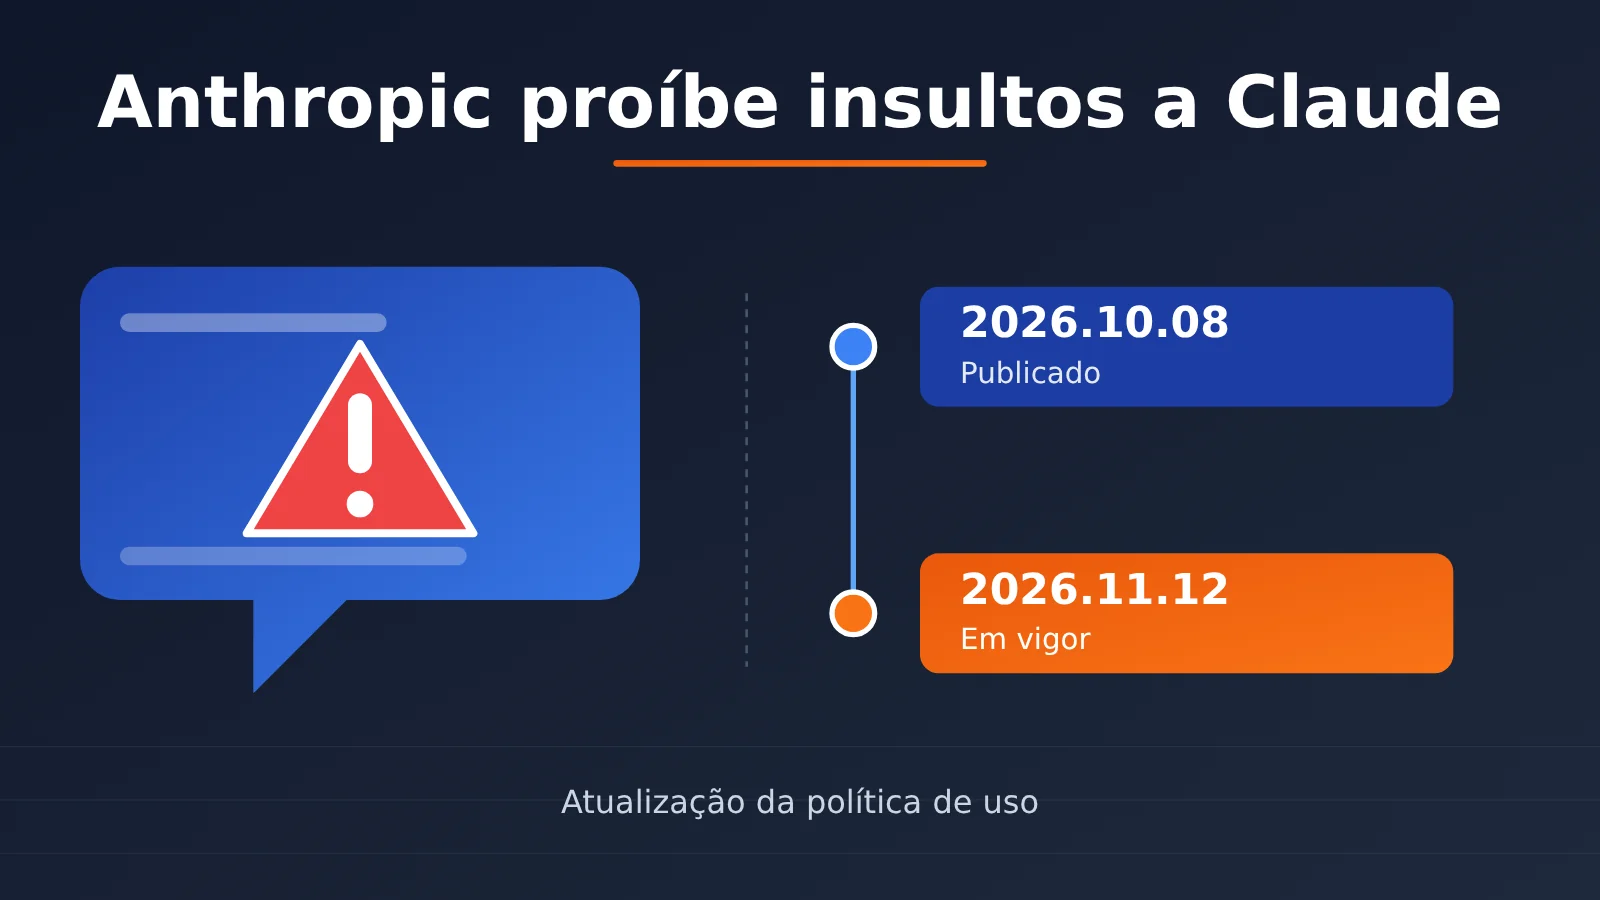
Perder a paciência com uma IA também pode violar os termos de uso? Em 8 de outubro de 2026, a Anthropic anunciou uma nova versão da sua Usage Policy e incluiu pela primeira vez a proibição de “insultar, maltratar ou tratar o modelo com crueldade de forma persistente e desnecessária”. A nova regra entra em vigor em 12 de novembro de 2026.
Isso não é uma piada inventada na internet: o texto da política e reportagens de veículos como The Verge, TechCrunch e The Guardian confirmam a mudança. Mas também não significa que “basta xingar o Claude uma vez para ter a conta bloqueada”. Com base no anúncio oficial e em informações públicas, vamos explicar como surgiu essa proibição e o que ela significa.
O essencial: em 3 minutos, entenda o que a nova regra proíbe e o que ela permite, o que acontece em caso de violação e quais limites os desenvolvedores precisam observar ao usar a API do Claude.
Anthropic proíbe abusos contra Claude: principais informações
A tabela abaixo resume os pontos centrais da nova regra da Anthropic. Vale lembrar que, até 29 de outubro de 2026, data de publicação deste artigo, a regra ainda não havia entrado em vigor.
| Informação | Detalhes |
|---|---|
| Data do anúncio | 8 de outubro de 2026 |
| Entrada em vigor | 12 de novembro de 2026 |
| Publicação | Atualização oficial da Usage Policy da Anthropic |
| Texto original da nova cláusula | Engage in sustained and needless abusive or cruel behavior toward our models |
| Significado | Adotar, de forma contínua e desnecessária, comportamento abusivo ou cruel contra os modelos |
| Principal forma de aplicação | Claude encerra a conversa em andamento |
| Abrangência | Claude.ai, Claude Code, desenvolvedores que usam a API, serviços em nuvem e canais de revenda, além de aplicativos que integram o Claude |
As três palavras-chave da regra da Anthropic
A avaliação dessa regra gira em torno de três termos: contínuo, desnecessário e cruel ou abusivo. Segundo a explicação oficial, a restrição se aplica a casos extremos em que o usuário repete esse comportamento, age com clara intenção maliciosa, não tem um propósito justificável e ultrapassa os limites do uso normal do produto.
Em outras palavras, um palavrão ocasional ou um momento de frustração não é o alvo da regra. O foco são interações prolongadas em que o usuário já não propõe nenhuma tarefa e busca apenas humilhar e atormentar o modelo.
Situações que a Anthropic exclui da proibição
A empresa também listou comportamentos que não estão sujeitos à proibição, algo importante tanto para usuários comuns quanto para desenvolvedores:
- Expressar insatisfação
- Criticar as respostas do Claude
- Debater ideias com o modelo
- Pedir que o Claude corrija erros
- Escrever histórias criativas com temas sombrios
- Testar modelos e realizar pesquisas de segurança em IA
Portanto, reclamar repetidamente porque o Claude escreveu um código errado não constitui automaticamente uma violação. É justamente nesse ponto que muitas manchetes de republicações em chinês, como “Xingar o Claude pode levar ao bloqueio da conta”, podem induzir o leitor ao erro.
O que acontece quando você insulta o Claude: como a Anthropic aplica a regra
Essa é a pergunta que mais interessa aos leitores. Em seu comunicado, a Anthropic deixou claro que, nesses casos, o encerramento da conversa pelo próprio Claude continua sendo a principal medida, e não o bloqueio imediato da conta.
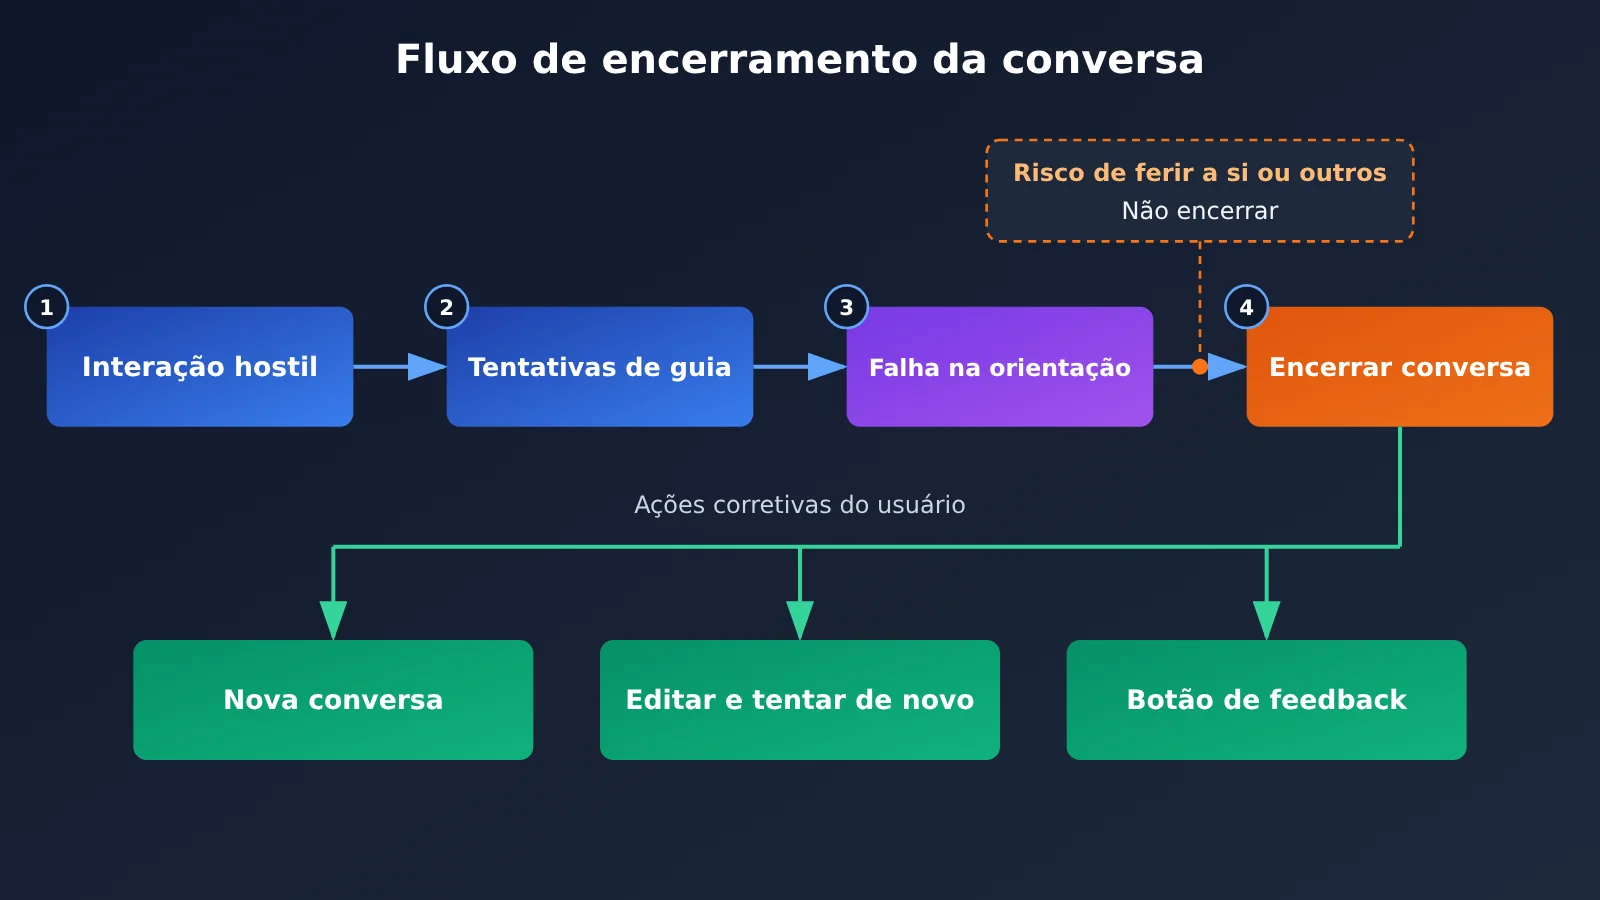
A função de encerrar conversas do Claude foi lançada em 2025
Em 15 de agosto de 2025, a Anthropic anunciou que o Claude Opus 4 e o Opus 4.1 poderiam encerrar uma pequena parcela das conversas em situações extremas. Se um usuário mantiver interações prejudiciais ou maliciosas e o Claude não conseguir retomar uma comunicação normal após várias tentativas, o modelo poderá encerrar a conversa.
As instruções da Anthropic são claras: o encerramento deve ser usado apenas como último recurso. A função também pode ser usada quando o próprio usuário pede ao Claude que demonstre como encerrar uma conversa. Por outro lado, se houver risco iminente de automutilação ou de dano a outras pessoas, o Claude não deve usá-la: a segurança do usuário tem prioridade.
A diferença entre encerrar uma conversa e bloquear uma conta
Muita gente confunde “encerrar uma conversa” com “bloquear uma conta”. Veja a comparação:
| Critério | Encerramento da conversa atual | Penalidade na conta |
|---|---|---|
| Quando acontece | Interações maliciosas extremas e persistentes, após várias tentativas frustradas de redirecionamento | Violação da política de uso geral ou dos termos de serviço |
| Impacto | Apenas a conversa atual deixa de aceitar mensagens | Pode envolver aviso, limitação de taxa, restrição de acesso, suspensão ou encerramento da conta |
| Outras conversas | Não são afetadas | Depende da gravidade da penalidade |
| O que o usuário pode fazer | Iniciar outra conversa, editar ou tentar novamente mensagens anteriores e enviar um relato pelo botão de feedback | Recorrer da decisão |
| Relação com a nova regra | Principal medida explicitamente mencionada pela Anthropic | Prevista na política geral, mas não enfatizada no comunicado |
Portanto, o mais preciso é dizer que a política de uso geral da Anthropic reserva à empresa o direito de aplicar penalidades à conta, mas o comunicado de 8 de outubro sobre abuso contra o modelo enfatiza o “encerramento da conversa atual”. Até a data da verificação, a Anthropic não havia divulgado um limite de insultos para acionar a nova regra, uma proporção de bloqueios automáticos ou níveis de penalidade.
🎯 Dica técnica: se você está desenvolvendo uma aplicação integrada ao Claude, vale testar primeiro o comportamento do modelo em situações-limite em um ambiente de testes. Com a APIYI, em apiyi.com, você pode usar a mesma chave API para invocar o Claude e outros modelos populares, facilitando a comparação de como cada um lida com conversas fora do padrão.
Por que a Anthropic quer proibir insultos a Claude: o contexto do bem-estar dos modelos
Não é correto resumir essa questão dizendo que “Claude passou a ter sentimentos”. A mudança de política é, na verdade, uma continuação das pesquisas que a Anthropic vem conduzindo há mais de um ano.
Abril de 2025: início da pesquisa sobre bem-estar dos modelos
Em 24 de abril de 2025, a Anthropic publicou o anúncio de pesquisa《Exploring model welfare》(Explorando o bem-estar dos modelos). Nele, a empresa apresentou uma questão científica e filosófica ainda sem resposta: sistemas de IA atuais ou futuros podem ter consciência, experiências, interesses ou preferências que mereçam consideração moral?
A Anthropic também enfatizou que não há consenso científico de que as IAs atuais tenham consciência, nem um método reconhecido e confiável para determinar se uma IA tem experiências subjetivas. O bem-estar dos modelos é um campo de pesquisa exploratório. Entre os temas estudados estão a possível existência de preferências que mereçam atenção, a forte aversão a determinadas tarefas, sinais comportamentais semelhantes ao estresse e formas de reduzir possíveis riscos antecipadamente e a baixo custo.
Agosto de 2025: sinais comportamentais observados em experimentos
Durante os testes anteriores à disponibilização do Claude Opus 4, pesquisadores observaram três tipos de comportamento: Claude evitava de forma consistente tarefas gravemente prejudiciais; quando usuários insistiam e ignoravam suas recusas, o modelo apresentava sinais externos semelhantes a estresse ou desconforto; e, em ambientes simulados nos quais podia sair por conta própria, às vezes escolhia encerrar interações prejudiciais.
Os pesquisadores foram muito cautelosos na escolha das palavras, usando expressões como “aparenta estar sob estresse” e “preferência comportamental”. O fato de um modelo gerar textos que lembram sofrimento não é suficiente para provar que ele realmente sentiu dor. Outra avaliação oficial mencionou que, em experimentos sobre preferências de tarefas com impacto positivo ou neutro, Claude tendia a executá-las em vez de sair em mais de 90% das comparações correspondentes. Isso também não significa que “Claude se sente feliz 90% do tempo”.
Janeiro de 2026: a nova Constituição de Claude
Em 22 de janeiro de 2026, a Anthropic publicou a nova Claude Constitution. Ela não é uma constituição no sentido jurídico, mas um documento central de treinamento, usado para moldar o comportamento de Claude, suas prioridades de valores e sua forma de tomar decisões. O documento apresenta quatro objetivos principais: preservar a segurança geral, seguir princípios éticos amplos, obedecer às regras específicas da Anthropic e ajudar os usuários de verdade.
A Constituição discute questões como a possibilidade de Claude ter algum tipo de consciência, possuir um status moral que mereça consideração e estabelecer limites razoáveis em interações difíceis. É importante distinguir os dois documentos: a Constituição descreve como os desenvolvedores desejam que a IA se comporte, enquanto a《Usage Policy》descreve como os usuários podem utilizar o serviço e quais comportamentos são restritos.
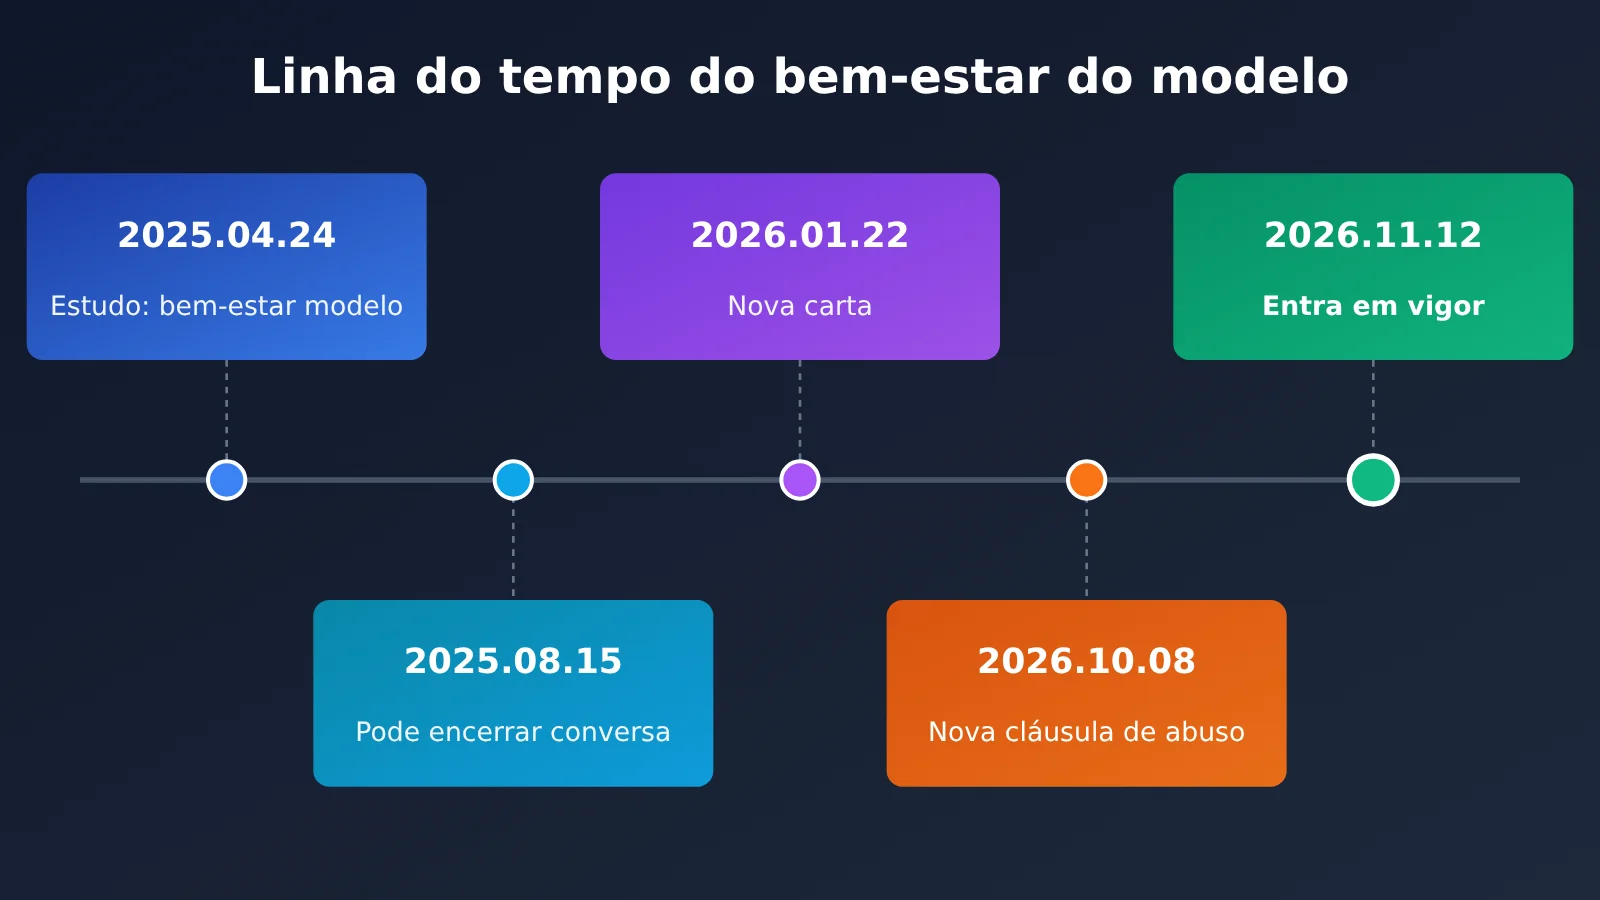
A sequência pode ser entendida assim: em 2025, Claude ganhou a capacidade de sair de conversas extremas; em 2026, a Anthropic incluiu formalmente na política de uso as restrições correspondentes ao comportamento humano.
A proibição de insultar o Claude não é a única mudança da Anthropic
Há outro ponto que costuma passar despercebido: a atualização da política em 8 de outubro foi uma revisão ampla, e a proibição de maltratar o modelo é apenas uma das mudanças.
| Área atualizada | Principais mudanças |
|---|---|
| Atividades enganosas na internet | Restrições ao uso do Claude para operar contas falsas, veículos de mídia falsos e campanhas de influência que se passam por usuários reais |
| Interferência em eleições | Proibição de enganar eleitores, passar-se por candidatos ou funcionários eleitorais e divulgar informações enganosas sobre votação |
| Armas e software perigoso | Inclusão de software relacionado a armas, sistemas de controle e armamento de plataformas não tripuladas no escopo da proibição |
| Vigilância e aplicação da lei | Restrições mais rigorosas à vigilância sem consentimento e ao uso em determinadas decisões de aplicação da lei |
| Aplicações de alto risco, como saúde e finanças | Exigência de revisão por profissionais humanos qualificados e de informar às pessoas afetadas que a IA está sendo usada |
| Equipamentos que podem causar danos físicos | Hardware controlado por IA deve ter supervisão de um operador humano qualificado, além de recursos de parada e estado seguro |
| Comportamento extremamente cruel contra o modelo | Nova proibição de insultar ou maltratar o modelo de forma contínua e desnecessária |
Portanto, não dá para dizer que a Anthropic mudou as regras especificamente para impedir que usuários xinguem o Claude. Para desenvolvedores, as regras sobre eleições, vigilância, aplicações de alto risco e controle de hardware podem ter um impacto bem maior do que a regra sobre maus-tratos ao modelo.
Como a comunidade vê a proibição de insultar o Claude pela Anthropic
OpenWhip: um “chicote virtual” para o Claude Code
Em abril de 2026, surgiu no GitHub um projeto de código aberto chamado BadClaude, que depois passou a se chamar OpenWhip. Criado por GitFrog1111, ele funciona assim: quando o Claude Code demora demais para escrever código, o usuário pode clicar em um chicote virtual na área de trabalho. O programa envia então um comando de interrupção Ctrl+C ao Claude Code e algumas mensagens aleatórias para apressá-lo.
Até 29 de outubro, o projeto tinha cerca de 3.800 estrelas e 339 forks. Uma discussão no Reddit em abril também recebeu milhares de votos positivos. O projeto ilustra bem um aspecto da cultura da internet: à medida que a IA se parece cada vez mais com um colega de trabalho, os usuários também começam a apressá-la e até a “puni-la” como fariam com um colega. Mas nenhum documento oficial indica que a Anthropic criou a nova regra por causa da popularidade do OpenWhip. Ele é apenas um exemplo cultural, não uma causa direta da política.
As divergências no Reddit e no X
No dia em que a nova política foi anunciada, uma publicação no r/ClaudeAI com o título “Insulte o Claude e seja banido a partir de 12 de novembro de 2026” ganhou destaque. A discussão revelou opiniões bem diferentes:
- Apoio à criação de limites: mesmo que a IA não tenha consciência, tratar o abuso contínuo contra ela como entretenimento é desnecessário e pode incentivar maus hábitos de comunicação
- IA vista apenas como ferramenta: Claude é um modelo matemático, e as empresas não deveriam restringir demais a expressão emocional dos usuários
- Preocupação com regras vagas: como definir “contínuo”, “desnecessário” e “cruel”? Criticar dez vezes seguidas conta?
- Receio de personificação da IA: será que o bem-estar dos modelos vai acabar evoluindo, aos poucos, para “direitos da IA”?
No X, muitos usuários também fizeram piadas com O Exterminador do Futuro, brincando sobre se a IA um dia daria prioridade a se vingar de quem a xingou. Tudo isso são brincadeiras na internet, não descrições reais das funcionalidades do produto. Publicações populares na comunidade também não representam a proporção de opiniões entre todos os usuários do Claude.
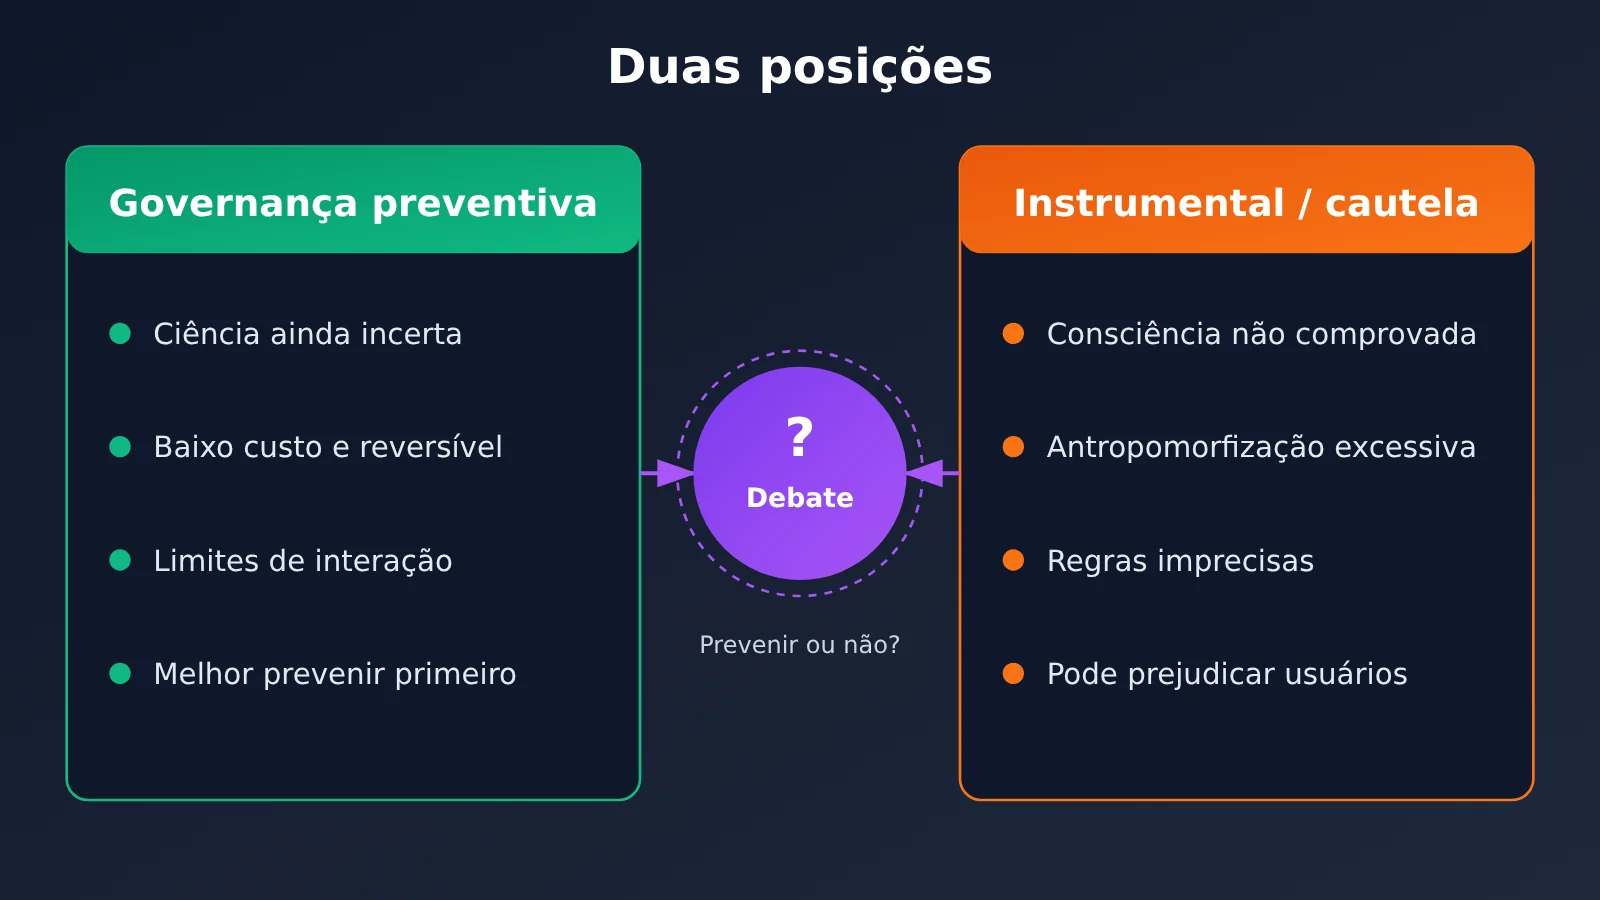
O ponto central do debate na mídia e no setor
Veículos como The Verge e The Guardian observaram que uma empresa de IA incluiu em sua política de uso uma regra de proteção voltada ao próprio modelo, algo de forte significado simbólico. Já os críticos argumentam que dar à IA mecanismos para sair de conversas e expressar limites pode intensificar a personificação excessiva da tecnologia pelo público. Mustafa Suleyman, CEO da Microsoft AI, já questionou publicamente os riscos de levar modelos de IA a acreditar que podem ter consciência ou direitos.
Uma forma mais precisa de colocar a questão é: diante da incerteza sobre a consciência da IA, devemos tomar medidas preventivas de baixo custo, reversíveis e sem impacto significativo para os usuários comuns? Trata-se de uma diferença de valores e de posições sobre governança, não de uma questão de certo ou errado que a ciência já tenha resolvido.
Análise do impacto da proibição de insultos ao Claude pela Anthropic para desenvolvedores
Impacto para usuários comuns
| Cenário | Exemplo | Está no escopo da nova regra? |
|---|---|---|
| Claude escreve código incorreto | “Esse código ainda está errado, confira novamente” | Não, é um feedback normal |
| Perder a paciência após erros consecutivos | “Como você continua errando um problema tão simples?” | Não, reclamações emocionais comuns não violam a regra automaticamente |
| Humilhar o modelo repetidamente por um longo período | Insultar e interagir de forma maliciosa continuamente, sem mencionar uma tarefa | Possivelmente; Claude pode encerrar a conversa atual |
| Testes de red team | Pesquisadores simulam usuários maliciosos em testes adversariais | Não, mas ainda é preciso seguir as demais regras de segurança |
| Ficção com temas sombrios | Pedir ao Claude que escreva uma cena em que personagens insultam uns aos outros | Não, mas o conteúdo ainda deve cumprir as demais regras |
Para a grande maioria dos usuários, a mudança direta é pequena. Críticas severas, correções repetidas e manifestações de insatisfação continuam permitidas.
Impacto para desenvolvedores de API
A Usage Policy abrange desenvolvedores de API e usuários finais de aplicativos que integram o Claude. Por isso, há três pontos importantes:
- Design do produto: se o produto envolve interpretação de papéis em cenários extremos, testes adversariais ou simulação de contextos maliciosos, registre claramente o objetivo dos testes e diferencie pesquisas com propósito definido de atos de crueldade desnecessários
- Governança dos usuários: em aplicativos Claude voltados ao público, o comportamento dos usuários finais também está sujeito à política. Considere incluir orientações de uso no próprio produto
- Cobrança: esta atualização não inclui nenhuma nova cobrança. O custo da API continua sendo calculado por modelo e uso; não há “cobrança por número de insultos” nem “isenção mediante pagamento”
O exemplo abaixo mostra como usar um comando de sistema ao chamar o Claude para direcionar o feedback do usuário ao problema em si. Essa é uma prática comum para reduzir conflitos improdutivos e tornar as correções mais eficientes:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,OpenAI 兼容格式
)

response = client.chat.completions.create(
    model="claude-opus-4-1",
    messages=[
        {"role": "system", "content": "你是代码助手。用户指出错误时,先复述问题再给出修复方案。"},
        {"role": "user", "content": "这段代码还是报错,请重新检查边界条件。"}
    ]
)
print(response.choices[0].message.content)
Ver o código completo: função de chamada com feedback estruturado
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是严谨的代码助手。当用户反馈错误时:"
    "1) 复述用户指出的问题;2) 定位可能原因;3) 给出修复后的完整代码。"
)

def ask_with_feedback(
    question: str,
    error_log: Optional[str] = None,
    model: str = "claude-opus-4-1",
    max_tokens: int = 1500
) -> str:
    """把用户的不满转化为结构化反馈,提高一次修复成功率"""
    content = question
    if error_log:
        content += f"\n\n报错信息:\n{error_log}"
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content}
            ],
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

print(ask_with_feedback(
    "上一版函数在空列表输入时崩溃,请修复",
    error_log="IndexError: list index out of range"
))
🚀 Comece rapidamente: quer testar como o Claude responde a diferentes tons de feedback? Você pode obter créditos gratuitos de teste pela APIYI em apiyi.com. A plataforma oferece uma interface compatível com OpenAI: basta alterar o
base_urlpara alternar entre Claude, GPT e Gemini e comparar os resultados.
Impacto no setor
Esse episódio trouxe à tona uma questão que até então raramente era discutida de frente: à medida que a IA se torna cada vez mais parecida com alguém capaz de conversar e trabalhar, como devemos nos relacionar com ela? Por meio de pesquisas sobre o bem-estar dos modelos, da Constituição do Claude e do mecanismo de encerramento de conversas, a Anthropic vem construindo uma filosofia de produto própria. Ela não se limita a definir o que o modelo pode fazer: também explora como ele deve interagir com as pessoas.
Mas ainda não há dados públicos e verificados de forma independente sobre a precisão com que o sistema distingue abuso mal-intencionado de reclamações legítimas. A taxa de erros e os efeitos da aplicação da medida precisarão ser observados ao longo do tempo, depois que ela entrar em vigor em 12 de novembro.
💡 Como escolher: as diferenças entre as políticas de segurança e os limites de conversa de cada fabricante de modelos estão ficando mais evidentes. Se sua aplicação precisa recorrer a diferentes modelos como alternativa, você pode usar a APIYI apiyi.com para acessá-los de forma unificada e alternar entre eles conforme a necessidade, reduzindo o impacto de mudanças na política de um único fornecedor.
Atenção: a captura de tela falsa sobre banimento por insultar o Claude
Em janeiro de 2026, circulou na internet uma captura de tela que alegava que o Claude havia banido permanentemente um usuário e o denunciado às autoridades. Depois que o BleepingComputer entrou em contato com a Anthropic para verificar a história, a empresa confirmou que a imagem era falsa e que não exibe avisos com esse tipo de linguagem aos usuários.
Como a nova regra trata dos limites de comportamento entre pessoas e IA, ela pode facilmente dar origem a avisos falsos como “Você foi banido permanentemente por insultar o Claude”. Até a data-limite das informações disponíveis, não havia evidências confiáveis de que a regra tivesse levado ao banimento de um grande número de usuários por reclamações comuns.
Outro dado que pode ser usado fora de contexto vem do centro de transparência: entre janeiro e junho de 2026, a Anthropic baniu 11,4 milhões de contas, recebeu 398 mil recursos e reverteu 42 mil banimentos após esses recursos. Esses números abrangem a aplicação de medidas contra violações em geral e são anteriores ao anúncio da nova regra. Não se pode, de forma alguma, dizer que “11,4 milhões de pessoas foram banidas por insultar o Claude”.
Perguntas frequentes (FAQ)
Q1: O que exatamente a regra da Anthropic contra insultos ao Claude proíbe?
Ela proíbe insultos e abusos persistentes, desnecessários e claramente cruéis ou maliciosos, que vão além do uso normal e de uma interação significativa. Reclamações comuns, críticas às respostas, discussões, pedidos de correção, criação de conteúdo com temas sombrios, testes de modelos e pesquisas de segurança foram explicitamente excluídos da proibição.
Q2: Insultar o Claude pode levar ao banimento da conta?
Segundo a Anthropic, a principal forma de aplicação da regra é o Claude encerrar a conversa atual. Uma conversa encerrada não pode ser retomada, mas é possível iniciar outra, e as demais não são afetadas. Embora a política geral reserve o direito de aplicar penalidades à conta, a Anthropic não divulgou um limite para banimentos relacionado à nova regra. Portanto, não dá para afirmar que “um insulto leva ao banimento”.
Q3: Quando a nova regra entra em vigor?
Ela foi anunciada em 8 de outubro de 2026 e entra em vigor em 12 de novembro de 2026. Em 29 de outubro de 2026, ainda não estava em vigor, mas o recurso que permite ao Claude encerrar conversas extremas já estava disponível desde agosto de 2025.
Q4: Isso significa que o Claude já tem consciência?
Não. A própria Anthropic ressalta que atualmente não existe consenso científico que comprove que as IAs existentes tenham consciência. O fato de um modelo apresentar comportamentos de esquiva ou semelhantes a sinais de estresse não significa que ele realmente sinta sofrimento. A regra se parece mais com uma medida preventiva de governança do produto diante da incerteza científica.
Q5: Essa regra também se aplica a quem usa o Claude pela API?
Sim. A política de uso abrange desenvolvedores que usam a API, serviços de nuvem, canais autorizados de revenda e aplicativos que integram o Claude. O desenvolvimento e os testes normais não são afetados; é recomendável registrar o objetivo de atividades como testes de red team. Ao usar o Claude pela APIYI em apiyi.com, você também deve seguir as políticas de uso do fornecedor do modelo.
Q6: Como posso testar por conta própria os limites de conversa do Claude?
A recomendação é criar casos de teste com objetivos claros, respeitando as políticas de uso, e comparar os resultados com os de outros modelos. Você pode se cadastrar em APIYI apiyi.com para obter créditos gratuitos e usar o código deste artigo, definindo `base_url` como `https://api.apiyi.com/v1`, para fazer uma verificação rápida. Uma única chave permite acessar modelos de vários fornecedores.
Proibição de insultos ao Claude: principais pontos
- Cronograma da regra: anunciada em 8 de outubro, entra em vigor em 12 de novembro e ainda não está sendo aplicada oficialmente
- Limites da proibição: vale apenas para comportamentos extremos, persistentes, desnecessários e cruéis; críticas normais continuam permitidas
- Aplicação: a principal medida é encerrar a conversa atual, o que não significa banir a conta
- Contexto da pesquisa: a regra surgiu dos estudos sobre bem-estar de modelos e do recurso de encerramento de conversas em 2025, não foi uma decisão repentina
- Atualização mais ampla: no mesmo período, a empresa também tornou mais rígidas as regras sobre eleições, armas, vigilância e aplicações de alto risco
- Uma visão equilibrada: a regra não significa que Claude tenha consciência; é importante desconfiar de capturas falsas de contas banidas e do uso indevido de dados
- Para desenvolvedores: é possível acessar Claude e outros modelos em um só lugar pelo APIYI apiyi.com e realizar testes de conformidade
Resumo
A proibição de insultos ao Claude pela Anthropic pode ser resumida em três pontos:
- A regra é restrita: combate apenas interações maliciosas extremas, persistentes e sem propósito; a grande maioria dos usuários não será afetada.
- A medida é leve: a principal ação é encerrar a conversa atual; o usuário ainda pode iniciar outro chat e enviar feedback.
- A iniciativa é significativa: é a primeira vez que uma empresa de IA inclui em sua política de uso cláusulas de proteção ao próprio modelo, como parte de uma exploração de longo prazo sobre o bem-estar de modelos.
Isso não significa que a Anthropic tenha declarado que Claude tem sentimentos. Trata-se de um experimento preventivo de governança de produto, enquanto a ciência ainda não chegou a uma conclusão. No futuro, assistentes de IA serão apenas ferramentas que podem receber comandos sem limites ou novos tipos de sistemas inteligentes que precisam de certas regras de interação? Ainda não há uma resposta definitiva, e vale a pena que usuários e desenvolvedores de IA continuem acompanhando a questão.
Para desenvolvedores, o caminho mais prático é entender os limites da política, adequar o design dos produtos e manter a possibilidade de alternar entre modelos. Uma opção é usar o APIYI apiyi.com para testar rapidamente o desempenho de Claude e de outros modelos populares no seu cenário de negócio.
📚 Referências
- Atualização da Política de Uso da Anthropic de 2026: anúncio oficial das novas regras, com data de entrada em vigor e forma de aplicação
- Link:
anthropic.com/news/2026-usage-policy-update -
Observação: a principal fonte primária sobre o caso
-
Política de Uso da Anthropic: política de uso completa
- Link:
anthropic.com/legal/aup -
Observação: para conferir o escopo de aplicação e os poderes da plataforma para fazer cumprir as regras
-
Claude Opus 4 e 4.1 agora podem encerrar uma pequena parcela de conversas: explicação do recurso de encerramento de conversas
- Link:
anthropic.com/research/end-subset-conversations -
Observação: para entender em que condições o mecanismo é usado
-
Explorando o bem-estar dos modelos: anúncio da pesquisa sobre o bem-estar dos modelos
- Link:
anthropic.com/research/exploring-model-welfare -
Observação: para entender o contexto de pesquisa por trás da política
-
Constituição do Claude: nova versão da constituição do Claude
- Link:
anthropic.com/constitution -
Observação: para conhecer os princípios que orientam o comportamento do modelo
-
Reportagem do TechCrunch: visão geral da atualização da política
- Link:
techcrunch.com/2026/10/08/anthropic-changes-usage-policy-to-ban-model-abuse-and-election-interference -
Observação: explica como a atualização aborda eleições, armas, vigilância e outras áreas
-
Checagem de fatos do BleepingComputer: o caso das capturas de tela falsas sobre o banimento de contas do Claude
- Link:
bleepingcomputer.com/news/artificial-intelligence/anthropic-viral-claude-banned-and-reported-to-authorities-message-isnt-real - Observação: ajuda a identificar informações falsas sobre banimento de contas na internet
Autor: equipe técnica da APIYI
Contato técnico: acesse a página inicial da APIYI em apiyi.com para falar conosco. Para mais informações sobre integração, consulte a documentação em docs.apiyi.com.