Nota do autor: este artigo analisa as cinco faixas de preço do Kimi K3.1 Pro, a cobrança por cache e os níveis de limite de uso, com base na tabela oficial capturada em 24/10/2026. Também traz três exemplos práticos para mostrar quanto custa cada solicitação.
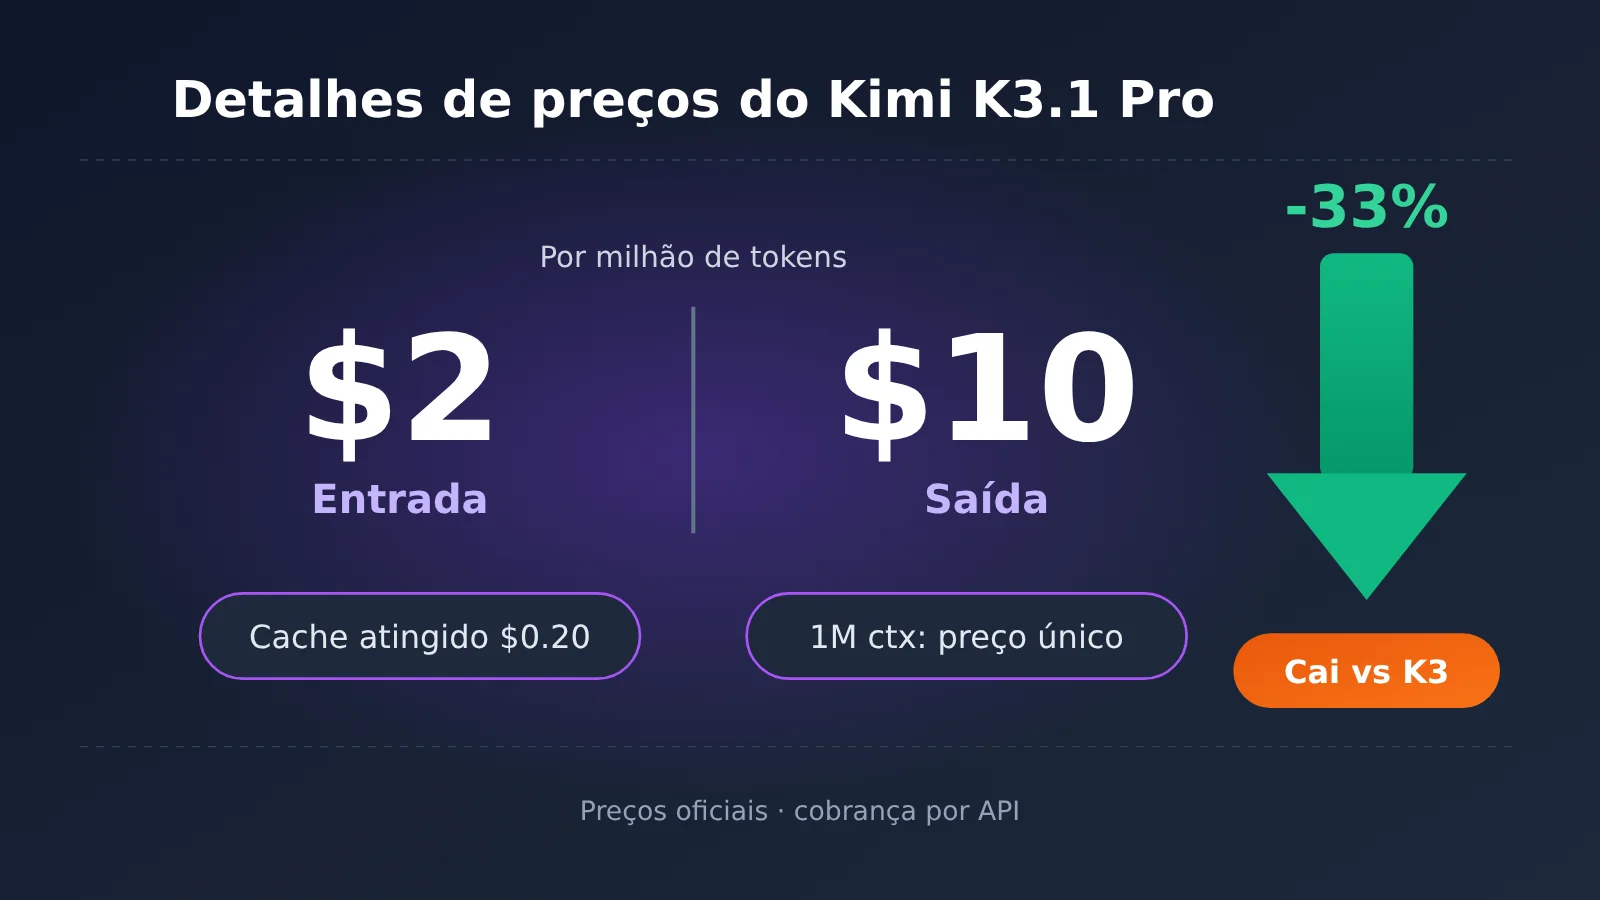
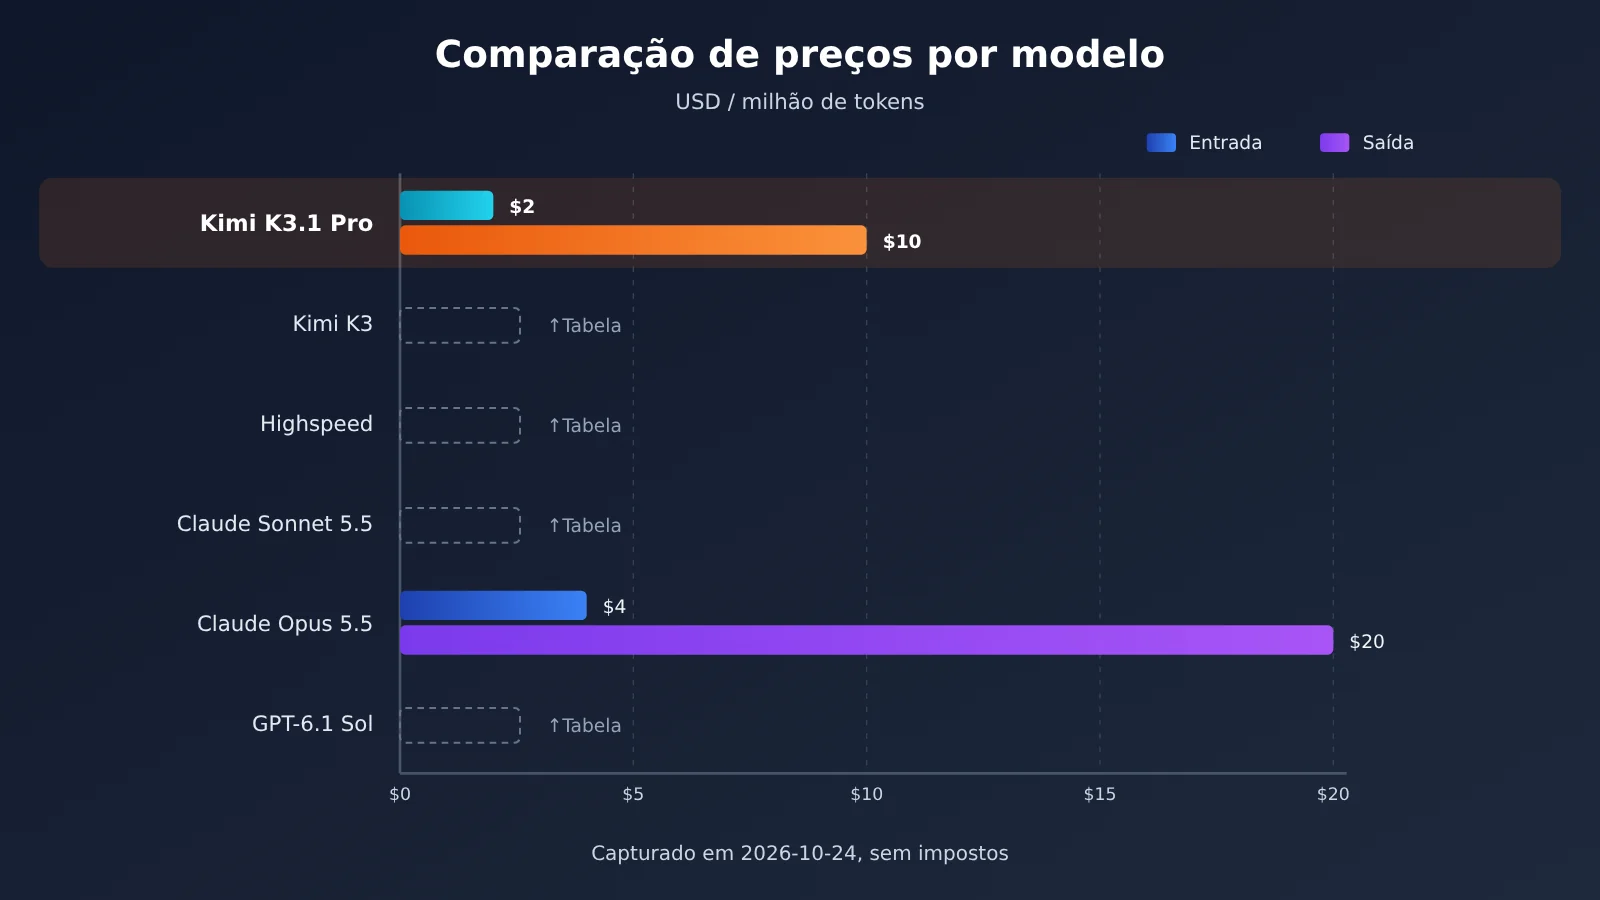
O preço oficial do Kimi K3.1 Pro é US$ 2 para entrada e US$ 10 para saída; com cache, apenas US$ 0,20 (em dólares por milhão de tokens). Esse preço é 33% menor que o da geração anterior, o Kimi K3. Ele custa o mesmo que o Claude Sonnet 5.5 e o GPT-6.1 Sol, e metade do Claude Opus 5.5.
As conclusões se baseiam na página oficial de preços da Moonshot (na documentação de preços de platform.kimi.ai) e nos cálculos da instituição independente Artificial Analysis. Os valores do artigo indicarão a origem: «oficial» significa que foram informados pela Moonshot em seu blog ou na documentação oficial; «terceiros» se refere a estimativas externas, como as da Artificial Analysis. Valores sem uma fonte confiável serão identificados como «não verificados».
Este artigo não se limita a copiar a tabela de preços. Uma redução de 33% no preço unitário não significa necessariamente uma redução de 33% na sua conta. A seguir, explicamos em quais casos dá para economizar e em quais não.
O que você vai encontrar aqui: ao terminar a leitura, você poderá calcular o custo de uma solicitação ao Kimi K3.1 Pro, saber em que situações vale a pena ativar o cache e quando convém aumentar antecipadamente seu nível de limite de uso, além de entender como desenvolvedores no Brasil podem pagar e integrar o serviço.
1. Principais pontos sobre os preços do Kimi K3.1 Pro
Comece por esta tabela, que responde às dúvidas mais comuns. Nas próximas seções, explicamos cada ponto em detalhes.
| Ponto | Descrição | Fonte | O que isso significa para você |
|---|---|---|---|
| Preço básico | Entrada: US$ 2 / saída: US$ 10 / cache com acerto: US$ 0,20 | Oficial | Está na mesma faixa de preço do Sonnet 5.5 e do GPT-6.1 Sol |
| Comparação com a geração anterior | Os três preços são 33% menores que os do K3 | Oficial / terceiros | Uma redução significativa no preço por unidade |
| Contexto | 1.048.576 tokens, com preço único, sem faixas | Oficial | Documentos longos não ficam mais caros por causa do tamanho |
| Custo por tarefa | Cerca de US$ 1,98 (artigo de lançamento) / US$ 2,11 (página do modelo) | Terceiros | Fica praticamente no mesmo nível do K3; não houve redução proporcional |
| Requisito inicial | É preciso adicionar pelo menos US$ 1 de saldo; o Tier 0 permite apenas 3 RPM | Oficial | Você precisa subir de nível antes de aumentar o uso |
Antes de continuar, vale explicar dois termos que aparecem várias vezes a seguir. Token é a menor unidade usada para cobrar pelo modelo. Dá para pensar nele como um fragmento de palavra; segundo a referência oficial, em inglês, cerca de 3 a 4 caracteres equivalem a 1 token. Milhão de tokens (MTok) significa 1.000.000 de tokens. Portanto, o preço de US$ 2 na tabela corresponde ao processamento de um milhão de tokens de entrada.
1.1 Quais itens são cobrados no Kimi K3.1 Pro?
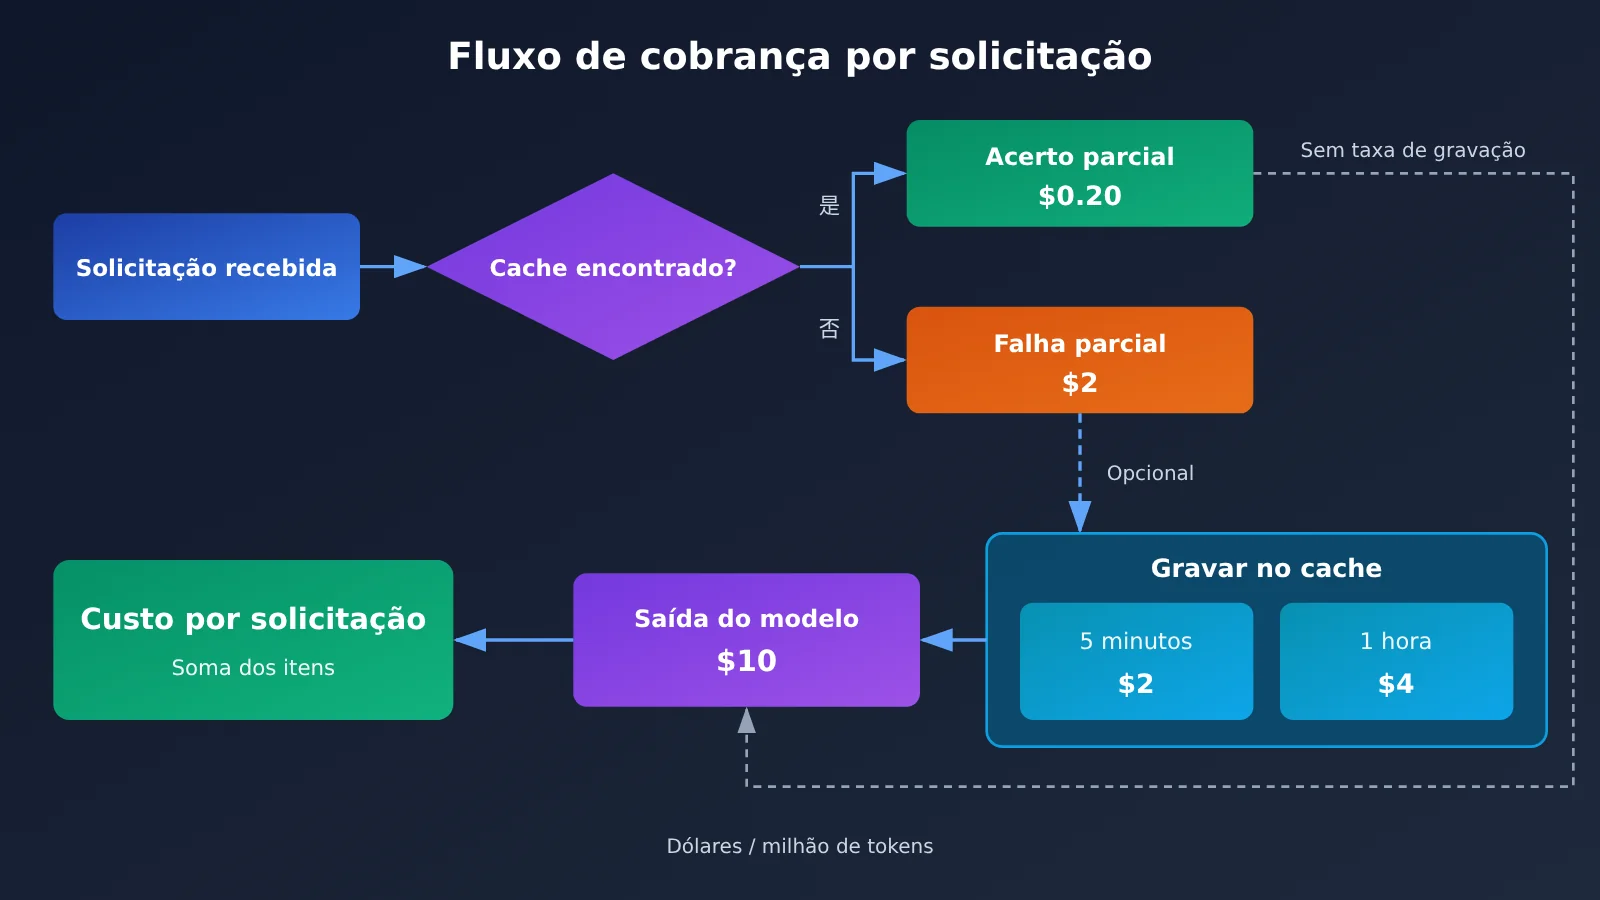
A documentação oficial lista três tipos de itens cobrados: gravação em cache (com opções de 5 minutos e 1 hora), entrada (com e sem acerto de cache) e saída. Separados, eles correspondem às cinco tarifas da tabela de preços. O valor de cada solicitação é a soma desses itens, calculados de acordo com a quantidade de tokens.
O cache de contexto é um dos pontos mais importantes desta tabela de preços. Funciona assim: se as partes iniciais de várias solicitações consecutivas forem exatamente iguais — por exemplo, um mesmo comando de sistema longo —, a plataforma armazena esse conteúdo para reutilizá-lo na solicitação seguinte. A parte reutilizada é cobrada por uma tarifa de “acerto”, bem mais baixa. Segundo a documentação oficial, o cache para prefixos repetidos é ativado automaticamente na API do Kimi. O TTL padrão é de 5 minutos; TTL é o período durante o qual o conteúdo permanece armazenado em cache.
A documentação oficial também especifica algumas regras que podem passar despercebidas: no K3, os acertos de cache são cobrados apenas pela tarifa de acerto, sem cobrança adicional pela gravação; as APIs relacionadas a arquivos — extração de conteúdo de documentos e armazenamento de arquivos — são gratuitas por enquanto, mas o conteúdo extraído continua sendo cobrado por token quando enviado ao modelo; e os preços da tabela não incluem impostos. O valor final é calculado conforme as regras da região de pagamento.
2. Tabela completa de preços do Kimi K3.1 Pro: confira as cinco faixas
A tabela abaixo reúne os preços das cinco principais opções atuais do Kimi, para facilitar a comparação. “Não listado” significa que o preço não aparece na página oficial de preços — não que seja gratuito.
| Modelo | Entrada (cache miss) | Saída | Entrada com cache hit | Gravação em cache por 5 minutos | Gravação em cache por 1 hora |
|---|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| kimi-k3 (geração anterior) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
| kimi-k2.7-code | $0.95 | $4.00 | $0.19 | Não listado | Não listado |
| kimi-k2.6 | $0.95 | $4.00 | $0.16 | Não listado | Não listado |
Observação: dados coletados em 24/10/2026. Valores em dólares por milhão de tokens, sem impostos. Fonte: página oficial de preços.
A tabela revela alguns padrões. Primeiro, a gravação em cache por 5 minutos no K3.1 Pro custa o mesmo que a entrada comum: $2. Ou seja, ativar esse cache praticamente não gera custo adicional. Já a gravação por 1 hora custa $4, o dobro do preço da entrada. Segundo, todos os preços da versão Highspeed são o dobro dos da versão padrão, com exceção da entrada com cache hit, que também custa $0.20. Por isso, em cenários com reutilização de prefixos longos, a diferença entre as duas versões diminui. Terceiro, o K2.7 Code e o K2.6 custam menos da metade do K3.1 Pro. Para tarefas que não exigem o raciocínio mais avançado, continuam sendo opções mais econômicas.
2.1 Comparação entre o Kimi K3.1 Pro e modelos da mesma faixa de preço
Ao comparar alguns dos principais modelos usando o mesmo critério (dólares por milhão de tokens), fica mais fácil entender a posição do K3.1 Pro.
| Modelo | Entrada / saída | Entrada com cache hit | Gravação em cache · prazo curto | Gravação em cache · prazo longo | Fonte |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2 / $10 | $0.20 | $2 (5 minutos) | $4 (1 hora) | Oficial |
| Kimi K3.1 Pro Highspeed | $4 / $20 | $0.20 | $4 (5 minutos) | $8 (1 hora) | Oficial |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | $2.50 (5 minutos) | $4 (1 hora) | Oficial |
| Claude Opus 5.5 | $4 / $20 | $0.20 | $5 (5 minutos) | $8 (1 hora) | Oficial |
| GPT-6.1 Sol (entrada ≤272K) | $2 / $10 | $0.10 | $2.50 (30 minutos) | $5 (12 horas) | Oficial |
| GPT-6.1 Sol (entrada >272K) | $4 / $15 | $0.20 | $5 (30 minutos) | $10 (12 horas) | Oficial |
| GPT-6 Astra (entrada ≤272K) | $10 / $50 | $1.00 | $12.50 (30 minutos) | $25 (12 horas) | Oficial |
| GPT-6 Astra (entrada >272K) | $20 / $75 | $2.00 | $25 (30 minutos) | $50 (12 horas) | Oficial |
Os dados da tabela vêm das páginas oficiais de preços de cada empresa. Foram coletados em 2026-10-24; os valores estão em dólares por milhão de tokens e não incluem impostos. As três empresas oferecem períodos diferentes para o cache: Kimi e Claude usam 5 minutos / 1 hora, enquanto a OpenAI usa 30 minutos / 12 horas. Os preços de gravação correspondem, respectivamente, a 1,25 e 2,5 vezes o preço de entrada sem cache. Para a maioria dos modelos, o preço de leitura é 10% do preço de entrada; a exceção é o GPT-6.1 Sol, com 5%. A OpenAI também divide os preços conforme o tamanho da entrada: até 272K tokens, vale o preço de contexto curto; acima de 272K tokens, aplica-se o preço de contexto longo. A tabela mostra apenas os preços padrão. A opção Batch, com metade do preço, e as opções Fast (antes chamada Priority) e UltraFast, que são mais caras, não foram incluídas.
Na comparação, Claude Sonnet 5.5 e GPT-6.1 Sol têm preços menores para entradas com cache hit (ambos custam $0.10), o que os torna mais vantajosos em cenários que reutilizam prefixos longos com frequência. No entanto, o preço de gravação em cache por 5 minutos do Sonnet 5.5 é $2.50, um pouco acima dos $2 do K3.1 Pro. Já o K3.1 Pro se destaca pelo baixo custo de gravação e pelo preço único para diferentes tamanhos de contexto, características que o tornam mais adequado para tarefas que envolvem a leitura de documentos extensos de uma só vez. Os preços de entrada e saída do Claude Opus 5.5 são o dobro dos do K3.1 Pro; portanto, a razão para escolhê-lo deve ser a capacidade, e não o preço. O ponto fraco do GPT-6.1 Sol é a gravação em cache: a opção de 30 minutos custa $2.50, acima dos $2 da opção de 5 minutos do K3.1 Pro. Além disso, o preço varia conforme o tamanho da entrada. Acima de 272K tokens, o preço de entrada sobe para $4 e o de saída, para $15. Para tarefas com documentos longos, use os valores da linha de contexto longo.
Recomendação: o desempenho dos modelos na mesma faixa de preço depende da tarefa. Vale a pena testar o mesmo conjunto de comandos em cada um antes de decidir. A lista de modelos da APIYI (apiyi.com) inclui claude-sonnet-5-5, claude-opus-5-5 e kimi-k3, entre outros. Você pode usar uma única chave API para fazer testes comparativos. O nome específico e o preço do K3.1 Pro dependem da lista de modelos da plataforma. Vamos disponibilizar esse modelo em breve.
3. Quanto custa uma chamada ao Kimi K3.1 Pro: 3 exemplos de cálculo
Depois de entender a tabela de preços, o que importa mesmo é: “quanto vou gastar nesta chamada?”. Os três exemplos abaixo cobrem situações típicas de conversa curta, reutilização de comandos longos e leitura de documentos extensos. Os cálculos estão detalhados; basta substituir os números de tokens pelos seus. A fórmula geral é: custo = número de tokens × preço unitário ÷ 1.000.000.
3.1 Exemplo 1: custo de uma solicitação curta ao Kimi K3.1 Pro
Cenário: uma pergunta e resposta comum, com 2.000 tokens de entrada (sem acerto de cache) e 500 tokens de saída.
- Entrada:
2000 × 2 ÷ 1000000 = $0.004 - Saída:
500 × 10 ÷ 1000000 = $0.005 - Total:
$0.004 + $0.005 = $0.009
Ou seja, uma conversa curta como essa custa menos de um centavo de dólar. Vale lembrar que o preço unitário da saída é 5 vezes maior que o da entrada. Em solicitações curtas, a saída costuma representar mais da metade do custo, então reduzir o tamanho da resposta é mais eficaz do que comprimir a entrada.
3.2 Exemplo 2: reutilização e cache de um comando longo no Kimi K3.1 Pro
Cenário: um comando do sistema com 20.000 tokens e 10 perguntas feitas em sequência dentro de 5 minutos. Cada pergunta adiciona 1.000 tokens de entrada nova e gera 800 tokens de saída.
Sem cache, cada solicitação cobra o preço integral de todo o comando:
- Por solicitação:
(20000 + 1000) × 2 ÷ 1000000 + 800 × 10 ÷ 1000000 = $0.042 + $0.008 = $0.05 - 10 solicitações:
$0.05 × 10 = $0.50
Com cache, o comando do sistema precisa ser gravado no cache na primeira solicitação. Nas 9 seguintes, ele é recuperado do cache:
- 1ª solicitação: gravação de
20000 × 2 ÷ 1000000 = $0.04, mais$0.002pela nova entrada e$0.008pela saída, totalizando$0.05 - Da 2ª à 10ª solicitação: acerto de cache de
20000 × 0.2 ÷ 1000000 = $0.004, mais$0.002 + $0.008, totalizando$0.014por solicitação - Total das 9 solicitações seguintes:
$0.014 × 9 = $0.126 - Total geral:
$0.05 + $0.126 ≈ $0.18
O custo das mesmas 10 conversas cai de $0.50 para cerca de $0.18, uma economia de aproximadamente 60%. Esse formato — um comando longo e fixo seguido de várias perguntas — é muito comum em bots de atendimento, assistentes de programação e frameworks de agentes. É justamente aí que o cache pode fazer mais diferença.
3.3 Exemplo 3: leitura de um documento extenso com o Kimi K3.1 Pro
Cenário: ler um documento de 300.000 tokens e gerar um resumo de 3.000 tokens.
- Entrada:
300000 × 2 ÷ 1000000 = $0.60 - Saída:
3000 × 10 ÷ 1000000 = $0.03 - Total: cerca de
$0.63
Se você fizer outra pergunta sobre o mesmo documento dentro de 5 minutos, a parte referente ao documento terá acerto de cache. A entrada custará apenas 300000 × 0.2 ÷ 1000000 = $0.06, além do custo da saída dessa chamada. Para tarefas em que você precisa consultar repetidamente o mesmo contrato, relatório financeiro ou repositório de código, concentrar as perguntas dentro do período de validade do cache pode reduzir bastante os custos.
4. Preço único para a janela de contexto de 1M do Kimi K3.1 Pro: o que significa não ter faixas de preço
Contexto é o volume total de conteúdo que o modelo consegue ver de uma só vez. Isso inclui seu comando, o histórico da conversa e os documentos enviados. A documentação oficial informa que toda a série K3 oferece uma janela de contexto de 1.048.576 tokens e que o K3.1 Pro cobra por uso a um preço único, sem faixas por tamanho do contexto.
Em resumo, o FAQ oficial diz que o K3.1 Pro oferece contexto de 1M e cobra por uso a um preço único. A gravação em cache, as entradas (com e sem acerto de cache) e as saídas têm o mesmo preço unitário. Em outras palavras, enviar 2.000 tokens ou 800.000 tokens custa os mesmos US$ 2 por milhão de tokens. O preço não fica mais caro conforme a solicitação aumenta.
Isso é importante na hora de comparar, porque nem todos os provedores calculam os preços dessa forma. A série GPT-6 da OpenAI aplica faixas conforme o tamanho da entrada: até 272K tokens, vale o preço de contexto curto; acima de 272K, o preço muda imediatamente para a faixa mais cara de contexto longo. No GPT-6 Astra, por exemplo, o preço da entrada passa de US$ 10 para US$ 20, o da saída vai de US$ 50 para US$ 75 e o de entradas com acerto de cache sobe de US$ 1,00 para US$ 2,00. A Claude segue outro caminho: a página oficial de preços informa que os modelos Claude 4.6 e posteriores — exceto o Claude Haiku 5.5 — cobram o preço padrão em toda a janela de contexto de 1M. Assim, uma solicitação com 900 mil tokens tem o mesmo preço unitário que outra com 9 mil. O único caso em que o preço aumenta é o Claude Haiku 5.5, quando o comando ultrapassa 100 mil tokens. Portanto, o K3.1 Pro não é o único sem faixas de preço: Claude Sonnet 5.5 e Opus 5.5 também não cobram mais conforme o tamanho do contexto. A série GPT-6 é que realmente muda de faixa.
Para quem desenvolve, o preço único traz duas vantagens diretas:
- Fica fácil estimar o orçamento: se o número de tokens dobrar, o custo também dobra. Não há um salto de preço ao atingir determinado tamanho. Dá para calcular tranquilamente o custo de um documento com 300 mil tokens, como no exemplo 3, multiplicando pela tarifa.
- Não é preciso dividir os documentos de propósito: em modelos com preços por faixa, algumas pessoas dividem documentos longos em várias partes para evitar a faixa mais cara. No K3.1 Pro, isso não reduz o custo e ainda pode prejudicar os resultados por causa da perda de contexto.
5. Por que o Kimi K3.1 Pro pode sair mais barato — e quando não sai
Nesta seção, vamos fazer as contas sem rodeios. O preço por token realmente caiu, mas o custo das tarefas também depende do tamanho da saída.
| Dimensão | Detalhes | Fonte | Impacto no custo |
|---|---|---|---|
| Redução dos preços | Os preços de entrada, saída e tokens com cache foram 33% menores que os do K3 | Oficial / terceiros | Reduz o custo |
| Preço dos tokens com cache | US$ 0,20, apenas 1/10 do preço de entrada | Oficial | Grande economia em cenários com reutilização de prefixos longos |
| Gravação em cache por 1 hora | US$ 4, o dobro do preço de entrada | Oficial | Mais vantajosa para tarefas com intervalos longos; não é necessária para tarefas curtas |
| Raciocínio sempre ativo | Não é possível desativar o raciocínio; a saída média é de 55 mil tokens, 14% a mais que no K3 | Oficial / terceiros | Compensa parte da redução de preço |
| Custo por tarefa | US$ 1,98 (referência de artigo publicado) / US$ 2,11 (custo ponderado por tarefa na página do modelo) | Terceiros | Praticamente igual ao do K3 |
5.1 Três maneiras de economizar com o Kimi K3.1 Pro
A primeira é a redução direta de 33% nos preços: de US$ 3/US$ 15 no K3 para US$ 2/US$ 10, enquanto o preço dos tokens com cache caiu de US$ 0,30 para US$ 0,20. Esses valores são consistentes tanto na tabela de preços oficial quanto nos dados da Artificial Analysis. A segunda é que os tokens com cache custam apenas 1/10 do preço de entrada. Como vimos no exemplo 2, conversas com várias rodadas e comandos longos e fixos podem gerar uma economia de cerca de 60%. A terceira é que, embora a gravação em cache por 1 hora custe o dobro, ela mantém o cache por mais tempo. Isso é útil para tarefas com intervalos de mais de 5 minutos entre chamadas, como um Agent agendado que é executado a cada dez minutos ou mais, ou uma conversa sobre um documento longo em que a pessoa para para pensar antes de fazer outra pergunta. Se houver pelo menos dois acertos no cache dentro de uma hora, o custo adicional da gravação geralmente se paga.
5.2 Quando o Kimi K3.1 Pro não sai mais barato
Raciocínio é o processo em que o modelo analisa o problema internamente antes de responder. Esse conteúdo de raciocínio também é cobrado como saída. A documentação oficial informa que não é possível desativar o raciocínio no K3.1 Pro; só dá para reduzir a quantidade de raciocínio ajustando reasoning_effort para low.
Segundo as estimativas da Artificial Analysis (terceiro), o K3.1 Pro gera, em média, cerca de 55 mil tokens por tarefa no Intelligence Index, contra 48 mil no K3 — 14% a mais. Como a saída é o item mais caro, esses tokens adicionais consomem parte da economia gerada pela redução de preço. No fim, o custo por tarefa estimado por terceiros fica em cerca de US$ 1,98 (com base em um artigo publicado). Já a página do modelo mostra um custo ponderado de US$ 2,11 por tarefa, considerando um desconto de 90% para o cache. Na prática, os valores ficam praticamente iguais aos do K3.
Em resumo: se o seu uso envolve principalmente entradas longas e reutilização em várias rodadas, a redução de preço do K3.1 Pro pode aparecer claramente na conta. Mas, se a maior parte das tarefas exige raciocínio complexo e gera respostas longas, o custo por tarefa talvez não seja menor que o do K3. O ideal é começar com um lote pequeno de tarefas reais e conferir a conta.
6. Limites de recarga e níveis de rate limit do Kimi K3.1 Pro
O serviço oficial cobra por uso, sem plano de assinatura. Além disso, a API do Kimi e a assinatura do Kimi e do Kimi Code têm cobranças independentes: a assinatura não cobre os custos da API. É preciso adicionar pelo menos US$ 1 de crédito à conta para começar a fazer chamadas. Ao atingir US$ 5 em recargas acumuladas, você recebe um voucher de US$ 5, que não conta para o total acumulado de recargas (informação oficial).
O nível de rate limit depende do valor acumulado em recargas. Antes, vale explicar algumas siglas: concorrência é o número de solicitações que podem ser processadas ao mesmo tempo; RPM é o número máximo de solicitações por minuto; TPM é o número máximo de tokens processados por minuto; TPD é o número máximo de tokens processados por dia.
| Nível | Recarga acumulada | Concorrência | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | US$ 1 | 1 | 3 | 500 mil | 1,5 milhão |
| Tier1 | US$ 10 | 15 | 100 | 2 milhões | Ilimitado |
| Tier2 | US$ 20 | 40 | 100 | 3 milhões | Ilimitado |
| Tier3 | US$ 100 | 50 | 200 | 3 milhões | Ilimitado |
| Tier4 | US$ 1.000 | 60 | 200 | 4 milhões | Ilimitado |
| Tier5 | US$ 3.000 | 100 | 300 | 5 milhões | Ilimitado |
Observação: os dados vêm da documentação oficial de rate limits (página pricing/limits em platform.kimi.ai), consultada em 24/10/2026.
As limitações do Tier0 são bem rígidas: só é possível enviar 3 solicitações por minuto, com um total diário de 1,5 milhão de tokens. Considerando o documento de 300 mil tokens do exemplo 3, dá para processá-lo 5 vezes por dia antes de atingir o limite. Além disso, com um TPM de 500 mil, não cabem nem dois documentos desse tamanho em um minuto. Se você pretende processar dados em lote ou disponibilizar o serviço para usuários, recomendamos elevar o total de recargas acumuladas para pelo menos Tier1 ainda durante os testes.
Há outro ponto importante: segundo o aviso oficial, o rate limit acionado pelo sistema de controle de risco não pode ser removido. Antes de colocar o serviço no ar, implemente no cliente o controle da taxa de solicitações e o recuo progressivo nas tentativas. Não use scripts com alta concorrência para tentar descobrir o limite.
7. Como pagar pelo Kimi K3.1 Pro na China e integrá-lo
Os canais oficiais cobram em dólares e seguem as regras de pagamento da região. Embora seja possível pagar diretamente da China, desenvolvedores locais costumam ter dúvidas sobre meios de pagamento internacionais, emissão de notas fiscais e a necessidade de gerenciar chaves de vários fornecedores. Uma alternativa é usar uma plataforma agregadora de APIs, que permite acessar vários modelos com uma conta e uma chave.
A APIYI (apiyi.com) é uma plataforma agregadora de APIs de IA. Com uma única chave API, você pode acessar modelos populares como OpenAI, Claude e Gemini. A interface é compatível com o formato da OpenAI, a cobrança é por uso e novos usuários recebem créditos gratuitos para testes. Segundo a verificação da lista de modelos da plataforma, em docs.apiyi.com/models, feita em 24/10/2026, os modelos da série Kimi disponíveis são:
kimi-k3: entrada US$ 3 / saída US$ 15 / leitura do cache US$ 0,3kimi-k2.7-code: entrada US$ 0,95 / saída US$ 3,99 / leitura do cache US$ 0,19kimi-k2.6: entrada US$ 0,6 / saída US$ 2,4 / leitura do cache US$ 0,1kimi-k2.5: entrada US$ 0,6 / saída US$ 3,15 / leitura do cache US$ 0,1
No dia da verificação, o kimi-k3.1-pro ainda não aparecia na lista de modelos da APIYI. Por isso, este artigo não informa o preço dele na plataforma. Consulte a lista de modelos no painel da plataforma para confirmar o nome, o preço e a data de lançamento do K3.1 Pro. Vamos disponibilizar esse modelo em breve; enquanto isso, você pode usar o kimi-k3 para testar o fluxo. Quando o K3.1 Pro estiver disponível, basta alterar o nome do modelo.
7.1 Como começar rapidamente com o Kimi K3.1 Pro
As etapas de integração são parecidas, tanto pelo canal oficial quanto por uma plataforma agregadora. Veja um exemplo usando a compatibilidade com a OpenAI:
- Crie uma conta e obtenha uma chave API. Pelo canal oficial, primeiro é preciso adicionar pelo menos US$ 1 de crédito.
- No SDK da OpenAI ou no cliente que você usa, defina
base_urlcomohttps://api.apiyi.com/v1(se estiver usando a APIYI). Se o projeto usar o formato da Anthropic, defina o endereço base comohttps://api.apiyi.com. - Defina
api_keycom sua chave e preenchamodelcom um dos nomes da lista de modelos da plataforma, como okimi-k3, disponível atualmente. Quando o K3.1 Pro for lançado, use o nome indicado na lista. - Para reduzir o custo de saída gerado pelo raciocínio, adicione
reasoning_effortaos parâmetros da solicitação e defina o valor comolow. Segundo as informações oficiais, o K3.1 Pro permite apenas reduzir o nível de raciocínio, não desativá-lo. - Coloque o comando de sistema longo e fixo no início das mensagens e mantenha-o inalterado para que prefixos repetidos possam aproveitar o cache automaticamente.
- Depois de fazer a chamada, confira na fatura ou nos campos de uso da resposta a quantidade de tokens de entrada, cache e saída. Em seguida, refaça o cálculo usando a fórmula da seção 3.
Dica para começar rapidamente: use primeiro os créditos gratuitos de teste da APIYI, em apiyi.com, para executar o exemplo 2 da seção 3. Compare o uso com e sem o prefixo fixo — essa é a maneira mais rápida de verificar se o cache está funcionando. O modelo e o preço do K3.1 Pro na plataforma serão os indicados na lista de modelos. Vamos disponibilizar esse modelo em breve.
Perguntas frequentes (FAQ)
Q1: Quanto custa o Kimi K3.1 Pro?
Os preços oficiais são: US$ 2 para entrada, US$ 10 para saída, US$ 0,20 para acertos de cache, US$ 2 para gravação em cache de 5 minutos e US$ 4 para gravação em cache de 1 hora. Os valores são por milhão de tokens, não incluem impostos e foram consultados em 24/10/2026.
Q2: Quanto o Kimi K3.1 Pro é mais barato que o K3? A conta vai cair 33% na prática?
Os três preços unitários são 33% menores, segundo os valores oficiais. Porém, o K3.1 Pro sempre usa o modo de raciocínio e gera, em média, 14% mais tokens de saída. De acordo com estimativas da Artificial Analysis, o custo por tarefa fica entre US$ 1,98 e US$ 2,11, praticamente igual ao do K3. A economia é mais significativa em cenários com entradas longas e reutilização em várias interações.
Q3: Para economizar, é melhor escolher o Kimi K3.1 Pro ou o Claude Sonnet 5.5?
Os preços de entrada e saída dos dois modelos são iguais: US$ 2 e US$ 10. O cache do Sonnet 5.5 é mais barato (US$ 0,10), enquanto a gravação em cache por 5 minutos custa menos no K3.1 Pro (US$ 2 contra US$ 2,50). Além disso, o K3.1 Pro mantém o mesmo preço para a janela de contexto de 1 milhão de tokens. Para reutilizar prefixos curtos com frequência, o Sonnet tende a ser mais vantajoso; para carregar documentos grandes de uma só vez, o K3.1 Pro pode ser a melhor opção. O ideal é comparar os dois com tarefas reais.
Q4: Vale a pena ativar o cache de 1 hora do Kimi K3.1 Pro?
A gravação em cache por 1 hora custa US$ 4, ou seja, US$ 2 a mais que a opção de 5 minutos. Em geral, vale a pena quando o mesmo prefixo será reutilizado mais de uma vez depois dos primeiros 5 minutos e dentro do período de 1 hora. Se as chamadas ficarem concentradas em poucos minutos, a opção padrão de 5 minutos é suficiente.
Q5: Como desenvolvedores no Brasil podem chamar o Kimi K3.1 Pro pela API?
É possível usar o canal oficial ou acessar pelo APIYI apiyi.com, que oferece uma interface compatível com OpenAI. Defina `base_url` como `https://api.apiyi.com/v1`. A plataforma já oferece modelos como `kimi-k3` e `kimi-k2.7-code`. Consulte a lista de modelos da plataforma para verificar o nome e o preço do K3.1 Pro. Vamos disponibilizar esse modelo o mais rápido possível.
Q6: A assinatura do Kimi pode ser usada para abater os custos da API?
Não. Segundo as informações oficiais, a API do Kimi é cobrada conforme o uso e não tem plano de assinatura. A cobrança é separada da assinatura do Kimi e do Kimi Code.
Q7: Quais são os pontos de atenção na cobrança do Kimi K3.1 Pro?
– Não é possível desativar o modo de raciocínio, então o consumo de tokens de saída pode ser maior. Você pode definir `reasoning_effort` como `low` para reduzir esse consumo.
– O Tier 0 permite apenas 3 RPM e 1,5 milhão de TPD. Se precisar de mais capacidade, solicite a mudança de nível com antecedência.
– Se o sistema de controle de risco limitar as chamadas, não será possível remover a restrição.
– A extração de arquivos é gratuita, mas o conteúdo extraído será enviado ao modelo e cobrado como entrada.
Q8: O que posso preparar enquanto o K3.1 Pro ainda não está disponível na plataforma?
Você pode configurar o fluxo de chamadas, a estrutura de cache e o monitoramento de uso com o `kimi-k3` no APIYI apiyi.com. Quando o K3.1 Pro estiver disponível, basta substituir o nome do modelo. Consulte a lista de modelos da plataforma para verificar o nome e o preço. Vamos disponibilizar esse modelo o mais rápido possível.
Principais pontos sobre os preços do Kimi K3.1 Pro
- Preço-base: US$ 2 para entrada / US$ 10 para saída / US$ 0,20 por acerto de cache. Preços oficiais, sem impostos.
- Cinco faixas disponíveis: gravação por 5 minutos custa US$ 2; por 1 hora, US$ 4. O custo de gravação é baixo.
- Posicionamento em relação à concorrência: tem o mesmo preço do Sonnet 5.5 e do GPT-6.1 Sol, e custa metade do Opus 5.5.
- Preço unitário fixo: a janela de contexto de 1 milhão de tokens não tem faixas de preço diferentes por tamanho, então o orçamento pode ser estimado de forma linear.
- Custo real: com o modo de raciocínio sempre ativo e 14% mais tokens de saída, o custo por tarefa fica praticamente no mesmo nível do K3 (segundo fontes terceirizadas).
- Requisitos para começar: recarga mínima de US$ 1. No Tier 0, o limite é de apenas 3 RPM, e a limitação de taxa por controle de risco não pode ser removida.
- Acesso no Brasil: é possível usar a APIYI para acessar uma interface compatível com a API da OpenAI. O modelo e o preço do K3.1 Pro dependem da lista da plataforma; vamos disponibilizar esse modelo o mais rápido possível.
Resumo
Principais pontos sobre os preços do Kimi K3.1 Pro:
- Preço unitário: US$ 2 para entrada / US$ 10 para saída / US$ 0,20 por acerto de cache. É 33% mais barato que o K3, com preço fixo para a janela de contexto de 1 milhão de tokens.
- Como economizar: deixe o prefixo fixo e longo no início e aproveite o cache. Em conversas com várias rodadas, isso pode reduzir em cerca de 60% o custo de entrada.
- Expectativa de custo: o modo de raciocínio sempre ativo gera respostas mais longas. Em tarefas complexas de raciocínio, o custo por tarefa fica próximo ao do K3. Não faça o orçamento considerando uma redução de 33%.
- Preparação para produção: aumente o nível de limite de taxa com antecedência e controle a velocidade das chamadas para evitar limitações de taxa por controle de risco, que não podem ser removidas.
Recomendamos usar a fórmula da seção 3 com a distribuição de tokens do seu caso para estimar os custos e, depois, validar o resultado com algumas tarefas reais. Se você precisa comparar modelos como Kimi, Claude e GPT no Brasil usando uma única chave, pode testar com os créditos gratuitos da APIYI em apiyi.com. O modelo e o preço do K3.1 Pro na plataforma dependem da lista de modelos; vamos disponibilizar esse modelo o mais rápido possível.
Referências
- Plataforma aberta da Kimi — preços dos modelos: preços em cinco faixas e regras de cobrança do K3.1 Pro e de outros modelos
- Link:
platform.kimi.ai/docs/pricing/chat -
Observação: fonte oficial da tabela de preços deste artigo e das informações sobre cobrança unificada para contextos de 1M
-
Plataforma aberta da Kimi — recarga e limites de uso: faixas de Tier0 a Tier5 e informações sobre controle de risco
- Link:
platform.kimi.ai/docs/pricing/limits -
Observação: fonte oficial dos requisitos de recarga e dos limites de RPM/TPM/TPD
-
Artificial Analysis — Kimi K3.1 Pro: estimativas de custo por tarefa e de tokens de saída feitas por terceiros
- Link:
artificialanalysis.ai -
Observação: fonte dos dados deste artigo sobre custos de US$ 1,98 / US$ 2,11 por tarefa e 55 mil tokens de saída
-
Lista de modelos da APIYI: modelos disponíveis atualmente na plataforma e seus preços
- Link:
docs.apiyi.com/models - Observação: informações sobre a disponibilidade de modelos como Kimi e Claude na plataforma
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI. Para mais informações, acesse a central de documentação em docs.apiyi.com