Recentemente um cliente perguntou no grupo uma questão bem típica: «A gente com o images2 consegue gerar um conjunto de imagens para e-commerce, né?» A resposta é sim, mas não é uma única chamada que cospe um conjunto inteiro de imagens. A API do gpt-image-2 funciona assim: «um comando corresponde a uma geração». Para ter um conjunto com imagem principal, imagem de pontos de venda, imagem de cenário e página de detalhes — cada uma com conteúdo diferente — é preciso fazer um pequeno trabalho de design na forma de chamar a API.
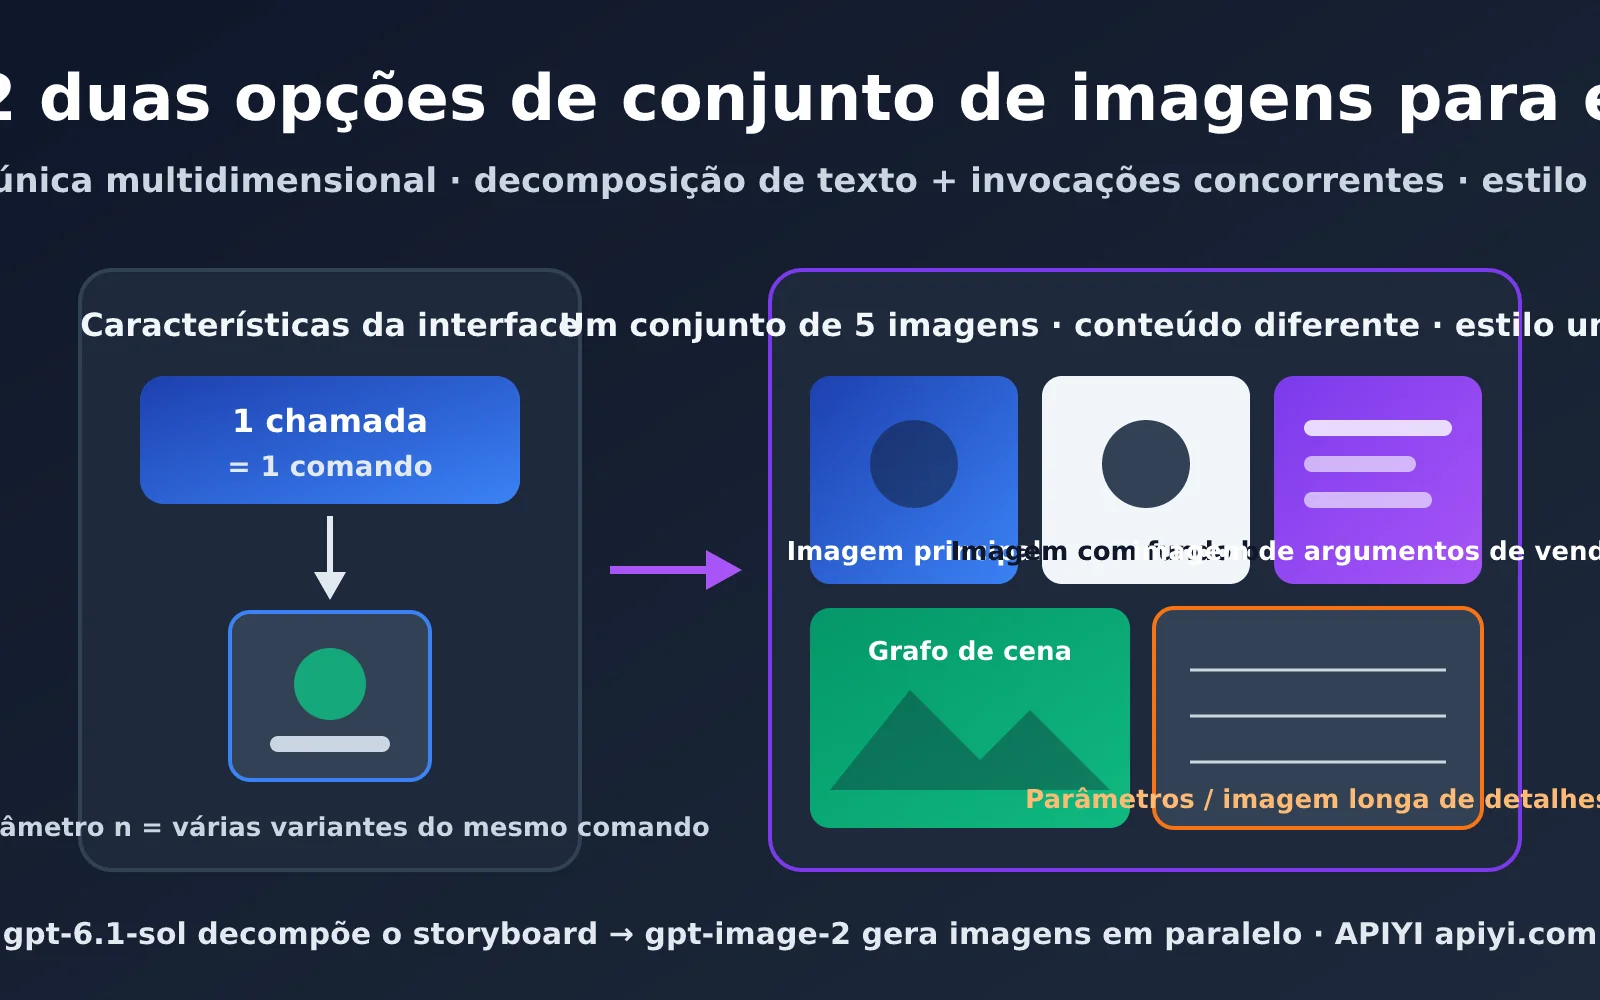
Este artigo divide o conjunto de imagens de e-commerce com gpt-image-2 em duas rotas: uma é usar uma única imagem para carregar informações multidimensionais, adequada para a imagem longa da página de detalhes; a outra é primeiro usar um modelo de texto para decompor a demanda e gerar o comando de cada imagem, e então chamar o gpt-image-2 em paralelo, adequada para um conjunto de múltiplas imagens de verdade. Ao final você terá o desenho completo do fluxo, código executável e algumas técnicas essenciais para manter o estilo do conjunto todo consistente.
A limitação central do conjunto de e-commerce com gpt-image-2: uma chamada, um único comando
Vamos deixar claro primeiro o comportamento da API — todo o desenho de solução a seguir parte dessa premissa. Os endpoints /v1/images/generations e /v1/images/edits do gpt-image-2 aceitam apenas um prompt por requisição. As séries oficiais gpt-image-2 e 2.5 suportam o parâmetro n, e a APIYI também dá suporte completo, mas o significado de n é «gerar n variações do mesmo comando», e não «n comandos, cada um gerando 1 imagem».
Ou seja, n=5 te entrega 5 versões da mesma cena, o que serve para «gerar algumas a mais e escolher a melhor», mas não serve para montar um conjunto. A essência de um conjunto de e-commerce é várias imagens com conteúdo diferente e estilo unificado: a imagem principal precisa destacar o produto, a de pontos de venda precisa de texto de apoio, a de cenário precisa de um ambiente de uso, a de parâmetros precisa de cotas e medidas. O comando de cada imagem é diferente, então naturalmente são necessárias várias chamadas.
Os 3 desafios reais do conjunto de e-commerce com gpt-image-2
Depois de entender bem a limitação, você percebe que a dificuldade do conjunto não está em «gerar várias imagens», mas nestas três coisas:
- Consistência do produto: o produto nas 5 imagens precisa ser o mesmo — cor, logo e estrutura não podem mudar de uma imagem para outra.
- Consistência de estilo: paleta de cores, iluminação, textura do fundo e estilo tipográfico devem parecer saídos do mesmo designer.
- Divisão de informação: cada imagem assume uma tarefa de marketing diferente; não dá para as 5 falarem do mesmo ponto de venda.
Essas três coisas mostram que o conjunto não se resolve «jogando uma frase no modelo»: é preciso planejar antes de chamar a API. A tabela abaixo traz a composição padrão de um conjunto nas plataformas de e-commerce mais comuns e serve como ponto de partida para o planejamento.
| Posição no conjunto | Uso principal | Proporção recomendada | Densidade de informação | Precisa de texto |
|---|---|---|---|---|
| Imagem principal (primeira) | Taxa de cliques nos resultados de busca | 1:1 | Baixa, destaca o produto | Opcional, pouco texto |
| Imagem de fundo branco | Exigências da plataforma, anúncios | 1:1 | Muito baixa | Não precisa |
| Imagem de pontos de venda | Comunicar 2-3 pontos principais | 1:1 ou 3:4 | Média | Precisa |
| Imagem de cenário | Criar atmosfera de uso | 1:1 ou 4:5 | Média | Opcional |
| Imagem de dimensões/parâmetros | Reduzir dúvidas e devoluções | 1:1 | Alta | Precisa |
| Imagem longa da página de detalhes | Explicar o produto por completo | 9:16 ou mais | Muito alta | Precisa |
🎯 Dica de planejamento: antes de escrever código, use a tabela acima para definir quantas imagens sua plataforma precisa e qual tarefa cada uma assume. Recomendamos rodar manualmente 2-3 imagens avulsas com gpt-image-2 na APIYI apiyi.com, confirmar que a fidelidade do produto e a renderização de texto atendem ao esperado, e só então entrar no fluxo de produção do conjunto em lote.
Solução 1: gpt-image-2 concentra múltiplas informações em uma única imagem (imagem longa de página de detalhes)
A primeira rota é “contar toda a história em uma só imagem”. O gpt-image-2 tem uma capacidade muito forte de renderizar texto em chinês e de entender layout, então é totalmente viável organizar, dentro de uma única imagem vertical grande, a área de visual principal, os argumentos de venda e a tabela de especificações. Para demandas como imagens longas de página de detalhes, imagens com coleção de argumentos de venda e infográficos, uma única invocação já entrega um material pronto com muita informação.
A maior vantagem dessa rota é que ela naturalmente não tem problema de consistência. Todo o conteúdo é gerado de uma vez pelo modelo dentro da mesma imagem, com tom e estilo naturalmente unificados, e sem precisar de código extra de orquestração. A desvantagem é que o espaço de uma imagem única é limitado: quando há conteúdo demais, o texto fica menor e mais apertado, e não é possível separar em imagens principais independentes para veiculação.
Como escrever o comando por zonas para a imagem longa de detalhes do gpt-image-2
O segredo para múltiplas dimensões em uma imagem é a descrição por zonas. Não escreva um bloco só com tudo misturado; siga a ordem do layout, de cima para baixo, dizendo ao modelo o que vai em cada região. Abaixo está um exemplo de estrutura de comando para uma imagem longa de página de detalhes de uma garrafa térmica:
Imagem longa de página de detalhes de e-commerce, formato vertical 9:16, estilo geral: minimalista nórdico, fundo bege claro, luz natural suave.
【Área superior】Visual principal do produto: uma garrafa térmica verde-musgo fosca posicionada em ângulo de 45 graus, com o texto de título "isolamento térmico de 24 horas".
【Área central】Três colunas de argumentos de venda, cada uma com um ícone linear e um texto curto: "interior em aço inox 316", "tampa que abre com um toque e uma mão", "capacidade de 500ml".
【Área inferior】Tabela de especificações: capacidade 500ml, peso 320g, altura 22cm, material aço inox 316.
Todos os textos devem usar uma fonte chinesa sem serifa bem legível, sem texto extra.
Quanto ao tamanho, para imagens longas recomendo o formato vertical 9:16, por exemplo 1152x2048 na faixa 2K. Se precisar de um material final em resolução mais alta, use 2160x3840 na faixa 4K.
A solução de imagem única precisa de apenas 1 invocação, tem o custo mais baixo e estilo naturalmente unificado; o preço é a capacidade limitada de informação — acima de 5 blocos o texto começa a ficar apertado — e a impossibilidade de separar imagens para usar como imagem principal de busca. Ela é mais indicada para páginas de detalhes e coleções de argumentos de venda de produtos padronizados do tipo “ficha técnica”, como eletrodomésticos, acessórios digitais e itens de uso diário.
💡 Dica prática: quando as zonas passam de 5, a taxa de erro na renderização de texto sobe bastante. A sugestão é dividir a imagem longa em 2 a 3 “meias-telas” geradas separadamente e depois empilhá-las verticalmente na página de detalhes. Essas meias-telas já formam, por si só, um pequeno conjunto de imagens — o que nos leva naturalmente à Solução 2.
Solução 2: modelo de texto decompõe + gpt-image-2 é invocado várias vezes para gerar o conjunto de imagens de e-commerce
Se o que você quer é um conjunto de imagens de verdade (imagem principal, imagem de argumentos de venda e imagem de cenário, cada uma independente), aí você precisa de uma pequena linha de produção. A ideia é deixar “entender a demanda e planejar os enquadramentos” para o modelo de texto, e “gerar as imagens” para o gpt-image-2, conectando os dois com um JSON estruturado.
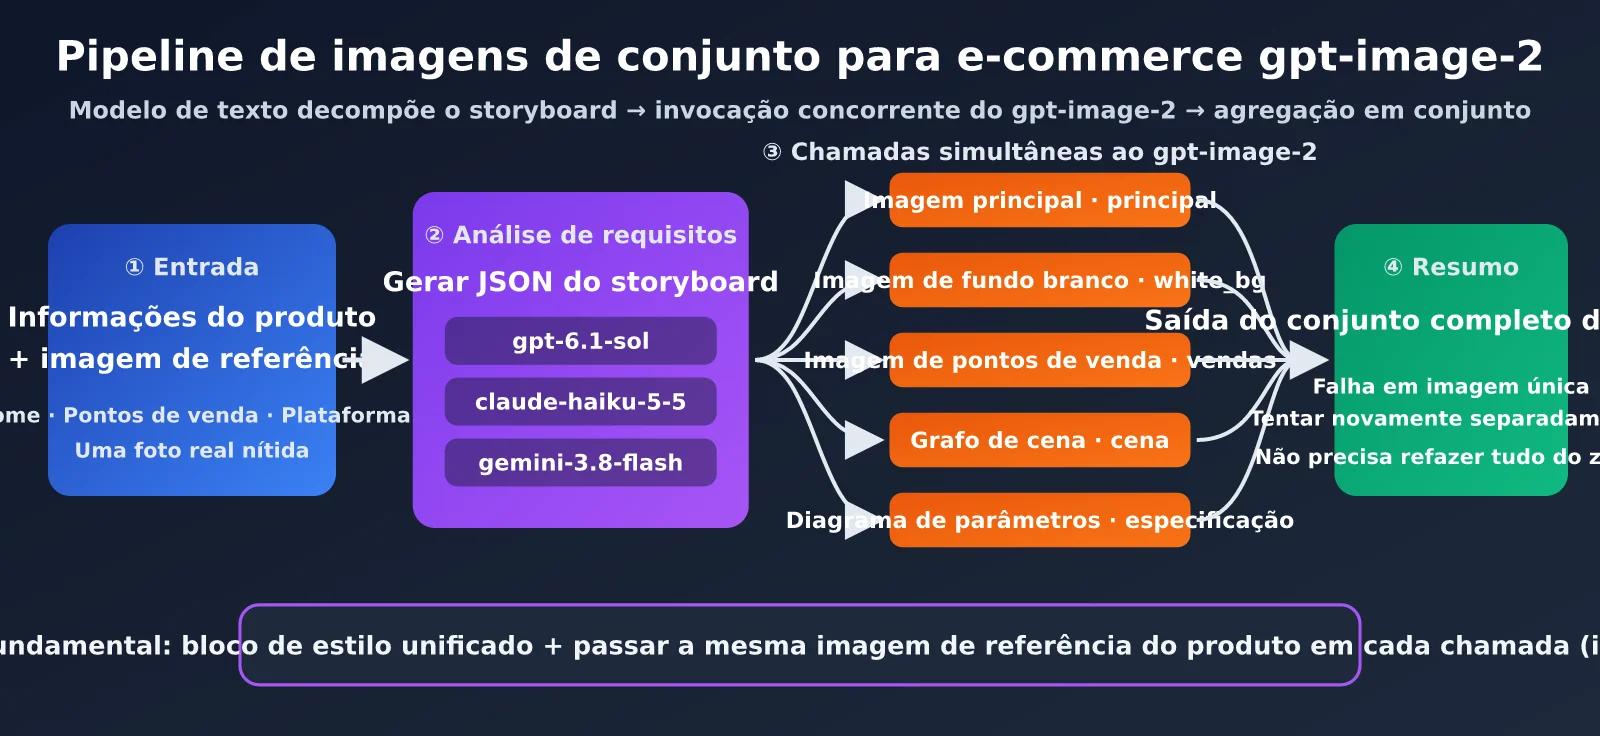
O fluxo completo tem 4 etapas:
- Entrada: o lojista fornece nome do produto, argumentos de venda, plataforma de destino e pelo menos uma foto nítida do produto real.
- Análise da demanda: o modelo de texto gera, a partir da entrada, um array JSON em que cada elemento é o enquadramento de uma imagem, incluindo finalidade, comando, tamanho e texto de copy.
- Geração paralela: o programa percorre o array de enquadramentos, chama o gpt-image-2 uma vez por enquadramento, sempre com a mesma imagem de referência do produto.
- Consolidação e validação: junta todos os resultados, refaz individualmente as imagens que falharam e, no fim, entrega o conjunto completo na ordem.
Como escolher o modelo de texto: o “cérebro” do conjunto de imagens do gpt-image-2
A etapa de análise da demanda exige do modelo de texto: entender a lógica de marketing de e-commerce, gerar JSON de forma estável e escrever comandos com boa carga visual. Hoje, os modelos mais recentes disponíveis na APIYI dão conta do recado:
| Modelo | Posicionamento | Cenários indicados | Motivo da escolha |
|---|---|---|---|
| gpt-6.1-sol | Recomendação principal | Produtos de ticket alto, extração de argumentos complexos | Melhor qualidade em copy de marketing e planejamento de enquadramentos |
| claude-haiku-5-5 | Barato e rápido | SKUs em lote, categorias padronizadas | Aderência a instruções estável, saída JSON bem organizada |
| gemini-3.8-flash | Barato e rápido | Grandes volumes, produtos transfronteiriços multilíngues | Rápido e barato, copy multilíngue natural |
A análise da demanda é chamada apenas uma vez por conjunto de imagens, consome poucos tokens, e o custo fica concentrado na geração das imagens. Recomendamos ajustar o template de comando com o gpt-6.1-sol até ficar satisfatório e, ao rodar em lote, trocar para o claude-haiku-5-5 ou o gemini-3.8-flash para reduzir custo. Os três modelos usam interface compatível com OpenAI na APIYI (apiyi.com), então a troca exige apenas mudar o parâmetro model.
Design do JSON de enquadramentos do conjunto de imagens de e-commerce do gpt-image-2
Fazer o modelo de texto gerar um JSON com estrutura fixa é o que garante a estabilidade de toda a linha de produção. Abaixo, o design de campos recomendado:
| Campo | Tipo | Descrição | Exemplo |
|---|---|---|---|
scene |
string | Identificador da posição no conjunto | main / white_bg / selling |
purpose |
string | A tarefa de marketing desta imagem | Destacar a aparência do produto e elevar o CTR |
prompt |
string | Comando completo para o gpt-image-2 | Garrafa térmica verde-musgo fosca sobre mesa de madeira… |
size |
string | Tamanho de saída | 2048x2048 |
text_overlay |
string | Texto que precisa ser renderizado na imagem | Isolamento térmico de 24 horas |
Código mínimo do conjunto de imagens com gpt-image-2
Abaixo está a versão mínima executável: primeiro o modelo de texto gera os enquadramentos, depois chamamos o endpoint edits do gpt-image-2 item por item (com a imagem de referência do produto).
import json, base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="gpt-6.1-sol",
    response_format={"type": "json_object"},
    messages=[{"role": "user", "content": "Planeje 5 imagens de conjunto para uma garrafa térmica 316 verde-musgo no Taobao, retorne {\"shots\": [...]}, "
               "cada item com scene/purpose/prompt/size/text_overlay, estilo unificado: minimalista nórdico, fundo bege claro, luz natural suave"}],
)
shots = json.loads(plan.choices[0].message.content)["shots"]

for s in shots:
    img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                             prompt=s["prompt"], size=s["size"])
    open(f"{s['scene']}.png", "wb").write(base64.b64decode(img.data[0].b64_json))
Esse código roda em série: as 5 imagens são esperadas uma após a outra. Na próxima seção vamos transformá-lo em uma versão concorrente.
Como manter a consistência de estilo no conjunto de imagens de e-commerce do gpt-image-2
O problema mais comum em múltiplas invocações é que as 5 imagens acabam parecendo de 5 lojas diferentes. Combinando as técnicas abaixo, dá para elevar a consistência a um nível comercialmente utilizável:
- Bloco de estilo unificado: escreva tom de cor, iluminação, fundo e linguagem de câmera em um texto fixo e concatene no fim de cada comando de enquadramento. Não deixe o modelo de texto inventar a descrição de estilo livremente a cada vez.
- Imagem de referência fixa do produto: em cada invocação, envie a mesma foto real do produto pelo endpoint edits e deixe explícito no comando “mantenha inalteradas a cor, o logo e a estrutura do produto na imagem de referência”. Esse é o meio mais eficaz de garantir a consistência do objeto principal.
- Parâmetros fixos: use o mesmo nível de
qualityem todo o conjunto e mude o tamanho só quando necessário (por exemplo, formato vertical para imagens longas). - Usar o parâmetro n para escolher a melhor: para posições mais críticas, como a imagem principal, defina
n=2oun=3para gerar algumas variantes e escolher a melhor manualmente. Esse é exatamente o uso correto do parâmetro n.
🎯 Recomendação de consistência: o bloco de estilo é a “norma de marca” de todo o conjunto; vale a pena manter um template fixo por loja. Ao chamar o gpt-image-2 pela APIYI (apiyi.com), você pode guardar o bloco de estilo em um arquivo de configuração, compartilhado por todos os SKUs, e basta atualizá-lo de forma unificada na troca de estação.
Chamadas concorrentes de conjuntos de imagens de e-commerce com gpt-image-2: estratégias para acelerar e escalar
Ao gerar um conjunto de 5 imagens em série, o tempo de espera é a soma do tempo de cada imagem — quanto mais imagens, mais lento fica. Como cada cena do storyboard não depende das outras, dá para chamar tudo em paralelo sem problema, fazendo o tempo total do conjunto ficar próximo ao da «imagem mais lenta».
A APIYI não define limite de concorrência para chamadas do gpt-image-2, abaixo de 500 RPM você pode usar direto, sem precisar solicitar nada extra. Para a grande maioria dos lojistas, mesmo rodando dezenas de SKUs em paralelo, você fica bem longe desse patamar.
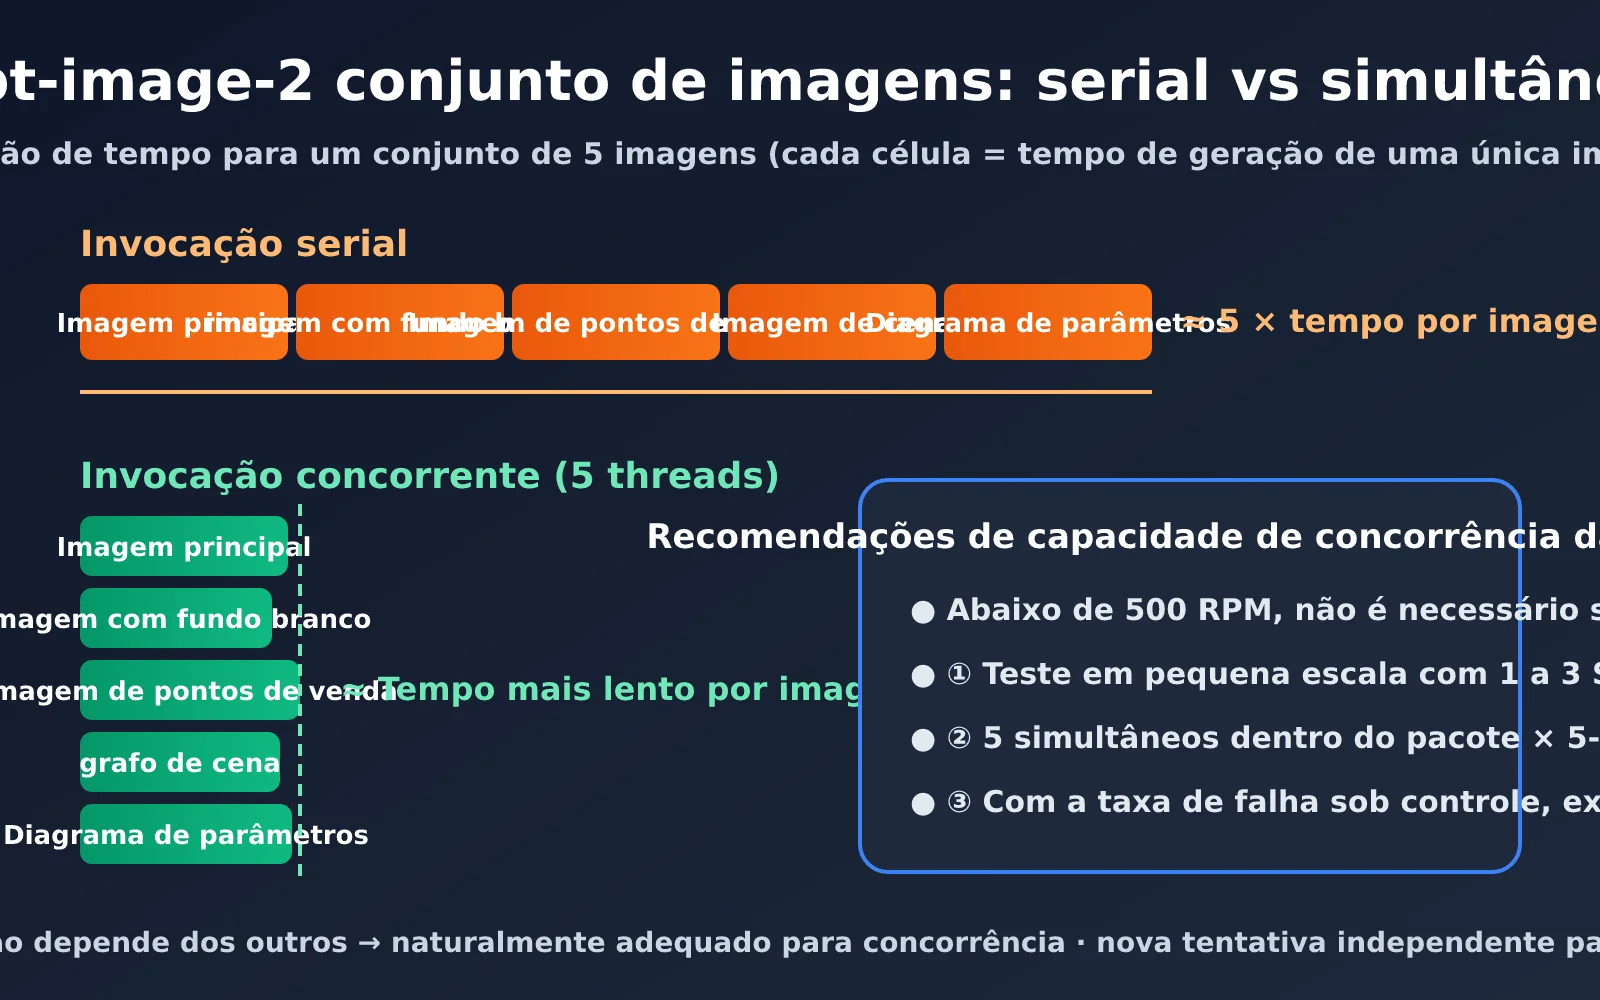
Código de geração concorrente de conjuntos com gpt-image-2
Basta trocar o loop serial acima por um pool de threads para gerar as imagens em paralelo, e ainda adicionar retry em caso de falha, evitando que uma imagem com erro faça o conjunto inteiro recomeçar:
from concurrent.futures import ThreadPoolExecutor

def gen_one(s, retries=2):
    for i in range(retries + 1):
        try:
            img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                                     prompt=s["prompt"] + STYLE_BLOCK, size=s["size"])
            return s["scene"], img.data[0].b64_json
        except Exception as e:
            if i == retries:
                return s["scene"], None

with ThreadPoolExecutor(max_workers=5) as pool:
    results = dict(pool.map(gen_one, shots))
failed = [k for k, v in results.items() if v is None]
Ver o código completo (com style block, lote de vários SKUs, regeneração de falhas e salvamento dos resultados)
import json, base64, time
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

STYLE_BLOCK = (
    "。整体风格:北欧简约,米白色背景,柔和自然光,低饱和配色,"
    "保持参考图中产品的颜色、Logo 和结构完全不变,文字使用清晰无衬线中文字体。"
)

PLAN_PROMPT = """你是资深电商视觉策划。根据以下商品信息规划一套 {count} 张的{platform}套图。
商品信息:{product}
输出 JSON:{{"shots": [{{"scene": "...", "purpose": "...", "prompt": "...",
"size": "2048x2048", "text_overlay": "..."}}]}}
要求:每张图承担不同营销任务;prompt 只描述画面内容,不要描述整体风格;
需要文字时把文字原文写进 prompt 并用引号标出。"""


def plan_shots(product: str, platform: str = "淘宝", count: int = 5,
               model: str = "gpt-6.1-sol") -> list:
    """Usa o modelo de texto para detalhar o storyboard; em lote pode trocar por claude-haiku-5-5 / gemini-3.8-flash"""
    resp = client.chat.completions.create(
        model=model,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": PLAN_PROMPT.format(
            count=count, platform=platform, product=product)}],
    )
    return json.loads(resp.choices[0].message.content)["shots"]


def gen_one(shot: dict, ref_image: str, retries: int = 2):
    """Gera uma imagem única, com retry e backoff exponencial em caso de falha"""
    for attempt in range(retries + 1):
        try:
            with open(ref_image, "rb") as f:
                img = client.images.edit(
                    model="gpt-image-2",
                    image=f,
                    prompt=shot["prompt"] + STYLE_BLOCK,
                    size=shot.get("size", "2048x2048"),
                )
            return shot["scene"], img.data[0].b64_json
        except Exception as e:
            print(f"[{shot['scene']}] Falha na tentativa {attempt + 1}: {e}")
            time.sleep(2 ** attempt)
    return shot["scene"], None


def gen_image_set(sku: str, product: str, ref_image: str, workers: int = 5):
    shots = plan_shots(product)
    out_dir = Path("output") / sku
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / "plan.json").write_text(json.dumps(shots, ensure_ascii=False, indent=2))

    with ThreadPoolExecutor(max_workers=workers) as pool:
        results = dict(pool.map(lambda s: gen_one(s, ref_image), shots))

    # Uma rodada de regeneração das imagens que falharam
    failed = [s for s in shots if results.get(s["scene"]) is None]
    for s in failed:
        results[s["scene"]] = gen_one(s, ref_image, retries=3)[1]

    for scene, b64 in results.items():
        if b64:
            (out_dir / f"{scene}.png").write_bytes(base64.b64decode(b64))
    print(f"{sku}: sucesso {sum(1 for v in results.values() if v)}/{len(shots)} imagens")


if __name__ == "__main__":
    gen_image_set(
        sku="cup-green-500",
        product="墨绿色 316 不锈钢保温杯,500ml,24 小时保温,一键弹盖",
        ref_image="cup.png",
    )
As 3 fases para escalar a concorrência
Embora não haja limite de concorrência, ainda recomendamos escalar por fases: validar o resultado primeiro e só depois aumentar o volume, evitando gerar centenas de imagens ruins de uma vez:
- Teste em pequena escala: escolha de 1 a 3 SKUs, rode em série ou com baixa concorrência, e confira manualmente a fidelidade do produto, a taxa de acerto dos textos e a consistência de estilo.
- Concorrência média: depois que o resultado estabilizar, suba para 5 concorrências por conjunto e 5-10 SKUs ao mesmo tempo, observando a taxa de falha e o tempo médio.
- Escala em lote: após confirmar que a taxa de falha está sob controle, aumente a concorrência conforme a demanda do negócio — dentro de 500 RPM dá para rodar direto.
| Modo de chamada | Tempo de um conjunto de 5 imagens | Estabilidade | Fase indicada |
|---|---|---|---|
| Chamada serial | Cerca de 5x o tempo de uma imagem | Mais estável, fácil de depurar | Fase de ajuste do comando |
| Concorrência dentro do conjunto (5 threads) | Aproximadamente o tempo da imagem mais lenta | Estável | Lançamentos do dia a dia |
| Vários SKUs + concorrência no conjunto | Próximo ao de um único conjunto | Exige retry junto | Lançamentos em lote para grandes promoções |
🚀 Sugestão de escala: para cenários de lançamentos concentrados antes de grandes promoções, recomendamos usar o modo «vários SKUs + concorrência no conjunto» através da APIYI (apiyi.com). A plataforma não exige nenhuma solicitação abaixo de 500 RPM e, com o mecanismo de regeneração das imagens que falharam, os conjuntos completos de dezenas de SKUs ficam prontos em pouquíssimo tempo.
Como escolher o esquema de conjunto de imagens para e-commerce com gpt-image-2
Os dois esquemas não são mutuamente exclusivos e, na prática, costumam ser combinados. A seguir, recomendações por plataforma e cenário:
| Plataforma/Cenário | Esquema recomendado | Quantidade sugerida | Observações |
|---|---|---|---|
| Imagem principal Taobao/Tmall | Esquema 2 | 5 imagens | Uma para imagem principal, fundo branco, argumentos de venda, cenário e especificações |
| Página de detalhes Taobao/Pinduoduo | Esquema 1 + Esquema 2 | 3-6 imagens de meia tela | Gerar por seções e depois montar verticalmente |
| Listing na Amazon | Esquema 2 | 7 imagens | Primeira imagem com fundo branco seguindo rigorosamente as regras; as demais com argumentos de venda e cenário |
| Página de produto em loja própria | Esquema 2 | 4-6 imagens | Imagens de cenário têm mais peso, destacando a identidade da marca |
| Divulgação no Xiaohongshu | Esquema 2 | 3-6 imagens | Formato vertical 3:4, priorizando cenas do cotidiano |
| Pôster de campanha/coletânea de argumentos | Esquema 1 | 1 imagem | Informação concentrada em uma só imagem, alta eficiência de divulgação |
O princípio central da escolha é simples: imagens que precisam ser veiculadas e exibidas de forma independente usam o Esquema 2; conteúdos lidos em sequência dentro de uma única página usam o Esquema 1. Se estiver em dúvida, comece gerando as imagens principal e de cenário com o Esquema 2, depois produza uma imagem longa com a coletânea de argumentos usando o Esquema 1 — assim a cobertura é a mais ampla.
💡 Sugestão de combinação: os dois esquemas usam o mesmo modelo gpt-image-2 e a mesma chave API. A recomendação é encapsular os dois fluxos em um único serviço, selecionando o esquema automaticamente conforme o tipo de produto. O lojista só precisa enviar uma foto do produto e algumas linhas de texto com os argumentos de venda.
Perguntas frequentes
O parâmetro n do gpt-image-2 consegue gerar diretamente um conjunto de imagens para e-commerce?
Não. As séries oficiais gpt-image-2 e 2.5 suportam o parâmetro n, e a APIYI também suporta, mas ele gera n variações a partir de um mesmo comando. Cada imagem de um conjunto tem conteúdo diferente e exige comandos diferentes, portanto é preciso fazer várias chamadas. O n é mais útil em posições-chave, como a imagem principal, para escolher a melhor entre as variações.
E se o produto aparecer diferente entre as várias imagens geradas?
Esse é o problema mais comum em conjuntos de imagens. A abordagem mais eficaz é usar sempre a interface edits em cada chamada, passando a mesma foto real do produto, e escrever no comando “mantenha inalteradas a cor, o logo e a estrutura do produto na imagem de referência”. Ao mesmo tempo, fixe a descrição de estilo em um style block, sem deixar o modelo de texto livre para improvisar. Recomenda-se usar como imagem de referência uma foto real com fundo limpo e iluminação uniforme — assim o resultado de reprodução fica melhor.
Como lidar com erros de renderização de texto em chinês nas imagens?
A capacidade de renderização de chinês do gpt-image-2 já é bastante forte, mas quanto mais texto, maior a chance de erro. A recomendação é limitar o texto de cada imagem a 2-3 frases curtas e indicar o texto original entre aspas no comando. Se o texto de alguma imagem sair errado, basta gerar novamente apenas aquela imagem, sem refazer o conjunto inteiro.
Qual modelo é mais vantajoso para a decomposição de texto?
Ao depurar o template de comando, use o gpt-6.1-sol, que oferece a melhor qualidade de planejamento; depois que o template estiver estável e for rodar em lote, dá para trocar para o claude-haiku-5-5 ou o gemini-3.8-flash, com custo menor e mais velocidade. Essa etapa é chamada apenas uma vez por conjunto de imagens, com gasto bem inferior ao da própria geração de imagens. Os três modelos podem ser chamados na APIYI apiyi.com com a mesma chave API.
É preciso solicitar cota para chamadas concorrentes?
Não. A APIYI não define limite de concorrência para o gpt-image-2: abaixo de 500 RPM, pode usar diretamente. A recomendação é começar com testes em pequena escala em 1-3 SKUs e, depois de confirmar os resultados, aumentar gradualmente o volume de chamadas concorrentes.
Resumo
Para gerar conjuntos de imagens de e-commerce com o gpt-image-2, o ponto-chave é entender a característica da interface: cada chamada corresponde a um comando. O parâmetro n resolve a questão de escolher a melhor opção, mas um conjunto de imagens exige várias chamadas, cada uma com um comando diferente. Partindo desse princípio, conteúdos de leitura contínua — como páginas de detalhes e coleções de pontos de venda — podem ser gerados de uma vez com a abordagem de imagem única multidimensional; já os conjuntos que precisam ser exibidos de forma independente — como imagens principais e imagens de cena — são produzidos em lote por um pipeline de decomposição via modelo de texto + chamadas concorrentes.
O núcleo comum das duas rotas é o controle de consistência: um bloco de estilo fixo somado à mesma imagem de referência do produto é a chave para que várias imagens pareçam ter saído da mesma equipe de design. Em relação à concorrência, abaixo de 500 RPM dá para escalar direto; o mais seguro é seguir três etapas: “teste em pequena escala → concorrência média → escala em lote”.
Recomendamos usar o APIYI apiyi.com para completar todo o pipeline de ponta a ponta: o gpt-6.1-sol, o claude-haiku-5-5 e o gemini-3.8-flash cuidam da decomposição de requisitos, o gpt-image-2 cuida da geração das imagens, e uma única chave API conecta todas as etapas — assim você monta rapidamente o seu próprio serviço de geração de conjuntos de imagens para e-commerce.
Autor: APIYI Team | Especializado em compartilhar conhecimento técnico sobre APIs de Modelos de Linguagem Grande. Para mais tutoriais de integração de modelos, acesse APIYI apiyi.com