Neulich hat ein Kunde in unserer Gruppe eine sehr typische Frage gestellt: „Können wir mit unserem images2 eigentlich ein E-Commerce-Bilderset generieren?“ Die Antwort ist ja – aber nicht so, dass ein einzelner Aufruf gleich ein komplettes Set ausspuckt. Die Schnittstelle von gpt-image-2 funktioniert nach dem Prinzip „eine Eingabeaufforderung, eine Generierung“. Wer ein Set aus Hauptbild, Verkaufsargument-Bild, Szenenbild und Detailseite braucht – also Bilder, deren Inhalte sich jeweils unterscheiden –, muss die Art des Aufrufs ein wenig durchdenken.
Dieser Artikel teilt E-Commerce-Bildersets mit gpt-image-2 in zwei Routen auf: Die eine packt mehrere Informationsdimensionen in ein einziges Bild – geeignet für lange Detailseiten-Grafiken. Die andere lässt zuerst ein Textmodell die Anforderung zerlegen und für jedes Bild eine Eingabeaufforderung erzeugen und ruft dann gpt-image-2 parallel auf – geeignet für echte Mehrbild-Sets. Nach der Lektüre haben Sie ein vollständiges Prozessdesign, lauffähigen Code und ein paar entscheidende Kniffe, um den Stil des gesamten Sets einheitlich zu halten.
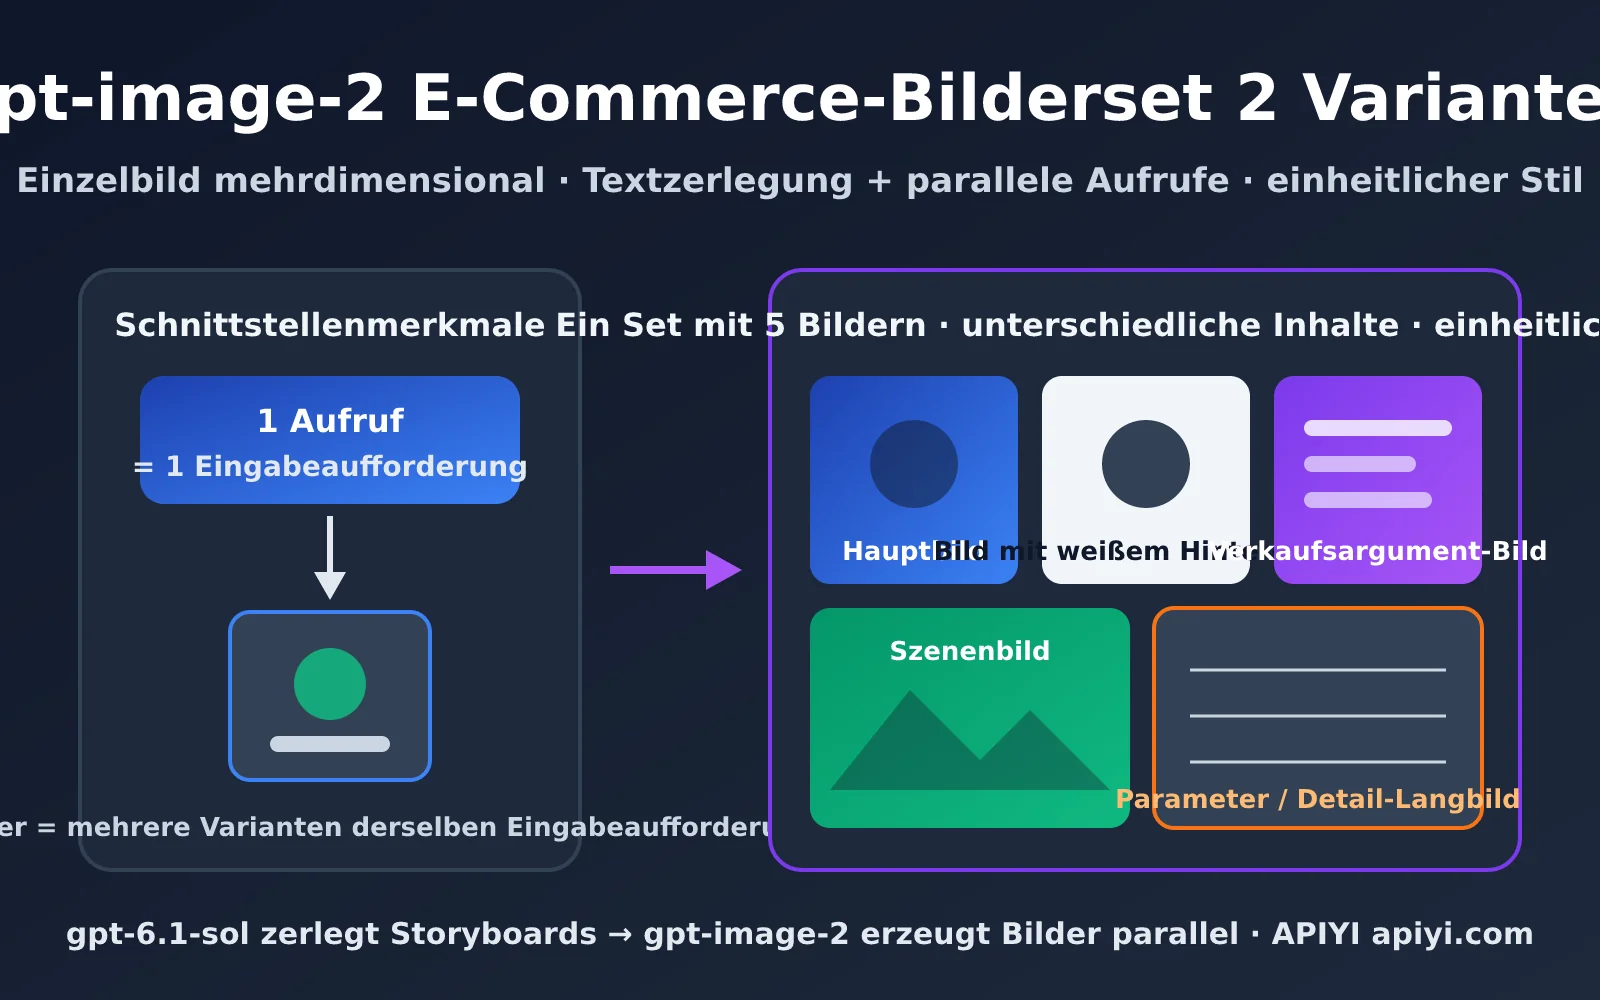
Die zentrale Einschränkung bei E-Commerce-Bildersets mit gpt-image-2: ein Aufruf entspricht genau einer Eingabeaufforderung
Zuerst machen wir das Verhalten der Schnittstelle klar, denn alle folgenden Lösungsdesigns bauen auf dieser Voraussetzung auf. Die Endpunkte /v1/images/generations und /v1/images/edits von gpt-image-2 akzeptieren pro Anfrage nur eine Eingabeaufforderung. Die offiziellen gpt-image-2- und 2.5-Serien unterstützen den Parameter n, APIYI unterstützt ihn ebenfalls vollständig – aber n bedeutet „n Varianten aus derselben Eingabeaufforderung„, nicht „n Eingabeaufforderungen ergeben je 1 Bild“.
Mit n=5 bekommen Sie also fünf Versionen desselben Motivs. Das passt gut zu „mehrere Ausgaben erzeugen und die beste auswählen“, taugt aber nicht für ein Set. Ein E-Commerce-Set besteht im Kern aus mehreren Bildern mit unterschiedlichem Inhalt und einheitlichem Stil: Das Hauptbild soll das Produkt in den Vordergrund stellen, das Verkaufsargument-Bild braucht Text, das Szenenbild eine Nutzungsumgebung, das Parameterbild Maßangaben. Jede Eingabeaufforderung ist anders, also braucht es zwangsläufig mehrere Aufrufe.
Die drei eigentlichen Schwierigkeiten bei E-Commerce-Bildersets mit gpt-image-2
Wenn man diese Einschränkung einmal verstanden hat, zeigt sich: Die Schwierigkeit liegt gar nicht darin, „mehrere Bilder zu erzeugen“, sondern in den folgenden drei Punkten:
- Konsistentes Motiv: Das Produkt in allen fünf Bildern muss dasselbe Produkt sein – Farbe, Logo und Aufbau dürfen nicht von Bild zu Bild variieren.
- Einheitlicher Stil: Farbton, Licht, Hintergrundtextur und Schriftstil müssen wirken, als kämen sie vom selben Designer.
- Klare Aufgabenverteilung: Jedes Bild übernimmt eine andere Marketingaufgabe; nicht alle fünf dürfen dasselbe Verkaufsargument erzählen.
Diese drei Punkte machen klar: Ein Set lässt sich nicht mit „ein Satz an das Modell“ lösen – vor dem Aufruf braucht es eine Planung. Die folgende Tabelle zeigt die typische Zusammensetzung eines Sets auf gängigen E-Commerce-Plattformen und kann als Ausgangspunkt für Ihre Planung dienen.
| Position im Set | Hauptzweck | Empfohlenes Seitenverhältnis | Informationsdichte | Text erforderlich |
|---|---|---|---|---|
| Hauptbild (Titelbild) | Klickrate in Suchergebnissen | 1:1 | niedrig, Produkt im Fokus | optional, wenig |
| Freisteller auf weißem Hintergrund | Plattformvorgaben, Werbeanzeigen | 1:1 | sehr niedrig | nicht nötig |
| Verkaufsargument-Bild | 2–3 Kernargumente vermitteln | 1:1 oder 3:4 | mittel | erforderlich |
| Szenenbild | Nutzungsatmosphäre schaffen | 1:1 oder 4:5 | mittel | optional |
| Maß-/Parameterbild | Rückfragen und Retouren reduzieren | 1:1 | hoch | erforderlich |
| Langes Detailseiten-Bild | Produkt vollständig erklären | 9:16 oder länger | sehr hoch | erforderlich |
🎯 Planungshinweis: Bevor Sie Code schreiben, legen Sie anhand der Tabelle oben fest, wie viele Bilder Ihre Plattform braucht und welche Aufgabe jedes einzelne übernimmt. Wir empfehlen, bei APIYI auf apiyi.com mit gpt-image-2 zunächst 2–3 Einzelbilder manuell zu erzeugen und zu prüfen, ob Produkttreue und Textwiedergabe den Erwartungen entsprechen – erst dann steigen Sie in den Batch-Workflow für das komplette Set ein.
Ansatz 1: gpt-image-2 – ein einzelnes Bild trägt mehrere Informationsdimensionen (lange Detailseiten-Grafik)
Der erste Weg lautet: „ein Bild erzählt die ganze Botschaft“. gpt-image-2 hat eine starke Fähigkeit zur Darstellung chinesischer Schrift und zum Verständnis von Layouts – es ist durchaus machbar, in einem großen Hochformat-Bild Hauptmotiv, Verkaufsargumente und eine Parameter-Tabelle in getrennten Bereichen anzuordnen. Für Anforderungen wie lange Detailseiten-Grafiken, Sammlungen von Verkaufsargumenten oder Infografiken liefert ein einziger Aufruf ein fertiges Bild mit sehr viel Information.
Der größte Vorteil dieses Weges: Ein Konsistenzproblem gibt es von Natur aus nicht. Alle Inhalte entstehen in einem einzigen Bild, das Modell generiert sie in einem Durchgang – Farbton und Stil sind automatisch einheitlich, und zusätzlicher Orchestrierungscode ist nicht nötig. Der Nachteil: Die Fläche eines einzelnen Bildes ist begrenzt. Bei zu viel Inhalt werden die Texte kleiner und enger, und man kann das Ganze nicht in einzelne Hauptbilder aufteilen, um sie separat auszuspielen.
Wie man die Eingabeaufforderung für eine lange Detailseiten-Grafik mit gpt-image-2 in Bereiche gliedert
Der Schlüssel für ein einzelnes Bild mit mehreren Dimensionen ist die bereichsweise Beschreibung. Schreiben Sie nicht einen großen, vermischten Beschreibungsblock, sondern sagen Sie dem Modell in der Reihenfolge des Layouts von oben nach unten, was in jeden Bereich gehört. Hier ein Beispiel für die Struktur einer Eingabeaufforderung für die lange Detailseiten-Grafik eines Thermobechers:
Hochformat 9:16, lange E-Commerce-Detailseiten-Grafik, Gesamtstil: schlichter skandinavischer Stil, cremeweißer Hintergrund, weiches natürliches Licht.
【Oberer Bereich】Produkt-Hauptmotiv: ein mattierter dunkelgrüner Thermobecher in 45-Grad-Schräglage, Titeltext „24 Stunden lang warmhaltend".
【Mittlerer Bereich】Verkaufsargumente in drei Spalten, jede Spalte ein Linien-Icon plus kurzer Text: „316-Edelstahl-Innenbehälter", „Deckel öffnet mit einem Klick – Einhandbedienung", „500 ml großes Fassungsvermögen".
【Unterer Bereich】Parameter-Tabelle: Fassungsvermögen 500 ml, Gewicht 320 g, Höhe 22 cm, Material 316 Edelstahl.
Alle Texte verwenden eine klare serifenlose chinesische Schrift; keine überflüssigen Texte erscheinen lassen.
Was die Abmessungen betrifft: Für lange Grafiken empfiehlt sich ein Hochformat im Verhältnis 9:16, zum Beispiel 1152x2048 in der 2K-Stufe. Wenn Sie endgültiges Material in höherer Auflösung brauchen, können Sie die 4K-Stufe mit 2160x3840 verwenden.
Der Ein-Bild-Ansatz braucht nur einen einzigen Aufruf, ist am günstigsten, und der Stil ist von Natur aus einheitlich; der Preis dafür ist eine begrenzte Informationskapazität. Bei mehr als 5 Bereichen werden die Texte leicht gedrängt, und man kann einzelne Teile nicht herauslösen, um sie separat als Such-Hauptbild auszuspielen. Am besten eignet er sich für Detailseiten und Verkaufsargument-Sammlungen von parameterorientierten Standardprodukten wie Haushaltsgeräten, Digital-Zubehör und Alltagsgegenständen.
💡 Praxistipp: Bei mehr als 5 Bereichen steigt die Fehlerquote bei der Textdarstellung deutlich an. Es empfiehlt sich, die lange Grafik in 2–3 „Halbbildschirm-Bilder“ aufzuteilen, sie separat zu generieren und dann in der Detailseite vertikal zusammenzusetzen. Diese Halbbildschirm-Bilder sind selbst schon eine kleine Bilderserie – und so ergibt sich der Übergang zu Ansatz 2 ganz natürlich.
Ansatz 2: Textmodell zerlegt die Aufgabe + gpt-image-2 generiert in mehreren Aufrufen eine E-Commerce-Bilderserie
Wenn Sie eine echte mehrteilige Bilderserie wollen (Hauptbild, Verkaufsargument-Bild, Szenenbild – jeweils eigenständig), brauchen Sie eine kleine Pipeline. Die Idee: Das Verstehen der Anforderung und die Planung der Bildsequenz übernimmt das Textmodell, die Bilderzeugung übernimmt gpt-image-2, und beide werden über strukturiertes JSON verbunden.
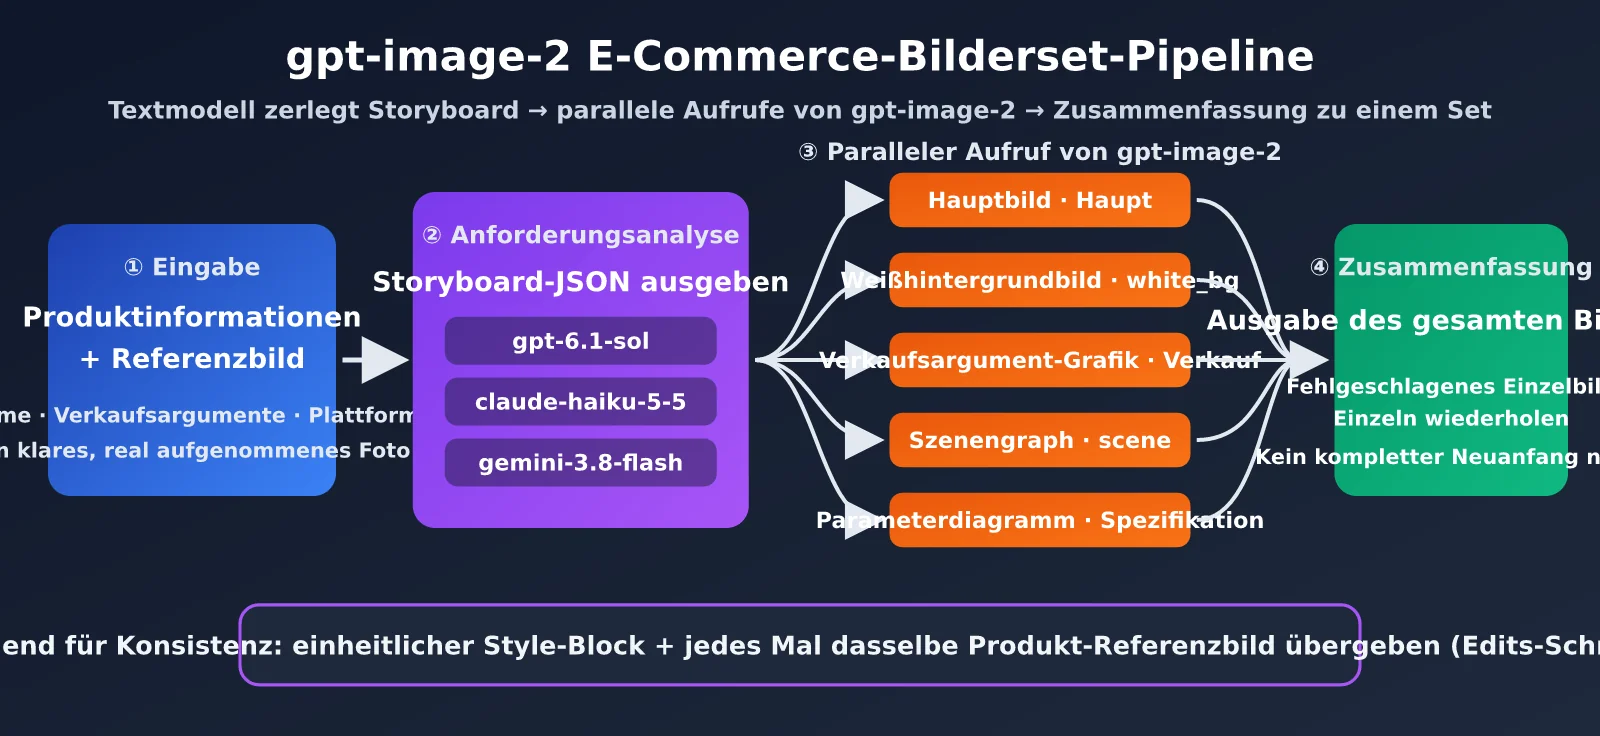
Der komplette Ablauf besteht aus 4 Schritten:
- Eingabe: Der Händler liefert Produktname, Verkaufsargumente, Zielplattform und mindestens ein klares Produktfoto.
- Bedarfsanalyse: Das Textmodell gibt auf Basis der Eingabe ein JSON-Array aus; jedes Element ist die Bildplanung für ein Bild, einschließlich Verwendungszweck, Eingabeaufforderung, Größe und Text.
- Parallele Bilderzeugung: Das Programm durchläuft das Bildplanungs-Array, ruft für jede Bildplanung einmal gpt-image-2 auf und übergibt dabei dasselbe Produkt-Referenzbild.
- Zusammenführen und Prüfen: Alle Ergebnisse werden gesammelt, fehlgeschlagene Einzelbilder separat erneut versucht und schließlich die gesamte Bilderserie in der richtigen Reihenfolge ausgegeben.
Wie man das Textmodell wählt: das „Gehirn“ der gpt-image-2-Bilderserie
Die Bedarfsanalyse stellt an das Textmodell folgende Anforderungen: Es muss die Marketinglogik im E-Commerce verstehen, zuverlässig JSON ausgeben und bildstarke Eingabeaufforderungen schreiben können. Mehrere der neuesten Modelle bei APIYI erfüllen das derzeit problemlos:
| Modell | Positionierung | Geeignete Szenarien | Auswahlgrund |
|---|---|---|---|
| gpt-6.1-sol | Flaggschiff-Empfehlung | Produkte mit hohem Warenkorbwert, komplexe Verkaufsargumente | Beste Qualität bei Marketingtexten und Bildplanung |
| claude-haiku-5-5 | Günstig und schnell | Massen-SKUs, standardisierte Kategorien | Stabile Anweisungsbefolgung, saubere JSON-Ausgabe |
| gemini-3.8-flash | Günstig und schnell | Große Mengen, mehrsprachige grenzüberschreitende Produkte | Schnell, kostengünstig, natürliche mehrsprachige Texte |
Die Bedarfsanalyse wird pro Bilderserie nur einmal aufgerufen, der Token-Verbrauch ist gering – die Kosten liegen vor allem bei der Bilderzeugung. Wir empfehlen, zuerst mit gpt-6.1-sol die Vorlage für die Eingabeaufforderung zufriedenstellend zu optimieren und beim Massenbetrieb dann auf claude-haiku-5-5 oder gemini-3.8-flash zu wechseln, um Kosten zu sparen. Alle drei Modelle laufen bei APIYI apiyi.com über eine OpenAI-kompatible Schnittstelle; beim Wechseln muss nur der Parameter model geändert werden.
Das JSON-Design der Bildplanung für eine gpt-image-2-E-Commerce-Bilderserie
Dass das Textmodell ein JSON mit fester Struktur ausgibt, ist der Schlüssel für einen stabilen Betrieb der gesamten Pipeline. Hier das empfohlene Feld-Design:
| Feld | Typ | Beschreibung | Beispiel |
|---|---|---|---|
scene |
string | Positionskennung innerhalb der Serie | main / white_bg / selling |
purpose |
string | Die Marketingaufgabe dieses Bildes | Produktaussehen hervorheben, Klickrate steigern |
prompt |
string | Vollständige Eingabeaufforderung für gpt-image-2 | Mattierter dunkelgrüner Thermobecher auf einem Holztisch… |
size |
string | Ausgabegröße | 2048x2048 |
text_overlay |
string | Der im Bild zu rendernde Text | 24 Stunden lang warmhaltend |
Minimalcode für die gpt-image-2-Bilderserie
Hier die minimale lauffähige Version: Zuerst lässt man das Textmodell die Bildplanung generieren, dann ruft man die edits-Schnittstelle von gpt-image-2 Zeile für Zeile auf (mit Produkt-Referenzbild).
import json, base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="gpt-6.1-sol",
    response_format={"type": "json_object"},
    messages=[{"role": "user", "content": "为墨绿色 316 保温杯规划 5 张淘宝套图,输出 {\"shots\": [...]},"
               "每项含 scene/purpose/prompt/size/text_overlay,统一风格:北欧简约、米白背景、柔和自然光"}],
)
shots = json.loads(plan.choices[0].message.content)["shots"]

for s in shots:
    img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                             prompt=s["prompt"], size=s["size"])
    open(f"{s['scene']}.png", "wb").write(base64.b64decode(img.data[0].b64_json))
Dieser Code läuft seriell ab – die 5 Bilder werden nacheinander abgewartet. Im nächsten Abschnitt wird er auf eine parallele Version umgestellt.
Wie man bei einer gpt-image-2-E-Commerce-Bilderserie einen einheitlichen Stil bewahrt
Das häufigste Problem bei mehreren Aufrufen: Die 5 Bilder sehen aus, als kämen sie aus 5 verschiedenen Shops. Kombiniert man die folgenden Tricks, lässt sich die Konsistenz auf ein kommerziell nutzbares Niveau heben:
- Einheitlicher Style-Block: Fassen Sie Farbton, Licht, Hintergrund und Bildsprache in einen festen Textblock zusammen und hängen Sie ihn an das Ende jeder Bildplanungs-Eingabeaufforderung an. Lassen Sie das Textmodell nicht bei jedem Durchgang die Stilbeschreibung frei improvisieren.
- Festes Produkt-Referenzbild: Übergeben Sie bei jedem Aufruf über die edits-Schnittstelle dasselbe Produktfoto und schreiben Sie in der Eingabeaufforderung ausdrücklich „Farbe, Logo und Struktur des Produkts im Referenzbild unverändert beibehalten“. Das ist das wirksamste Mittel, um das Hauptmotiv konsistent zu halten.
- Feste Parameter: Verwenden Sie für dieselbe Bilderserie dieselbe
quality-Stufe; die Größe ändern Sie nur, wenn nötig (etwa Hochformat für lange Grafiken). - Auswahl über den Parameter n: Für die kritischste Stelle wie das Hauptbild können Sie
n=2odern=3setzen, mehrere Varianten generieren und manuell das beste Bild auswählen. Genau das ist die richtige Verwendung des Parameters n.
🎯 Konsistenztipp: Der Style-Block ist die „Markenrichtlinie“ der gesamten Bilderserie. Es empfiehlt sich, für jeden Shop eine feste Vorlage zu pflegen. Wenn Sie gpt-image-2 über APIYI apiyi.com aufrufen, können Sie den Style-Block in einer Konfigurationsdatei ablegen, die alle SKUs gemeinsam nutzen – bei einem Saisonwechsel aktualisieren Sie ihn einfach zentral.
gpt-image-2 für E-Commerce-Bildsets parallel aufrufen: Tempo und Skalierung
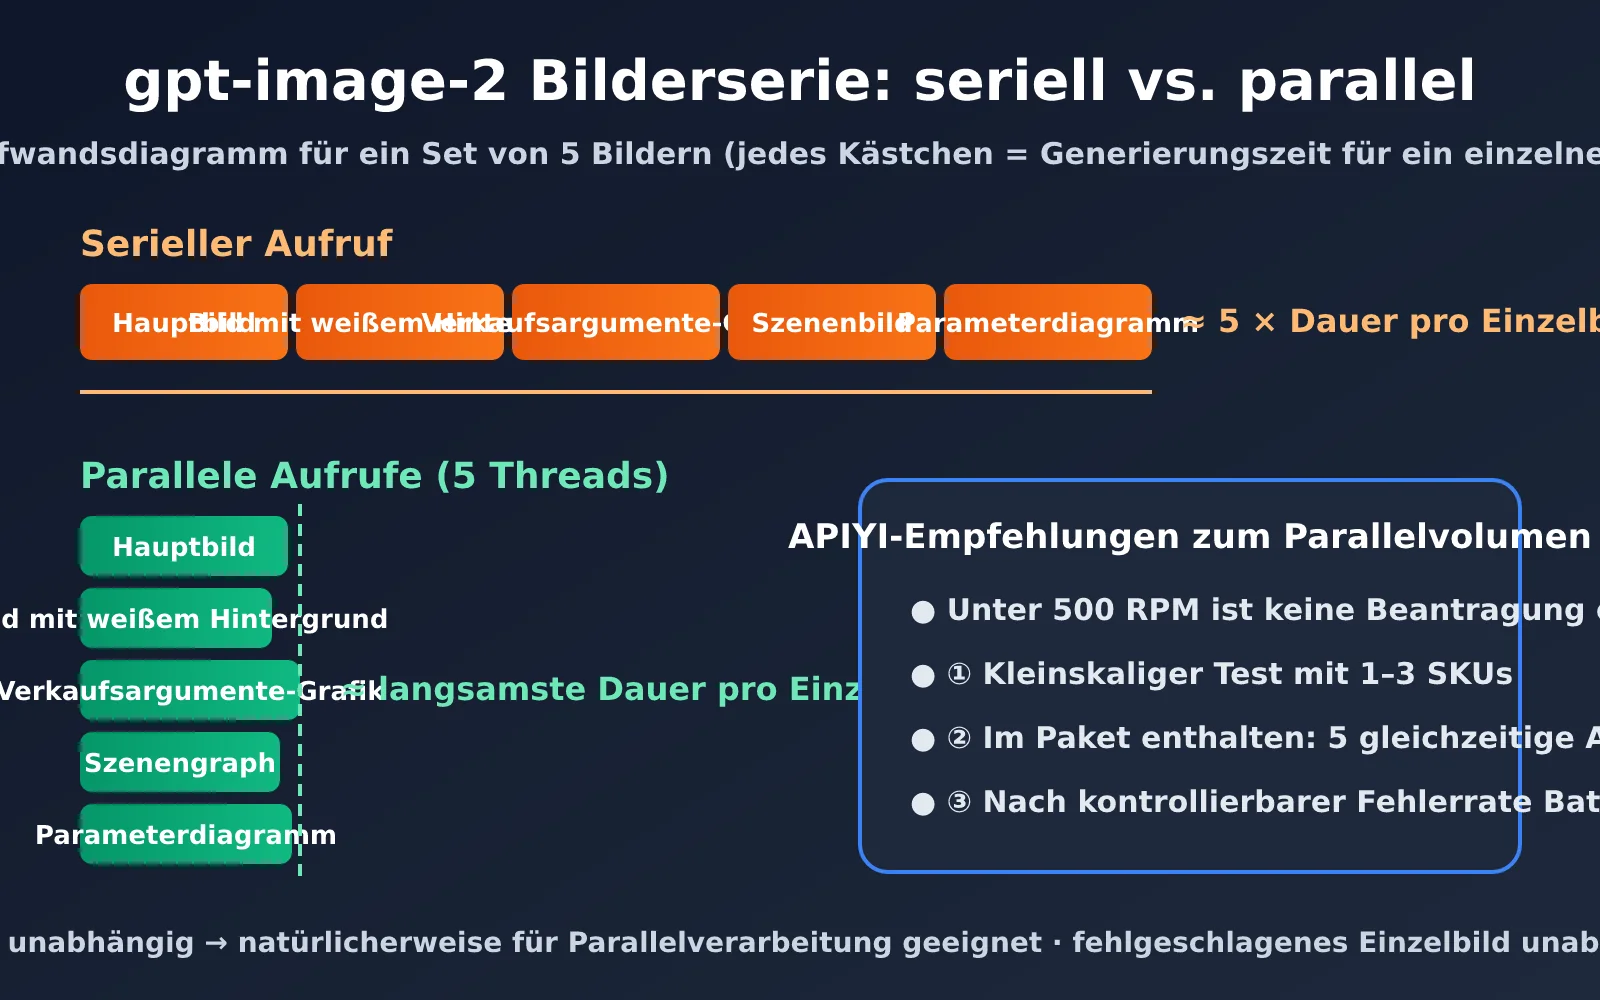
Wenn Sie ein Set aus 5 Bildern seriell erzeugen, entspricht die Wartezeit der Summe der Einzelzeiten. Je mehr Bilder, desto langsamer wird es. Da die einzelnen Shots nicht voneinander abhängen, können Sie sie ohne Weiteres parallel aufrufen. Dann entspricht die Dauer des gesamten Sets in etwa der Dauer des langsamsten Bildes.
APIYI setzt für Aufrufe von gpt-image-2 kein Parallelitätslimit. Unter 500 RPM können Sie direkt arbeiten, ohne zusätzliche Beantragung. Für die meisten Händler ist selbst das gleichzeitige Erzeugen von Bildsets für Dutzende SKUs weit von dieser Größenordnung entfernt.
Paralleler Code für gpt-image-2-Bildsets
Ersetzen Sie die serielle Schleife oben durch einen Thread-Pool, um die Bilder parallel zu erzeugen. Ergänzen Sie außerdem Wiederholungsversuche bei Fehlern, damit ein einzelnes fehlgeschlagenes Bild nicht das ganze Set neu starten lässt:
from concurrent.futures import ThreadPoolExecutor

def gen_one(s, retries=2):
    for i in range(retries + 1):
        try:
            img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                                     prompt=s["prompt"] + STYLE_BLOCK, size=s["size"])
            return s["scene"], img.data[0].b64_json
        except Exception as e:
            if i == retries:
                return s["scene"], None

with ThreadPoolExecutor(max_workers=5) as pool:
    results = dict(pool.map(gen_one, shots))
failed = [k for k, v in results.items() if v is None]
Vollständigen Code anzeigen (inkl. Style-Block, Batch für mehrere SKUs, Nachgenerierung bei Fehlern, Speichern der Ergebnisse)
import json, base64, time
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

STYLE_BLOCK = (
    "。整体风格:北欧简约,米白色背景,柔和自然光,低饱和配色,"
    "保持参考图中产品的颜色、Logo 和结构完全不变,文字使用清晰无衬线中文字体。"
)

PLAN_PROMPT = """你是资深电商视觉策划。根据以下商品信息规划一套 {count} 张的{platform}套图。
商品信息:{product}
输出 JSON:{{"shots": [{{"scene": "...", "purpose": "...", "prompt": "...",
"size": "2048x2048", "text_overlay": "..."}}]}}
要求:每张图承担不同营销任务;prompt 只描述画面内容,不要描述整体风格;
需要文字时把文字原文写进 prompt 并用引号标出。"""


def plan_shots(product: str, platform: str = "淘宝", count: int = 5,
               model: str = "gpt-6.1-sol") -> list:
    """Shots mit einem Textmodell aufteilen; für Batch-Verarbeitung ggf. claude-haiku-5-5 / gemini-3.8-flash verwenden"""
    resp = client.chat.completions.create(
        model=model,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": PLAN_PROMPT.format(
            count=count, platform=platform, product=product)}],
    )
    return json.loads(resp.choices[0].message.content)["shots"]


def gen_one(shot: dict, ref_image: str, retries: int = 2):
    """Einzelbild erzeugen, bei Fehlern mit exponentiellem Backoff wiederholen"""
    for attempt in range(retries + 1):
        try:
            with open(ref_image, "rb") as f:
                img = client.images.edit(
                    model="gpt-image-2",
                    image=f,
                    prompt=shot["prompt"] + STYLE_BLOCK,
                    size=shot.get("size", "2048x2048"),
                )
            return shot["scene"], img.data[0].b64_json
        except Exception as e:
            print(f"[{shot['scene']}] 第 {attempt + 1} 次失败:{e}")
            time.sleep(2 ** attempt)
    return shot["scene"], None


def gen_image_set(sku: str, product: str, ref_image: str, workers: int = 5):
    shots = plan_shots(product)
    out_dir = Path("output") / sku
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / "plan.json").write_text(json.dumps(shots, ensure_ascii=False, indent=2))

    with ThreadPoolExecutor(max_workers=workers) as pool:
        results = dict(pool.map(lambda s: gen_one(s, ref_image), shots))

    # Fehlgeschlagene Einzelbilder einmal nachgenerieren
    failed = [s for s in shots if results.get(s["scene"]) is None]
    for s in failed:
        results[s["scene"]] = gen_one(s, ref_image, retries=3)[1]

    for scene, b64 in results.items():
        if b64:
            (out_dir / f"{scene}.png").write_bytes(base64.b64decode(b64))
    print(f"{sku}: 成功 {sum(1 for v in results.values() if v)}/{len(shots)} 张")


if __name__ == "__main__":
    gen_image_set(
        sku="cup-green-500",
        product="墨绿色 316 不锈钢保温杯,500ml,24 小时保温,一键弹盖",
        ref_image="cup.png",
    )
Drei Phasen für die parallele Skalierung
Auch wenn es kein Parallelitätslimit gibt, empfehlen wir, die Menge schrittweise zu erhöhen. Prüfen Sie zuerst die Ergebnisse und skalieren Sie dann, damit nicht auf einen Schlag Hunderte unbrauchbare Bilder entstehen:
- Kleiner Test: Wählen Sie 1–3 SKUs und lassen Sie sie seriell oder mit niedriger Parallelität durchlaufen. Prüfen Sie manuell, wie genau das Produkt wiedergegeben wird, ob der Text korrekt ist und ob der Stil einheitlich bleibt.
- Mittlere Parallelität: Wenn die Ergebnisse stabil sind, gehen Sie auf 5 parallele Aufrufe pro Bildset und 5–10 SKUs gleichzeitig. Beobachten Sie Fehlerquote und durchschnittliche Dauer.
- Große Stückzahlen: Sobald die Fehlerquote kontrollierbar ist, erhöhen Sie die Parallelität entsprechend Ihrem Geschäftsvolumen. Bis 500 RPM können Sie direkt arbeiten.
| Aufrufart | Dauer für ein Set mit 5 Bildern | Stabilität | Geeignete Phase |
|---|---|---|---|
| Serieller Aufruf | ca. 5 × Dauer eines Einzelbilds | Am stabilsten, gut zum Debuggen | Phase zum Testen der Eingabeaufforderungen |
| Parallel innerhalb des Sets (5 Threads) | etwa so lange wie das langsamste Einzelbild | Stabil | Tägliche Neuerscheinungen |
| Mehrere SKUs + parallel im Set | ähnlich wie ein einzelnes Set | Wiederholungsversuche erforderlich | Massen-Updates vor großen Verkaufsaktionen |
🚀 Skalierungsempfehlung: Für konzentrierte Produkt-Updates vor großen Verkaufsaktionen empfehlen wir über APIYI apiyi.com das Vorgehen „mehrere SKUs + parallel im Set“. Unter 500 RPM ist keine Beantragung nötig. Zusammen mit der Nachgenerierung fehlgeschlagener Einzelbilder lassen sich komplette Bildsets für Dutzende SKUs in sehr kurzer Zeit fertigstellen.
gpt-image-2: Welchen Ansatz für E-Commerce-Bildsets wählen?
Die beiden Ansätze schließen sich nicht aus und werden in der Praxis häufig kombiniert. Hier sind Empfehlungen nach gängigen Plattformen und Szenarien:
| Plattform/Szenario | Empfohlener Ansatz | Empfohlene Anzahl | Hinweis |
|---|---|---|---|
| Taobao/Tmall – Hauptbild | Ansatz 2 | 5 Bilder | Je ein Bild für Hauptansicht, weißen Hintergrund, Verkaufsargumente, Szene und Spezifikationen |
| Taobao/Pinduoduo – Detailseite | Ansatz 1 + Ansatz 2 | 3–6 Bilder im Halbseitenformat | Segmentweise erzeugen und anschließend vertikal zusammenfügen |
| Amazon-Listing | Ansatz 2 | 7 Bilder | Das erste Bild muss streng den Vorgaben für weißen Hintergrund entsprechen; die übrigen Bilder dienen Verkaufsargumenten und Szenen |
| Eigener Onlineshop – Produktseite | Ansatz 2 | 4–6 Bilder | Szenenbilder haben mehr Gewicht; die Markenwirkung stärker betonen |
| Xiaohongshu – Empfehlungsbeiträge | Ansatz 2 | 3–6 Bilder | 3:4-Hochformat, überwiegend alltagsnahe Szenen |
| Kampagnenplakat/USP-Übersicht | Ansatz 1 | 1 Bild | Informationen auf einem Bild gebündelt; hohe Verbreitungseffizienz |
Die zentrale Auswahlregel ist einfach: Bilder, die separat ausgespielt und eigenständig präsentiert werden, mit Ansatz 2; Inhalte, die nur auf einer Seite fortlaufend gelesen werden, mit Ansatz 1. Wenn Sie unsicher sind, erzeugen Sie zuerst mit Ansatz 2 das Hauptbild und die Szenenbilder und dann mit Ansatz 1 ein langes USP-Übersichtsbild – das deckt die meisten Fälle ab.
💡 Kombinationstipp: Beide Ansätze nutzen dasselbe gpt-image-2-Modell und denselben API-Schlüssel. Es bietet sich an, beide Abläufe in einem Service zu bündeln und den Ansatz automatisch nach Produkttyp auszuwählen. Händler müssen dann nur ein Produktbild und ein paar Zeilen mit Verkaufsargumenten hochladen.
Häufige Fragen
Lassen sich mit dem n-Parameter von gpt-image-2 direkt komplette E-Commerce-Bildsets erzeugen?
Nein. Die offiziellen gpt-image-2- und 2.5-Serien unterstützen den n-Parameter, und APIYI ebenfalls. Allerdings erzeugt er n Varianten aus derselben Eingabeaufforderung. Bei einem Bildset hat jedes Bild einen anderen Inhalt und benötigt eine eigene Eingabeaufforderung; daher sind mehrere Aufrufe nötig. n eignet sich eher für zentrale Positionen wie das Hauptbild, um die beste Variante auszuwählen.
Was tun, wenn das Produkt auf den erzeugten Bildern unterschiedlich aussieht?
Das ist das häufigste Problem bei Bildsets. Am wirksamsten ist es, bei jedem Aufruf über den edits-Endpunkt dasselbe Produktfoto zu übergeben und in der Eingabeaufforderung ausdrücklich zu schreiben: „Farbe, Logo und Struktur des Produkts im Referenzbild unverändert lassen“. Gleichzeitig sollten Sie die Stilbeschreibung als festen Style-Block beibehalten, damit das Textmodell nicht frei improvisiert. Als Referenzbild eignen sich Produktfotos mit sauberem Hintergrund und gleichmäßiger Beleuchtung am besten.
Wie geht man mit fehlerhaft gerendertem chinesischem Text im Bild um?
gpt-image-2 kann chinesischen Text inzwischen recht gut rendern, doch je mehr Text, desto höher die Fehlerwahrscheinlichkeit. Empfohlen: pro Bild höchstens 2–3 kurze Sätze Text und den Originaltext in der Eingabeaufforderung in Anführungszeichen setzen. Wenn der Text auf einem Bild fehlerhaft ist, erzeugen Sie nur dieses eine Bild neu – nicht das gesamte Set.
Welches Modell ist für die Textzerlegung am wirtschaftlichsten?
Zum Debuggen von Eingabeaufforderungsvorlagen ist gpt-6.1-sol die beste Wahl; die Planungsqualität ist am höchsten. Sobald die Vorlage stabil läuft, können Sie für die Massenabwicklung auf claude-haiku-5-5 oder gemini-3.8-flash wechseln – günstiger und schneller. Dieser Schritt läuft pro Bildset nur einmal und kostet deutlich weniger als die eigentliche Bilderzeugung. Alle drei Modelle lassen sich bei APIYI auf apiyi.com mit demselben API-Schlüssel aufrufen.
Muss für parallele Aufrufe ein Kontingent beantragt werden?
Nein. APIYI setzt für gpt-image-2 keine Obergrenze für die Parallelität. Unter 500 RPM können Sie direkt loslegen. Empfohlen ist, zunächst mit 1–3 SKUs einen kleinen Test durchzuführen und die Parallelität erst nach Bestätigung der Ergebnisse schrittweise zu erhöhen.
Zusammenfassung
Bei der Erstellung von E-Commerce-Bilderserien mit gpt-image-2 kommt es vor allem darauf an, die Eigenheit der Schnittstelle zu verstehen: „Ein Aufruf entspricht einer Eingabeaufforderung“. Der Parameter n löst das Problem der Auswahl des besten Ergebnisses, doch eine Bilderserie erfordert mehrere Aufrufe mit jeweils unterschiedlichen Eingabeaufforderungen. Unter dieser Voraussetzung lassen sich Inhalte für fortlaufendes Lesen wie Detailseiten und Sammlungen der Verkaufsargumente mit dem Einzelbild-Multidimensional-Ansatz in einem Durchgang erzeugen. Bilderserien, deren Bilder einzeln präsentiert werden müssen – etwa Hauptbilder und Szenenbilder –, lassen sich mit einer Pipeline aus Zerlegung durch ein Textmodell + parallelen Aufrufen im Batch-Verfahren abarbeiten.
Der gemeinsame Kern beider Wege ist die Konsistenzkontrolle: ein fester Style-Block plus dasselbe Produktreferenzbild sind der Schlüssel dafür, dass mehrere Bilder so wirken, als stammten sie vom selben Designteam. Bei der Parallelität kann man unterhalb von 500 RPM direkt hochskalieren; am sichersten ist ein dreistufiges Vorgehen: „kleiner Testlauf → mittlere Parallelität → Batch-Skalierung“.
Wir empfehlen, die gesamte Pipeline über APIYI apiyi.com aus einer Hand abzuwickeln: gpt-6.1-sol, claude-haiku-5-5 und gemini-3.8-flash übernehmen die Anforderungszerlegung, gpt-image-2 erzeugt die Bilder – ein einziger API-Schlüssel verbindet alle Schritte, sodass Sie schnell Ihren eigenen Service zur Erzeugung von E-Commerce-Bilderserien aufbauen können.
Autor: APIYI Team | Fokus auf Wissensaustausch rund um KI-Großmodell-APIs. Weitere Tutorials zur Modellintegration finden Sie bei APIYI apiyi.com