作者注:Qwen4-Max 仍处于预览阶段,还没有公开跑分、上下文长度和按 token 单价,这三项无法与 Qwen3.8-Max 硬比;现在能按量调用的仍是 qwen3.8-max。
Qwen4-Max 预览一出来,正在用 Qwen 的开发者最先问的往往是:要不要换?比 Qwen3.8-Max 强多少?贵多少?这些问题现在还给不出 可以对齐的答案,因为预览阶段缺少做比较必需的三项公开信息。
这不是在唱衰 Qwen4-Max。我们不判断它的能力强弱,只说明一个事实:截至 2026-11-12,Qwen4-Max 预览还没有公开跑分、上下文长度和按 token 单价,而 Qwen3.8-Max 已经发布,可以按量调用。按 2026-11-12 API易 apiyi.com 的型号列表,现在能直接接入的是 qwen3.8-max。
核心价值:3 分钟弄清 Qwen4-Max 预览和 Qwen3.8-Max 之间哪些项现在不能比,以及在正式信息公布之前,手上的项目应该怎么安排。
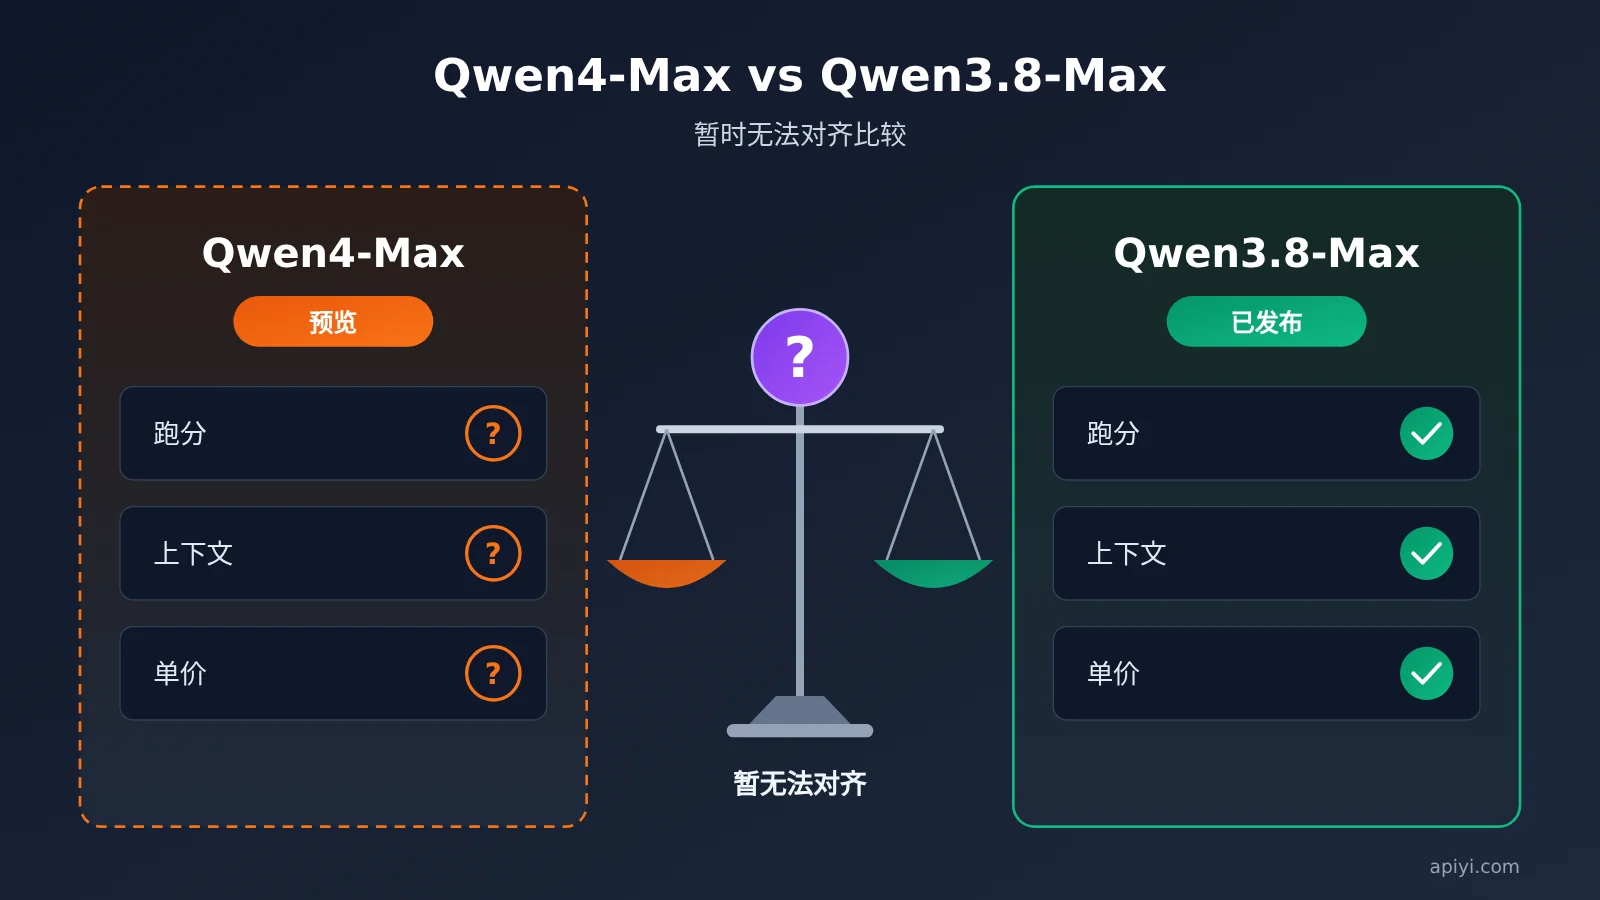
Qwen4-Max 与 Qwen3.8 核心信息速览
先把两边目前能确认的信息放在一起。下表只列参考资料能证实的内容,没有公开的项目直接标为“未公开”,不做推测。
| 信息项 | Qwen4-Max(预览) | Qwen3.8-Max |
|---|---|---|
| 发布状态 | 预览阶段 | 已发布型号 |
| 公开跑分 | 未公开 | 已发布型号,可查阅正式资料 |
| 上下文长度 | 未公开 | 以官方文档和型号说明为准 |
| 按 token 单价 | 未公开 | 输入 $1.65 / 输出 $4.95 / 缓存读 $0.20625(每 1M tokens) |
| 按量调用 | 2026-11-12 的型号列表中暂无 | 可调用,模型 ID qwen3.8-max |
| 可用平台 | 以官方后续公告为准 | API易 等平台 |
表里“未公开”出现了三次,分别是跑分、上下文和单价。这三项正是模型选型时最常用的比较维度,缺任何一项,横向对比都会失去依据。此前已有文章介绍过预览开放的情况,本文只讨论这三项为什么不能硬比。
Qwen4-Max 预览缺失的三项信息分别影响什么
跑分决定能力判断。没有官方公开的基准分数,就没有统一口径去衡量 Qwen4-Max 在推理、代码、长文本等任务上相对 Qwen3.8-Max 的进退。零散的社区截图或个别对话体验,测试集、提示词和采样参数都不一致,不能代替正式跑分。
上下文长度决定架构设计。RAG 的分块大小、对话历史的截断策略、长文档是一次性输入还是分段处理,都依赖确定的上下文上限。这个数字未定,就无法评估迁移后能否省去现有的分段逻辑,也无法判断会不会出现超长报错。
按 token 单价决定成本模型。预算、定价、限流策略都建立在单价之上。预览阶段即使可以体验,也不等于已经有可以写进成本表的价格,拿一个未定的价格和 qwen3.8-max 的现行单价相比,结论没有意义。
Qwen3.8-Max 现在能按量调用的价格与接入方式
既然比较的条件还不具备,手上的项目就以已发布的型号为准。下表是 2026-11-12 型号列表中 qwen3.8-max 的价格,单位为每 1M tokens。
| 计费项 | 单价(每 1M tokens) | 说明 |
|---|---|---|
| 输入 | $1.65 | 未命中缓存的提示词部分 |
| 输出 | $4.95 | 模型生成内容,单价为输入的 3 倍 |
| 缓存读 | $0.20625 | 命中缓存的输入部分,单价为输入的 1/8 |
从结构上看,输出单价是输入的 3 倍,缓存读只要输入的 12.5%。因此控制输出长度、提高缓存命中率,是降低 qwen3.8-max 成本最直接的两个手段。系统提示词较长、多轮对话前缀稳定的场景,缓存带来的收益会更明显。
Qwen3.8-Max 成本估算示例
按上面的单价,可以算出几个典型请求的费用。以下数字都由公开单价直接计算,便于套用到自己的业务量中。
| 场景 | 输入 tokens | 其中缓存命中 | 输出 tokens | 单次费用 |
|---|---|---|---|---|
| 单次常规请求 | 10,000 | 0 | 2,000 | $0.0264 |
| 同样请求、前缀缓存命中 | 10,000 | 8,000 | 2,000 | $0.01485 |
| 批量处理 1M 输入 | 1,000,000 | 0 | 200,000 | $2.64 |
第二行与第一行的输入、输出总量相同,只是 8,000 个输入 tokens 命中了缓存,单次费用就从 $0.0264 降到约 $0.0149,降幅超过四成。这是 Qwen4-Max 预览目前无法提供的计算条件,因为它的单价还没有公布。
如何接入 qwen3.8-max
API易 提供 OpenAI 兼容接口,用 OpenAI SDK 或任何兼容客户端都可以直接接入,只需要修改三个参数:
base_url:https://api.apiyi.com/v1(使用 API易 统一接口)api_key:在 API易 控制台创建的 API Keymodel:qwen3.8-max
调用方式与 Chat Completions 一致,messages 数组按 system、user、assistant 的角色顺序组织即可。如果项目原本对接的是 OpenAI 兼容端点,通常只需要替换 base_url 和模型 ID,业务代码不用改动。
🚀 快速开始:在 API易 apiyi.com 注册即可获得免费测试额度,先用
qwen3.8-max跑通自己的业务提示词,记录真实的输入、输出和缓存命中比例,后续 Qwen4-Max 正式开放时就有现成的对照数据。
Qwen4-Max 预览对现有 Qwen 项目的影响分析
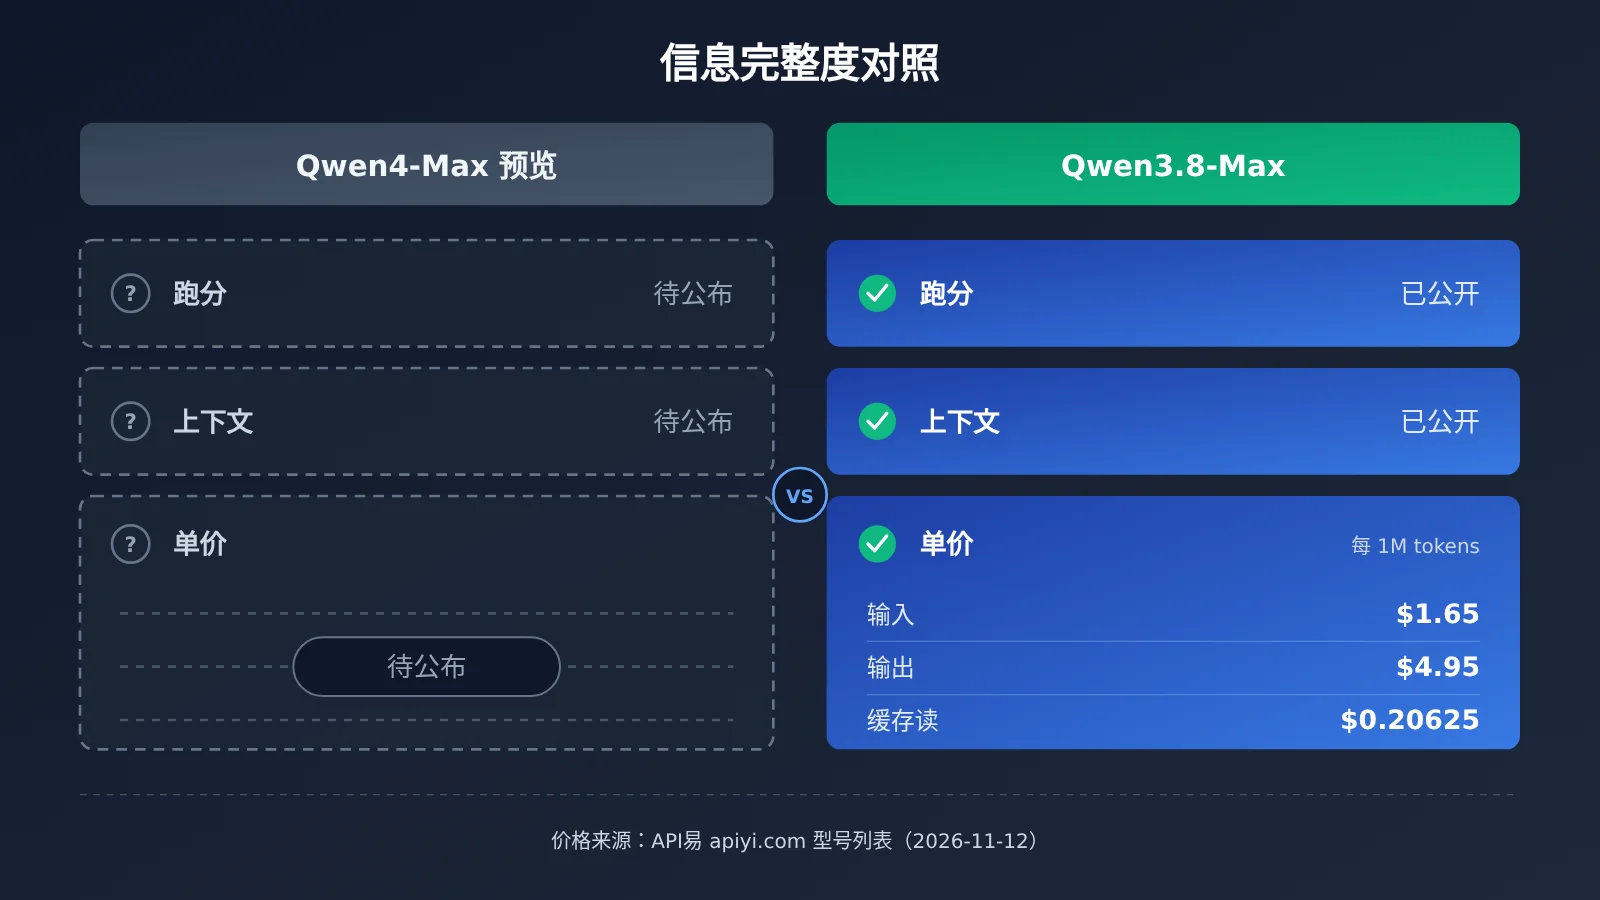
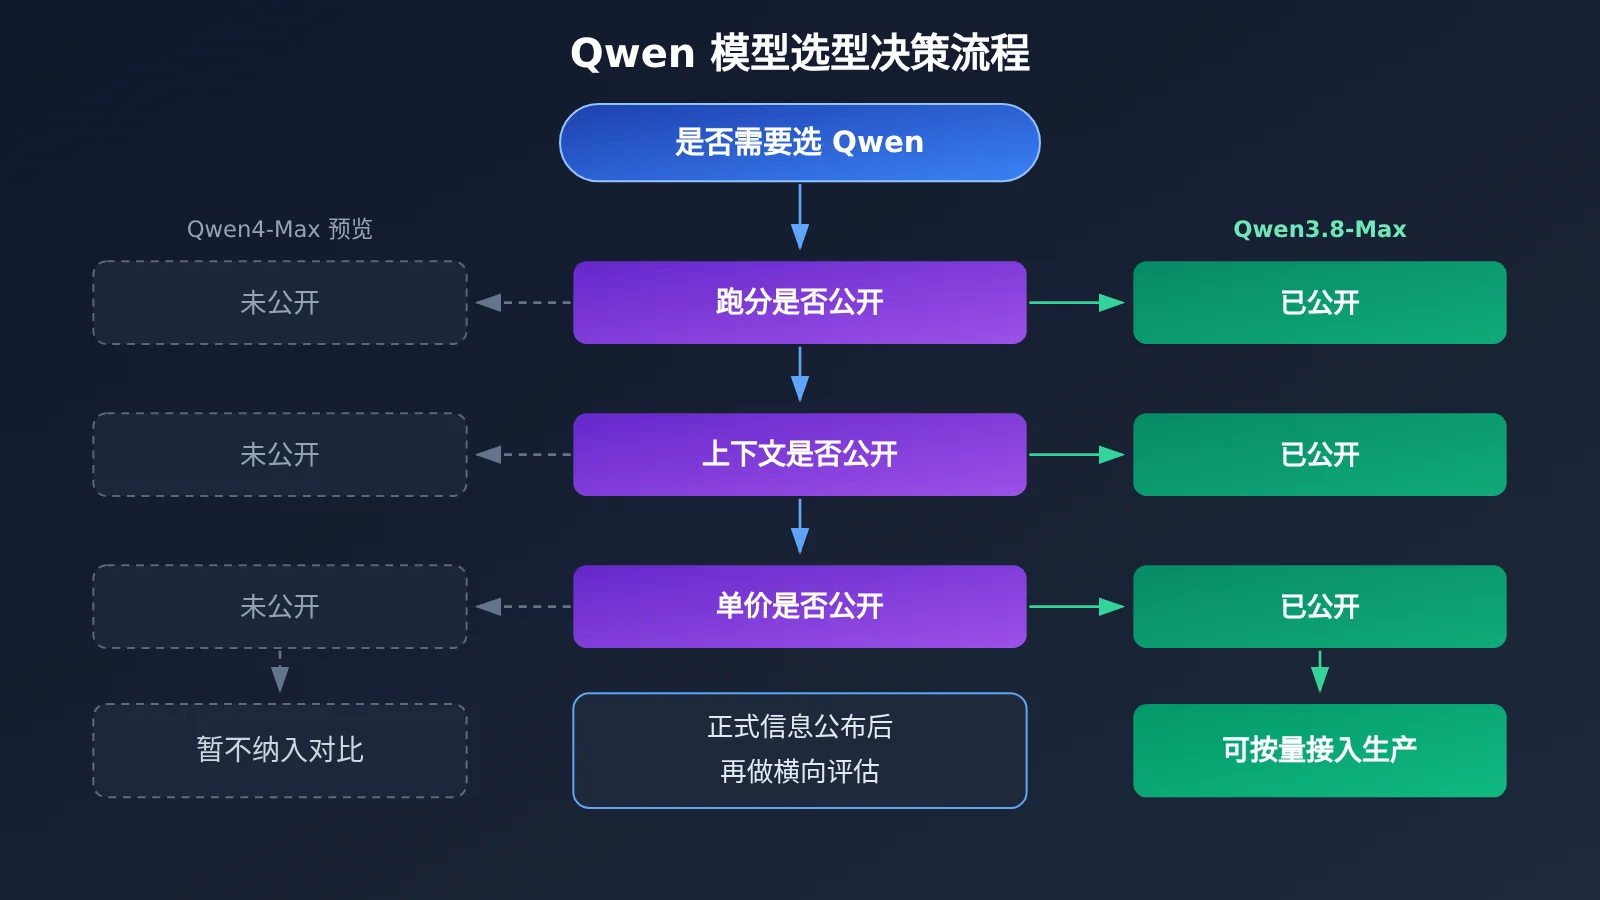
上图把两边的信息完整度放在一起:一边是三个待公布的空位,一边是可以直接查到的数据。在这种状态下做对比,任何“强多少”“贵多少”的结论都缺少依据。价格数据可以在 API易 apiyi.com 的型号列表中核对。
对正在使用 Qwen 的开发者的影响
- 生产环境不需要动:Qwen4-Max 预览不改变 qwen3.8-max 的可用性和价格,现有调用照常进行。
- 评估工作可以先做准备:整理一组代表自己业务的评测提示词和打分标准,正式信息公布后直接拿来对比两个型号。
- 成本预算仍按 qwen3.8-max 编制:预览阶段没有单价,不宜把 Qwen4-Max 写进下一阶段的预算或报价。
- 上下文相关的改造先搁置:在 Qwen4-Max 的上下文长度公布之前,不建议为了它调整分块或截断逻辑。
不同角色的应对建议
| 角色 | 现在可以做的事 | 等正式信息公布后再做的事 |
|---|---|---|
| 应用开发者 | 继续用 qwen3.8-max,沉淀业务评测集 |
用同一评测集对比两个型号 |
| 架构负责人 | 按 qwen3.8-max 的实际上限设计上下文策略 | 根据 Qwen4-Max 上下文长度评估是否简化分块 |
| 成本负责人 | 按输入 $1.65、输出 $4.95 每 1M tokens 编制预算 | 拿到 Qwen4-Max 单价后重算迁移成本 |
| 产品经理 | 对外描述仍以已发布型号能力为准 | 根据公开跑分决定是否宣传升级 |
对模型选型流程的启示
预览版本最容易引发的问题,是把“看起来更新”当成“已经更好”。规范的选型流程至少需要三类公开依据:能力(跑分)、容量(上下文)和成本(单价)。三者齐备之前,新型号适合放进观察清单,不适合放进生产方案。
通过统一接口管理模型调用,还有一个好处:将来 Qwen4-Max 正式开放按量调用时,只需要改动 model 参数就能做 A/B 对比,不必重新对接一套 SDK。
💡 选择建议:在 Qwen4-Max 的三项关键信息公布之前,建议把 qwen3.8-max 作为生产主力。通过 API易 apiyi.com 的统一接口接入,后续新型号上线后可以在同一套代码里快速切换对比。
常见问题 FAQ
Q1:Qwen4-Max 预览现在能和 Qwen3.8-Max 做对比吗?
在跑分、上下文长度和按 token 单价这三项上还不能。Qwen4-Max 仍处于预览阶段,这三项都没有公开,缺少统一口径。能确定的只有发布状态:Qwen3.8-Max 已发布且可以按量调用,Qwen4-Max 还在预览。
Q2:Qwen4-Max 是不是已经全面超过 Qwen3.8-Max?
目前没有公开数据支持这个结论。新一代型号的版本号更大,不代表在所有任务上都更强,也不代表价格更合适。是否超过、在哪些任务上超过,需要等官方公开跑分后再判断,并且最好结合自己的业务评测集验证。
Q3:Qwen3.8-Max 现在的调用价格是多少?
按 2026-11-12 的型号列表,qwen3.8-max 每 1M tokens 输入 $1.65、输出 $4.95、缓存读 $0.20625。缓存读单价只有输入的 1/8,提示词前缀稳定的场景可以明显降低成本。
Q4:如何通过 API 快速调用 Qwen3.8-Max?
推荐使用支持多模型的 API 聚合平台:
1. 访问 API易 apiyi.com 注册账号,获取 API Key 和免费测试额度
2. 将 base_url 设为 `https://api.apiyi.com/v1`
3. 模型 ID 填写 `qwen3.8-max`,按 OpenAI 兼容的 Chat Completions 格式调用
Q5:Qwen4-Max 正式开放后,迁移成本高吗?
接口层面的迁移成本取决于接入方式。如果使用 OpenAI 兼容接口统一管理,通常只需更换模型 ID;真正需要评估的是效果和成本差异。建议现在就在 API易 apiyi.com 上用 qwen3.8-max 沉淀评测数据,到时直接对照。
Q6:预览阶段有哪些需要注意的限制?
预览阶段的关键参数都可能发生变化。跑分未公开,无法判断能力边界;上下文长度未公开,长文本方案无法定型;单价未公开,无法纳入预算。因此不建议把预览型号用于有稳定性和成本要求的生产业务。
Qwen4-Max 与 Qwen3.8 核心要点 Key Takeaways
- 发布状态不同:Qwen4-Max 仍是预览,Qwen3.8-Max 是已发布、可按量调用的型号。
- 三项无法硬比:Qwen4-Max 的跑分、上下文长度和按 token 单价均未公开。
- 不要提前下结论:没有公开数据时,不能断言 Qwen4-Max 全面超过 Qwen3.8-Max。
- 现行价格可查:qwen3.8-max 每 1M tokens 输入 $1.65、输出 $4.95、缓存读 $0.20625。
- 缓存是降本关键:缓存读单价只有输入的 1/8,前缀稳定的场景收益明显。
- 生产以 qwen3.8-max 为准:通过 API易 统一接口接入,后续切换型号只改模型 ID。
总结
Qwen4-Max 预览与 Qwen3.8-Max 的关系,核心要点如下:
- 比较条件尚不具备:Qwen4-Max 预览缺少公开跑分、上下文长度和按 token 单价,三项都不能和 Qwen3.8-Max 硬比。
- 现行可用的是 qwen3.8-max:价格明确,输入 $1.65、输出 $4.95、缓存读 $0.20625(每 1M tokens)。
- 现在做准备,正式公布后再对比:先沉淀业务评测集和成本数据,信息齐备后再做迁移决策。
在 Qwen4-Max 的正式信息公布之前,稳妥的做法是继续用 qwen3.8-max 支撑业务,同时把评测和成本基线准备好。推荐通过 API易 apiyi.com 接入 qwen3.8-max,平台提供 OpenAI 兼容的统一接口和免费测试额度,新型号上线后可以在同一套代码里直接对比。
📚 参考资料
- API易 型号与价格列表:2026-11-12 可调用型号核对
- 链接:
api.apiyi.com/api/pricing -
说明:用于确认当前可按量调用的 Qwen 型号
-
API易 模型文档:qwen3.8-max 计费说明
- 链接:
docs.apiyi.com/models - 说明:包含 qwen3.8-max 输入、输出与缓存读的单价
作者:APIYI 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多模型接入资料可查阅 API易 文档中心