Nota do autor: a OpenAI anunciou a intenção de adquirir a Pierre. Neste artigo, analisamos seus cinco produtos: Trees e Diffs, já usados pelo Codex, além de Highlights, DiffsHub e o serviço pago Code Storage. Você vai descobrir quais componentes de código aberto já pode usar.
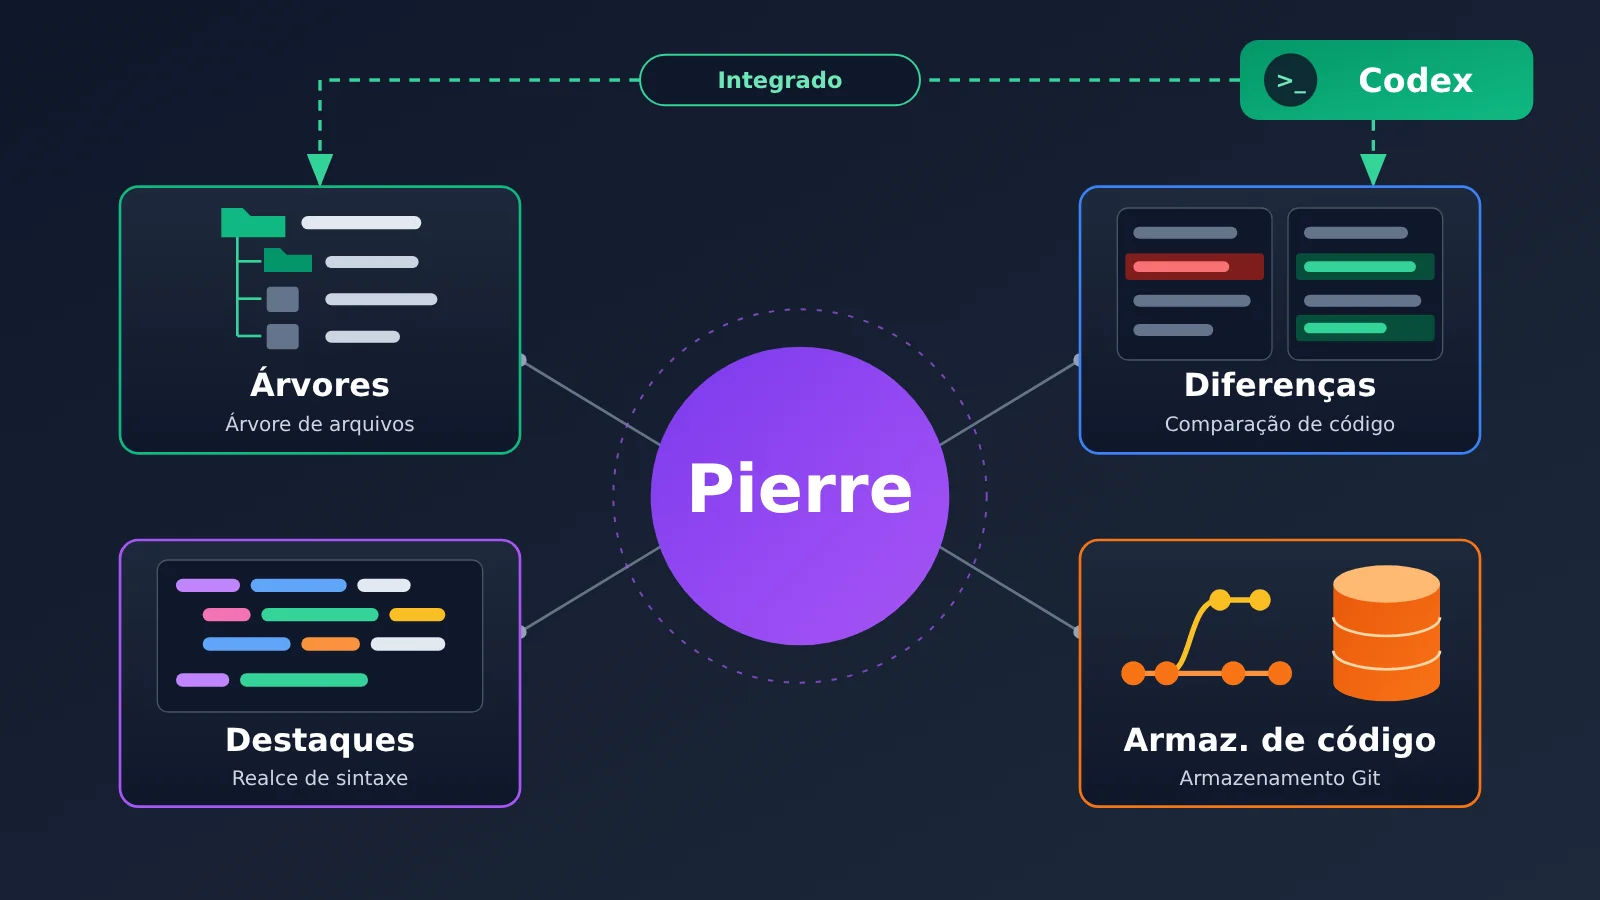
Em 4 de novembro de 2026, a OpenAI anunciou que pretende adquirir a empresa de ferramentas para desenvolvedores Pierre Computer Company. Muita gente pensou logo de cara: “A OpenAI comprou mais uma empresa de hospedagem Git”. Mas não é bem assim. A Pierre tem um conjunto completo de tecnologias que abrange navegação de código, comparação de diferenças, edição online, destaque de sintaxe e armazenamento Git. E dois de seus produtos já funcionam no aplicativo Codex há algum tempo.
Não é um boato nem apenas uma notícia rápida. O anúncio oficial da OpenAI confirma que o Codex usa as bibliotecas Trees e Diffs da Pierre. Os repositórios de código aberto e os pacotes NPM da empresa também estão disponíveis para consulta pública. Vale lembrar que a transação ainda não foi concluída e que o valor da aquisição não foi divulgado.
O que você vai encontrar aqui: um mapa claro dos produtos e das tecnologias da Pierre, com as diferenças entre componentes de código aberto, ferramentas online e serviços pagos de armazenamento — e quais componentes você já pode instalar nos seus projetos.
Principais informações sobre a aquisição da Pierre
Vamos separar os fatos confirmados das informações que ainda não foram divulgadas ou confirmadas. A tabela abaixo inclui apenas o que foi declarado explicitamente no anúncio da OpenAI e nos canais oficiais da Pierre.
| Informação | Confirmado | Não divulgado ou não confirmado |
|---|---|---|
| Status da transação | Aquisição proposta anunciada em 2026-11-04, sujeita às condições habituais de fechamento e à aprovação dos órgãos reguladores | Data de fechamento, valor da aquisição e avaliação da empresa |
| Situação atual do Codex | O aplicativo Codex já usa as bibliotecas Trees e Diffs | Se o código dos usuários do Codex será migrado para o Code Storage |
| Próximos passos | Explorar gradualmente a integração dos recursos do Code Storage ao Codex | Cronograma completo de integração e novos preços |
| Compromisso com código aberto | Os projetos de código aberto da Pierre continuarão abertos, e a OpenAI continuará contribuindo | Planos de manutenção de longo prazo para cada versão |
| Clientes atuais | Os clientes atuais do Code Storage poderão continuar usando o serviço após a transação | Política de preços de longo prazo e planos de migração de dados |
Até o fechamento da transação, as duas empresas continuarão operando de forma independente. A Axios interpreta a negociação como uma expansão do Codex para o campo de colaboração em código, há muito dominado pelo GitHub. Essa, porém, é uma avaliação da imprensa sobre a direção da concorrência: a OpenAI não anunciou uma alternativa completa ao GitHub.
Mapa técnico da Pierre: componentes de código aberto, ferramenta online e armazenamento pago
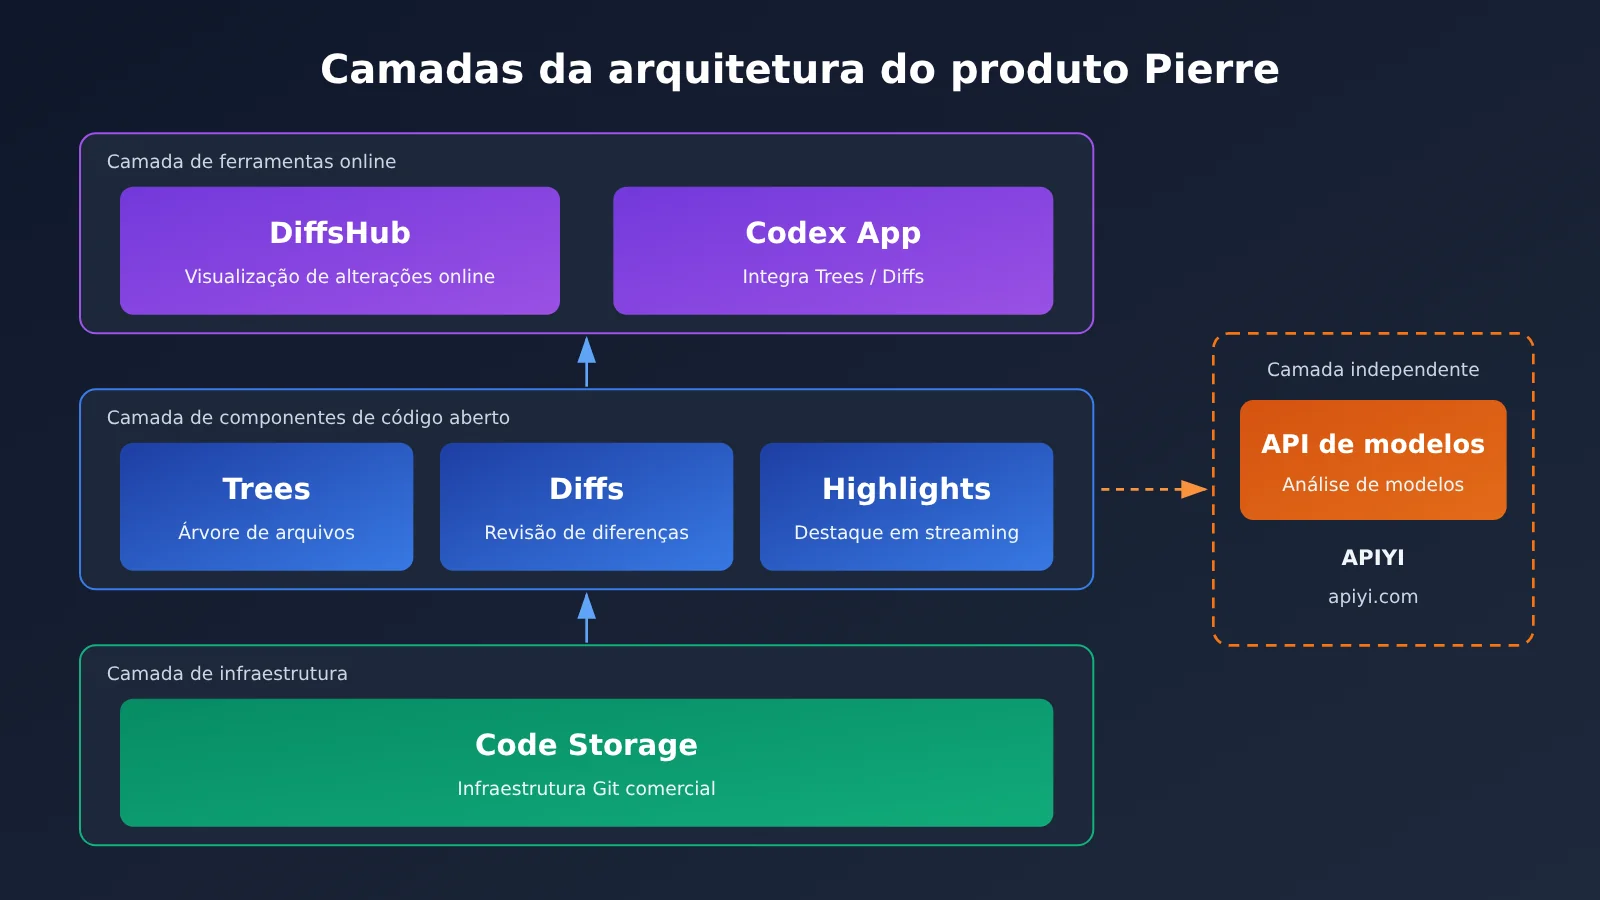
Para entender a Pierre, o primeiro passo é dividir seus produtos em três camadas. A empresa não é especializada no treinamento de Modelos de Linguagem Grande nem vende APIs de modelos. Seu foco são o software e a infraestrutura necessários para exibir, editar, armazenar e gerenciar código. No site oficial, ela se define como uma fornecedora de “infraestrutura de baixo nível e combinável para cargas de trabalho orientadas por máquinas”.
| Produto | Camada | Problema que resolve | Como acessar |
|---|---|---|---|
| Trees | Componente de código aberto | Como navegar pelos arquivos de um projeto | pnpm add @pierre/trees |
| Diffs | Componente de código aberto | Como visualizar, comparar e editar alterações no código | pnpm add @pierre/diffs |
| Highlights | Recurso de destaque de sintaxe (Beta) | Como exibir o destaque de sintaxe rapidamente e em streaming | Consulte a documentação oficial do Diffs |
| DiffsHub | Ferramenta online | Como navegar pelas alterações de código no GitHub pelo navegador | Acesse diffshub.com |
| Code Storage | Serviço comercial | Como armazenar código em larga escala usando Git e API | Cobrança por uso, com consumo mínimo mensal |
A parte de código aberto está concentrada no repositório GitHub pierrecomputer/pierre, sob a licença Apache License 2.0. Em 2026-11-05, o repositório tinha cerca de 6.500 stars, 266 forks e aproximadamente 1.320 commits. Esses números são um retrato de um momento específico e podem mudar. Vale lembrar que esse repositório não contém todo o código do backend comercial do Code Storage.
Pierre Diffs por dentro: Edit Mode, interface de revisão e Merge Conflict
O pacote open source do Diffs é o @pierre/diffs. Na consulta à página oficial, a versão exibida era a v1.6.4, e o ponto de entrada para React era @pierre/diffs/react. Sua função básica é renderizar arquivos de código, patches e diferenças entre duas versões na web. Ele oferece duas visualizações: Split, lado a lado, e Stacked/Unified, com as alterações combinadas verticalmente. Também destaca diferenças por caractere ou palavra dentro das linhas. Os desenvolvedores podem fornecer as duas versões de um arquivo ou passar diretamente um arquivo de patch.
Diffs Edit Mode: edite o código diretamente na visualização de diferenças
A OpenAI destacou esse recurso em seu anúncio: quem está revisando pode editar uma linha de código diretamente na visualização de diff. O Edit Mode oferece seleção e seleção múltipla, indentação automática, desfazer e refazer, busca no arquivo, marcações de lint, ações de edição personalizadas e cursores locais e remotos. A ferramenta disponibiliza o EditProvider e APIs de editor relacionadas. Alguns recursos de edição ainda estão marcados como Beta.
Isso resolve um problema bem específico: no fluxo tradicional, quando você encontra um erro em uma linha gerada por IA, precisa abrir o editor completo, localizar o arquivo, fazer a correção e voltar para a revisão. O Edit Mode reúne a descoberta e a correção do problema na mesma interface. Isso é especialmente útil quando um agente gera muitas alterações e uma pessoa precisa revisá-las por partes.
Interface de revisão de código do Diffs: um framework de anotações extensível
O Diffs oferece um framework flexível de anotações, que permite associar comentários por linha, resultados de verificações de CI, observações de revisão por IA e saídas de ferramentas de terceiros a linhas específicas do código. Os desenvolvedores também podem adicionar botões personalizados, como Accept Change e Reject Change, à visualização de diferenças, além de permitir respostas a comentários e explicações sobre as linhas selecionadas.
Vale deixar claro o limite: o Diffs é um componente de visualização e interação, não um modelo de IA que descobre vulnerabilidades automaticamente. A origem das observações de revisão depende do seu sistema. Você pode, por exemplo, integrar uma API de Modelo de Linguagem Grande para gerar sugestões e depois usar o Diffs para exibi-las.
Diffs Merge Conflict: tratamento estruturado de conflitos
Quando um diff de texto comum encontra um conflito de mesclagem, ele apenas exibe os marcadores do conflito. O Diffs oferece uma interface específica que apresenta a região em conflito como conteúdo adicionado e removido de forma estruturada. A pessoa usuária pode escolher manter a versão atual, aceitar a versão recebida ou manter ambas e, em seguida, visualizar o arquivo com o conflito resolvido.
Na implementação técnica, a documentação oficial informa que a ferramenta é compatível com Vanilla JavaScript e React, usa Shiki para destaque de sintaxe e organiza parte da estrutura de renderização com CSS Grid e Shadow DOM. Ela também oferece ferramentas de SSR, Worker Pool e renderização virtualizada. A virtualização evita que o navegador renderize de uma vez uma grande quantidade de conteúdo que não está visível.
Pierre Trees e Highlights: árvores de arquivos grandes e destaque em streaming
Trees: um componente de árvore de arquivos para grandes repositórios
O pacote open source do Trees é @pierre/trees. Na consulta, a versão exibida oficialmente era a v1.0.0-beta.6. Ele cuida da barra lateral de navegação de arquivos em ferramentas como o Codex e oferece expansão e recolhimento de diretórios, busca e filtragem por nome e caminho, compactação automática de cadeias de diretórios vazios com um único nível, arrastar e soltar arquivos e diretórios, criação e renomeação, além de menus de contexto e ícones personalizáveis.
O recurso mais relevante para programação com IA é a exibição do status do Git. Os arquivos podem receber as marcas M (modificado), A (adicionado e preparado para commit), D (excluído), R (renomeado) e U (não rastreado). Os diretórios que contêm arquivos alterados também podem exibir marcas. Quando um Agent modifica dezenas de arquivos de uma vez, basta uma olhada na árvore para saber onde estão as mudanças.
Em desempenho, o Trees usa virtualização automática e prioriza a renderização apenas das linhas visíveis. O site oficial apresenta uma árvore com 2.956 arquivos totalmente expandida e também demonstra a renderização virtualizada de dezenas de milhares de entradas. São demonstrações oficiais, não benchmarks independentes, e não garantem o mesmo desempenho em todos os dispositivos. Em acessibilidade, o Trees oferece navegação pelas teclas de direção, gerenciamento de foco com Tab e papéis ARIA tree/treeitem, entre outros recursos. Segundo a documentação oficial, o design segue as orientações relevantes da WCAG 2.1.
Highlights: destaque de sintaxe que acompanha a velocidade do Agent
O Highlights aparece atualmente como Beta na documentação oficial do Diffs. Segundo a documentação, ele inclui lexers para 152 linguagens, é baseado em WebAssembly e funciona no navegador, no Node.js e no Cloudflare Workers, gerando HTML ou objetos de token compatíveis com o Shiki.
Suas quatro APIs principais têm funções bem definidas: codeToHtml() processa o código completo; codeToTokens() gera tokens organizados por linha; StreamTokenizer é adequado para receber conteúdo aos poucos e retornar as linhas concluídas; e LiveTokenizer faz atualizações incrementais em documentos durante a edição. Em resumo, o Highlights resolve um problema de exibição: como manter o destaque de sintaxe atualizado enquanto o Agent gera código em streaming. Ele não melhora a capacidade de programação do modelo em si.
DiffsHub: troque github.com por diffshub.com
O DiffsHub é uma ferramenta online da Pierre que mostra o Trees e o Diffs em cenários reais. Ao trocar github.com por diffshub.com em links de Pull Request, Commit, Comparison, Patch ou Diff do GitHub, você pode navegar pelo mesmo conjunto de alterações na interface da Pierre. Os exemplos oficiais incluem repositórios como oven-sh/bun e nodejs/node.
Para acessar um repositório privado, você precisa fornecer seu próprio Personal Access Token do GitHub com as permissões necessárias. O site oficial informa que o token é armazenado no localStorage do navegador; isso não significa que a Pierre possa acessar repositórios privados livremente. O site também alerta que navegadores móveis podem travar ao abrir diffs extremamente grandes. O DiffsHub não substitui o GitHub nem é a própria biblioteca open source Diffs.
O que diferencia o Pierre Code Storage de um repositório GitHub comum
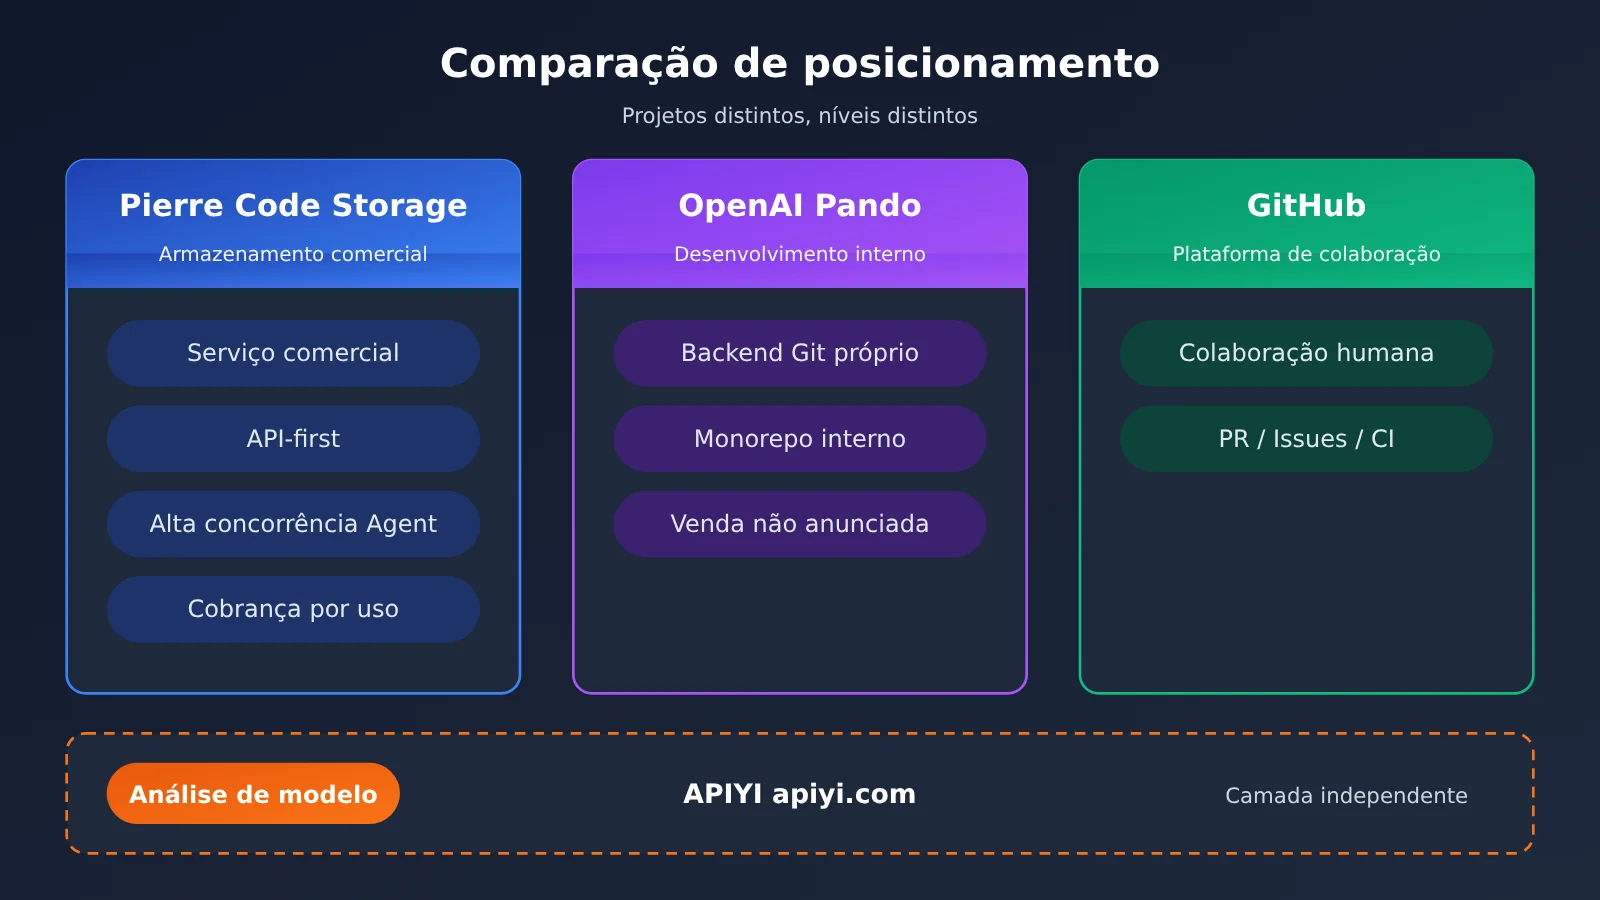
Se Trees e Diffs são a camada de interface para “visualizar código”, o Code Storage é a camada de infraestrutura para “armazenar código” — e também o foco estratégico dessa transação. Trata-se de um serviço de armazenamento distribuído e programável baseado em Git, voltado para produtos de IA que precisam criar, ler, modificar e sincronizar repositórios em grande escala.
O GitHub gira em torno da colaboração entre pessoas: repositórios, PRs, Issues e CI/CD. Já o Code Storage prioriza uma abordagem headless e API-first. Ele permite criar repositórios, commits, branches e merges pela API, gravar e ler arquivos em streaming e filtrar bases de código com Grep e Glob. Também oferece branches temporárias (Ephemeral Branches), Webhooks, Git LFS e sincronização com GitHub, GitLab e Bitbucket. As operações padrão de Git over HTTPS, como clone, push e fetch, também estão disponíveis.
Em uma discussão sobre o Code Storage no Hacker News (66 pontos e 42 comentários), a Pierre deu um exemplo: depois que um agente modifica 10 arquivos, criar um commit pela API REST do GitHub exige obter o SHA da branch, criar branch, blobs, tree e commit e, por fim, atualizar a referência. São cerca de 15 requisições e, sob carga elevada, ainda é preciso lidar com erros 422 causados pela consistência eventual. No Code Storage, seria possível enviar o diff completo com uma única chamada a createCommitFromDiff. Essa é a explicação da empresa na comunidade, não um teste comparativo independente.
| Métrica (dados informados no site oficial) | Valor | Natureza do dado |
|---|---|---|
| Tamanho máximo por repositório | 32TB | Especificação do produto |
| Armazenamento total e número de repositórios | Sem limite geral | Especificação do produto |
| Gravações simultâneas | 30+ | Especificação do produto |
| Requisições Git por repositório | Já foram observadas 500+ por segundo | Dado observado pela empresa, não é um valor garantido |
| Requisições à API | Já foram observadas 15,000+ por segundo | Dado observado pela empresa, não é um valor garantido |
| Disponibilidade | SLA de 99.99% | Compromisso de serviço, não uma taxa histórica verificada de forma independente |
Sobre a arquitetura, a empresa afirma usar um protocolo Git de commit em três fases e uma arquitetura baseada em quorum do tipo “Spoke-like” para garantir consistência e durabilidade em ambientes distribuídos. A topologia completa do cluster, porém, não foi divulgada. Para empresas, também declara conformidade com SOC 2 Type II, suporte relacionado à HIPAA, criptografia por tenant e testes de penetração anuais. Antes da contratação, ainda é importante verificar os relatórios e os termos do contrato.
Os casos de clientes também foram publicados pela própria Pierre. No caso da Lovable, a empresa informa a criação de mais de 8 milhões de repositórios por semana, com pico de 250 repositórios por segundo. A Poke usa Git para armazenar a memória dos agentes e configurações de fluxo de trabalho e informa uma latência de push P95 de 90 milissegundos. Já a Skydive dá a mais de 150 agentes seus próprios repositórios privados, onde ficam definições de identidade, configurações de MCP, Skills e memória persistente. Esses casos apontam para uma tendência: os repositórios Git estão deixando de servir apenas para “armazenar código” e passando também a “armazenar o estado dos agentes”.
Novidades no SDK, CLI e Agent Skills do Pierre
No dia anterior ao anúncio da aquisição, em 3 de novembro de 2026, o Pierre lançou um novo SDK e uma CLI unificados. A maior mudança é que o SDK, a CLI e a API HTTP agora usam nomes consistentes para as operações. Por exemplo, a criação de uma branch aparece nas três interfaces como pierre.repos.branches.create(), pierre repos:branches create e /api/repos/{repo_name}/branches/create. Assim, um agente pode usar o mesmo “catálogo de operações” para alternar entre as interfaces.
# SDK TypeScript (Node.js 22 / 24 / 26)
npm install @pierre/sdk

# SDK Python (Python 3.10+)
pip install pierre-sdk

# SDK Go (Go 1.25+)
go get github.com/pierrecomputer/sdk/go

# CLI
npm install -g @pierre/cli

# Instalar Pierre Skills para agentes de programação
npx skills add pierrecomputer/skills

# Criar uma branch a partir de main usando a CLI
pierre repos:branches create feature/preview --repo-name my-repo --base-ref main
A autenticação usa as variáveis de ambiente PIERRE_ORG e PIERRE_PRIVATE_KEY. Para cada operação, o SDK emite um token com o escopo de permissões adequado e validade de 5 minutos. O novo SDK substitui os antigos @pierre/storage, pierre-storage e code-storage-go, que ainda podem ser usados, mas não receberão novas versões. Vale destacar que esse conjunto de SDK e CLI atende ao Code Storage e não significa que o Codex CLI da OpenAI ganhou novos comandos integrados.
Como funciona a cobrança do Pierre Code Storage
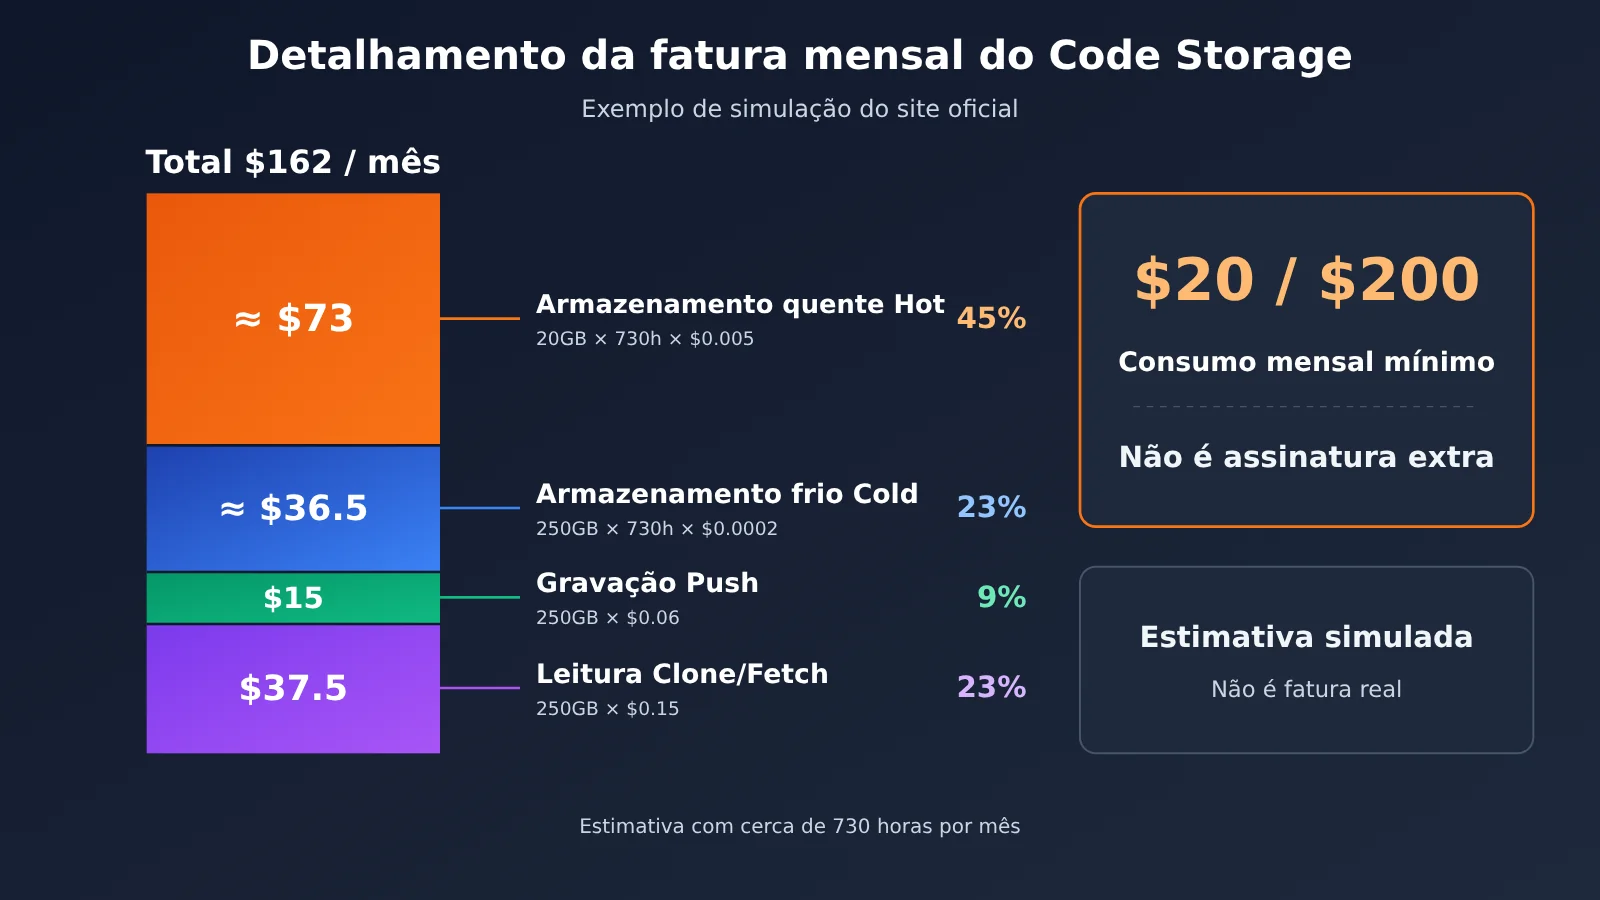
É fácil interpretar os preços do Code Storage de forma equivocada. Os valores de $20/mês no Starter e $200/mês no Scale são consumos mínimos mensais, não mensalidades fixas cobradas além do uso. Ou seja, se um usuário do Starter consumir mais de 20 dólares no mês, pagará pelo uso real; se consumir menos, pagará 20 dólares.
| Item de cobrança | Preço | Descrição |
|---|---|---|
| Starter | Consumo mínimo de $20/mês | Multitenant, suporte por e-mail |
| Scale | Consumo mínimo de $200/mês | Opção single-tenant, SSO, suporte 24/7 |
| Enterprise | Contrato personalizado | Opções de rede como VPC; preço não divulgado |
| Armazenamento quente Hot | $0.005/GB/hora | Dados acessados nos últimos 7 dias |
| Armazenamento frio Cold | $0.0002/GB/hora | Dados sem acesso há mais de 7 dias |
| Gravação Push | $0.06/GB | Cobrança mensal |
| Leitura Clone/Fetch | $0.15/GB | Cobrança mensal |
O exemplo do simulador oficial considera 20GB de armazenamento quente, 250GB de armazenamento frio e 250GB tanto de gravação quanto de leitura, com custo estimado de cerca de $162/mês. Fazendo uma conta aproximada com 730 horas por mês, o armazenamento quente custa cerca de $73, o frio cerca de $36.5, a gravação $15 e a leitura $37.5, totalizando exatamente $162. Como dá para ver, o tráfego de leitura representa uma parcela significativa do custo — um dos motivos pelos quais alguns desenvolvedores no HN criticaram a cobrança pelo tráfego de rede. Esse exemplo é uma estimativa simulada, não uma fatura real, e essa tabela de preços segue um sistema de cobrança completamente diferente da assinatura do Codex e dos preços por token dos modelos da OpenAI.
Primeiros passos com a stack da Pierre: crie um protótipo de revisão com IA usando Diffs
Os componentes da Pierre não oferecem recursos de modelo. Por isso, uma combinação prática é usar git diff para obter as alterações, chamar a API de um Modelo de Linguagem Grande para gerar comentários por linha e passar o resultado ao Diffs como Annotation para renderização. O esquema abaixo é apenas uma sugestão de arquitetura e não significa que a OpenAI tenha lançado uma API integrada para esse fluxo.
| Camada | Produtos representativos | Papel no fluxo de revisão | Plataformas disponíveis |
|---|---|---|---|
| Armazenamento | Code Storage / GitHub | Armazenar repositórios, branches e histórico | Plataforma oficial da Pierre e plataformas de hospedagem Git |
| Modelo | GPT, Claude, Gemini etc. | Ler o Diff e gerar comentários de revisão | APIYI apiyi.com e APIs oficiais dos provedores |
| Interface | Diffs + Trees | Exibir alterações, associar comentários e editar linhas | @pierre/diffs, @pierre/trees |
Este exemplo minimalista precisa de apenas algumas linhas para enviar o diff ao modelo e solicitar uma resposta em JSON:
import subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI
)

diff = subprocess.run(["git", "diff", "HEAD~1"], capture_output=True, text=True).stdout
resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Substitua por qualquer modelo disponível na plataforma
    messages=[{"role": "user", "content": f"逐行审查以下 diff,返回 JSON 列表 [{{file, line, comment}}]:\n{diff}"}]
)
print(resp.choices[0].message.content)
Ver o código completo da implementação (com análise de JSON e tratamento alternativo)
import json
import subprocess
from typing import List, Dict
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是资深代码审查员。只针对 diff 中新增或修改的行给出意见,"
    "严格输出 JSON 数组,每项包含 file、line、severity、comment 四个字段。"
)

def get_diff(base: str = "HEAD~1") -> str:
    result = subprocess.run(
        ["git", "diff", base], capture_output=True, text=True, check=True
    )
    return result.stdout

def review_diff(diff: str, model: str = "gpt-4o-mini") -> List[Dict]:
    if not diff.strip():
        return []
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": diff[:60000]},  # Truncamento simples para evitar conteúdo longo demais
        ],
        temperature=0.2,
    )
    text = resp.choices[0].message.content.strip()
    text = text.removeprefix("```json").removesuffix("```").strip()
    try:
        return json.loads(text)
    except json.JSONDecodeError:
        return [{"file": "", "line": 0, "severity": "info", "comment": text}]

if __name__ == "__main__":
    annotations = review_diff(get_diff())
    # Grava o resultado em um arquivo para o front-end associá-lo às linhas correspondentes com Annotation do @pierre/diffs
    with open("review_annotations.json", "w", encoding="utf-8") as f:
        json.dump(annotations, f, ensure_ascii=False, indent=2)
    print(f"生成 {len(annotations)} 条审查意见")
No front-end, depois de instalar @pierre/diffs, associe os comentários de review_annotations.json à visualização do Diff por arquivo e número de linha. Combine isso com o Edit Mode para que a pessoa responsável pela revisão possa fazer alterações no próprio local. Para os parâmetros específicos dos componentes, consulte a documentação oficial em diffs.com/docs.
🚀 Comece rápido: ao criar esse tipo de protótipo, uma opção para a camada de modelo é usar a APIYI apiyi.com. Com uma única chave, você pode alternar entre modelos como GPT, Claude e Gemini e comparar a qualidade da revisão no seu código. Novos usuários também recebem créditos gratuitos para testes.
Análise do impacto da aquisição da Pierre
Impacto para desenvolvedores
- Componentes de código aberto prontos para uso: Diffs e Trees já estão em produção no Codex, sob a licença Apache-2.0. Eles podem ser usados em barras laterais de assistentes de programação com IA, plataformas internas de revisão ou ambientes de trabalho para agentes. A OpenAI também prometeu continuar disponibilizando-os como código aberto.
- A revisão está se tornando o novo gargalo: a OpenAI revelou que seu número semanal de PRs internos mais que dobrou em comparação com o período anterior do quarto trimestre. Com a geração de código mais rápida, interfaces de revisão que facilitem a visualização e a edição serão essenciais para ganhar eficiência.
- Uma nova abordagem para armazenar o estado dos agentes: os casos de Poke e Skydive mostram que o Git pode armazenar a memória e as configurações de agentes, com histórico e capacidade de reversão integrados.
Impacto para o setor
- O Codex passa a cobrir mais etapas do ciclo de desenvolvimento: da geração e revisão até o armazenamento. Mas, até 2026-11-05, não havia evidências de que a integração com o GitHub seria cancelada.
- Não confunda Pando com Code Storage: o Pando, anunciado pela OpenAI em 2 de novembro, é um backend Git desenvolvido pela própria empresa para dar suporte ao seu monorrepositório interno. Ele e o Code Storage da Pierre são projetos independentes.
- Ainda não há consenso na comunidade: nas discussões no HN, algumas pessoas demonstraram preocupação com arquivamento em armazenamento frio e com as diferenças de posicionamento em relação ao GitHub, enquanto outras criticaram a cobrança por tráfego. Algumas dezenas de comentários não representam toda a comunidade de desenvolvedores, e ainda não há avaliações independentes com amostras grandes.
Perguntas frequentes (FAQ)
Q1: A Pierre é uma empresa de hospedagem Git?
Não exatamente. A Pierre oferece componentes de front-end de código aberto (Diffs e Trees), recursos de destaque de sintaxe (Highlights), uma ferramenta on-line (DiffsHub) e um serviço comercial de armazenamento Git (Code Storage). Descrevê-la apenas como uma plataforma de hospedagem Git deixaria de fora a tecnologia de interface que o Codex já usa.
Q2: A OpenAI já concluiu a aquisição da Pierre?
Não. Em 4 de novembro de 2026, a OpenAI apenas anunciou a intenção de compra. A transação ainda depende de condições habituais de fechamento e aprovação regulatória. O valor e a data de conclusão não foram divulgados, e as duas empresas operam de forma independente até o fechamento.
Q3: Os US$ 20/mês do Code Storage são uma nova cobrança do Codex?
Não. Esse é o consumo mínimo mensal do plano Pierre Code Storage Starter, sem relação com a assinatura do Codex ou com o preço dos tokens do modelo. O anúncio da aquisição também não trouxe nenhum novo preço para os planos do Codex.
Q4: Quais componentes da Pierre posso usar diretamente no meu projeto?
As opções mais diretas são `@pierre/diffs` e `@pierre/trees`. Ambos são pacotes NPM públicos, com suporte a Vanilla JS e React. O Highlights está marcado como Beta na documentação do Diffs, o DiffsHub é uma ferramenta on-line e o Code Storage é pago.
Q5: Como adicionar comentários de revisão por IA à interface do Diffs?
O Diffs cuida apenas da exibição e da interação; você precisa gerar os comentários. Seguindo o exemplo deste artigo, é possível enviar o `git diff` a um Modelo de Linguagem Grande e adicionar os comentários retornados para cada linha como Annotation. Na camada de modelo, você pode fazer a invocação do modelo pela interface compatível com OpenAI da APIYI apiyi.com. Basta alterar o base_url para reutilizar o código existente. Após o cadastro, é possível usar o crédito gratuito para testar o fluxo.
Q6: A APIYI pode se integrar diretamente ao Pierre Code Storage?
No momento, essa integração não existe. A APIYI apiyi.com oferece um serviço de agregação de APIs de Modelos de Linguagem Grande, que corresponde à camada de modelo no fluxo de revisão. Já o Code Storage precisa ser integrado separadamente, usando o SDK ou a CLI oficial da Pierre. Os dois podem ser combinados na arquitetura, mas não são o mesmo produto.
Pierre Trees, Diffs e Code Storage: principais pontos
- Estrutura em três camadas: Pierre reúne componentes de código aberto, ferramentas online e um serviço de armazenamento pago; não é apenas uma plataforma Git.
- Integração já confirmada: o Codex App já usa Trees e Diffs; a integração com o Code Storage ainda está nos planos.
- Destaques do Diffs: edição na própria linha com Edit Mode, interface de revisão com Annotation e tratamento estruturado de conflitos de merge.
- Destaques do Trees: renderização virtualizada de árvores de arquivos grandes e exibição nativa de status do Git, como M/A/D/R/U.
- Posicionamento do Code Storage: infraestrutura Git com foco em API; os dados de desempenho são informados pela própria empresa.
- Preços: $20/$200 são valores mínimos de consumo mensal. A cobrança é baseada em armazenamento e tráfego, sem taxa de assinatura adicional.
- Como começar: instale o componente Diffs e use a APIYI apiyi.com para invocar o modelo e montar um protótipo de revisão.
Resumo
O núcleo técnico da Pierre pode ser resumido em três pontos:
- A camada de interface já foi validada: Trees e Diffs já estão em uso no Codex e são componentes de código aberto que podem ser integrados gratuitamente desde já.
- A camada de armazenamento é o foco estratégico: o Code Storage transforma o Git em uma infraestrutura programável para agentes, mas os dados de escala e desempenho ainda são informados pelo fornecedor.
- É importante distinguir os limites: a aquisição proposta ainda não foi concluída, o Pando não tem relação com o Code Storage e os preços de armazenamento e de modelos seguem sistemas separados.
Se você está criando uma ferramenta de programação com IA ou uma plataforma interna de revisão de código, a abordagem mais prática é montar a interface com @pierre/diffs e @pierre/trees e depois integrar um Modelo de Linguagem Grande para gerar comentários de revisão. Uma opção para validar os resultados rapidamente é usar a APIYI apiyi.com: com uma única interface, você pode comparar o desempenho de vários modelos na sua base de código.
📚 Referências
- Anúncio de aquisição da OpenAI: OpenAI to acquire Pierre Computer Company, Inc.
- Link:
openai.com/index/openai-to-acquire-pierre -
Descrição: fonte primária sobre o status da transação, os componentes já usados pelo Codex e o compromisso com código aberto
-
Site e documentação do Diffs: informações sobre os componentes Diffs, Edit Mode e Highlights
- Link:
diffs.com/docs -
Descrição: inclui exemplos interativos e documentação completa da API
-
Site do Trees: demonstração do componente de árvore de arquivos
- Link:
trees.software -
Descrição: informações sobre status do Git, virtualização e acessibilidade
-
Preços do Code Storage: critérios oficiais de cobrança e simulador de preços
- Link:
code.storage/pricing -
Descrição: detalhes do consumo mínimo mensal e da cobrança por uso
-
Notas de lançamento do Pierre SDK and CLI: atualização de 2026-11-03
- Link:
code.storage/changelog/pierre-sdk-and-cli -
Descrição: comandos de instalação, requisitos de ambiente e nomenclatura unificada
-
Repositório de código aberto do Pierre: código aberto sob a licença Apache-2.0
- Link:
github.com/pierrecomputer/pierre -
Descrição: código-fonte dos componentes e atualizações da comunidade
-
Scaling Git at OpenAI: apresentação do Pando, desenvolvido pela OpenAI
- Link:
openai.com/index/scaling-git-at-openai - Descrição: ajuda a distinguir o Pando do Code Storage
Autor: equipe técnica da APIYI
Troca de experiências técnicas: para comparar diferentes Modelos de Linguagem Grande em projetos de revisão de código com IA, acesse APIYI em apiyi.com, obtenha créditos para testes e converse com nossa equipe.