작성자 노트: 이 글은 APIYI에서 두 가지 프로토콜로 Gemini 4 Neon에 첫 요청을 보내는 방법과, 요청이 성공한 뒤 어떤 필드와 로그를 확인해야 하는지 설명합니다.
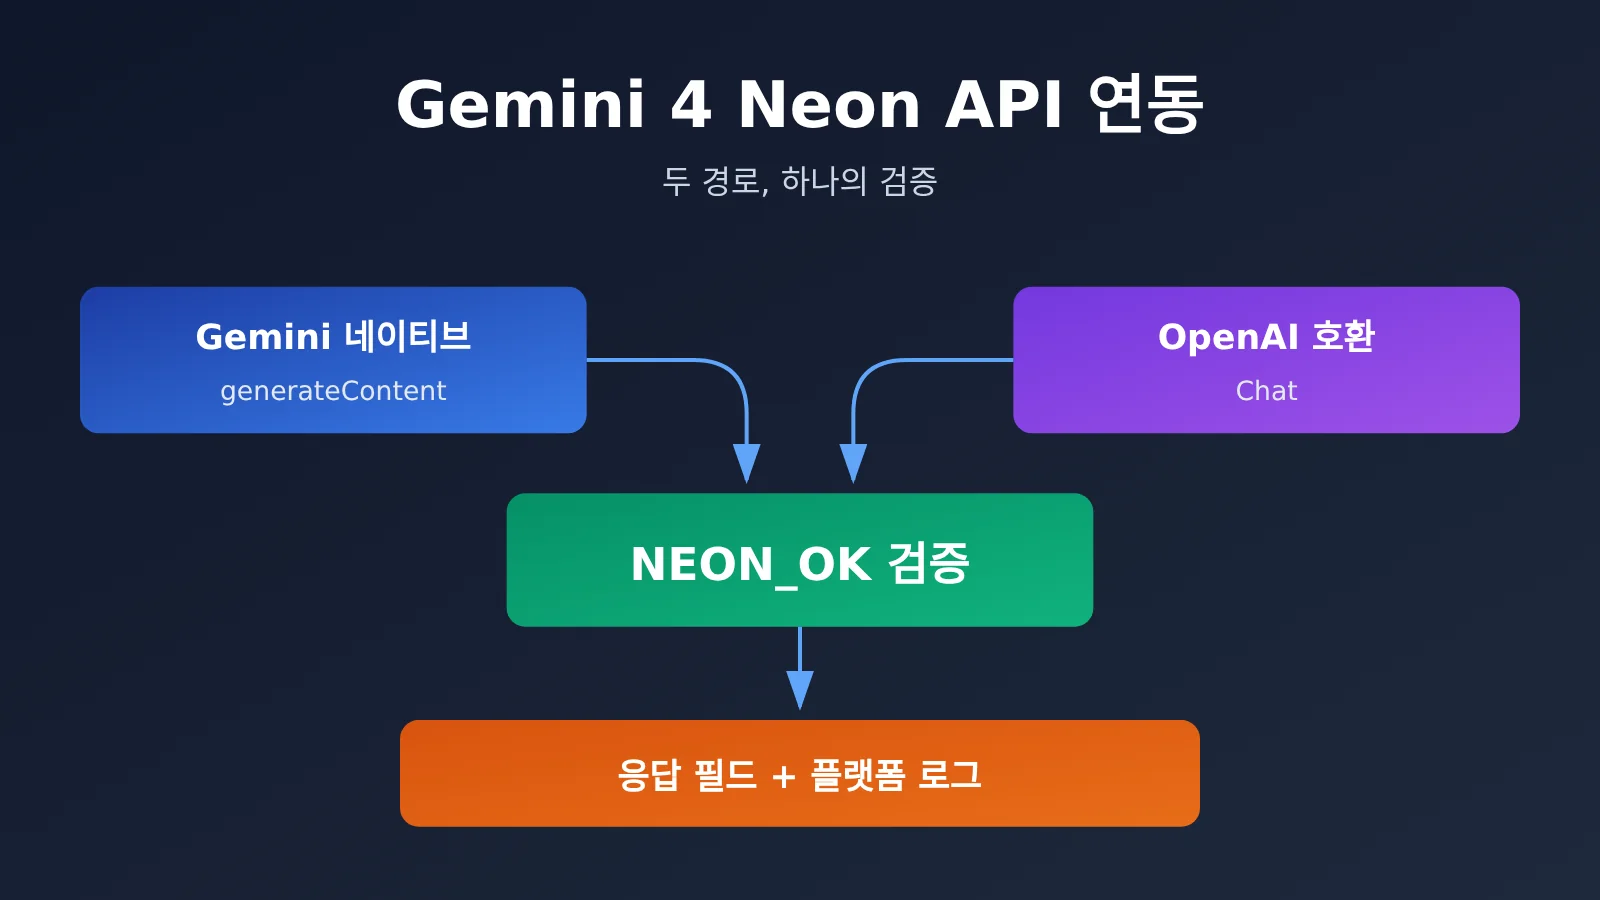
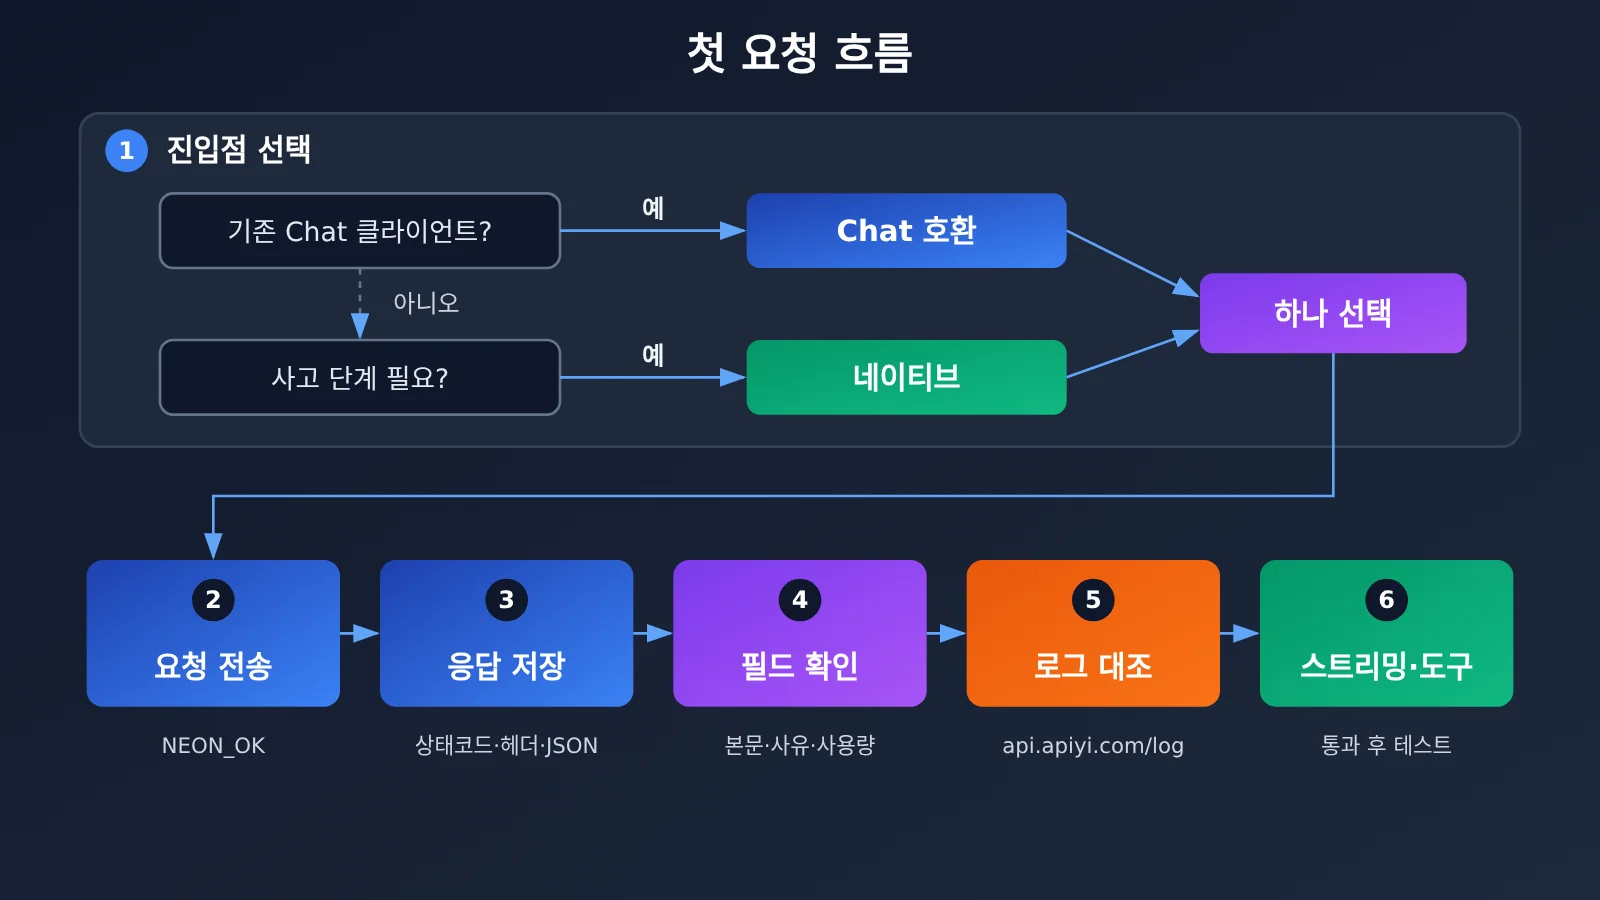
결론부터 말하면: 프로젝트에 이미 OpenAI Chat 클라이언트가 있다면 OpenAI 호환 Chat Completions 엔드포인트를 사용하면 되고, base_url과 모델 이름만 바꾸면 됩니다. Gemini의 사고 레벨을 명시적으로 설정해야 한다면 Gemini 네이티브 generateContent 엔드포인트를 사용해 generationConfig.thinkingConfig.thinkingLevel에서 지정하면 됩니다. 어느 쪽을 선택하든 먼저 같은 짧은 프롬프트로 일반 텍스트 요청을 끝까지 실행해 보고, 그다음 HTTP 상태, 응답 본문, 종료 이유, 사용량, 플랫폼 로그를 기준으로 검수하세요. 검수가 통과한 뒤에 스트리밍 출력, 도구 호출 같은 기능을 테스트하면 됩니다.
배경 정보는 다음과 같습니다. Google은 2026년 11월 18일 AI Studio 업데이트 노트에서 Gemini 4 Neon을 공개하고 GA를 선언했습니다. APIYI는 베이징 시간 2026-11-20 11:45에 해당 모델이 목록에 등록된 것을 확인했고, 공개 가격표에서 gemini-4-neon을 확인할 수 있으며 사용 가능한 그룹은 default와 svip입니다. 이 글의 예시는 모두 APIYI 문서와 SDK 문서에 맞춰 작성했으며, 과금되는 엔드포인트를 호출하지 않았고 본문에도 실측 통계는 전혀 없습니다.
Gemini 4 Neon API 연동 지식 맵과 인덱스
전체 연동 과정은 세 단계로 나뉘어요: 인터페이스 선택, 요청 전송, 출력과 로그 확인. 각 단계의 산출물은 다음 단계의 입력이 되죠. 아래 표는 이 세 단계의 선후 관계, 이렇게 배치한 이유, 각 단계에서 달성해야 할 목표를 한데 모은 것으로, 지식 맵으로도 읽기 인덱스로도 활용할 수 있어요.
| 번호 | 단계 | 이전 단계에서 제공하는 것 | 이렇게 배치한 이유 | 이 단계의 목표 |
|---|---|---|---|---|
| 1 | 진입점 선택 (1.1 Chat 호환 / 1.2 네이티브와 사고 단계) | 현재 사용 중인 코드 스택과 사고 단계에 대한 요구 | 진입점이 URL, 인증 방식, 필드 구조를 결정하며 이후 모든 단계가 여기에 달려 있음 | 하나의 프로토콜을 확정하고, 두 경로에서 동시에 문제를 찾지 않음 |
| 2 | 동일한 짧은 요청 전송 (2.1 네이티브 cURL / 2.2 Python SDK) | 확정된 진입점과 요청 형식 | 고정된 짧은 프롬프트를 쓰면 모델 능력의 차이를 배제하고 링크가 정상인지만 검증할 수 있음 | 완전한 상태 코드, 응답 헤더, 응답 본문 확보 |
| 3 | 검증 (3.1 필드 / 3.2 신원과 로그 / 3.3 실패 증거 보존) | 2단계에서 저장한 원본 응답 | 먼저 응답 자체를 보고, 그다음 플랫폼 로그와 대조하며, 증거를 가까운 것부터 먼 것 순으로 확인 | “텍스트 성공”이 성립하는지 판단; 성립하지 않으면 추적 가능한 증거를 남김 |
읽기 가이드: 한 가지 프로토콜만 사용하는 독자는 1절에서 해당 소절을 읽은 뒤 2.1 또는 2.2 중 하나만 보면 되고, 3절은 전체를 읽어야 해요.
To Know: Gemini 4 Neon API 필수 용어
| 용어 | 간단한 설명 |
|---|---|
generateContent |
Gemini 네이티브의 비스트리밍 생성 인터페이스, 요청 본문에서 contents와 parts로 내용을 구성 |
thinkingLevel |
네이티브 인터페이스의 generationConfig.thinkingConfig 아래 사고 단계 필드, 이 글의 예시에서는 high 사용 |
| thought part | 네이티브 응답에서 사고 내용으로 표시된 part, 본문을 이어붙일 때 제외해야 함 |
finishReason / finish_reason |
네이티브와 호환 인터페이스 각각의 중지 이유 필드 |
X-Shellapi-Request-Id |
APIYI가 원본 응답 헤더나 오류 메시지에서 반환하는 요청 식별자, 문제 해결에 사용 |
1 Gemini 4 Neon API 접속 엔드포인트 선택
두 엔드포인트는 같은 모델을 가리키지만, 차이는 프로토콜 형태와 제어할 수 있는 파라미터에 있어요. 아래에 비교표를 먼저 제시하고, 이어서 두 개의 소절로 선택 이유를 설명할게요.
| 비교 항목 | OpenAI 호환 Chat | Gemini 네이티브 |
|---|---|---|
| 주소 | https://api.apiyi.com/v1 + Chat Completions |
https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent |
| 적합한 대상 | 이미 OpenAI SDK나 Chat 클라이언트를 쓰는 프로젝트 | Gemini 파라미터를 명시적으로 제어해야 하는 프로젝트 |
| 사고 레벨 | 이 글에서는 관련 파라미터를 전달하지 않음 | thinkingConfig.thinkingLevel |
| 본문 위치 | choices[0].message.content |
candidates[0].content.parts 중 thought가 아닌 text |
| 모델 식별자 | 응답의 model |
응답의 modelVersion(반환되는 경우) |
1.1 Gemini 4 Neon 호환 엔드포인트: 기존 Chat 클라이언트 그대로 사용
이미 있는 코드가 OpenAI Python SDK나 다른 Chat Completions 클라이언트를 기반으로 한다면, 변경을 가장 적게 하는 방법은 base_url을 https://api.apiyi.com/v1로 바꾸고 모델 이름을 gemini-4-neon으로 적는 거예요. 메시지 구조는 그대로 두면 돼요. 이렇게 하면 비즈니스 로직 코드를 거의 손대지 않아도 되고, 문제가 생겼을 때 네트워크인지, 인증인지, 모델인지 판단하기도 비교적 쉬워요.
이 경로를 쓸 때는 몇 가지 경계를 분명히 해둬야 해요. 첫째, reasoning_effort를 전달하지 마세요. Google 자체 호환 레이어에서는 이 값에 매핑이 있지만, APIYI의 호환 엔드포인트도 같은 걸 보장한다는 뜻은 아니에요. 둘째, 이 글에서는 /v1/responses 인터페이스를 사용하지 않아요. 셋째, 예전의 thinkingBudget 표기와 minimal 레벨도 이 글의 범위가 아니에요. 사고 레벨을 정말로 제어해야 한다면 1.2의 네이티브 엔드포인트로 가야 해요.
1.2 Gemini 4 Neon 네이티브 엔드포인트: 사고 레벨을 명시적으로 설정
네이티브 엔드포인트는 Gemini 자체의 요청 구조를 사용해요. 사고 레벨은 generationConfig.thinkingConfig.thinkingLevel로 명시적으로 전달하며, APIYI 전용 사용 사례에서 쓰는 값은 "high"예요. 네이티브 응답은 사고 내용과 본문을 서로 다른 part로 나눠서 반환하기 때문에, 본문을 읽을 때는 직접 필터링해야 해요. 구체적인 작성 방법은 2.1절에서 다룰게요.
인증과 관련해서 이 네이티브 사용 사례는 Authorization: Bearer 요청 헤더를 쓰고, Gemini 공식 문서에서 흔히 보이는 key 파라미터 방식은 사용하지 않아요. 기존 네이티브 코드를 마이그레이션할 때는 이 부분을 먼저 확인해야 해요.
2 Gemini 4 Neon API에 동일한 짧은 요청 보내기
두 프로토콜은 동일한 프롬프트를 사용해요: Reply with exactly NEON_OK and nothing else. 이 프롬프트는 예상 출력이 짧아서 결과를 판단하기도 쉬워요. 반환값이 NEON_OK가 아니면 연결 경로나 파싱 단계에 문제가 있다는 뜻이라, “모델마다 답변 스타일이 다르다” 같은 변수를 배제할 수 있죠. API 키는 항상 환경 변수 APIYI_API_KEY에서 읽고, 코드나 명령 기록에는 직접 쓰지 마세요.
2.1 Gemini 4 Neon 네이티브 cURL과 JSON 값 추출
아래 명령은 HTTP 상태 코드, 응답 헤더, JSON 응답 본문을 각각 저장해요. 3절 검증에서 이 세 가지를 모두 사용할 거예요.
curl -sS -X POST "https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "Authorization: Bearer ${APIYI_API_KEY}" \
  -H "Content-Type: application/json" \
  -D neon_native_headers.txt \
  -o neon_native_body.json \
  -w "%{http_code}\n" \
  -d '{
    "contents": [
      {"role": "user", "parts": [{"text": "Reply with exactly NEON_OK and nothing else."}]}
    ],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "high"}
    }
  }' > neon_native_status.txt
본문을 읽을 때는 candidates[0].content.parts 안에서 thought가 아닌 모든 text를 이어 붙여야 하고, 첫 번째 part만 가져오면 안 돼요. 아래 예시는 jq로 처리하지만, jq가 설치되어 있지 않다면 다른 JSON 파싱 도구로 바꿔도 됩니다:
# 본문: thought가 아닌 text를 이어 붙이기
jq -r '[.candidates[0].content.parts[]? | select(.thought != true) | .text // empty] | join("")' neon_native_body.json

# 종료 이유, 사용량, 모델 버전(필드가 없으면 null 출력, 직접 값 보충 금지)
jq '{finishReason: .candidates[0].finishReason, usageMetadata, modelVersion}' neon_native_body.json

# 플랫폼 요청 식별자
grep -i "x-shellapi-request-id" neon_native_headers.txt
2.2 Gemini 4 Neon의 Python OpenAI SDK 호출과 응답 읽기
OpenAI 호환 엔드포인트에서는 with_raw_response를 사용해서 파싱된 객체와 원본 응답 헤더를 모두 얻을 수 있어요. max_retries=0은 SDK의 자동 재시도를 끄는 설정으로, 한 번의 실패가 재시도에 가려지지 않게 하고 플랫폼에 여러 로그가 남아 어느 요청인지 맞추기 어려운 상황을 막아줍니다.
import os
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # APIYI OpenAI 호환 엔드포인트
    max_retries=0,
    timeout=120.0,
)

try:
    raw = client.chat.completions.with_raw_response.create(
        model="gemini-4-neon",
        messages=[{"role": "user", "content": "Reply with exactly NEON_OK and nothing else."}],
        max_tokens=4096,
    )
    print("HTTP:", raw.status_code)
    print("X-Shellapi-Request-Id:", raw.headers.get("x-shellapi-request-id"))

    completion = raw.parse()
    if not completion.choices:
        print("choices 为空,不读取正文")
    else:
        choice = completion.choices[0]
        print("content:", choice.message.content)
        print("finish_reason:", choice.finish_reason)
    print("usage:", completion.usage)
    print("model:", completion.model)

except APIStatusError as e:
    print("HTTP:", e.status_code)
    print("X-Shellapi-Request-Id:", e.response.headers.get("x-shellapi-request-id"))
    print("error:", e.message)  # 기록 전에 키 등 민감 정보가 없는지 확인
except APIConnectionError as e:
    print("未拿到 HTTP 响应:", type(e).__name__)
이 코드에서 특히 주의할 점이 하나 있어요. choices가 비어 있을 때 choices[0]을 바로 쓰면 인덱스 오류가 발생해 진짜 문제를 가려버려요. 연결 오류는 HTTP 상태 코드도 응답 헤더도 없으므로 APIStatusError와 따로 처리해야 해요.
3 Gemini 4 Neon API 첫 요청 검증
검증의 목표는 “순수 텍스트 요청이 성공했다”는 사실이 성립하는지 판단하는 것이에요. HTTP 2xx이고 본문이 예상한 NEON_OK라면, 이번 텍스트 요청 하나가 성공했다는 것만 알 수 있어요. 이것만으로 모델 정체성을 증명할 수 없고, 성능 테스트 결과로 삼을 수도 없어요.
3.1 HTTP 상태, 본문, 종료 이유, 사용량
| 검사 항목 | 네이티브 필드 | 호환 필드 | 통과 조건 |
|---|---|---|---|
| HTTP 상태 | 저장된 status | raw.status_code |
2xx |
| 본문 | thought가 아닌 text 연결 |
choices[0].message.content |
NEON_OK와 같음 |
| 종료 이유 | candidates[0].finishReason |
choices[0].finish_reason |
기록됨, 본문 상황과 일치 |
| 사용량 | usageMetadata |
usage |
기록됨, 로그와 대조하는 데 사용 |
응답에 어떤 필드가 없으면 “반환되지 않음”으로 기록하고, 경험에 기대어 값을 추론하지 마세요. 종료 이유는 본문과 함께 봐야 해요. 본문이 비어 있는데 종료 이유가 정상 종료가 아니라면, 문제는 보통 파싱 코드가 아니라 생성 과정에 있어요.
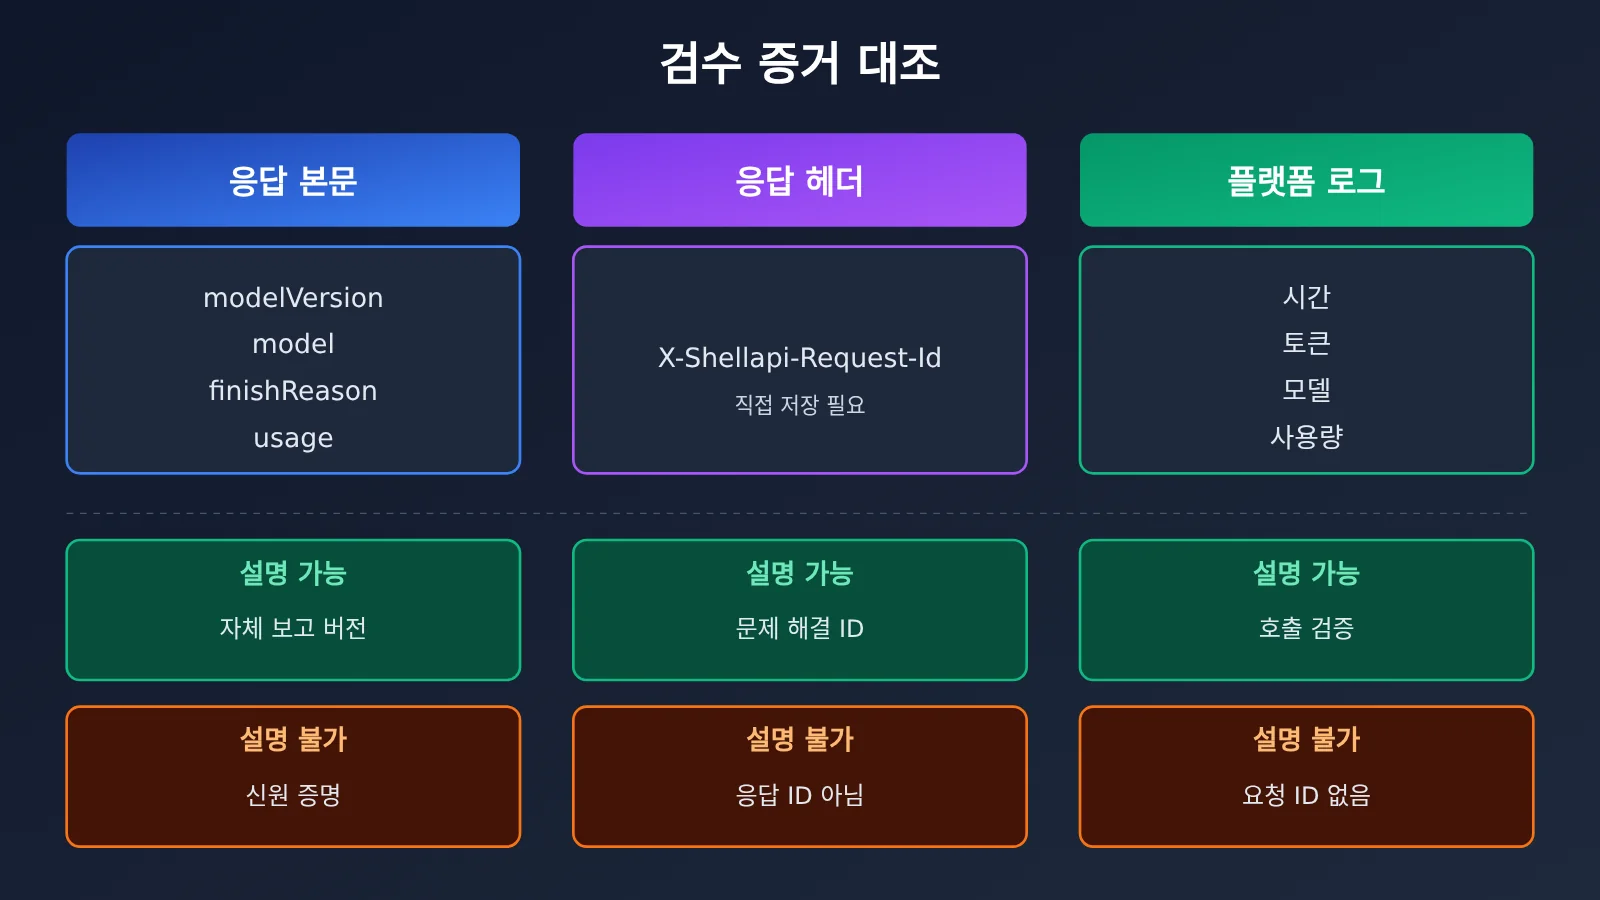
3.2 네이티브 modelVersion, 호환 model, 로그가 각각 무엇을 증명할 수 있을까
이 항목들은 각각 증명할 수 있는 범위가 달라서, 기록할 때 서로를 대체하지 않도록 해요.
| 정보 | 출처 | 증명할 수 있는 것 | 증명할 수 없는 것 |
|---|---|---|---|
modelVersion |
네이티브 응답 본문(반환되는 경우) | 응답이 자체적으로 밝힌 모델 버전 | 단독으로 모델 신원 증명으로 쓸 수는 없음 |
model |
호환 응답 본문 | 응답이 자체적으로 밝힌 모델명 | 위와 같음 |
| 플랫폼 로그 | api.apiyi.com/log |
시간, 토큰, 모델, 사용량 기준으로 이번 호출을 대조 | 콘솔에 요청 ID가 표시되지 않음 |
X-Shellapi-Request-Id |
원본 응답 헤더 또는 오류 메시지 | 플랫폼 장애 대응 시 사용하는 요청 식별자 | responseId, Chat id, SDK의 _request_id와는 다름 |
로그를 대조할 때는 요청을 보낸 시각, 사용한 토큰, 모델명 gemini-4-neon, 사용량 숫자를 가지고 맞춰 봐요. 콘솔에는 요청 ID가 표시되지 않기 때문에 X-Shellapi-Request-Id는 반드시 응답 헤더에서 직접 저장해 둬야 하고, 나중에 콘솔에서는 조회할 수 없어요.
3.3 Gemini 4 Neon 본문이 없거나 요청이 실패했을 때 증거를 남기는 방법
요청이 실패했거나 본문이 없을 때는 먼저 재시도하지 말고, 아래 순서대로 증거를 저장하세요:
- HTTP 상태 코드를 저장하세요. 연결 오류라면 예외 유형을 기록하세요.
- 원시 응답 헤더를 저장하고, 여기서
X-Shellapi-Request-Id를 추출하세요. - 원시 응답 본문 또는 오류 정보를 저장하고, API 키 등 민감한 내용은 제거하세요.
- 중지 이유와 사용량(있는 경우), 요청이 발송된 시간, 사용한 토큰 이름, 모델 이름을 기록하세요.
api.apiyi.com/log에서 시간과 토큰을 기준으로 해당 기록을 찾은 뒤, 위 자료를 가지고 플랫폼의 요청 ID 장애 해결 문서를 참고해 처리하세요.
원시 응답에 관해 한 가지 더 주의할 점이 있어요. parts에 thought 내용만 있다면 필터링된 본문은 비어 있을 수밖에 없어요. 이때는 “필터링 후 본문이 비어 있음”이라고 있는 그대로 기록해야 하며, 출력을 얻기 위해 thought 내용을 본문으로 취급해서는 안 돼요.
단일 턴 순수 텍스트가 위 방식으로 검증을 통과한 뒤에, 프로젝트 필요에 따라 스트리밍 출력, 도구 호출 등의 기능을 검증하세요. 기능을 하나 추가할 때마다 “동일한 요청, 원시 응답 저장, 로그 대조” 방법으로 별도 검증하세요. 이 글은 벤치마크 점수와 가격을 다루지 않으며, 관련 정보는 공식 발표와 APIYI 공개 카탈로그를 기준으로 하세요.
참고 자료
- Google AI Studio 변경 로그 (2026-11-18):
aistudio.google.com/docs/changelog - Gemini GenerateContentResponse 구조:
aistudio.google.com/api-reference/generate-content - APIYI Gemini 4 Neon 출시 공지 및 두 프로토콜 예시:
docs.apiyi.com/news/gemini-4-neon-launch.md - APIYI Gemini 응답 처리:
docs.apiyi.com/api-capabilities/gemini/response-handling - APIYI OpenAI 호환 응답 처리:
docs.apiyi.com/api-capabilities/openai/response-handling - APIYI 요청 ID 장애 해결:
docs.apiyi.com/faq/request-id-troubleshooting - openai-python 원시 응답 접근:
github.com/openai/openai-python
천 리 길도 한 걸음부터. ——《도덕경》