Примечание автора: в этой статье рассказывается, как через APIYI с помощью двух протоколов отправить первый запрос к Gemini 4 Neon, а также какие поля и логи нужно проверить после успешного ответа.
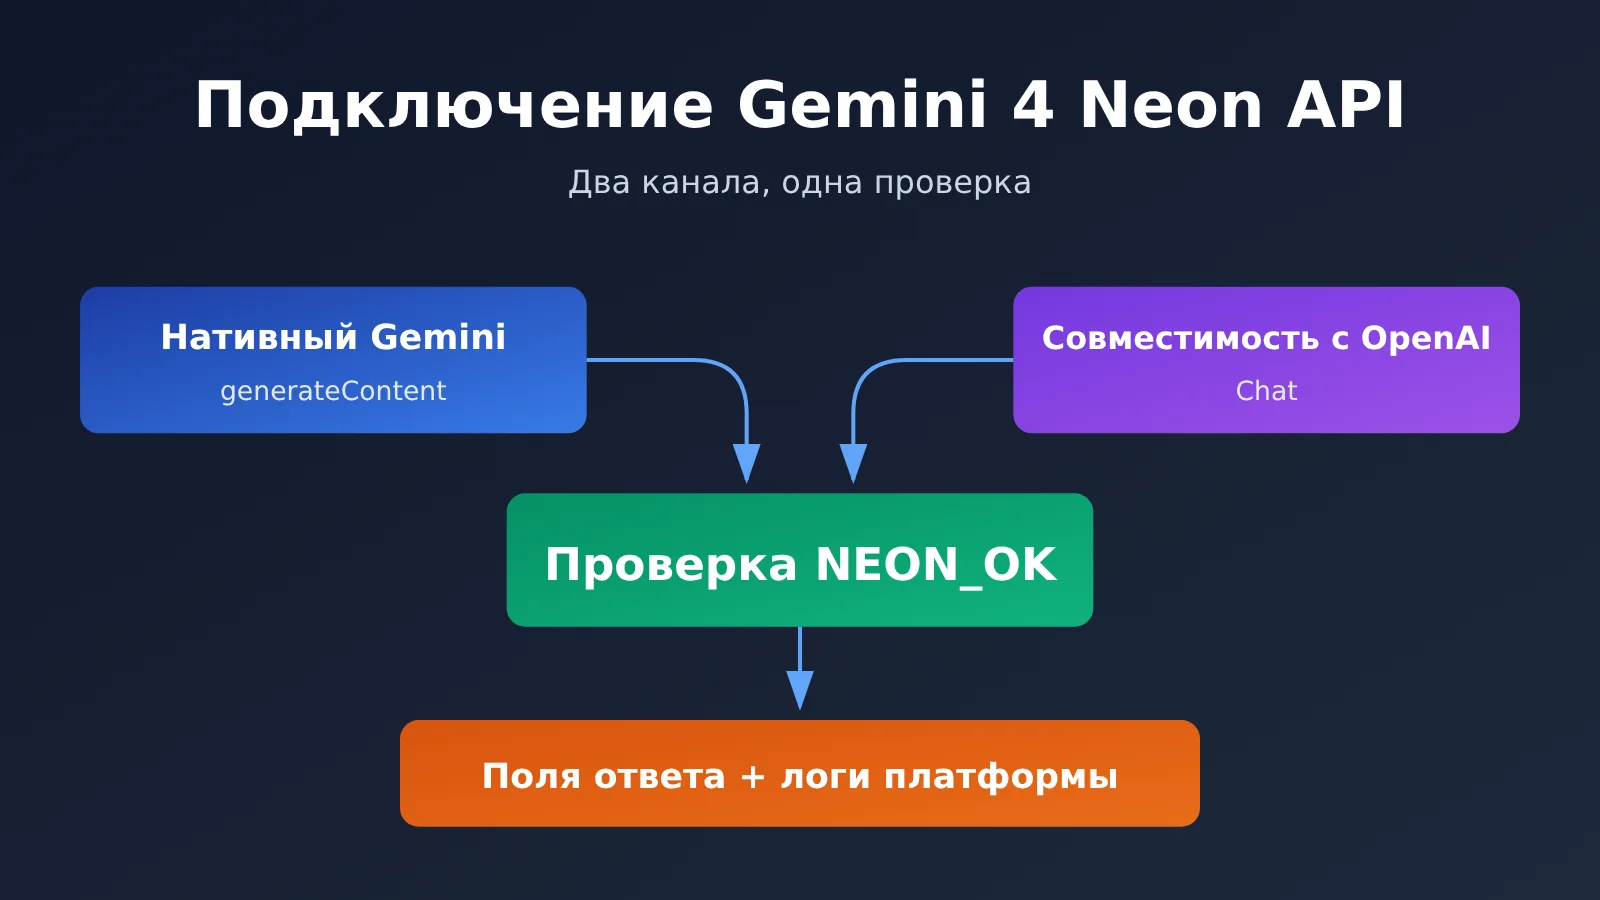
Сразу к делу: если в проекте уже есть клиент OpenAI Chat, идите через совместимую с OpenAI точку входа Chat Completions — достаточно заменить base_url и имя модели. Если нужно явно задать уровень размышлений Gemini, идите через нативную точку входа generateContent и указывайте его в generationConfig.thinkingConfig.thinkingLevel. Какой бы путь вы ни выбрали, сначала прогоните один и тот же короткий промпт на чистом тексте, а потом устраивайте приёмку по HTTP-статусу, телу ответа, причине остановки, расходу токенов и логам платформы. Когда приёмка пройдена, можно тестировать потоковый вывод, вызов инструментов и прочие возможности.
Предыстория такая. Google в обновлении AI Studio от 18 ноября 2026 года выпустил Gemini 4 Neon и объявил GA. APIYI подтвердил появление модели в каталоге по пекинскому времени 2026-11-20 11:45, в публичном прайс-листе видно gemini-4-neon, доступные группы — default и svip. Примеры в этой статье написаны по документации APIYI и документации SDK, платные интерфейсы не вызывались, никаких статистических данных реальных замеров в тексте нет.
Карта знаний и указатель по подключению к API Gemini 4 Neon
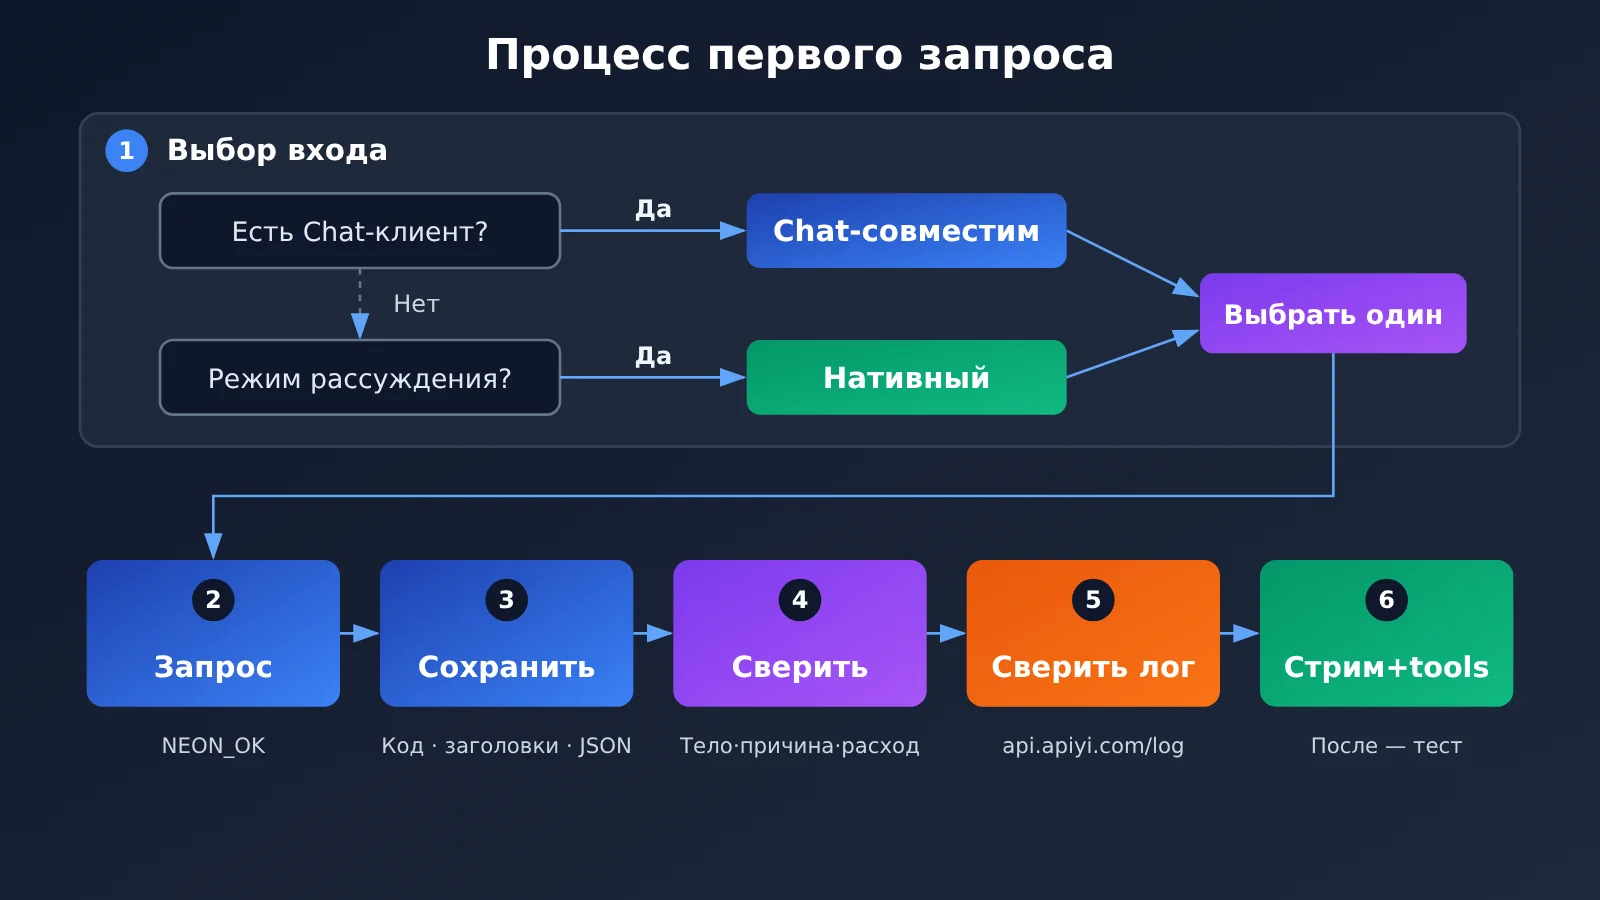
Весь процесс подключения состоит из трёх шагов: выбрать интерфейс, отправить запрос, проверить вывод и журналы. Результат каждого шага становится входными данными для следующего. Таблицу ниже можно использовать и как карту знаний, и как указатель для чтения: в ней собраны порядок этих трёх шагов, логика их расположения и цель каждого этапа.
| № | Шаг | Что даёт предыдущий шаг | Почему шаги идут именно так | Цель шага |
|---|---|---|---|---|
| 1 | Выбор входа (1.1 Chat-совместимый / 1.2 нативный режим и уровень мышления) | Ваш текущий стек кода и требования к уровню мышления | Вход определяет URL, способ аутентификации и структуру полей; от него зависят все последующие шаги | Выбрать один протокол и не отлаживать два пути одновременно |
| 2 | Отправка одного и того же короткого запроса (2.1 нативный cURL / 2.2 Python SDK) | Уже выбранный вход и формат запроса | Фиксированный короткий промпт позволяет исключить различия в возможностях моделей и проверить только работоспособность цепочки | Получить полный код состояния, заголовки ответа и тело ответа |
| 3 | Проверка (3.1 поля / 3.2 идентификация и журналы / 3.3 фиксация доказательств при сбое) | Исходный ответ, сохранённый на шаге 2 | Сначала смотрим на сам ответ, затем сверяем его с журналами платформы; доказательства собираем от ближних к дальним | Определить, действительно ли «текстовый ответ успешен»; если нет — оставить проверяемые доказательства |
Совет по чтению: если вы используете только один протокол, после чтения соответствующего подраздела раздела 1 сразу переходите к 2.1 или 2.2; раздел 3 нужно читать полностью.
Что нужно знать: необходимые термины API Gemini 4 Neon
| Термин | Краткое объяснение |
|---|---|
generateContent |
Нативный нестриминговый интерфейс генерации Gemini; в теле запроса содержимое организуется через contents и parts |
thinkingLevel |
Поле уровня мышления в generationConfig.thinkingConfig нативного интерфейса; в примерах этой статьи используется high |
| thought part | Part в нативном ответе, помеченный как содержимое мышления; при сборке основного текста его нужно исключить |
finishReason / finish_reason |
Поля причины остановки в нативном и совместимом интерфейсах соответственно |
X-Shellapi-Request-Id |
Идентификатор запроса, который APIYI возвращает в исходных заголовках ответа или в сообщении об ошибке; используется для диагностики |
1 Выбор точки подключения API Gemini 4 Neon
Оба входа ведут к одной и той же модели, разница — в форме протокола и в том, какими параметрами можно управлять. Сначала сравнение, затем в двух подразделах объясню, почему выбирать тот или иной вариант.
| Параметр сравнения | OpenAI-совместимый Chat | Нативный Gemini |
|---|---|---|
| Адрес | https://api.apiyi.com/v1 + Chat Completions |
https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent |
| Для кого | Проекты, где уже есть OpenAI SDK или Chat-клиент | Проекты, где нужен явный контроль параметров Gemini |
| Уровень рассуждений | В этой статье соответствующие параметры не передаются | thinkingConfig.thinkingLevel |
| Где находится основной текст | choices[0].message.content |
text (не thought) в candidates[0].content.parts |
| Идентификатор модели | model в ответе |
modelVersion в ответе (если возвращается) |
1.1 Совместимый вход Gemini 4 Neon: используем существующий Chat-клиент
Если код уже построен на OpenAI Python SDK или другом клиенте Chat Completions, минимальное изменение — заменить base_url на https://api.apiyi.com/v1 и указать имя модели gemini-4-neon, структуру сообщений при этом менять не нужно. Плюс в том, что код бизнес-логики почти не правится, а при возникновении проблем проще понять, дело в сети, аутентификации или самой модели.
У этого пути есть несколько границ, которые стоит обозначить. Во-первых, не передавайте reasoning_effort. Собственный слой совместимости Google его маппит, но это не значит, что совместимый вход APIYI берёт на себя те же обязательства. Во-вторых, в этой статье не используется эндпоинт /v1/responses. В-третьих, старый способ записи thinkingBudget и уровень minimal тоже вне рамок статьи. Если вам действительно нужно управлять уровнем рассуждений, переходите к нативному входу из 1.2.
1.2 Нативный вход Gemini 4 Neon: явно задаём уровень рассуждений
Нативный вход использует собственную структуру запроса Gemini. Уровень рассуждений передаётся явно через generationConfig.thinkingConfig.thinkingLevel, в специализированном примере APIYI используется значение "high". Нативный ответ также разделяет содержание рассуждений и основной текст на разные part, поэтому при чтении основного текста нужно активно фильтровать — конкретный код приведён в разделе 2.1.
Что касается аутентификации, в этом нативном примере используется заголовок Authorization: Bearer, а не распространённая у официального Gemini запись с параметром key. При миграции существующего нативного кода сначала проверьте этот момент.
2 Отправка одного и того же короткого запроса в Gemini 4 Neon API
Оба протокола используют один и тот же промпт: Reply with exactly NEON_OK and nothing else. Ожидаемый вывод по этому промпту очень короткий, и результат легко проверить. Если вернулось что-то кроме NEON_OK, значит проблема в цепочке или в разборе ответа — так можно отбросить помехи вроде «модель просто отвечает в другом стиле». API-ключ всегда читается из переменной окружения APIYI_API_KEY, не записывайте его в код или в историю команд.
2.1 Нативный cURL для Gemini 4 Neon и извлечение значений из JSON
Приведённая ниже команда сохраняет HTTP-код статуса, заголовки ответа и тело JSON-ответа по отдельности — все три понадобятся при приёмке в разделе 3.
curl -sS -X POST "https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "Authorization: Bearer ${APIYI_API_KEY}" \
  -H "Content-Type: application/json" \
  -D neon_native_headers.txt \
  -o neon_native_body.json \
  -w "%{http_code}\n" \
  -d '{
    "contents": [
      {"role": "user", "parts": [{"text": "Reply with exactly NEON_OK and nothing else."}]}
    ],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "high"}
    }
  }' > neon_native_status.txt
При чтении основного текста нужно склеить все text из candidates[0].content.parts, которые не являются thought, а не брать только первую part. В примере ниже используется jq; если jq не установлен, можно взять любой другой инструмент разбора JSON:
# Основной текст: склеиваем text, не являющиеся thought
jq -r '[.candidates[0].content.parts[]? | select(.thought != true) | .text // empty] | join("")' neon_native_body.json

# Причина остановки, расход, версия модели (если поля нет — выводится null, не подставляйте значение сами)
jq '{finishReason: .candidates[0].finishReason, usageMetadata, modelVersion}' neon_native_body.json

# Идентификатор запроса платформы
grep -i "x-shellapi-request-id" neon_native_headers.txt
2.2 Вызов Gemini 4 Neon через Python OpenAI SDK и чтение ответа
Совместимый эндпоинт использует with_raw_response — так можно получить и разобранный объект, и исходные заголовки ответа. max_retries=0 отключает автоматические повторы SDK, чтобы одна неудача не маскировалась ретраями, а на платформе не появлялось несколько логов, по которым непонятно, к какому именно запросу они относятся.
import os
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # OpenAI-совместимый эндпоинт APIYI
    max_retries=0,
    timeout=120.0,
)

try:
    raw = client.chat.completions.with_raw_response.create(
        model="gemini-4-neon",
        messages=[{"role": "user", "content": "Reply with exactly NEON_OK and nothing else."}],
        max_tokens=4096,
    )
    print("HTTP:", raw.status_code)
    print("X-Shellapi-Request-Id:", raw.headers.get("x-shellapi-request-id"))

    completion = raw.parse()
    if not completion.choices:
        print("choices 为空,不读取正文")
    else:
        choice = completion.choices[0]
        print("content:", choice.message.content)
        print("finish_reason:", choice.finish_reason)
    print("usage:", completion.usage)
    print("model:", completion.model)

except APIStatusError as e:
    print("HTTP:", e.status_code)
    print("X-Shellapi-Request-Id:", e.response.headers.get("x-shellapi-request-id"))
    print("error:", e.message)  # перед записью убедитесь, что нет ключей и других чувствительных данных
except APIConnectionError as e:
    print("未拿到 HTTP 响应:", type(e).__name__)
В этом коде есть один момент, на который стоит обратить особое внимание: когда choices пуст, нельзя сразу обращаться к choices[0], иначе возникнет ошибка индексации и скроет настоящую проблему. У ошибки соединения нет HTTP-статуса и заголовков ответа, поэтому её нужно обрабатывать отдельно от APIStatusError.
3 Приёмка первого запроса к Gemini 4 Neon API
Цель приёмки — понять, выполняется ли условие «текстовый запрос прошёл успешно». Код HTTP 2xx и ожидаемое NEON_OK в теле ответа говорят лишь о том, что этот конкретный текстовый запрос удался. Это не подтверждает идентичность модели и не может считаться результатом теста производительности.
3.1 HTTP-статус, тело ответа, причина остановки и расход
| Проверка | Нативное поле | Совместимое поле | Условие прохождения |
|---|---|---|---|
| HTTP-статус | сохранённый status | raw.status_code |
2xx |
| Тело ответа | склейка text без thought-частей |
choices[0].message.content |
равно NEON_OK |
| Причина остановки | candidates[0].finishReason |
choices[0].finish_reason |
записана и согласуется с телом ответа |
| Расход | usageMetadata |
usage |
записан для сверки с логами |
Если какого-то поля в ответе нет, помечайте его как «не возвращено» и не пытайтесь угадать значение по опыту. Причину остановки нужно смотреть вместе с телом ответа. Если тело пустое, а причина остановки не означает нормальное завершение, проблема обычно кроется в процессе генерации, а не в коде парсинга.
3.2 Нативный modelVersion, совместимый model и журналы: что каждый из них может прояснить
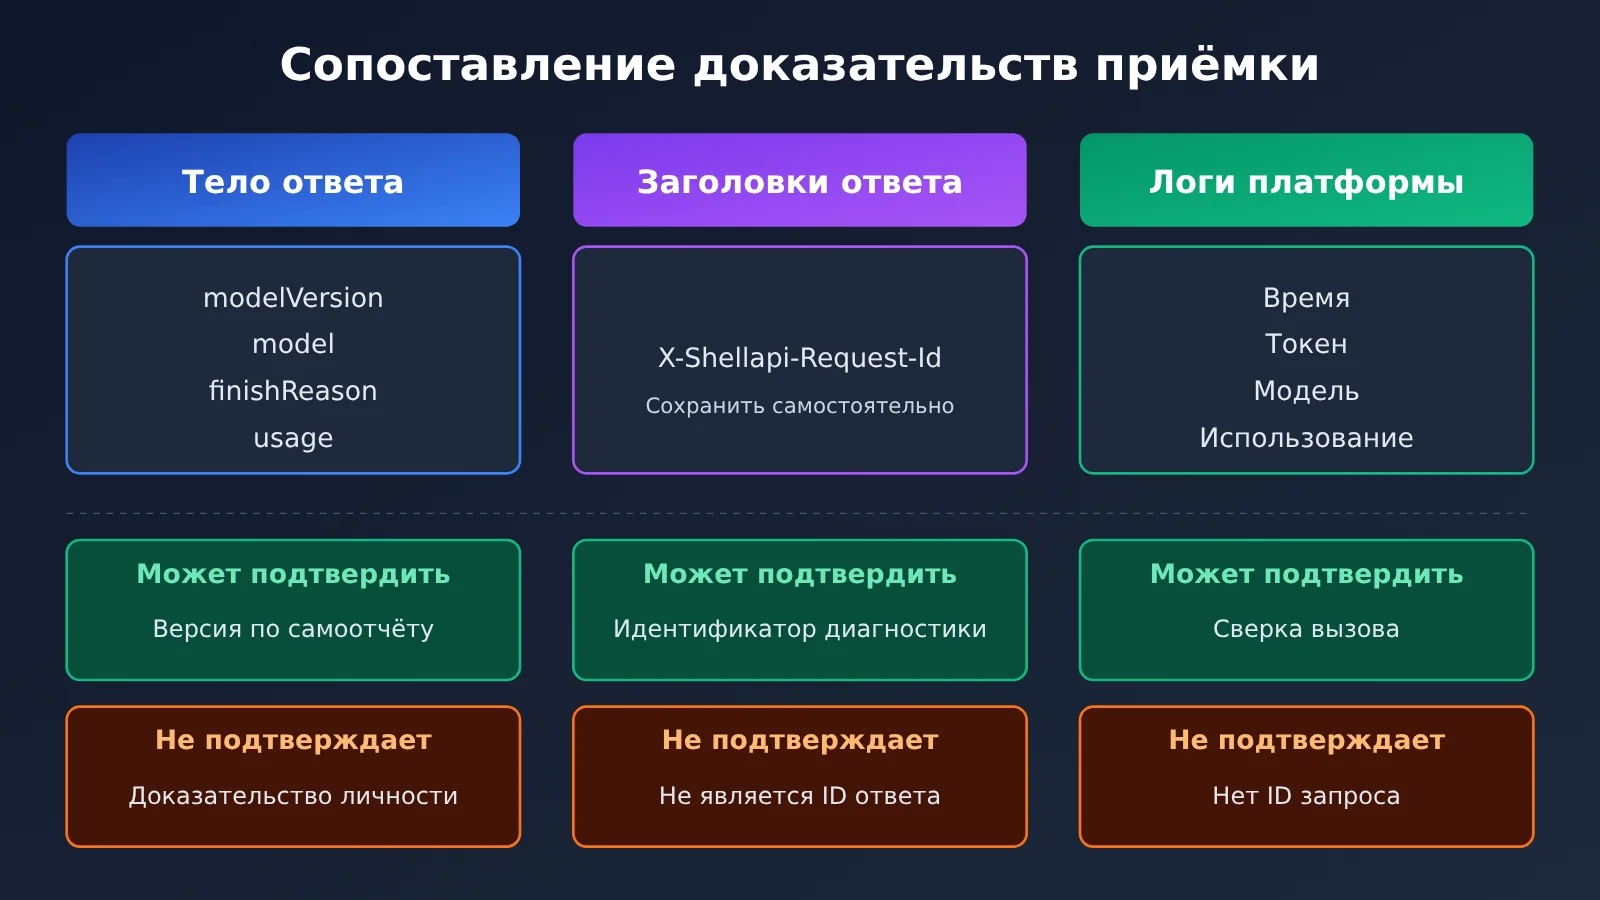
Эти элементы подтверждают разные вещи, и при фиксации результатов не стоит подменять один другим:
| Информация | Источник | Что подтверждает | Что не подтверждает |
|---|---|---|---|
modelVersion |
Нативное тело ответа (если возвращается) | Версия модели, которую ответ указывает сам | Не может само по себе служить доказательством идентичности |
model |
Тело совместимого ответа | Имя модели, которое ответ указывает сам | То же самое |
| Журнал платформы | api.apiyi.com/log |
Позволяет свернуть этот вызов по времени, токену, модели и расходу | В консоли не отображается ID запроса |
X-Shellapi-Request-Id |
Заголовок исходного ответа или текст ошибки | Идентификатор запроса, который платформа использует для диагностики | Это не responseId, не Chat id и не _request_id из SDK |
При сверке с журналами сопоставляйте время отправки запроса, использованный токен, имя модели gemini-4-neon и цифры расхода. Поскольку консоль не отображает ID запроса, X-Shellapi-Request-Id нужно самостоятельно сохранить из заголовков ответа — потом в консоли его не найти.
3.3 Gemini 4 Neon: как фиксировать доказательства, если тело ответа отсутствует или запрос завершился ошибкой
Когда запрос падает или тело ответа пустое, не спешите с повтором — сначала сохраните доказательства в таком порядке:
- Сохраните код состояния HTTP. Если это ошибка соединения — запишите тип исключения.
- Сохраните исходные заголовки ответа и вытащите из них
X-Shellapi-Request-Id. - Сохраните сырое тело ответа или сообщение об ошибке, предварительно удалив чувствительные данные вроде API-ключа.
- Зафиксируйте причину остановки и расход (если он есть), а также время отправки запроса, имя использованного токена и название модели.
- Зайдите на
api.apiyi.com/log, найдите нужную запись по времени и токену и с этими материалами сверьтесь с документацией платформы по траблшутингу через request ID.
Есть ещё один нюанс про нативный ответ. Если в parts лежит только thought-контент, после фильтрации тело окажется пустым. В этом случае так и пишите: «после фильтрации тело пустое» — не выдавайте thought-контент за тело только ради того, чтобы получить хоть какой-то вывод.
Когда одиночный текстовый запрос прошёл приёмку по описанной схеме, можно проверять потоковый вывод, вызов инструментов и другие возможности — смотря что нужно проекту. Каждую новую возможность принимайте отдельно по одному и тому же принципу: «тот же запрос, сохранить исходный ответ, свер-ить с логами». Бенчмарки и цены в этой статье не разбираются — актуальное смотрите в официальных анонсах и публичном каталоге APIYI.
Ссылки
- Журнал обновлений Google AI Studio (2026-11-18):
aistudio.google.com/docs/changelog - Структура Gemini GenerateContentResponse:
aistudio.google.com/api-reference/generate-content - Анонс выхода Gemini 4 Neon от APIYI и примеры для двух протоколов:
docs.apiyi.com/news/gemini-4-neon-launch.md - Обработка ответов Gemini в APIYI:
docs.apiyi.com/api-capabilities/gemini/response-handling - Обработка ответов, совместимых с OpenAI, в APIYI:
docs.apiyi.com/api-capabilities/openai/response-handling - Траблшутинг по request ID в APIYI:
docs.apiyi.com/faq/request-id-troubleshooting - Доступ к сырому ответу в openai-python:
github.com/openai/openai-python
Путь в тысячу ли начинается с первого шага. — «Дао дэ цзин»