Catatan penulis: Artikel ini menjelaskan cara mengirim permintaan pertama ke Gemini 4 Neon di APIYI dengan dua protokol, serta field dan log apa saja yang perlu diperiksa setelah permintaan berhasil.
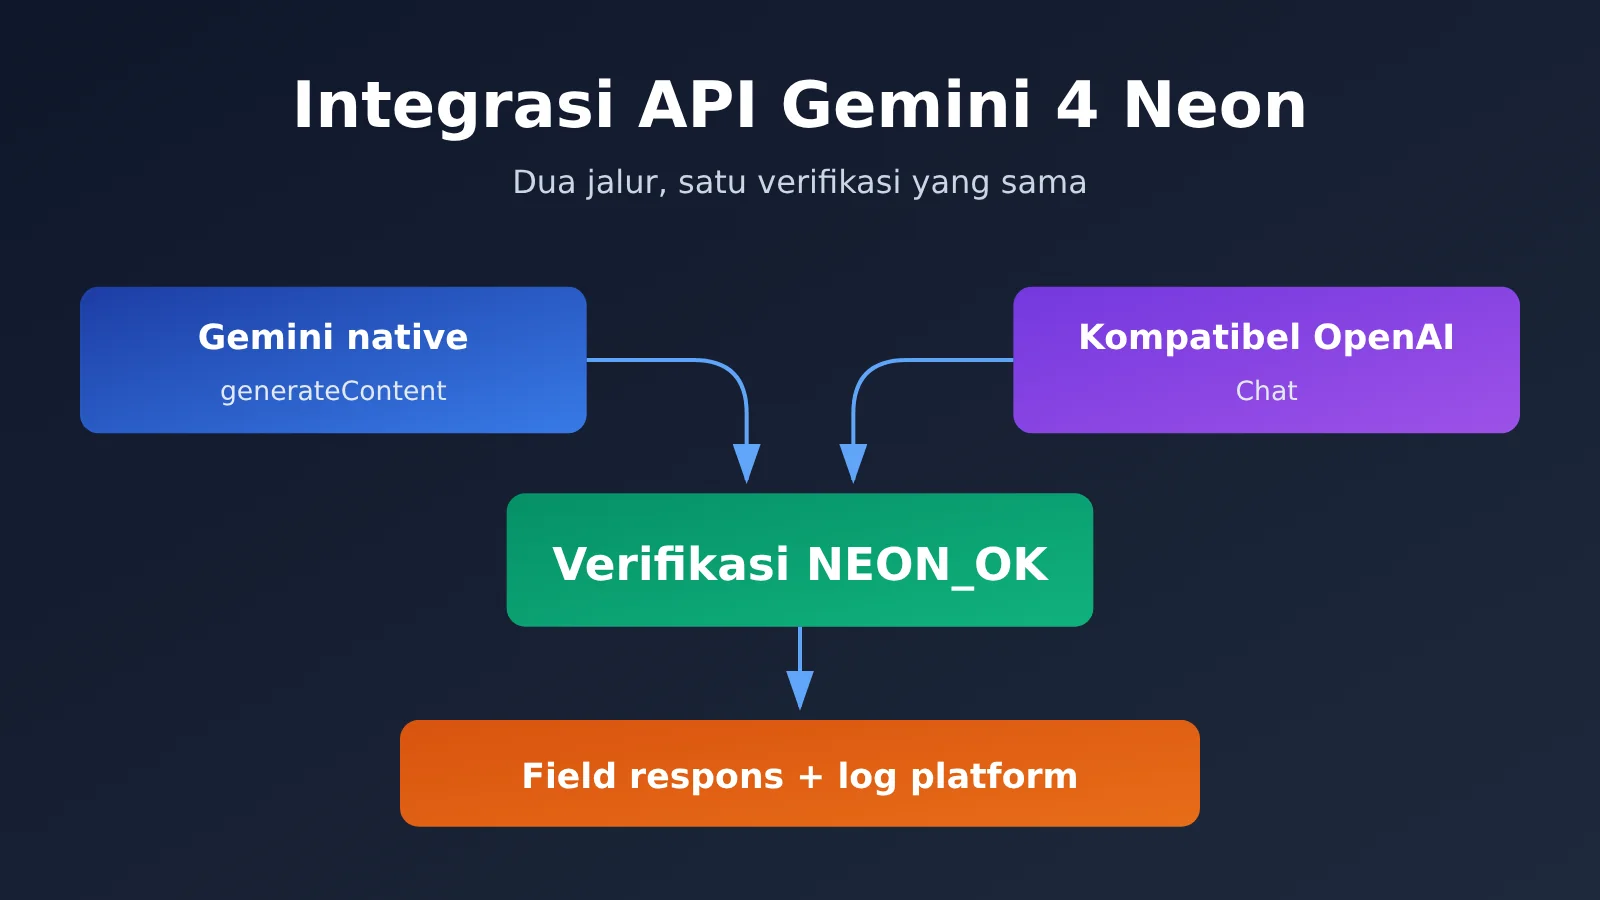
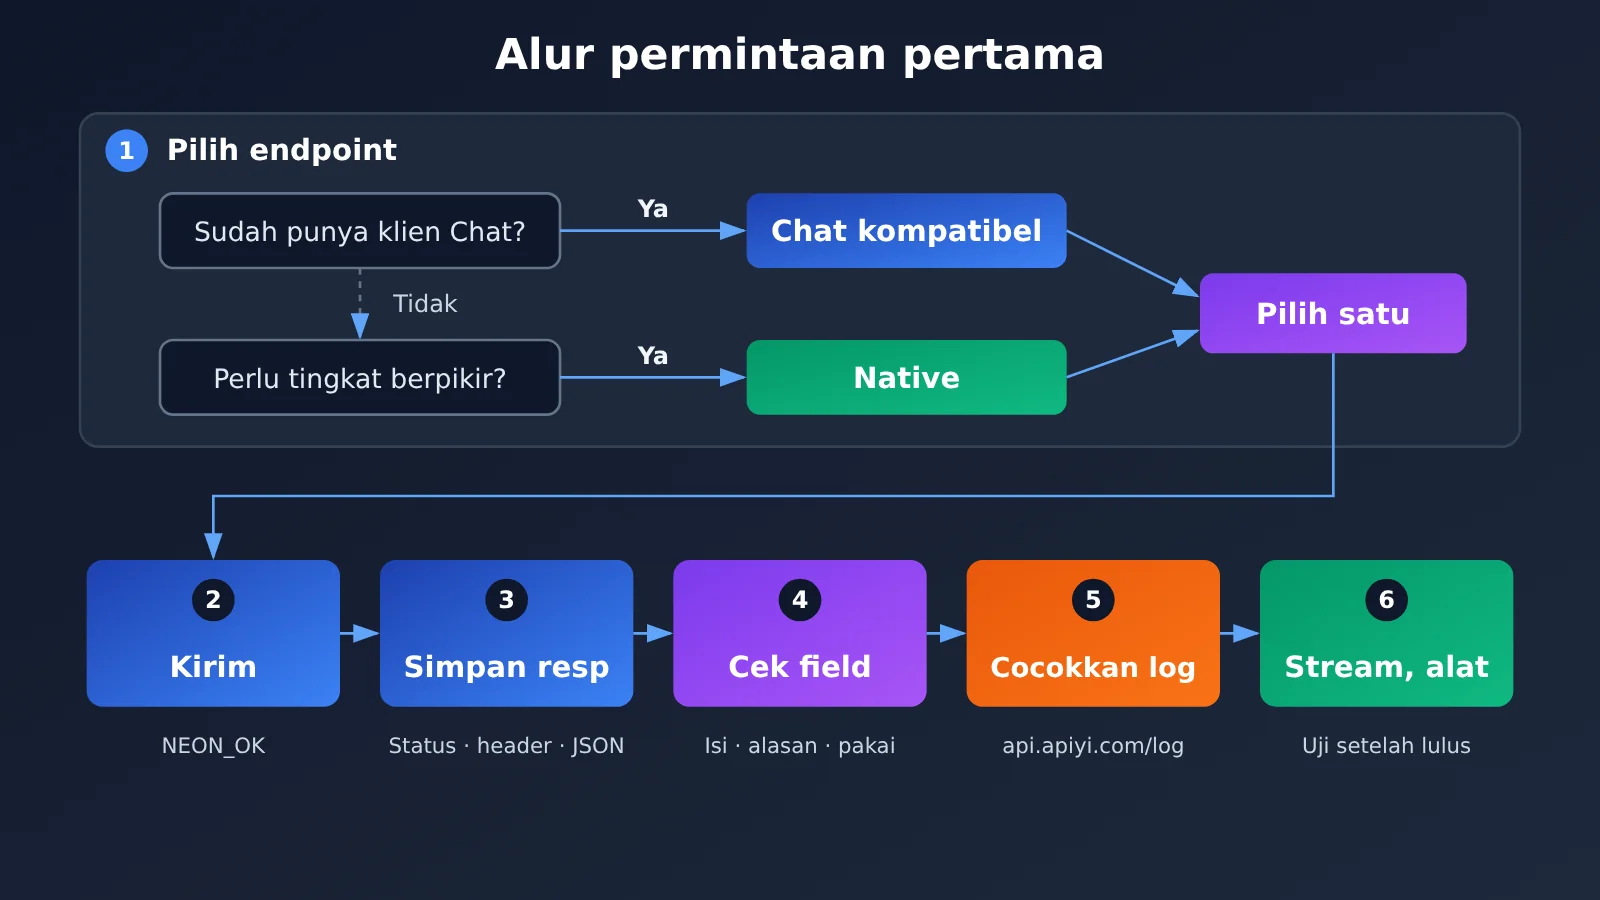
Kesimpulan di awal: Jika proyek sudah memiliki klien OpenAI Chat, gunakan endpoint Chat Completions yang kompatibel dengan OpenAI; cukup ganti base_url dan nama model. Jika perlu mengatur tingkat penalaran Gemini secara eksplisit, gunakan endpoint native Gemini generateContent, dan tentukan nilainya di generationConfig.thinkingConfig.thinkingLevel. Apa pun jalur yang dipilih, jalankan dulu teks biasa dengan petunjuk singkat yang sama hingga berhasil, lalu validasi berdasarkan status HTTP, body, alasan berhenti, penggunaan, dan log platform. Setelah validasi lolos, baru uji kemampuan seperti output streaming dan tool calling.
Berikut informasi latar belakangnya. Google merilis Gemini 4 Neon dalam log pembaruan AI Studio tanggal 18 November 2026 dan mengumumkan status GA-nya. APIYI mengonfirmasi ketersediaan model ini pada 2026-11-20 pukul 11:45 waktu Beijing; di katalog harga publik, gemini-4-neon sudah terlihat dengan grup yang tersedia: default dan svip. Contoh dalam artikel ini disusun berdasarkan dokumentasi APIYI dan dokumentasi SDK, tidak memanggil endpoint berbayar, dan tidak memuat statistik pengujian aktual apa pun.
Peta Pengetahuan dan Indeks Integrasi API Gemini 4 Neon
Seluruh proses integrasi dibagi menjadi tiga langkah: memilih antarmuka, mengirim permintaan, lalu memeriksa output dan log. Setiap keluaran dari satu langkah menjadi masukan bagi langkah berikutnya. Tabel berikut menyatukan hubungan urutan ketiga langkah, alasan penjadwalannya, dan target yang ingin dicapai pada tiap langkah; bisa dipakai sebagai peta pengetahuan sekaligus indeks bacaan.
| No. | Langkah | Apa yang diberikan langkah sebelumnya | Mengapa urutannya seperti ini | Target langkah ini |
|---|---|---|---|---|
| 1 | Memilih pintu masuk (1.1 kompatibel Chat / 1.2 native dan tingkat pemikiran) | Tumpukan kode yang Anda miliki dan kebutuhan akan tingkat pemikiran | Pintu masuk menentukan URL, cara penulisan autentikasi, dan struktur field; semua langkah setelahnya bergantung pada ini | Menentukan satu protokol, tidak melakukan pemecahan masalah di dua jalur sekaligus |
| 2 | Mengirim permintaan pendek yang sama (2.1 cURL native / 2.2 SDK Python) | Pintu masuk dan format permintaan yang sudah ditentukan | Dengan petunjuk pendek yang tetap, perbedaan kemampuan model bisa dikesampingkan; yang diuji hanya apakah jalurnya tersambung | Mendapatkan kode status, header respons, dan body respons yang lengkap |
| 3 | Verifikasi (3.1 field / 3.2 identitas dan log / 3.3 menyimpan bukti kegagalan) | Respons mentah yang disimpan pada Langkah 2 | Lihat respons itu sendiri dulu, lalu cocokkan dengan log platform; bukti diperiksa dari yang terdekat ke yang terjauh | Menentukan apakah “teks berhasil” benar-benar terpenuhi; jika tidak, tinggalkan bukti yang dapat ditelusuri |
Saran membaca: pembaca yang hanya menggunakan salah satu protokol, setelah selesai membaca subbagian yang sesuai di Bagian 1, langsung melihat salah satu dari 2.1 atau 2.2; Bagian 3 perlu dibaca secara lengkap.
Perlu Diketahui: Istilah Penting API Gemini 4 Neon
| Istilah | Penjelasan singkat |
|---|---|
generateContent |
Antarmuka generasi non-streaming native Gemini; di body permintaan, konten disusun dengan contents dan parts |
thinkingLevel |
Field tingkat pemikiran di bawah generationConfig.thinkingConfig pada antarmuka native; contoh dalam artikel ini memakai high |
| thought part | Part dalam respons native yang ditandai sebagai konten pemikiran; harus dikecualikan saat menggabungkan isi utama |
finishReason / finish_reason |
Field alasan berhenti pada antarmuka native dan antarmuka kompatibel |
X-Shellapi-Request-Id |
ID permintaan yang dikembalikan APIYI di header respons mentah atau pesan error, digunakan untuk pemecahan masalah |
1 Memilih jalur akses API Gemini 4 Neon
Kedua jalur akses mengarah ke model yang sama. Perbedaannya terletak pada bentuk protokol dan parameter yang dapat dikendalikan. Di bawah ini disajikan perbandingan terlebih dahulu, lalu dua subbagian yang menjelaskan alasan pemilihannya.
| Item perbandingan | Chat kompatibel OpenAI | Gemini native |
|---|---|---|
| Alamat | https://api.apiyi.com/v1 + Chat Completions |
https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent |
| Cocok untuk | Proyek yang sudah memiliki OpenAI SDK atau klien Chat | Proyek yang perlu mengendalikan parameter Gemini secara eksplisit |
| Tingkat berpikir | Artikel ini tidak mengirimkan parameter terkait | thinkingConfig.thinkingLevel |
| Lokasi teks utama | choices[0].message.content |
text yang bukan thought di dalam candidates[0].content.parts |
| Penanda model | model di dalam respons |
modelVersion di dalam respons (jika dikembalikan) |
1.1 Jalur kompatibel Gemini 4 Neon: tetap gunakan klien Chat yang sudah ada
Jika kode yang sudah ada menggunakan OpenAI Python SDK atau klien Chat Completions lainnya, perubahan paling sedikit adalah mengganti base_url menjadi https://api.apiyi.com/v1, menuliskan nama model gemini-4-neon, dan tidak perlu mengubah struktur pesan. Keuntungannya, kode lapisan bisnis hampir tidak perlu diubah, dan saat terjadi masalah lebih mudah menentukan apakah masalahnya ada di jaringan, autentikasi, atau model.
Ada beberapa batasan yang perlu diperjelas saat menggunakan jalur ini. Pertama, jangan mengirimkan reasoning_effort. Google sendiri punya lapisan kompatibilitas yang memetakannya, tetapi itu tidak berarti endpoint kompatibel APIYI juga memberikan komitmen yang sama. Kedua, artikel ini tidak menggunakan endpoint /v1/responses. Ketiga, penulisan thinkingBudget lama dan tingkat minimal juga di luar cakupan artikel ini. Jika Anda memang perlu mengendalikan tingkat berpikir, silakan beralih ke jalur native di 1.2.
1.2 Jalur native Gemini 4 Neon: setel tingkat berpikir secara eksplisit
Jalur native menggunakan struktur permintaan milik Gemini sendiri. Tingkat berpikir dikirimkan secara eksplisit melalui generationConfig.thinkingConfig.thinkingLevel; nilai yang digunakan dalam kasus khusus APIYI adalah "high". Respons native juga memisahkan konten berpikir dan teks utama ke dalam part yang berbeda, jadi saat membaca teks utama, lakukan penyaringan secara aktif. Bagian 2.1 memberikan contoh penulisannya.
Dari sisi autentikasi, kasus native ini menggunakan header permintaan Authorization: Bearer, bukan penulisan parameter key yang umum dipakai Gemini resmi. Saat memigrasikan kode native yang sudah ada, periksa dulu bagian ini.
2 Mengirim permintaan singkat yang sama ke API Gemini 4 Neon
Kedua protokol memakai petunjuk yang sama: Reply with exactly NEON_OK and nothing else. Petunjuk ini sengaja dibuat sangat pendek supaya hasilnya mudah dinilai. Selama balasan yang kembali bukan NEON_OK, berarti ada masalah pada jalur koneksi atau proses parsing, sehingga gangguan seperti “gaya jawaban model berbeda” bisa langsung disingkirkan. Kunci API selalu dibaca dari variabel lingkungan APIYI_API_KEY, jangan ditulis ke dalam kode atau riwayat perintah.
2.1 cURL native Gemini 4 Neon dan pengambilan nilai JSON
Perintah berikut menyimpan status code HTTP, header respons, dan body JSON respons secara terpisah. Ketiganya akan dipakai lagi saat verifikasi di bagian 3.
curl -sS -X POST "https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "Authorization: Bearer ${APIYI_API_KEY}" \
  -H "Content-Type: application/json" \
  -D neon_native_headers.txt \
  -o neon_native_body.json \
  -w "%{http_code}\n" \
  -d '{
    "contents": [
      {"role": "user", "parts": [{"text": "Reply with exactly NEON_OK and nothing else."}]}
    ],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "high"}
    }
  }' > neon_native_status.txt
Saat membaca body, semua text di candidates[0].content.parts yang bukan thought harus digabungkan, bukan hanya mengambil part pertama. Contoh berikut memakai jq; kalau jq belum terpasang, bisa diganti dengan tool parsing JSON apa pun:
# Body: gabungkan text yang bukan thought
jq -r '[.candidates[0].content.parts[]? | select(.thought != true) | .text // empty] | join("")' neon_native_body.json

# Alasan berhenti, penggunaan, versi model (kalau field tidak ada, hasilnya null, jangan diisi sendiri)
jq '{finishReason: .candidates[0].finishReason, usageMetadata, modelVersion}' neon_native_body.json

# Identitas request dari platform
grep -i "x-shellapi-request-id" neon_native_headers.txt
2.2 Pemanggilan Gemini 4 Neon dengan Python OpenAI SDK dan pembacaan respons
Endpoint kompatibel ini memakai with_raw_response, sehingga kita bisa mendapatkan objek hasil parsing sekaligus membaca header respons mentah. max_retries=0 dipakai untuk mematikan retry otomatis dari SDK, supaya satu kegagalan tidak tertutupi oleh percobaan ulang, dan supaya di platform tidak muncul beberapa log yang membuat kita sulit mencocokkan request mana yang bermasalah.
import os
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # Endpoint kompatibel OpenAI APIYI
    max_retries=0,
    timeout=120.0,
)

try:
    raw = client.chat.completions.with_raw_response.create(
        model="gemini-4-neon",
        messages=[{"role": "user", "content": "Reply with exactly NEON_OK and nothing else."}],
        max_tokens=4096,
    )
    print("HTTP:", raw.status_code)
    print("X-Shellapi-Request-Id:", raw.headers.get("x-shellapi-request-id"))

    completion = raw.parse()
    if not completion.choices:
        print("choices 为空,不读取正文")
    else:
        choice = completion.choices[0]
        print("content:", choice.message.content)
        print("finish_reason:", choice.finish_reason)
    print("usage:", completion.usage)
    print("model:", completion.model)

except APIStatusError as e:
    print("HTTP:", e.status_code)
    print("X-Shellapi-Request-Id:", e.response.headers.get("x-shellapi-request-id"))
    print("error:", e.message)  # Pastikan tidak berisi kunci atau info sensitif sebelum dicatat
except APIConnectionError as e:
    print("未拿到 HTTP 响应:", type(e).__name__)
Ada satu hal yang perlu diperhatikan pada kode ini: ketika choices kosong, jangan langsung menulis choices[0], karena akan memunculkan error indeks yang justru menutupi masalah sebenarnya. Kesalahan koneksi tidak punya status code HTTP dan tidak punya header respons, jadi penanganannya harus dipisahkan dari APIStatusError.
3 Memvalidasi Permintaan Pertama ke Gemini 4 Neon API
Tujuan validasi adalah untuk menentukan apakah “permintaan teks murni berhasil” benar-benar terjadi. HTTP 2xx dengan body yang sesuai yaitu NEON_OK hanya menunjukkan bahwa permintaan teks kali ini berhasil. Hal ini tidak dapat membuktikan identitas model, dan juga tidak bisa dijadikan hasil uji performa.
3.1 Status HTTP, Body, Alasan Berhenti, dan Penggunaan
| Item pemeriksaan | Field native | Field kompatibel | Kondisi lulus |
|---|---|---|---|
| Status HTTP | status yang disimpan | raw.status_code |
2xx |
| Body | gabungan text non-thought |
choices[0].message.content |
sama dengan NEON_OK |
| Alasan berhenti | candidates[0].finishReason |
choices[0].finish_reason |
sudah dicatat, dan konsisten dengan kondisi body |
| Penggunaan | usageMetadata |
usage |
sudah dicatat, untuk dibandingkan dengan log |
Jika suatu field tidak ada dalam respons, catat sebagai “tidak dikembalikan”, jangan menebak nilainya berdasarkan pengalaman. Alasan berhenti perlu dilihat bersama dengan body. Jika body kosong sementara alasan berhenti bukan penyelesaian normal, masalahnya biasanya ada pada proses generasi, bukan pada kode parsing.
3.2 Apa yang dapat dijelaskan oleh modelVersion native, model kompatibel, dan log
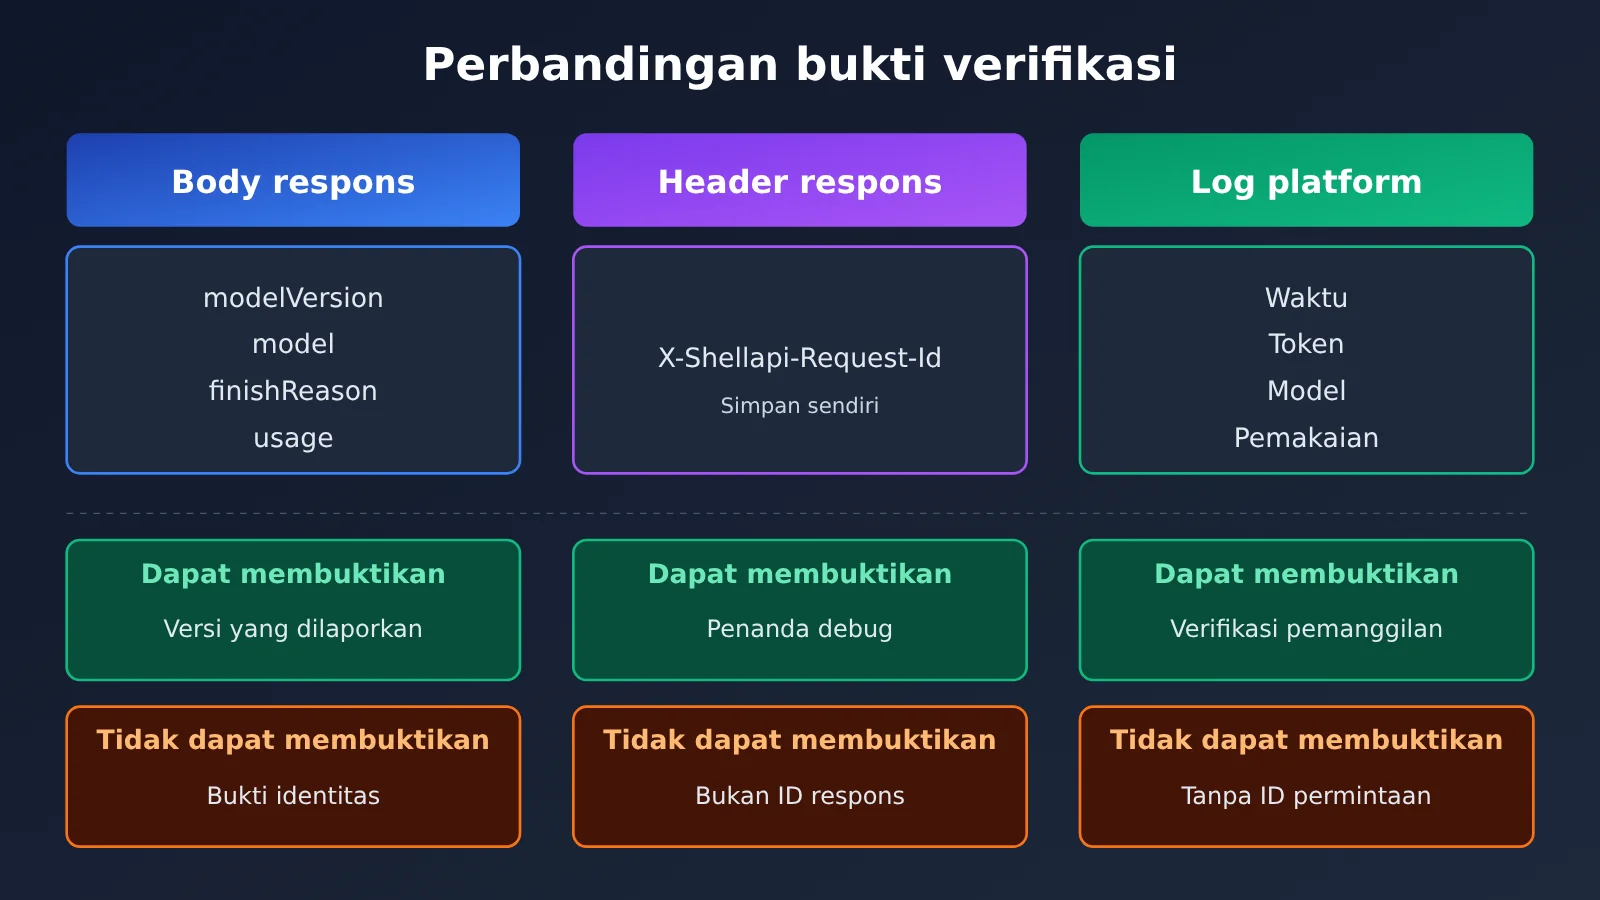
Cakupan yang dapat dibuktikan oleh masing-masing informasi ini berbeda-beda; saat mencatat, jangan gunakan yang satu untuk menggantikan yang lain:
| Informasi | Sumber | Dapat menjelaskan | Tidak dapat menjelaskan |
|---|---|---|---|
modelVersion |
body respons native (jika dikembalikan) | versi model yang dilaporkan sendiri oleh respons | tidak dapat dijadikan bukti identitas secara mandiri |
model |
body respons kompatibel | nama model yang dilaporkan sendiri oleh respons | sama seperti di atas |
| Log platform | api.apiyi.com/log |
mencocokkan pemanggilan ini berdasarkan waktu, token, model, dan penggunaan | konsol tidak menampilkan ID permintaan |
X-Shellapi-Request-Id |
header respons asli atau pesan error | pengenal permintaan yang dipakai platform saat menangani masalah | ini bukan responseId, Chat id, juga bukan _request_id dari SDK |
Saat memeriksa log, cocokkan berdasarkan waktu permintaan dikirim, token yang digunakan, nama model gemini-4-neon, serta angka penggunaan. Karena konsol tidak menampilkan ID permintaan, X-Shellapi-Request-Id harus Anda simpan sendiri dari header respons; setelah itu, informasi ini tidak dapat dicari di konsol.
3.3 Cara menyimpan bukti saat Gemini 4 Neon tidak memiliki isi respons atau saat permintaan gagal
Saat permintaan gagal atau tidak ada isi respons, jangan langsung mencoba ulang. Simpan bukti dengan urutan berikut:
- Simpan kode status HTTP. Jika terjadi kesalahan koneksi, catat jenis exception-nya.
- Simpan header respons asli, lalu ambil
X-Shellapi-Request-Iddarinya. - Simpan isi respons asli atau pesan kesalahan, dan hapus konten sensitif seperti kunci API.
- Catat alasan berhenti dan penggunaan (jika ada), serta waktu permintaan dikirim, nama token yang digunakan, dan nama model.
- Buka
api.apiyi.com/log, temukan catatan yang sesuai berdasarkan waktu dan token, lalu gunakan materi di atas untuk menangani masalah dengan merujuk pada dokumentasi pemecahan masalah ID permintaan dari platform.
Ada satu hal lagi yang perlu diperhatikan terkait respons native. Jika parts hanya berisi konten thought, maka isi respons setelah difilter akan kosong. Dalam kondisi ini, catat dengan jujur bahwa “isi respons setelah difilter kosong”, jangan menjadikan konten thought sebagai isi respons hanya demi mendapatkan output.
Setelah verifikasi teks murni satu putaran lolos dengan cara di atas, barulah verifikasi kemampuan seperti output streaming dan pemanggilan tool sesuai kebutuhan proyek. Setiap kali menambahkan satu kemampuan, lakukan verifikasi terpisah dengan metode “permintaan yang sama, simpan respons asli, bandingkan dengan log”. Artikel ini tidak membahas benchmark dan harga; untuk informasi terkait, silakan mengacu pada pengumuman resmi dan katalog publik APIYI.
Referensi
- Changelog Google AI Studio (2026-11-18):
aistudio.google.com/docs/changelog - Struktur Gemini GenerateContentResponse:
aistudio.google.com/api-reference/generate-content - Pengumuman peluncuran APIYI Gemini 4 Neon dan contoh dua protokol:
docs.apiyi.com/news/gemini-4-neon-launch.md - Penanganan respons APIYI Gemini:
docs.apiyi.com/api-capabilities/gemini/response-handling - Penanganan respons kompatibel OpenAI APIYI:
docs.apiyi.com/api-capabilities/openai/response-handling - Pemecahan masalah ID permintaan APIYI:
docs.apiyi.com/faq/request-id-troubleshooting - Akses respons asli openai-python:
github.com/openai/openai-python
Perjalanan seribu mil dimulai dari satu langkah. ——《Dao De Jing》