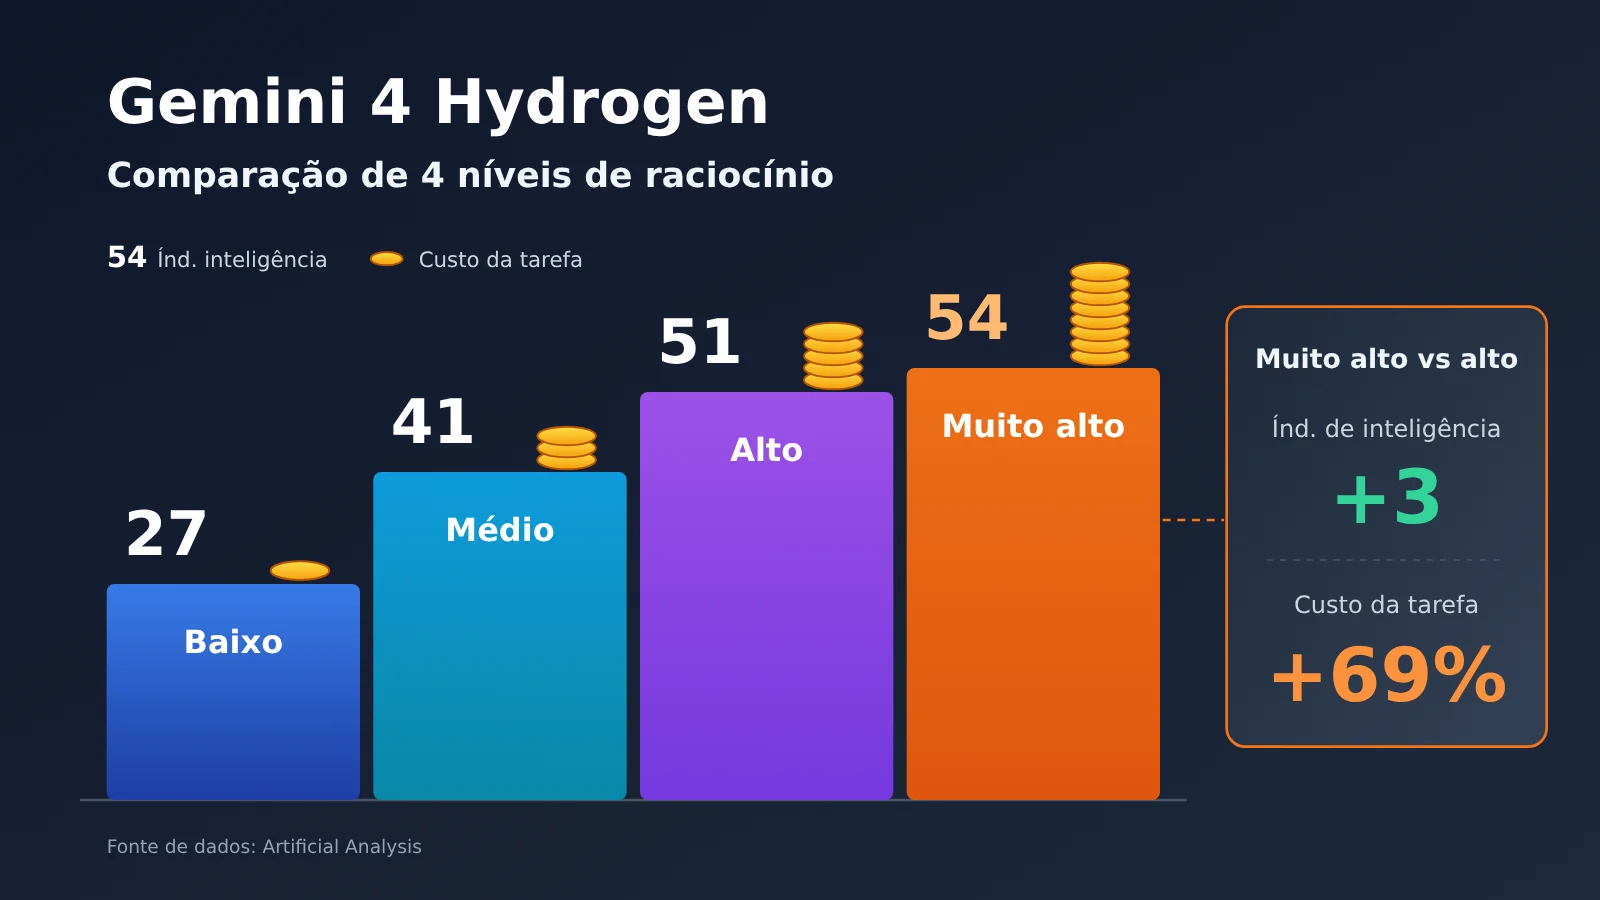
Resumo em uma frase: A avaliação em quatro níveis do Artificial Analysis mostra que, ao passar de High para XHigh no Gemini 4 Hydrogen, o índice de inteligência sobe apenas 3 pontos, enquanto o custo das tarefas de avaliação aumenta cerca de 69%. Por isso, faz mais sentido configurar o nível de pensamento de acordo com a dificuldade da tarefa.
O Google lançou oficialmente o Gemini 4 Hydrogen em 12 de novembro de 2026, oferecendo ao mesmo tempo quatro níveis de pensamento: Low, Medium, High e XHigh. Os quatro níveis usam o mesmo ID de modelo e a mesma tabela de preços por token, mas as pontuações, os custos e os tempos de espera nas avaliações de terceiros variam bastante.
Este não é um guia do tipo “quanto mais alto o nível, melhor”. Usamos os dados padronizados de avaliação do Artificial Analysis para calcular o ganho marginal de cada nível e oferecemos recomendações claras por tipo de tarefa.
Valor principal: depois de ler este artigo, você conseguirá decidir qual nível usar no seu negócio e como controlar o custo de raciocínio com o parâmetro thinking_level.
Termos que você precisa conhecer antes de comparar os quatro níveis de raciocínio do Gemini 4 Hydrogen
- thinking_level: parâmetro de nível de raciocínio que controla a profundidade de inferência do modelo. O Hydrogen aceita quatro valores: Low, Medium, High e XHigh.
- tokens de raciocínio: tokens que o modelo usa para raciocinar antes de entregar a resposta final. Segundo a página oficial de preços do Google, essa parte entra no preço de saída.
- token: unidade usada para medir texto, imagens e outras informações processadas pelo modelo. A API cobra por milhão de tokens.
- Harness: estrutura de teste que organiza as entradas do modelo, executa chamadas de ferramentas e pontua as tarefas. Pontuações obtidas com Harness diferentes não podem ser comparadas diretamente.
- API: interface que permite que programas chamem um serviço. Os exemplos de código deste artigo usam o formato compatível com OpenAI.
Por que o mesmo Gemini 4 Hydrogen tem desempenhos tão diferentes entre os quatro níveis?
Gemini 4 Hydrogen é um modelo de alta eficiência lançado pelo Google DeepMind, voltado principalmente para programação do dia a dia e execução de tarefas por agentes de IA. O ID do modelo na API é gemini-4-hydrogen. Os quatro níveis de raciocínio não são quatro modelos distintos, e sim quatro profundidades de raciocínio do mesmo modelo. A documentação do Google Cloud indica uma tarefa recomendada para cada nível:
| Nível de raciocínio | Uso recomendado | Profundidade de raciocínio | É o padrão? |
|---|---|---|---|
| Low | Tarefas simples, como classificação | Rasa | Não |
| Medium | Programação do dia a dia | Média | Não (nível padrão do 3.8 Flash) |
| High | Agentes com várias etapas | Profunda | ✅ Padrão do Hydrogen |
| XHigh | Raciocínio complexo e profundo | A mais profunda | Não |
Por que a conta muda se o preço unitário dos quatro níveis do Hydrogen é o mesmo?
Até 13 de novembro de 2026, o preço oficial de chamadas Standard do Google é US$ 1.50 por milhão de tokens de entrada e US$ 7.50 por milhão de tokens de saída, sem diferença entre os quatro níveis. A diferença vem do volume de tokens: quanto mais alto o nível, mais tokens de raciocínio o modelo gera antes de responder, e esses tokens são cobrados pelo preço de saída.
Então, “preço unitário igual” não significa “custo igual por tarefa”. A mesma pergunta, no XHigh, pode gerar várias vezes mais conteúdo de raciocínio do que no High, e a conta também aumenta. Ao estimar custos, não basta olhar o comprimento da resposta final; é preciso incluir a parte invisível do raciocínio.
Dados medidos das quatro configurações do Gemini 4 Hydrogen: comparação de pontuação, custo e velocidade
Os dados abaixo vêm da instituição terceirizada Artificial Analysis e a avaliação foi concluída no dia do lançamento. O índice de inteligência, o custo das tarefas de avaliação e o tempo médio vêm do Intelligence Index v5.0.1; a latência do primeiro token de resposta e o total de tokens de saída vêm de um snapshot da página de 13 de novembro de 2026. Todos os resultados são de avaliações padronizadas de terceiros, não testes feitos por este site.
| Nível de raciocínio | Índice de inteligência | Custo médio por tarefa | Tempo médio por tarefa | Latência do primeiro token de resposta | Tokens de saída da avaliação completa |
|---|---|---|---|---|---|
| Low | 27 | US$ 0,29 | 1,3 minutos | cerca de 5,7 segundos | 20,3 milhões |
| Medium | 41 | US$ 0,80 | 3,7 minutos | cerca de 11,8 segundos | 54,4 milhões |
| High (padrão) | 51 | US$ 1,87 | 8,3 minutos | cerca de 18,9 segundos | 110 milhões |
| XHigh | 54 | US$ 3,16 | 13,5 minutos | cerca de 37,8 segundos | 304 milhões |
Não confunda os três indicadores de tempo
Esta tabela traz três tipos de indicadores, com significados diferentes:
- Índice de inteligência: uma pontuação de capacidade que agrega vários benchmarks; indica apenas o nível relativo dentro desse conjunto de avaliações.
- Tempo médio por tarefa: métrica ponderada calculada com base no número de tokens de saída da tarefa e na velocidade de saída ponta a ponta; representa uma carga de trabalho de avaliação padronizada. Quando o usuário faz uma pergunta simples, não necessariamente precisa esperar 8,3 minutos.
- Latência do primeiro token de resposta: tempo de espera desde o envio da solicitação até a visualização do primeiro token de resposta, incluindo a fase de raciocínio do modelo; é o indicador que o usuário mais percebe em cenários de conversa.
Pela tabela, dá para ver que a diferença de pontuação entre Medium e High (10 pontos) é bem maior que entre High e XHigh. Com o mesmo nome de modelo, a diferença real de capacidade entre os níveis pode passar de 20 pontos; ao comparar o Hydrogen com outros modelos, é preciso primeiro confirmar qual nível o outro está usando.
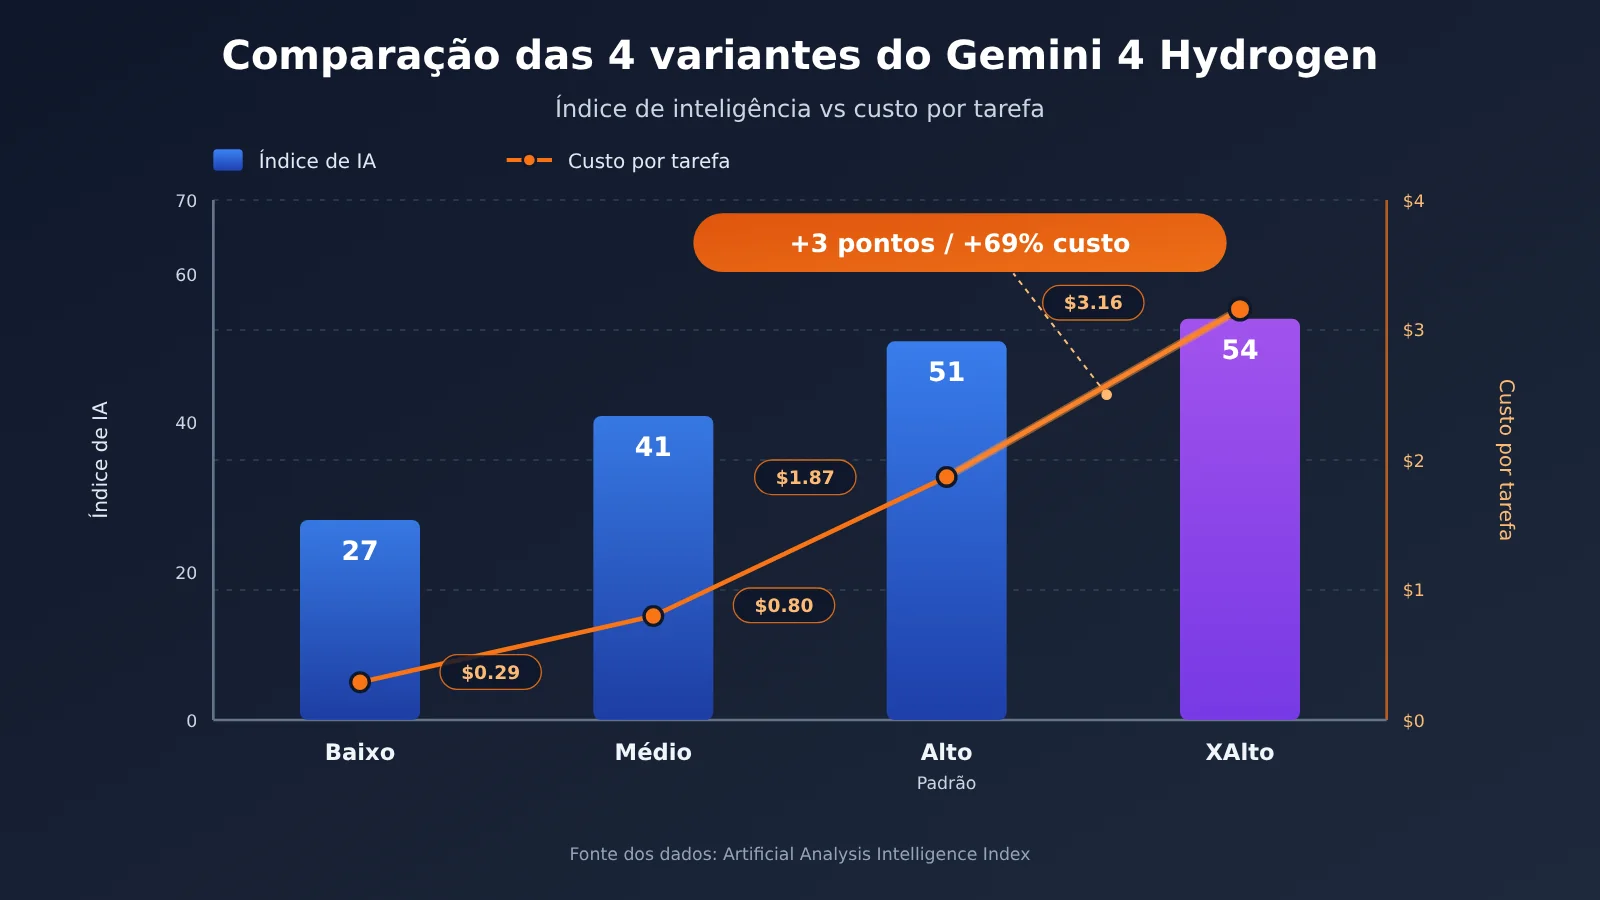
Gemini 4 Hydrogen XHigh vs High: 69% mais caro — e o que exatamente você está comprando?
Comparando as quatro configurações duas a duas, dá para ver o ganho e o custo de cada upgrade. As variações percentuais da tabela abaixo foram calculadas pela redação com base nos dados publicados pela Artificial Analysis.
| Caminho de upgrade | Variação do Índice de Inteligência | Variação do custo por tarefa | Variação do tempo médio | Custo extra por ponto adicional |
|---|---|---|---|---|
| Low → Medium | +14 pontos | +176% | +185% | cerca de $0.036 |
| Medium → High | +10 pontos | +134% | +124% | cerca de $0.107 |
| High → XHigh | +3 pontos | +69% | +63% | cerca de $0.43 |
Retorno decrescente: o custo marginal dos quatro níveis de raciocínio do Hydrogen
Subindo de High para XHigh, o Índice de Inteligência vai de 51 para 54, um ganho de cerca de 5,9%; o custo por tarefa sobe de $1.87 para $3.16, o tempo médio passa de 8,3 minutos para 13,5 minutos e a latência da primeira resposta praticamente dobra, de cerca de 18,9 segundos para cerca de 37,8 segundos. Fazendo as contas por “ponto adicional”, o custo marginal do XHigh é aproximadamente 12 vezes o do Low → Medium.
A explicação está principalmente no consumo de tokens. No conjunto completo de avaliações, o High gera cerca de 110 milhões de tokens de saída, enquanto o XHigh chega a cerca de 304 milhões — aproximadamente 2,76 vezes mais. Só que a fatura não cresce 2,76 vezes, porque o custo total também inclui tokens de entrada, acertos de cache e a forma de ponderação das tarefas de avaliação. Não dá para estimar o custo simplesmente multiplicando o volume de tokens de saída.
Média mais baixa não significa ganho baixo em tarefas complexas
O Índice de Inteligência é o resultado médio de várias tarefas, e uma diferença de 3 pontos pode vir de duas situações: na maioria das tarefas as duas configurações se saem igual, e em algumas tarefas realmente difíceis o XHigh é claramente melhor. Em casos como raciocínio científico, provas matemáticas e refatorações grandes que atravessam vários arquivos — situações em que um erro em um passo compromete tudo — o raciocínio extra do XHigh pode ser justamente o que define se a tarefa sai ou não.
Por isso a forma mais precisa de dizer é: o XHigh tem custo-benefício muito baixo em tarefas comuns, mas pode ser necessário em algumas tarefas de alta dificuldade. Se vale ou não gastar 69% a mais, você precisa verificar com a sua própria amostra de tarefas — não dá para decidir só pelo número médio.
🎯 Dica técnica: comece separando de 20 a 50 tarefas reais e rodando cada uma com High e com XHigh, comparando taxa de sucesso e custo por tarefa. Pelo APIYI apiyi.com, dá para fazer o teste A/B trocando o parâmetro com a mesma chave API, sem mexer na estrutura do código do seu negócio.
Para que tipos de tarefa servem cada um dos quatro níveis de raciocínio do Gemini 4 Hydrogen?
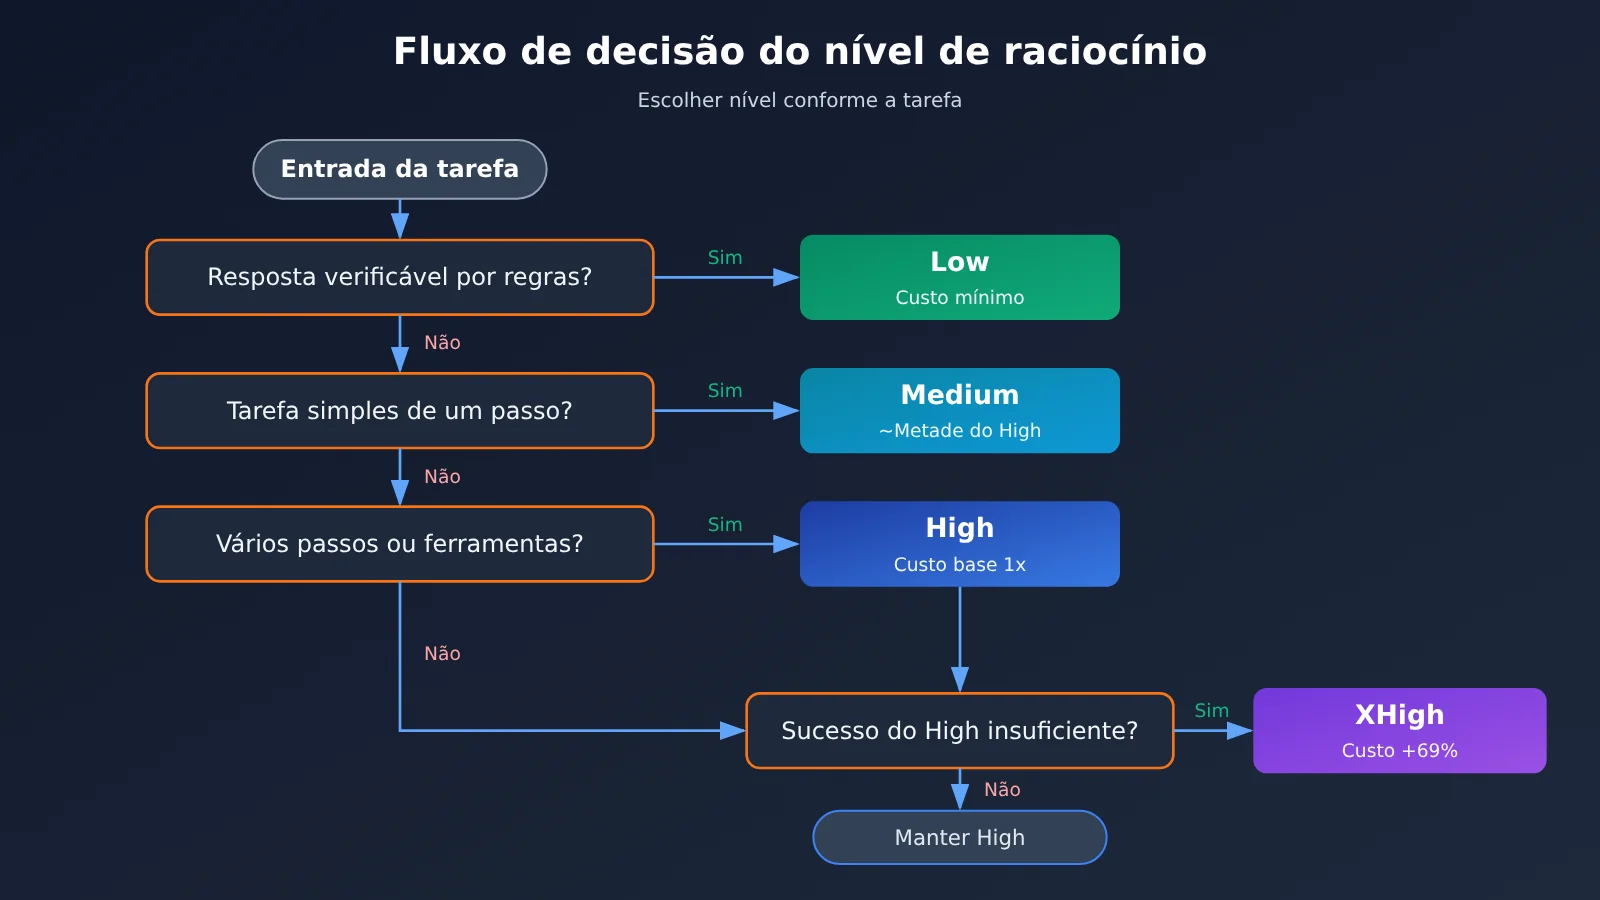
Combinando as recomendações oficiais do Google com os dados de custo acima, dá para montar as sugestões a seguir conforme a dificuldade da tarefa:
| Tipo de tarefa | Nível recomendado | Exemplos típicos | Motivo da escolha |
|---|---|---|---|
| Classificação, extração, organização de formato | Low | Classificação de tickets, extração de campos, formatação JSON, perguntas e respostas simples | Custo mais baixo, latência do primeiro token em cerca de 5.7 segundos, adequado para alta concorrência |
| Código e processamento de conteúdo rotineiros | Medium | Escrever funções em um único arquivo, reescrever textos, resumir documentos, automação de negócios em geral | 14 pontos acima do Low, com custo ainda menos da metade do High |
| Agentes com múltiplas etapas e chamadas de ferramentas | High | Corrigir bugs em vários arquivos, chamar ferramentas em sequência, análise abrangente após recuperação | Nível padrão oficial, com bom equilíbrio entre capacidade e custo |
| Raciocínio de alta complexidade | XHigh | Raciocínio científico, provas matemáticas, refatoração de engenharia de software de grande porte | Use apenas quando a taxa de sucesso do High não for claramente suficiente |
Cenários de uso dos níveis baixos do Hydrogen
Low e Medium são adequados para cenários em que o objetivo da tarefa é claro e a resposta é fácil de verificar. Por exemplo, extrair valores e datas de um contrato, ou dividir o feedback dos usuários em dez categorias: nesses casos, pensar mais um pouco dificilmente aumenta a precisão — só acrescenta latência e custo. Em cenários sensíveis à latência do primeiro token, como chat em tempo real e autocompletar de busca, os cerca de 5.7 segundos do Low são claramente melhores que os cerca de 37.8 segundos do XHigh.
Cenários de uso dos níveis altos do Hydrogen
O High é o nível padrão definido pelo Google e serve para a maioria dos fluxos de trabalho com agentes. Só vale subir para o XHigh quando a tarefa entra na situação de “o High falha repetidamente e o custo das retentativas já passou do custo de subir de nível”. Vale lembrar que o model card oficial do Google também observa que níveis de raciocínio mais altos podem aumentar bastante o tempo de execução e o custo, com eventuais atrasos ou timeouts — em tarefas de cadeia longa, configure bem as políticas de timeout e retentativa.
Como os desenvolvedores podem controlar o custo de raciocínio do Gemini 4 Hydrogen
O parâmetro thinking_level e os valores padrão
O Hydrogen escolhe o nível de raciocínio por meio do parâmetro thinking_level. Quando ele não é informado, o padrão é High. Ao migrar do Gemini 3.8 Flash, há alguns pontos de atenção:
- O 3.8 Flash usa Medium por padrão. Após a migração, se você não passar o parâmetro, ele muda automaticamente para High, e a fatura pode aumentar.
thinking_budgeteMINIMALnão são mais suportados; usá-los retorna HTTP 400.- Valores personalizados de temperature, top_p e top_k são ignorados.
- Chamadas de ferramentas em múltiplos turnos exigem salvar e reenviar corretamente as thought signatures.
Exemplo minimalista: chamar o Hydrogen por nível
Abaixo usamos o formato compatível com OpenAI, passando o nível de raciocínio via extra_body. Plataformas diferentes podem usar nomes de campo diferentes para repassar esse parâmetro — consulte a documentação da plataforma para saber o nome exato.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "Classifique este feedback: reembolso muito lento"}],
    extra_body={"thinking_level": "low"}  # Use Low para classificação simples
)
print(resp.choices[0].message.content)
Ver o código completo: classificação por dificuldade da tarefa e escalonamento automático de nível
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Mapeamento entre tipo de tarefa e nível padrão
LEVEL_MAP = {
    "classify": "low",
    "extract": "low",
    "content": "medium",
    "code": "medium",
    "agent": "high",
    "reasoning": "xhigh",
}
ESCALATE = {"low": "medium", "medium": "high", "high": "xhigh"}


def call_hydrogen(prompt: str, level: str) -> tuple[str, dict]:
    resp = client.chat.completions.create(
        model="gemini-4-hydrogen",
        messages=[{"role": "user", "content": prompt}],
        extra_body={"thinking_level": level},
    )
    usage = resp.usage.model_dump() if resp.usage else {}
    return resp.choices[0].message.content, usage


def run_task(prompt: str, task_type: str, validator=None,
             max_level: Optional[str] = "high") -> str:
    """Começa com nível baixo; se a validação falhar, sobe um nível por vez. max_level limita o nível máximo"""
    level = LEVEL_MAP.get(task_type, "medium")
    while True:
        answer, usage = call_hydrogen(prompt, level)
        print(f"[{level}] usage={usage}")  # Registra os tokens para calcular o custo de tarefas bem-sucedidas
        if validator is None or validator(answer):
            return answer
        if level == max_level or level not in ESCALATE:
            return answer
        level = ESCALATE[level]


result = run_task(
    prompt="Extraia o número do pedido, retorne apenas os dígitos: pedido A-20261113-889 já foi enviado",
    task_type="extract",
    validator=lambda s: s.strip().replace("-", "").isalnum(),
)
print(result)
🚀 Início rápido: a APIYI apiyi.com oferece uma interface compatível com OpenAI. Com uma única chave API você pode chamar modelos populares como Gemini, Claude e OpenAI, e novos usuários ganham cota gratuita para testes — ideal para validar a estratégia de níveis acima antes de colocar em produção.
Estratégia de níveis: começar pelo nível baixo e só subir se falhar
A abordagem recomendada é “nível baixo por padrão, subir conforme a necessidade”: tarefas simples ficam fixas em Low ou Medium; tarefas complexas começam em High e só sobem para XHigh quando a validação falha; e cada tipo de tarefa tem um teto de nível máximo, para evitar explosões inesperadas de custo. Isso segue a mesma lógica do Google no Antigravity Orchestrator, que divide o trabalho entre modelos diferentes — só que aqui o que se ajusta é a profundidade de raciocínio de um único modelo.
Como medir o efeito da otimização de níveis do Hydrogen com quatro métricas
| Métrica de otimização | Como é calculada | Por que acompanhar |
|---|---|---|
| Taxa de acerto / taxa de sucesso | Tarefas aprovadas na validação ÷ total de tarefas | A qualidade não pode cair de forma perceptível depois de baixar o nível |
| Tempo ponta a ponta | Tempo total da requisição até obter um resultado utilizável, incluindo novas tentativas | A latência do primeiro token é só uma parte disso |
| Consumo de tokens | Tokens de entrada + saída (incluindo raciocínio) | Tokens de raciocínio são cobrados pelo preço de saída |
| Custo por tarefa bem-sucedida | Custo total ÷ tarefas bem-sucedidas | Um nível baixo que falha e repete muito pode sair mais caro que um nível alto |
O “custo por tarefa bem-sucedida” é a métrica que melhor reflete o gasto real. Se 30% das tarefas em Medium precisam ser refeitas, enquanto High acerta de primeira, o custo por tarefa bem-sucedida em High pode até ser menor.
Perguntas frequentes
Q1: Os quatro níveis de pensamento do Gemini 4 Hydrogen são quatro modelos diferentes?
Não. Os quatro níveis são apenas profundidades de raciocínio distintas do mesmo modelo `gemini-4-hydrogen`, alternadas pelo parâmetro thinking_level. O preço por Token é o mesmo; a diferença está na quantidade de Tokens de pensamento gerados.
Q2: Se o XHigh só é 3 pontos melhor que o High, não vale a pena usá-lo de jeito nenhum?
Não é bem assim. Esses 3 pontos são a diferença média em várias tarefas; em raciocínio científico, provas matemáticas e grandes tarefas de engenharia, o XHigh pode ser o que decide se a tarefa é concluída ou não. Para tarefas comuns o custo-benefício do XHigh é baixo, mas para poucas tarefas de alta dificuldade ele pode ser necessário.
Q3: O tempo médio de 8,3 minutos do High significa que toda pergunta vai demorar tudo isso?
Não. Os 8,3 minutos são o tempo ponderado das tarefas padronizadas de avaliação da Artificial Analysis. Para conversas comuns, o mais relevante é a latência até o primeiro Token da resposta: cerca de 18,9 segundos no High e cerca de 5,7 segundos no Low. A duração real também depende do tamanho da tarefa.
Q4: O que acontece se eu não passar thinking_level?
O padrão é High. Projetos migrados do Gemini 3.8 Flash (cujo padrão é Medium) que mantêm o código antigo sem passar o parâmetro verão o nível de pensamento subir automaticamente, e o custo pode aumentar junto. Recomendo definir o nível explicitamente.
Q5: Como comparar rapidamente o efeito dos diferentes níveis no meu próprio negócio?
A sugestão é preparar um lote de amostras de tarefas reais, rodar cada nível e registrar a taxa de sucesso e o consumo de Tokens:
1. Registre-se na APIYI apiyi.com e obtenha a chave API e a cota gratuita de testes
2. Use o código deste artigo e altere o valor de `thinking_level`
3. Escolha o nível mais adequado com base no “custo por tarefa bem-sucedida”
Q6: Quais problemas conhecidos existem nos níveis altos de pensamento do Hydrogen?
O model card do Google menciona que níveis altos de pensamento podem aumentar bastante o tempo e o custo, além de ocasionais atrasos ou timeouts. Também há relatos de usuários no Hacker News sobre execução excessiva em algumas tarefas de Agent. Recomendo definir timeout, nível máximo e condições de parada para tarefas longas.
Q7: Ao estimar custos por Token, qual é o erro mais comum?
Estimar apenas pelo número de caracteres da resposta final. Os Tokens de pensamento entram no preço de saída, e o total de Tokens de saída do XHigh na bateria completa de avaliações é cerca de 2,76 vezes o do High. Consultar o detalhamento real de uso no console da APIYI apiyi.com é mais confiável do que estimar manualmente.
Principais conclusões: os quatro níveis de pensamento do Gemini 4 Hydrogen
- Mesmo modelo, níveis diferentes: o preço unitário dos quatro níveis é o mesmo; o custo real da tarefa é determinado pela quantidade de tokens de pensamento utilizada.
- Retornos decrescentes evidentes: de High → XHigh ganha-se 3 pontos, e o custo da tarefa de avaliação aumenta cerca de 69%.
- Latência dobrada: a latência da primeira resposta no XHigh é de cerca de 37,8 segundos, o dobro do High.
- O padrão é High: ao migrar do 3.8 Flash, é preciso definir explicitamente o nível.
- Escolha o nível pela dificuldade: use Low para classificação, Medium para o comum, High para Agents e XHigh apenas para tarefas difíceis.
- Olhe para o custo das tarefas bem-sucedidas: inclua também as novas tentativas para comparar o gasto real dos diferentes níveis.
- Valide com amostras: você pode usar uma única chave no APIYI apiyi.com para comparar o desempenho dos quatro níveis.
Resumo
As principais conclusões da comparação dos quatro níveis de pensamento do Gemini 4 Hydrogen:
- Grande diferença de capacidade: de 27 pontos no Low a 54 pontos no XHigh — sob o mesmo nome de modelo, a capacidade dobra.
- Custo marginal crescente: o custo extra por cada 1 ponto adicional sobe de cerca de US$ 0,036 na transição Low → Medium para cerca de US$ 0,43 na transição High → XHigh.
- Use o XHigh conforme a necessidade: a diferença na pontuação média é pequena, mas ainda pode ser decisiva para algumas tarefas de alta dificuldade.
A recomendação para o dia a dia é: definir explicitamente o thinking_level, usar o nível baixo para tarefas simples, subir o nível em etapas complexas e usar o custo das tarefas bem-sucedidas como métrica final.
Recomendamos validar rapidamente o desempenho de cada nível com amostras de tarefas reais no APIYI apiyi.com; a plataforma oferece interface compatível com OpenAI e cota gratuita para testes.
📚 Materiais de Referência
- Artificial Analysis – Página de avaliação do Gemini 4 Hydrogen nas quatro configurações: índice de inteligência, custo por tarefa, duração e dados de latência
- Link:
artificialanalysis.ai/models/gemini-4-hydrogen-low - Link:
artificialanalysis.ai/models/gemini-4-hydrogen-medium - Link:
artificialanalysis.ai/models/gemini-4-hydrogen-high - Link:
artificialanalysis.ai/models/gemini-4-hydrogen -
Descrição: fonte de todos os dados comparativos das quatro configurações deste artigo; a latência é um indicador dinâmico
-
Blog oficial do Google – Introducing Gemini 4 Hydrogen: anúncio de lançamento
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Descrição: posicionamento do modelo, escopo de capacidades e casos de parceiros
-
Guia do Desenvolvedor do Google Cloud – Gemini 4 Hydrogen:
thinking_levele considerações de migração - Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Descrição: usos recomendados para as quatro configurações, configuração padrão, parâmetros incompatíveis
-
Página de preços do Google AI Studio: preços oficiais da API do Hydrogen
- Link:
aistudio.google.com/docs/pricing -
Descrição: preços dos modos Standard, Batch, Flex e Priority, regras de cobrança de tokens de raciocínio
-
Cartão de Modelo do Google DeepMind: limitações e avaliação de segurança
- Link:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - Descrição: riscos de duração nos níveis de raciocínio alto, recusas de resposta e alucinações, entre outros problemas conhecidos
Autor: equipe técnica da APIYI
Contato técnico: fique à vontade para falar conosco pela página inicial do site oficial da APIYI e obter mais materiais sobre a integração dos modelos da série Gemini