Nota do autor: este artigo explica as causas e as soluções para os erros 429, 401 e 500 em APIs de IA. Você verá quais erros devem ser tratados com novas tentativas, quais exigem ajustes na configuração e quando usar backoff exponencial, fallback entre modelos e circuit breaker.
Ao invocar um Modelo de Linguagem Grande em produção, muitos desenvolvedores já se depararam com uma sequência de erros 429, 401 e 500 no grupo de alertas durante a madrugada. Uma reação comum é adicionar novas tentativas a todas as requisições que falharam, mas isso costuma piorar a situação. Neste artigo, vamos analisar como diagnosticar os erros 429, 401 e 500 em APIs de IA e projetar soluções tolerantes a falhas, substituindo as “tentativas às cegas” por um tratamento específico para cada caso.
Este não é um artigo introdutório sobre códigos de status HTTP, mas um guia prático para operações em produção. Vamos abordar as causas típicas de cada erro, quando vale tentar novamente, como implementar a lógica de tratamento na camada de aplicação e como dividir a responsabilidade pela tolerância a falhas entre o gateway e a aplicação.
O que você vai aprender: ao final da leitura, você conseguirá identificar em poucos minutos se um erro pede uma nova tentativa, um fallback ou uma correção imediata na configuração. Também saberá quando usar backoff exponencial, fallback entre modelos e circuit breaker.
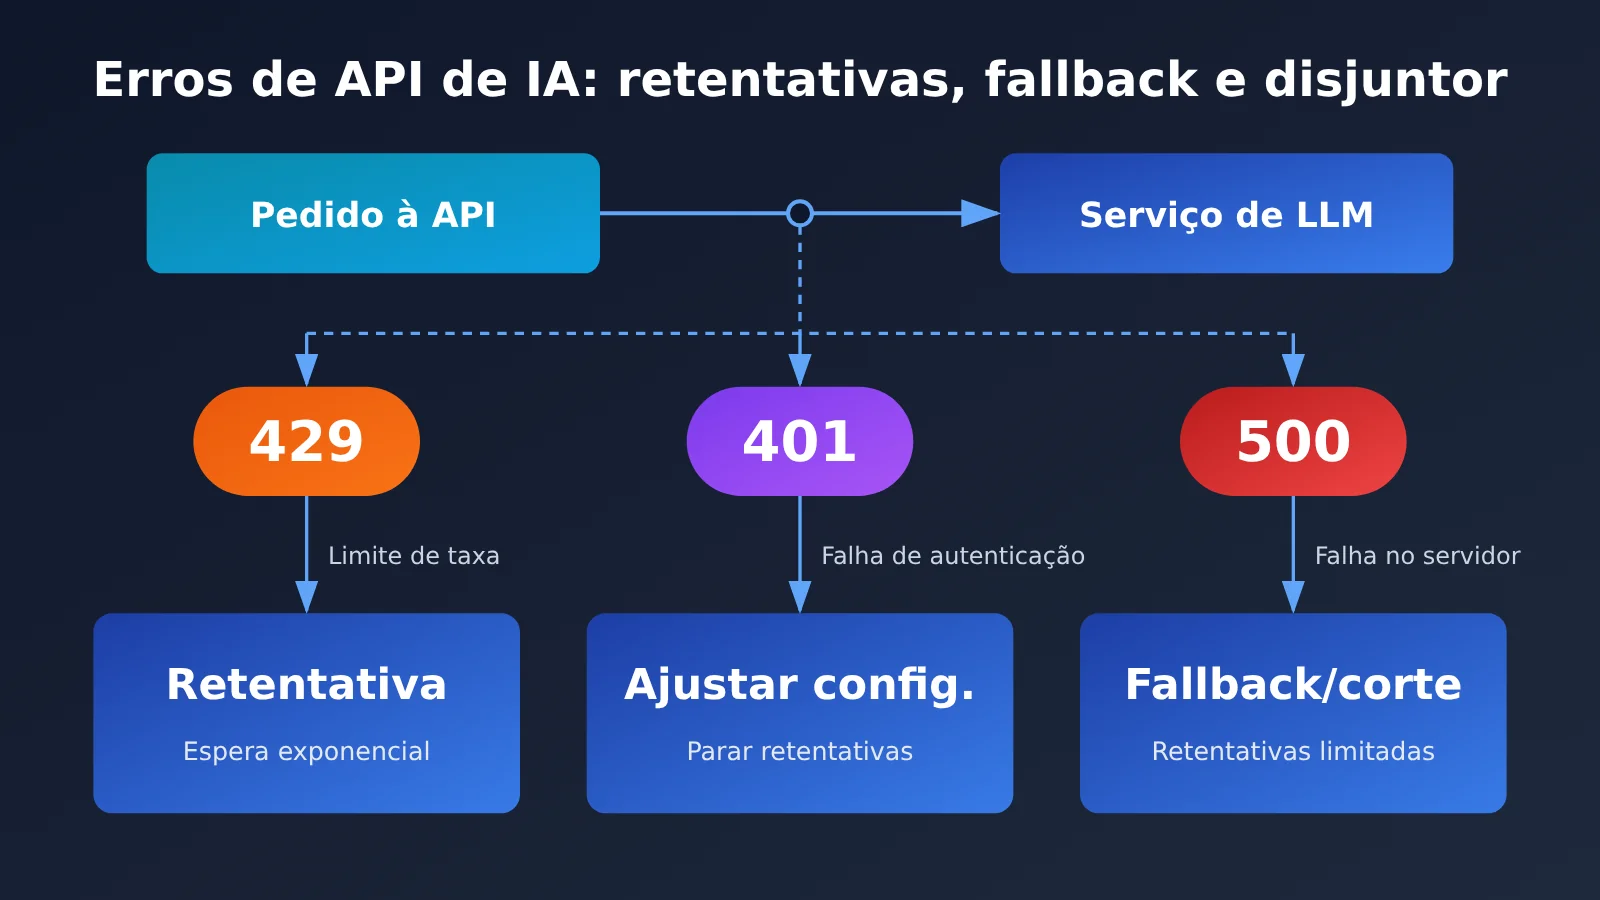
Pontos principais sobre erros 429, 401 e 500 em APIs de IA
Ao lidar com erros em APIs de IA, o primeiro passo é classificá-los. Depois, avalie se vale a pena tentar novamente. Cada código indica um tipo de problema: alguns se resolvem após uma espera, enquanto outros continuarão falhando independentemente do número de tentativas. A tabela resume as categorias.
| Categoria de erro | Códigos de status típicos | Natureza do problema | Pode tentar novamente? | Como resolver |
|---|---|---|---|---|
| Limite de requisições | 429 | Requisições rápidas demais ou cota esgotada | Depende da causa | Ler Retry-After, usar recuo exponencial e distinguir limite de requisições de cota insuficiente |
| Autenticação | 401, 403 | Chave inválida ou permissões insuficientes | Não | Interromper as tentativas, emitir um alerta e corrigir a configuração |
| Servidor | 500, 502, 503, 504 | Falha ou sobrecarga no serviço de origem | Sim, com limite | Fazer um número limitado de tentativas com recuo e, se as falhas persistirem, usar uma alternativa ou acionar um disjuntor |
| Requisição | 400, 404, 413, 422 | Parâmetros, nome do modelo ou comprimento incorretos | Não | Registrar o corpo da requisição e corrigir os parâmetros antes de reenviá-la |
Em resumo, a decisão de tentar novamente depende de o erro ser temporário ou determinístico. Para erros temporários, como limites de requisições ou instabilidade no serviço de origem, novas tentativas fazem sentido. Para erros determinísticos, como chave ou parâmetros incorretos, elas só desperdiçam cota, atrasam a resposta e podem até acionar limites mais rígidos.
Tabela de decisão para códigos de erro de APIs de IA
Na prática, olhar apenas o código de status não basta: também é preciso considerar o campo de tipo de erro no corpo da resposta e os cabeçalhos. A tabela abaixo pode ser usada diretamente para definir a lógica da aplicação.
| Sinal observado | Causa provável | Ação recomendada | Conta para o circuit breaker? |
|---|---|---|---|
429 com o cabeçalho Retry-After |
Limite de taxa | Aguardar o tempo indicado no cabeçalho e tentar novamente | Não |
| 429 com erro indicando cota ou saldo insuficiente | Cota da conta esgotada | Não tentar novamente; gerar um alerta para recarregar o saldo ou trocar de conta | Não |
| 401 | Chave incorreta, expirada ou em formato inválido | Não tentar novamente; verificar a chave e as variáveis de ambiente | Não |
| 403 | A chave não tem permissão para acessar o modelo ou a região | Não tentar novamente; verificar as permissões e se o modelo está habilitado | Não |
| 500 / 502 | Erro interno no serviço upstream ou falha de encaminhamento no gateway | Tentar novamente 2 a 3 vezes, com backoff | Sim |
| 503 | Serviço sobrecarregado ou em manutenção | Tentar novamente com backoff; se falhar, usar uma alternativa | Sim |
| 504 ou timeout do cliente | Geração muito longa ou resposta lenta do serviço upstream | Decidir se uma nova tentativa é adequada conforme a idempotência; considerar aumentar o timeout | Sim |
O ponto mais fácil de deixar passar é que o erro 429 pode ter dois significados. Alguns provedores também retornam 429 quando a cota acaba, mas o campo de tipo no corpo do erro é diferente do usado para limite de taxa. Se a aplicação olhar apenas o código de status, pode continuar tentando indefinidamente com backoff uma requisição que falhou por saldo insuficiente. Os logs ficam cheios de erros 429, mas a situação não se resolve.
Entendendo o erro 429 de limite de requisições
O erro 429 ocorre quando o número de requisições ou tokens ultrapassa o limite permitido em um intervalo de tempo. As APIs de Modelos de Linguagem Grande costumam ter limites em várias dimensões: requisições por minuto, tokens por minuto e, em alguns casos, requisições simultâneas. Por isso, mesmo com poucas requisições, enviar um contexto muito longo de uma só vez pode causar um erro 429.
Há três princípios para tratar o erro 429 na aplicação. Primeiro, respeite o cabeçalho Retry-After ou outro cabeçalho semelhante que indique quando o limite será redefinido, em vez de tentar adivinhar o tempo de espera. Segundo, na ausência dessas informações, use recuo exponencial com variação aleatória para evitar que muitos clientes retomem as requisições ao mesmo tempo e esgotem o limite novamente. Terceiro, controle o fluxo na origem: usar um token bucket ou uma fila para limitar a concorrência é mais eficaz do que tentar novamente depois do erro.
Entendendo o erro 401 de autenticação
O erro 401 é um dos que menos justificam uma nova tentativa. Ele quase sempre é causado por um problema de configuração. Entre os casos comuns estão: espaços ou quebras de linha extras ao copiar a chave, variáveis de ambiente não injetadas corretamente no contêiner, uso de uma chave de teste em produção, chave substituída ou revogada, ou formato incorreto no cabeçalho de autenticação.
Em interfaces compatíveis com a OpenAI, outra causa frequente é a incompatibilidade entre base_url e a chave, como usar a chave da plataforma A para acessar o endereço da plataforma B. Por isso, ao receber um erro 401, a aplicação deve interromper imediatamente as tentativas, disparar um alerta de alta prioridade e registrar os primeiros caracteres da chave e o endereço da requisição nos logs para facilitar a identificação do problema. Nunca registre a chave completa.
Entendendo os erros 500 do servidor
Os erros da série 500 indicam um problema no servidor ou na comunicação entre serviços. A causa pode ser uma falha interna no serviço do modelo, sobrecarga ou uma falha no encaminhamento pelo gateway. Esses erros costumam ser temporários, então vale tentar novamente um número limitado de vezes. Mas, se persistirem, é sinal de que o serviço está instável. Continuar tentando só acumulará solicitações e ocupará as threads; nesse caso, é melhor recorrer a um modelo alternativo ou acionar um circuit breaker.
Também é importante prestar atenção aos erros 504 e aos tempos limite do cliente. A geração de textos longos por um Modelo de Linguagem Grande já é lenta por natureza. Se o tempo limite for muito curto, uma solicitação normal, mas demorada, pode ser interpretada como falha e enviada novamente. Isso pode gerar cobranças duplicadas e, se a resposta em streaming for interrompida, o frontend também pode receber conteúdo truncado.
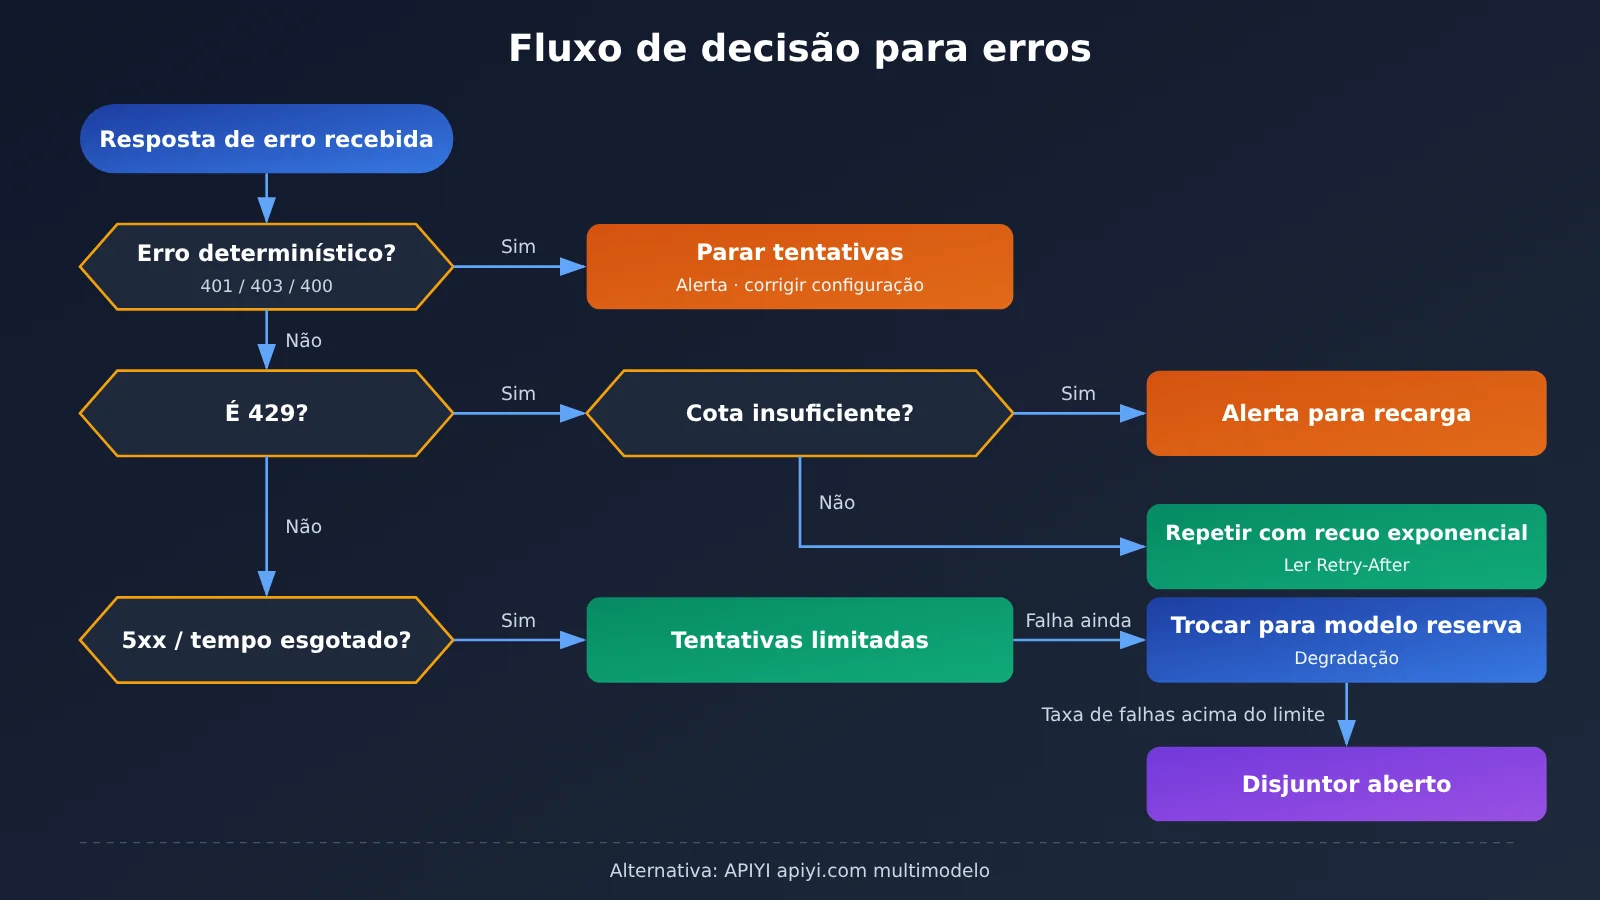
Primeiros passos com retentativas, fallback e circuit breaker em APIs de IA
Depois de classificar os erros, é hora de implementar a lógica de tratamento. Conforme solicitado, esta seção não traz blocos de código: vamos explicar os pontos principais de cada mecanismo com listas de parâmetros e etapas, para que você possa implementá-los em qualquer linguagem.
Como implementar retentativas com backoff exponencial
A ideia do backoff exponencial é aumentar o tempo de espera a cada retentativa e acrescentar uma variação aleatória, chamada jitter. Você pode organizar a lógica assim:
- Defina o conjunto de erros que permitem retentativa, como
429(exceto quando a cota estiver esgotada),500,502,503,504e tempos limite de rede. - Após cada falha, verifique o cabeçalho
Retry-Afterda resposta. Se estiver presente, aguarde o tempo indicado; caso contrário, calcule a espera pela fórmula de backoff. - A fórmula costuma ser “intervalo base × 2 elevado ao número de retentativas”. Acrescente um valor aleatório de jitter e defina um limite para cada espera.
- Defina o número máximo de retentativas e o tempo total disponível. Se qualquer um dos limites for atingido, interrompa as tentativas e encaminhe o erro para a lógica de fallback.
- Registre cada retentativa em log, incluindo código de erro, número da tentativa, tempo de espera e nome do modelo, para facilitar a análise posterior.
Se você usa um SDK oficial, confira se ele já oferece parâmetros como max_retries e timeout. Nesse caso, evite adicionar outra camada com as mesmas retentativas: o número de tentativas pode se multiplicar, ampliando o volume de requisições durante uma falha.
A tabela abaixo traz valores iniciais comuns, baseados na prática. Ajuste-os conforme os requisitos de latência da sua aplicação e os limites do provedor.
| Parâmetro | Significado | Valor inicial comum | Critério de ajuste |
|---|---|---|---|
max_retries |
Número máximo de retentativas | 2 a 5 | Use valores menores para conversas em tempo real e maiores para processamento em lote offline |
| Intervalo base | Espera antes da primeira retentativa | Cerca de 1 segundo | Aumente para serviços com limites de taxa mais rigorosos |
| Limite por espera | Teto do tempo de backoff | Dezenas de segundos | Evite que uma espera longa demais comprometa a requisição |
| Jitter | Distribui as retentativas ao longo do tempo | Valor aleatório correspondente a uma parte do tempo de espera | Quanto mais clientes simultâneos, mais necessário |
| Tempo total disponível | Duração máxima de uma chamada | Definido conforme o SLA da aplicação | Após o tempo limite, acione o fallback diretamente |
🚀 Comece rápido: para simular o comportamento das retentativas diante de diferentes códigos de erro durante os testes, você pode usar a APIYI apiyi.com para acessar vários modelos por uma interface unificada compatível com a OpenAI. Assim, é possível observar as respostas e os erros de cada modelo com a mesma lógica de retentativa, reduzindo o trabalho de adaptação para cada provedor.
Como projetar o fallback entre modelos
As tentativas de repetição resolvem o problema de um modelo temporariamente indisponível. O fallback entra em cena quando esse modelo não deve se recuperar em pouco tempo. A ideia é configurar uma cadeia de alternativas: após falhas consecutivas no modelo principal, o sistema muda para os modelos de reserva em ordem, garantindo que a aplicação continue respondendo. Em troca, pode haver alguma perda de qualidade ou aumento de custo.
Ao projetar essa cadeia, é importante verificar se os recursos são equivalentes. Se o modelo principal depende de chamadas de função, saída estruturada ou contexto longo, os modelos de reserva também precisam oferecer suporte a esses recursos. Caso contrário, o fallback pode causar novos erros 400 ou falhas na análise do formato de saída. A tabela abaixo apresenta sugestões de cadeias de fallback para diferentes cenários.
| Cenário | Modelo principal | Primeira alternativa | Segunda alternativa | Plataformas disponíveis |
|---|---|---|---|---|
| Atendimento ao cliente online | Modelo de uso geral de alta qualidade | Modelo equivalente de outro fornecedor | Modelo leve e rápido + respostas simplificadas | APIYI apiyi.com, APIs oficiais dos fornecedores |
| Geração e revisão de código | Modelo de ponta com forte capacidade de programação | Modelo de ponta de outro fornecedor | Retornar uma mensagem pedindo para tentar novamente mais tarde | APIYI apiyi.com, APIs oficiais dos fornecedores |
| Processamento de conteúdo em lote | Modelo com bom custo-benefício | Outro modelo na mesma faixa de preço | Adicionar à fila para processamento posterior | APIYI apiyi.com, APIs oficiais dos fornecedores |
| Extração de informações estruturadas | Modelo com suporte a saída JSON | Outro modelo com suporte a saída estruturada | Usar um mecanismo de regras como alternativa | APIYI apiyi.com, APIs oficiais dos fornecedores |
Há alguns detalhes importantes a considerar no fallback:
- Adaptação dos comandos: cada modelo reage de forma diferente aos comandos de sistema. O ideal é que cada modelo de reserva tenha sua própria versão de comando, já validada.
- Comprimento do contexto: antes da troca, verifique se o tamanho das mensagens excede a janela de contexto do modelo de reserva. Se necessário, reduza o histórico.
- Identificação dos resultados: registre nos logs e no monitoramento que a resposta veio de um modelo de fallback. Isso facilita a avaliação do impacto na qualidade.
- Não use fallback para erros de autenticação: um erro 401 indica um problema de configuração. Trocar de modelo só vai mascarar o problema; em vez disso, gere um alerta imediatamente.
Como funciona o circuit breaker e quando usá-lo
O circuit breaker, ou disjuntor, impede que uma dependência com falhas persistentes comprometa todo o sistema. Ele costuma ter três estados: fechado, quando as solicitações passam normalmente e a taxa de falhas é monitorada; aberto, quando a taxa ou o número de falhas consecutivas ultrapassa um limite e as solicitações são rejeitadas ou encaminhadas para uma alternativa, sem acessar o serviço upstream com falha; e semiaberto, após um período de espera, quando algumas solicitações de teste são liberadas. Se tiverem sucesso, o disjuntor volta ao estado fechado; se falharem, ele abre novamente.
O essencial é contabilizar apenas erros que representem a saúde do serviço upstream. Erros 5xx e timeouts devem entrar na taxa de falhas, mas erros do cliente, como 401 e 400, não. Caso contrário, um erro de configuração pode abrir o disjuntor e fazer com que todas as solicitações válidas sejam rejeitadas. Um erro 429 causado por falta de quota também não deve ser contabilizado: ele reflete o estado da conta, não a saúde do serviço.
Isso não significa que circuit breakers sejam sempre necessários. Em ferramentas internas com pouco tráfego, a amostra é pequena demais para calcular uma taxa de falhas confiável, o que pode levar a disparos indevidos. Nesses casos, uma combinação simples de novas tentativas e uma alternativa de contingência já basta. O circuit breaker é mais adequado para serviços em produção com alta concorrência: ele limita rapidamente os danos quando o upstream apresenta falhas generalizadas e evita que solicitações lentas esgotem os pools de threads e conexões.
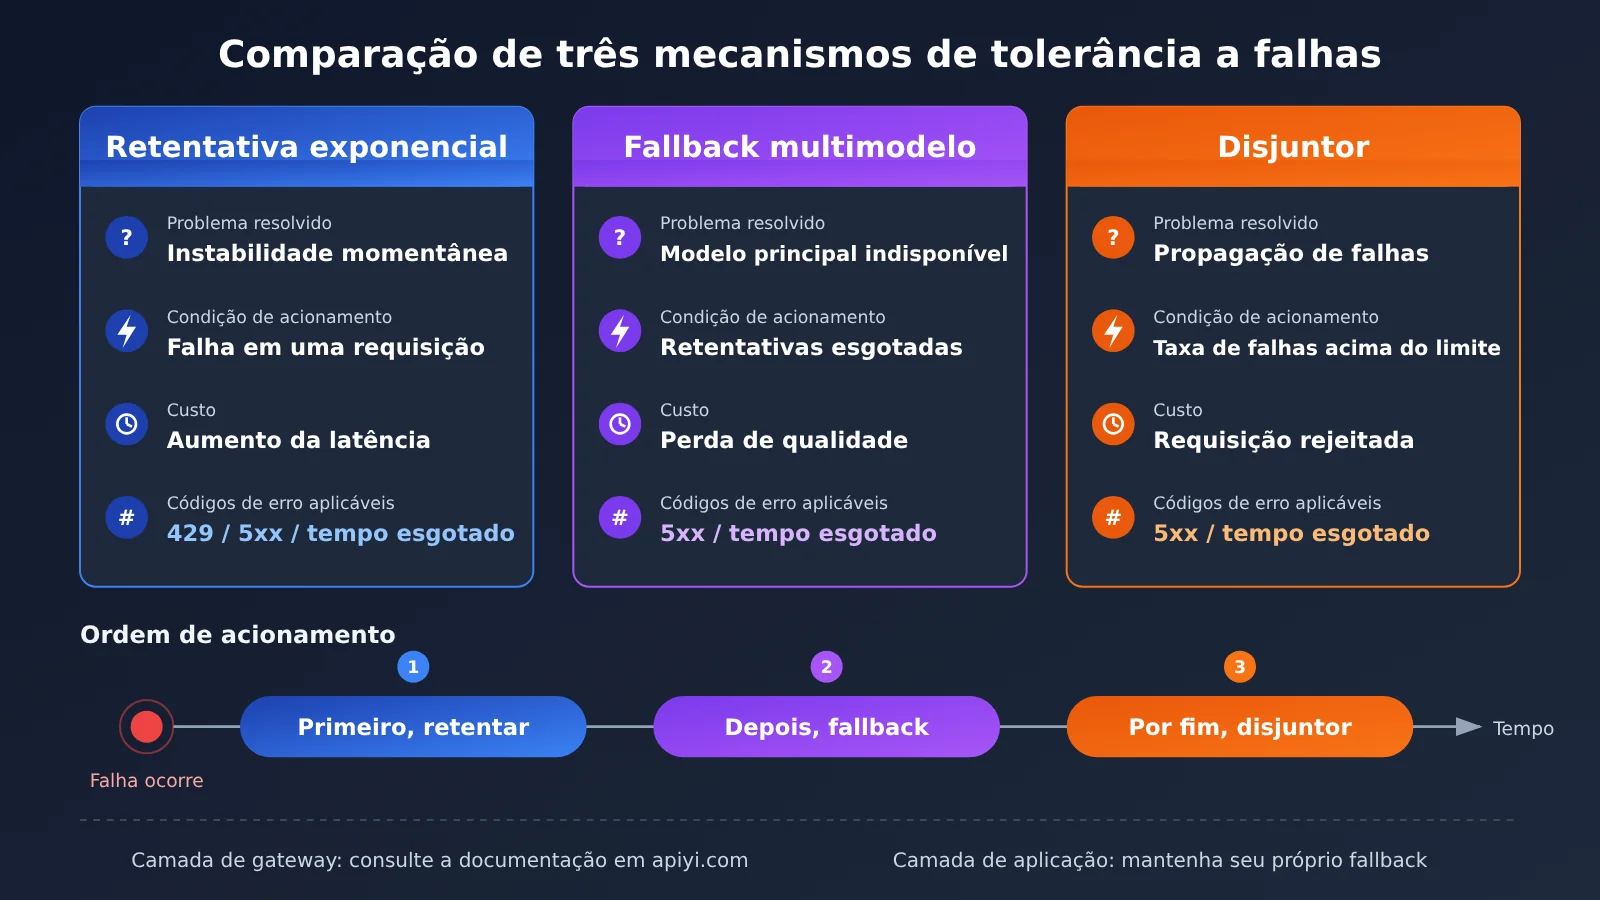
Divisão da tolerância a falhas entre gateway e aplicação
Cada vez mais equipes acessam Modelos de Linguagem Grande por meio de gateways de API ou plataformas agregadoras. Nesse cenário, surge uma dúvida comum: se o gateway já oferece fallback automático, a aplicação ainda precisa implementar novas tentativas e circuit breaker? Sim, mas com responsabilidades diferentes. O gateway lida melhor com problemas nos canais de provedores, enquanto a aplicação entende melhor as necessidades do negócio.
| Responsabilidade | Mais adequada ao gateway | Mais adequada à aplicação |
|---|---|---|
| Troca de canal em caso de falha | Alternância entre canais para o mesmo modelo e balanceamento de carga | Não precisa implementar novamente |
| Fallback entre modelos | Pode oferecer roteamento de modelos | Decide se o negócio aceita uma redução de qualidade e se é necessário alterar o comando |
| Novas tentativas | Tentativas rápidas no nível do canal | Limite de tentativas de negócio, considerando o tempo de espera do usuário |
| Circuit breaker | Verificações de saúde dos canais de provedores | Circuit breaker e alternativa de contingência quando todo o gateway estiver inacessível |
| Erros de autenticação e limites de uso | Retorna tipos de erro claros | Gera alertas, interrompe novas tentativas e solicita intervenção humana |
| Monitoramento | Taxa de sucesso e latência dos canais | Taxa de sucesso do negócio, proporção de fallbacks e impacto nos usuários |
A APIYI, por exemplo, menciona em sua apresentação recursos de estabilidade como fallback automático, balanceamento de carga e monitoramento em tempo real. Esses recursos são adequados para lidar com falhas nos canais, permitindo que a aplicação se concentre nas alternativas de contingência para o negócio. Ainda assim, é preciso consultar a documentação da plataforma e fazer testes para verificar se as condições que acionam o fallback no gateway, os códigos de erro e o formato do corpo das respostas são idênticos aos da API oficial. A expressão “sem limite de concorrência” usada na apresentação também não significa que erros 429 nunca ocorrerão: os limites dos próprios modelos acessados continuam existindo. Para maior segurança, a aplicação deve sempre manter a lógica de tratamento de erros 429 e 5xx e ter seu próprio plano de contingência para quando o gateway estiver totalmente inacessível.
🎯 Recomendação técnica: depois de integrar o gateway, provoque intencionalmente alguns tipos de erro no ambiente de testes. Por exemplo, use uma chave incorreta, solicite um nome de modelo inexistente ou envie um contexto longo demais. Registre os códigos de status e os campos do corpo de erro que a APIYI apiyi.com realmente retorna e ajuste as regras de classificação de erros da aplicação com base nesses dados, em vez de simplesmente copiar o formato de erros da documentação oficial.
Perguntas frequentes (FAQ)
Q1: Qual é a diferença fundamental entre os erros 429 e 500 em uma API de IA?
O erro 429 indica que suas requisições ultrapassaram um limite, seja pela frequência de chamadas ou pela cota da conta. Já o erro 500 indica uma falha no servidor do provedor. No primeiro caso, reduza a frequência e respeite o tempo de espera; no segundo, tente novamente um número limitado de vezes e, se a falha persistir, acione o fallback. Ambos podem se resolver depois de um tempo, mas exigem tratamentos diferentes.
Q2: Por que nunca fazer novas tentativas automáticas após um erro 401?
O erro 401 é determinístico: se a chave estiver incorreta, o resultado será o mesmo mesmo depois de dez mil tentativas. Além de desperdiçar recursos, as tentativas automáticas podem esconder o problema e atrasar os alertas. O correto é interromper a operação imediatamente e verificar o conteúdo da chave, a injeção das variáveis de ambiente e se o endereço da requisição corresponde ao esperado.
Q3: O que pode causar um erro 429 que não desaparece, mesmo após várias tentativas?
A causa mais comum é o esgotamento da cota ou do saldo. Alguns provedores também retornam 429 nessa situação, mas o campo de tipo no corpo do erro é diferente daquele usado para uma limitação comum de frequência. Outra possibilidade é que suas novas tentativas não tenham variação aleatória de tempo (*jitter*): muitas requisições são reenviadas ao mesmo tempo e continuam atingindo o limite. Primeiro, examine o corpo do erro e depois confira a distribuição dos horários das tentativas.
Q4: O fallback entre modelos pode afetar a qualidade da resposta?
Sim. O fallback troca qualidade por disponibilidade, então é importante definir, na lógica de negócio, em quais situações essa troca é aceitável. Prepare comandos validados separadamente para os modelos alternativos e monitore a proporção de requisições que usam fallback. Se essa proporção ficar alta por muito tempo, verifique a cota e a estabilidade do modelo principal.
Q5: Como testar, com baixo custo, uma cadeia de fallback entre modelos?
Você pode montar um ambiente de testes com uma plataforma que ofereça uma interface unificada para vários modelos. Por exemplo, com a APIYI apiyi.com, é possível alternar entre modelos de diferentes provedores usando o mesmo método de chamada compatível com OpenAI. Basta alterar o nome do modelo para verificar as diferenças nas respostas e nos erros dos modelos principal e alternativos usando o mesmo comando. É uma boa forma de ensaiar o fallback antes de entrar em produção.
Q6: Se o gateway já faz fallback automático, a aplicação ainda precisa de um circuit breaker?
Sim. O fallback do gateway lida com problemas nos canais dos provedores, mas o próprio gateway também pode ficar inacessível pela rede ou indisponível. O circuit breaker e a solução de contingência na aplicação existem para lidar com essas situações. Ao usar um gateway como o da APIYI, você pode configurar o circuit breaker da aplicação para avaliar o “gateway como um todo”, em vez de cada canal de modelo. Assim, as responsabilidades das duas camadas não se sobrepõem.
Q7: Quais são os efeitos colaterais conhecidos de novas tentativas, fallback e circuit breaker?
Novas tentativas podem gerar cobranças duplicadas e, em operações não idempotentes, como gravações feitas por chamadas de ferramentas, podem levar à execução repetida de ações. O fallback pode causar variações na qualidade e diferenças no formato das respostas. Já um circuit breaker configurado com sensibilidade excessiva pode rejeitar requisições legítimas. Por isso, os três mecanismos precisam ser ajustados continuamente com base nas métricas de monitoramento: não basta configurá-los uma vez e esquecê-los.
Pontos principais sobre tratamento de erros em APIs de IA
- Classifique antes de agir: corrija erros determinísticos imediatamente e reserve as tentativas automáticas para erros temporários.
- Confira o corpo do erro 429: diferencie limite de requisições de cota esgotada. No segundo caso, tentar novamente não adianta.
- Nunca tente novamente após um 401: gere um alerta e verifique se a chave, as variáveis de ambiente e o endereço da API estão corretos e são compatíveis.
- Defina limites para as tentativas: use espera exponencial com variação aleatória e estabeleça limites tanto para o número de tentativas quanto para o tempo total.
- Alinhe os recursos na alternativa: o modelo substituto precisa oferecer os mesmos recursos e ter seus próprios comandos.
- Conte apenas erros de servidor no circuit breaker: inclua erros 5xx e timeouts na taxa de falhas, mas não erros do cliente.
- Divida as responsabilidades entre gateway e aplicação: use a APIYI apiyi.com para lidar com a tolerância a falhas entre canais, enquanto a aplicação cuida das alternativas de negócio.
Resumo
Quando uma API de IA retornar erros 429, 401 ou 500, o mais importante é abandonar o hábito de “tentar tudo novamente” e tratar cada erro conforme sua natureza:
- Erros de limite de requisições: respeite o
Retry-Aftere tente novamente com espera exponencial e variação aleatória. Ao mesmo tempo, controle a concorrência e o consumo de tokens na origem. - Erros de autenticação e requisição: interrompa o processo imediatamente, gere um alerta e corrija a configuração. Nunca tente novamente de forma automática nem use uma alternativa para encobrir o problema.
- Erros de servidor: faça um número limitado de tentativas e, se as falhas persistirem, passe para um modelo alternativo. Em cenários de alta concorrência, use um circuit breaker para limitar rapidamente o impacto.
- Separação entre gateway e aplicação: o gateway cuida da troca de canais e da distribuição de carga; a aplicação controla a lógica de negócio, os limites de tentativas e a alternativa final.
Comece transformando a tabela de decisão deste artigo em uma norma interna de tratamento de erros para a equipe. Depois, faça uma simulação de falhas para confirmar que cada tipo de erro segue o fluxo esperado.
Se você está planejando uma cadeia de modelos alternativos, pode usar a APIYI apiyi.com para comparar o desempenho e o comportamento de erro de vários modelos em uma interface unificada. Valide primeiro a estratégia de tolerância a falhas no ambiente de testes e só depois a leve para produção.
📚 Referências
- Ofox.ai Blog – Artigo sobre tratamento de erros em APIs de IA: apresenta abordagens para lidar com erros 429 de limite de requisições, 401 de autenticação e 500 de servidor, além de backoff exponencial, fallback entre modelos e circuit breakers
- Link:
ofox.ai/blog/page/41/ -
Observação: fonte de referência para o tema deste artigo, útil para consultar o material em inglês
-
Ofox.ai Blog – Artigos sobre gateways de API para LLMs: discutem a escolha de gateways para LLMs e o contexto de falhas entre vários provedores
- Link:
ofox.ai/blog/page/40/ -
Observação: ajudam a entender o papel da tolerância a falhas na camada de gateway em arquiteturas com múltiplos modelos
-
Central de documentação da APIYI: instruções de integração e documentação de uso da plataforma
- Link:
docs.apiyi.com - Observação: consulte a documentação da plataforma e faça testes para confirmar detalhes como o formato dos códigos de erro e o comportamento de fallback
Autor: Equipe técnica da APIYI
Troca de experiências: entre em contato conosco pela página inicial do site da APIYI para conversar sobre práticas de estabilidade de APIs de IA. Para mais informações sobre integração, consulte a central de documentação em docs.apiyi.com.