Nota del autor: Este artículo explica, por código de error, las causas y soluciones para los errores 429, 401 y 500 de las API de IA. También aclara cuándo conviene reintentar, corregir la configuración o aplicar retroceso exponencial, conmutación a otro modelo y un mecanismo de circuito abierto.
Cuando usas un Modelo de Lenguaje Grande en producción, encontrarte de madrugada con una cadena de errores 429, 401 y 500 en el grupo de alertas es una situación conocida para muchos desarrolladores. Una respuesta habitual es reintentar todas las solicitudes fallidas, pero eso suele empeorar las cosas. En este artículo veremos, por código de error, cómo diagnosticar los errores 429, 401 y 500 de una API de IA y diseñar mecanismos de tolerancia a fallos, para sustituir los «reintentos a ciegas» por un tratamiento específico para cada caso.
Esto no es una introducción a los códigos de estado HTTP, sino una guía práctica para operar en producción. Veremos las causas habituales de cada error, si conviene reintentar, cómo escribir la lógica de tratamiento en la aplicación y cómo repartir la tolerancia a fallos entre la pasarela y la aplicación.
Qué te aporta: al terminar, podrás decidir en pocos minutos si un error requiere un reintento, una alternativa o una corrección inmediata de la configuración. También sabrás en qué situaciones conviene usar retroceso exponencial, conmutación a otro modelo o un mecanismo de circuito abierto.
Puntos clave sobre los errores 429, 401 y 500 en las API de IA
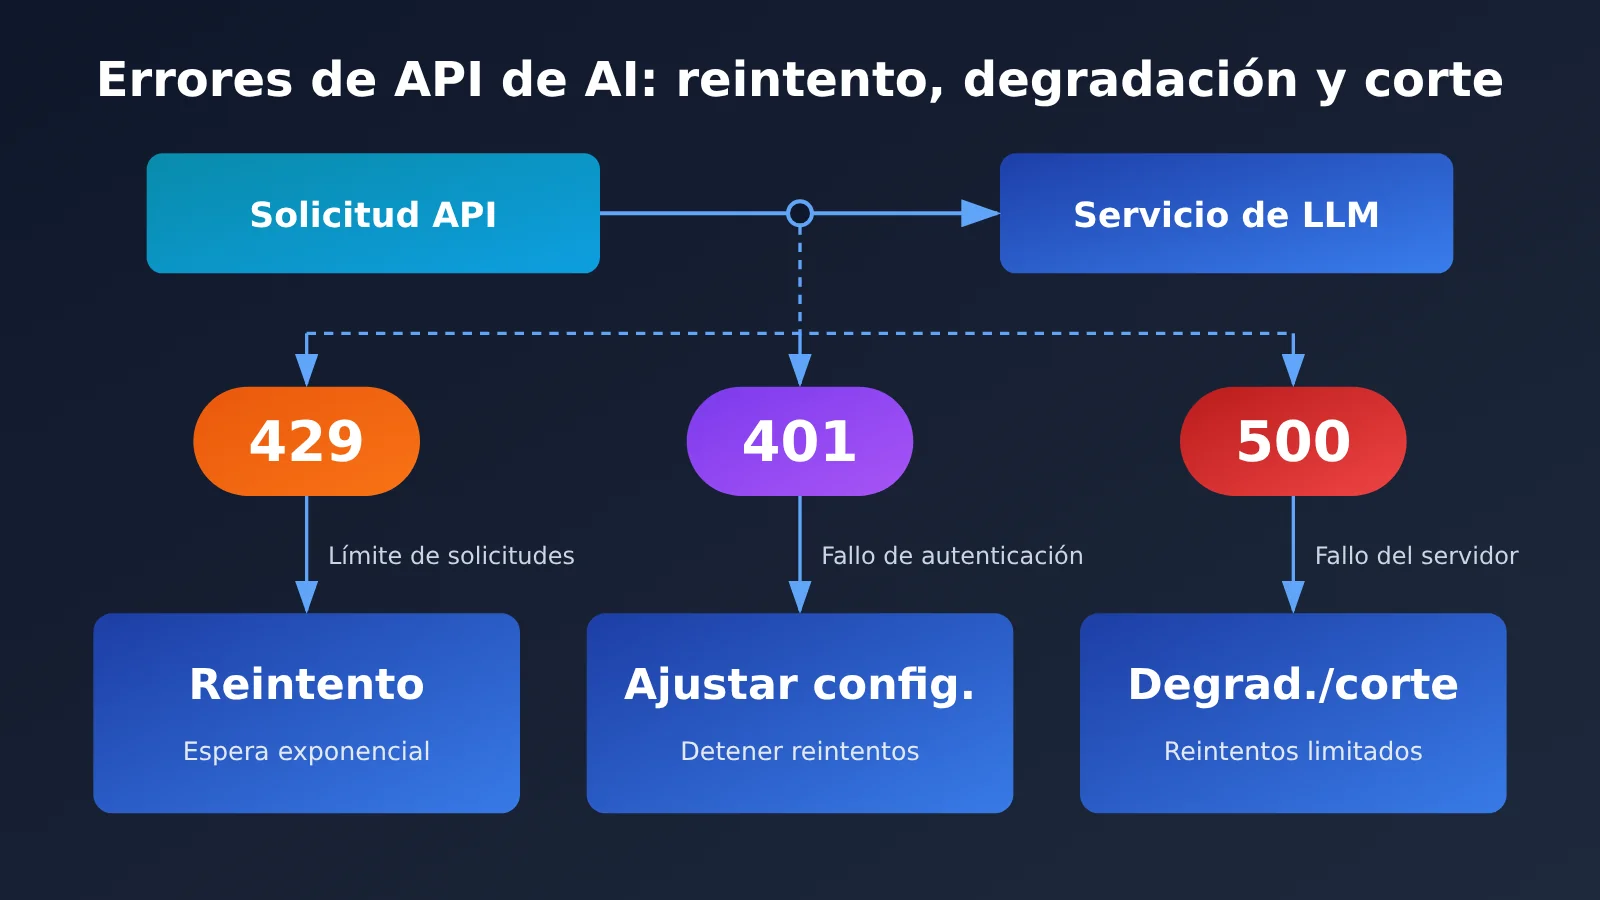
Para gestionar errores de una API de IA, primero hay que clasificarlos; los reintentos vienen después. Cada código indica un tipo de problema distinto: algunos se resuelven solos si esperas un poco, mientras que otros fallarán sin importar cuántas veces lo intentes. La siguiente tabla resume cómo identificar cada categoría.
| Categoría de error | Códigos habituales | Causa | ¿Se puede reintentar? | Cómo actuar |
|---|---|---|---|---|
| Límite de solicitudes | 429 | Demasiadas solicitudes o cuota agotada | Depende de la causa | Leer Retry-After, aplicar espera exponencial y distinguir entre límite de solicitudes y cuota insuficiente |
| Autenticación | 401、403 | Clave no válida o permisos insuficientes | No | Detener los reintentos de inmediato, generar una alerta y corregir la configuración |
| Servidor | 500、502、503、504 | Fallo o sobrecarga del servicio upstream | Sí, con un límite | Reintentar un número limitado de veces con espera progresiva; si el fallo persiste, usar una alternativa o activar un cortocircuito |
| Solicitud | 400、404、413、422 | Parámetros, nombre del modelo o longitud incorrectos | No | Registrar el cuerpo de la solicitud y corregir los parámetros antes de volver a enviarla |
En resumen, la conveniencia de reintentar depende de si el error es temporal o persistente. Tiene sentido reintentar ante errores temporales, como un límite de solicitudes o fallos intermitentes del servicio upstream. En cambio, ante errores persistentes, como una clave o parámetros incorrectos, los reintentos solo desperdician cuota, retrasan la respuesta y pueden activar límites de solicitudes más estrictos.
Tabla de decisión para códigos de error de API de IA
Al investigar un problema, no basta con mirar el código de estado: también hay que revisar el campo de tipo de error en el cuerpo de la respuesta y las cabeceras. Esta tabla puede servir directamente para diseñar la lógica de la aplicación.
| Señal observada | Posible causa | Acción recomendada | ¿Cuenta para el circuito de protección? |
|---|---|---|---|
429 con cabecera Retry-After |
Límite de frecuencia | Esperar el tiempo indicado en la cabecera y reintentar | No |
| 429 con un mensaje de cuota o saldo insuficiente en el cuerpo del error | Cuota de la cuenta agotada | No reintentar; generar una alerta para recargar o cambiar de cuenta | No |
| 401 | Clave incorrecta, caducada o con formato inválido | No reintentar; comprobar la clave y las variables de entorno | No |
| 403 | La clave no tiene acceso al modelo o a la región | No reintentar; comprobar los permisos y si el modelo está habilitado | No |
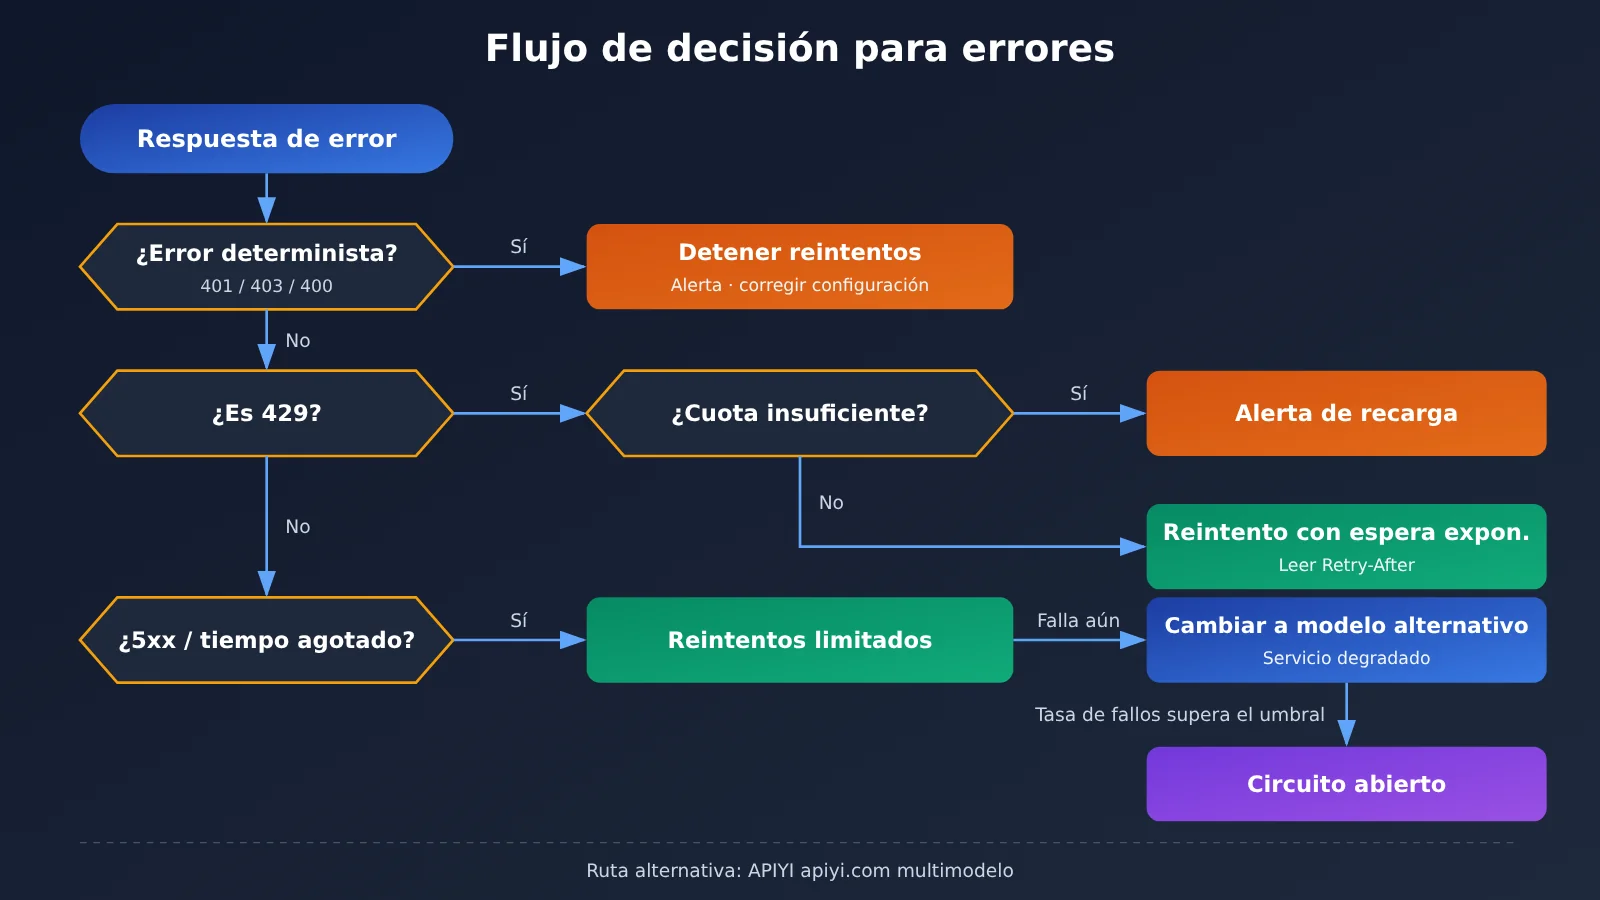
| 500 / 502 | Error interno del proveedor o fallo de reenvío de la pasarela | Reintentar 2-3 veces con espera progresiva | Sí |
| 503 | Servicio sobrecargado o en mantenimiento | Reintentar con espera progresiva y, si falla, recurrir a una alternativa | Sí |
| 504 o tiempo de espera agotado del cliente | Generación demasiado larga o respuesta lenta del proveedor | Decidir si se reintenta según la idempotencia y considerar aumentar el tiempo de espera | Sí |
Lo más fácil de pasar por alto son los dos significados del 429. Algunos proveedores también lo devuelven cuando se agota la cuota, pero el campo de tipo en el cuerpo del error es distinto al de una limitación de frecuencia normal. Si la aplicación solo mira el código de estado, seguirá reintentando indefinidamente una solicitud con «saldo insuficiente», con esperas progresivas: los registros estarán llenos de errores 429, pero el servicio nunca se recuperará.
Error 429: límites de solicitudes
La causa principal de un error 429 es haber superado el límite de solicitudes o tokens en un período determinado. Las API de Modelos de Lenguaje Grande suelen aplicar límites en varias dimensiones: solicitudes por minuto, tokens por minuto y, en algunos casos, solicitudes simultáneas. Por eso, incluso con pocas solicitudes, enviar una con un contexto muy largo puede provocar un 429.
Hay tres principios para gestionar un 429 en la aplicación. Primero, respeta la cabecera Retry-After u otras similares que indiquen cuándo se restablece el límite, en lugar de adivinar cuánto esperar. Segundo, si no hay ninguna cabecera que lo indique, usa una espera exponencial con variación aleatoria para evitar que muchos clientes reintenten al mismo tiempo y vuelvan a agotar el límite. Tercero, controla el tráfico desde el origen: limitar la concurrencia con un algoritmo de cubo de tokens o una cola es más eficaz que reintentar después.
Error 401: autenticación
El 401 es el error que menos sentido tiene reintentar. Casi siempre se debe a un problema de configuración. Entre las causas habituales están los espacios o saltos de línea añadidos al copiar la clave, una variable de entorno que no se ha inyectado correctamente en el contenedor, una clave de pruebas utilizada en producción, una clave que se ha rotado o revocado, o un formato incorrecto en la cabecera de autenticación.
En las interfaces compatibles con OpenAI, otra causa frecuente es que base_url y la clave no correspondan a la misma plataforma; por ejemplo, usar una clave de la plataforma A para enviar una solicitud a la dirección de la plataforma B. Por eso, ante un 401, la aplicación debe detener los reintentos de inmediato, activar una alerta de alta prioridad y registrar los primeros caracteres de la clave y la dirección de la solicitud para facilitar el diagnóstico. Nunca debe registrar la clave completa.
Errores 500 del servidor: claves para entenderlos
Los errores de la serie 500 indican un problema en el servidor o en la cadena de comunicación. Puede tratarse de un fallo interno o una sobrecarga del servicio del modelo, o de un error de reenvío en la puerta de enlace intermedia. Estos errores suelen ser temporales, por lo que conviene reintentar un número limitado de veces. Sin embargo, si persisten, significa que el servicio de origen está en mal estado. Seguir reintentando solo acumulará solicitudes y ocupará los hilos disponibles; en ese caso, es mejor recurrir a la degradación del servicio o a un disyuntor.
También hay que prestar atención a los errores 504 y a los tiempos de espera del cliente. Los Modelos de Lenguaje Grande tardan en generar textos largos por naturaleza. Si el tiempo de espera es demasiado corto, una solicitud lenta pero válida puede interpretarse como fallida y volver a intentarse. Esto puede generar cargos duplicados y, si se interrumpe la salida en streaming, también puede hacer que el frontend reciba contenido truncado.
Primeros pasos con reintentos, alternativas y circuit breakers para API de IA
Una vez clasificadas las situaciones, toca llevar la lógica a código. En lugar de incluir bloques de código, esta sección explica los puntos clave de cada mecanismo mediante listas de parámetros y pasos que puedes implementar en cualquier lenguaje.
Claves para implementar reintentos con backoff exponencial
La idea del backoff exponencial es aumentar el tiempo de espera con cada reintento y añadir una variación aleatoria. Puedes organizar la lógica así:
- Define el conjunto de errores que admiten reintento, por ejemplo,
429(si no se debe a una cuota insuficiente),500,502,503,504y los tiempos de espera agotados de la red. - Después de cada fallo, comprueba primero la cabecera
Retry-Afterde la respuesta. Si está presente, espera el tiempo indicado; si no, calcula la espera con la fórmula de backoff. - La fórmula suele ser «intervalo base × 2 elevado al número de reintentos», más una variación aleatoria. Establece también un límite para cada espera.
- Define un número máximo de reintentos y un límite de tiempo total. Si se supera cualquiera de los dos, abandona el intento y pasa el error a la lógica de alternativa.
- Registra cada reintento, incluidos el código de error, el número de reintento, el tiempo de espera y el nombre del modelo, para facilitar el análisis posterior.
Si usas un SDK oficial, ten en cuenta que muchos ya incluyen parámetros como max_retries y timeout. Evita añadir otra capa de reintentos equivalente por fuera: de lo contrario, los reintentos se multiplicarán y el volumen de solicitudes aumentará considerablemente durante una incidencia.
La siguiente tabla ofrece valores iniciales habituales basados en la experiencia. Ajústalos según los requisitos de latencia de tu aplicación y los límites del proveedor.
| Parámetro | Significado | Valor inicial habitual | Criterio de ajuste |
|---|---|---|---|
max_retries |
Número máximo de reintentos | 2-5 | Usa un valor bajo para conversaciones en tiempo real y uno más alto para procesamiento por lotes |
| Intervalo base | Espera antes del primer reintento | Aproximadamente 1 segundo | Auméntalo para servicios con límites de tasa estrictos |
| Límite por espera | Tiempo máximo de backoff | Del orden de decenas de segundos | Evita que una espera excesiva retrase toda la solicitud |
| Variación aleatoria | Distribuye los reintentos en el tiempo | Un valor aleatorio proporcional al tiempo de espera | Es más necesaria cuanto mayor sea el número de clientes concurrentes |
| Límite de tiempo total | Duración máxima de una invocación | Según el SLA de la aplicación | Al agotarse, activa directamente la alternativa |
🚀 Inicio rápido: Si quieres simular cómo se comportan los reintentos con distintos códigos de error durante las pruebas, puedes acceder a varios modelos mediante una interfaz unificada compatible con OpenAI a través de APIYI apiyi.com. Así podrás observar las respuestas y los errores de cada modelo con la misma lógica de reintentos, sin tener que adaptar todo por separado para cada proveedor.
Cómo diseñar una estrategia de degradación entre modelos
Los reintentos resuelven el problema de que «un modelo no esté disponible temporalmente»; la degradación aborda el caso en que «ese modelo no pueda recuperarse a corto plazo». La degradación entre modelos consiste en configurar de antemano una cadena de alternativas: si el modelo principal falla varias veces seguidas, se cambia a los modelos de respaldo en orden. Así, la aplicación puede seguir respondiendo, aunque quizá con una menor calidad o un mayor costo.
Al diseñar esta cadena, hay que comprobar que las capacidades sean equivalentes. Si el modelo principal depende de la llamada a funciones, la salida estructurada o un contexto largo, los modelos de respaldo también deben admitir esas funciones. De lo contrario, la degradación podría provocar nuevos errores 400 o fallos al analizar el formato de salida. La siguiente tabla muestra una posible forma de diseñar cadenas de respaldo según el caso de uso.
| Caso de uso | Modelo principal | Primera alternativa | Segunda alternativa | Plataformas disponibles |
|---|---|---|---|---|
| Conversaciones de atención al cliente en línea | Modelo generalista de alta calidad | Modelo de otro proveedor del mismo nivel | Modelo ligero y rápido + respuesta simplificada | APIYI apiyi.com, API oficiales de cada proveedor |
| Generación y revisión de código | Modelo insignia con gran capacidad de programación | Modelo insignia de otro proveedor | Mostrar un aviso para volver a intentarlo más tarde | APIYI apiyi.com, API oficiales de cada proveedor |
| Procesamiento de contenido por lotes | Modelo con buena relación calidad-precio | Otro modelo de precio similar | Añadir a una cola para procesarlo más tarde | APIYI apiyi.com, API oficiales de cada proveedor |
| Extracción de información estructurada | Modelo compatible con salida JSON | Otro modelo compatible con salida estructurada | Motor de reglas como último recurso | APIYI apiyi.com, API oficiales de cada proveedor |
Hay varios detalles que conviene tener en cuenta al implementar la degradación:
- Adaptación de las indicaciones: cada modelo responde de forma distinta a las indicaciones del sistema. Lo ideal es que cada modelo de respaldo tenga su propia versión validada.
- Longitud del contexto: antes de cambiar de modelo, comprueba si la longitud de los mensajes supera la ventana de contexto del modelo de respaldo. Si es necesario, recorta primero el historial.
- Identificación del resultado: marca en los registros y en el sistema de monitoreo que «esta respuesta procede de un modelo de respaldo», para poder evaluar el impacto en la calidad.
- No recurras a la degradación ante errores de autenticación: un error 401 indica un problema de configuración. Cambiar de modelo solo lo ocultaría; lo correcto es generar una alerta directamente.
Cómo funciona el circuit breaker y cuándo usarlo
El circuit breaker evita que una dependencia que falla de forma continua termine afectando a todo el sistema. Normalmente tiene tres estados: cuando está cerrado, deja pasar las solicitudes y registra la tasa de fallos; si la tasa o el número de fallos consecutivos supera un umbral, pasa al estado abierto, en el que rechaza las solicitudes directamente o activa una alternativa degradada, sin volver a acceder al servicio que falla. Tras un periodo de espera, entra en estado semiabierto y deja pasar unas pocas solicitudes de prueba: si tienen éxito, vuelve a cerrarse; si fallan, se abre de nuevo.
La clave está en contabilizar solo los errores que reflejan el estado del servicio de origen. Los errores 5xx y los tiempos de espera agotados deben contar como fallos, pero los errores del cliente como 401 y 400 no. De lo contrario, un error de configuración podría abrir el circuit breaker y hacer que se rechacen todas las solicitudes válidas. Los errores 429 causados por una cuota insuficiente tampoco deben contabilizarse, porque reflejan el estado de la cuenta, no la salud del servicio.
Usar más circuit breakers no siempre es mejor. En herramientas internas con un volumen de llamadas muy bajo, la muestra para calcular la tasa de fallos es demasiado pequeña y el circuit breaker puede activarse por error. En esos casos, basta con combinar reintentos sencillos y una alternativa degradada. El circuit breaker resulta más útil en servicios en producción con mucha concurrencia: permite limitar rápidamente el impacto de una falla generalizada del servicio de origen y evita que las solicitudes lentas ocupen todos los hilos y conexiones disponibles.
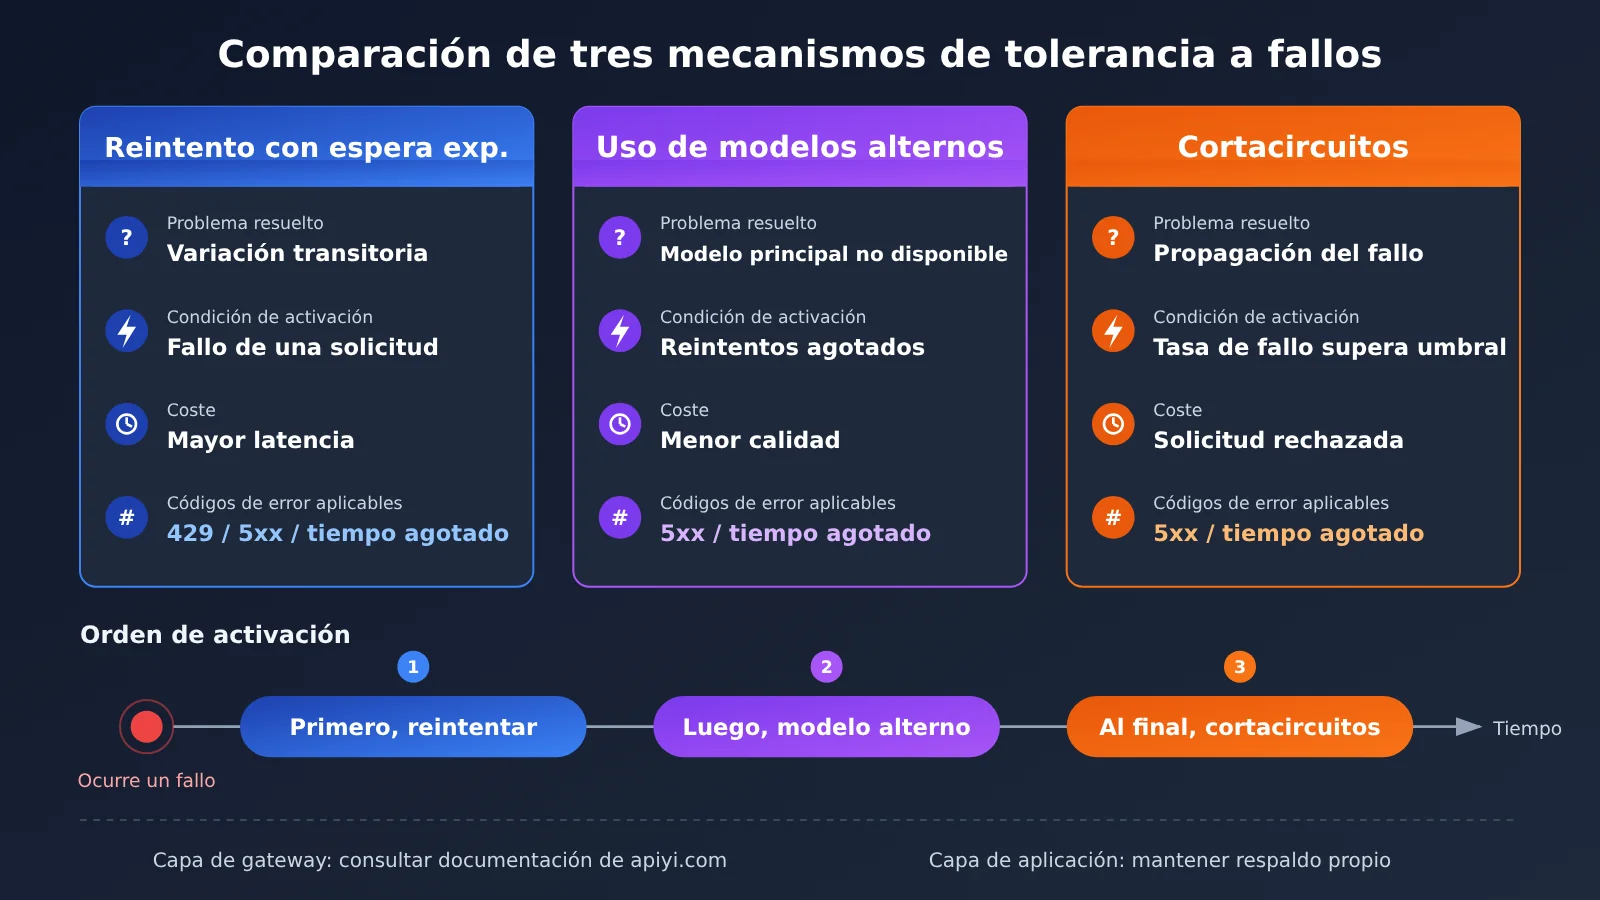
Reparto de responsabilidades de tolerancia a fallos entre la puerta de enlace y la aplicación
Cada vez más equipos invocan Modelos de Lenguaje Grande a través de una puerta de enlace API o una plataforma de agregación. Esto plantea una duda frecuente: si la puerta de enlace ya tiene degradación automática, ¿la aplicación también necesita reintentos y un circuito de protección? Sí, pero con responsabilidades distintas. La puerta de enlace se ocupa mejor de los problemas de los canales de proveedores, mientras que la aplicación conoce mejor la lógica de negocio.
| Responsabilidad de tolerancia a fallos | Más adecuada para la puerta de enlace | Más adecuada para la aplicación |
|---|---|---|
| Conmutación por fallo de canal | Cambio entre varios canales para un mismo modelo y balanceo de carga | No hace falta volver a implementarla |
| Degradación entre modelos | Puede ofrecer enrutamiento de modelos | Decide si el negocio acepta una menor calidad y si hay que cambiar la indicación |
| Reintentos | Reintentos rápidos a nivel de canal | Presupuesto de reintentos a nivel de negocio, coordinado con los tiempos de espera del usuario |
| Circuito de protección | Comprobación del estado de los canales de proveedores | Protección y alternativa cuando no se puede acceder a la puerta de enlace |
| Errores de autenticación y cuota | Devuelve tipos de error claros | Genera alertas, detiene los reintentos y notifica para que intervenga una persona |
| Monitoreo | Tasa de éxito y latencia a nivel de canal | Tasa de éxito, proporción de solicitudes degradadas e impacto en los usuarios a nivel de negocio |
Por ejemplo, APIYI menciona en su descripción comercial funciones de estabilidad como la degradación automática, el balanceo de carga y el monitoreo en tiempo real. Estas funciones son adecuadas para gestionar la conmutación por fallo entre canales, mientras que la aplicación puede centrarse en las alternativas de negocio. Sin embargo, para saber si las condiciones que activan la degradación, los códigos de error y el formato del cuerpo de error de la puerta de enlace coinciden por completo con los oficiales, hay que consultar la documentación de la plataforma y realizar pruebas. La mención de «concurrencia ilimitada» en la descripción comercial tampoco significa que nunca vaya a aparecer un error 429: los límites de los modelos del proveedor siguen existiendo. Lo más prudente es que la aplicación conserve siempre la lógica para gestionar errores 429 y 5xx, y que tenga su propia alternativa para cuando no pueda acceder a la puerta de enlace.
🎯 Recomendación técnica: después de integrar la puerta de enlace, conviene provocar primero varios tipos de error en un entorno de pruebas: usar una clave incorrecta, solicitar un modelo inexistente o enviar un contexto demasiado largo. Registra los códigos de estado y los campos del cuerpo de error que devuelve realmente APIYI apiyi.com y ajusta con ellos las reglas de clasificación de errores de la aplicación, en lugar de copiar sin más el formato de error de la documentación oficial.
Preguntas frecuentes FAQ
Q1: ¿Cuál es la diferencia fundamental entre los errores 429 y 500 de una API de IA?
El error 429 indica que tus solicitudes superan el límite permitido: el problema está en el ritmo de las invocaciones o en la cuota de la cuenta. El error 500 indica un fallo del servidor, es decir, del proveedor. En el primer caso, conviene reducir la frecuencia y respetar el tiempo de espera; en el segundo, puedes reintentar un número limitado de veces y recurrir a un modelo alternativo si el fallo persiste. En ambos casos puede que «se solucione esperando un poco», pero la forma de gestionarlos es distinta.
Q2: ¿Por qué nunca se debe reintentar automáticamente un error 401?
El error 401 es determinista: si la clave es incorrecta, el resultado será el mismo aunque lo intentes diez mil veces. Los reintentos automáticos no solo desperdician recursos, sino que también ocultan el problema y retrasan las alertas. Lo correcto es interrumpir el proceso de inmediato y comprobar el contenido de la clave, la inyección de variables de entorno y que la dirección de la solicitud sea la correcta.
Q3: ¿Por qué un error 429 no se resuelve aunque siga reintentando?
La causa más habitual es que se haya agotado la cuota o el saldo. Algunos proveedores también devuelven un 429 en ese caso, pero el campo de tipo del cuerpo del error es distinto al de una limitación de frecuencia normal. Otra posibilidad es que los reintentos no incluyan una variación aleatoria (*jitter*): muchas solicitudes se reenvían al mismo tiempo y mantienen el límite saturado. Revisa primero el cuerpo del error y después la distribución temporal de los reintentos.
Q4: ¿Usar modelos alternativos puede afectar a la calidad de la respuesta?
Sí. En esencia, recurrir a un modelo alternativo supone priorizar la disponibilidad frente a la calidad, así que hay que definir qué situaciones pueden aceptar ese cambio. Conviene preparar indicaciones verificadas específicamente para los modelos de respaldo y hacer seguimiento del porcentaje de solicitudes que recurren a ellos. Si ese porcentaje se mantiene alto durante mucho tiempo, es hora de revisar la cuota y la estabilidad del modelo principal.
Q5: ¿Cómo puedo probar a bajo costo una cadena de modelos alternativos?
Puedes crear un entorno de pruebas con una plataforma que ofrezca una interfaz unificada para varios modelos. Por ejemplo, con APIYI apiyi.com puedes cambiar entre modelos de distintos proveedores usando el mismo método de invocación compatible con OpenAI. Solo tienes que cambiar el nombre del modelo para comprobar las diferencias en las respuestas y los errores del modelo principal y los de respaldo ante la misma indicación. Es una buena forma de probar el mecanismo antes de ponerlo en producción.
Q6: Si uso una pasarela con cambio automático a modelos alternativos, ¿sigo necesitando un interruptor de circuito en la capa de aplicación?
Sí. El cambio a modelos alternativos de la pasarela resuelve los problemas de los canales del proveedor, pero la propia pasarela también puede sufrir fallos de red o quedar completamente indisponible. El interruptor de circuito y el mecanismo de respaldo de la aplicación están ahí para esos casos. Al usar una pasarela como APIYI, puedes configurar el interruptor de circuito de la aplicación para que recopile estadísticas sobre la «pasarela en su conjunto», en lugar de hacerlo sobre cada canal de modelo. Así, las responsabilidades de ambas capas no se duplican.
Q7: ¿Qué efectos secundarios conocidos tienen los reintentos, el uso de modelos alternativos y los interruptores de circuito?
Los reintentos pueden generar cargos duplicados y, en operaciones no idempotentes —como las de escritura que invocan herramientas—, pueden hacer que una acción se ejecute más de una vez. El uso de modelos alternativos puede provocar variaciones de calidad y diferencias en el formato de salida. Si el interruptor de circuito se configura con demasiada sensibilidad, puede rechazar solicitudes válidas. Por eso, es necesario ajustar los parámetros de los tres mecanismos de forma continua con ayuda de métricas de monitorización, en lugar de configurarlos una vez y olvidarse.
Puntos clave para gestionar errores de API de IA
- Clasifica antes de actuar: corrige de inmediato los errores deterministas; reserva los reintentos para los errores temporales.
- En los errores 429, revisa el cuerpo de la respuesta: distingue entre un límite de tasa y una cuota agotada; en el segundo caso, reintentar no sirve de nada.
- Nunca reintentes un error 401: genera una alerta y comprueba que la clave, las variables de entorno y la dirección del endpoint coincidan.
- Pon límites a los reintentos: usa espera exponencial con fluctuación aleatoria y establece límites tanto para el número de intentos como para el tiempo total.
- Alinea las capacidades al usar alternativas: el modelo de respaldo debe admitir las mismas funciones y contar con indicaciones propias.
- El circuito solo debe contar errores del servidor: incluye los 5xx y los tiempos de espera agotados en la tasa de fallos, pero no los errores del cliente.
- Reparte las responsabilidades entre la puerta de enlace y la aplicación: puedes usar APIYI apiyi.com para gestionar la tolerancia a fallos de los canales, mientras la aplicación se encarga de las alternativas de negocio.
Conclusión
Cuando una API de IA devuelve un error 429, 401 o 500, lo más importante es abandonar la costumbre de «reintentar todo por igual» y actuar según la naturaleza del error:
- Errores de límite de tasa: respeta
Retry-After, reintenta con espera exponencial y fluctuación aleatoria, y controla desde el origen la concurrencia y el consumo de tokens. - Errores de autenticación y de solicitud: interrumpe el proceso de inmediato, genera una alerta y corrige la configuración. Nunca reintentes automáticamente ni uses una alternativa para ocultar el problema.
- Errores del servidor: limita los reintentos y, si los fallos persisten, cambia a un modelo de respaldo. En escenarios de alta concurrencia, usa también un interruptor de circuito para limitar el impacto rápidamente.
- Separación entre puerta de enlace y aplicación: la puerta de enlace gestiona el cambio de canal y la carga; la aplicación controla la lógica de negocio, el presupuesto de reintentos y la solución alternativa final.
Conviene convertir primero la tabla de decisiones de este artículo en una guía interna de gestión de errores. Después, realiza un simulacro de fallos para comprobar que cada tipo de error siga la ruta prevista.
Si estás planificando una cadena de alternativas con varios modelos, puedes usar APIYI apiyi.com para comparar su comportamiento y sus errores mediante una interfaz unificada. Valida primero la estrategia de tolerancia a fallos en un entorno de pruebas y después llévala a producción.
📚 Referencias
- Ofox.ai Blog – Artículo sobre gestión de errores de API de IA: Explica cómo gestionar errores 429 por límite de solicitudes, 401 de autenticación y 500 del servidor, además del retroceso exponencial, el uso de modelos alternativos y los interruptores de circuito.
- Enlace:
ofox.ai/blog/page/41/ -
Nota: Fuente de referencia para el enfoque de este artículo, útil para consultar información en inglés.
-
Ofox.ai Blog – Artículos sobre gateways de API para LLM: Abordan la selección de gateways para LLM y el contexto de los fallos entre distintos proveedores.
- Enlace:
ofox.ai/blog/page/40/ -
Nota: Ayudan a entender el papel de la tolerancia a fallos en la capa de gateway dentro de una arquitectura multimodelo.
-
Centro de documentación de APIYI: Guías de integración y uso de la plataforma.
- Enlace:
docs.apiyi.com - Nota: Para detalles como el formato de los códigos de error y el comportamiento de los mecanismos alternativos, consulta la documentación de la plataforma y realiza pruebas.
Autor: Equipo técnico de APIYI
Intercambio técnico: Puedes contactarnos desde la página principal de APIYI para conversar sobre prácticas de estabilidad de las API de IA. Encontrarás más información sobre la integración en el centro de documentación de docs.apiyi.com.