著者注:この記事では、AI API で 429、401、500 エラーが発生する原因と対処法をエラーコード別に解説します。どのエラーを再試行すべきか、どのエラーでは設定を修正すべきかに加え、指数バックオフ、複数モデルへのフォールバック、サーキットブレーカーの適用範囲も説明します。
本番環境で大規模言語モデルを呼び出していると、深夜のアラート通知に 429、401、500 がずらりと並ぶ――多くの開発者が経験したことのある光景ではないでしょうか。よくある対処法は、失敗したリクエストをすべて再試行することですが、かえって状況を悪化させる場合もあります。この記事では、AI API で 429、401、500 が発生したときの判断方法と耐障害設計をエラーコード別に解説し、「やみくもな再試行」から「エラーに応じた対処」への転換をサポートします。
この記事は HTTP ステータスコードの入門解説ではありません。本番運用に役立つ実践ガイドです。各エラーの典型的な原因や再試行の可否、アプリケーション層での処理ロジックの書き方、ゲートウェイ層とアプリケーション層での耐障害対策の分担を取り上げます。
この記事でわかること:エラーが発生したときに、再試行すべきか、フォールバックすべきか、それともすぐに設定を修正すべきかを数分で判断できるようになります。また、指数バックオフ、複数モデルへのフォールバック、サーキットブレーカーがそれぞれどのような場面に適しているかもわかります。
AI APIの429・401・500エラー:押さえておきたいポイント
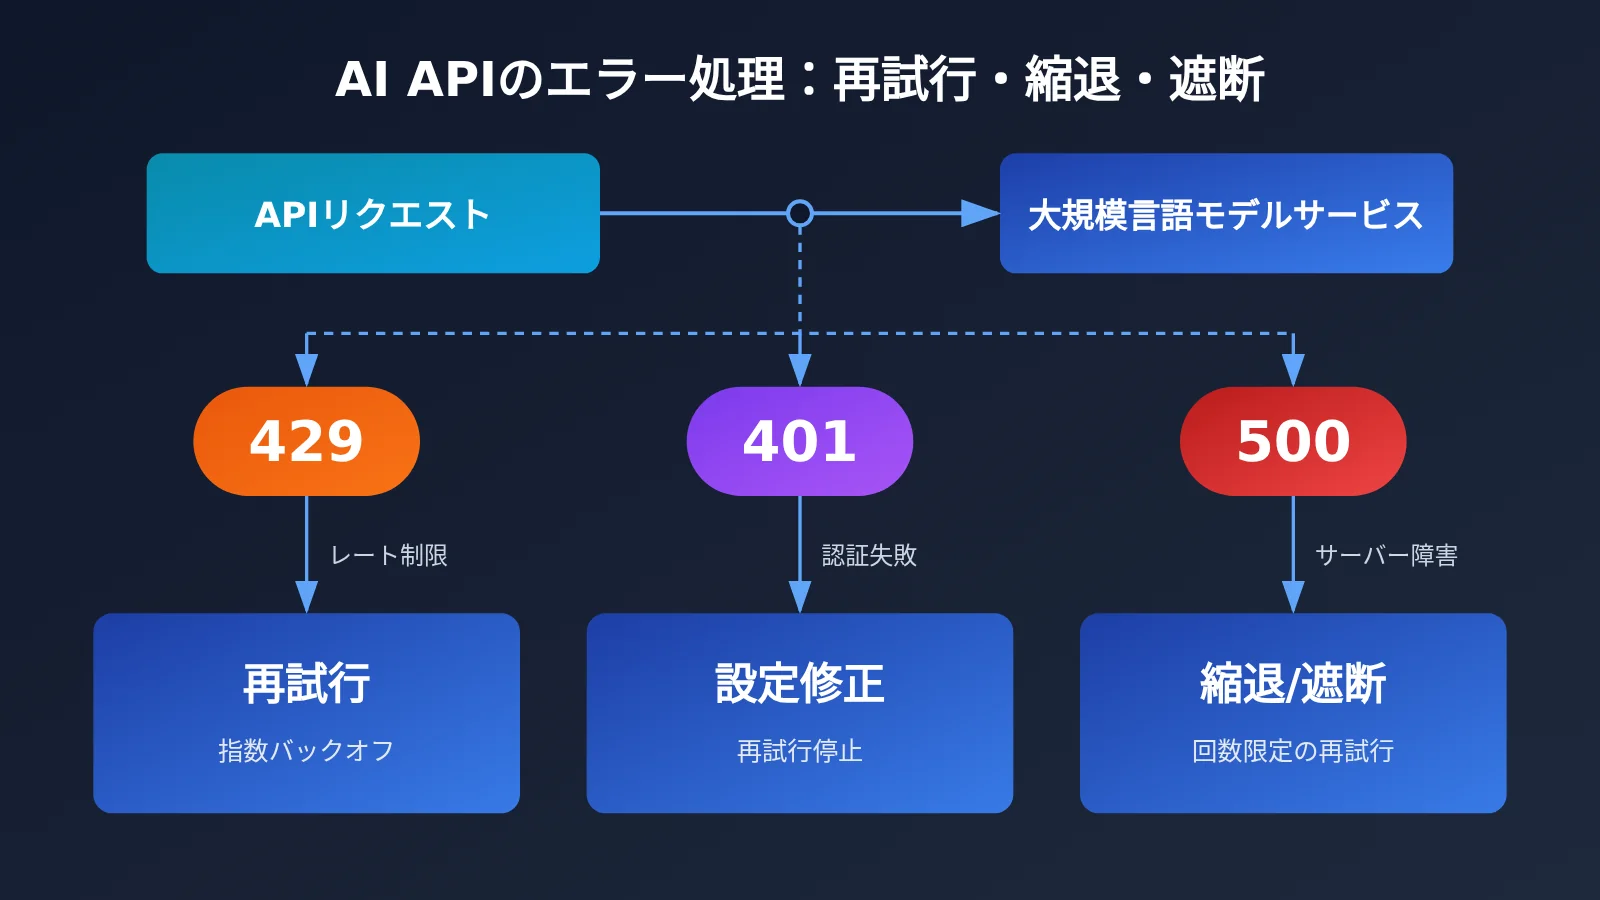
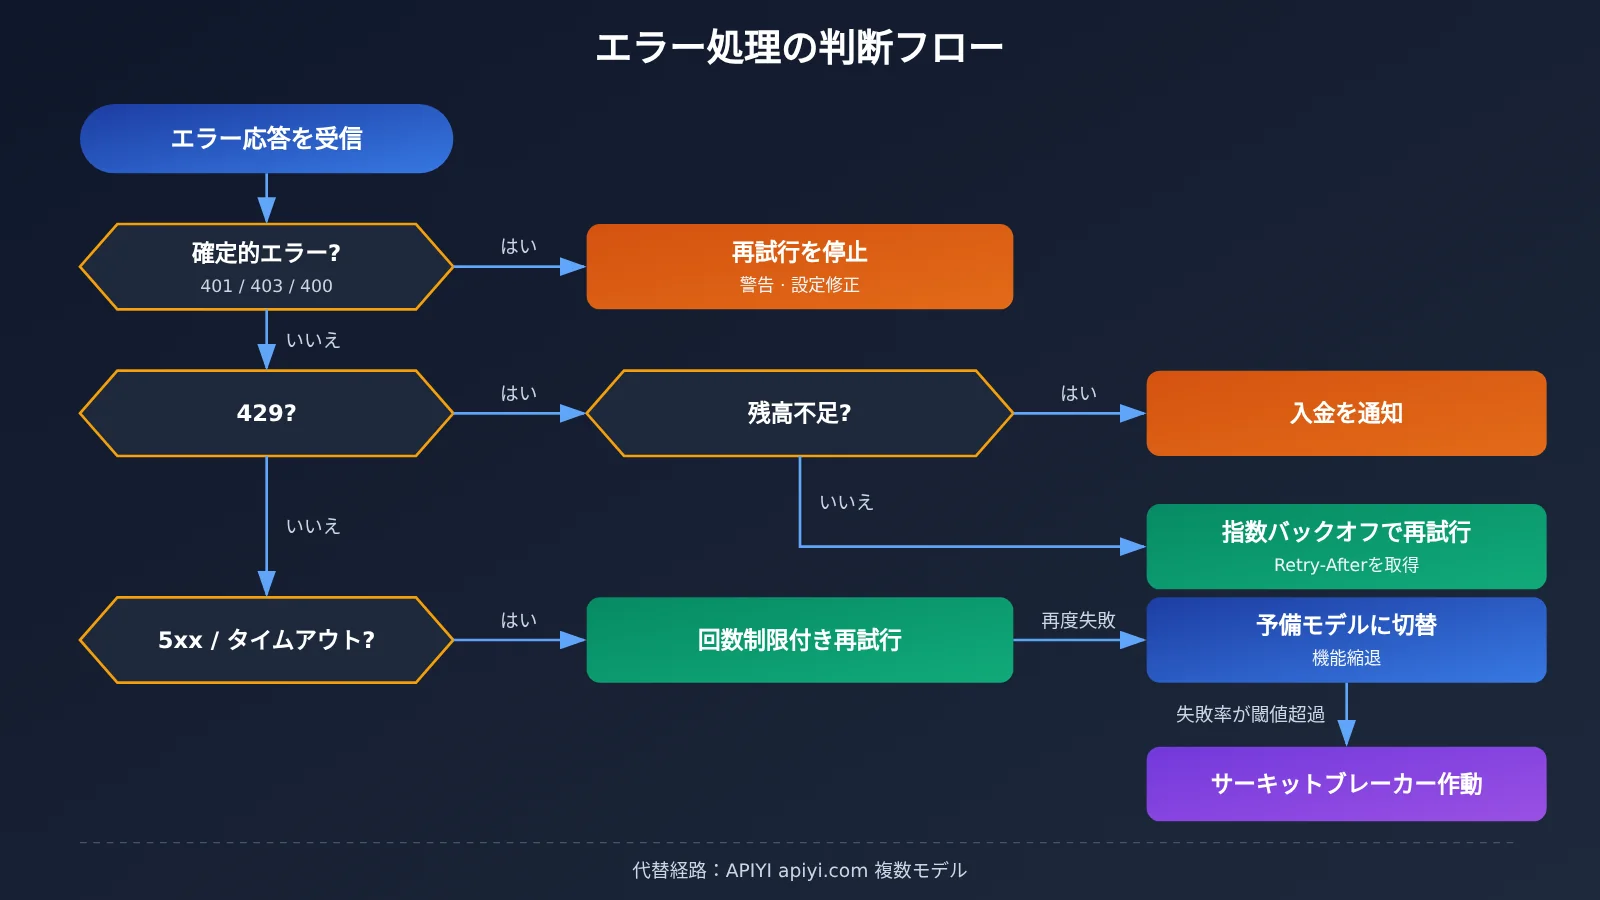
AI APIのエラーに対処するときは、まずエラーを分類し、リトライはその後に判断します。エラーコードによって問題の性質は異なり、少し待てば解消するものもあれば、何度リトライしても失敗するものもあります。まずは以下の表で、それぞれのエラーの概要を確認しましょう。
| エラーの種類 | 代表的なステータスコード | 問題の原因 | リトライの可否 | 主な対処法 |
|---|---|---|---|---|
| レート制限 | 429 | リクエストが多すぎる、または利用枠を使い切った | 原因による | Retry-After を確認し、指数バックオフを行う。レート制限と利用枠不足を区別する |
| 認証 | 401、403 | APIキーが無効、または権限が不足している | 不可 | 直ちにリトライを停止し、アラートを出して設定を修正する |
| サーバー側 | 500、502、503、504 | 上流サービスの障害または過負荷 | 可能。ただし回数制限あり | バックオフを用いて限られた回数だけリトライし、失敗が続く場合は代替手段への切り替えやサーキットブレーカーを適用する |
| リクエスト | 400、404、413、422 | パラメーター、モデル名、長さに誤りがある | 不可 | リクエストボディを記録し、パラメーターを修正してから再送する |
このように、リトライできるかどうかは、エラーが一時的なものか、確定的なものかによって決まります。一時的なエラー(レート制限や上流サービスの一時的な不調)では、リトライが有効です。一方、確定的なエラー(APIキーやパラメーターの誤り)では、リトライしても利用枠を無駄に消費し、応答が遅くなるだけです。さらに、より厳しいレート制限がかかる可能性もあります。
AI APIエラーコードの判断表
実際のトラブルシューティングでは、ステータスコードだけでなく、レスポンスボディ内のエラータイプフィールドやレスポンスヘッダーもあわせて確認する必要があります。以下は、アプリケーション層のロジック設計にそのまま使える判断表です。
| 確認されたシグナル | 考えられる原因 | 推奨アクション | サーキットブレーカーの統計に計上するか |
|---|---|---|---|
429 かつ Retry-After ヘッダーあり |
レート制限 | ヘッダーに指定された時間だけ待ってからリトライ | いいえ |
| 429 かつエラーボディに利用枠・残高不足の表示あり | アカウントの利用枠を使い切った | リトライせず、アラートを出して入金するかアカウントを切り替える | いいえ |
| 401 | APIキーの誤り、期限切れ、または形式の不備 | リトライせず、APIキーと環境変数を確認 | いいえ |
| 403 | APIキーにそのモデルまたは地域へのアクセス権限がない | リトライせず、権限とモデルの利用設定を確認 | いいえ |
| 500 / 502 | 上流サービスの内部エラー、ゲートウェイの転送失敗 | 待機時間を徐々に延ばしながら 2-3 回リトライ | はい |
| 503 | サービスの過負荷またはメンテナンス | 待機時間を徐々に延ばしながらリトライし、失敗したら代替手段に切り替える | はい |
| 504 またはクライアントのタイムアウト | 生成内容が長すぎる、上流サービスの応答が遅い | 冪等性に応じてリトライを判断し、タイムアウト時間の延長を検討 | はい |
この表で特に見落としやすいのは、429 には2つの意味があることです。利用枠を使い切った場合にも 429 を返すサービス提供者がありますが、エラーボディのタイプフィールドは通常のレート制限とは異なります。アプリケーション層でステータスコードしか見ていないと、「残高不足」のリクエストに対して待機時間を延ばしながら無限にリトライしてしまいます。ログは 429 で埋まり、いつまでたっても復旧しません。
429 レート制限エラーの詳しい解説
429 の主な原因は、単位時間あたりのリクエスト数またはトークン数が制限を超えることです。大規模言語モデルの API では通常、1 分あたりのリクエスト数やトークン数など、複数の観点でレート制限が設けられています。同時実行数が制限される場合もあります。そのため、リクエスト数が少なくても、一度に非常に長いコンテキストを送ると 429 が発生することがあります。
アプリケーション層で 429 を処理する際には、3 つの原則があります。第一に、Retry-After や同様のリセット時刻を示すヘッダーを優先し、待機時間を推測しないこと。第二に、ヘッダーに指示がない場合は、ランダムなジッターを加えた指数バックオフを使い、多数のクライアントが同時に再試行して再び制限に達するのを防ぐこと。第三に、リクエストの発生元で流量を制御することです。トークンバケットやキューで同時実行数を制限するほうが、エラー発生後の再試行より効果的です。
401 認証エラーの詳しい解説
401 は、特に再試行を避けるべきエラーです。ほとんどの場合、設定の問題が原因です。よくある例として、キーのコピー時に余分な空白や改行が入った、環境変数がコンテナに正しく渡されていない、テスト環境のキーを本番環境で使用している、キーがローテーションまたは失効された、認証ヘッダーの形式が間違っている、といったケースがあります。
OpenAI 互換インターフェースでは、base_url とキーの不一致も頻繁に起こる原因です。例えば、A プラットフォームのキーを使って B プラットフォームのアドレスにリクエストするケースです。そのため、401 が発生したら、アプリケーション層ですぐに再試行を停止し、優先度の高いアラートを発報しましょう。また、原因をすばやく特定できるよう、キーの先頭数文字とリクエスト先のアドレスをログに記録します。ただし、キー全体は記録しないでください。
500系サーバーエラーの詳しい解説
500系のエラーは、サーバー側または通信経路に問題があることを示します。上流のモデルサービスで内部エラーが発生していたり、負荷が高すぎたり、中間ゲートウェイでの転送に失敗していたりする可能性があります。通常は一時的なエラーのため、回数を制限してリトライするのが適切です。ただし、継続して発生する場合は、上流サービスが正常に動作していない可能性があります。そのままリトライを続けると、リクエストが滞留し、スレッドが占有されるだけです。縮退運転やサーキットブレーカーに切り替えましょう。
504エラーとクライアント側のタイムアウトにも注意が必要です。大規模言語モデルによる長文の生成には、もともと時間がかかります。タイムアウトを短く設定しすぎると、正常に処理中のリクエストを失敗と誤判定してリトライし、重複課金が発生する可能性があります。また、ストリーミング出力が中断されると、フロントエンドには途中で途切れた内容が届いてしまいます。
AI APIのリトライ・フォールバック・サーキットブレーカー入門
エラーを分類したら、処理ロジックをコードに落とし込みましょう。このセクションでは、追加要件に従ってコードブロックは掲載せず、パラメータ一覧と手順で各仕組みの実装ポイントを説明します。任意の言語で実装する際の参考にしてください。
指数バックオフによるリトライの実装ポイント
指数バックオフとは、リトライのたびに待機時間を倍増させ、さらにランダムなジッターを加える方法です。実装時は、次の手順でロジックを組み立てます。
- リトライ可能なエラーの集合を定義します。例えば、
429(利用枠不足を除く)、500、502、503、504、ネットワークタイムアウトなどです。 - 失敗するたびに、まずレスポンスヘッダーの
Retry-Afterを確認します。値があればそれに従って待機し、なければバックオフの計算式で待機時間を求めます。 - 待機時間は通常、「基本間隔 × 2 のリトライ回数乗」で計算し、ランダムなジッターを加えます。1回あたりの待機時間には上限も設けます。
- 最大リトライ回数と総所要時間の上限を設定し、どちらかを超えたら直ちに中止して、エラーをフォールバック処理に渡します。
- リトライのたびに、エラーコード、リトライ回数、待機時間、モデル名をログに記録します。事後分析に役立ちます。
公式SDKを使用する場合、多くのSDKには max_retries や timeout などのパラメータが用意されています。この場合、外側に同じようなリトライ処理を重ねないよう注意しましょう。リトライ回数が掛け合わされ、障害時にリクエスト数が大幅に増えてしまいます。
次の表は、一般的な初期設定値の例です。これらは経験に基づく目安であり、実際の値はビジネス上の遅延要件やサービス提供元の制限に合わせて調整してください。
| パラメータ | 意味 | 一般的な初期値 | 調整の目安 |
|---|---|---|---|
max_retries |
最大リトライ回数 | 2~5回 | リアルタイム対話では小さく、オフラインのバッチ処理では大きくする |
| 基本間隔 | 初回リトライまでの待機時間 | 約1秒 | レート制限が厳しいサービスでは長めにする |
| 1回あたりの待機時間の上限 | バックオフ時間の上限 | 数十秒程度 | 1回の待機が長くなりすぎてリクエストに支障が出るのを防ぐ |
| ランダムジッター | リトライのタイミングを分散 | 待機時間の一部に相当するランダム値 | 同時接続するクライアントが多いほど重要 |
| 総所要時間の上限 | 1回の呼び出しにかけられる最長時間 | ビジネスのSLAに応じて設定 | タイムアウト後は直接フォールバック |
🚀 クイックスタート:テスト段階で、エラーコードごとのリトライ動作を試したい場合は、APIYI apiyi.com の統一されたOpenAI互換インターフェースを通じて複数のモデルに接続できます。同じリトライロジックで各モデルのレスポンスやエラーを確認でき、サービス提供元ごとに個別対応する手間を減らせます。
複数モデルへのフォールバックの設計方法
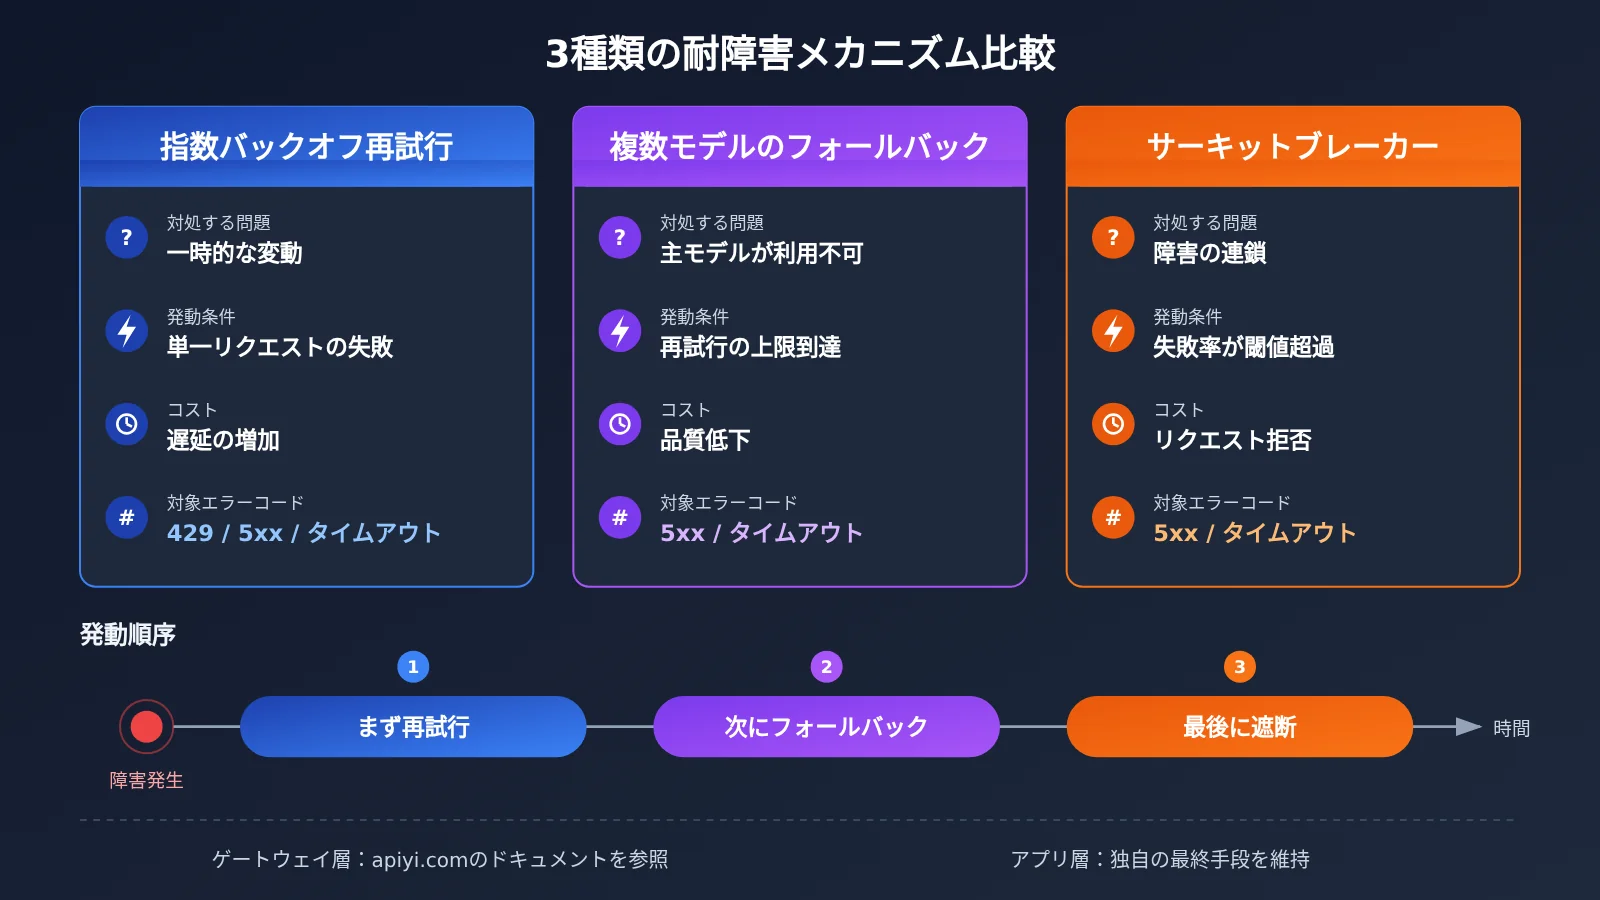
リトライは「同じモデルが一時的に利用できない」場合への対処で、フォールバックは「そのモデルが短時間では復旧しない」場合への対処です。複数モデルへのフォールバックでは、あらかじめ代替経路を設定しておきます。メインモデルで連続してエラーが発生したら、代替モデルに順番に切り替えることで、サービスの応答を継続できます。ただし、品質が多少低下したり、コストが増えたりする可能性があります。
フォールバック先を選ぶ際は、必要な機能を同等に備えているかを確認しましょう。メインモデルで関数呼び出し、構造化出力、長いコンテキストを利用している場合、代替モデルもそれらの機能をサポートしている必要があります。そうでなければ、切り替え後に新たな 400 エラーが発生したり、出力形式の解析に失敗したりします。次の表は、用途別のフォールバック設計の参考例です。
| 業務シナリオ | メインモデルの役割 | 第1代替 | 第2代替 | 利用可能なプラットフォーム |
|---|---|---|---|---|
| オンラインカスタマーサポートの対話 | 高品質な汎用モデル | 同等レベルの他社モデル | 軽量で高速なモデル + 簡易的な返信 | APIYI apiyi.com、各社の公式 API |
| コード生成とレビュー | コーディング能力に優れたフラッグシップモデル | 他社のフラッグシップモデル | 「後でもう一度お試しください」と表示 | APIYI apiyi.com、各社の公式 API |
| コンテンツの一括処理 | コストパフォーマンスに優れたモデル | 同価格帯の他のモデル | キューに入れて後で処理 | APIYI apiyi.com、各社の公式 API |
| 構造化情報の抽出 | JSON 出力をサポートするモデル | 同じく構造化出力をサポートするモデル | ルールエンジンで代替 | APIYI apiyi.com、各社の公式 API |
フォールバック時には、次の点にも注意が必要です。
- プロンプトの調整:システムプロンプトへの反応はモデルによって異なります。代替モデルには、検証済みの専用プロンプトを用意するのが望ましいでしょう。
- コンテキスト長:切り替え前に、メッセージの長さが代替モデルのコンテキストウィンドウを超えていないか確認し、必要に応じて履歴を切り詰めます。
- 結果の記録:ログや監視システムに「この応答はフォールバック先のモデルによるもの」と記録し、品質への影響を評価しやすくします。
- 認証エラーではフォールバックしない:401 は設定に問題があることを示します。モデルを切り替えると問題を隠してしまうだけなので、すぐにアラートを出しましょう。
サーキットブレーカーの仕組みと適用範囲
サーキットブレーカーは、障害が続いている依存先によってシステム全体が機能不全に陥るのを防ぎます。通常は3つの状態があります。クローズ状態ではリクエストを通常どおり通し、同時に失敗率を集計します。失敗率や連続失敗回数がしきい値を超えるとオープン状態に移り、リクエストを即座に拒否するか、フォールバック処理を実行して、障害のある上流サービスにはアクセスしません。一定の冷却期間が過ぎるとハーフオープン状態となり、少数の試行リクエストを通します。成功すればクローズ状態に戻り、失敗すれば再びオープン状態になります。
サーキットブレーカーで重要なのは、上流サービスの健全性を表すエラーだけを集計することです。5xxとタイムアウトは失敗率に含めるべきですが、401や400のようなクライアントエラーは含めるべきではありません。そうしないと、設定ミスによってサーキットブレーカーがオープンになり、正常なリクエストまで拒否されてしまいます。利用枠の不足によって返される429も、サービスの健全性ではなくアカウントの状態を示しているため、集計に含めるべきではありません。
また、サーキットブレーカーは多用すればよいというものでもありません。呼び出し回数の少ない内部ツールでは、失敗率の集計に必要なサンプルが不足し、誤判定が起きやすくなります。このような場合は、シンプルなリトライとフォールバックで十分です。サーキットブレーカーは、同時アクセスの多い本番サービスにより適しています。上流サービスで大規模な障害が発生した際に被害の拡大を素早く食い止め、応答の遅いリクエストがスレッドプールやコネクションプールを占有するのを防げます。
ゲートウェイ層とアプリケーション層におけるフォールトトレランスの役割分担
APIゲートウェイや集約プラットフォームを通じて大規模言語モデルを呼び出すチームが増えています。そこでよくある疑問が、「ゲートウェイに自動フォールバックがあるなら、アプリケーション層でもリトライやサーキットブレーカーが必要なのか」というものです。答えは「必要ですが、役割は異なります」。ゲートウェイは「上流の接続先」に関する問題を扱うのが得意で、アプリケーション層は「ビジネス上の意味」に関する問題をよりよく理解しています。それぞれが適した範囲を担当します。
| フォールトトレランスの役割 | ゲートウェイ層に適した処理 | アプリケーション層に適した処理 |
|---|---|---|
| 接続先の切り替え | 同一モデルの複数接続先間での切り替え、負荷分散 | 重複して実装する必要はない |
| モデル間のフォールバック | モデルのルーティング機能を提供 | 品質低下を業務上許容できるか、プロンプトの変更が必要かを判断 |
| リトライ | 接続先レベルでの迅速なリトライ | 業務レベルでのリトライ回数・時間の上限、ユーザーのタイムアウト体験との調整 |
| サーキットブレーカー | 上流の接続先に対するヘルスチェック | ゲートウェイ全体に接続できない場合のサーキットブレーカーと代替処理 |
| 認証・利用枠のエラー | 明確なエラー種別を返す | アラート、リトライの停止、担当者への通知 |
| 監視 | 接続先レベルの成功率とレイテンシ | 業務レベルの成功率、フォールバック率、ユーザーへの影響 |
APIYI を例に挙げると、サービス紹介では自動フォールバック、負荷分散、リアルタイム監視などの安定性に関する機能が紹介されています。このような機能に接続先レベルの切り替えを任せれば、アプリケーション層は業務上の代替処理に注力できます。ただし、ゲートウェイのフォールバック発動条件や、返されるエラーコード・エラー本文の形式が公式APIと完全に一致するかどうかは、プラットフォームのドキュメントと実際のテストで確認する必要があります。また、サービス紹介にある「同時実行数の制限なし」も、429が決して発生しないことを意味するわけではありません。上流モデル自体の制限は依然として存在します。安全策として、アプリケーション層には常に429や5xxへの処理を残し、ゲートウェイ全体に接続できない場合に備えて独自の代替手段を用意しておきましょう。
🎯 技術的なアドバイス:ゲートウェイへの接続後は、まずテスト環境で意図的にいくつかのエラーを発生させることをおすすめします。たとえば、誤ったキーを使う、存在しないモデル名を指定する、長すぎるコンテキストを送信するといった方法です。APIYI apiyi.com が実際に返すステータスコードとエラー本文のフィールドを記録し、公式ドキュメントのエラー形式をそのまま使うのではなく、その結果に基づいてアプリケーション層のエラー分類ルールを調整しましょう。
よくある質問 FAQ
Q1:AI APIの429エラーと500エラーの本質的な違いは何ですか?
429はリクエストが制限を超えたことを示し、呼び出し側のリクエスト頻度やアカウントの利用枠に問題があります。500はサーバー側のエラーで、上流側に問題があります。前者はまずリクエスト頻度を下げ、指定された待機時間を守ります。後者は回数を制限してリトライし、失敗が続く場合はフォールバックします。どちらも「少し待てば直る」可能性がありますが、対処の重点は異なります。
Q2:なぜ401エラーは自動リトライしてはいけないのですか?
401は確定的なエラーで、キーが間違っていれば1万回リトライしても結果は同じです。自動リトライはリソースを無駄にするだけでなく、問題を見えにくくし、アラートを遅らせる原因にもなります。すぐに処理を中断し、キーの内容、環境変数の設定、リクエスト先のアドレスが正しいかを確認しましょう。
Q3:429がリトライを続けても解消しない場合、どのような原因が考えられますか?
最も多い原因は、利用枠や残高の使い切りです。一部のサービスでは、この場合も429が返されますが、エラーボディ内のタイプを示すフィールドは通常のレート制限とは異なります。もう一つの可能性は、リトライにランダムなジッターを加えていないことです。大量のリクエストが同時に再送され、制限に達し続けている場合があります。まずエラーボディを確認し、次にリトライのタイミングが分散されているかを確認しましょう。
Q4:複数モデル間のフォールバックは出力品質に影響しますか?
影響する可能性があります。フォールバックは本質的に、品質と引き換えに可用性を確保する手段です。そのため、どの場面ならフォールバックを許容できるかを業務面から明確にしておく必要があります。予備モデル用に個別に検証したプロンプトを用意し、モニタリングでフォールバック率を集計することをおすすめします。フォールバック率が長期間高い場合は、メインモデルの利用枠と安定性を確認しましょう。
Q5:異なるモデル間のフォールバック経路を低コストでテストするにはどうすればよいですか?
複数モデルに対応した統一インターフェースを提供するプラットフォームを使って、テスト環境を構築できます。例えば、APIYI apiyi.com を利用すれば、同じOpenAI互換の呼び出し方式で異なる提供元のモデルを切り替えられます。モデル名を変更するだけで、同じプロンプトに対するメインモデルと予備モデルの出力の違いやエラー時の挙動を検証できるため、本番公開前のフォールバック演習に適しています。
Q6:自動フォールバック機能付きのゲートウェイを使う場合も、アプリケーション層にサーキットブレーカーは必要ですか?
必要です。ゲートウェイのフォールバックは上流の接続先に関する問題を解決しますが、ゲートウェイ自体にもネットワークがつながらない、全体が利用できなくなるといった問題が起こりえます。アプリケーション層のサーキットブレーカーと代替処理は、このような事態に備えるものです。APIYIのようなゲートウェイを使う場合は、アプリケーション層のサーキットブレーカーの集計対象を個々のモデルの接続先ではなく「ゲートウェイ全体」にすることで、両層の役割が重複しなくなります。
Q7:リトライ、フォールバック、サーキットブレーカーにはどのような副作用がありますか?
リトライでは重複課金が発生する可能性があり、冪等でない操作(ツール呼び出しを伴う書き込み操作など)では、処理が重複して実行される可能性があります。フォールバックでは品質の変動や出力形式の違いが生じることがあります。サーキットブレーカーのパラメータを敏感に設定しすぎると、正常なリクエストまで拒否してしまいます。そのため、いずれも一度設定して終わりにせず、モニタリング指標を確認しながら継続的に調整する必要があります。
AI APIのエラー処理:押さえておきたいポイント
- まず分類してから対処:設定やリクエストに原因があるエラーはすぐに修正し、一時的なエラーだけをリトライします。
- 429はエラー本文を確認:レート制限と利用枠の枯渇を区別します。後者はリトライしても意味がありません。
- 401は絶対にリトライしない:すぐにアラートを出し、キー、環境変数、APIの接続先が正しい組み合わせになっているかを重点的に確認します。
- リトライには上限を設ける:指数バックオフにランダムなジッターを加え、回数と総経過時間の両方に上限を設定します。
- フォールバック先の機能を揃える:代替モデルが同じ機能をサポートしていることを確認し、モデルごとに専用のプロンプトを用意します。
- サーキットブレーカーではサーバー側エラーのみをカウント:5xxとタイムアウトは失敗率に含め、クライアント側エラーは含めません。
- ゲートウェイとアプリケーションで役割分担:APIYI apiyi.com を活用して接続先レベルの耐障害性を確保し、アプリケーション側で業務上の最終的な対処を担います。
まとめ
AI APIで429、401、500が返されたときに最も大切なのは、「すべて一律にリトライする」習慣をやめ、エラーの性質に応じて対処することです。
- レート制限エラー:
Retry-Afterを守り、指数バックオフとジッターを使ってリトライします。同時に、並列実行数とトークン使用量を発生源から制御します。 - 認証・リクエストエラー:すぐに処理を中断してアラートを出し、設定を修正します。自動リトライはせず、フォールバックで問題を隠すことも避けます。
- サーバー側エラー:回数を限定してリトライし、失敗が続く場合は代替モデルに切り替えます。高並列の環境では、サーキットブレーカーと組み合わせて被害の拡大を防ぎます。
- ゲートウェイとアプリケーションの役割分担:ゲートウェイは接続先の切り替えと負荷分散を担当し、アプリケーション側は業務上の意味、リトライの上限、最終的な対処を管理します。
まずは、この記事の判断表をチーム内のエラー処理ルールとしてまとめ、そのルールに沿って障害対応訓練を実施することをおすすめします。エラーの種類ごとに、想定した処理に進むことを確認しましょう。
複数モデルを使ったフォールバックの仕組みを検討している場合は、APIYI apiyi.com を通じて、統一されたインターフェースで複数モデルの性能やエラー時の挙動を比較できます。まずはテスト環境で耐障害性を検証してから、本番環境に導入しましょう。
📚 参考資料
- Ofox.ai Blog – AI API Error Handling に関する記事:429 レート制限、401 認証エラー、500 サーバーエラーへの対処法や、指数バックオフ、複数モデルへのフォールバック、サーキットブレーカーを紹介
- リンク:
ofox.ai/blog/page/41/ -
補足:本記事のテーマを検討する際に参考にした資料です。英語の原文とあわせてご覧ください
-
Ofox.ai Blog – LLM API Gateway 関連記事:LLM ゲートウェイの選定と、複数のサービスプロバイダーにまたがる障害について解説
- リンク:
ofox.ai/blog/page/40/ -
補足:複数モデルを組み合わせたアーキテクチャにおける、ゲートウェイ層の耐障害性の位置づけを理解するのに役立ちます
-
APIYI ドキュメントセンター:プラットフォームへの接続方法と利用ドキュメント
- リンク:
docs.apiyi.com - 補足:エラーコードの形式やフォールバックの動作などの詳細は、プラットフォームのドキュメントと実際のテスト結果をご確認ください
著者:APIYI 技術チーム
技術交流:AI API の安定運用について、ぜひ APIYI のウェブサイトのトップページからお問い合わせください。接続に関する詳しい資料は、docs.apiyi.com のドキュメントセンターをご覧ください