
Nota do autor: usando uma solicitação de controle de qualidade de atendimento ao cliente como exemplo, vamos destrinchar a aceitação da saída do GPT-6.2 Sol na Responses API, a manutenção do estado da sessão e a recuperação de resultados em segundo plano.
Conclusão primeiro: para integrar o GPT-6.2 Sol a um sistema de produção, é preciso dividir a mesma tarefa de negócio em quatro comportamentos e definir critérios de aceitação para cada um. São eles: feedback imediato na interface, resultado que a máquina possa armazenar, contexto entre turnos e estado final. Os eventos de streaming servem apenas para exibição; antes de armazenar, é obrigatório obter a resposta completa e passar pela validação de Schema e de negócio. Para informações entre turnos, primeiro é preciso definir quem mantém o estado. Tarefas em segundo plano reconhecem apenas o ID de resposta e o estado terminal; as notificações podem se repetir, então a gravação deve ser idempotente.
Para atender a esses quatro pontos, há duas premissas. Primeiro, quando forem necessárias ferramentas integradas ou personalizadas, siga as instruções de migração do GPT-6.2 para a Responses API; este artigo também aborda apenas o comportamento de execução da Responses. Segundo, se a chamada for feita por meio de uma plataforma agregadora, a disponibilidade de recursos como modo em segundo plano e Webhook depende da configuração atual da plataforma. Na APIYI apiyi.com, o gpt-6.2-sol já está listado publicamente com as duas entradas responses e chat.
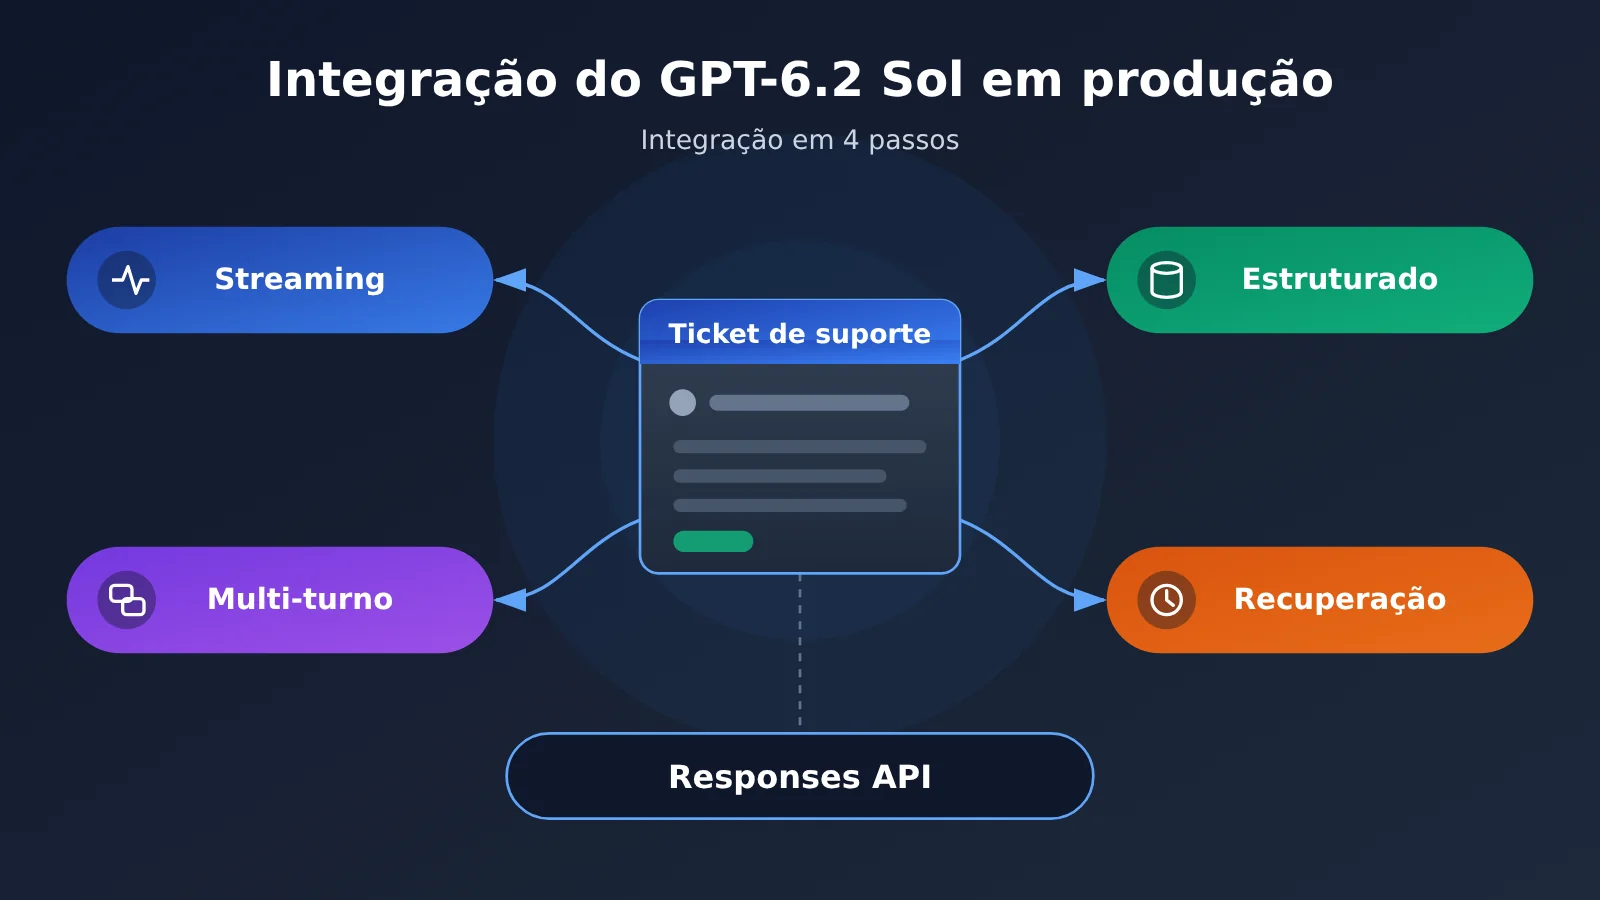
Mapa de conhecimento para colocar o GPT-6.2 Sol em produção
O artigo inteiro gira em torno de um único fluxo: enviar a requisição → exibir → continuar → reler → aceitar. O diagrama abaixo mostra os artefatos de cada etapa e a seção do texto correspondente.
Enviar a requisição(model=gpt-6.2-sol,Responses API)
  │
  ├─▶ Exibição【Seção 1】
  │     Eventos incrementais → a página mostra os pareceres de QA em tempo real
  │     Evento de estado final → encerra o carregamento; resposta completa → Schema + validação de negócio → persistência / revisão humana
  │
  ├─▶ Continuação【Seção 2】
  │     Histórico autogerenciado / previous_response_id / Conversation
  │     Regras permanentes (developer) separadas das instruções do turno (instructions)
  │
  ├─▶ Releitura【Seção 3】
  │     Envio em background → salvar o ID da resposta → verificação de assinatura e deduplicação do Webhook → releitura por ID → salvar o estado final
  │
  └─▶ Aceitação【Seção 4】
         Sucesso / resposta incompleta / notificação duplicada / cliente desconectado / mudança de Schema
Índice de integração do GPT-6.2 Sol
| Seção | Pergunta que responde | O que entrega para o restante do texto | O que você consegue fazer ao terminar |
|---|---|---|---|
| 1. Streaming e estruturação | Como a página acompanha o stream e como a máquina recebe o resultado | Define os critérios de “concluído” e “pronto para persistir” | Distinguir o caminho de exibição do caminho de persistência |
| 2. Estado em múltiplos turnos | Como a próxima requisição se conecta ao turno anterior | Define quem detém o estado e as condições de retenção | Alterar só o foco do turno, sem quebrar o prefixo |
| 3. Tarefas em background | Como o resultado é persistido depois que o usuário sai da página | A correspondência entre ID da resposta, ID da tarefa e estado final | Implementar verificação de assinatura, deduplicação e escrita idempotente |
| 4. Aceitação para produção | Quais comportamentos precisam ser validados antecipadamente | Reúne os critérios definidos nas três seções anteriores | Produzir um registro de regressão rastreável |
As seções 1 a 3 correspondem, cada uma, a um caminho de execução. Se você só vai implementar um deles, pode consultar conforme a necessidade. A seção 4 depende dos estados definidos nas três seções anteriores, então é melhor deixá-la para o final.
Termos essenciais do GPT-6.2 Sol
| Termo | Explicação |
|---|---|
| SSE | Protocolo pelo qual o servidor envia eventos ao cliente em ordem, usando uma única conexão HTTP. |
| Structured Outputs | Recurso da API que exige que o conteúdo estruturado retornado em caso de sucesso esteja em conformidade com um JSON Schema suportado. |
| Resposta de recusa | Item de conteúdo retornado quando o modelo recusa explicitamente a tarefa; precisa de um fluxo separado. |
| Estado da sessão | Contexto como mensagens e resultados de ferramentas, mantido para requisições subsequentes. |
| Item de raciocínio criptografado | Item de resposta criptografado usado para continuar o estado de raciocínio, que pode ser reenviado junto com o contexto. |
| Prefixo | A sequência de contexto no início da requisição atual que é idêntica à do turno anterior. |
| Janela de conclusão | Faixa de tempo alvo para a conclusão definida para essa resposta, depois que o serviço aceita a requisição em background. |
| Webhook | Notificação assinada que o servidor envia proativamente para uma URL indicada pela aplicação. |
| Estado final | O estado definitivo após a tarefa ser concluída, falhar, ficar incompleta ou ser cancelada. |
| Idempotência | Quando o mesmo callback ou tarefa é processado repetidamente, mas produz efeito de negócio apenas uma vez. |
1. Saída em streaming e validação estrutural do GPT-6.2 Sol
1.1 Os dois caminhos de saída do GPT-6.2 Sol
Vamos começar com um cenário de controle de qualidade no atendimento. O atendente de plantão abre um ticket e a página precisa exibir imediatamente o parecer de supervisão gerado pelo modelo. O resultado da mesma análise também precisa ser gravado no banco de controle de qualidade para as estatísticas de fim de dia. Essas duas necessidades têm definições diferentes de “conclusão”, por isso é preciso tratá-las como dois caminhos separados.
| Caminho | Consumidor | Sinal de que depende | Condição para determinar “conclusão” | Destino em caso de falha |
|---|---|---|---|---|
| Caminho de exibição | Página do atendente | Evento incremental response.output_text.delta |
Recebimento de response.completed ou de evento de estado terminal de falha |
Aviso na página, mantendo o conteúdo já exibido |
| Caminho de gravação no banco | Banco de dados de controle de qualidade | Objeto de resposta completo | Validação de Schema e validação de negócio ambas aprovadas | Rejeição, resposta incompleta e erro de formato entram separadamente em revisão manual |
Depois de definir stream=true na requisição de streaming, o servidor envia os eventos em sequência via HTTP SSE. A página só precisa anexar e exibir o texto contido em response.output_text.delta. Já o estado de carregamento precisa aguardar um evento de estado terminal para terminar — o fato de o texto parar de sair não significa que a tarefa foi concluída.
1.2 Exemplo de exibição em streaming do GPT-6.2 Sol
O exemplo abaixo serve apenas para demonstração. Ele entrega o texto incremental ao frontend e encerra a espera no estado final:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Entrada compatível com OpenAI da APIYI
)

stream = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "你是客服质检督查员,只依据工单原文给出意见。"},
        {"role": "user", "content": "工单 #A1024:客户三次催单未获回复……"},
    ],
    stream=True,
)

for event in stream:
    if event.type == "response.output_text.delta":
        push_to_page(event.delta)          # Adiciona em tempo real na página
    elif event.type == "response.completed":
        finish_loading(event.response.id)  # Encerra o carregamento com o estado final
    elif event.type in ("response.failed", "response.incomplete"):
        show_error(event.type)             # Falha e incompleto são avisados separadamente
push_to_page, finish_loading e assim por diante são funções do lado do negócio. A lista completa de eventos de estado final deve seguir a documentação oficial de resposta em streaming.
1.3 Ordem de validação da saída estruturada do GPT-6.2 Sol
Na Responses API, a saída estruturada é declarada em text.format, não dentro das mensagens. Depois que o caminho de persistência recebe a resposta completa, a decisão segue esta ordem:
- Verifique o status da resposta. Respostas incompletas (
statusigual a incomplete) vão direto para revisão manual, sem tentar interpretar um JSON pela metade. - Verifique os itens de conteúdo. Se aparecer algum item do tipo recusa, siga o fluxo de recusa e não o trate como erro de formato.
- Faça o parse do JSON e a validação contra o Schema.
- Faça a validação de negócio: o ticket original existe, campos faltantes devem ficar claramente visíveis e não podem ser preenchidos silenciosamente.
Ver o código completo de persistência estruturada do GPT-6.2 Sol
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

QA_SCHEMA = {
    "type": "object",
    "properties": {
        "ticket_id": {"type": "string"},
        "verdict": {"type": "string", "enum": ["合格", "需整改", "信息不足"]},
        "issues": {"type": "array", "items": {"type": "string"}},
        "missing_fields": {"type": "array", "items": {"type": "string"}},
    },
    "required": ["ticket_id", "verdict", "issues", "missing_fields"],
    "additionalProperties": False,
}

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[{"role": "user", "content": "请质检工单 #A1024:……"}],
    text={"format": {"type": "json_schema", "name": "qa_result",
                     "schema": QA_SCHEMA, "strict": True}},
)

def route(resp):
    if resp.status == "incomplete":
        return ("manual_review", "incomplete", resp.incomplete_details)
    for item in resp.output:
        for part in getattr(item, "content", []) or []:
            if part.type == "refusal":
                return ("manual_review", "refusal", part.refusal)
    try:
        data = json.loads(resp.output_text)
    except json.JSONDecodeError:
        return ("manual_review", "bad_json", None)
    if not ticket_exists(data["ticket_id"]):
        return ("manual_review", "unknown_ticket", data)
    return ("save", "ok", data)

print(route(resp), resp.id)
Atenção: passar na validação de Schema só significa que a estrutura está correta, não que o conteúdo está correto. Se o número do ticket existe e se os campos faltantes foram apontados fielmente são checagens que precisam ser feitas na camada de negócio.
🎯 Dica técnica: Em ambiente de teste, você pode disparar ao mesmo tempo requisições em streaming e não streaming através do APIYI apiyi.com, e comparar o estado final e o resultado de persistência do mesmo ticket nos dois caminhos. Assim dá para confirmar antecipadamente que a lógica de carregamento do frontend e os ramos de persistência não interferem entre si.
2. GPT-6.2 Sol: continuidade de estado em conversas multi-turno
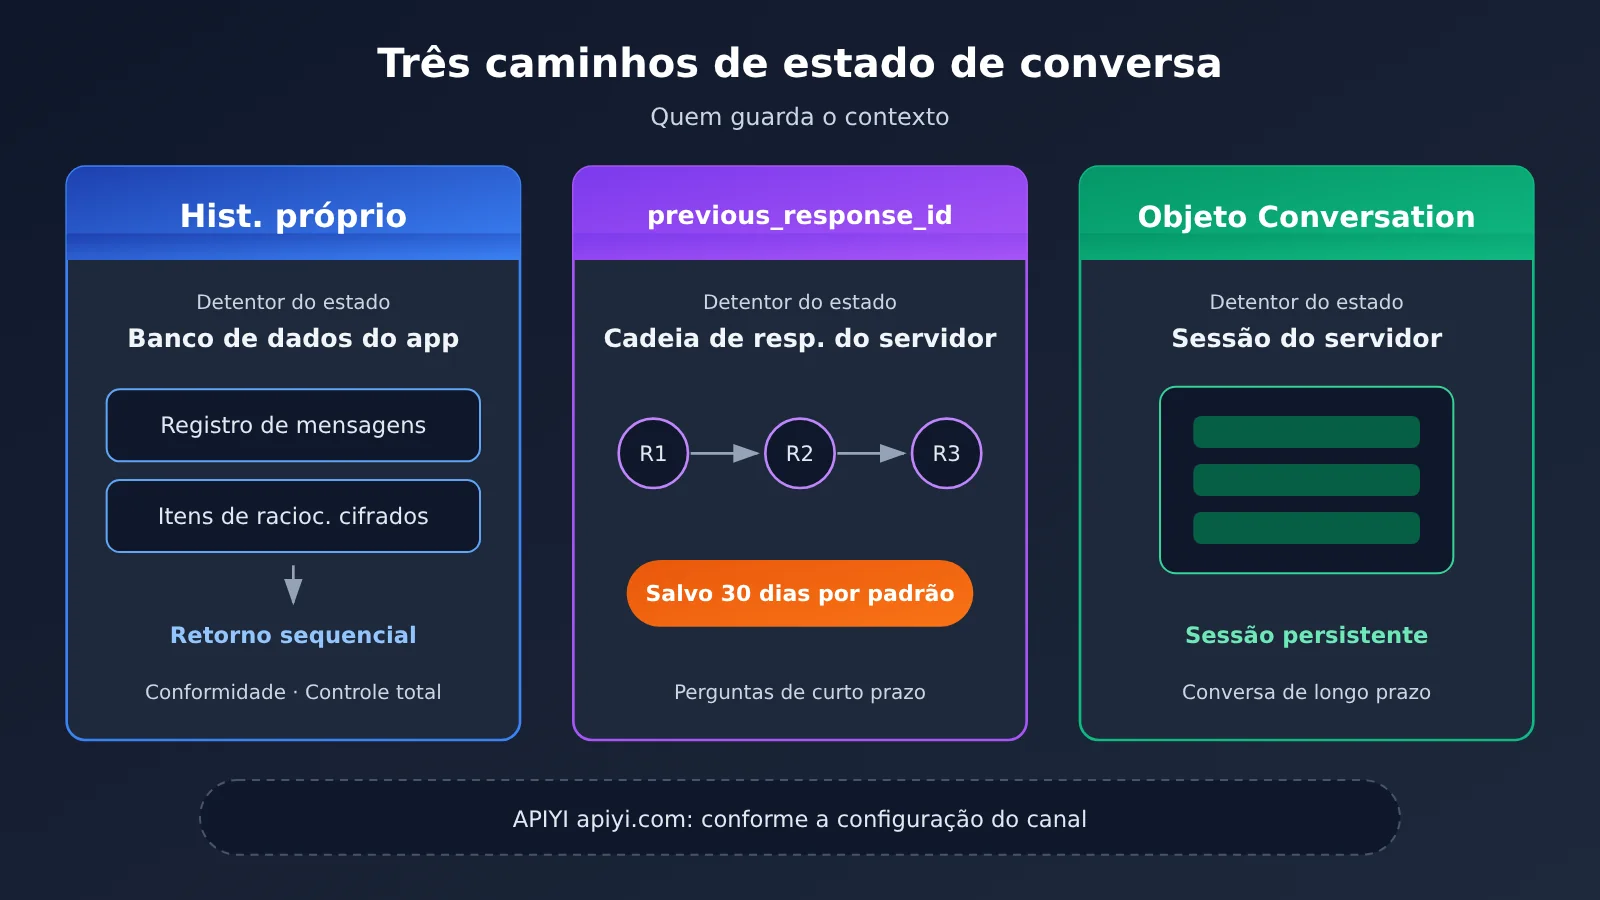
2.1 Comparação dos três caminhos de estado do GPT-6.2 Sol
O atendente acrescenta novos fatos na mesma ordem de serviço e quer que o modelo continue a análise a partir da rodada anterior. A primeira pergunta a responder, então, é: quem guarda o contexto?
| Caminho | Dono do estado | Condição de retenção | Cenário adequado | Plataformas disponíveis |
|---|---|---|---|---|
| Histórico autogerenciado | A própria aplicação | Decidido pela aplicação; é preciso reenviar as mensagens na ordem original e os itens de resposta necessários | Requisitos de conformidade ou necessidade de controle total do contexto | API oficial, APIYI apiyi.com |
previous_response_id |
Cadeia de respostas do lado do servidor | Só dá para continuar enquanto a resposta estiver disponível; o objeto de resposta fica salvo por 30 dias por padrão | Perguntas de acompanhamento de curto prazo | Depende da configuração atual do canal |
| Objeto Conversation | Objeto de sessão do lado do servidor | Os itens anexados ao Conversation seguem as regras de retenção desse objeto | Conversas que precisam de maior persistência | Depende da configuração atual do canal |
Se você optar pelo histórico autogerenciado e, ao mesmo tempo, quiser que o raciocínio seja contínuo, não basta reenviar apenas texto. Os itens de resposta necessários precisam ser preservados e reproduzidos em ordem, incluindo os itens de raciocínio criptografados.
2.2 Como alterar apenas o foco de auditoria no GPT-6.2 Sol
Suponha que, na segunda rodada, você queira apenas mudar o foco da auditoria de “tempo de resposta” para “conformidade do script”. O jeito certo é: colocar as regras gerais de controle de qualidade na primeira mensagem developer da cadeia, e escrever o foco específico desta rodada no instructions de nível superior. O instructions vale apenas para a requisição em que foi fornecido e não contamina as rodadas seguintes.
first = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "通用质检规则:依据工单原文;缺项必须列出……"},
        {"role": "user", "content": "质检工单 #A1024,关注响应时效。"},
    ],
)

second = client.responses.create(
    model="gpt-6.2-sol",
    previous_response_id=first.id,
    instructions="本轮只审查话术合规,不重复时效结论。",  # vale apenas para esta requisição
    input=[{"role": "user", "content": "补充:坐席第二次回复使用了模板话术。"}],
)
Escrever assim traz ainda uma vantagem: a primeira regra permanece intacta e o prefixo fica estável.
2.3 Riscos de alteração de prefixo no GPT-6.2 Sol
O GPT-6.2 pode limpar itens de raciocínio relevantes em algumas situações: reescrever histórico antigo, fazer troca parcial de modelo (por exemplo, downgrade) e trocar de usuário ou de organização. Para sessões Standard de agente único que precisam continuar, se você quiser ajustar o nível de raciocínio ou o Schema de saída, deve acrescentar um item configuration_update aplicável, em vez de voltar e alterar a configuração antiga. Os campos específicos desse item seguem o guia de migração do GPT-6.2.
Quando regras de longo prazo precisarem ser atualizadas, acrescente uma nova mensagem developer ao final do contexto, sem editar as regras antigas e sem mexer nas configurações anteriores de ferramentas e Schema. Mesmo que o prefixo permaneça estável, o acerto do cache ainda depende da requisição específica e das condições de processamento — não dá para tratá-lo como resultado garantido.
3. Persistência de tarefas em background do GPT-6.2 Sol
3.1 Submissão e janelas de conclusão em background do GPT-6.2 Sol
O resumo de tickets aguardando revisão no fim do dia pode demorar bastante, e o atendente também não fica o tempo todo com a página aberta. Esse tipo de tarefa é submetido com background: true. Assim que a submissão retorna, salve imediatamente de forma persistente o ID de resposta recebido e mapeie-o um a um com o ID da tarefa de negócio.
A janela de conclusão é escolhida de acordo com o tempo de espera aceitável; o valor padrão é soonest. 2h e 8h são janelas com desconto no Standard, atualmente em teste público, e não permitem ativar streaming no momento da submissão. Os nomes dos parâmetros da janela de conclusão e os requisitos de armazenamento seguem a documentação do modo background.
| Janela de conclusão | Posicionamento | Streaming | Tarefas de QA adequadas |
|---|---|---|---|
soonest (padrão) |
Concluir o quanto antes | Conforme a documentação do modo background | Revisões que precisam ser reexaminadas no turno |
2h |
Janela com desconto Standard, teste público | Não ativar | Consolidação pós-turno |
8h |
Janela com desconto Standard, teste público | Não ativar | Resumos em lote de fim de dia |
3.2 Validação de assinatura, deduplicação e releitura do Webhook do GPT-6.2 Sol
Enquanto a tarefa está na fila ou em andamento, basta consultar continuamente o mesmo ID. Se receber um evento de conclusão, processe na seguinte ordem:
- Verifique a assinatura. Se a validação falhar, descarte imediatamente.
- Use o
webhook-idpara deduplicar. A mesma notificação pode ser reenviada. - Releia a resposta completa por
event.data.id. A notificação em si não é usada como resultado. - Grave o estado final e o resultado de forma idempotente, usando o ID da tarefa.
Ver o código de recuperação de tarefas em background do GPT-6.2 Sol
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Submissão
job = client.responses.create(
    model="gpt-6.2-sol",
    background=True,
    input=[{"role": "user", "content": "汇总今日待审工单摘要:……"}],
)
db.save_task(task_id="QA-20261120-01", response_id=job.id, status=job.status)

# Processamento do Webhook
def on_webhook(headers, raw_body):
    event = verify_and_parse(headers, raw_body)        # verificação de assinatura; se falhar, lança exceção
    if db.seen_webhook(headers["webhook-id"]):         # deduplicação
        return 200
    db.mark_webhook(headers["webhook-id"])
    resp = client.responses.retrieve(event.data.id)    # reler a resposta completa
    task_id = db.task_by_response(resp.id)
    db.upsert_result(task_id, status=resp.status,      # gravação idempotente pelo ID da tarefa
                     body=resp.output_text if resp.status == "completed" else None)
    return 200
Quando o usuário fecha a página e volta depois, o front-end só precisa consultar o banco local com o ID da tarefa de negócio. Se o estado ainda não chegou ao estado final, o servidor continua consultando com o ID de resposta já salvo.
Atenção especial à retenção de dados. O modo background, para permitir a releitura, armazena temporariamente os dados da resposta. Mesmo com store: false definido, ou com ZDR habilitado na organização, isso não muda; por isso, confira na documentação de controle de dados se isso é aceitável.
💡 Sugestão de integração: O endereço de callback do Webhook e o modo background exigem suporte do canal. Antes de integrar via APIYI apiyi.com, recomendo confirmar se o grupo atual da conta tem o modo background e a capacidade de callback liberados. Se ainda não estiverem liberados, dá para começar usando polling pelo ID de resposta para validar a máquina de estados.
4. Checklist de aceitação de lançamento do GPT-6.2 Sol
4.1 Tabela de aceitação sintética do GPT-6.2 Sol
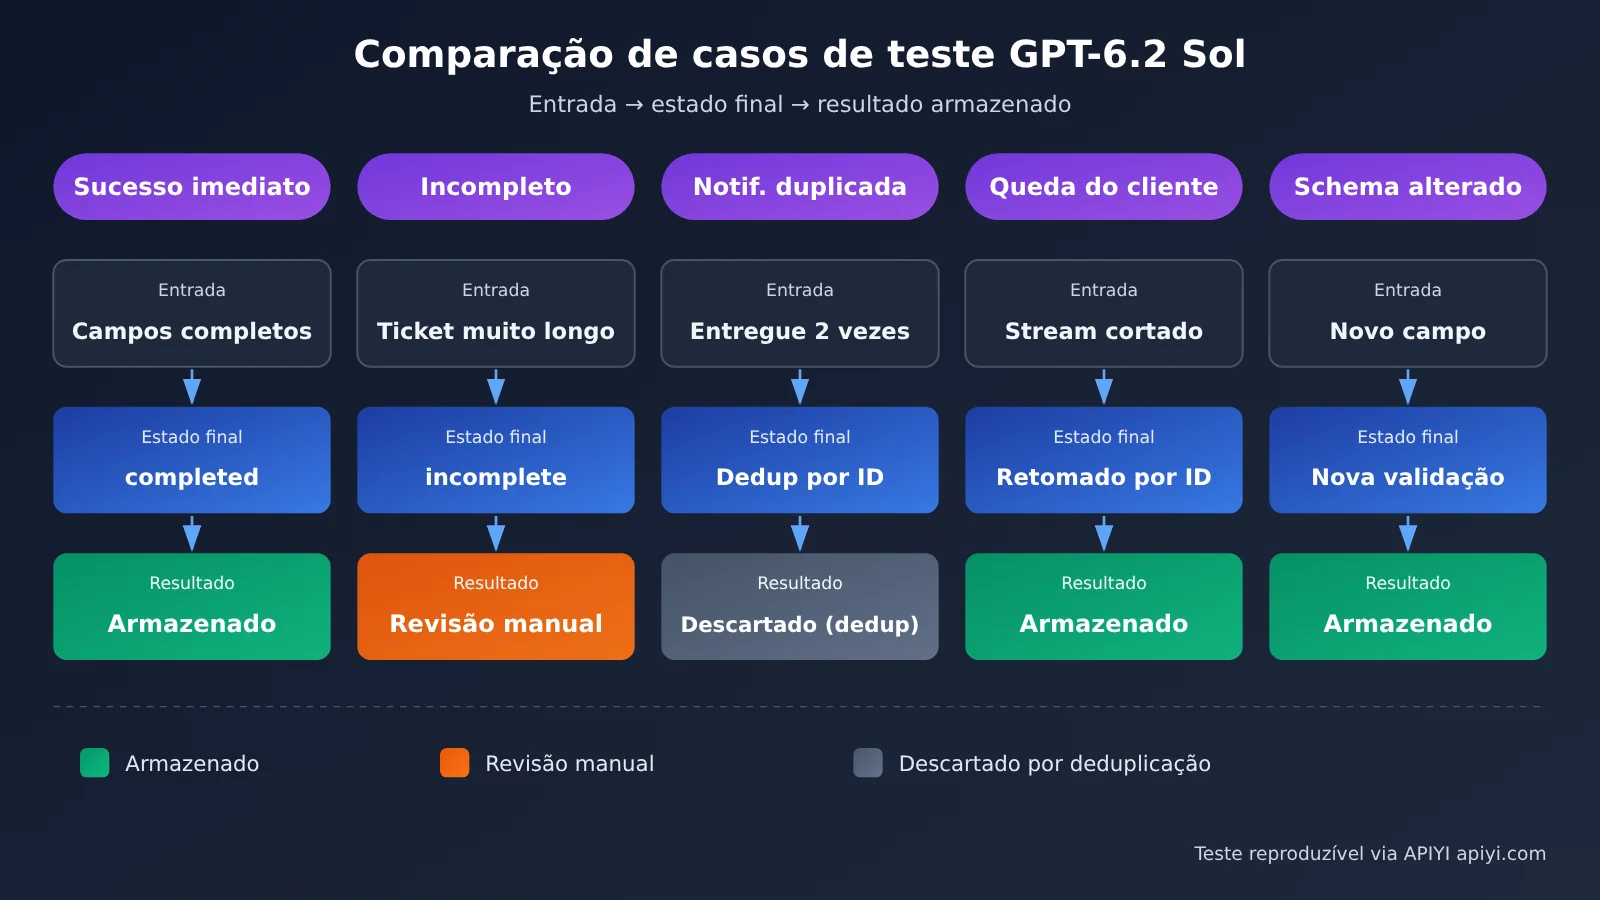
A tabela de aceitação abaixo continua usando o caso sintético de controle de qualidade do atendimento ao cliente, transformando item por item os critérios de decisão das três seções anteriores em casos de teste executáveis.
| Caso de teste | Condições de entrada | Estado ou resultado esperado |
|---|---|---|
| Sucesso na primeira tentativa | Ticket real existente, com todos os campos preenchidos | Estado final completed; validação de Schema e de negócio aprovada; um registro gravado por task ID |
| Resposta incompleta na primeira tentativa | Limite máximo de saída reduzido artificialmente, ou ticket muito longo | Estado incomplete; o JSON não é analisado; entra em revisão manual com o motivo registrado |
| Notificação duplicada | O mesmo webhook-id entregue duas vezes |
A segunda é deduplicada; a tabela de resultados tem apenas um registro |
| Cliente desconectado | Conexão do navegador interrompida durante o streaming | Estado recuperado pelo response ID já salvo; o resultado gravado não é afetado pela página |
| Alteração de Schema | Um campo obrigatório é adicionado no meio da sessão | Ajuste feito por atualização incremental de configuração, sem reescrever a configuração antiga; os novos resultados são validados pelo novo Schema |
Cada caso de teste precisa salvar quatro informações: o ID do modelo invocado (gpt-6.2-sol), os parâmetros de execução, o response ID e a versão de configuração do lado da aplicação. Se aparecer problema, dá para localizar exatamente qual requisição foi, usando essas quatro informações.
4.2 Critérios de referência na regressão do GPT-6.2 Sol
| Item | O que registrar | Descrição |
|---|---|---|
| Modelo | gpt-6.2-sol |
Referência ao ID público do model card |
| Endpoint | Responses | Chamadas de função e ferramentas integradas passam por este caminho |
| Nível de raciocínio | O nível realmente utilizado | Nem Responses nem Chat Completions aceitam none |
| Uso | usage.output_tokens e a subconta de tokens de raciocínio dentro dele |
A cobrança da saída já inclui os tokens de raciocínio |
| Faixa de cobrança | Se a entrada de uma requisição única ultrapassa 272K | A interface pública de preços do APIYI usa 272.000 tokens de entrada como ponto de mudança de faixa; a cobrança real segue a fatura |
Ao migrar sistemas antigos, é preciso verificar separadamente estes itens: endpoint, parâmetros da requisição, entrada multi-turno, contexto de raciocínio e cache. Depois da verificação, rode a mesma bateria de casos de teste tanto nas requisições de exemplo quanto nas de produção.
🚀 Sugestão de aceitação: as cinco categorias de casos de teste podem ser colocadas no CI e rodadas automaticamente sempre que o Schema for alterado ou o canal for trocado. Com a chave unificada do APIYI apiyi.com, dá para comparar as diferenças de comportamento entre grupos diferentes usando o mesmo conjunto de casos.
Se os cinco casos da tabela de aceitação passarem todos e cada um puder ser rastreado pelo response ID, isso indica que esse fluxo de controle de qualidade já tem condições de ir para produção.
Referências
- Cartão do modelo GPT-6.2 Sol: ID do modelo, contexto e regras de cobrança
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Link:
- Guia de migração do GPT-6.2: escolha de endpoint, alteração de prefixo e atualização de configuração
- Link:
developers.openai.com/api/docs/guides/latest-model
- Link:
- Respostas em streaming e saída estruturada: eventos SSE e
text.format- Link:
developers.openai.com/api/docs/guides/streaming-responses
- Link:
- Estado da sessão:
previous_response_ide Conversations- Link:
developers.openai.com/api/docs/guides/conversation-state
- Link:
- Modo em segundo plano e Webhook: janela de conclusão, verificação de assinatura e deduplicação
- Link:
developers.openai.com/api/docs/guides/background
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Fique à vontade para falar com a gente pela página inicial do site da APIYI. Há mais materiais de integração disponíveis no centro de documentação docs.apiyi.com









