Nota do autor: comparar os preços escalonados de entrada do GPT-6.2 Sol e do 6.1 Sol na APIYI, usar um exemplo de documento longo com 300 mil tokens para mostrar a diferença de taxa de entrada quando o limite é ultrapassado e apresentar uma lista de verificação para conferência da cobrança.
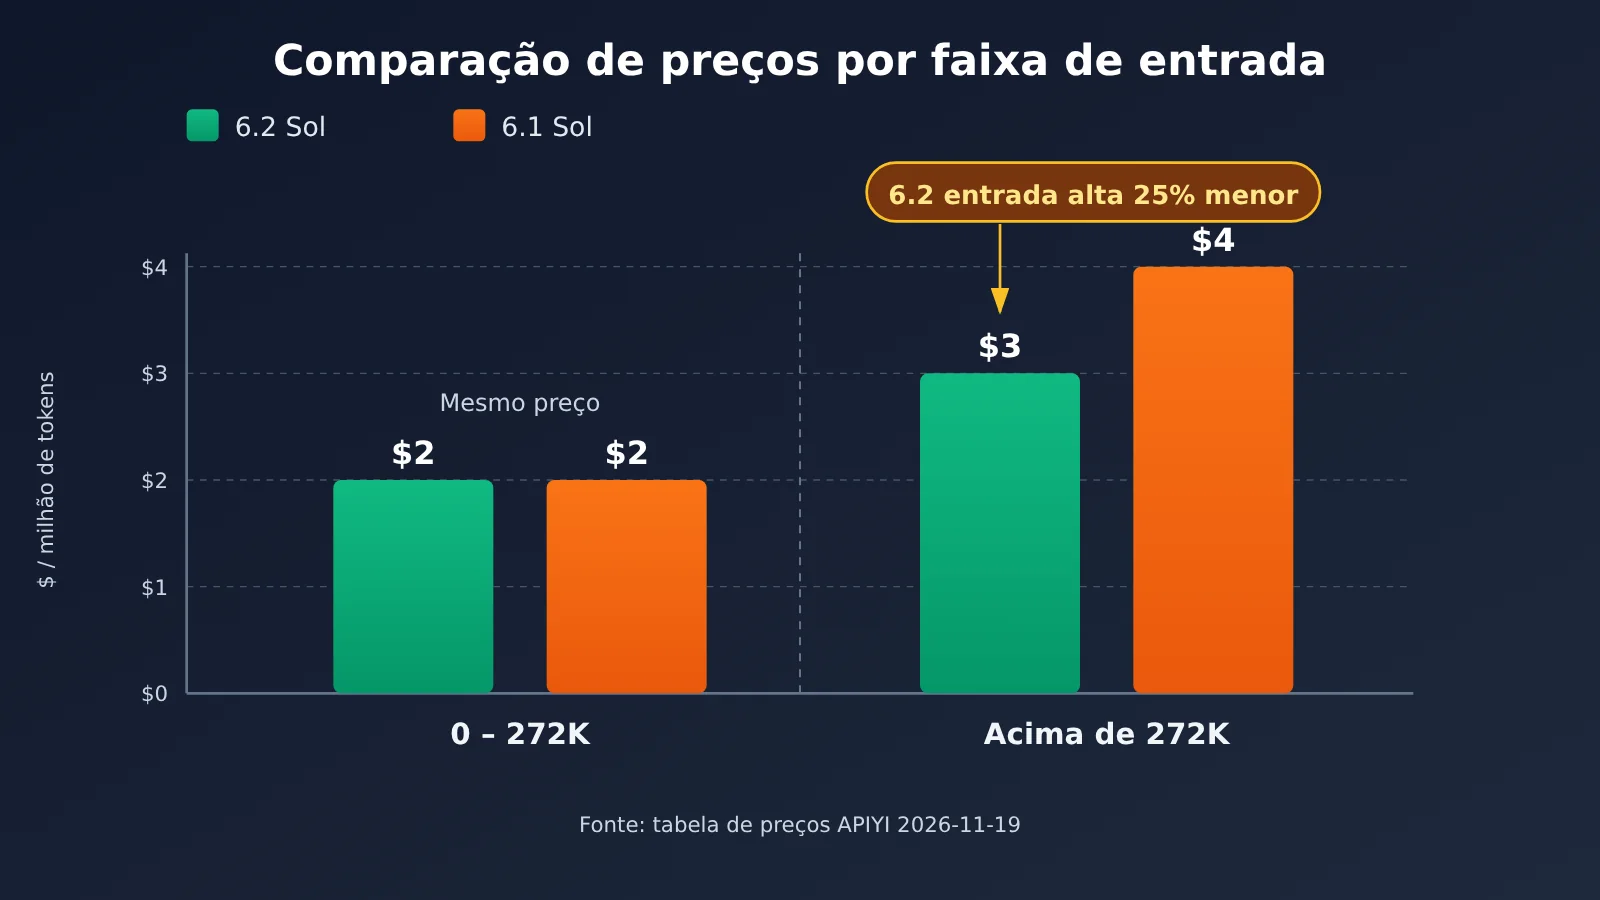
Vamos direto à conclusão: para uma entrada única de até 272.000 tokens, o preço de entrada do GPT-6.2 Sol e do 6.1 Sol na APIYI é de US$ 2 por milhão de tokens; escolher qualquer um dos dois não economiza nessa tarifa. A diferença aparece apenas na faixa superior, acima de 272.000 tokens. A tabela geral de preços da APIYI lista as tarifas de entrada da faixa superior como US$ 3 para o 6.2 Sol e US$ 4 para o 6.1 Sol (por milhão de tokens); o preço de tabela da faixa superior do 6.2 Sol é 25% menor.
Este não é um recibo de cobrança real. Todos os números deste artigo vêm da tabela geral de preços de modelos da APIYI (apiyi.com), consultada em 2026-11-19; o exemplo com 300 mil tokens é apenas uma estimativa de taxa de entrada calculada sob premissas específicas de cobrança, não representa o custo total da fatura e não inclui as partes de saída e cache.
Valor central: depois de ler este artigo, você consegue avaliar se sua tarefa com documentos longos vai entrar na faixa superior, calcular a diferença de taxa de entrada do GPT-6.2 Sol em comparação com o 6.1 Sol e saber quais itens de cobrança precisa conferir antes de entrar em produção.
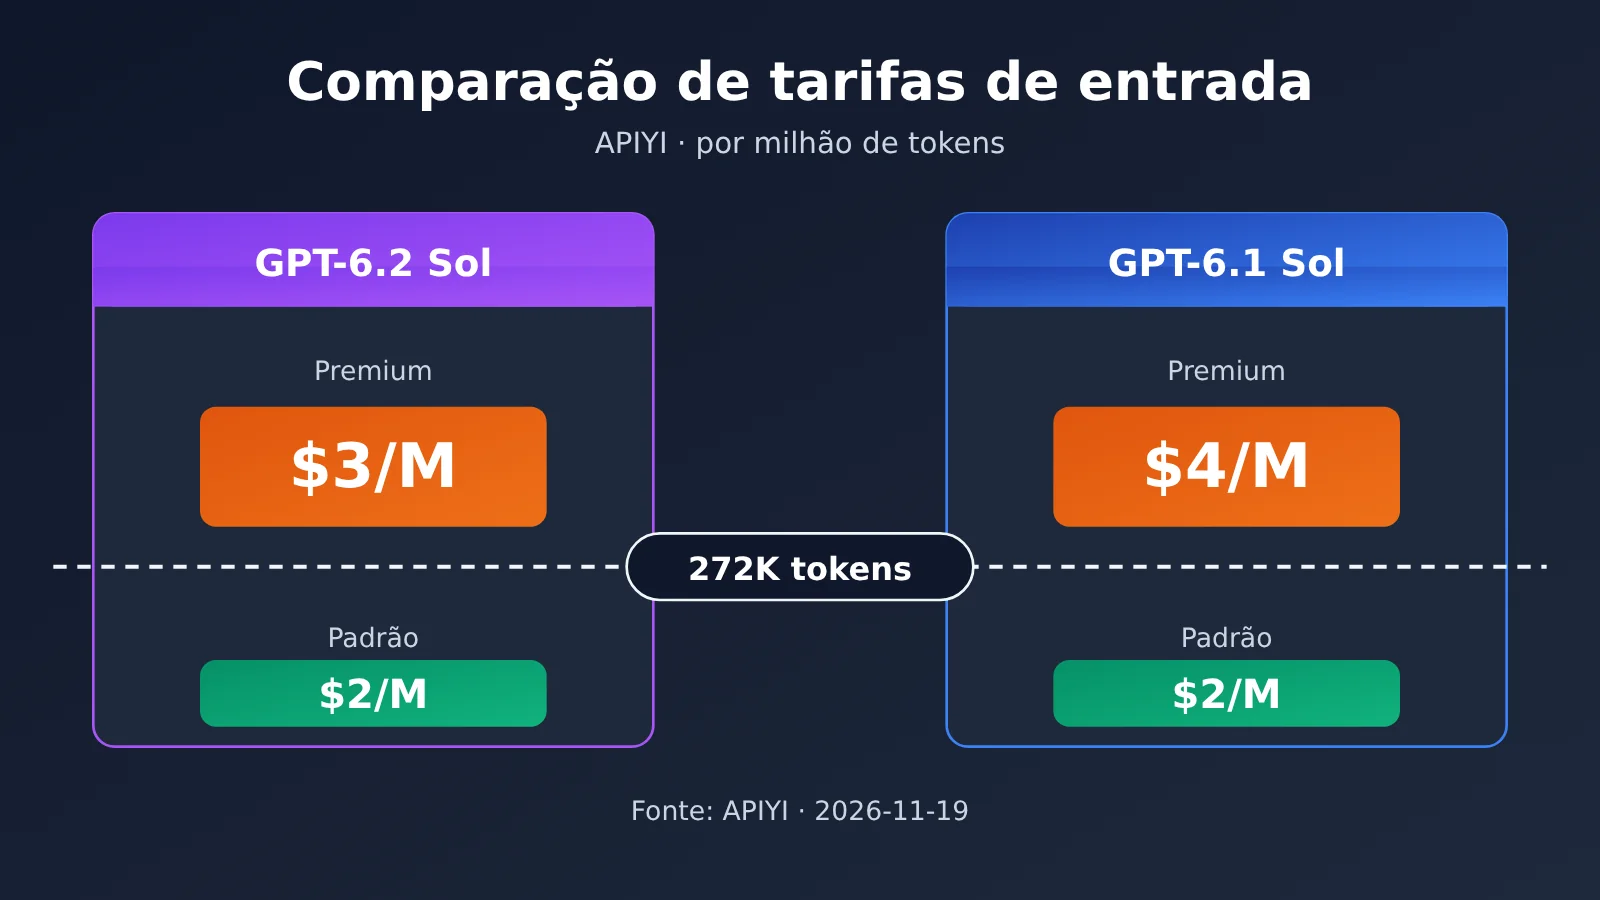
Principais diferenças entre GPT-6.2 Sol e 6.1 Sol: preço de entrada em faixas
Os dois modelos usam preço escalonado na APIYI, com ponto de corte em 272.000 Token. A tabela abaixo compara, lado a lado, os preços de entrada dentro e fora desse limite. Os dados vêm das observações de preço escalonado da tabela geral de preços de modelos da APIYI, com consulta feita em 2026-11-19.
| Faixa de entrada | Preço de entrada gpt-6.2-sol | Preço de entrada gpt-6.1-sol | Diferença | Fonte dos dados |
|---|---|---|---|---|
| 0 – 272.000 Token | $2 / milhão de Token | $2 / milhão de Token | Igual | Tabela geral de preços da APIYI (apiyi.com) |
| Acima de 272.000 Token | $3 / milhão de Token | $4 / milhão de Token | 6.2 é 25% menor | Tabela geral de preços da APIYI |
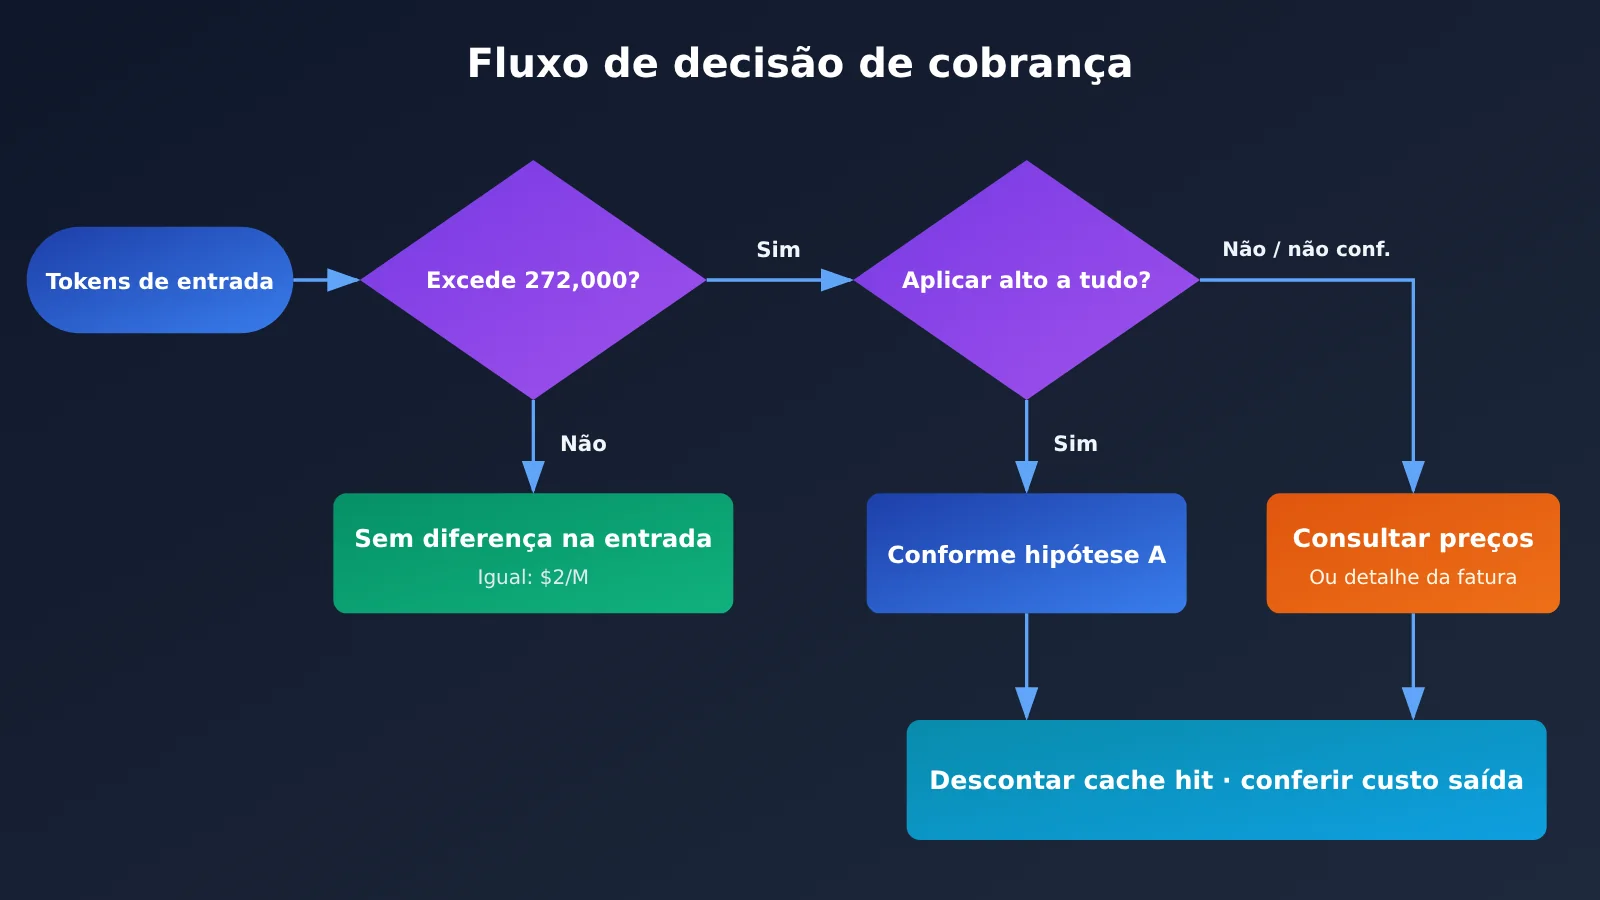
Vale um aviso: esta tabela cobre apenas a tarifa de entrada. A tabela geral pública da APIYI não confirma, com base nisso, que todos os grupos apliquem a faixa alta ao pedido inteiro, nem traz nessa mesma observação as tarifas de faixa alta para saída e cache. Ou seja, “a entrada de faixa alta do 6.2 Sol é 25% mais barata” não se converte automaticamente em “o pedido inteiro fica 25% mais barato” — para isso é preciso conferir a fatura real do seu grupo.
Além disso, o model card oficial da OpenAI também tem suas próprias regras de faixas para o gpt-6.2-sol. As regras oficiais do fabricante e os preços da plataforma APIYI são dois critérios distintos, e este artigo não mistura os cálculos: todos os números são preços da plataforma APIYI. Se quiser entender as regras do fabricante, consulte o model card oficial separadamente.
GPT-6.2 Sol vs. 6.1 Sol: exemplo de cálculo do custo de entrada com 300 mil tokens
Suponha que a entrada de uma requisição seja de 300,000 tokens e que não haja nenhum acerto de cache. Isso já ultrapassa o limite de 272,000, e o ponto central é como a plataforma aplica a tarifa mais alta a essa requisição. A cobrança escalonada costuma ter dois critérios de aplicação, e a tabela abaixo mostra os resultados para cada caso.
| Premissa de cobrança | Custo de entrada do gpt-6.2-sol | Custo de entrada do gpt-6.1-sol | Diferença | Status |
|---|---|---|---|---|
| A: tarifa alta aplicada sobre toda a entrada | 0.3 × $3 = $0.90 | 0.3 × $4 = $1.20 | $0.30 | Algoritmo ilustrativo do material de referência; é preciso confirmar o roteamento |
| B: tarifa alta aplicada apenas ao excedente | 0.272 × $2 + 0.028 × $3 = $0.628 | 0.272 × $2 + 0.028 × $4 = $0.656 | $0.028 | Dedução puramente matemática, não confirmada pela plataforma |
Se o roteamento da APIYI que você usa confirmar que a tarifa mais alta é aplicada sobre toda a entrada, então a diferença para uma única entrada de 300 mil tokens sem cache é de $0.30. A hipótese B serve apenas para mostrar que “critérios diferentes podem gerar diferenças de uma ordem de grandeza”, e não é uma regra já publicada pela plataforma. Antes de montar o orçamento, confirmar a qual critério o seu grupo pertence é mais importante do que qualquer exemplo de cálculo.
Três distinções no orçamento de documentos longos: tokens, contagem de caracteres e fatura
Muitos desvios de orçamento não vêm das tarifas, mas da confusão entre conceitos. Os três pares de conceitos abaixo precisam ser tratados separadamente ao orçar documentos longos com GPT-6.2 Sol ou 6.1 Sol.
| Conceito que costuma gerar confusão | Entendimento correto | Impacto no orçamento |
|---|---|---|
| Contagem de caracteres vs. token | A cobrança é feita em tokens; não há proporção fixa de conversão entre contagem de caracteres e tokens, pois isso varia conforme o idioma e o conteúdo | Não dá para aplicar diretamente o exemplo de 300 mil tokens a “300 mil caracteres” |
| Tokens do documento vs. tokens de entrada da requisição | A entrada da requisição também inclui comando de sistema, histórico da conversa, definições de ferramentas etc. | O documento em si pode não atingir o limite, mas, somado ao contexto, pode ultrapassar 272,000 |
| Custo de entrada teórico vs. fatura real | O valor teórico é o preço de tabela multiplicado pelo número de tokens; a fatura real também depende de acertos de cache, do critério do grupo e do custo de saída | O exemplo de cálculo serve apenas como referência de teto; vale o detalhamento da fatura |
A forma mais confiável é ler diretamente o campo usage retornado pela API e usar o prompt_tokens real para saber se o limite foi ultrapassado, em vez de estimar pela contagem de caracteres.
Como estimar o custo de entrada de documentos longos no GPT-6.2 Sol e no 6.1 Sol
Exemplo mínimo: ler a quantidade real de tokens de entrada
Primeiro faça uma requisição para descobrir quantos tokens de entrada esse documento longo realmente consome na chamada:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # interface unificada APIYI
)

doc = open("long_doc.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "请总结以下文档:\n" + doc}]
)
print("prompt_tokens:", resp.usage.prompt_tokens)
Ver o código completo: estimar o custo de entrada sob duas hipóteses de cobrança
import openai

# Snapshot de preços: tabela geral de preços APIYI, consulta em 2026-11-19, unidade USD/milhão de tokens
# Inclui apenas a tarifa de entrada; para tarifas de saída e de cache, consulte a tabela de preços e a fatura da plataforma
PRICES = {
    "gpt-6.2-sol": {"low": 2.0, "high": 3.0},
    "gpt-6.1-sol": {"low": 2.0, "high": 4.0},
}
THRESHOLD = 272_000

def estimate_input_cost(model: str, input_tokens: int, cached_tokens: int = 0,
                        mode: str = "full") -> float:
    """
    Estima o custo teórico de entrada da parte não cacheada dos tokens de entrada
    mode="full":     acima do limite, aplica a tarifa alta sobre o valor total (é preciso confirmar se o seu grupo é assim)
    mode="marginal": aplica a tarifa alta apenas ao excedente (premissa nossa, não confirmada pela plataforma)
    cached_tokens é apenas deduzido do cálculo; o custo da parte em cache precisa ser verificado separadamente
    """
    p = PRICES[model]
    uncached = max(input_tokens - cached_tokens, 0)
    if input_tokens <= THRESHOLD:
        return uncached / 1e6 * p["low"]
    if mode == "full":
        return uncached / 1e6 * p["high"]
    low_part = min(uncached, THRESHOLD)
    high_part = max(uncached - THRESHOLD, 0)
    return low_part / 1e6 * p["low"] + high_part / 1e6 * p["high"]

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

doc = open("long_doc.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "请总结以下文档:\n" + doc}]
)

usage = resp.usage
cached = 0
details = getattr(usage, "prompt_tokens_details", None)
if details is not None and getattr(details, "cached_tokens", None):
    cached = details.cached_tokens

for m in PRICES:
    for mode in ("full", "marginal"):
        cost = estimate_input_cost(m, usage.prompt_tokens, cached, mode)
        print(f"{m} [{mode}] 未缓存输入费估算: ${cost:.4f}")
Substituindo input_tokens=300_000 e cached_tokens=0, o modo full dá $0.90 e $1.20, batendo com o exemplo A lá em cima. Os preços no script são um snapshot da data da consulta, então quando a plataforma reajustar os valores você precisa atualizar junto.
🚀 Início rápido: vale a pena primeiro rodar um documento longo de verdade no APIYI apiyi.com usando a cota gratuita de teste para novos usuários, pegar o
prompt_tokense os detalhes da fatura e só depois definir o orçamento. Isso é bem mais confiável do que estimar apenas pela contagem de caracteres.
GPT-6.2 Sol vs 6.1 Sol: recomendações por cenário
A tabela abaixo traz recomendações apenas do ponto de vista da tarifa de entrada, sem considerar diferenças de qualidade ou velocidade do modelo — esses dois fatores dependem de você testar com a sua tarefa real.
| Seu cenário de documentos longos | Conclusão sob a ótica da tarifa de entrada | Ação sugerida |
|---|---|---|
| Entrada única estável dentro de 272.000 tokens | Ambos custam US$ 2 por milhão de tokens; não há diferença nessa tarifa | Escolha pelo desempenho e pelas demais rubricas de custo, não conte com a tarifa de entrada para economizar |
| Entrada única frequentemente acima de 272.000 tokens | A faixa alta de entrada do 6.2 Sol está 25% mais barata | Após confirmar a regra de cobrança do seu grupo, avalie o 6.2 Sol como prioridade |
| Entrada oscilando perto do limite | A diferença depende da proporção de requisições que ultrapassam o limite | Levante a distribuição de prompt_tokens ao longo de um período antes de decidir |
| O mesmo documento é consultado repetidamente | O acerto de cache altera a fatura real | Confira separadamente a tarifa da parte cacheada; não extrapole com base no valor sem cache |
Situações típicas para escolher o GPT-6.2 Sol
- Contratos, demonstrativos financeiros, repositórios de código e outros materiais muito longos precisam caber de uma vez na janela de contexto, e a entrada costuma ultrapassar 272.000 tokens.
- O orçamento é consumido principalmente pela tarifa de entrada da faixa alta, e a regra de cobrança do seu grupo já foi confirmada.
Situações típicas para continuar com o GPT-6.1 Sol
- A entrada das tarefas fica dentro do limite de forma consistente; nessa tarifa ele é igual ao 6.2 Sol, então a troca não traz economia na tarifa de entrada.
- O fluxo atual já roda de forma estável no 6.1 Sol e é preciso avaliar as diferenças de desempenho antes de migrar.
GPT-6.2 Sol vs. 6.1 Sol: recomendações de decisão e checklist de conferência de cobrança
A lógica de decisão pode ser resumida em uma frase: sem ultrapassar o limite, não dá para economizar com essa tarifa; ultrapassando, é preciso conferir ao mesmo tempo grupo, cache e saída. Antes de colocar tarefas com documentos longos em produção, vale a pena revisar item por item a lista abaixo.
| Item de conferência | Pergunta a confirmar | Como verificar |
|---|---|---|
| Tokens de entrada por chamada | Realmente passa de 272,000? Inclui o comando de sistema e o histórico? | Leia usage.prompt_tokens na resposta |
| Critério de cobrança por grupo | Depois de ultrapassar o limite, a faixa mais alta se aplica ao valor total ou existe outra regra? | Consulte a tabela geral de preços da APIYI e as instruções de preço escalonado; se necessário, fale com a plataforma |
| Acerto de cache | Quantas entradas atingem o cache e como a parte em cache é cobrada? | Verifique o campo cached_tokens e os detalhes da fatura |
| Preço de saída | A saída também tem faixas? Qual é a tarifa? | Use a tabela de preços da plataforma como referência; este artigo não cita preços de saída não verificados |
| Validade do preço | A data de referência deste artigo é 2026-11-19; já houve reajuste? | Consulte novamente a tabela geral de preços antes da chamada |
| Consistência de critério | Você está misturando as faixas oficiais do fornecedor com o preço de tabela da plataforma no mesmo cálculo? | Anote as regras do fornecedor separadamente; no orçamento, use apenas um critério |
💡 Recomendação de escolha: se suas tarefas com documentos longos realmente ultrapassam o limite com frequência, vale a pena chamar gpt-6.2-sol e gpt-6.1-sol no APIYI apiyi.com usando o mesmo documento e comparar os detalhes de cobrança das duas chamadas antes de decidir se migra. A mesma chave API permite alternar entre os modelos, o que facilita esse tipo de comparação.
Perguntas frequentes (FAQ)
Q1: Comparando o GPT-6.2 Sol com o 6.1 Sol, onde exatamente está a diferença no preço de entrada?
A diferença aparece só na faixa mais alta. Segundo a tabela geral de preços da APIYI, para entradas de 0–272,000 tokens os dois custam $2 por milhão de tokens; acima de 272,000, o 6.2 Sol fica em $3 e o 6.1 Sol em $4 — ou seja, o 6.2 Sol sai 25% mais barato.
Q2: Um documento de 300 mil caracteres equivale a 300 mil tokens?
Não. Não existe uma proporção fixa de conversão entre número de caracteres e tokens, e além disso uma única entrada ainda inclui o comando de sistema e o histórico da conversa. Use o `prompt_tokens` retornado pela API como referência para saber se você passou do limite.
Q3: Com uma entrada de 300 mil tokens, o 6.2 Sol garante uma economia de $0.30?
Não necessariamente. Os $0.30 são apenas uma estimativa da taxa de entrada, calculada assumindo “toda a entrada na faixa superior e nenhum acerto de cache”. Se a regra de agrupamento for diferente ou houver acerto de cache, a diferença muda — e isso não inclui a taxa de saída.
Q4: Dá para dizer que o 6.2 Sol é 25% mais barato que o 6.1 Sol no total da fatura?
Não. Os 25% são apenas a diferença no preço de tabela da entrada na faixa superior. A tabela pública da APIYI não confirma, com base nisso, a regra de cobrança total para todos os grupos, nem traz as tarifas da faixa superior para saída e cache: a diferença no total da fatura só aparece na conta real.
Q5: Como verificar rapidamente o custo do meu documento longo na APIYI?
1. Cadastre-se na APIYI (apiyi.com) e obtenha sua chave API — novos usuários têm cota gratuita para testes
2. Use o código deste artigo, defina `base_url` como `https://api.apiyi.com/v1` e envie um documento longo real
3. Anote `prompt_tokens` e `cached_tokens` e compare com os detalhes da fatura da plataforma
Q6: Quais são as limitações dos dados deste artigo?
Os números deste artigo vêm apenas da tabela geral de preços da plataforma consultada em 2026-11-19. Não são faturas reais e não cobrem preço de saída, qualidade ou velocidade do modelo. As regras de faixa do model card oficial do fabricante e o preço de tabela da plataforma seguem critérios diferentes, e este artigo não mistura os dois — quando os preços mudarem, use a tabela mais recente como referência.
GPT-6.2 Sol vs. 6.1 Sol: principais conclusões
- Mesmo preço dentro do limite: até 272,000 tokens, o preço de tabela de entrada dos dois modelos é o mesmo: $2 por milhão de tokens.
- Diferença na faixa superior: acima do limite, o 6.2 Sol custa $3 e o 6.1 Sol custa $4; o primeiro é 25% mais barato.
- O exemplo tem premissas: com todos os 300 mil tokens na faixa superior e sem cache, a diferença no custo de entrada é de $0.30.
- Token não é caractere: use
prompt_tokenspara saber se o limite foi ultrapassado. - Teoria não é fatura: cache, regras de agrupamento e custos de saída alteram o gasto real.
- Teste antes de definir o orçamento: rode um teste com documentos reais na APIYI (apiyi.com), compare com a fatura e só então decida.
Resumo
GPT-6.2 Sol vs. 6.1 Sol nos custos de entrada para documentos longos:
- Sem diferença dentro do limite: quando a entrada não passa de 272,000 tokens, trocar de modelo não reduz esse custo.
- Acima do limite, vale a tarifa da faixa superior: o preço de tabela de entrada do 6.2 Sol na faixa superior é 25% menor que o do 6.1 Sol; com 300 mil tokens todos na faixa superior e sem cache, a diferença é de $0.30.
- O orçamento deve seguir a fatura: confira também as regras de agrupamento, os acertos de cache e os custos de saída; o exemplo é apenas uma estimativa do custo de entrada.
Se o seu negócio realmente costuma processar documentos muito longos, vale a pena usar a APIYI (apiyi.com) com requisições reais para comparar os detalhes de cobrança dos dois modelos e, a partir disso, definir a escolha do modelo e o orçamento mensal.
📚 Materiais de Referência
-
Tabela geral de preços dos modelos APIYI: explicação da precificação escalonada
- Link:
docs.apiyi.com/models - Descrição: é a fonte de todos os preços de entrada citados neste artigo; a consulta foi feita em 2026-11-19, então reconfirme antes de fazer a chamada
- Link:
-
Model card oficial da OpenAI – gpt-6.2-sol: descrição oficial dos níveis do fabricante
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol - Descrição: as regras do fabricante e os preços da plataforma seguem critérios diferentes, servem apenas como referência separada e não devem ser combinados com os números deste artigo
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site oficial da APIYI. Há mais materiais sobre cobrança e integração no centro de documentação docs.apiyi.com