作者注:對比 GPT-6.2 Sol 與 6.1 Sol 在 API易的階梯輸入標價,用 30 萬 Token 長文檔算例說明超閾值時的輸入費差異,並給出核賬清單。
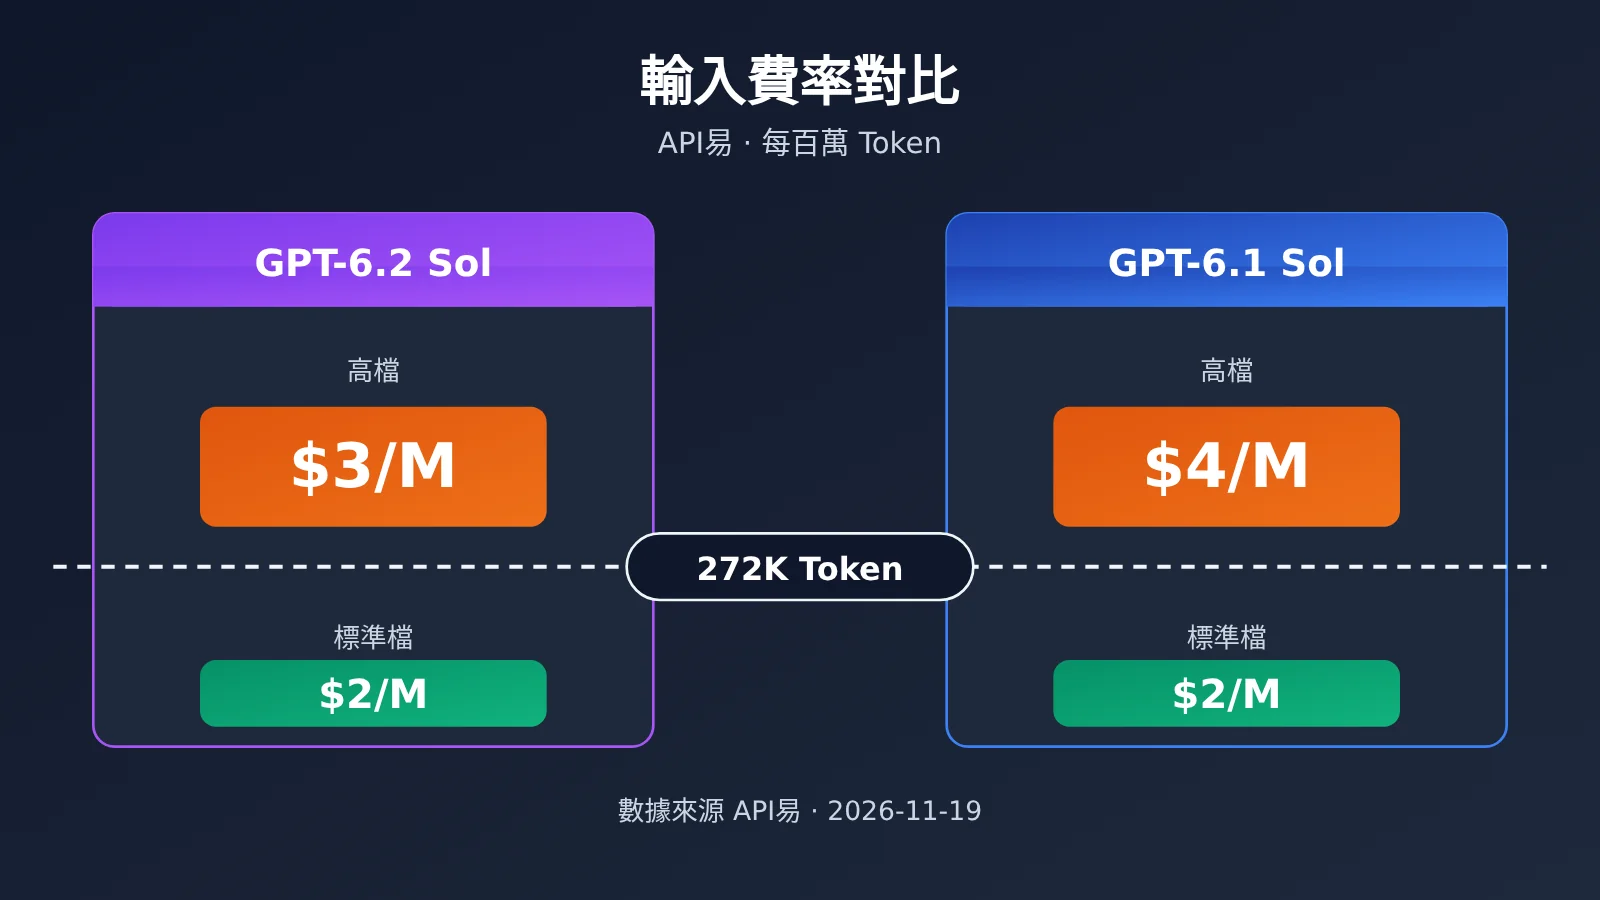
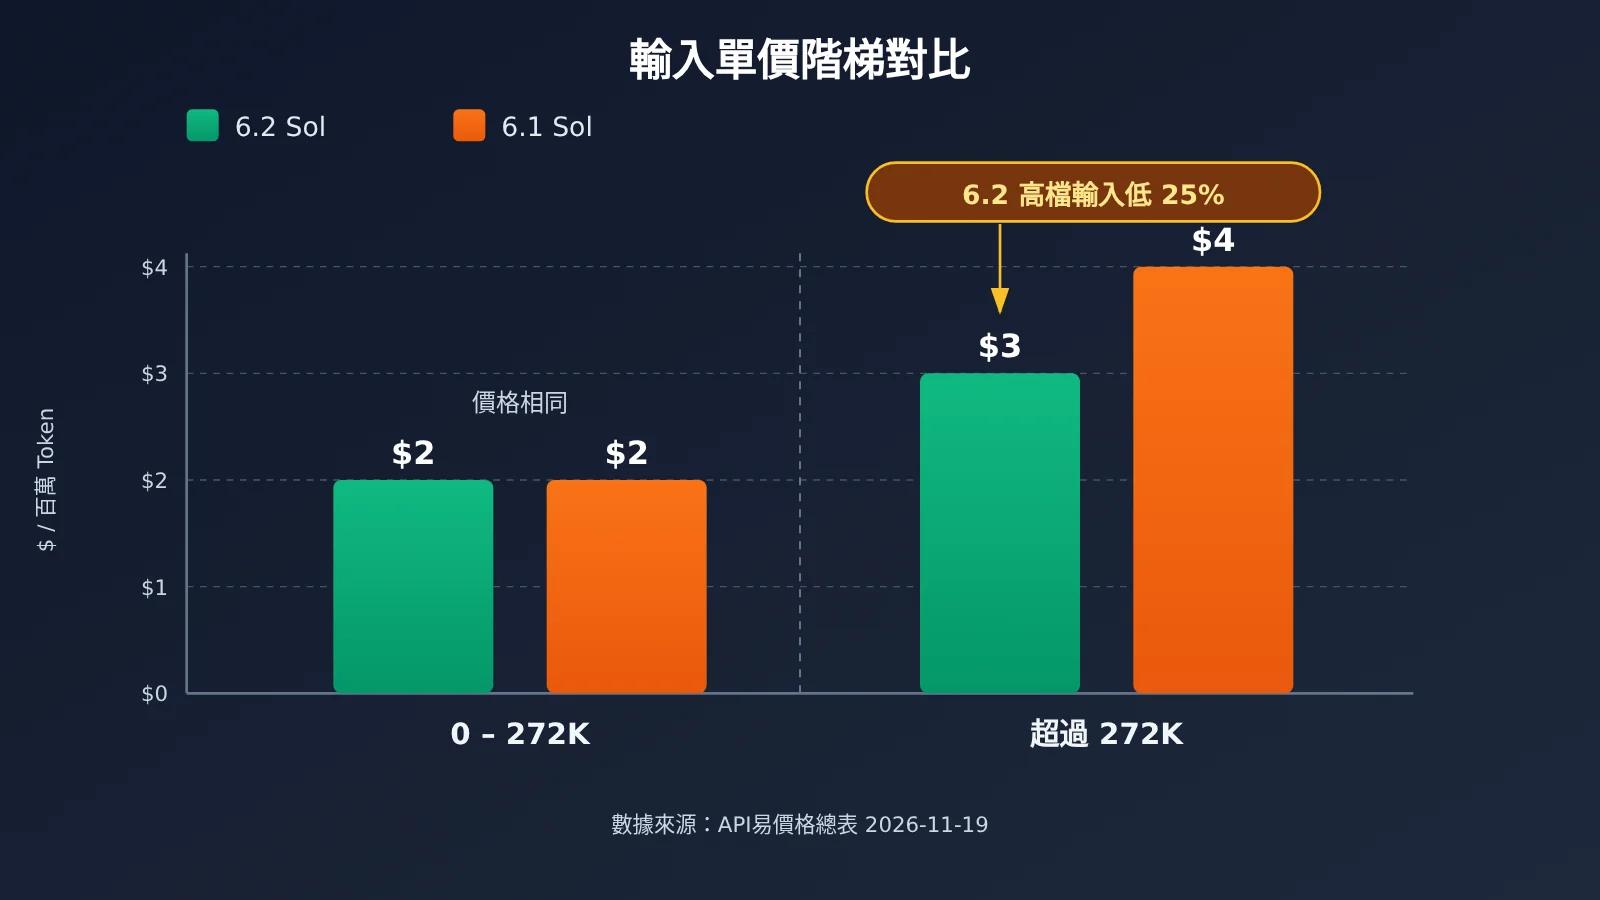
先給結論:單次輸入在 272,000 Token 以內時,GPT-6.2 Sol 和 6.1 Sol 在 API易的輸入標價都是 $2/百萬 Token,選哪個在這項費率上都不省錢。差異只出現在超過 272,000 Token 的高檔區間。API易價格總表列出的高檔輸入費率是 6.2 Sol $3、6.1 Sol $4(每百萬 Token),6.2 Sol 的高檔標價低 25%。
這不是一份實測賬單。本文所有數字都來自 2026-11-19 查詢的 API易 apiyi.com 模型價格總表,30 萬 Token 的算例只是在特定計費假設下算出的輸入費示意,不代表整單費用,也不包含輸出和緩存部分。
核心價值:讀完本文,你可以判斷自己的長文檔任務會不會進入高檔區間,算出 GPT-6.2 Sol 對比 6.1 Sol 的輸入費差額,並知道上線前需要覈對哪些賬單項。
GPT-6.2 Sol 對比 6.1 Sol 核心差異:階梯輸入標價
兩個模型在 API易都採用階梯計價,分界點是 272,000 Token。下表並列閾值內外的輸入標價,數據取自 API易模型價格總表的階梯計價說明,查詢日期爲 2026-11-19。
| 輸入區間 | gpt-6.2-sol 輸入標價 | gpt-6.1-sol 輸入標價 | 差異 | 數據來源 |
|---|---|---|---|---|
| 0 – 272,000 Token | $2 / 百萬 Token | $2 / 百萬 Token | 相同 | API易 apiyi.com 價格總表 |
| 超過 272,000 Token | $3 / 百萬 Token | $4 / 百萬 Token | 6.2 低 25% | API易價格總表 |
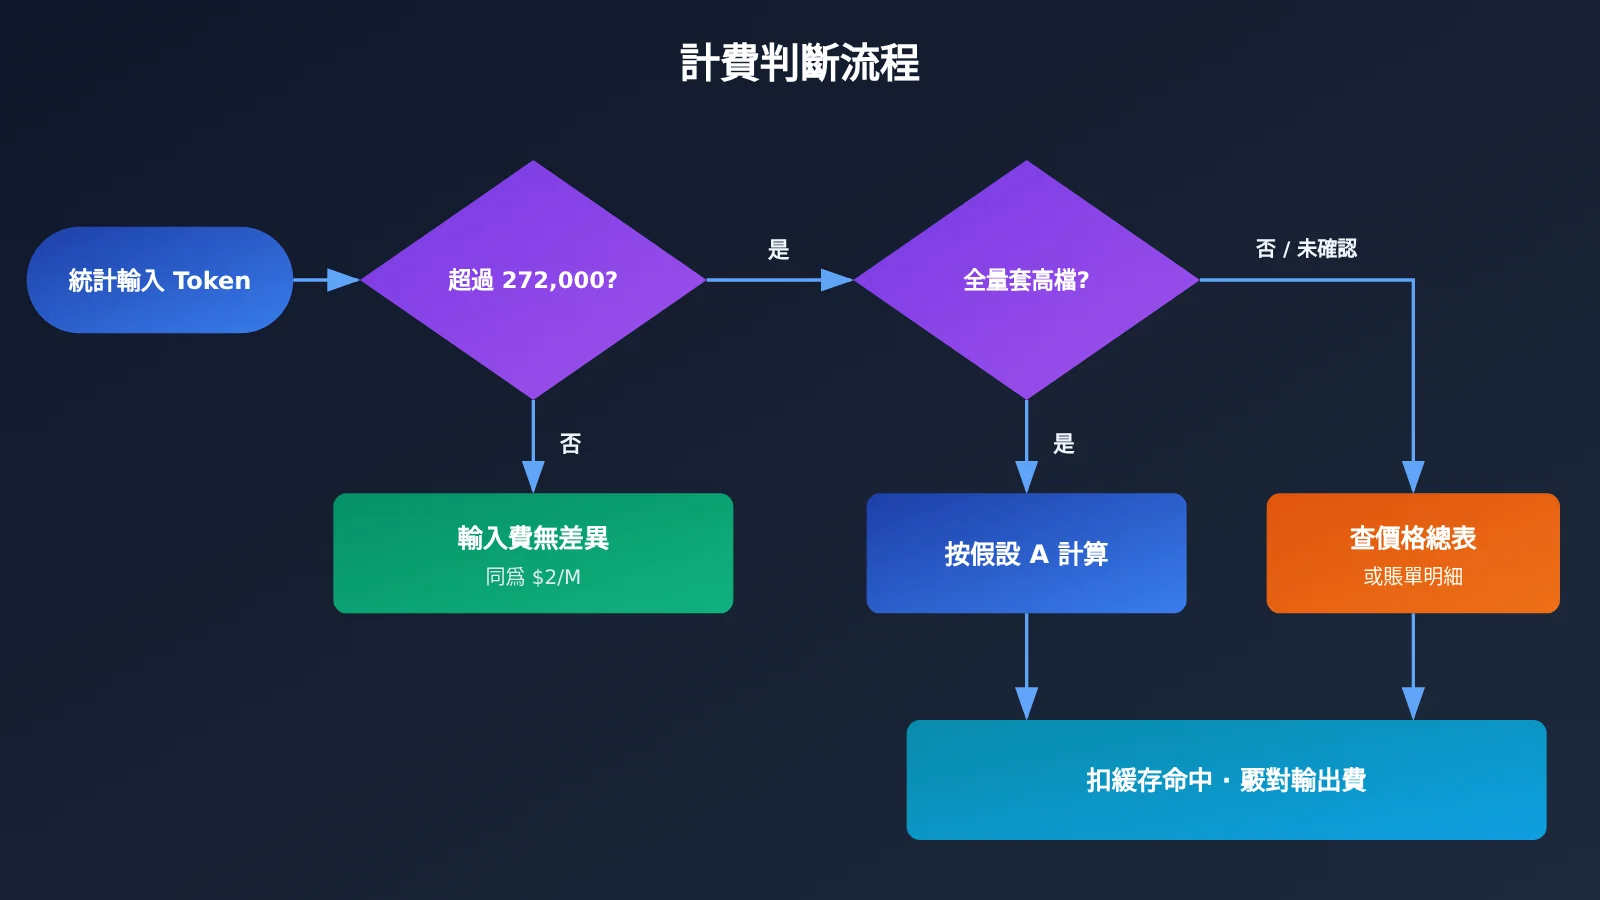
需要注意,這張表只覆蓋輸入費率。API易公開總表並未據此確認所有分組都按整單套用高檔,也未在這項說明中給出輸出與緩存的高檔費率。所以“6.2 Sol 高檔輸入便宜 25%”不能直接推導成“整單便宜 25%”,後者需要結合你所在分組的實際賬單來覈對。
另外,OpenAI 官方模型卡對 gpt-6.2-sol 也有自己的檔位說明。廠商官方規則與 API易平臺標價屬於兩套口徑,本文不做混算,所有數字均爲 API易平臺標價;如需瞭解廠商規則,請單獨查閱官方模型卡。
GPT-6.2 Sol 對比 6.1 Sol:30 萬 Token 輸入費算例
假設一次請求的輸入爲 300,000 Token,且全部未命中緩存。這已經超過 272,000 的閾值,關鍵在於平臺如何對這次請求套用高檔費率。階梯計價常見兩種口徑,下表分別給出計算結果。
| 計費假設 | gpt-6.2-sol 輸入費 | gpt-6.1-sol 輸入費 | 差額 | 狀態 |
|---|---|---|---|---|
| A:全量輸入套用高檔 | 0.3 × $3 = $0.90 | 0.3 × $4 = $1.20 | $0.30 | 參考資料給出的示意算法,需確認路由 |
| B:僅超出部分套用高檔 | 0.272 × $2 + 0.028 × $3 = $0.628 | 0.272 × $2 + 0.028 × $4 = $0.656 | $0.028 | 純數學推演,平臺未確認 |
如果你所用的 API易路由確認按全量輸入套用高檔,那麼單次 30 萬 Token 未緩存輸入的差額是 $0.30。假設 B 只是爲了說明“口徑不同,差額可能相差一個數量級”,並不是平臺已公佈的規則。做預算之前,先確認你的分組屬於哪種口徑,比任何算例都重要。
長文檔預算的三個區分:Token、字數與賬單
很多預算偏差並不是來自費率,而是來自概念混淆。下面三組概念在做 GPT-6.2 Sol 或 6.1 Sol 長文檔預算時必須分開看。
| 容易混淆的概念 | 正確理解 | 對預算的影響 |
|---|---|---|
| 字數 vs Token | 計費按 Token,字數與 Token 沒有固定換算比例,隨語言和內容變化 | 不能用“30 萬字”直接套 30 萬 Token 的算例 |
| 文檔 Token vs 單次輸入 Token | 單次輸入還包括系統提示詞、對話歷史、工具定義等 | 文檔本身不到閾值,加上上下文後可能越過 272,000 |
| 理論輸入費 vs 實際賬單 | 理論值按標價乘以 Token 數;實際賬單還受緩存命中、分組口徑、輸出費影響 | 算例只能作爲上限參考,以賬單明細爲準 |
最可靠的做法是直接讀取接口返回的 usage 字段,用真實的 prompt_tokens 判斷是否越過閾值,而不是靠字數估算。
如何預估 GPT-6.2 Sol 與 6.1 Sol 的長文檔輸入費
極簡示例:讀取真實輸入 Token 數
先發一次請求,拿到這份長文檔在實際調用中的輸入 Token 數:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口
)

doc = open("long_doc.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "請總結以下文檔:\n" + doc}]
)
print("prompt_tokens:", resp.usage.prompt_tokens)
查看完整實現代碼:按兩種計費假設估算輸入費
import openai

# 價格快照:API易價格總表,2026-11-19 查詢,單位 美元/百萬 Token
# 僅包含輸入費率;輸出與緩存費率請以平臺價格表和賬單爲準
PRICES = {
    "gpt-6.2-sol": {"low": 2.0, "high": 3.0},
    "gpt-6.1-sol": {"low": 2.0, "high": 4.0},
}
THRESHOLD = 272_000

def estimate_input_cost(model: str, input_tokens: int, cached_tokens: int = 0,
                        mode: str = "full") -> float:
    """
    估算未緩存輸入部分的理論輸入費
    mode="full":     超閾值時全量套用高檔(需確認所在分組是否如此)
    mode="marginal": 僅超出部分套用高檔(假設口徑,平臺未確認)
    cached_tokens 僅從計算中扣除,緩存部分的費用需單獨覈對
    """
    p = PRICES[model]
    uncached = max(input_tokens - cached_tokens, 0)
    if input_tokens <= THRESHOLD:
        return uncached / 1e6 * p["low"]
    if mode == "full":
        return uncached / 1e6 * p["high"]
    low_part = min(uncached, THRESHOLD)
    high_part = max(uncached - THRESHOLD, 0)
    return low_part / 1e6 * p["low"] + high_part / 1e6 * p["high"]

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

doc = open("long_doc.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "請總結以下文檔:\n" + doc}]
)

usage = resp.usage
cached = 0
details = getattr(usage, "prompt_tokens_details", None)
if details is not None and getattr(details, "cached_tokens", None):
    cached = details.cached_tokens

for m in PRICES:
    for mode in ("full", "marginal"):
        cost = estimate_input_cost(m, usage.prompt_tokens, cached, mode)
        print(f"{m} [{mode}] 未緩存輸入費估算: ${cost:.4f}")
把 input_tokens=300_000、cached_tokens=0 代入,full 模式會得到 $0.90 與 $1.20,與上文算例 A 一致。腳本中的價格是查詢日快照,平臺調價後需要同步更新。
🚀 快速開始:建議先在 API易 apiyi.com 用新用戶免費測試額度跑一份真實長文檔,拿到
prompt_tokens和賬單明細後再定預算,比單純按字數估算可靠得多。
GPT-6.2 Sol 對比 6.1 Sol 場景推薦
下表只從輸入費率角度給出建議,不涉及模型質量與速度差異;這兩項需要你結合自己的任務實際測試。
| 你的長文檔場景 | 輸入費率角度的結論 | 建議動作 |
|---|---|---|
| 單次輸入穩定在 272,000 Token 以內 | 兩者同爲 $2/百萬 Token,這項費率無差異 | 按效果和其他費用項選型,不要指望靠輸入費省錢 |
| 單次輸入經常超過 272,000 Token | 6.2 Sol 高檔輸入標價低 25% | 確認分組計費口徑後,優先評估 6.2 Sol |
| 輸入在閾值附近波動 | 差異取決於超閾值請求的佔比 | 統計一段時間的 prompt_tokens 分佈再決定 |
| 同一文檔會被反覆提問 | 緩存命中會改變實際賬單 | 單獨覈對緩存部分費率,不要按未緩存算例外推 |
選擇 GPT-6.2 Sol 的典型情況
- 合同、財報、代碼倉庫等超長材料需要一次性塞進上下文,輸入經常越過 272,000 Token。
- 預算主要被高檔輸入費喫掉,且已確認所在分組的計費口徑。
繼續使用 GPT-6.1 Sol 的典型情況
- 任務輸入長期在閾值以內,這項費率與 6.2 Sol 相同,切換不會帶來輸入費節省。
- 現有流程已經在 6.1 Sol 上穩定運行,遷移前需要先評估效果差異。
GPT-6.2 Sol 對比 6.1 Sol 決策建議與核賬清單
決策邏輯可以壓縮成一句話:不超閾值,不能靠這項費率省錢;超閾值,要同時覈對分組、緩存和輸出。上線長文檔任務之前,建議逐項過一遍下面的清單。
| 核賬項 | 要確認的問題 | 覈對方式 |
|---|---|---|
| 單次輸入 Token | 是否真的超過 272,000?是否包含系統提示詞和歷史 | 讀取返回中的 usage.prompt_tokens |
| 分組計費口徑 | 超閾值後是全量套用高檔,還是另有規則 | 查閱 API易價格總表階梯計價說明,必要時諮詢平臺 |
| 緩存命中 | 有多少輸入命中緩存,緩存部分如何計費 | 查看 cached_tokens 字段與賬單明細 |
| 輸出費 | 輸出是否也分檔,費率是多少 | 以平臺價格表爲準,本文不引用未覈實的輸出價 |
| 價格時效 | 本文快照日期爲 2026-11-19,是否已調價 | 調用前重新查詢價格總表 |
| 口徑一致性 | 是否把廠商官方檔位與平臺標價混在一起算 | 廠商規則單獨標註,預算只用一套口徑 |
💡 選擇建議:如果你的長文檔任務確實頻繁超過閾值,建議在 API易 apiyi.com 上用同一份文檔分別調用 gpt-6.2-sol 和 gpt-6.1-sol,對照兩次的賬單明細,再決定是否遷移。同一個 API Key 即可切換模型,便於做這類對照。
常見問題 FAQ
Q1:GPT-6.2 Sol 對比 6.1 Sol,輸入價格到底差在哪裏?
只差在高檔區間。按 API易價格總表,0–272,000 Token 輸入兩者都是 $2/百萬 Token;超過 272,000 後,6.2 Sol 爲 $3,6.1 Sol 爲 $4,6.2 Sol 低 25%。
Q2:30 萬字的文檔是不是就等於 30 萬 Token?
不是。字數與 Token 沒有固定換算比例,而且單次輸入還包含系統提示詞和對話歷史。請以接口返回的 `prompt_tokens` 爲準判斷是否超過閾值。
Q3:30 萬 Token 輸入用 6.2 Sol 一定能省 $0.30 嗎?
不一定。$0.30 是在“全量輸入套用高檔、全部未命中緩存”的前提下算出的輸入費示意。如果分組口徑不同或有緩存命中,差額會變化,而且這不包括輸出費。
Q4:可以說 6.2 Sol 整單比 6.1 Sol 便宜 25% 嗎?
不可以。25% 只是高檔輸入標價的差距。API易公開總表並未據此確認所有分組的整單計費規則,也未給出輸出與緩存的高檔費率,整單差異需要看實際賬單。
Q5:如何在 API易 上快速驗證自己的長文檔成本?
1. 在 API易 apiyi.com 註冊並獲取 API Key,新用戶有免費測試額度
2. 用本文代碼把 `base_url` 設爲 `https://api.apiyi.com/v1`,發送一份真實長文檔
3. 記錄 `prompt_tokens`、`cached_tokens`,再與平臺賬單明細對照
Q6:本文數據有哪些侷限?
本文數字只來自 2026-11-19 查詢的平臺價格總表,不是實測賬單,也不涉及輸出價格、模型質量或速度。廠商官方模型卡的檔位規則與平臺標價屬於不同口徑,本文未做混算,價格變動時請以最新價格表爲準。
GPT-6.2 Sol 對比 6.1 Sol 核心要點 Key Takeaways
- 閾值內同價:272,000 Token 以內,兩者輸入標價都是 $2/百萬 Token。
- 高檔有差距:超閾值後 6.2 Sol 爲 $3、6.1 Sol 爲 $4,前者低 25%。
- 算例有前提:全量套高檔且未緩存時,30 萬 Token 輸入費差 $0.30。
- Token 不等於字數:以
prompt_tokens判斷是否越過閾值。 - 理論不等於賬單:緩存、分組口徑和輸出費都會改變實際支出。
- 先測再定預算:在 API易 apiyi.com 用真實文檔跑一次,對照賬單再決策。
總結
GPT-6.2 Sol 對比 6.1 Sol 在長文檔輸入費上的核心要點:
- 閾值以內無差異:輸入不超過 272,000 Token 時,換模型不能省這項費用。
- 超閾值看高檔費率:6.2 Sol 高檔輸入標價比 6.1 Sol 低 25%,30 萬 Token 全量高檔未緩存時差 $0.30。
- 預算以賬單爲準:同時覈對分組口徑、緩存命中和輸出費,算例只是輸入費示意。
如果你的業務確實經常處理超長文檔,推薦通過 API易 apiyi.com 用真實請求對照兩個模型的賬單明細,再據此確定模型選型和月度預算。
📚 參考資料
-
API易模型價格總表:階梯計價說明
- 鏈接:
docs.apiyi.com/models - 說明: 本文所有輸入標價的來源,查詢日期 2026-11-19,調用前請重新確認
- 鏈接:
-
OpenAI 官方模型卡 – gpt-6.2-sol:廠商官方檔位說明
- 鏈接:
developers.openai.com/api/docs/models/gpt-6.2-sol - 說明: 廠商規則與平臺標價屬於不同口徑,僅供單獨參考,不與本文數字混算
- 鏈接:
作者: APIYI 技術團隊
技術交流: 歡迎在 API易官網首頁聯繫我們,更多計費與接入資料可訪問 docs.apiyi.com 文檔中心