作者注:对比 GPT-6.2 Sol 与 6.1 Sol 在 API易的阶梯输入标价,用 30 万 Token 长文档算例说明超阈值时的输入费差异,并给出核账清单。
先给结论:单次输入在 272,000 Token 以内时,GPT-6.2 Sol 和 6.1 Sol 在 API易的输入标价都是 $2/百万 Token,选哪个在这项费率上都不省钱。差异只出现在超过 272,000 Token 的高档区间。API易价格总表列出的高档输入费率是 6.2 Sol $3、6.1 Sol $4(每百万 Token),6.2 Sol 的高档标价低 25%。
这不是一份实测账单。本文所有数字都来自 2026-11-19 查询的 API易 apiyi.com 模型价格总表,30 万 Token 的算例只是在特定计费假设下算出的输入费示意,不代表整单费用,也不包含输出和缓存部分。
核心价值:读完本文,你可以判断自己的长文档任务会不会进入高档区间,算出 GPT-6.2 Sol 对比 6.1 Sol 的输入费差额,并知道上线前需要核对哪些账单项。
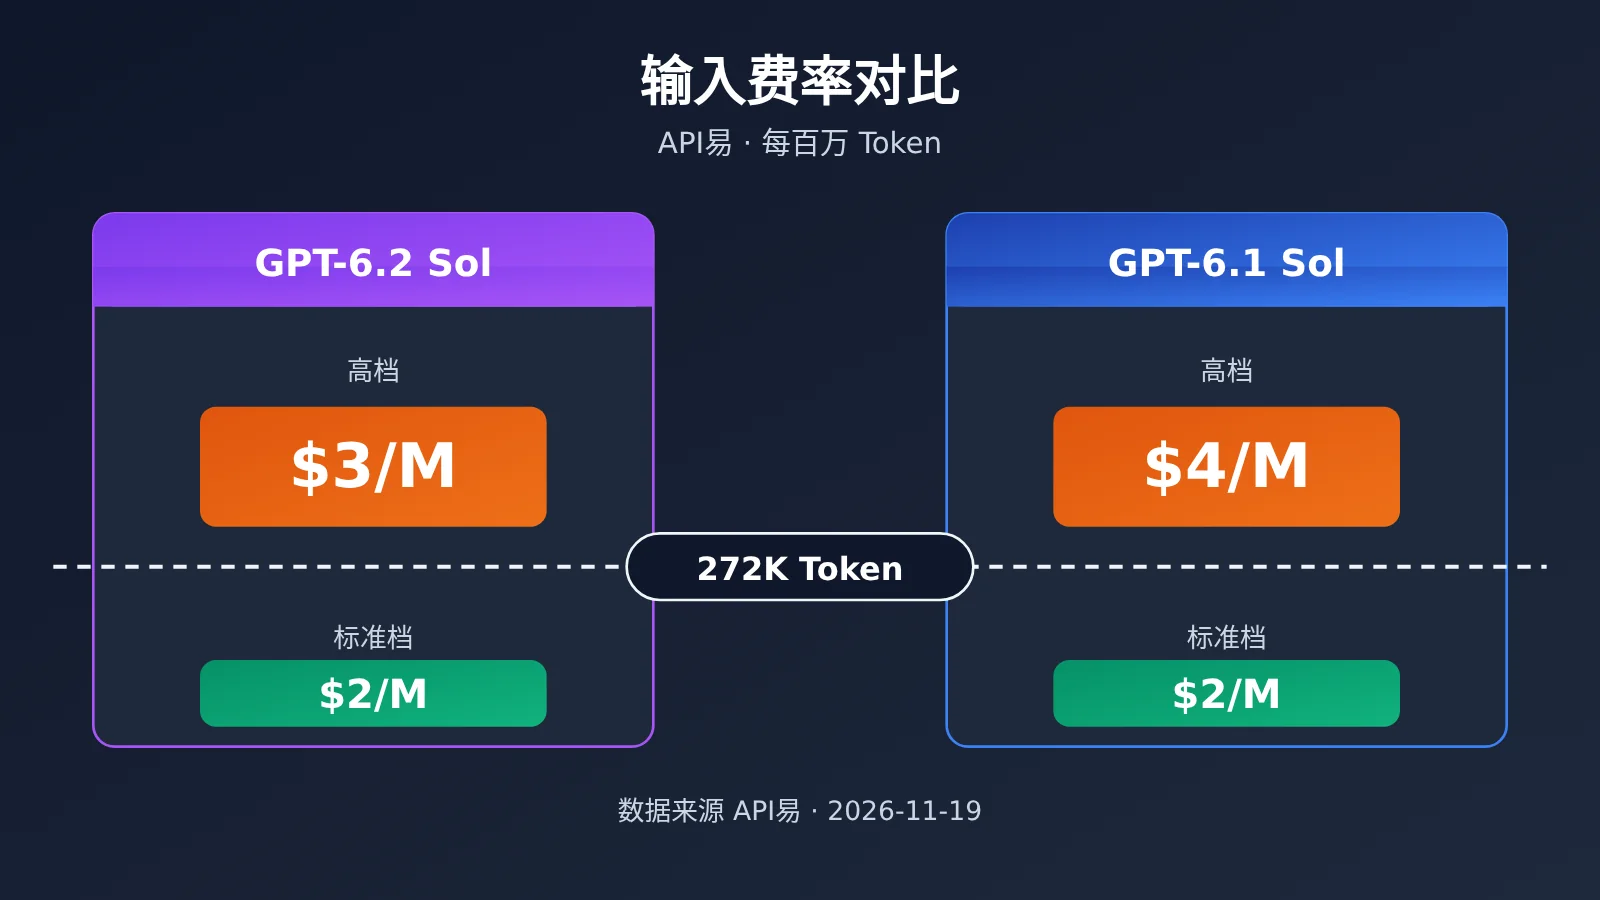
GPT-6.2 Sol 对比 6.1 Sol 核心差异:阶梯输入标价
两个模型在 API易都采用阶梯计价,分界点是 272,000 Token。下表并列阈值内外的输入标价,数据取自 API易模型价格总表的阶梯计价说明,查询日期为 2026-11-19。
| 输入区间 | gpt-6.2-sol 输入标价 | gpt-6.1-sol 输入标价 | 差异 | 数据来源 |
|---|---|---|---|---|
| 0 – 272,000 Token | $2 / 百万 Token | $2 / 百万 Token | 相同 | API易 apiyi.com 价格总表 |
| 超过 272,000 Token | $3 / 百万 Token | $4 / 百万 Token | 6.2 低 25% | API易价格总表 |
需要注意,这张表只覆盖输入费率。API易公开总表并未据此确认所有分组都按整单套用高档,也未在这项说明中给出输出与缓存的高档费率。所以“6.2 Sol 高档输入便宜 25%”不能直接推导成“整单便宜 25%”,后者需要结合你所在分组的实际账单来核对。
另外,OpenAI 官方模型卡对 gpt-6.2-sol 也有自己的档位说明。厂商官方规则与 API易平台标价属于两套口径,本文不做混算,所有数字均为 API易平台标价;如需了解厂商规则,请单独查阅官方模型卡。
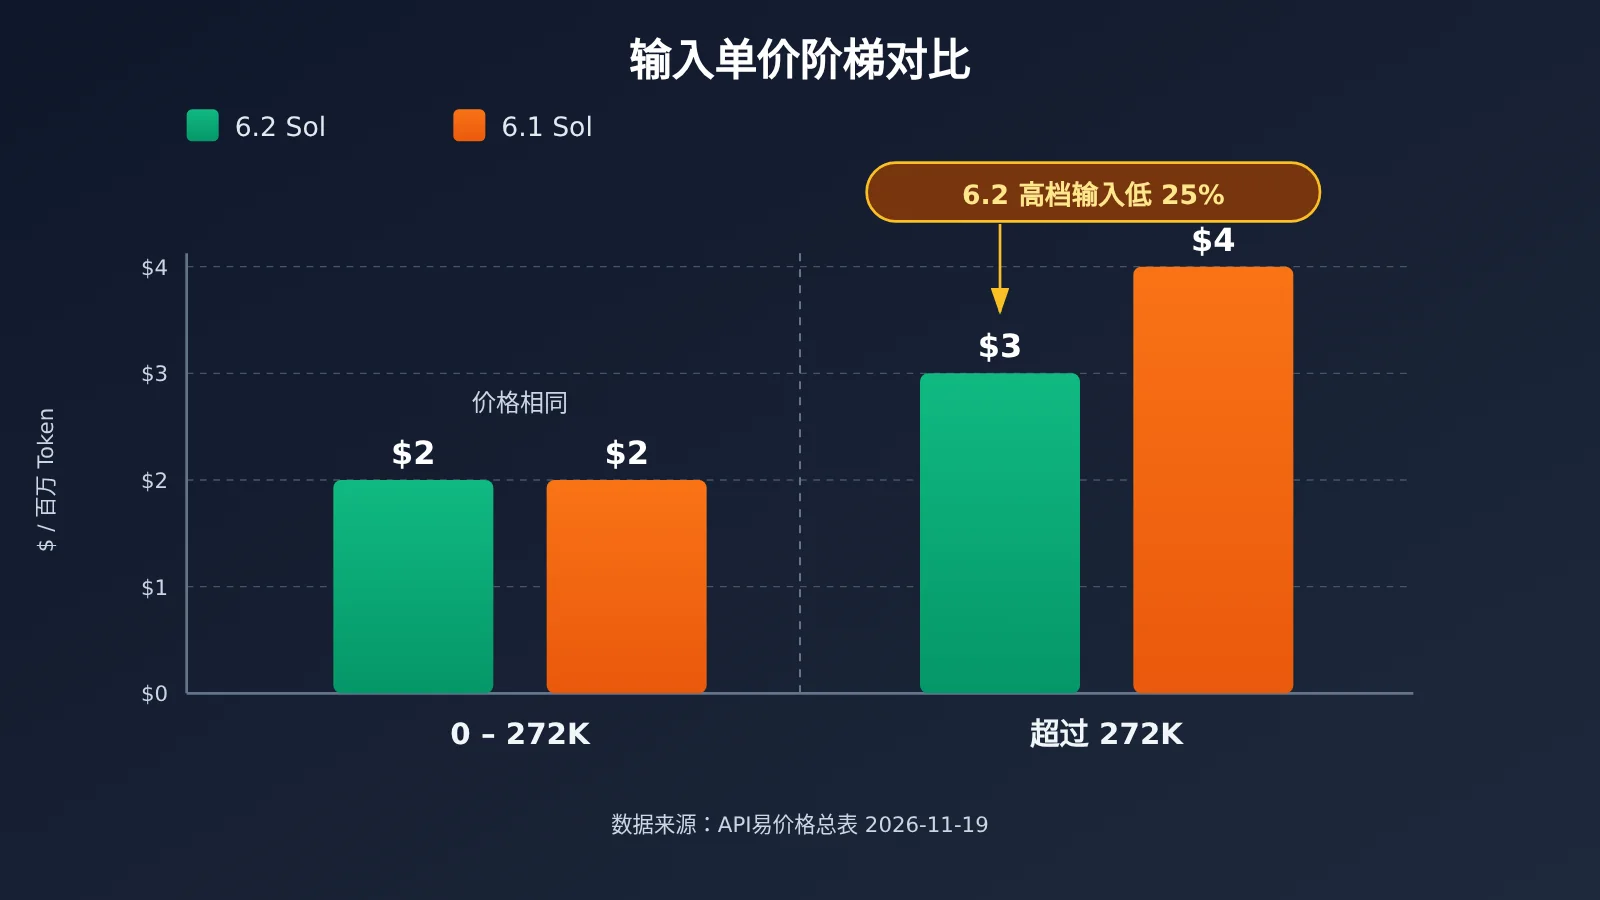
GPT-6.2 Sol 对比 6.1 Sol:30 万 Token 输入费算例
假设一次请求的输入为 300,000 Token,且全部未命中缓存。这已经超过 272,000 的阈值,关键在于平台如何对这次请求套用高档费率。阶梯计价常见两种口径,下表分别给出计算结果。
| 计费假设 | gpt-6.2-sol 输入费 | gpt-6.1-sol 输入费 | 差额 | 状态 |
|---|---|---|---|---|
| A:全量输入套用高档 | 0.3 × $3 = $0.90 | 0.3 × $4 = $1.20 | $0.30 | 参考资料给出的示意算法,需确认路由 |
| B:仅超出部分套用高档 | 0.272 × $2 + 0.028 × $3 = $0.628 | 0.272 × $2 + 0.028 × $4 = $0.656 | $0.028 | 纯数学推演,平台未确认 |
如果你所用的 API易路由确认按全量输入套用高档,那么单次 30 万 Token 未缓存输入的差额是 $0.30。假设 B 只是为了说明“口径不同,差额可能相差一个数量级”,并不是平台已公布的规则。做预算之前,先确认你的分组属于哪种口径,比任何算例都重要。
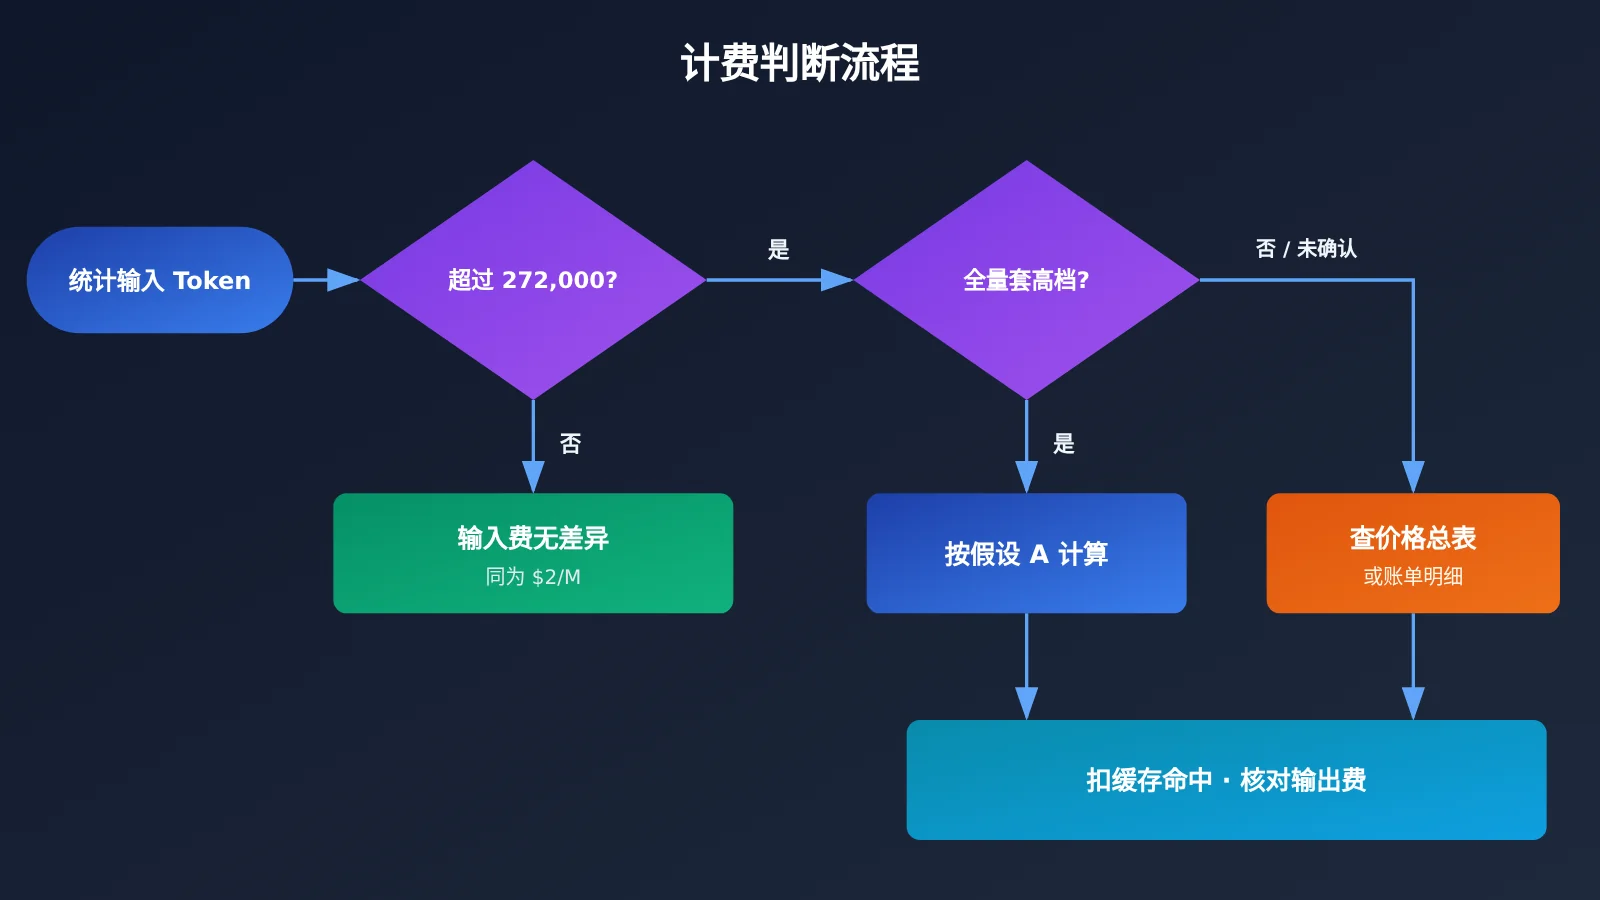
长文档预算的三个区分:Token、字数与账单
很多预算偏差并不是来自费率,而是来自概念混淆。下面三组概念在做 GPT-6.2 Sol 或 6.1 Sol 长文档预算时必须分开看。
| 容易混淆的概念 | 正确理解 | 对预算的影响 |
|---|---|---|
| 字数 vs Token | 计费按 Token,字数与 Token 没有固定换算比例,随语言和内容变化 | 不能用“30 万字”直接套 30 万 Token 的算例 |
| 文档 Token vs 单次输入 Token | 单次输入还包括系统提示词、对话历史、工具定义等 | 文档本身不到阈值,加上上下文后可能越过 272,000 |
| 理论输入费 vs 实际账单 | 理论值按标价乘以 Token 数;实际账单还受缓存命中、分组口径、输出费影响 | 算例只能作为上限参考,以账单明细为准 |
最可靠的做法是直接读取接口返回的 usage 字段,用真实的 prompt_tokens 判断是否越过阈值,而不是靠字数估算。
如何预估 GPT-6.2 Sol 与 6.1 Sol 的长文档输入费
极简示例:读取真实输入 Token 数
先发一次请求,拿到这份长文档在实际调用中的输入 Token 数:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口
)

doc = open("long_doc.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "请总结以下文档:\n" + doc}]
)
print("prompt_tokens:", resp.usage.prompt_tokens)
查看完整实现代码:按两种计费假设估算输入费
import openai

# 价格快照:API易价格总表,2026-11-19 查询,单位 美元/百万 Token
# 仅包含输入费率;输出与缓存费率请以平台价格表和账单为准
PRICES = {
    "gpt-6.2-sol": {"low": 2.0, "high": 3.0},
    "gpt-6.1-sol": {"low": 2.0, "high": 4.0},
}
THRESHOLD = 272_000

def estimate_input_cost(model: str, input_tokens: int, cached_tokens: int = 0,
                        mode: str = "full") -> float:
    """
    估算未缓存输入部分的理论输入费
    mode="full":     超阈值时全量套用高档(需确认所在分组是否如此)
    mode="marginal": 仅超出部分套用高档(假设口径,平台未确认)
    cached_tokens 仅从计算中扣除,缓存部分的费用需单独核对
    """
    p = PRICES[model]
    uncached = max(input_tokens - cached_tokens, 0)
    if input_tokens <= THRESHOLD:
        return uncached / 1e6 * p["low"]
    if mode == "full":
        return uncached / 1e6 * p["high"]
    low_part = min(uncached, THRESHOLD)
    high_part = max(uncached - THRESHOLD, 0)
    return low_part / 1e6 * p["low"] + high_part / 1e6 * p["high"]

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

doc = open("long_doc.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "请总结以下文档:\n" + doc}]
)

usage = resp.usage
cached = 0
details = getattr(usage, "prompt_tokens_details", None)
if details is not None and getattr(details, "cached_tokens", None):
    cached = details.cached_tokens

for m in PRICES:
    for mode in ("full", "marginal"):
        cost = estimate_input_cost(m, usage.prompt_tokens, cached, mode)
        print(f"{m} [{mode}] 未缓存输入费估算: ${cost:.4f}")
把 input_tokens=300_000、cached_tokens=0 代入,full 模式会得到 $0.90 与 $1.20,与上文算例 A 一致。脚本中的价格是查询日快照,平台调价后需要同步更新。
🚀 快速开始:建议先在 API易 apiyi.com 用新用户免费测试额度跑一份真实长文档,拿到
prompt_tokens和账单明细后再定预算,比单纯按字数估算可靠得多。
GPT-6.2 Sol 对比 6.1 Sol 场景推荐
下表只从输入费率角度给出建议,不涉及模型质量与速度差异;这两项需要你结合自己的任务实际测试。
| 你的长文档场景 | 输入费率角度的结论 | 建议动作 |
|---|---|---|
| 单次输入稳定在 272,000 Token 以内 | 两者同为 $2/百万 Token,这项费率无差异 | 按效果和其他费用项选型,不要指望靠输入费省钱 |
| 单次输入经常超过 272,000 Token | 6.2 Sol 高档输入标价低 25% | 确认分组计费口径后,优先评估 6.2 Sol |
| 输入在阈值附近波动 | 差异取决于超阈值请求的占比 | 统计一段时间的 prompt_tokens 分布再决定 |
| 同一文档会被反复提问 | 缓存命中会改变实际账单 | 单独核对缓存部分费率,不要按未缓存算例外推 |
选择 GPT-6.2 Sol 的典型情况
- 合同、财报、代码仓库等超长材料需要一次性塞进上下文,输入经常越过 272,000 Token。
- 预算主要被高档输入费吃掉,且已确认所在分组的计费口径。
继续使用 GPT-6.1 Sol 的典型情况
- 任务输入长期在阈值以内,这项费率与 6.2 Sol 相同,切换不会带来输入费节省。
- 现有流程已经在 6.1 Sol 上稳定运行,迁移前需要先评估效果差异。
GPT-6.2 Sol 对比 6.1 Sol 决策建议与核账清单
决策逻辑可以压缩成一句话:不超阈值,不能靠这项费率省钱;超阈值,要同时核对分组、缓存和输出。上线长文档任务之前,建议逐项过一遍下面的清单。
| 核账项 | 要确认的问题 | 核对方式 |
|---|---|---|
| 单次输入 Token | 是否真的超过 272,000?是否包含系统提示词和历史 | 读取返回中的 usage.prompt_tokens |
| 分组计费口径 | 超阈值后是全量套用高档,还是另有规则 | 查阅 API易价格总表阶梯计价说明,必要时咨询平台 |
| 缓存命中 | 有多少输入命中缓存,缓存部分如何计费 | 查看 cached_tokens 字段与账单明细 |
| 输出费 | 输出是否也分档,费率是多少 | 以平台价格表为准,本文不引用未核实的输出价 |
| 价格时效 | 本文快照日期为 2026-11-19,是否已调价 | 调用前重新查询价格总表 |
| 口径一致性 | 是否把厂商官方档位与平台标价混在一起算 | 厂商规则单独标注,预算只用一套口径 |
💡 选择建议:如果你的长文档任务确实频繁超过阈值,建议在 API易 apiyi.com 上用同一份文档分别调用 gpt-6.2-sol 和 gpt-6.1-sol,对照两次的账单明细,再决定是否迁移。同一个 API Key 即可切换模型,便于做这类对照。
常见问题 FAQ
Q1:GPT-6.2 Sol 对比 6.1 Sol,输入价格到底差在哪里?
只差在高档区间。按 API易价格总表,0–272,000 Token 输入两者都是 $2/百万 Token;超过 272,000 后,6.2 Sol 为 $3,6.1 Sol 为 $4,6.2 Sol 低 25%。
Q2:30 万字的文档是不是就等于 30 万 Token?
不是。字数与 Token 没有固定换算比例,而且单次输入还包含系统提示词和对话历史。请以接口返回的 `prompt_tokens` 为准判断是否超过阈值。
Q3:30 万 Token 输入用 6.2 Sol 一定能省 $0.30 吗?
不一定。$0.30 是在“全量输入套用高档、全部未命中缓存”的前提下算出的输入费示意。如果分组口径不同或有缓存命中,差额会变化,而且这不包括输出费。
Q4:可以说 6.2 Sol 整单比 6.1 Sol 便宜 25% 吗?
不可以。25% 只是高档输入标价的差距。API易公开总表并未据此确认所有分组的整单计费规则,也未给出输出与缓存的高档费率,整单差异需要看实际账单。
Q5:如何在 API易 上快速验证自己的长文档成本?
1. 在 API易 apiyi.com 注册并获取 API Key,新用户有免费测试额度
2. 用本文代码把 `base_url` 设为 `https://api.apiyi.com/v1`,发送一份真实长文档
3. 记录 `prompt_tokens`、`cached_tokens`,再与平台账单明细对照
Q6:本文数据有哪些局限?
本文数字只来自 2026-11-19 查询的平台价格总表,不是实测账单,也不涉及输出价格、模型质量或速度。厂商官方模型卡的档位规则与平台标价属于不同口径,本文未做混算,价格变动时请以最新价格表为准。
GPT-6.2 Sol 对比 6.1 Sol 核心要点 Key Takeaways
- 阈值内同价:272,000 Token 以内,两者输入标价都是 $2/百万 Token。
- 高档有差距:超阈值后 6.2 Sol 为 $3、6.1 Sol 为 $4,前者低 25%。
- 算例有前提:全量套高档且未缓存时,30 万 Token 输入费差 $0.30。
- Token 不等于字数:以
prompt_tokens判断是否越过阈值。 - 理论不等于账单:缓存、分组口径和输出费都会改变实际支出。
- 先测再定预算:在 API易 apiyi.com 用真实文档跑一次,对照账单再决策。
总结
GPT-6.2 Sol 对比 6.1 Sol 在长文档输入费上的核心要点:
- 阈值以内无差异:输入不超过 272,000 Token 时,换模型不能省这项费用。
- 超阈值看高档费率:6.2 Sol 高档输入标价比 6.1 Sol 低 25%,30 万 Token 全量高档未缓存时差 $0.30。
- 预算以账单为准:同时核对分组口径、缓存命中和输出费,算例只是输入费示意。
如果你的业务确实经常处理超长文档,推荐通过 API易 apiyi.com 用真实请求对照两个模型的账单明细,再据此确定模型选型和月度预算。
📚 参考资料
-
API易模型价格总表:阶梯计价说明
- 链接:
docs.apiyi.com/models - 说明: 本文所有输入标价的来源,查询日期 2026-11-19,调用前请重新确认
- 链接:
-
OpenAI 官方模型卡 – gpt-6.2-sol:厂商官方档位说明
- 链接:
developers.openai.com/api/docs/models/gpt-6.2-sol - 说明: 厂商规则与平台标价属于不同口径,仅供单独参考,不与本文数字混算
- 链接:
作者: APIYI 技术团队
技术交流: 欢迎在 API易官网首页联系我们,更多计费与接入资料可访问 docs.apiyi.com 文档中心