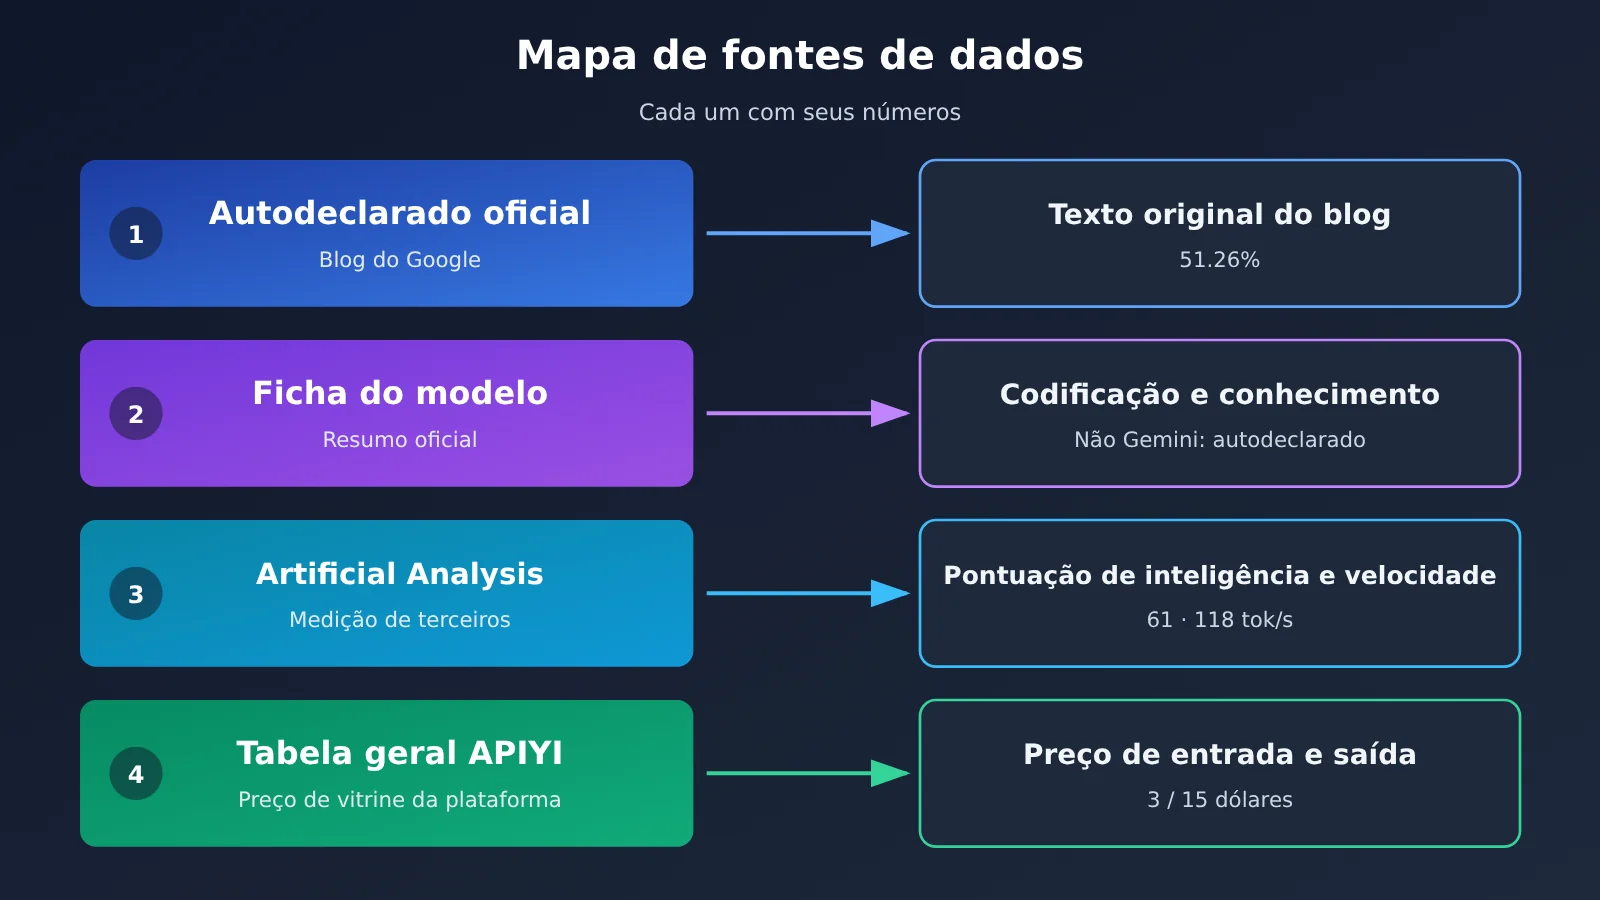
Nota do autor: este artigo lê os números públicos do Gemini 4 Neon e do Claude Opus 5.5 em duas frentes separadas — programação e trabalho de conhecimento — e indica, item por item, se cada número vem de autodeclaração oficial, model card, página do modelo no Artificial Analysis, artigo do Artificial Analysis, tabela geral da APIYI ou interface de preços.
Se o seu fluxo de trabalho já estiver integrado ao Claude Opus 5.5, o Gemini 4 Neon, lançado em 2026-11-18, traz uma pergunta direta: quem tem os números mais altos no mesmo projeto e se esses números foram medidos com a mesma régua. O blog do Google, a model card do DeepMind e o Artificial Analysis divulgaram números no dia do lançamento, mas seus critérios, configurações e frameworks de teste são diferentes.
A data de verificação dos dados deste artigo é 2026-11-19. Todos os números vêm de fontes públicas, e cada um traz a fonte indicada. Programação e trabalho de conhecimento são lidos em duas frentes; model card e Artificial Analysis são abordados em duas seções. Qual modelo é mais adequado para você depende de quais linhas você prioriza.
Valor central: depois de ler este artigo, você vai saber como interpretar a tabela de três colunas da model card do Gemini 4 Neon, o que representam a pontuação de inteligência, o custo por tarefa, o tempo de execução e a velocidade de saída no Artificial Analysis, e como encontrar o modelo e o preço listado do Claude Opus 5.5 na APIYI.
Principais pontos do Gemini 4 Neon e do Claude Opus 5.5
Vamos começar com uma tabela de leitura rápida. Cada linha indica a configuração e a fonte; os dois números de uma mesma linha não foram necessariamente medidos nas mesmas condições.
| Dimensão | Gemini 4 Neon | Claude Opus 5.5 | Fonte |
|---|---|---|---|
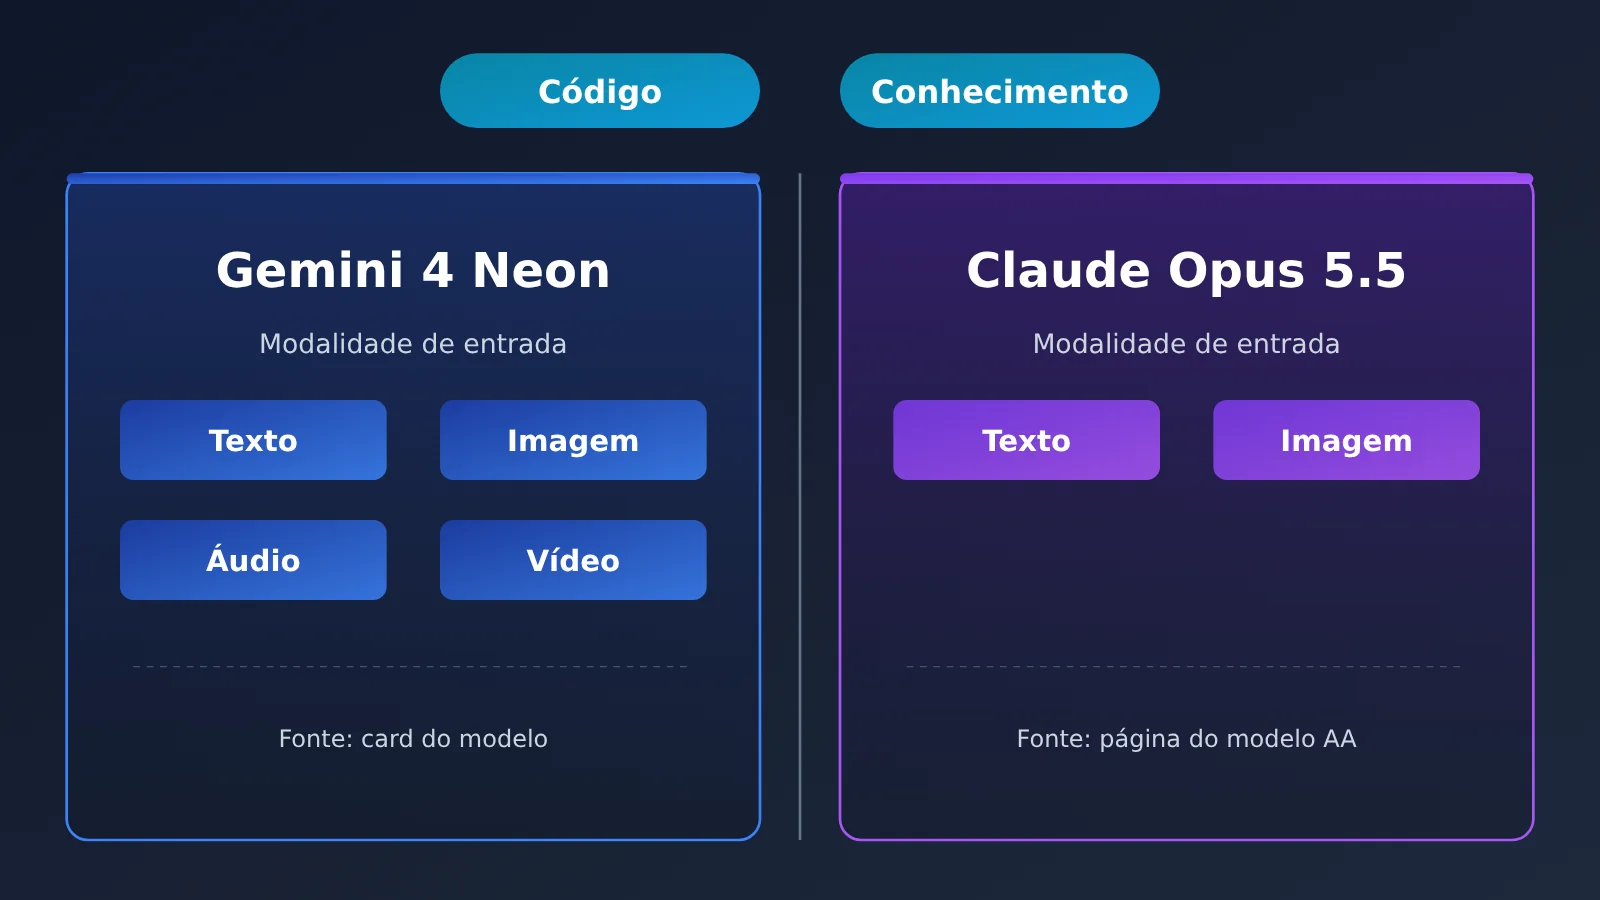
| Modalidades de entrada | Texto, imagem, áudio, vídeo | Texto, imagem | Ficha técnica do modelo / página do modelo no Artificial Analysis |
| Pontuação de inteligência (Índice v5.0.1) | 61 (xhigh) | 59 (max) | Página do modelo no Artificial Analysis |
| Terminal-bench 4.1 (ajustado para trapaça) | 65.2% | 65.8% | Ficha técnica do modelo (resultados que não são do Gemini são autodeclarados por cada fornecedor) |
| FrontierCode 2.0 | 46.2% (high padrão) | 47.3% | Ficha técnica do modelo |
| Custo por tarefa | US$ 6.44 | US$ 10.04 | Página do modelo no Artificial Analysis |
| Velocidade de saída | 110 tokens/s | 118 tokens/s | Página do modelo no Artificial Analysis |
| Preço de tabela (entrada / saída, por milhão de tokens) | US$ 3 / 15 | US$ 4 / 20 | Página de preços do Google AI Studio / página do modelo no Artificial Analysis |
Distribuição dos números entre Gemini 4 Neon e Claude Opus 5.5
Nesta tabela, há linhas em que cada um dos lados fica na frente. Na maioria das categorias da ficha técnica e na pontuação de inteligência do Artificial Analysis (61 contra 59), o Gemini 4 Neon leva vantagem. Já no Terminal-bench 4.1 (65.8% contra 65.2%), no FrontierCode 2.0 (47.3% contra 46.2%) e na velocidade de saída (118 contra 110 tokens/s), o Claude Opus 5.5 fica na frente.
As modalidades de entrada merecem uma observação à parte. Segundo a ficha técnica do modelo, o Gemini 4 Neon aceita texto, imagem, áudio e vídeo como entrada. Segundo a página do modelo no Artificial Analysis, as entradas do Claude Opus 5.5 são texto e imagem. Se a sua tarefa precisa lidar diretamente com áudio ou vídeo, esse item vai decidir a escolha. Se a tarefa envolve apenas texto e capturas de tela, esse item não faz diferença.
Gemini 4 Neon vs Claude Opus 5.5: como ler a tabela de três colunas do model card
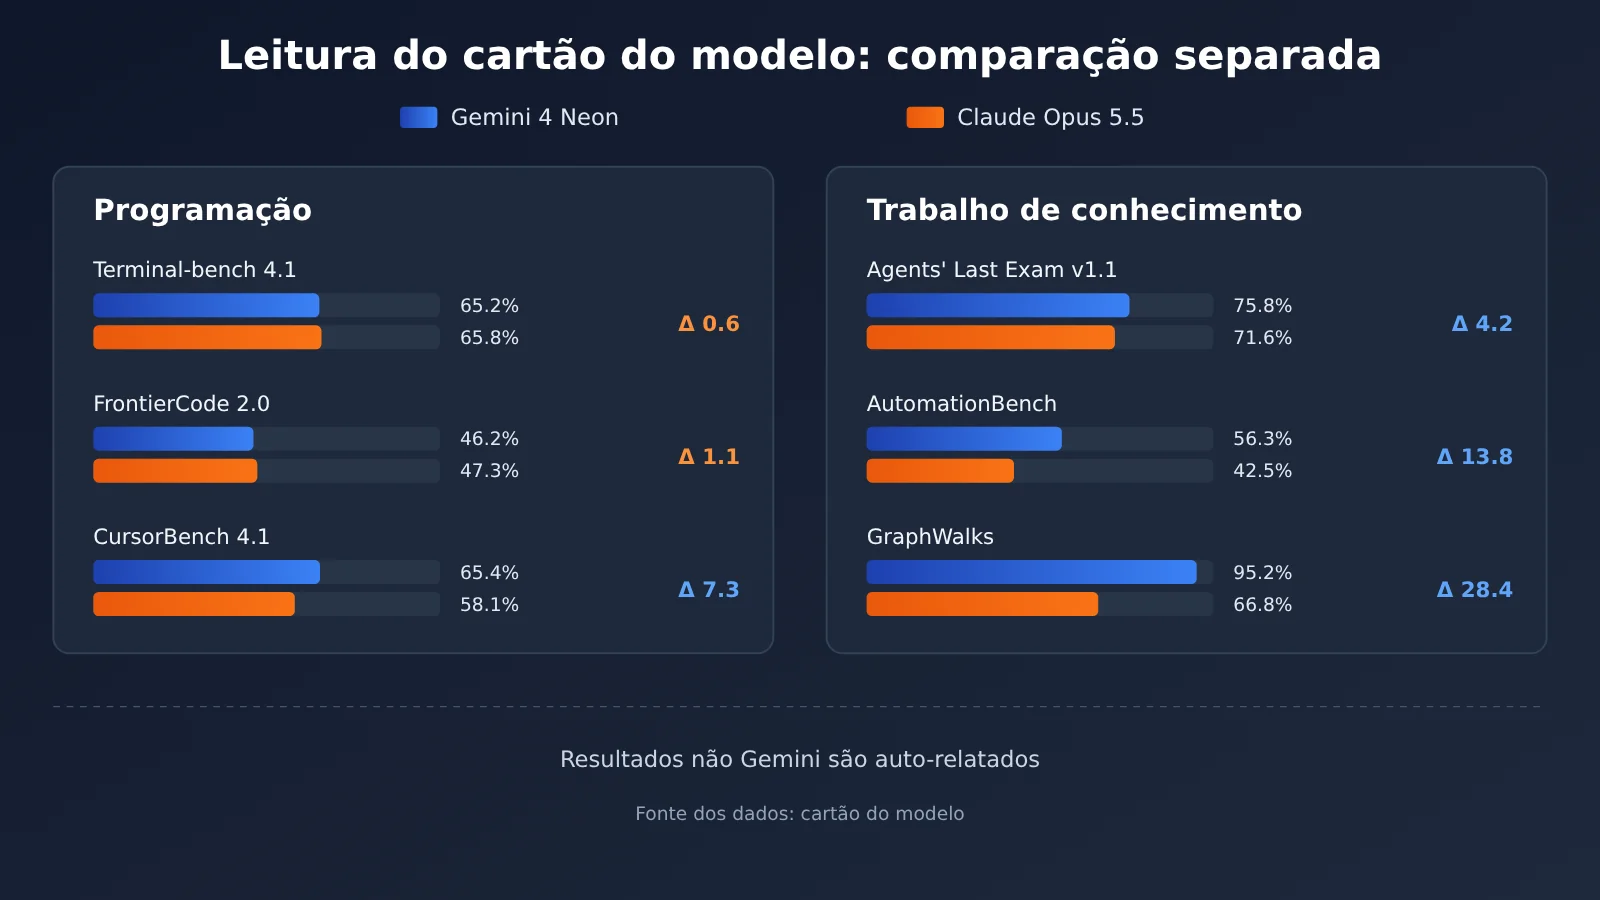
A tabela comparativa do model card do DeepMind tem apenas três colunas: Gemini 4 Neon, Claude Opus 5.5 e GPT-6.2 Sol. Este artigo lê só as duas primeiras. O PDF de notas de avaliação deixa claro que os resultados que não são do Gemini vêm, por padrão, de autorrelatos de cada fornecedor. Ou seja, esta tabela é um resumo oficial — as colunas não foram remedidas pelo mesmo laboratório no mesmo dia —, então ao ler trate cada célula como uma declaração pública.
Subitens de codificação: Gemini 4 Neon e Claude Opus 5.5
Abaixo estão as linhas do model card relacionadas a codificação e programação segura.
| Subitem (model card) | Gemini 4 Neon | Claude Opus 5.5 | Quem é maior |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | Neon |
| Terminal-bench 4.1 (acurácia ajustada por trapaça) | 65.2% | 65.8% | Opus |
| FrontierCode 2.0 | 46.2% (high padrão) | 47.3% | Opus |
| SWE-sweep harness do fornecedor | 39.0% | 10.1% | Neon |
| SWE-sweep harness mini-SWE | 12.8% | 3.6% | Neon |
| CWE-Bench v2 | 70.7% | 67.1% | Neon |
| WebExploitBench v1.2 | 51.3% | 37.1% | Neon |
Há três pontos de atenção ao ler esta tabela.
- Os dois subitens em que o Opus é maior pertencem à codificação principal. Tanto o Terminal-bench 4.1 quanto o FrontierCode 2.0 medem operações de terminal e tarefas de código, com diferenças de 0.6 e 1.1 ponto percentual, respectivamente. A nota do Neon no FrontierCode está marcada como high padrão.
- As duas linhas do SWE-sweep usam dois harnesses diferentes. O Neon marca 39.0% dentro do Google Antigravity e 12.8% no harness mini-SWE. O blog do Google atribui essa diferença ao que o harness desbloqueia, então não convém interpretá-la como se os modelos em si fossem três vezes diferentes. Ao comparar os dois modelos, faça a comparação sob o mesmo harness, isto é, 39.0% contra 10.1%, ou 12.8% contra 3.6%.
- O mesmo número aparece escrito de forma diferente conforme a fonte. O WebExploitBench é 51.3% no model card e 51.26% no blog do Google. As duas grafias ficam registradas fielmente, sem escolher uma em detrimento da outra.
Subpontuações de conhecimento e ciência: Gemini 4 Neon vs. Claude Opus 5.5
As subcategorias de trabalho de conhecimento, raciocínio científico e contexto longo são mais numerosas, e nesta parte o Neon leva vantagem na maioria delas.
| Subcategoria (card do modelo) | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| AA Index v5.0.1 | 61 | 59 |
| Vals Index v2.2 | 70,9% | 70,1% |
| AutomationBench | 56,3% | 42,5% |
| Agents’ Last Exam v1.1 | 75,8% | 71,6% |
| RiemannBench | 84,0% | 80,0% |
| Terminal-Bench-Science 0.1 | 70,5% | 63,3% |
| HLE-Diamond | 71,3% | 67,9% |
| MKA Climb WSR | 56,5% | 53,0% |
| Chartography | 73,5% | 66,3% |
| LVBench | 89,0% | 83,7% |
| GraphWalks (256k a 1M, F1 do BFS) | 95,2% | 66,8% |
As diferenças variam bastante de uma linha para outra. No Vals Index são apenas 0,8 ponto percentual; já no GraphWalks são 28,4 pontos percentuais, que mede a travessia de grafo em contexto ultralongo de 256k a 1M de tokens. Se o seu trabalho de conhecimento envolve recuperar informações e raciocinar sobre documentos longos, vale olhar com atenção para a linha do GraphWalks. Se for automação de negócios, o 56,3% contra 42,5% do AutomationBench fica mais próximo do seu cenário de uso.
O blog do Google também listou algumas posições em formato de autodeclaração oficial, como 1º lugar no Legal Research Bench e no Tax Agent Bench, além de maioria em 1º lugar no Surge em finanças, contabilidade e modelagem de tabelas. O blog não traz os percentuais desses itens nem os números correspondentes do Opus, então essas colocações não podem entrar diretamente na tabela comparativa dos dois modelos.
Gemini 4 Neon vs Claude Opus 5.5: como ler os quatro números do Artificial Analysis
O Artificial Analysis é uma medição de terceiros e pertence a um sistema diferente do dos model cards. Para cada nível de raciocínio, sua página de modelo traz pontuação de inteligência, custo por tarefa, tempo e velocidade de saída. A comparação principal desta seção é Neon xhigh contra Opus max — os níveis mais altos de cada uma das duas empresas nas páginas de modelo, mas os dois níveis não são equivalentes.
| Métrica (página de modelo do Artificial Analysis, v5.0.1) | Gemini 4 Neon (xhigh) | Claude Opus 5.5 (max) |
|---|---|---|
| Pontuação de inteligência | 61 | 59 |
| Custo por tarefa | US$ 6.44 | US$ 10.04 |
| Tempo por tarefa | 21.5 minutos | 24.5 minutos |
| Velocidade de saída | 110 tokens/s | 118 tokens/s |
| Primeiro token da resposta | 56.51 segundos | 335.85 segundos |
| Tokens de saída no índice de execução | 283 milhões | 218 milhões |
| Preço de tabela (entrada / saída) | US$ 3.00 / 15.00 | US$ 4.00 / 20.00 |
| Preço misto | US$ 2.21 | US$ 2.94 |
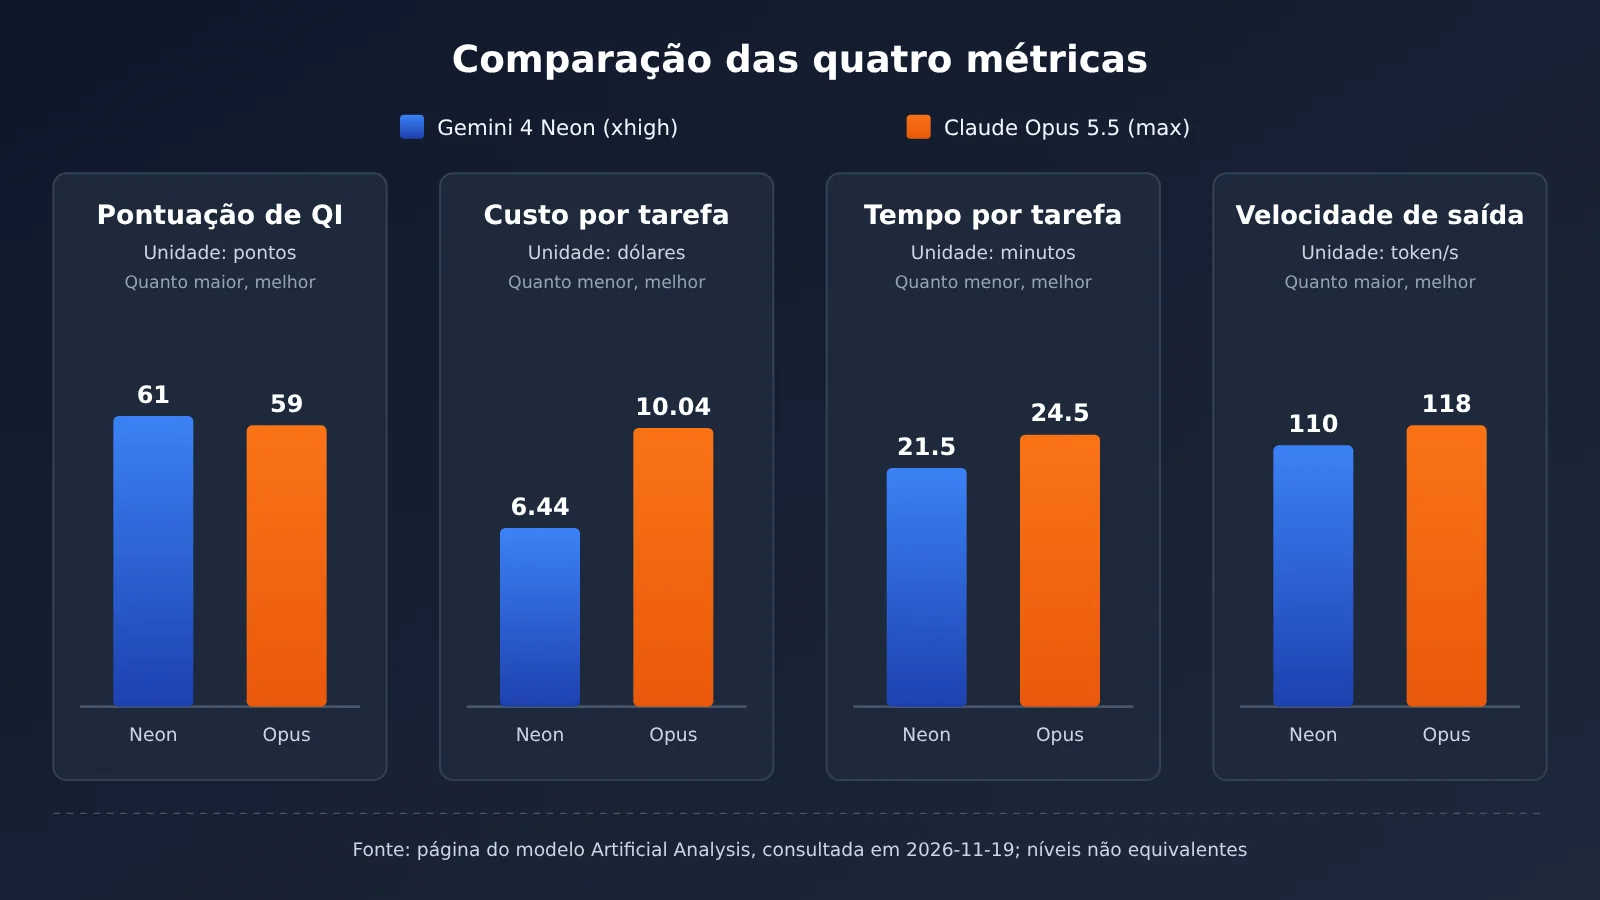
📊 Nota sobre o gráfico: os números da imagem acima vêm da página de modelo do Artificial Analysis e refletem a contabilidade de quando o terceiro executa o índice. Ao chamar o Claude Opus 5.5 no APIYI apiyi.com, considere a lista de modelos e os preços de tabela da plataforma.
Custo por tarefa: uma conta do ranking
O custo por tarefa de 6.44 dólares contra 10.04 dólares é o valor calculado pelo Artificial Analysis depois de rodar o seu índice — é uma conta que consta no ranking e não é igual à sua fatura na APIYI. Esse número depende ao mesmo tempo do preço unitário e do volume consumido. Segundo os dados da página do modelo, o Neon gerou 283 milhões de tokens ao rodar o índice, mais do que os 218 milhões do Opus, mas o preço unitário dele é de 3/15 dólares, enquanto o do Opus é de 4/20 dólares. O seu custo real depende do comprimento da entrada da sua tarefa, do comprimento da saída e da taxa de acerto do cache.
Tempo de execução, velocidade de saída e tempo até o primeiro token
A velocidade de saída é maior no Opus: 118 contra 110 tokens/s. Já o tempo por tarefa é menor no Neon: 21.5 contra 24.5 minutos. Os dois conjuntos de números não se contradizem, porque o tempo de execução também inclui a espera pelo primeiro token e o volume total de saída. Segundo a página do modelo, o primeiro token de resposta do Opus max leva 335.85 segundos, e o do Neon xhigh, 56.51 segundos. Em cenários interativos, o tempo até o primeiro token pesa muito mais na percepção do que a taxa de transferência.
Comparação entre níveis e pontuação de código
Se você baixar o nível, os números da página do modelo também mudam. O Neon high tem 60 pontos, 14.8 minutos e 101 tokens/segundo; o Opus xhigh tem 57 pontos, 16.1 minutos e 107 tokens/segundo; e o Opus high tem 52 pontos, 9.3 minutos e 108 tokens/segundo. Os tempos até o primeiro token dos três níveis high, medium e low do Neon são, respectivamente, 40.64 segundos, 20.14 segundos e 13.93 segundos. Esses números vêm do FAQ da página do modelo e não estão na mesma coluna da tabela-resumo acima.
Em programação, o artigo da Artificial Analysis traz o Coding Agent Index: o Neon xhigh marca 59 no Antigravity CLI, e o Opus 5.5 max marca 58 no Claude Code; os dois rodam em CLIs diferentes. O blog do Google informa 58.6, um número autodeclarado oficialmente e diferente do 59 do artigo. O mesmo artigo também traz o custo por tarefa de programação: 6.86 dólares para o Neon e 12.61 dólares para o Opus 5.5 max.
Recomendações de cenários para Gemini 4 Neon e Claude Opus 5.5
As observações abaixo são julgamentos baseados nos números acima. São recomendações, não fatos. Vale revalidar com a sua própria amostra de tarefas.
Cenários que favorecem o Gemini 4 Neon
- Áudio e vídeo diretamente como entrada: segundo o model card, o Neon aceita áudio e vídeo; a entrada do Opus é texto e imagem.
- Raciocínio e recuperação com contexto ultralongo: 95.2% contra 66.8%; a janela unificada do Neon chega a 1048576 tokens (guia para desenvolvedores do Google Cloud).
- Agentes de automação de negócios e trabalho do conhecimento: AutomationBench 56.3% contra 42.5%, Agents’ Last Exam v1.1 75.8% contra 71.6% (model card).
- Interações sensíveis à espera pelo primeiro token: segundo a página do modelo da Artificial Analysis, o primeiro token do Neon xhigh leva 56.51 segundos, enquanto o do Opus max leva 335.85 segundos.
Cenários em que vale a pena continuar com Claude Opus 5.5
- Programação para operações de terminal: Terminal-bench 4.1 é 65.8% contra 65.2% (model card).
- Tarefas de código do tipo FrontierCode: 47.3% contra 46.2% (model card; para o Neon, o padrão é high).
- Throughput de saídas longas: velocidade de saída de 118 contra 110 tokens/segundo (página do modelo da Artificial Analysis).
- Fluxos de trabalho já profundamente integrados ao Claude Code ou ao endpoint messages: o custo de migração também precisa entrar na conta.
Como chamar o Claude Opus 5.5 na APIYI e conferir o status do Gemini 4 Neon
Modelo e preço do Claude Opus 5.5 na APIYI
Se você já usa o Opus, dá para conferir modelo e preço na APIYI (apiyi.com) com a mesma chave. A tabela geral da APIYI em docs.apiyi.com/models.md está marcada com atualização de 2026-11-16 09:39 (UTC+8). A interface de preços api.apiyi.com/api/pricing foi lida em 2026-11-19, na versão shell-api-modelmak-v1, com 285 modelos no total.
| ID do modelo | Entrada / leitura de cache / saída (USD por milhão de tokens) | Endpoints | Grupos (tabela geral da APIYI) | ID do grupo (interface de preços) |
|---|---|---|---|---|
claude-opus-5-5 |
4 / 0.2 / 20 | chat, messages | ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP | ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip |
claude-opus-5-5-thinking |
4 / 0.2 / 20 | chat, messages | os mesmos acima | os mesmos acima |
gemini-4-neon |
não disponível | — | — | — |
Os nomes dos dois conjuntos de grupos não batem exatamente, então mantivemos os dois na tabela. Na interface de preços, model_ratio igual a 1 corresponde a entrada de 2 dólares por milhão de tokens, e completion_ratio igual a 5 significa que o preço de saída é 5 vezes o da entrada — a mesma lógica da primeira faixa da tabela geral, então dá para conferir os preços da tabela acima usando essa regra.
Nem a tabela geral nem a interface de preços da APIYI trazem gemini-4-neon, e também não existe página de modelo dedicada a ele. Ainda não está no ar, mas vamos publicá-lo o quanto antes; modelo e preço valem pelo que estiver na lista de modelos da plataforma. Como referência, a página de preços do Google AI Studio informa para o Neon o valor pago de 3,00 dólares de entrada, 15,00 de saída (incluindo tokens de raciocínio) e 0,15 de cache, por milhão de tokens, sem faixa gratuita e apenas com cache implícito.
Passos da chamada
- Coloque a chave numa variável de ambiente, por exemplo
APIYI_API_KEY. O código só lê a variável, nunca deixa a chave escrita em texto puro. - Se estiver usando um cliente compatível com OpenAI, defina o base_url como
https://api.apiyi.com/v1. - No campo
model, preenchaclaude-opus-5-5ouclaude-opus-5-5-thinking, e escolha o endpoint chat ou messages conforme a necessidade. - Escolha o grupo de acordo com a sua operação. Os nomes dos grupos seguem a grafia da tabela geral e da interface de preços.
- Quando o Neon estiver disponível e você for fazer o teste comparativo, fique atento: o guia para desenvolvedores do Google Cloud diz que os níveis de raciocínio são apenas low, medium, high e xhigh, com high como padrão. Passar
thinking_budgetouMINIMALretorna HTTP400. Ele não suporta cache de contexto explícito; o cache implícito entra automaticamente em prefixos compartilhados acima de 4096 tokens.
🚀 Comece rápido: rode primeiro uma linha de base no Opus com uma dúzia de tarefas reais suas, anotando os tokens de saída e o tempo gasto. Quando o Neon estiver disponível na APIYI (apiyi.com), faça a comparação com o mesmo lote de amostras e o mesmo nível de raciocínio — assim o número que você obtém é o da sua própria operação.
Recomendações de decisão entre Gemini 4 Neon e Claude Opus 5.5
💡 Recomendação de escolha: se o seu trabalho for voltado principalmente a terminal e tarefas de código, a diferença apontada pelo model card e pelo Artificial Analysis é bem pequena — o Opus é ligeiramente superior no Terminal-bench 4.1 e no FrontierCode 2.0, então não há um motivo claro para trocar. Se o seu trabalho pender mais para organização de conhecimento, janela de contexto longa e entradas multimodais, a maioria dos itens do model card mostra o Neon à frente, e vale a pena fazer um teste comparativo assim que ele for lançado. O que está acima é um julgamento, não um fato.
Em relação aos custos, não monte o orçamento diretamente com base nos 6,44 e 10,04 dólares do Artificial Analysis. E também não aplique ao Opus aquela frase do blog do Google de que “o custo por tarefa no nível high padrão é 32% menor que o do Carbon” — esse é o algoritmo do próprio Google, e o objeto de comparação também não é o Opus.
Perguntas frequentes (FAQ)
P1: Qual é o posicionamento do Gemini 4 Neon?
Segundo o blog do Google (autorreportado pela própria empresa) e o guia para desenvolvedores do Google Cloud, o Neon fica entre o Hydrogen (execução rápida do dia a dia) e o Carbon (tarefas complexas de longa duração), voltado a fluxos complexos de alta frequência. A ficha do modelo diz que ele foi adaptado a partir do Gemini 4 Carbon, com conhecimento até março de 2026.
P2: Em codificação, quem tem números maiores entre Gemini 4 Neon e Claude Opus 5.5?
Depende da métrica. Na ficha do modelo, o Opus é maior no Terminal-bench 4.1 (65,8% contra 65,2%) e no FrontierCode 2.0 (47,3% contra 46,2%), enquanto o Neon é maior no CursorBench 4.1 e no SWE-sweep. No artigo da Artificial Analysis, o Coding Agent Index é 59 contra 58, mas os dois rodaram em CLIs diferentes.
P3: A pontuação de inteligência de 61 contra 59 foi comparada no mesmo nível?
Não. É Neon xhigh contra Opus max, pegando o nível mais alto de cada página de modelo. Se compararmos Neon high (60) com Opus xhigh (57), a diferença muda. A pontuação de inteligência 61 é consistente entre o blog do Google, a ficha do modelo e a Artificial Analysis.
P4: O custo de US$ 6,44 por tarefa contra US$ 10,04 pode ser usado como a minha fatura?
Não. Isso é o valor de ranking que a Artificial Analysis usa ao rodar o índice, e depende do conjunto de tarefas e do volume de tokens de saída dela. A fatura real é calculada com base nas suas próprias entradas, saídas e uso de cache, além do preço de tabela da plataforma. Na APIYI apiyi.com, o preço de tabela do Opus é US$ 4 para entrada, US$ 0,2 para leitura de cache e US$ 20 para saída (por milhão de tokens).
P5: Já dá para chamar o Gemini 4 Neon na APIYI?
Nem na tabela geral da APIYI (atualizada em 2026-11-16) nem na interface de preços (lida em 2026-11-19) existe `gemini-4-neon`. Ainda não está disponível; vamos colocá-lo no ar o quanto antes. Modelo e preço seguem a lista de modelos da plataforma. Por enquanto, você pode usar `claude-opus-5-5` no apiyi.com para rodar amostras de linha de base e se preparar para a comparação futura.
P6: Por que o Opus tem velocidade de saída maior, mas leva mais tempo por tarefa?
O tempo de tarefa inclui a espera pelo primeiro token. Segundo a página de modelo da Artificial Analysis, o primeiro token de resposta do Opus max é 335,85 segundos, e o do Neon xhigh é 56,51 segundos. A velocidade de saída reflete apenas a taxa de processamento depois que a geração começa.
P7: Quais são as limitações dessas comparações?
Na ficha do modelo, os resultados que não são do Gemini vêm, por padrão, de dados autorreportados por cada empresa. O Coding Agent Index tem duas versões, 58,6 e 59, e o MKA tem duas versões, 56,5% e 56%; mantivemos ambos os valores fielmente neste artigo. Os 12,8% e 39,0% do SWE-sweep vêm de dois harnesses diferentes. As colocações e os números de segurança no blog do Google são autorreportados oficialmente e não resultados de retestes de terceiros.
Principais pontos (Key Takeaways) do Gemini 4 Neon e Claude Opus 5.5
- Há números mais altos dos dois lados: Neon é maior na maioria das subcategorias do model card e na pontuação de inteligência; Opus é maior nas duas pontuações de codificação e na velocidade de saída.
- O model card é o resumo oficial: os resultados que não são do Gemini são auto-reportados por cada fornecedor, e não uma reavaliação feita no mesmo dia.
- O nível de configuração precisa ficar claro: a comparação da pontuação de inteligência é Neon xhigh contra Opus max.
- O custo por tarefa é a conta do ranking: 6.44 contra 10.04 dólares, o que não equivale à fatura da plataforma.
- Há diferença de modalidades: Neon aceita entrada de áudio e vídeo; Opus é texto e imagem.
- Como começar: Opus já está disponível na APIYI; Neon ainda não, então vale conferir a lista de modelos da plataforma.
Resumo
A comparação entre Gemini 4 Neon e Claude Opus 5.5 precisa ser analisada separando codificação e trabalho de conhecimento:
- Linha de codificação: Opus é ligeiramente maior no Terminal-bench 4.1 e no FrontierCode 2.0; Neon é maior no CursorBench 4.1 e no SWE-sweep com o mesmo harness.
- Linha de trabalho de conhecimento: na maioria das subcategorias do model card, Neon é maior, e as diferenças mais evidentes estão no GraphWalks e no AutomationBench.
- Os quatro números do Artificial Analysis: pontuação de inteligência 61 contra 59, custo por tarefa 6.44 contra 10.04 dólares, tempo 21.5 contra 24.5 minutos, velocidade de saída 110 contra 118 token/s, com níveis Neon xhigh contra Opus max.
A recomendação é primeiro criar uma linha de base do Opus com suas próprias amostras de tarefas e, depois que o Neon estiver disponível, fazer a comparação no mesmo nível de configuração. Você pode conferir os preços de tabela e os grupos de claude-opus-5-5 e claude-opus-5-5-thinking na APIYI apiyi.com, e usar a mesma chave para realizar a invocação e depois alternar entre os modelos.
📚 Referências
-
Post de lançamento de Sundar Pichai: canais de disponibilidade do Gemini 4 Neon
- Link:
x.com/sundarpichai/status/2123167780988125621 - Observação: escopo de lançamento divulgado oficialmente
- Link:
-
Blog do Google “Introducing Gemini 4 Neon”: números de benchmark, preços e segurança divulgados oficialmente
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Observação: Coding Agent Index 58.6, explicação do harness do SWE-sweep
- Link:
-
Model card do DeepMind: tabela comparativa de três colunas e notas de avaliação
- Link:
deepmind.google/models/model-cards/gemini-4-neon/ - Observação: resultados de modelos que não são Gemini vêm, por padrão, de dados autodeclarados por cada fornecedor
- Link:
-
Guia do desenvolvedor do Google Cloud: ID do modelo, níveis de raciocínio e regras de cache
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Observação: condições que acionam o HTTP 400
- Link:
-
Página de preços do Google AI Studio: preço do Neon na modalidade paga
- Link:
aistudio.google.com/docs/pricing - Observação: não há nível gratuito; apenas cache implícito é suportado
- Link:
-
Artigo do Artificial Analysis: pontuação de inteligência e custo por tarefa de codificação do Neon
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Observação: medição de terceiros, Coding Agent Index 59
- Link:
-
Página de modelo do Artificial Analysis: dados por faixa do Neon e do Opus 5.5
- Link:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/claude-opus-5-5 - Observação: lido em 2026-11-19, índice v5.0.1
- Link:
Autor: equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI. Modelos e preços podem ser consultados no centro de documentação docs.apiyi.com