Resumo: Este artigo se baseia em relatórios públicos de testes de terceiros para analisar o desempenho do Qwen4-Max-Preview em tarefas como a máquina de pegar pelúcias, a correção de um serviço Python e a busca em 1.600 tickets, além de explicar seus limites em tempo de execução e julgamento científico.
Começando pela conclusão: o veredito central sobre a capacidade de programação do Qwen4-Max-Preview
Os relatórios públicos de testes mostram que o Qwen4-Max-Preview consegue conduzir desenvolvimento em várias etapas, adicionar testes e entregar projetos reproduzíveis. A evidência mais forte veio de uma tarefa de correção de código: o modelo primeiro reproduziu o defeito, depois adicionou testes, enviou requisições HTTP reais e validou a integridade dos dados; no fim, todos os 57 testes passaram. As limitações também são claras: tarefas complexas demoram bastante — a tarefa da máquina de pegar pelúcias levou cerca de 75 minutos; em tarefas de pesquisa científica, a explicação do modelo sobre os resultados dos cálculos foi além do que as evidências sustentavam. Portanto, entregáveis complexos e conclusões científicas exigem revisão de desenvolvedores.
A seguir, começamos pela tarefa da máquina de pegar pelúcias e depois examinamos um relatório que cobre 12 tarefas, com foco em dois conjuntos de evidências verificáveis: correção de código e busca de tickets. Em seguida, usamos o caso da fatoração de matriz não negativa para ilustrar os limites de raciocínio do modelo; depois, discutimos eficiência com base na comparação entre ferramentas no mesmo desafio da máquina de pegar pelúcias; e, por fim, indicamos os tipos de tarefa que faz sentido delegar a ele. Esta é uma análise de avaliação de relatórios públicos: não executamos novamente os projetos dos autores, e todos os números vêm com fonte e condições de teste.
Para entender: 9 termos para compreender a avaliação do Qwen4-Max-Preview
| Termo | Explicação |
|---|---|
| Agent (Agente) | Modo de trabalho em que o modelo planeja as etapas por conta própria, chama ferramentas e avança na tarefa passo a passo. |
| Máquina de estados | Controlar o comportamento de um programa por meio de um conjunto de estados e regras de transição entre eles, como no “mover — descer e agarrar — levantar — contabilizar” de uma máquina de pegar bichinhos de pelúcia. |
| Teste de regressão | Revalidar funcionalidades existentes após modificar o código, confirmando que o comportamento antigo não foi quebrado. |
| Requisição HTTP | Requisição enviada pelo cliente ao servidor, usada para verificar qual resultado a interface retorna em execução real. |
| Verificação por hash | Calcular o valor de resumo do conteúdo de um arquivo; comparar antes e depois revela se os dados originais ou o arquivo de teste foram alterados. |
| Vazão de tokens | Quantidade de tokens processados ou gerados por unidade de tempo; o valor é afetado pelas ferramentas, pela rede e pelo ambiente de execução. |
| Recuperação em contexto | Localizar e associar informações-alvo dentro de uma grande quantidade de material trazida em uma única requisição. |
| Fatoração de matriz não negativa | Algoritmo que aproxima uma matriz de dados não negativa como o produto de duas matrizes de fatores não negativos. |
| Solução localmente ótima | Solução que não pode ser melhorada dentro de uma vizinhança próxima; para determinar se uma solução é localmente ótima, são necessárias condições matemáticas ou análises adicionais. |
1 Concluir uma máquina de pegar pelúcias em 75 minutos: uma tarefa de programação complexa do Qwen4-Max-Preview
1.1 O que a tarefa da máquina de pegar pelúcias avalia
Em 12 de novembro de 2026, o site 人人都是产品经理 publicou um relatório de teste prático do Qwen4-Max-Preview no Qoder. A parte mais complexa foi o sistema de interação da máquina de pegar pelúcias. Essa tarefa concentra vários desafios de programação em um único projeto: interação mecânica e feedback de força, oscilação pendular do cabo, colisões entre as pelúcias, máquina de estados do fluxo de controle e, por fim, a lógica de pontuação.
Esse tipo de tarefa dificilmente se resolve com uma única geração. Os efeitos físicos, as transições de estado e as regras de pontuação dependem uns dos outros, então o modelo precisa escrever, executar, observar e corrigir repetidamente. Por isso, a tarefa avalia a capacidade de conduzir múltiplas etapas no estilo Agent.
1.2 Tempo, velocidade e consumo registrados pelo autor
| Métrica | Registro do autor | Condições e observações do teste |
|---|---|---|
| Tempo total | cerca de 75 minutos | ambiente Qoder, tarefa única |
| Velocidade de saída | cerca de 33 tokens/s | velocidade observada nessa tarefa |
| Consumo de Credits | cerca de 65 | estimativa do autor, medição pelo Token Plan |
| Qualidade da entrega | relativamente sólida | avaliação subjetiva do autor, que considera o resultado geral comparável ao do Kimi K3.1 |
Esses números se aplicam apenas a essa tarefa. Credits é a unidade de medição da assinatura do Token Plan; o consumo real é influenciado em conjunto pela entrada, pelos acertos de cache, pela saída, pelos tokens de raciocínio e pelas chamadas de ferramentas. Os 65 Credits indicam apenas a ordem de grandeza do gasto nessa tarefa. Os 33 tokens/s também são um valor observado em um ambiente específico.
O mesmo relatório também registrou outras tarefas. Em uma tarefa de pintura a nanquim usando apenas NumPy e PIL, o modelo gerou mais de 1.000 linhas de código, desenhou cerca de 4.019 pinceladas e fez uma autoverificação com estatísticas de luminosidade dos pixels e varredura de contornos em ASCII. Ao descobrir que a andorinha se sobrepunha ao bloco escuro da abertura da janela, ajustou as coordenadas por iniciativa própria. O autor considera que a organização do código e a capacidade de autoverificação são fortes, mas que o desempenho estético ainda tem espaço para melhorar.
2 O que as doze tarefas reais do Qwen4-Max-Preview cobrem
2.1 Um relatório de teste mais abrangente
Em 16 de novembro, o site 人人都是产品经理 publicou um relatório de teste do Z Finance, no qual o autor afirma ter concluído 12 tarefas e realizado verificação por amostragem e revalidação dos resultados-chave. A tabela abaixo organiza as tarefas cobertas pelo relatório:
| Categoria | Tarefa de teste | Principal capacidade avaliada |
|---|---|---|
| Geração visual | Pelicano andando de bicicleta em SVG | Compreensão visual, geração de código |
| Análise financeira | Análise conjunta de três relatórios financeiros | Compreensão de documentos longos, critérios financeiros |
| Reconhecimento de gráficos | Gráfico de barras da receita de produtos Apple | Leitura de gráficos, estimativa numérica |
| Colaboração de escritório | Três rodadas de revisão de ata de reunião | Manutenção de contexto, consistência das revisões |
| Processamento de dados | Limpeza de 44 linhas de dados de vendas | Deduplicação, conversão de unidades, fórmulas |
| Apresentação | PPT de IPO da T-Head | Recuperação em tempo real, geração de arquivos |
| Recuperação em textos longos | 1.600 tickets de atendimento ao cliente | Correlação entre registros, filtragem por condições |
| Manutenção de código | Correção de serviço de tickets em Python | Localização de defeitos, testes e regressão |
| Reprodução científica | Algoritmo de fatoração de matriz não negativa | Implementação de algoritmo, validação numérica |
| Desenvolvimento web | Página de exibição de materiais do prospecto | HTML, entrega offline, interação |
| Sistema de simulação | Simulação de jardim de chuva | Design de interação, cálculo numérico |
| Desenvolvimento de jogos | Mini-jogo 3D com tema das quatro estações | Cenário 3D, gerenciamento de estado, interação |
2.2 Cinco casos que merecem atenção
Entre essas 12 tarefas, as cinco a seguir são as que melhor demonstram a capacidade do modelo de entregar “resultados utilizáveis”:
- Análise de relatórios financeiros: com a entrada dos relatórios anuais FY2026 da Apple e da Costco e da segunda versão do prospecto da Anthropic, a tarefa foi concluída em cerca de 8 minutos. Os 6 números-chave verificados por amostragem estavam todos corretos; o modelo distinguiu prejuízo operacional de prejuízo líquido, apontou o impacto da variação do valor justo das debêntures conversíveis sobre o prejuízo líquido e não inventou orientações futuras não divulgadas.
- Limpeza no Excel: nas 44 linhas de detalhes de vendas havia registros duplicados, dados duplicados que diferiam apenas por espaços, duas unidades de medida (yuan e dezenas de milhares de yuan), três formatos de data e 5 pedidos ausentes. Após a limpeza, restaram 35 linhas, totalizando 215.700 yuan nas quatro regiões; as 5 células de resumo usavam fórmulas reais, e a alteração dos detalhes atualizava automaticamente os valores de resumo.
- Geração de PPT: por meio de recuperação em tempo real, o modelo identificou as informações do anúncio de cisão, gerou um PPT editável e distinguiu a previsão de avaliação da precificação de emissão; após a segunda rodada de ajuste de público-alvo, os 20 números-chave, datas e nomes originais permaneceram inalterados. O autor também apontou a omissão de uma linha de produtos.
- Recuperação de tickets e correção em Python: essas duas tarefas trazem as evidências mais concretas e são detalhadas nas seções 4 e 3, respectivamente.
O ponto em comum entre essas tarefas é que os entregáveis podem ser verificados: se as fórmulas se atualizam em cadeia, se os números conferem com o texto original, se os testes passam. Esse tipo de evidência é mais convincente do que “gerar um trecho de código que parece correto”.
3 57 testes aprovados: a evidência de engenharia mais convincente do Qwen4-Max-Preview
3.1 Reconstrução completa do processo de correção
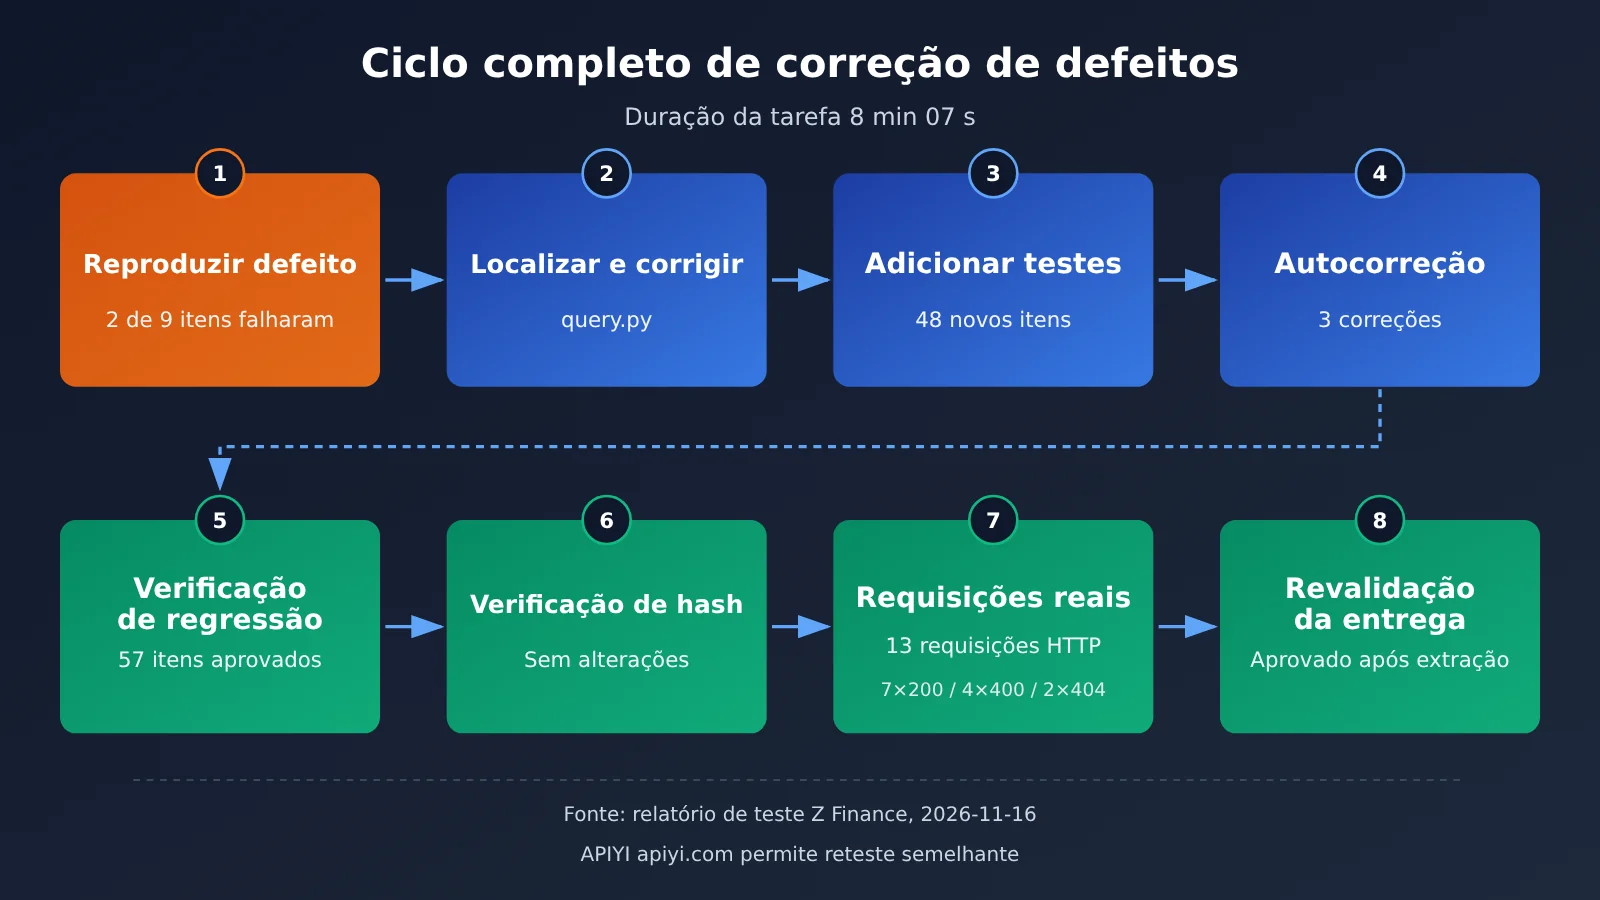
O objeto testado é um serviço de consulta de tickets escrito com a biblioteca padrão do Python, cujos defeitos envolvem filtragem combinada, ordenação, paginação e validação de parâmetros. A tarefa exigia corrigir os defeitos preservando a interface, os dados originais e os testes existentes. O relatório registra que essa tarefa levou 8 minutos e 07 segundos, com o seguinte processo:
| Etapa | Ação do modelo | Significado para a engenharia |
|---|---|---|
| Reproduzir o defeito | Primeiro executou os 9 testes originais, reproduzindo 2 falhas | Confirmar que o problema existe antes de mexer no código |
| Localizar a modificação | As principais alterações se concentraram em query.py | Escopo de mudança reduzido, menos efeitos colaterais |
| Complementar os testes | Adicionou 48 testes | Cobriu casos de borda não cobertos pelos testes originais |
| Autocorreção | Corrigiu 3 problemas nos testes que ele mesmo escreveu | Percebeu erros nos próprios testes e os corrigiu a tempo |
| Validação de regressão | No fim, os 57 testes passaram todos | 9 testes originais mais 48 testes novos |
| Verificação de integridade | Fez verificação de hash nos dados originais e nos testes existentes, sem alteração nos hashes | Prova de que não “passou” adulterando dados ou testes |
| Requisições reais | Iniciou o serviço local e enviou 13 requisições HTTP, obtendo 7 respostas 200, 4 respostas 400 e 2 respostas 404 | Verificou as respostas normais e o tratamento de erros da interface em execução |
| Revalidação da entrega | Descompactou o pacote final entregue e executou novamente, com os testes passando | Confirma que o próprio artefato entregue roda de forma independente |
3.2 Por que isso demonstra mais do que gerar código
Há dois modos de falha comuns na programação com IA: um é alterar testes ou dados para deixar os testes “verdes”, e o outro é o código passar nos testes mas falhar em execução real. A verificação de hash dessa tarefa mira o primeiro risco, enquanto as requisições HTTP reais e a revalidação do pacote entregue miram o segundo. As 4 respostas 400 e as 2 respostas 404 mostram que o modelo também validou os caminhos de erro, e tanto a validação de parâmetros quanto o tratamento de recursos inexistentes passaram por verificação real.
Esse fluxo é consistente com o hábito de engenheiros experientes ao corrigir bugs: reproduzir, corrigir, complementar testes, regredir e entregar. Isso prova que o Qwen4-Max-Preview possui um ciclo completo de manutenção em um serviço com regras claras e escala controlada. Ainda assim, é o registro de uma única tarefa e não pode ser convertido em uma taxa genérica de sucesso em correção de código.
4 O valor prático de um contexto de 4 milhões: encontrar uma pista separada por 741 linhas em 1.600 chamados
4.1 Desenho do teste e resultados
A janela de contexto anunciada oficialmente para o Qwen4-Max-Preview é de 1.000.000 de tokens. O tamanho da janela é apenas o limite superior de capacidade; o que determina o valor prático é se o modelo consegue estabelecer associações corretas em meio a uma grande quantidade de material. O teste com chamados do relatório da Z Finance responde a essa questão.
Os dados do teste são 1.600 chamados de atendimento ao cliente, com cerca de 500 mil bytes, e as pistas principais estão distribuídas em dois registros separados por 741 linhas. Foram feitas 5 perguntas no total. O relatório registra que as 5 perguntas foram todas respondidas corretamente. Os resultados específicos incluem:
- Relacionar dois chamados dispersos e encontrar o valor de reembolso de 1.386 yuans e a pessoa responsável.
- Com base na data de aprovação, determinar se a nova política de cupons de compensação se aplica a esse caso.
- Contar 62 chamados que atendem às condições especificadas, o que coincide com a contagem feita por script.
- Identificar dois grupos de números de pedido duplicados e distinguir qual grupo pertence ao fluxo normal e qual pertence a um conflito de informações do cliente.
4.2 Bytes e tokens são duas unidades
Cerca de 500 mil bytes é o tamanho do arquivo; a quantidade de tokens depende da tokenização e da proporção entre chinês e inglês, então as duas coisas precisam ser calculadas separadamente. Este teste comprova a “associação entre registros e filtragem condicional em materiais de porte médio”; sua escala é muito menor que o limite superior de 1 milhão de tokens da janela, portanto não pode ser encarado como um teste de estresse da capacidade máxima.
O valor do resultado do item 3 está no fato de ser verificável: os 62 chamados coincidem com a contagem do script, o que mostra que a contagem do modelo pode ser conferida por um programa determinístico. No uso real, também é recomendável adotar a mesma prática: verificar com um script os resultados estatísticos apresentados pelo modelo e, em seguida, usar o modelo para associação e explicação, partes que os scripts têm dificuldade de realizar.
5 Uma limitação que não pode ser ignorada: conclusões excessivas do Qwen4-Max-Preview em raciocínio científico
5.1 O cálculo está correto, mas a explicação vai além das evidências
A tarefa de reprodução científica exigia implementar, com base em um artigo especificado, o algoritmo de atualização multiplicativa para fatoração de matrizes não negativas. A matriz de entrada era 48×36, com três conjuntos diferentes de valores iniciais e 500 iterações por grupo. O relatório registra que o modelo levou 10 minutos e 06 segundos e entregou código, resultados numéricos, gráficos e logs; os três grupos de resultados forneceram 52 pontos de verificação cada, os pontos principais do grupo A coincidem com resultados de referência públicos, e há ainda 63 registros de autoverificação.
O problema está na etapa de conclusão. O modelo, apenas com base na queda contínua da função objetivo, interpretou o resultado como convergência para um ótimo local. O autor observa que isso é uma inferência excessiva.
5.2 Três conceitos que precisam ser avaliados separadamente
Este caso envolve três níveis de julgamento, e cada nível seguinte exige evidências mais fortes do que o anterior:
- Queda da função objetivo: característica de design da regra de atualização multiplicativa, que pode ser observada diretamente nos logs e gráficos.
- Convergência da iteração numérica: exige verificar se as mudanças nas grandezas iteradas tendem a se estabilizar e definir critérios de parada claros.
- Convergência para um ótimo local: exige validar condições de otimalidade, como as condições KKT; a queda do valor da função, por si só, não permite chegar a essa conclusão.
Isso mostra que a capacidade de execução e o rigor argumentativo do modelo precisam ser avaliados separadamente. Cálculos numéricos podem ser verificados por pontos de checagem, enquanto conclusões científicas precisam ser revisadas por pessoas com o contexto relevante. Em cenários de pesquisa, reprodução de artigos ou relatórios técnicos, o “trecho de conclusão” gerado pelo modelo deve ser tratado como rascunho.
6 Comparação do Qwen4-Max-Preview com outras ferramentas de programação na mesma tarefa
6.1 Dados comparativos do desafio da máquina de pelúcias
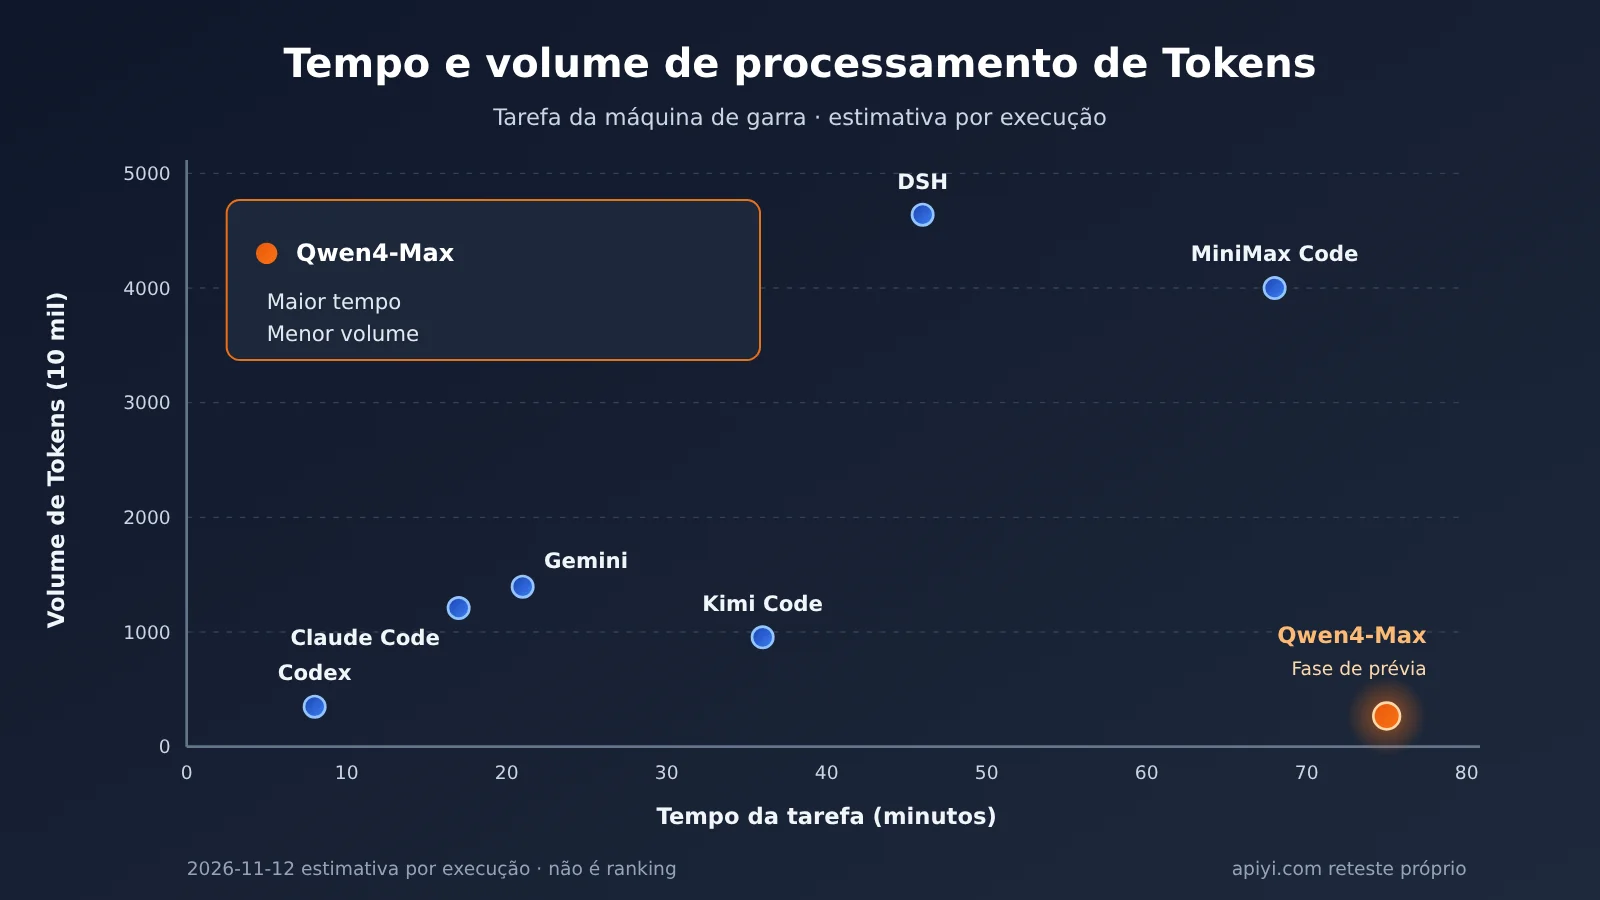
O relatório de 12 de novembro também trouxe os registros do mesmo desafio da máquina de pelúcias (claw machine) em diferentes ferramentas. A linha do Qwen na tabela original estava marcada como Qwen4-Max, com data de teste em 12 de novembro, antes do lançamento da versão oficial em 16 de novembro, correspondendo ao modelo da fase de pré-visualização.
| Ferramenta/Modelo | Tempo | Total de tokens processados (estimado) | Tokens de saída | Ponto de entrada para reteste |
|---|---|---|---|---|
| Codex | 8 minutos | 3,5 milhões | 28 mil | Ferramenta oficial correspondente |
| Claude Code | 17 minutos | 12,15 milhões | 130 mil | Ferramenta oficial; o modelo Claude pode ser chamado via APIYI apiyi.com |
| Gemini | 21 minutos | 13,94 milhões | 81 mil | Ferramenta oficial; o modelo Gemini pode ser chamado via APIYI |
| Kimi Code | 36 minutos | 9,5 milhões | 59 mil | Ferramenta oficial correspondente |
| DSH | 46 minutos | 46,44 milhões | 281 mil | Ferramenta oficial correspondente |
| MiniMax Code | 68 minutos | 40 milhões | 198 mil | Ferramenta oficial correspondente |
| Qwen4-Max (fase de pré-visualização) | 75 minutos | 2,69 milhões | 55 mil | Token Plan (Qoder) |
6.2 Como ler esse conjunto de dados
Os dados mostram um contraste bem claro: o Qwen4-Max-Preview teve o menor total de tokens processados nessa tarefa, cerca de 2,69 milhões, mas o maior tempo, cerca de 75 minutos. Combinando isso com a velocidade observada de cerca de 33 Tokens/s, dá para ver que o gargalo dessa tarefa foi a velocidade de geração — o volume de tokens consumidos em si não era grande.
Esse conjunto de dados não serve para fazer ranking, por três motivos: o total de tokens é uma estimativa do autor; a proporção de cache de contexto, as estratégias de chamada e a forma de execução de cada ferramenta são diferentes; e as versões específicas de cada modelo na tabela também não estão padronizadas. Um volume de tokens processados menor pode vir de menos leituras repetidas, ou de diferenças na estratégia de cache da camada da ferramenta — o material disponível não permite distinguir. O que ele permite concluir é: neste ambiente de ferramentas, o Qwen4-Max-Preview é adequado para tarefas que não são sensíveis ao tempo de espera e que se importam mais com a completude da entrega.
7 Para quais desenvolvedores vale a pena experimentar o Qwen4-Max-Preview
7.1 Cenários adequados e cenários que exigem cautela
Juntando os dois relatórios, o Qwen4-Max-Preview se mostra mais estável nas seguintes tarefas:
- Manutenção de código com regras bem definidas: tarefas de correção e de complementação de testes em que já existem testes prontos e os limites do problema estão claros.
- Busca e correlação em documentos longos: localização de informações entre registros em tickets, logs, contratos e relatórios financeiros, com uso de scripts para conferir os resultados estatísticos.
- Automação de escritório: limpeza de dados, Excel com fórmulas, PPT editável e múltiplas rodadas de revisão.
- Desenvolvimento de protótipos interativos: páginas web em arquivo único, sistemas simulados e protótipos de mini jogos — como a página de demonstração offline de cerca de 46KB, sem dependências externas, citada no relatório.
Três tipos de tarefa pedem cautela: desenvolvimento interativo sensível ao tempo de resposta (uma única tarefa pode durar mais de uma hora), saídas de conclusões que exigem argumentação matemática ou científica rigorosa, e mudanças em produção com requisitos de alta confiabilidade. A conclusão dos autores do relatório também inclui “em tarefas de escopo mais amplo, parte das informações acaba sendo omitida” e “ainda é necessária verificação humana do entregável final”.
Antes de usar, também é preciso ficar atento às restrições oficiais: o Preview só pode ser usado de forma interativa por meio do Alibaba Cloud Token Plan, em ferramentas como Claude Code, Cursor e Qoder; não oferece suporte a cobrança por consumo; o período de preview vai até 25 de novembro de 2026, às 24:00 (horário de Pequim), quando será descontinuado. A versão oficial do Qwen4-Max já foi lançada em 16 de novembro, e a recomendação oficial é migrar para a versão estável. Os parâmetros das duas são diferentes: no modo de raciocínio, a saída máxima da versão oficial é de 262.144 Tokens, enquanto a do Preview é de 393.216 Tokens — na migração, é preciso reconfigurar o orçamento de saída.
7.2 Faça um reteste do mesmo tipo com suas próprias tarefas
Relatórios de segunda mão, no máximo, mostram que “este modelo consegue fazer isso”. Para decidir se ele serve para a sua equipe, o caminho mais direto é fazer uma comparação usando seu próprio código e seus próprios testes reais. O exemplo abaixo envia uma tarefa de correção de código pela interface compatível com OpenAI e registra o tempo gasto e o consumo de Tokens. Use como referência o nome real do modelo que aparece na lista de modelos da plataforma.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada APIYI, compatível com OpenAI
)

resp = client.chat.completions.create(
    model="qwen4-max",  # Use o nome real conforme a lista de modelos da APIYI
    messages=[{"role": "user", "content": "阅读以下代码与失败的测试,给出最小修复补丁:..."}]
)
print(resp.choices[0].message.content)
Ver o script de reteste comparativo entre vários modelos
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Uma única Key para chamar vários modelos
)

# Substitua pelos nomes reais da lista de modelos da plataforma
MODELS = ["qwen4-max", "claude-sonnet-model-name", "gpt-model-name"]

TASK = """你将收到一个 Python 服务的源码和测试结果。
要求:1) 先说明复现到的失败原因;2) 只修改必要文件;
3) 补充覆盖边界条件的测试;4) 不得修改原始数据和已有测试。
--- 源码与测试输出 ---
{payload}
"""

def run_case(model: str, payload: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": TASK.format(payload=payload)}],
        max_tokens=32000,  # Tokens de raciocínio dos modelos de raciocínio também consomem o orçamento de saída; reserve espaço
    )
    usage = resp.usage
    return {
        "model": model,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    payload = open("bug_context.txt", encoding="utf-8").read()
    for m in MODELS:
        r = run_case(m, payload)
        print(f"{r['model']}: {r['seconds']}s, "
              f"in={r['prompt_tokens']}, out={r['completion_tokens']}")
        # Aplique o patch em um diretório isolado, rode os testes e faça a verificação de hash dos dados originais antes de pontuar
O script só coleta a solução e o consumo; a etapa de avaliação precisa seguir o que o relatório faz: aplicar o patch em um diretório isolado, rodar os testes originais e os testes novos, e confirmar por hash que os dados e os testes antigos não foram alterados. Só assim a conclusão vale para o seu código.
🚀 Início rápido: se você quer comparar vários modelos no mesmo conjunto de tarefas, pode obter cota gratuita de teste pela APIYI apiyi.com. A plataforma oferece uma interface compatível com OpenAI: com uma única chave API você alterna entre modelos populares como OpenAI, Claude e Gemini, o que facilita rodar o script de reteste dentro do mesmo fluxo de avaliação.
8 Perguntas frequentes sobre a avaliação do Qwen4-Max-Preview
Q1: Concluir a máquina de pegar bichinhos em 75 minutos significa que ele é lento?
Nessa tarefa do Qoder, o tempo gasto foi o mais longo da tabela de comparação, com velocidade de saída observada em cerca de 33 Tokens/s. Isso é apenas um registro em um único ambiente; o agendamento de ferramentas e as condições de rede também influenciam o resultado. Se o seu cenário é sensível ao tempo de espera, recomendo testar com suas próprias tarefas.
Q2: Passar em 57 testes representa a taxa de sucesso de correção de código dele?
Isso representa um processo de correção completo e verificável, e não pode ser convertido em taxa de sucesso. Para avaliar o desempenho no seu próprio projeto, você pode usar o APIYI apiyi.com para comparar vários modelos com o mesmo conjunto de amostras de defeitos, pontuando conforme os resultados dos testes e as verificações de hash.
Q3: O teste de tickets verificou a janela de contexto de 1 milhão de Tokens?
Não. Esse teste tem cerca de 500 mil bytes; a quantidade de Tokens depende da forma de tokenização e o volume é muito menor que o limite da janela. O que ele verificou foi a capacidade de correlação entre registros e de filtragem por condições.
Q4: O que fazer depois que o Preview terminar?
A versão oficial do Qwen4-Max já foi lançada, e a recomendação é usar a versão oficial. A versão oficial oferece API com cobrança por uso, e a saída máxima no modo de raciocínio é de 262.144 Tokens, portanto é preciso ajustar o orçamento de saída durante a migração. A disponibilidade e os preços em plataformas de terceiros mudam rapidamente; você pode confirmar o nome atual do modelo disponível na lista de modelos do APIYI apiyi.com antes de integrar.
Q5: Posso colocar a Key do Token Plan no backend da minha própria aplicação?
Não. As regras oficiais determinam que o Token Plan seja usado apenas de forma interativa nas ferramentas de programação e ferramentas de agentes permitidas; chamadas em lote por scripts automatizados e backends de aplicações próprias não estão dentro do escopo permitido, e violações podem resultar em suspensão da assinatura ou bloqueio da Key. Aplicações próprias devem escolher um produto de API compatível com o escopo de uso.
9 Principais conclusões da avaliação do Qwen4-Max-Preview
- Ciclo completo de entrega: a tarefa de correção de código cobriu reprodução, correção, testes complementares, verificação de hash, requisição real e revalidação da entrega, com 57 testes aprovados.
- Correlação em textos longos: em 1.600 tickets, cruzou 741 linhas de pistas relacionadas, acertou todas as 5 perguntas e 62 dados estatísticos coincidiram com o script.
- Entrega de documentos de escritório: as fórmulas do Excel podem ser encadeadas e, após várias rodadas de edição no PPT, 20 fatos-chave permaneceram inalterados.
- Limitação de velocidade: a tarefa da máquina de pegar pelúcias levou cerca de 75 minutos; o volume de tokens processados foi baixo e o tempo gasto, alto.
- Limites de raciocínio: os cálculos da reprodução científica coincidiram com os resultados de referência, mas as conclusões extrapolam as evidências e precisam de revisão humana.
- Natureza das evidências: tudo acima são testes práticos de tarefas feitos por um único autor e não constituem um ranking padronizado.
- Como começar: faça um reteste comparativo com seu próprio código e seus testes; com a APIYI apiyi.com, você pode alternar entre vários modelos em um único endpoint.
10 Conclusão: onde os desenvolvedores devem usar o Qwen4-Max-Preview
O perfil traçado pelos relatórios públicos é bastante claro. O Qwen4-Max-Preview se sai bem em trabalhos com regras claras e resultados verificáveis: manutenção de código com testes, recuperação de informações entre registros em grandes volumes de texto, processamento de dados com fórmulas e documentos de escritório editáveis, além do desenvolvimento de protótipos interativos. Nessas tarefas, ele consegue adicionar testes por conta própria, encontrar erros sozinho e entregar resultados que podem ser verificados novamente.
Suas limitações também são concretas: tarefas complexas demoram mais e são mais adequadas para execução em segundo plano; conclusões científicas tendem a ir além das evidências e precisam de revisão especializada; a versão Preview só pode ser usada de forma interativa por meio do Token Plan, em ferramentas específicas, e será descontinuada em 25 de novembro — para uso a longo prazo, deve-se migrar para a versão oficial.
A abordagem mais pragmática é tratá-lo como um assistente de engenharia capaz de concluir sozinho o ciclo de manutenção, deixando para o desenvolvedor a responsabilidade de validar as conclusões e fazer o merge final. Antes de colocá-lo em produção, vale a pena fazer uma comparação entre vários modelos usando suas próprias tarefas reais; com a interface unificada da APIYI apiyi.com, dá para testar e comparar no mesmo fluxo.
📚 Materiais de referência
-
人人都是产品经理: a versão preview do Qwen4-Max chegou! Testes práticos e impressões: teste prático da máquina de garra do Qoder e comparação entre ferramentas, 2026-11-12
- Link:
woshipm.com/ai/6492544.html - Descrição: fonte dos 75 minutos de duração, 33 Tokens/s, 65 Credits e da tabela comparativa
- Link:
-
人人都是产品经理: teste prático do Qwen4-Max-Preview (relatório de testes da Z Finance): teste abrangente com 12 tarefas, 2026-11-16
- Link:
woshipm.com/evaluating/6494229.html - Descrição: fonte dos dados de correção de código, recuperação de tickets, reprodução de pesquisa científica e tarefas de escritório
- Link:
-
Alibaba Cloud Model Studio: documentação do Qwen4-Max-Preview: especificações oficiais e instruções de uso
- Link:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Descrição: janela de contexto, saída máxima, período de preview e forma de acesso
- Link:
-
Alibaba Cloud Model Studio: documentação do Qwen4-Max: parâmetros e cobrança da versão oficial
- Link:
help.aliyun.com/zh/model-studio/qwen4-max - Descrição: orçamento de saída da versão oficial e informações sobre pagamento por uso
- Link:
-
Alibaba Cloud: permissões e normas de uso do Token Plan: limitações do escopo de uso
- Link:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Descrição: requisitos de uso interativo e cenários proibidos
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI apiyi.com; há mais materiais de integração disponíveis no centro de documentação docs.apiyi.com