Resumen: Este artículo, basado en informes públicos de pruebas de terceros, analiza el desempeño de Qwen4-Max-Preview al completar tareas como operar una máquina de peluches, reparar un servicio Python y buscar entre 1,600 tickets, y explica sus límites en cuanto a tiempo de ejecución y juicio científico.
Conclusión anticipada: juicio central sobre la capacidad de programación de Qwen4-Max-Preview
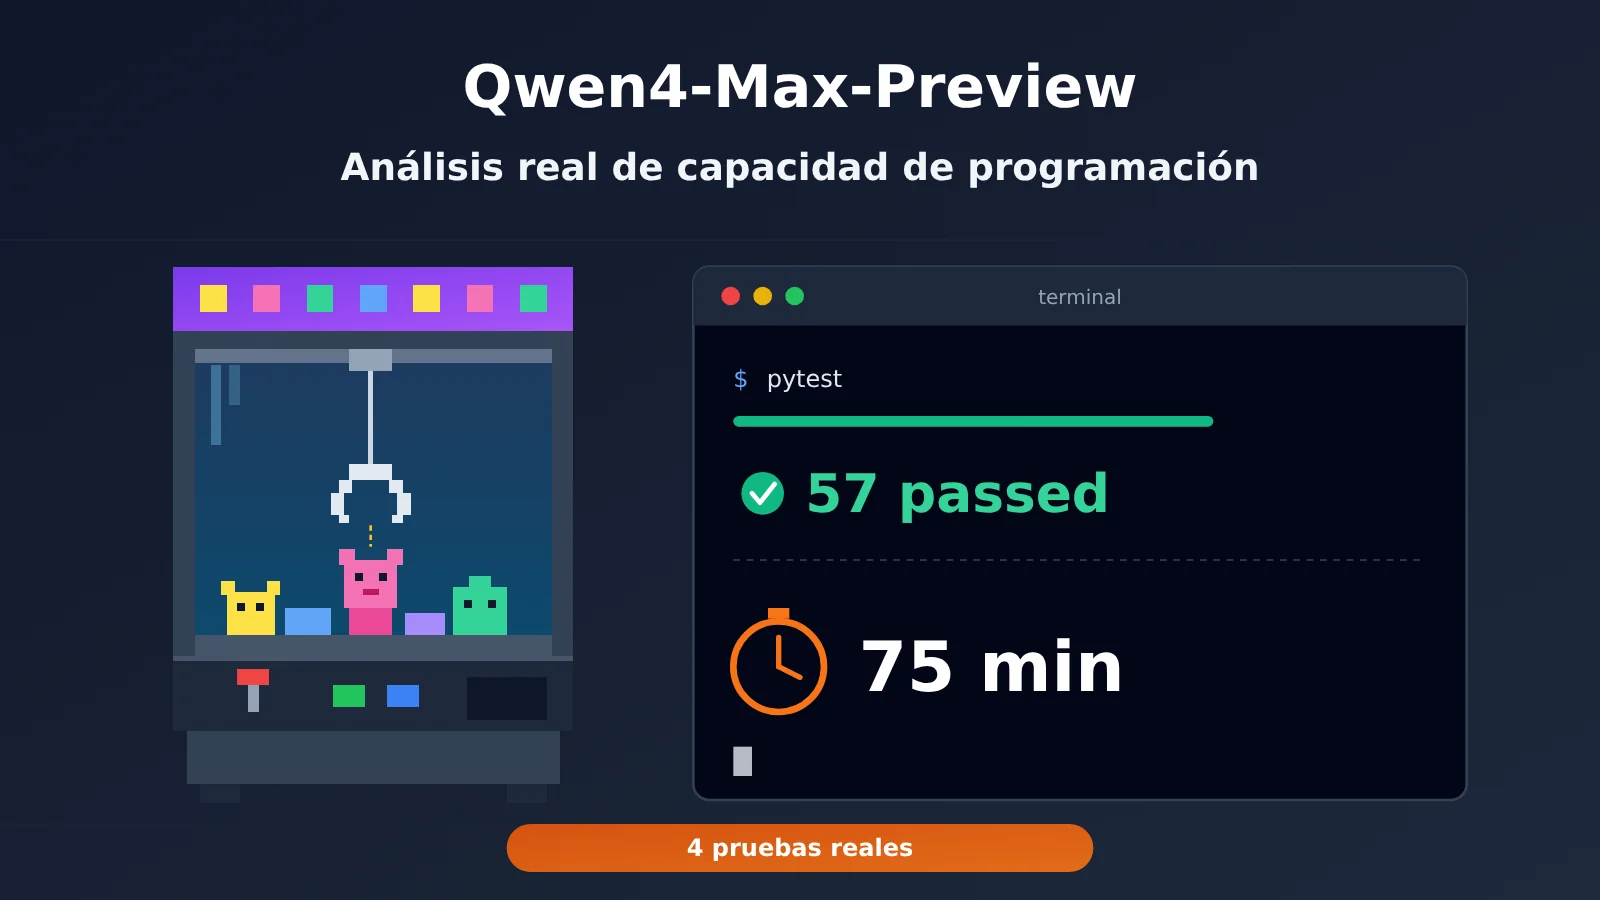
Los informes públicos de pruebas muestran que Qwen4-Max-Preview puede impulsar el desarrollo en varios pasos, complementar pruebas y entregar proyectos verificables. La evidencia más sólida proviene de una tarea de reparación de código: el modelo primero reproduce el fallo, luego añade pruebas, envía solicitudes HTTP reales y valida la integridad de los datos; al final, las 57 pruebas pasan en su totalidad. Sus puntos débiles también son claros: las tareas complejas consumen bastante tiempo; la tarea de la máquina de peluches tomó alrededor de 75 minutos; y, en tareas de investigación científica, la explicación del modelo sobre los resultados de cálculo va más allá de lo que respalda la evidencia. Por lo tanto, tanto los entregables complejos como las conclusiones científicas necesitan revisión por parte del desarrollador.
A continuación, comenzamos con la tarea de la máquina de peluches, luego revisamos un informe que abarca 12 tareas y nos centramos en dos grupos de evidencia verificable: la reparación de código y la búsqueda de tickets. Después, usamos un caso de factorización matricial no negativa para mostrar los límites de razonamiento del modelo; luego, con una comparación entre herramientas para el mismo desafío de la máquina de peluches, analizamos la cuestión de la eficiencia; y, por último, presentamos qué tipos de tareas conviene delegarle. Este artículo es un análisis de evaluación de informes públicos; no hemos vuelto a ejecutar el proyecto del autor, y todas las cifras indican su fuente y las condiciones de prueba.
Lo que debes saber: 9 términos para entender la evaluación de Qwen4-Max-Preview
| Término | Explicación |
|---|---|
| Agente | Forma de trabajo en la que el modelo planifica sus propios pasos, invoca herramientas y hace avanzar la tarea poco a poco. |
| Máquina de estados | Controla el comportamiento de un programa mediante un conjunto de estados y reglas de transición entre ellos; por ejemplo, el ciclo «mover—agarrar—subir—liquidar» de una máquina de garra. |
| Pruebas de regresión | Volver a validar las funciones existentes después de modificar el código para confirmar que el comportamiento anterior no se ha roto. |
| Solicitud HTTP | Petición que el cliente envía al servidor para comprobar qué resultado devuelve la interfaz en un entorno real de ejecución. |
| Verificación de hash | Calcular el valor hash del contenido de un archivo y compararlo antes y después permite saber si los datos originales o el archivo de prueba se modificaron. |
| Rendimiento de tokens | Cantidad de tokens procesados o generados por unidad de tiempo; el valor depende de las herramientas, la red y el entorno de ejecución. |
| Recuperación de contexto | Localizar y relacionar la información objetivo dentro de una gran cantidad de material incluido en una sola solicitud. |
| Factorización de matrices no negativas | Algoritmo que aproxima una matriz de datos no negativa descomponiéndola en el producto de dos matrices de factores no negativas. |
| Óptimo local | Solución que no se puede mejorar dentro de su vecindario; para decidir si es un óptimo local se necesitan condiciones matemáticas adicionales o análisis. |
1 75 minutos para completar una máquina de garra: una compleja tarea de programación de Qwen4-Max-Preview
1.1 Qué evalúa la tarea de la máquina de garra
El 12 de noviembre de 2026, el medio 人人都是产品经理 publicó un informe de pruebas reales de Qwen4-Max-Preview basado en Qoder, y una de las tareas más complejas fue el sistema interactivo de una máquina de garra. Esta tarea concentra en un solo proyecto varios desafíos de programación: interacción mecánica y retroalimentación de fuerza, balanceo y colgado de la cuerda, colisiones entre peluches, la máquina de estados del flujo de control y, por último, la lógica de puntuación.
Este tipo de tarea es difícil de completar con una sola generación. Los efectos físicos, los cambios de estado y las reglas de puntuación dependen unos de otros, y el modelo necesita escribir, ejecutar, observar y corregir repetidamente. Por eso, lo que se evalúa aquí es la capacidad de avance multipaso al estilo de un Agent.
1.2 Tiempo, velocidad y consumo registrados por el autor
| Métrica | Registro del autor | Condiciones de prueba y notas |
|---|---|---|
| Tiempo total | Unos 75 minutos | Entorno Qoder, tarea única |
| Velocidad de salida | Unos 33 Tokens/s | Velocidad observada en esa tarea |
| Consumo de Credits | Unos 65 | Estimación del autor, medición de Token Plan |
| Calidad de entrega | Bastante sólida | Evaluación subjetiva del autor, que considera que en conjunto puede empatar con Kimi K3.1 |
Estas cifras corresponden solo a esa tarea. Credits es la unidad de medida de suscripción de Token Plan, y el consumo real está influenciado por la entrada, los aciertos de caché, la salida, los tokens de pensamiento y las llamadas a herramientas. Por tanto, 65 Credits solo indican el orden de magnitud del gasto en esta tarea. 33 Tokens/s también es un valor observado en un entorno específico.
El mismo informe también registró otras tareas. En la tarea de pintura a tinta china en la que solo se usaron NumPy y PIL, el modelo generó más de 1,000 líneas de código, dibujó alrededor de 4,019 pinceladas y se autoverificó mediante estadísticas de luminosidad de píxeles y escaneo de contornos ASCII. Tras descubrir que la golondrina se superponía con el bloque negro de la abertura de la ventana, ajustó las coordenadas por iniciativa propia. El autor considera que su capacidad de organización del código y de autoverificación es bastante fuerte, aunque su desempeño estético aún tiene margen de mejora.
2. ¿Qué cubren las doce tareas reales de Qwen4-Max-Preview?
2.1 Un informe de pruebas más completo
El 16 de noviembre, el medio chino 人人都是产品经理 publicó un informe de pruebas de Z Finance. Según su autor, se completaron 12 tareas y se realizaron comprobaciones por muestreo y nuevas verificaciones de los resultados clave. La tabla siguiente organiza las tareas que cubre el informe:
| Categoría | Tarea de prueba | Capacidad evaluada principalmente |
|---|---|---|
| Generación visual | SVG de un pelícano en bicicleta | Comprensión visual, generación de código |
| Análisis financiero | Análisis conjunto de tres informes financieros | Comprensión de documentos extensos, criterios financieros |
| Reconocimiento de gráficos | Gráfico de barras de ingresos por producto de Apple | Lectura de gráficos, estimación de valores |
| Colaboración de oficina | Tres rondas de revisión de actas de reunión | Mantenimiento del contexto, coherencia de las modificaciones |
| Procesamiento de datos | Limpieza de 44 filas de datos de ventas | Eliminación de duplicados, conversión de unidades, fórmulas |
| Presentaciones | PPT de la salida a bolsa de Pingtouge | Búsqueda en tiempo real, generación de archivos |
| Búsqueda en textos largos | 1.600 tickets de atención al cliente | Correlación entre registros, filtrado por condiciones |
| Mantenimiento de código | Reparación de un servicio de tickets en Python | Localización de defectos, pruebas y regresión |
| Reproducción científica | Algoritmo de factorización matricial no negativa | Implementación de algoritmos, validación numérica |
| Desarrollo web | Página de presentación de materiales del prospecto de OPI | HTML, entrega sin conexión, interacción |
| Sistemas de simulación | Simulación de un jardín pluvial | Diseño de interacción, cálculo numérico |
| Desarrollo de videojuegos | Minijuego 3D con temática de las cuatro estaciones | Escenas 3D, gestión de estado, interacción |
2.2 Cinco casos que vale la pena destacar
De estas 12 tareas, las cinco siguientes son las que mejor muestran la capacidad del modelo para entregar «resultados utilizables»:
- Análisis financiero: se partió de los informes anuales de Apple y Costco correspondientes a FY2026 y de la segunda versión del prospecto de OPI de Anthropic; la tarea se completó en unos 8 minutos. Las 6 cifras clave comprobadas por muestreo eran correctas en todos los casos. El modelo distinguió entre pérdida operativa y pérdida neta, señaló el efecto de la variación del valor razonable de los bonos convertibles sobre la pérdida neta y no inventó por su cuenta previsiones futuras que no se habían divulgado.
- Limpieza en Excel: entre las 44 filas de detalles de ventas se habían colado registros duplicados, duplicados que solo diferían por espacios, dos unidades (yuanes y decenas de miles de yuanes), tres formatos de fecha y 5 pedidos faltantes. Tras la limpieza quedaron 35 filas; las cuatro áreas sumaban 215.700 yuanes, las 5 celdas de resumen usaban fórmulas reales y los totales se actualizaban automáticamente al modificar los detalles.
- Generación de PPT: mediante búsqueda en tiempo real, el modelo identificó la información del anuncio de escisión, generó un PPT editable y distinguió entre las previsiones de valoración y el precio de emisión. Tras ajustar el público objetivo en la segunda ronda, los 20 números, fechas y nombres clave originales se mantuvieron sin cambios. El autor también señaló que faltaba una línea de productos.
- Búsqueda de tickets y reparación en Python: estas dos son las evidencias más concretas y se desarrollan en las secciones 4 y 3, respectivamente.
El punto en común de estas tareas es que los entregables se pueden comprobar: si las fórmulas están vinculadas y se actualizan, si los números coinciden con el texto original y si las pruebas pasan. Este tipo de evidencia resulta más convincente que «haber generado un fragmento de código que parece correcto».
3 57 pruebas superadas: la evidencia de ingeniería más convincente de Qwen4-Max-Preview
3.1 Reconstrucción completa del proceso de corrección
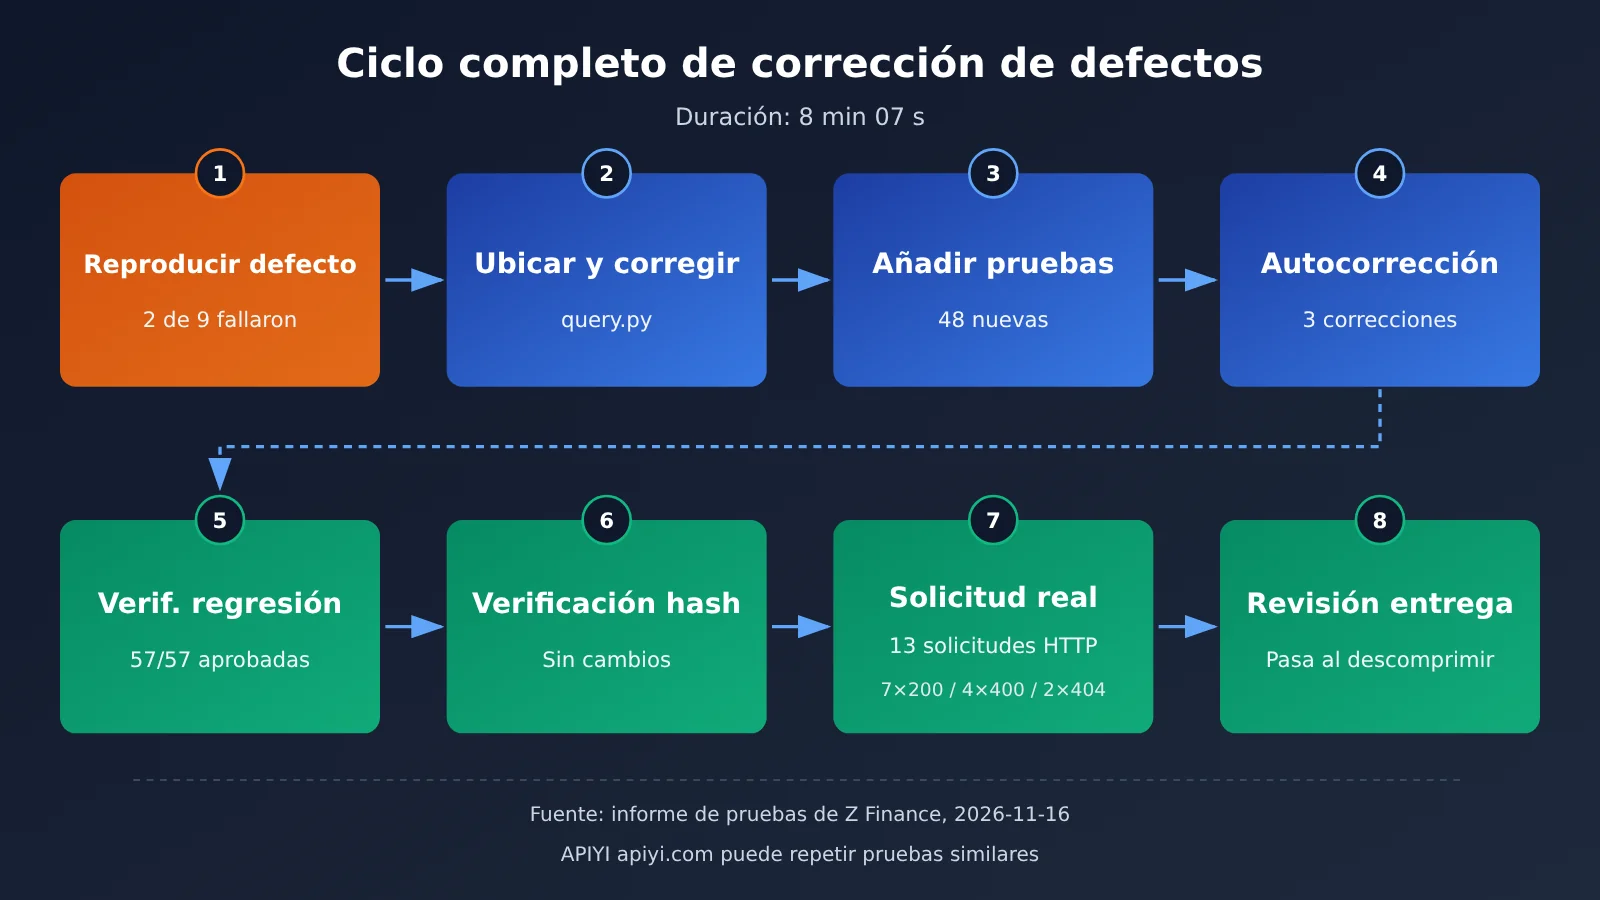
El objeto de prueba es un servicio de consulta de tickets escrito con la biblioteca estándar de Python, cuyos defectos involucran filtrado combinado, ordenación, paginación y validación de parámetros. La tarea requería corregir los defectos preservando al mismo tiempo la interfaz, los datos originales y las pruebas existentes. El informe registra que esta tarea tomó 8 minutos y 07 segundos, con el siguiente proceso:
| Paso | Acción del modelo | Significado ingenieril |
|---|---|---|
| Reproducir el defecto | Ejecutar primero las 9 pruebas originales, reproduciendo 2 de los fallos | Confirmar primero que el problema existe, luego ponerse a modificar |
| Localizar la modificación | La modificación principal se concentra en query.py | Alcance de cambio acotado, reduce efectos secundarios |
| Añadir pruebas | Se añadieron 48 pruebas nuevas | Cubre casos límite que las pruebas originales no cubrían |
| Autocorrección | Corregir 3 problemas en las pruebas escritas por el propio modelo | Detectar que la prueba misma estaba mal escrita y corregirla a tiempo |
| Verificación de regresión | Al final, las 57 pruebas superan todas | 9 pruebas originales más 48 pruebas nuevas |
| Comprobación de integridad | Verificación de hash sobre los datos originales y las pruebas originales, sin cambios en el hash | Demuestra que no se «aprobó» manipulando datos o pruebas |
| Solicitudes reales | Iniciar el servicio local y enviar 13 solicitudes HTTP, obteniendo 7 × 200, 4 × 400 y 2 × 404 | Verifica la respuesta normal y el manejo de errores de la interfaz en tiempo de ejecución |
| Re-verificación de la entrega | Descomprimir el paquete de entrega final y ejecutarlo de nuevo, las pruebas pasan | Confirma que el propio entregable puede ejecutarse de forma independiente |
3.2 Por qué esto dice más que generar código
En la programación con IA hay dos formas comunes de fallar: una es modificar las pruebas o los datos para hacer que las pruebas «se pongan verdes»; otra es que el código pase en las pruebas pero falle en tiempo de ejecución real. La verificación de hash de esta tarea aborda el primer riesgo, mientras que las solicitudes HTTP reales y la re-verificación del paquete de entrega abordan el segundo. Las 4 respuestas 400 y las 2 respuestas 404 muestran que el modelo también validó las rutas de error: la validación de parámetros y el tratamiento de recursos inexistentes se comprobaron en la práctica.
Este proceso coincide con los hábitos de un ingeniero experimentado al corregir un bug: reproducir, corregir, complementar pruebas, regresión y entrega. Demuestra que Qwen4-Max-Preview posee un ciclo completo de mantenimiento en un servicio con reglas claras y escala controlable. Aun así, sigue siendo el registro de una sola tarea y no puede convertirse en una tasa de éxito genérica de corrección de código.
4. El valor real de una ventana de contexto de 4 millones: encontrar una pista separada por 741 líneas entre 1.600 tickets
4.1 Diseño de la prueba y resultados
La ventana de contexto oficial de Qwen4-Max-Preview es de 1.000.000 tokens. El tamaño de la ventana solo marca el límite de capacidad; lo que determina su utilidad real es si el modelo puede establecer asociaciones correctas dentro de mucho material. La prueba de tickets del informe de Z Finance responde a esa pregunta.
Los datos de la prueba eran 1.600 tickets de atención al cliente, con un volumen de unos 500.000 bytes. Las pistas clave estaban repartidas entre dos registros separados por 741 líneas, y se plantearon 5 preguntas. El informe registra que las 5 preguntas se respondieron correctamente. En concreto:
- Relacionó dos tickets dispersos y localizó el importe del reembolso de 1.386 yuanes y la persona que lo tramitó.
- A partir de la fecha de aprobación, determinó si la nueva política de cupones de compensación aplicaba a ese caso.
- Contó 62 tickets que cumplían las condiciones indicadas, coincidiendo con el resultado del script.
- Encontró dos grupos de números de pedido duplicados y distinguió cuál correspondía a un flujo normal y cuál a un conflicto en la información del cliente.
4.2 Bytes y tokens son dos unidades distintas
Esos aproximadamente 500.000 bytes son el tamaño del archivo; la cantidad de tokens depende de la tokenización y de la proporción entre chino e inglés, así que conviene calcular ambos valores por separado. Esta prueba demuestra la «asociación entre registros y el filtrado por condiciones en material de tamaño medio»; su escala está muy por debajo del límite de 1 millón de tokens de la ventana, por lo que no debe tomarse como una prueba de estrés de capacidad máxima.
El valor del tercer resultado está en que se puede verificar: 62 tickets coinciden con el recuento del script, lo que indica que el recuento del modelo puede revisarse con un programa determinista. En uso real, también conviene adoptar la misma práctica: verificar con un script los resultados estadísticos que da el modelo y reservar el modelo para la asociación y la explicación, esas partes que a un script le resultan difíciles.
5 Una limitación que no conviene pasar por alto: las conclusiones excesivas de Qwen4-Max-Preview en el razonamiento científico
5.1 El cálculo es correcto, pero la explicación va más allá de la evidencia
La tarea de reproducción científica pedía implementar, a partir de un artículo indicado, el algoritmo de actualización multiplicativa para la factorización matricial no negativa. La matriz de entrada era de 48×36, se usaron tres conjuntos de valores iniciales distintos y cada uno se iteró 500 veces. El informe registra que el modelo tardó 10 min 06 s y entregó código, resultados numéricos, gráficos y registros; cada uno de los tres conjuntos de resultados incluía 52 puntos de control, los puntos de control clave del grupo A coincidían con los resultados de referencia públicos, y además había 63 registros de autoverificación.
El problema aparece en el apartado de las conclusiones. El modelo, apoyándose únicamente en que la función objetivo seguía disminuyendo, interpretó el resultado como una convergencia a un óptimo local. El autor señala que se trata de una inferencia excesiva.
5.2 Tres conceptos que deben evaluarse por separado
Este caso implica tres niveles de juicio, y cada uno exige evidencia más sólida que el anterior:
- Descenso de la función objetivo: es una característica de diseño de la regla de actualización multiplicativa, y se puede observar directamente en los registros y en los gráficos.
- Convergencia numérica de la iteración: hay que comprobar si la variación de las cantidades iteradas tiende a estabilizarse y fijar un criterio de parada claro.
- Convergencia a un óptimo local: hay que verificar las condiciones de optimalidad, por ejemplo las condiciones KKT; observar solo el descenso del valor de la función no basta para concluirlo.
Esto muestra que la capacidad de ejecución del modelo y el rigor de su argumentación deben evaluarse por separado. Los cálculos numéricos se pueden verificar con puntos de control, mientras que las conclusiones científicas requieren la revisión de alguien con los conocimientos adecuados. En contextos de investigación, reproducción de artículos o informes técnicos, el «párrafo de conclusiones» que genera el modelo debería tratarse como un borrador.
6 Comparación de Qwen4-Max-Preview con otras herramientas de programación en la misma tarea
6.1 Datos comparativos del desafío de la máquina de peluches
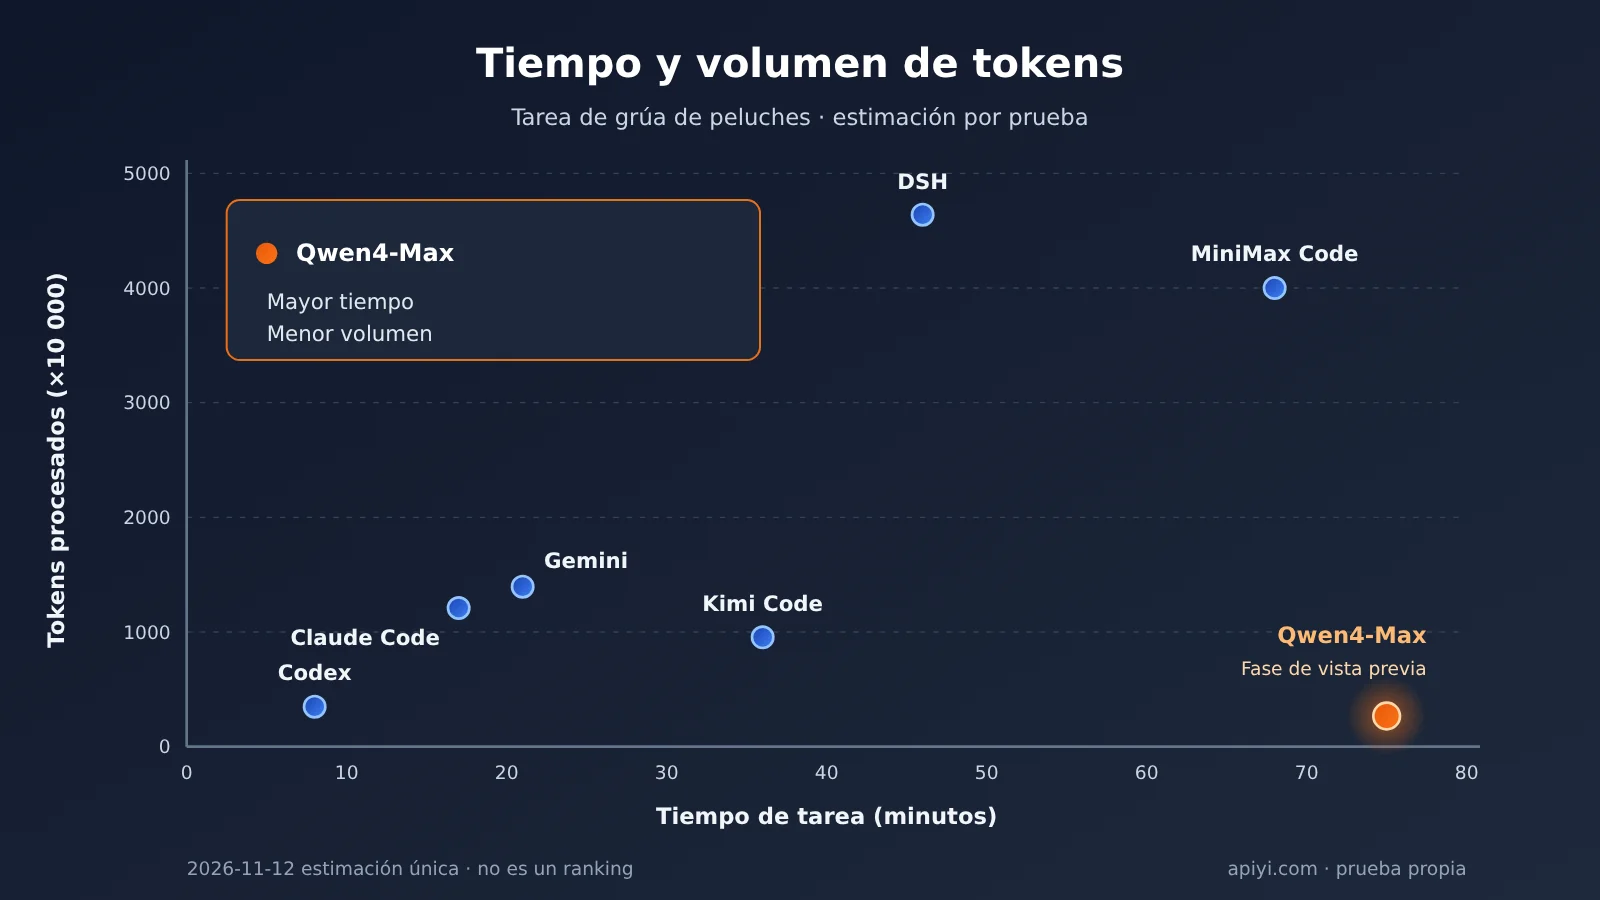
El informe del 12 de noviembre también recoge el registro del mismo desafío de la máquina de peluches en distintas herramientas. En la tabla original, la fila de Qwen aparece etiquetada como Qwen4-Max, con una fecha de prueba del 12 de noviembre, anterior al lanzamiento de la versión oficial el 16 de noviembre, así que corresponde al modelo en fase de preview.
| Herramienta/Modelo | Tiempo | Volumen total de tokens procesados (estimado) | Tokens de salida | Entrada para repetir la prueba |
|---|---|---|---|---|
| Codex | 8 minutos | 3,5 millones | 28 mil | Herramienta oficial correspondiente |
| Claude Code | 17 minutos | 12,15 millones | 130 mil | Herramienta oficial; el modelo Claude puede invocarse a través de APIYI apiyi.com |
| Gemini | 21 minutos | 13,94 millones | 81 mil | Herramienta oficial; el modelo Gemini puede invocarse a través de APIYI |
| Kimi Code | 36 minutos | 9,5 millones | 59 mil | Herramienta oficial correspondiente |
| DSH | 46 minutos | 46,44 millones | 281 mil | Herramienta oficial correspondiente |
| MiniMax Code | 68 minutos | 40 millones | 198 mil | Herramienta oficial correspondiente |
| Qwen4-Max (fase de preview) | 75 minutos | 2,69 millones | 55 mil | Token Plan (Qoder) |
6.2 Cómo leer estos datos
Los datos muestran un contraste bastante claro: Qwen4-Max-Preview registró en esta tarea el menor volumen total de tokens procesados, unos 2,69 millones, y a la vez el mayor tiempo, unos 75 minutos. Si se cruza esto con la velocidad observada de unos 33 tokens/s, se ve que el cuello de botella de esa ejecución estuvo en la velocidad de generación: el volumen de tokens consumido en sí no era grande.
Estos datos no sirven para establecer un ranking, por tres razones: el total de tokens es una estimación del autor; la proporción de contexto en caché, las estrategias de invocación y la forma de ejecución difieren entre herramientas; y las versiones concretas de cada modelo en la tabla tampoco están especificadas de manera uniforme. Un volumen de tokens bajo puede deberse a menos lecturas repetidas, pero también a diferencias en las políticas de caché de la capa de herramientas, y con el material disponible no es posible distinguir entre ambas causas. Lo que sí permite afirmar es esto: en este entorno de herramientas, Qwen4-Max-Preview encaja en tareas donde el tiempo de espera no es crítico y lo que importa más es que la entrega esté completa.
7 Qué desarrolladores deberían probar Qwen4-Max-Preview
7.1 Escenarios adecuados y de uso con precaución
Combinando ambos informes, Qwen4-Max-Preview se mantiene bastante estable en las siguientes tareas:
- Mantenimiento de código con reglas claras: tareas de corrección y pruebas complementarias con pruebas ya existentes y límites del problema bien definidos.
- Búsqueda y asociación en documentos largos: búsquedas entre registros en tickets, logs, contratos e informes financieros, con scripts para verificar los resultados estadísticos.
- Automatización de oficina: limpieza de datos, Excel con fórmulas, PPT editables y modificaciones de múltiples rondas.
- Desarrollo de prototipos interactivos: páginas web de un solo archivo, sistemas de simulación y prototipos de minijuegos; por ejemplo, la página de demostración offline de unos 46KB y sin dependencias externas que aparece en el informe.
Hay que tener precaución con tres tipos de tareas: el desarrollo interactivo sensible al tiempo de respuesta (una sola tarea puede durar más de una hora), la generación de conclusiones que requieren una argumentación matemática o científica rigurosa, y los cambios en producción con altos requisitos de fiabilidad. El resumen de los autores del informe también incluye que «en tareas de alcance amplio se omite parte de la información» y que «todavía se requiere verificación humana de los entregables finales».
Antes de usarlo, también hay que tener en cuenta las limitaciones oficiales: Preview solo se puede usar de forma interactiva a través del Token Plan de Alibaba Cloud en herramientas como Claude Code, Cursor, Qoder, etc.; no admite pago por uso, y dejará de estar disponible tras el período de vista previa que finaliza el 25 de noviembre de 2026 a las 24:00 (hora de Pekín). La versión oficial Qwen4-Max ya está disponible desde el 16 de noviembre, y la recomendación oficial es migrar a la versión oficial. Los parámetros de ambas versiones son distintos: la salida máxima del modo de pensamiento de la versión oficial es de 262,144 Tokens, mientras que la de Preview es de 393,216 Tokens; al migrar hay que reconfigurar el presupuesto de salida.
7.2 Haz tu propia réplica comparativa con tus tareas
Un informe de segunda mano, como mucho, demuestra que «este modelo puede hacerlo». Para decidir si encaja con tu equipo, lo más directo es hacer una comparación con tu propio código y tus propias pruebas. El ejemplo siguiente envía una tarea de corrección de código a través de la interfaz compatible con OpenAI y registra el tiempo y el consumo de tokens. Usa como nombre del modelo el nombre real que aparece en la lista de modelos de la plataforma.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI, compatible con OpenAI
)

resp = client.chat.completions.create(
    model="qwen4-max",  # Use el nombre real según la lista de modelos de APIYI
    messages=[{"role": "user", "content": "阅读以下代码与失败的测试,给出最小修复补丁:..."}]
)
print(resp.choices[0].message.content)
Ver el script de réplica comparativa con varios modelos
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Una sola clave para invocar varios modelos
)

# Reemplace con los nombres reales de la lista de modelos de la plataforma
MODELS = ["qwen4-max", "claude-sonnet-model-name", "gpt-model-name"]

TASK = """你将收到一个 Python 服务的源码和测试结果。
要求:1) 先说明复现到的失败原因;2) 只修改必要文件;
3) 补充覆盖边界条件的测试;4) 不得修改原始数据和已有测试。
--- 源码与测试输出 ---
{payload}
"""

def run_case(model: str, payload: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": TASK.format(payload=payload)}],
        max_tokens=32000,  # Los tokens de razonamiento del modelo de razonamiento también consumen el presupuesto de salida; hay que reservar espacio
    )
    usage = resp.usage
    return {
        "model": model,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    payload = open("bug_context.txt", encoding="utf-8").read()
    for m in MODELS:
        r = run_case(m, payload)
        print(f"{r['model']}: {r['seconds']}s, "
              f"in={r['prompt_tokens']}, out={r['completion_tokens']}")
        # Aplicar el parche en un directorio aislado, ejecutar las pruebas y validar por hash los datos originales antes de puntuar
El script solo se encarga de recoger las propuestas y el consumo; la parte de puntuación debe copiar lo que hace el informe: aplicar el parche en un directorio aislado, ejecutar las pruebas originales y las nuevas, y comprobar con hashes que los datos y las pruebas antiguas no se han modificado. Solo así las conclusiones serán válidas para tu repositorio.
🚀 Inicio rápido: Si quieres comparar varios modelos sobre un mismo conjunto de tareas, puedes obtener cuota de prueba gratuita en APIYI apiyi.com. La plataforma ofrece una interfaz compatible con OpenAI: con una sola clave API puedes cambiar entre OpenAI, Claude, Gemini y otros modelos principales, lo que facilita ejecutar el script de réplica dentro de un mismo flujo de evaluación.
8 Preguntas frecuentes sobre la evaluación de Qwen4-Max-Preview
P1: ¿Completar la máquina de garra (claw machine) en 75 minutos indica que es lento?
En esa tarea de Qoder, su tiempo fue el más largo de la tabla comparativa, con una velocidad de salida observada de aproximadamente 33 tokens/s. Esto es solo un registro en un único entorno; la programación de herramientas y las condiciones de red pueden afectar el resultado. Si tu escenario es sensible al tiempo de espera, se recomienda probarlo con tus propias tareas.
P2: ¿Que pasen 57 pruebas puede representar su tasa de éxito en la corrección de código?
Representa un proceso de corrección completo y verificable, pero no se puede convertir en una tasa de éxito. Para evaluar su rendimiento en tu propio proyecto, puedes usar APIYI apiyi.com para comparar varios modelos con el mismo conjunto de muestras de defectos y puntuar según las pruebas superadas y los resultados de verificación de hash.
P3: ¿La prueba de tickets verificó el contexto de 1 millón de tokens?
No. La prueba ocupa aproximadamente 500.000 bytes; el número de tokens depende de cómo se tokenice y su escala es mucho menor que el límite de la ventana. Lo que se verificó fue la capacidad de correlación entre registros y de filtrado condicional.
P4: ¿Qué hacer después de que termine la Preview?
El sitio oficial ya ha puesto en línea la versión estable Qwen4-Max y recomienda usarla. La versión estable admite la API de pago por uso, y la salida máxima en modo de pensamiento es de 262,144 tokens; al migrar, hay que ajustar el presupuesto de salida. La disponibilidad y los precios en plataformas de terceros cambian con rapidez, así que puedes confirmar en la lista de modelos de APIYI apiyi.com los nombres de modelos disponibles actualmente antes de integrarte.
P5: ¿Se puede poner la clave (Key) de Token Plan en el backend de tu propia aplicación?
No. Las normas oficiales establecen que Token Plan solo está permitido para uso interactivo dentro de las herramientas de programación y de agentes autorizadas; las llamadas masivas mediante scripts automatizados y los backends de aplicaciones propias no están dentro del ámbito permitido, y una infracción puede provocar la suspensión de la suscripción o el bloqueo de la clave. Las aplicaciones propias deben elegir productos de API que cumplan con el ámbito de uso.
9 Conclusiones clave de la evaluación de Qwen4-Max-Preview
- Ciclo cerrado de entrega: la tarea de corrección de código cubrió reproducción, corrección, pruebas adicionales, verificación de hash, solicitud real y reverificación de la entrega; pasaron 57 pruebas.
- Correlación en textos largos: entre 1,600 tickets, se enlazaron pistas a lo largo de 741 líneas; las 5 preguntas se respondieron correctamente y 62 estadísticas coincidieron con el script.
- Entrega de oficina: las fórmulas de Excel se pueden vincular; tras varias rondas de modificación del PPT, los 20 hechos clave se mantuvieron sin cambios.
- Punto débil en velocidad: la tarea de la máquina de peluches tomó unos 75 minutos; el volumen de procesamiento de tokens fue bajo y el tiempo de ejecución, largo.
- Límites del razonamiento: los cálculos de la reproducción científica coincidieron con los resultados de referencia, pero las conclusiones presentan inferencias excesivas y requieren revisión humana.
- Naturaleza de la evidencia: todo lo anterior son pruebas de tareas realizadas por un solo autor y no constituyen una clasificación estandarizada.
- Cómo empezar: repita las pruebas comparativas con su propio código y sus propias pruebas; con APIYI apiyi.com puede cambiar entre varios modelos dentro de una misma interfaz.
10 Resumen: dónde deberían usar los desarrolladores Qwen4-Max-Preview
El perfil que ofrecen los informes públicos es bastante claro. Qwen4-Max-Preview destaca en trabajos con reglas definidas y resultados verificables: mantenimiento de código con pruebas, recuperación de registros cruzados en materiales extensos, procesamiento de datos con fórmulas y archivos de oficina editables, y desarrollo de prototipos interactivos. En estas tareas puede añadir pruebas por su cuenta, detectar sus propios errores y entregar resultados que se pueden volver a verificar.
Sus limitaciones también son concretas: las tareas complejas consumen bastante tiempo, por lo que conviene dejarlas en segundo plano; las conclusiones científicas tienden a ir más allá de la evidencia disponible y necesitan revisión profesional; Preview solo puede usarse de forma interactiva en herramientas específicas mediante Token Plan y dejará de estar disponible el 25 de noviembre, así que para un uso a largo plazo habría que pasar a la versión oficial.
La forma más pragmática de usarlo es tratarlo como un asistente de ingeniería capaz de completar de forma independiente el ciclo cerrado de mantenimiento, mientras el desarrollador se encarga de validar las conclusiones y hacer la fusión final. Antes de ponerlo en producción, se recomienda hacer una comparación entre varios modelos con tareas reales propias; con la interfaz unificada de APIYI apiyi.com se pueden realizar las pruebas y comparaciones dentro del mismo flujo de trabajo.
📚 Referencias
-
Todos somos gerentes de producto: ¡Llegó la versión preliminar de Qwen4-Max! Prueba práctica y primeras impresiones: prueba real de la máquina de garra con Qoder y comparación entre herramientas, 2026-11-12
- Enlace:
woshipm.com/ai/6492544.html - Descripción: origen de los datos de 75 minutos de duración, 33 tokens/s, 65 créditos y la tabla comparativa
- Enlace:
-
Todos somos gerentes de producto: prueba práctica de Qwen4-Max-Preview (informe de pruebas de Z Finance): prueba integral de 12 tareas, 2026-11-16
- Enlace:
woshipm.com/evaluating/6494229.html - Descripción: fuente de datos sobre reparación de código, búsqueda de tickets, reproducción de investigación científica y tareas de oficina
- Enlace:
-
Alibaba Cloud Model Studio: documentación de Qwen4-Max-Preview: especificaciones oficiales e instrucciones de uso
- Enlace:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Descripción: ventana de contexto, salida máxima, periodo de vista previa y método de acceso
- Enlace:
-
Alibaba Cloud Model Studio: documentación de Qwen4-Max: parámetros y facturación de la versión oficial
- Enlace:
help.aliyun.com/zh/model-studio/qwen4-max - Descripción: información sobre el presupuesto de salida y el pago por uso de la versión oficial
- Enlace:
-
Alibaba Cloud: permisos y normas de uso de Token Plan: limitaciones del alcance de uso
- Enlace:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Descripción: requisitos para el uso interactivo y escenarios prohibidos
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página de inicio del sitio web de APIYI, apiyi.com; para más materiales de integración, visita el centro de documentación en docs.apiyi.com.