Nota do autor: comparando Qwen4-Max e Claude Opus 5.5 em quatro categorias de tarefas — terminal e repositório de código, tarefas longas de escritório, documentos longos multimodais e custo —, com pontuações de benchmark, especificações, preço de cache e custo de migração, além de recomendações práticas de escolha.
Se sua equipe já usa o Claude Opus 5.5 como modelo principal, rodando em produção dentro do Claude Code ou em agentes construídos por vocês, o Qwen4-Max lançado em 2026-11-16 vai fazer você refazer as contas: o preço de entrada é apenas 37.5% do Opus 5.5, e o preço de saída, apenas 22.5%.
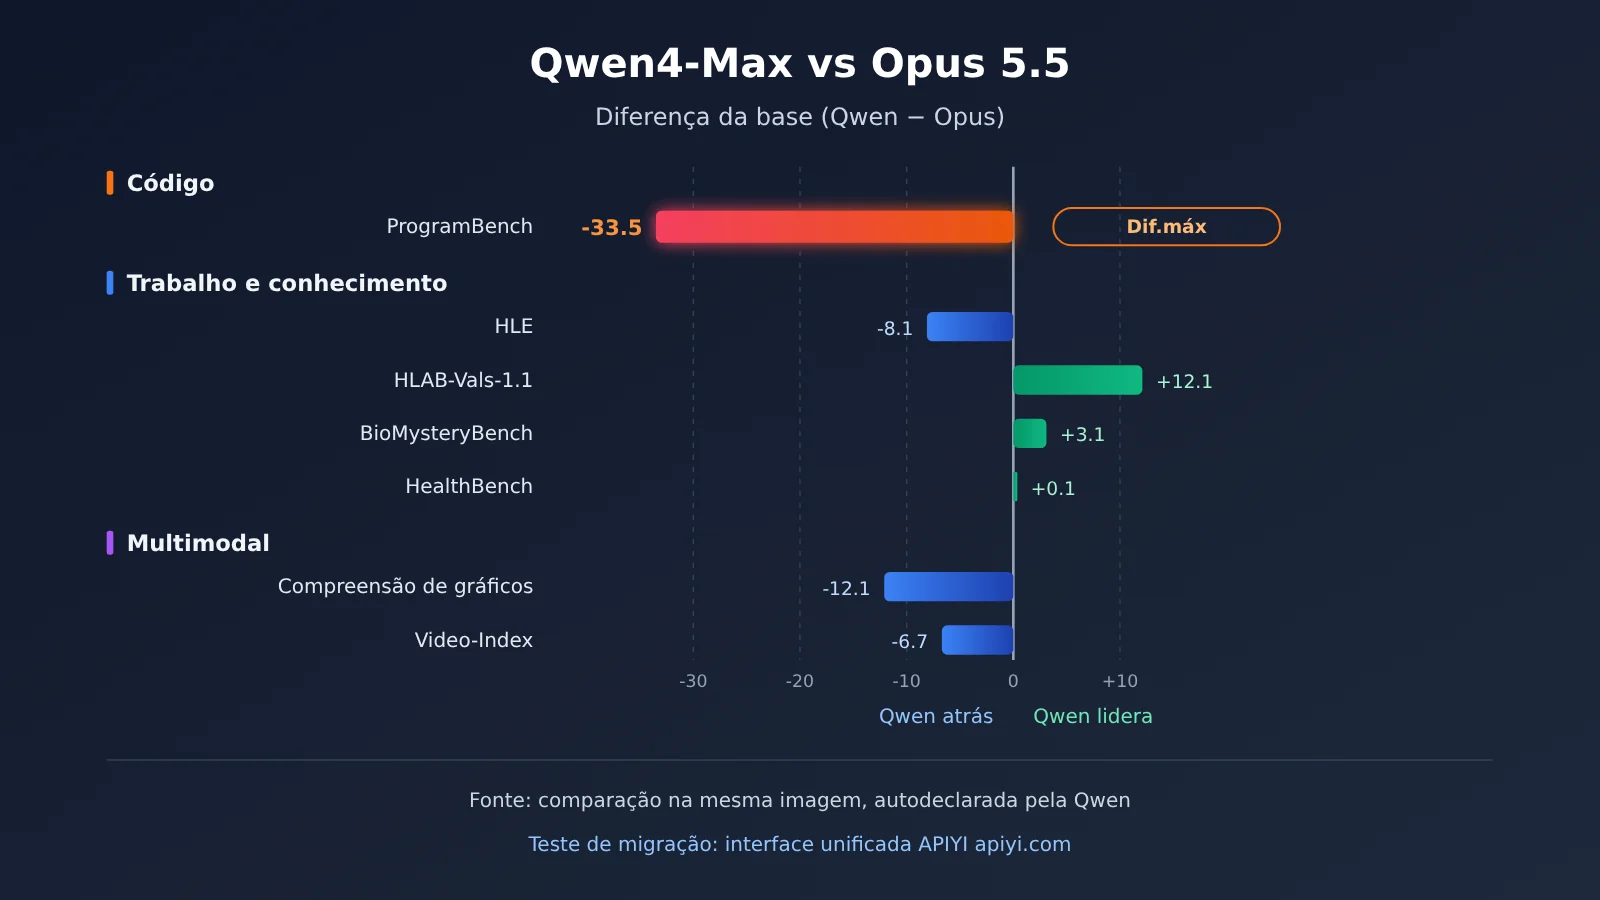
Conclusão direta, sem meio-termo: operações de terminal e refatoração em nível de repositório continuam no Opus 5.5 — o Qwen4-Max fica 33.5 pontos atrás no ProgramBench, e essa é a maior deficiência desta comparação; automação de fluxos de trabalho, agentes de alta concorrência sensíveis a custo e tarefas de documentação com saídas muito longas podem começar pelo Qwen4-Max; já entregáveis de escritório, gráficos e tarefas de compreensão de vídeo seguem com vantagem clara para o Opus 5.5.
Valor central: ao terminar de ler este artigo, você terá uma tabela de trade-offs organizada por tipo de tarefa e entenderá com clareza as diferenças entre os dois lados em preço de cache, nível de raciocínio padrão e etapas reais de migração.
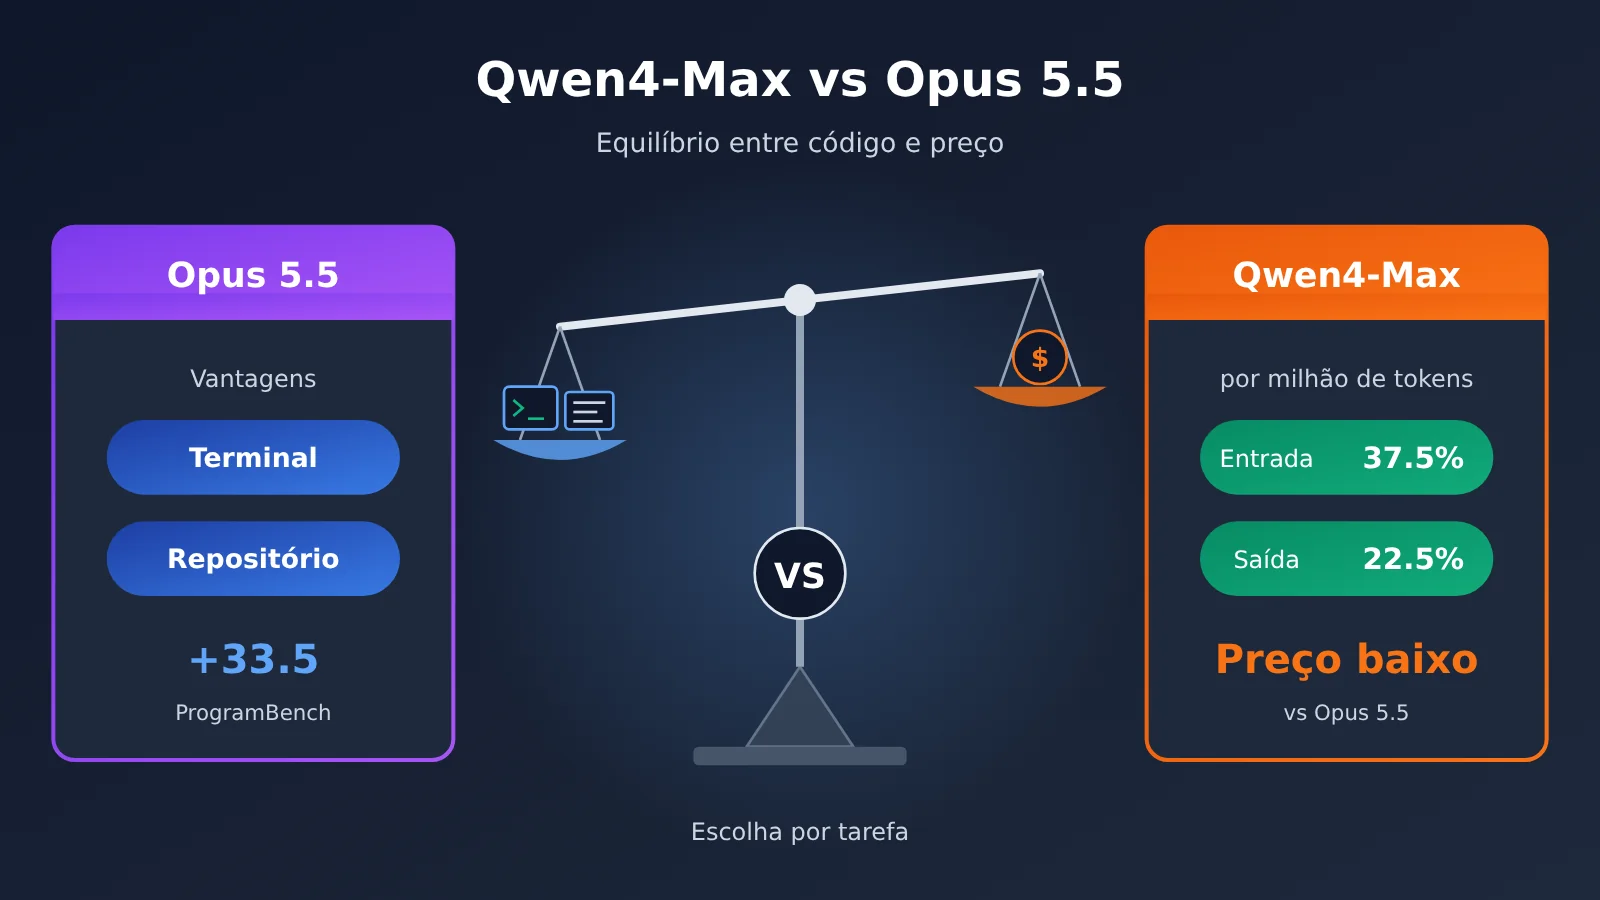
Comparação entre Qwen4-Max e Opus 5.5: visão geral das principais diferenças
Antes de mais nada, vamos esclarecer a origem dos dados. Os números deste artigo vêm de três fontes distintas e não devem ser misturados:
- Comparação na mesma imagem, autodeclarada pela Qwen: a Alibaba lista, no post de lançamento, as pontuações de Qwen4-Max e Opus 5.5 usando a mesma imagem. São resultados executados pelo próprio fabricante, não uma reprodução independente.
- Snapshot de ranking público, 14/11/2026: ranking Code Arena WebDev do arena.ai, com base em votação pública.
- Texto original da documentação da Anthropic: as especificações e os preços do Opus 5.5 vêm da página oficial do modelo e da página de preços da Anthropic.
A tabela abaixo condensa as conclusões do artigo; as seções seguintes detalham as evidências item por item.
| Tipo de tarefa | Recomendação | Evidência principal | Justificativa em uma frase |
|---|---|---|---|
| Operação de terminal e refatoração de repositório inteiro | Opus 5.5 | Qwen4-Max 11,1 abaixo no Terminal-Bench; 33,5 abaixo no ProgramBench | Cadeias de comandos com várias etapas e mudanças no repositório inteiro são o ponto mais fraco do Qwen4-Max |
| Codificação para correção de um único issue | Vale testar o Qwen4-Max | Qwen4-Max 1,5 acima no DeepSWE | A capacidade de correções localizadas já está equiparada, e a vantagem de preço é clara |
| Entregáveis de escritório e tarefas longas | Opus 5.5 | Qwen4-Max 115 Elo abaixo no AA-Briefcase; 6,9 abaixo no JobBench | A diferença de qualidade em documentos e relatórios é perceptível |
| Automação de fluxos de trabalho | Qwen4-Max | Qwen4-Max 3,0 acima no AutomationBench | Em tarefas de fluxo com regras claras, não fica atrás e custa menos |
| Compreensão de gráficos e vídeos | Opus 5.5 | Qwen4-Max 12,1 abaixo no Chartography; 6,7 abaixo no Video-Index | Ainda há diferença na leitura multimodal de imagens |
| Agentes de alta concorrência sensíveis a custo | Qwen4-Max | Entrada 37,5%, saída 22,5% | Com volume alto, a diferença na fatura pode se multiplicar |
Diferenças de especificações entre Qwen4-Max e Opus 5.5
Em termos de especificações, ambos têm janela de contexto de 1M, mas os valores padrão de saída e raciocínio são bem diferentes:
- Qwen4-Max: backbone de 2,4T, 71B ativados, mais 328B de N-gram Embedding; visão nativa; saída máxima de 393K e cadeia de raciocínio máxima de 262K;
reasoning_effortpadrão em high. - Opus 5.5 (texto original da documentação da Anthropic): posicionado para codificação agêntica de longa duração e trabalho de conhecimento; saída máxima de 128K; effort padrão em medium; conhecimento com data de corte em junho de 2026.
O detalhe do nível padrão passa fácil despercebido. O Qwen4-Max já vem configurado com high por padrão, e o processo de raciocínio é cobrado como saída; por isso, a diferença na fatura real costuma ser menor que os 22,5% do preço de tabela. A seção de preços, mais adiante, traz uma evidência indireta vinda de um ranking público.
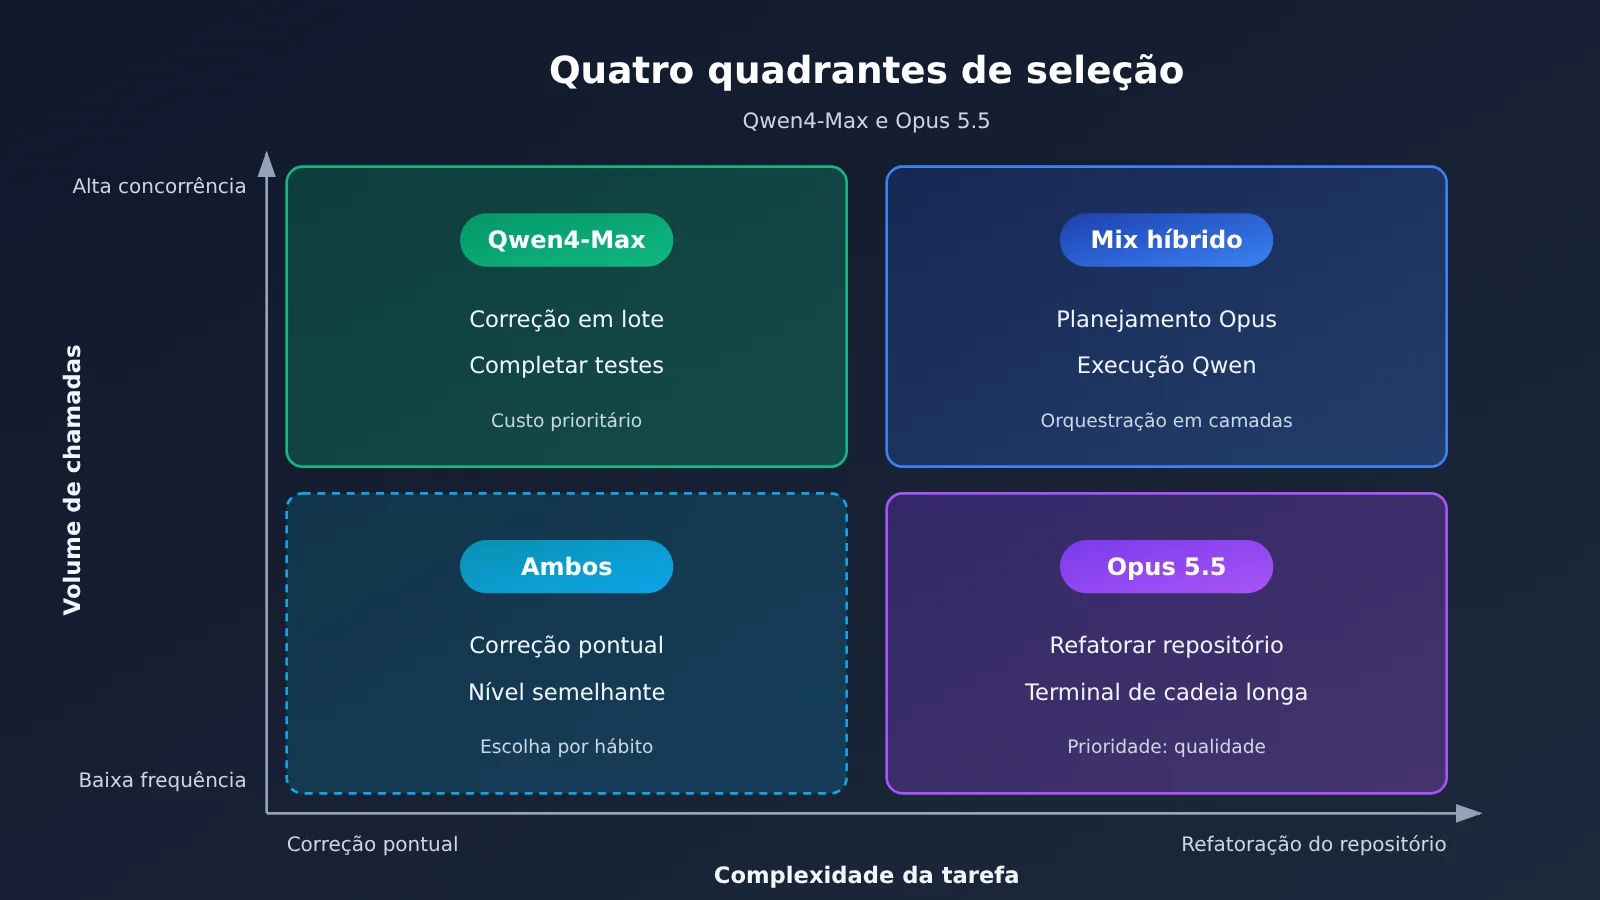
Qwen4-Max vs Opus 5.5: tarefas de terminal e de repositório de código
Esta é a parte que mais interessa aos atuais usuários do Opus e também a que exige mais cautela em relação ao Qwen4-Max.
| Benchmark (mesmo gráfico, valores declarados pela própria Qwen) | Qwen4-Max | Opus 5.5 | Diferença |
|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 74.2 | Qwen 1.5 acima |
| CodeArena WebDev Elo | 1750 | 1816 | Qwen 66 abaixo |
| Terminal-Bench 4.0 | 48.5 | 59.6 | Qwen 11.1 abaixo |
| ProgramBench | 31.5 | 65.0 | Qwen 33.5 abaixo |
Vamos ver item por item o que isso significa na prática:
- DeepSWE 1.5 acima: em tarefas como fazer uma correção pontual a partir de uma issue específica, o Qwen4-Max já está no mesmo nível do Opus 5.5 — 1.5 ponto pode ser considerado praticamente empate, o que o torna adequado para rodar filas de correção de bugs de baixo risco.
- WebDev 66 Elo abaixo: na impressão geral da geração de páginas front-end, o voto dos usuários pende mais para o Opus; ao criar landing pages e protótipos de componentes, a diferença é visível a olho nu.
- Terminal-Bench 11.1 abaixo: a capacidade de executar comandos em sequência no terminal, ler a saída e então decidir o próximo passo fica claramente atrás — e isso é o dia a dia de fluxos de trabalho no estilo Claude Code. Migrar significa mais travamentos no meio do caminho ou mais necessidade de intervenção humana.
- ProgramBench 33.5 abaixo: esta é a maior deficiência desta comparação, com a pontuação quase caindo pela metade. Em tarefas de construir um programa do zero ou reescrevê-lo em larga escala, o Qwen4-Max ainda não serve como substituto do Opus 5.5.
O ranking público também indica uma posição semelhante. Segundo o snapshot do ranking público de 2026-11-14, o arena.ai Code Arena WebDev tem 1,007,405 votos e 159 modelos: o Opus 5.5 (Max) está em 2º lugar com 1816 pontos, e o Qwen4-Max (xHigh) em 6º com 1750 pontos — mas este último tem apenas 1,814 votos e ainda está marcado como Preliminary, então a posição pode oscilar.
Recomendações de uso do Qwen4-Max em cenários de repositório de código
Se o seu agent faz principalmente refatoração do repositório inteiro, migração entre módulos ou operações de terminal em cadeias longas, a recomendação é manter o Opus 5.5. Se você dividiu a tarefa em duas camadas — “planejamento + execução” —, pode deixar o Opus 5.5 responsável pelo planejamento e pelas mudanças críticas, e direcionar tarefas locais como correção de um único arquivo e complemento de testes para o Qwen4-Max.
Qwen4-Max vs Opus 5.5: trabalho de escritório e tarefas longas
Os resultados em tarefas de escritório e de agente de longa duração são mais heterogêneos do que na programação: há vitórias e derrotas.
| Benchmark (comparação na mesma tabela, autorreportada pelo Qwen) | Qwen4-Max | Opus 5.5 | Diferença |
|---|---|---|---|
| AA-Briefcase v1.1 Elo | 1686 | 1801 | Qwen 115 a menos |
| JobBench | 68.5 | 75.4 | Qwen 6.9 a menos |
| APEX-Agents v1.1 | 72.1 | 73.5 | Qwen 1.4 a menos |
| AutomationBench-AA | 72.5 | 69.5 | Qwen 3.0 a mais |
| AgentArena Net Improvement | 7.5 | 18.2 | Qwen 10.7 a menos |
Levando para o trabalho real:
- AA-Briefcase 115 Elo a menos: em entregáveis de escritório como relatórios, propostas e planilhas, o resultado final do Opus 5.5 é mais facilmente adotado sem ajustes — é a maior diferença do cenário de escritório.
- JobBench 6.9 a menos: a completude integrada em tarefas próximas do trabalho real continua com o Opus na frente, o que significa que, na entrega de ponta a ponta, a taxa de retrabalho pode ser maior.
- APEX-Agents 1.4 a menos: em tarefas genéricas de agente, basicamente empatam; trocar de modelo não traz diferença perceptível de experiência.
- AutomationBench 3.0 a mais: automação de processos com regras bem definidas é justamente o ponto forte do Qwen4-Max; processamento de formulários, movimentação de dados e orquestração de tarefas agendadas são bons candidatos a migrar primeiro.
- AgentArena Net Improvement 10.7 a menos: a capacidade de melhorar continuamente ao longo de várias rodadas de iteração é menor; em tarefas longas, quanto mais para o fim, mais se depende da autocorreção do modelo — e aí o Opus se mostra mais estável.
Além disso, o limite máximo de saída de 393K e de cadeia de pensamento de 262K do Qwen4-Max são uma vantagem concreta em tarefas longas que exigem produzir de uma só vez conteúdo muito extenso; já o máximo de saída do Opus 5.5 é de 128K.
Qwen4-Max vs Opus 5.5: chinês e documentos longos multimodais
Antes de tudo: o gráfico comparativo dos materiais de referência não traz um benchmark específico para chinês, então este artigo não consegue responder com números “quem é melhor em chinês”. Se a qualidade em chinês é o seu critério central, faça um teste A/B com seu próprio conjunto de amostras e não confie em conclusões de segunda mão.
O que dá para quantificar são as tarefas multimodais e de conhecimento:
| Benchmark (comparação no mesmo gráfico, segundo dados oficiais da Qwen) | Qwen4-Max | Opus 5.5 | Diferença |
|---|---|---|---|
| Chartography | 54.2 | 66.3 | Qwen 12.1 pontos abaixo |
| Video-Index | 68.1 | 74.8 | Qwen 6.7 pontos abaixo |
| Humanity’s Last Exam | 51.7 | 59.8 | Qwen 8.1 pontos abaixo |
| HLAB-Vals-1.1 | 21.3 | 9.2 | Qwen 12.1 pontos acima |
| BioMysteryBench | 85.0 | 81.9 | Qwen 3.1 pontos acima |
| HealthBench Professional | 60.0 | 59.9 | Praticamente empatado |
O significado prático desses números é o seguinte: ao ler gráficos e extrair dados visuais de relatórios financeiros e de pesquisa, o Qwen4-Max fica 12.1 pontos atrás e tende a deixar passar ou interpretar mal as coordenadas; a compreensão de vídeo também apresenta uma diferença de 6.7 pontos; e as questões de conhecimento geral de alta dificuldade (HLE) ficam 8.1 pontos atrás. Por outro lado, em raciocínio biológico e perguntas e respostas médicas especializadas, o Qwen4-Max empata ou até leva uma leve vantagem, liderando por 12.1 pontos no HLAB-Vals.
Então, para tarefas com documentos longos, é preciso subdividir ainda mais: documentos predominantemente textuais que exigem saídas muito longas podem ter o Qwen4-Max como candidato principal; já PDFs com muitos gráficos ou materiais que incluem vídeo ainda devem usar o Opus 5.5.
Preço por milhão de tokens e a conta de cache: Qwen4-Max vs. Opus 5.5
O preço é o argumento mais forte do Qwen4-Max. As unidades da tabela abaixo são por 1M tokens. Os preços oficiais foram obtidos dos textos originais da documentação da QwenCloud e da Anthropic, respectivamente; os preços atuais na APIYI foram obtidos de docs.apiyi.com/models, com data de coleta 2026-11-16.
| Item de cobrança ($/1M tokens) | Qwen4-Max oficial | Opus 5.5 oficial | Qwen/Opus | APIYI qwen3.8-max |
APIYI claude-opus-5-5 |
|---|---|---|---|---|---|
| Entrada | 1.5 | 4 | 37.5% | 1.65 | 4 |
| Saída | 4.5 | 20 | 22.5% | 4.95 | 20 |
| Leitura de cache | 0.075 | 0.20 | 37.5% | 0.20625 | 0.2 |
| Escrita de cache de 5 minutos | 1.875 | 5 | 37.5% | conforme a lista da plataforma | conforme a lista da plataforma |
| Escrita de cache de 1 hora | 3 | 8 | 37.5% | conforme a lista da plataforma | conforme a lista da plataforma |
Na verdade, as estruturas de cache das duas são estruturalmente idênticas: a leitura de cache é 5% do preço de entrada, a escrita de cache de 5 minutos é 1.25x o preço de entrada e a escrita de cache de 1 hora é 2x. Isso significa que a estratégia de cache que você desenhou para o Opus pode ser transportada tal e qual para o Qwen4-Max, e a conta diminui proporcionalmente para 37.5%. Vale ficar atento: no APIYI, a leitura de cache do qwen3.8-max é 12.5% do preço de entrada, uma proporção diferente da oficial do Qwen4-Max; ao migrar, faça o cálculo separadamente conforme o modelo real.
Uma conta concreta
Tomando como exemplo 100 milhões de tokens de entrada + 10 milhões de tokens de saída: o Qwen4-Max fica em cerca de $195 (150 + 45), e o Opus 5.5 em cerca de $600 (400 + 200). A diferença é de aproximadamente $405, o equivalente a dois terços da conta do Opus.
Mas preço de tabela não é o mesmo que valor efetivamente pago. O snapshot do ranking público, 2026-11-14, fornece o custo P50 por tarefa: Opus 5.5 (Max) $8.99, Qwen4-Max (xHigh) $4.18, uma razão de cerca de 46%, e não os 22.5% do preço de tabela. Isso acontece porque os níveis de raciocínio dos dois são diferentes: o Qwen4-Max usa high por padrão, a cadeia de pensamento é cobrada como saída e o consumo de tokens é maior. Quanto você economiza de fato depende do comprimento da sua tarefa e do nível de raciocínio; recomendo medir com uma reprodução do seu próprio tráfego.
💰 Dica de custo: ao comparar contas, registre ao mesmo tempo os quatro volumes de tokens — entrada, saída, leitura de cache e escrita de cache — em vez de olhar apenas para o preço unitário. Chamando os dois modelos em paralelo na mesma conta pela APIYI apiyi.com, os detalhes de uso ficam alinhados em um único lugar.
Qwen4-Max vs Opus 5.5: recomendações de decisão e os três passos da migração
Migrar um agente de Opus para Qwen passa inevitavelmente por três passos: verificar o modelo, comparar preços e conferir o protocolo.
Primeiro passo: verificar o modelo. Até 16/11/2026, o Qwen4-Max ainda não está disponível no APIYI — vamos colocá-lo no catálogo o quanto antes; atualmente o modelo mais forte do lado Qwen é o qwen3.8-max. Do lado Opus, você pode usar claude-opus-5-5, e há também o claude-opus-5-5-thinking, com o mesmo preço. Modelos e preços têm como referência a lista de modelos do centro de documentação em apiyi.com; antes do lançamento, dá para montar a esteira de rollout gradual usando qwen3.8-max.
Segundo passo: comparar preços. Seguindo o método da seção anterior, estime o custo dos dois lados com base em uma semana de tráfego real e alinhe o nível de raciocínio antes de comparar. A lista de modelos do APIYI em apiyi.com reúne entrada, saída e leitura de cache na mesma tabela geral, o que a torna uma fonte de dados prática para montar sua planilha de cálculo.
Terceiro passo: conferir o protocolo. O APIYI oferece uma interface compatível com OpenAI, com endpoint em https://api.apiyi.com/v1. Para trocar de modelo, basta alterar o campo model — por exemplo, de claude-opus-5-5 para qwen3.8-max — mantendo api_key e base_url inalterados. Vale checar mais dois pontos: no lado Qwen, o parâmetro de intensidade de raciocínio se chama reasoning_effort e o padrão é high; se quiser alinhar com o medium do Opus, é preciso defini-lo explicitamente. Além disso, a duração de escrita do cache e as regras de acerto também precisam ser verificadas novamente para o modelo de destino.
🎯 Sugestão de rollout gradual: não troque o agente inteiro de uma vez. Recomendo dividir o tráfego sob o mesmo
base_url(https://api.apiyi.com/v1) por tipo de tarefa: migre primeiro as tarefas de automação e de correção pontual, mantenha as tarefas de terminal e de repositório inteiro no Opus 5.5, e observe a taxa de retrabalho por duas semanas antes de decidir o próximo passo.
Perguntas frequentes
Q1: Qwen4-Max ou Opus 5.5 — qual é melhor para um coding agent?
Depende da granularidade da tarefa. Na correção de uma issue isolada (DeepSWE), os dois ficam empatados, e dá para economizar usando o Qwen4-Max; já em operações de múltiplos passos no terminal e na construção de repositórios inteiros (Terminal-Bench, ProgramBench), o Opus 5.5 lidera com folga — no ProgramBench a diferença chega a 33,5 pontos, então para esse tipo de tarefa continue com o Opus.
Q2: Os números do gráfico da Alibaba podem ser comparados com os do ranking arena?
Não como se fossem a mesma base. O primeiro é uma comparação com a mesma imagem, auto-reportada pela própria Qwen; o segundo é um snapshot de um ranking público (2026-11-14), e além disso o Qwen4-Max tem apenas 1.814 votos no ranking, ainda em status Preliminary. Dá para usar os dois como referência de tendência, mas não se deve fundi-los numa conclusão do tipo “está X pontos à frente”.
Q3: Quanto dá para economizar de verdade mudando para o Qwen4-Max?
No preço de tabela, a entrada sai 62,5% mais barata e a saída 77,5%. Mas o custo por tarefa P50 no ranking público fica numa razão de cerca de 46%, porque o Qwen4-Max usa por padrão um nível de raciocínio mais alto e gera mais tokens de pensamento. A economia real precisa ser medida com um replay do seu próprio tráfego.
Q4: Já é possível chamar o Qwen4-Max no APIYI?
Por enquanto não: o Qwen4-Max ainda não está disponível na plataforma, e vamos colocá-lo no ar o quanto antes. Hoje é possível montar o fluxo de migração com o `qwen3.8-max` e, depois do lançamento, basta alterar o campo `model`. Para o status dos modelos, consulte a lista de modelos em APIYI apiyi.com.
Q5: Quanto código precisa mudar para sair do Opus e ir para o Qwen?
Se você já usa uma interface compatível com OpenAI, basta apontar o `base_url` para `https://api.apiyi.com/v1`, trocar o nome do modelo e, conforme necessário, definir o `reasoning_effort`. Depois de se registrar no APIYI apiyi.com, você pode usar o crédito de teste gratuito para novos usuários e rodar uma primeira rodada de comparação.
Q6: Quais são as limitações conhecidas do Qwen4-Max?
O terminal e a codificação de repositório inteiro são os pontos mais fracos: a compreensão de gráficos fica 12,1 pontos atrás, o Elo em entregáveis de escritório é 115 pontos menor, e a capacidade de autoaperfeiçoamento em múltiplas rodadas também é mais fraca. Além disso, todos os números comparativos são auto-reportados pelos fabricantes, sem reprodução por terceiros, e faltam dados de benchmark específicos para o desempenho em chinês.
Qwen4-Max vs Opus 5.5: Principais Pontos-Chave (Key Takeaways)
- Maior ponto fraco: 33,5 pontos a menos no ProgramBench — para build e refatoração de repositório completo, continue usando Opus 5.5.
- Áreas empatadas: DeepSWE, APEX-Agents e HealthBench ficam praticamente iguais; dá para priorizar o roteamento.
- Vantagens do Qwen: automação de fluxos de trabalho, raciocínio biomédico e saída ultra longa de 393K.
- Estrutura de preços: entrada 37,5%, saída 22,5%; as quatro proporções de cache seguem exatamente a mesma estrutura do Opus.
- Diferença de custo real: o nível de raciocínio padrão é
high, e o custo das tarefas nos benchmarks públicos fica em torno de 46%. - Caminho de migração: no APIYI apiyi.com, rode primeiro
qwen3.8-maxusando o mesmo endpoint; quando o Qwen4-Max for lançado, basta substituir diretamente.
Resumo
A escolha entre Qwen4-Max e Opus 5.5 pode ser resumida em três pontos:
- Terminal e repositório de código ficam com Opus 5.5: a diferença no Terminal-Bench e no ProgramBench é grande demais, e a diferença de preço não cobre o custo de retrabalho.
- Automação e alta concorrência ficam com Qwen4-Max: em tarefas com capacidade equivalente ou superior, economizar 30 a 50% da conta é lucro puro.
- Roteamento por tarefa, em vez de substituição total: usar a mesma interface e rotear por tipo de tarefa é a forma de migração com menor risco.
Recomendamos primeiro fazer uma rodada de replay das suas próprias tarefas no APIYI apiyi.com com qwen3.8-max e claude-opus-5-5, e depois que o Qwen4-Max for lançado, tomar a decisão final de troca.
📚 Referências
-
Blog de lançamento do Qwen4-Max: comparação entre as especificações do modelo e os benchmarks autorrelatados oficiais
- Link:
qwen.ai/blog?id=qwen4-max - Descrição: inclui parâmetros de arquitetura, janela de contexto, limite de saída e pontuações comparativas no mesmo gráfico
- Link:
-
Visão geral dos modelos Anthropic: especificações do Opus 5.5
- Link:
platform.claude.com/docs/en/about-claude/models/overview.md - Descrição: contexto, saída máxima, esforço padrão e data de corte de conhecimento
- Link:
-
Página de preços da Anthropic: preços de entrada, saída e cache do Opus 5.5
- Link:
platform.claude.com/docs/en/about-claude/pricing.md - Descrição: inclui preços de escrita de cache de 5 minutos e 1 hora
- Link:
-
Lista de modelos APIYI: preços atuais e modelos disponíveis na plataforma
- Link:
docs.apiyi.com/models - Descrição: verifique o status de disponibilidade e o preço dos modelos antes da migração
- Link:
Autor: Equipe técnica APIYI
Contato técnico: Sinta-se à vontade para nos contatar pela página inicial do site APIYI apiyi.com; mais materiais de integração podem ser encontrados no centro de documentação docs.apiyi.com