Примечание автора: сравниваем Qwen4-Max и Claude Opus 5.5 по четырём типам задач — терминал и работа с репозиториями, длинные офисные задачи, мультимодальные длинные документы и стоимость. Разбираем бенчмарки, характеристики, цену кэша и затраты на миграцию, а в конце — практичные рекомендации по выбору.
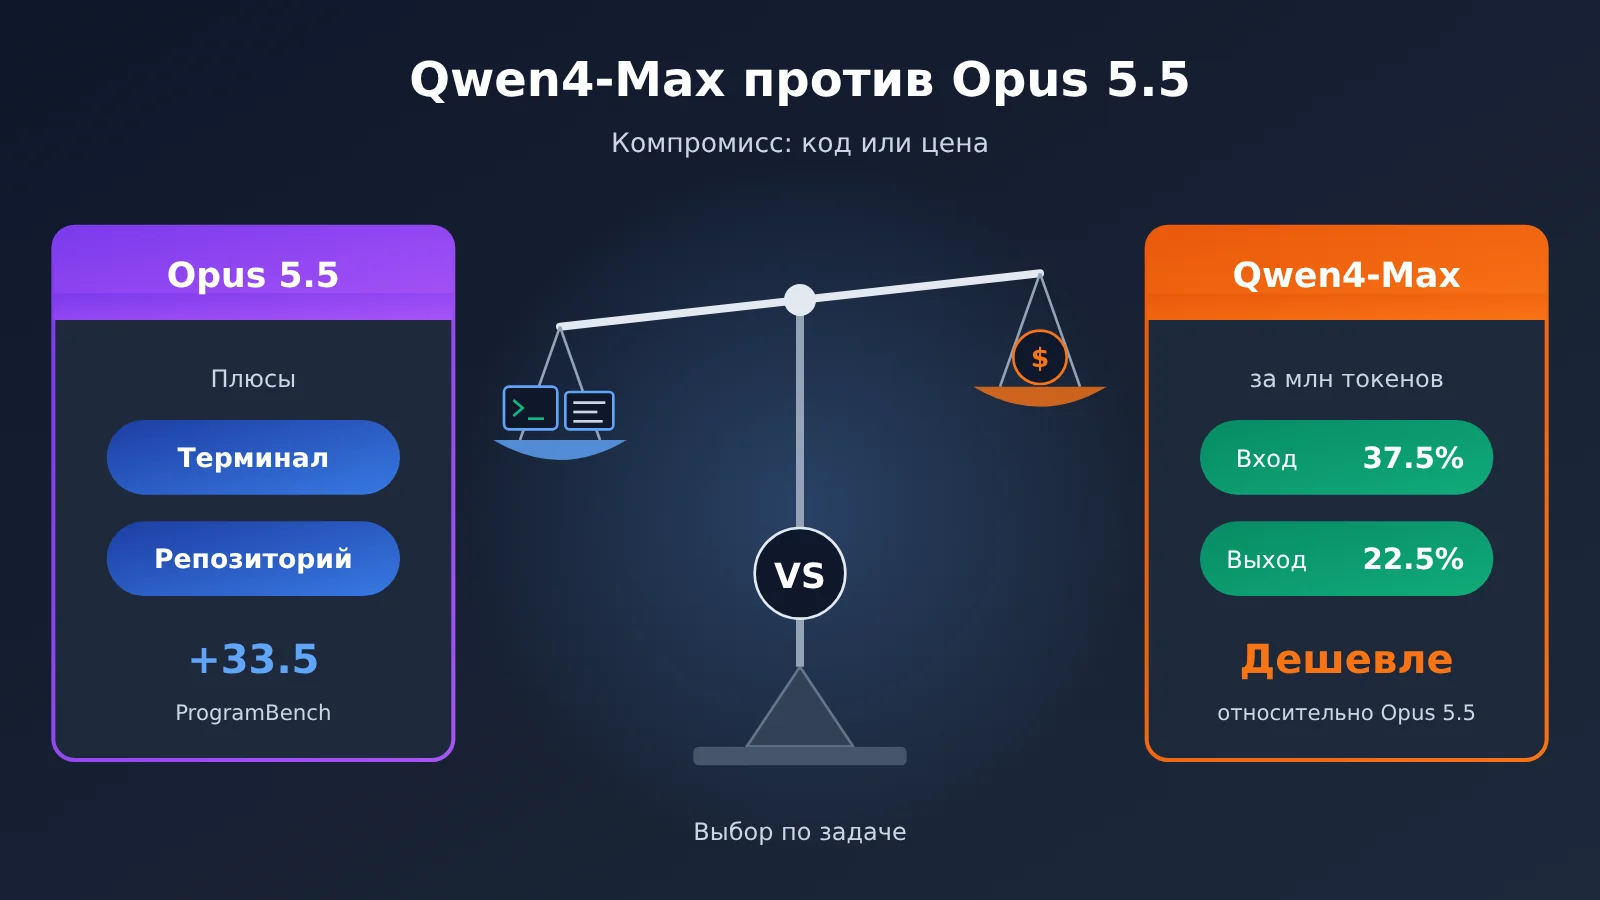
Если ваша команда уже сделала Claude Opus 5.5 основной моделью и крутит её в продакшене через Claude Code или собственного агента, то вышедший 2026-11-16 Qwen4-Max заставит пересчитать бюджет: цена за входные токены — лишь 37.5% от Opus 5.5, а за выходные — 22.5%.
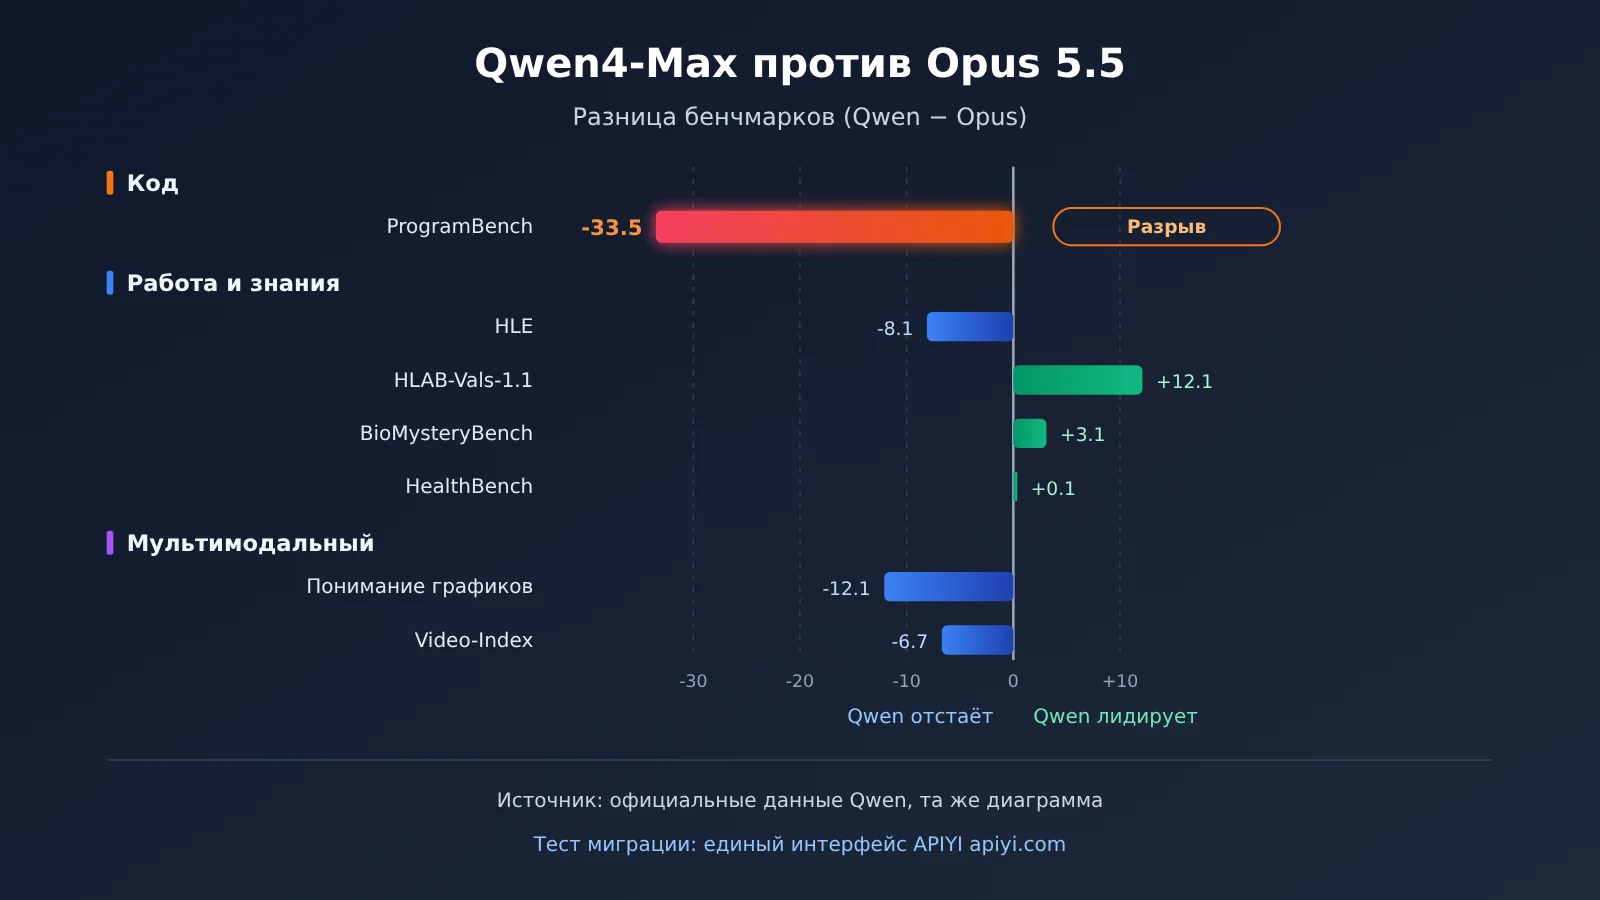
Сразу вывод, без компромиссов: операции в терминале и рефакторинг на уровне репозитория остаются за Opus 5.5 — Qwen4-Max проигрывает 33.5 балла на ProgramBench, и это самое слабое место в сравнении. Автоматизацию рабочих процессов, высоконагруженные агенты с чувствительностью к цене и документы со сверхдлинным выводом можно сначала пробовать на Qwen4-Max. В офисных артефактах, диаграммах и задачах на понимание видео у Opus 5.5 по-прежнему заметное преимущество.
Главное: дочитав статью, вы получите таблицу компромиссов по типам задач и чётко увидите разницу между двумя моделями в цене кэша, уровне рассуждений по умолчанию и реальных шагах миграции.
Qwen4-Max против Opus 5.5: краткий обзор ключевых различий
Сначала уточним методику подсчёта. Цифры в статье взяты из трёх разных источников, и смешивать их нельзя:
- Официальное сравнение от Qwen на одной картинке: Alibaba в блоге о релизе сводит на одном изображении оценки Qwen4-Max и Opus 5.5; это собственный прогон вендора, а не независимое воспроизведение.
- Снимок публичного рейтинга на 2026-11-14: рейтинг Code Arena WebDev от arena.ai, основанный на открытом голосовании.
- Оригинальная документация Anthropic: характеристики и цены Opus 5.5 взяты с официальной страницы модели и страницы с ценами Anthropic.
Таблица ниже — сжатый итог всей статьи; в следующих разделах разберём аргументы по пунктам.
| Тип задачи | Рекомендация | Ключевой аргумент | Короткое обоснование |
|---|---|---|---|
| Терминальные операции и рефакторинг на уровне репозитория | Opus 5.5 | Terminal-Bench ниже на 11.1, ProgramBench ниже на 33.5 | Многошаговые цепочки команд и изменения во всём репозитории — самое слабое место Qwen4-Max |
| Кодинг в стиле исправления отдельного issue | Qwen4-Max можно попробовать | DeepSWE выше на 1.5 | В локальных исправлениях модель уже не уступает, а ценовое преимущество очевидно |
| Офисные документы и длинные задачи | Opus 5.5 | AA-Briefcase ниже на 115 Elo, JobBench ниже на 6.9 | Разница в качестве документов и отчётов ощутима |
| Автоматизация рабочих процессов | Qwen4-Max | AutomationBench выше на 3.0 | На задачах с чёткими правилами не уступает и стоит дешевле |
| Понимание графиков и видео | Opus 5.5 | Chartography ниже на 12.1, Video-Index ниже на 6.7 | В мультимодальном чтении изображений разрыв сохраняется |
| Высоконагруженные агенты, чувствительные к стоимости | Qwen4-Max | Цена входа — 37.5%, выхода — 22.5% | При больших объёмах разница в счетах растёт кратно |
Различия в характеристиках Qwen4-Max и Opus 5.5
На уровне характеристик у обоих контекстное окно 1M, но значения по умолчанию для вывода и рассуждений сильно различаются:
- Qwen4-Max: основная модель на 2.4T параметров, 71B активных, плюс 328B N-gram Embedding; встроенная поддержка зрения; максимальный вывод 393K, максимальная цепочка рассуждений 262K; по умолчанию
reasoning_effort— high. - Opus 5.5 (по оригинальной документации Anthropic): ориентирован на длительные агентные задачи в кодинге и интеллектуальной работе; максимальный вывод 128K; по умолчанию effort — medium; знания актуальны по июнь 2026 года.
Пункт про уровень по умолчанию легко упустить. У Qwen4-Max по умолчанию сразу включён high, а процесс рассуждений тарифицируется как выходные токены, поэтому реальная разница в счетах обычно меньше 22.5% из прайса; в разделе о ценах ниже приведём косвенное подтверждение из публичного рейтинга.
Qwen4-Max против Opus 5.5: задачи в терминале и кодовых репозиториях
Это та часть, которая больше всего волнует нынешних пользователей Opus, и одновременно та, где с Qwen4-Max нужно быть особенно осторожными.
| Бенчмарк (данные самого Qwen, одинаковые условия) | Qwen4-Max | Opus 5.5 | Разница |
|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 74.2 | Qwen выше на 1.5 |
| CodeArena WebDev Elo | 1750 | 1816 | Qwen ниже на 66 |
| Terminal-Bench 4.0 | 48.5 | 59.6 | Qwen ниже на 11.1 |
| ProgramBench | 31.5 | 65.0 | Qwen ниже на 33.5 |
Посмотрим, что каждый пункт означает на практике:
- DeepSWE выше на 1.5: в задачах вроде точечного исправления по заданному issue Qwen4-Max уже находится на одном уровне с Opus 5.5; 1.5 балла можно считать паритетом, так что его можно ставить в очередь низкорисковых исправлений багов.
- WebDev ниже на 66 Elo: общий вид сгенерированных фронтенд-страниц; в голосовании пользователи чаще выбирают Opus, и при создании лендингов и прототипов компонентов разница заметна невооружённым глазом.
- Terminal-Bench ниже на 11.1: способность последовательно выполнять команды в терминале, читать вывод и решать, что делать дальше, заметно слабее. А это как раз повседневная работа в стиле Claude Code; переход на Qwen4-Max означает больше зависаний посреди задачи и больше случаев, когда нужно вмешиваться вручную.
- ProgramBench ниже на 33.5: это самое слабое место в текущем сравнении, результат едва ли не вдвое хуже. Для задач, где нужно с нуля построить программу или масштабно её переписать, Qwen4-Max пока не годится как замена Opus 5.5.
Публичный рейтинг даёт близкую картину. По снимку публичного рейтинга на 2026-11-14, в arena.ai Code Arena WebDev было 1,007,405 голосов и 159 моделей: Opus 5.5 (Max) с 1816 баллами на 2-м месте, Qwen4-Max (xHigh) с 1750 баллами на 6-м, но у последнего всего 1,814 голосов, и он всё ещё помечен как Preliminary — позиция может колебаться.
Рекомендации по использованию Qwen4-Max в сценариях с кодовыми репозиториями
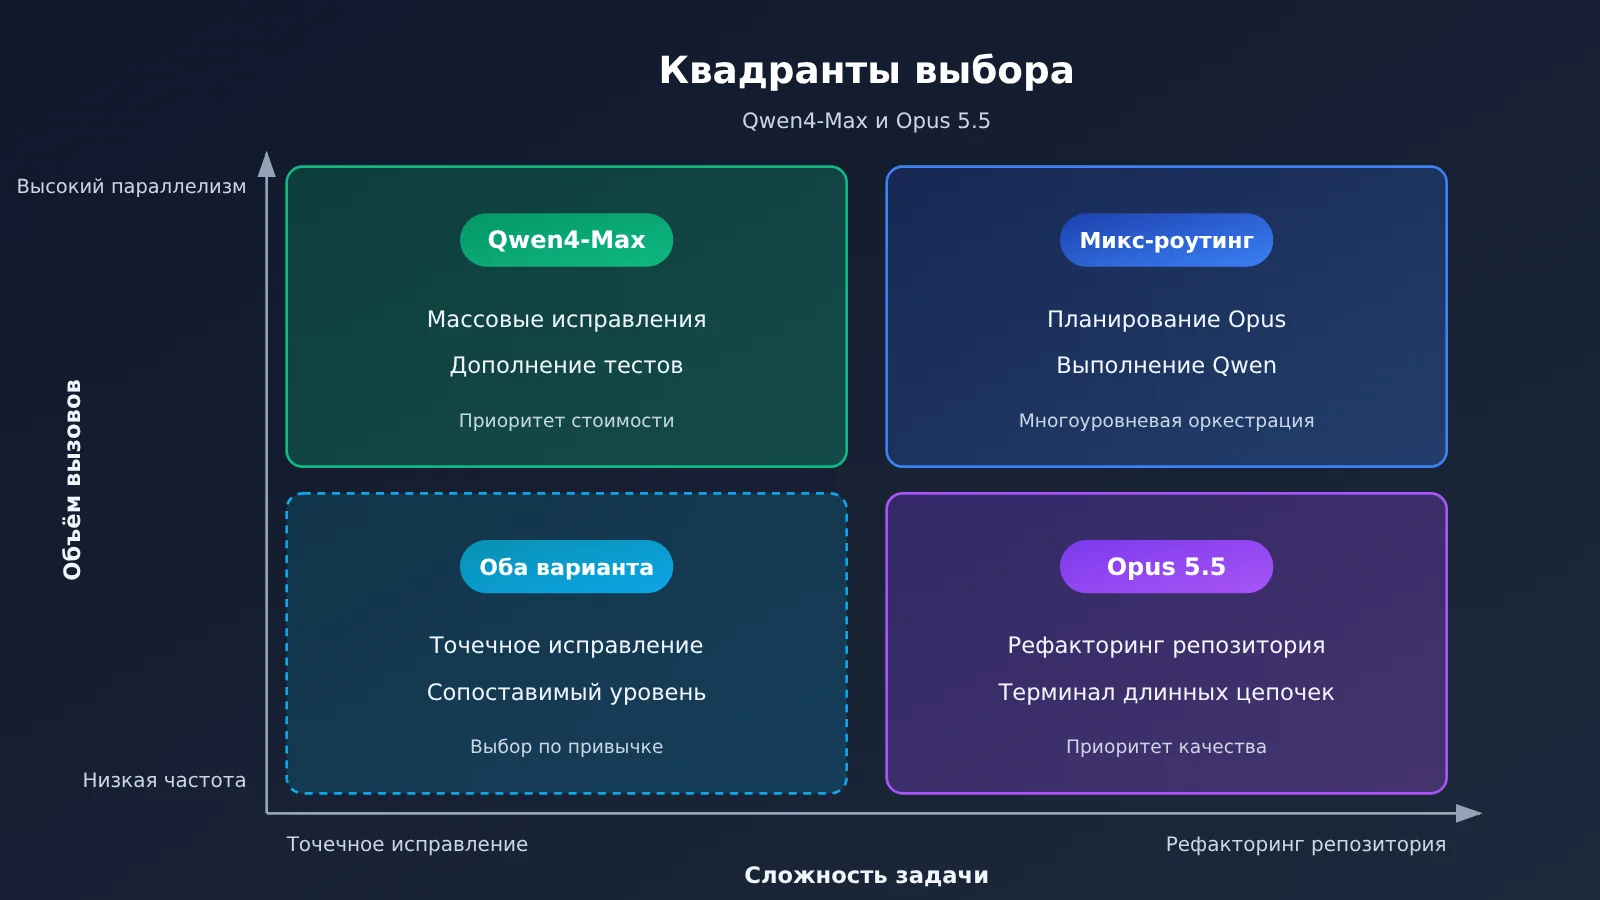
Если ваш агент в основном занимается рефакторингом всего репозитория, межмодульной миграцией или длинными цепочками операций в терминале, лучше оставить Opus 5.5. Если вы разбили задачу на два уровня — «планирование + выполнение», можно поручить Opus 5.5 планирование и ключевые изменения, а локальные задачи вроде правок одного файла и дописывания тестов передать Qwen4-Max.
Qwen4-Max против Opus 5.5: офисные задачи и длинные задачи
В офисных задачах и в длительных agent-задачах картина более пёстрая, чем в кодинге: тут есть и поражения, и победы.
| Бенчмарк (данные самого Qwen, сравнение из одного и того же графика) | Qwen4-Max | Opus 5.5 | Разница |
|---|---|---|---|
| AA-Briefcase v1.1 Elo | 1686 | 1801 | Qwen ниже на 115 |
| JobBench | 68.5 | 75.4 | Qwen ниже на 6.9 |
| APEX-Agents v1.1 | 72.1 | 73.5 | Qwen ниже на 1.4 |
| AutomationBench-AA | 72.5 | 69.5 | Qwen выше на 3.0 |
| AgentArena Net Improvement | 7.5 | 18.2 | Qwen ниже на 10.7 |
Что это значит на практике:
- AA-Briefcase ниже на 115 Elo: в офисных артефактах — отчётах, предложениях, таблицах — готовый результат Opus 5.5 чаще можно взять и сразу использовать. Это самый большой разрыв в офисных сценариях.
- JobBench ниже на 6.9: по совокупному выполнению задач, близких к реальным рабочим ролям, Opus по-прежнему впереди, а значит при сквозной сдаче работы вероятность переделок выше.
- APEX-Agents ниже на 1.4: на общих agent-задачах практически паритет, смена модели заметного падения опыта не даст.
- AutomationBench выше на 3.0: а вот автоматизация процессов с чёткими правилами — как раз сильная сторона Qwen4-Max. Обработку форм, перенос данных, оркестрацию задач по расписанию стоит мигрировать в первую очередь.
- AgentArena Net Improvement ниже на 10.7: способность последовательно улучшать результат за несколько итераций слабее. Чем длиннее задача и чем сильнее она требует самокоррекции по ходу, тем стабильнее выглядит Opus.
Отдельно стоит отметить: максимальный вывод в 393K и лимит цепочки рассуждений в 262K — это реальное преимущество Qwen4-Max для длинных задач, где нужно за один раз выдать очень объёмный результат. У Opus 5.5 максимальный вывод — 128K.
Qwen4-Max против Opus 5.5: китайский язык и мультимодальные длинные документы
Сразу оговорка: в сравнительных графиках из справочных материалов нет отдельного бенчмарка для китайского языка, поэтому цифрами ответить на вопрос «кто лучше в китайском» в этой статье не получится. Если качество китайского — ваш ключевой показатель, прогоните A/B на собственной выборке и не опирайтесь на чужие выводы.
А вот мультимодальные задачи и задачи на знания можно обсуждать в цифрах:
| Бенчмарк (сравнение на одних и тех же графиках, по данным самой Qwen) | Qwen4-Max | Opus 5.5 | Разница |
|---|---|---|---|
| Chartography | 54.2 | 66.3 | Qwen ниже на 12.1 |
| Video-Index | 68.1 | 74.8 | Qwen ниже на 6.7 |
| Humanity’s Last Exam | 51.7 | 59.8 | Qwen ниже на 8.1 |
| HLAB-Vals-1.1 | 21.3 | 9.2 | Qwen выше на 12.1 |
| BioMysteryBench | 85.0 | 81.9 | Qwen выше на 3.1 |
| HealthBench Professional | 60.0 | 59.9 | Практически паритет |
Что эти цифры означают на практике: в чтении графиков и извлечении данных из диаграмм в финансовых отчётах и исследовательских документах Qwen4-Max отстаёт на 12.1 балла — чаще пропускает или неверно считывает значения по осям координат; в понимании видео разрыв тоже 6.7 балла; в сложных комплексных вопросах на знания (HLE) — 8.1 балла. Зато в биологических рассуждениях и профессиональных медицинских вопросах Qwen4-Max не уступает, а кое-где даже немного впереди, а в HLAB-Vals лидирует с отрывом в 12.1 балла.
Поэтому задачи с длинными документами стоит разделять: если документ в основном текстовый и требует очень длинного вывода, Qwen4-Max можно рассматривать как первого кандидата; если это PDF с плотной графикой или материалы с видеоконтентом, по-прежнему лучше использовать Opus 5.5.
Цены Qwen4-Max и Opus 5.5 за миллион токенов и расчёт по кэшу
Цена — самый сильный аргумент Qwen4-Max. В таблице ниже все значения указаны за 1M tokens; официальные цены взяты из оригинальной документации QwenCloud и Anthropic, текущие цены APIYI — из docs.apiyi.com/models, данные на 2026-11-16.
| Позиция тарификации ($/1M tokens) | Qwen4-Max (офиц.) | Opus 5.5 (офиц.) | Qwen/Opus | APIYI qwen3.8-max |
APIYI claude-opus-5-5 |
|---|---|---|---|---|---|
| Вход | 1.5 | 4 | 37.5% | 1.65 | 4 |
| Выход | 4.5 | 20 | 22.5% | 4.95 | 20 |
| Чтение кэша | 0.075 | 0.20 | 37.5% | 0.20625 | 0.2 |
| Запись кэша на 5 минут | 1.875 | 5 | 37.5% | По прайс-листу платформы | По прайс-листу платформы |
| Запись кэша на 1 час | 3 | 8 | 37.5% | По прайс-листу платформы | По прайс-листу платформы |
Структура кэширования у обоих на самом деле полностью совпадает: чтение кэша стоит 5% от цены входа, запись кэша на 5 минут — 1,25× цены входа, запись кэша на 1 час — 2×. Это значит, что стратегию кэширования, продуманную для Opus, можно один в один перенести на Qwen4-Max, а счёт пропорционально уменьшится до 37,5%. Важно учитывать: в APIYI у qwen3.8-max чтение кэша стоит 12,5% от цены входа — пропорция отличается от официальной у Qwen4-Max, поэтому при миграции считайте отдельно по фактической модели.
Конкретный расчёт
Возьмём 100 млн входных токенов + 10 млн выходных токенов: Qwen4-Max — около $195 (150 + 45), Opus 5.5 — около $600 (400 + 200). Разница примерно $405, то есть две трети счёта Opus.
Но цена в прайсе не равна фактической оплате. Снимок публичного рейтинга на 2026-11-14 даёт стоимость одной задачи P50: Opus 5.5 (Max) — $8.99, Qwen4-Max (xHigh) — $4.18, отношение около 46%, а не 22,5% из прайса. Причина в разных уровнях рассуждений: Qwen4-Max по умолчанию работает на high, цепочка рассуждений тарифицируется как выходные токены, поэтому токенов расходуется больше. Сколько реально удастся сэкономить, зависит от длины задач и уровня рассуждений — лучше проверить на воспроизведении собственного трафика.
💰 Совет по стоимости: при сравнении счетов фиксируйте объём токенов по всем четырём позициям — вход, выход, чтение кэша и запись кэша, — а не только цену за токен. Через APIYI apiyi.com можно параллельно вызывать обе модели в одном аккаунте — детализация расхода будет в одном месте.
Qwen4-Max против Opus 5.5: рекомендации по выбору и миграция за три шага
Перевести агента с Opus на Qwen без трёх шагов не получится: проверить модель, сравнить цены и согласовать протокол.
Шаг первый: проверить модель. По состоянию на 2026-11-16 Qwen4-Max ещё не добавлена в каталог APIYI — мы стараемся добавить её как можно скорее; сейчас самая сильная модель на стороне Qwen — qwen3.8-max. На стороне Opus доступна claude-opus-5-5, а также claude-opus-5-5-thinking по той же цене. Названия моделей и цены смотрите в списке моделей в документации apiyi.com; до появления Qwen4-Max можно собрать пилотный контур на qwen3.8-max.
Шаг второй: сравнить цены. Как в предыдущем разделе, оцените стоимость обеих сторон на реальном трафике за неделю и сравнивайте только после выравнивания уровней reasoning. В списке моделей APIYI на apiyi.com входные, выходные токены и чтение кэша сведены в одну общую таблицу — её удобно использовать как источник данных для расчётной таблицы.
Шаг третий: согласовать протокол. APIYI предоставляет OpenAI-совместимый интерфейс с endpoint https://api.apiyi.com/v1; при смене модели достаточно изменить поле model, например с claude-opus-5-5 на qwen3.8-max, а api_key и base_url остаются прежними. Дополнительно проверьте два момента: параметр интенсивности reasoning на стороне Qwen называется reasoning_effort, по умолчанию стоит high; если хотите сопоставить его с medium у Opus, задайте значение явно. Правила записи в кэш и попадания в кэш тоже нужно заново проверить для целевой модели.
🎯 Совет по постепенному переходу: не переключайте всего агента за один раз. Разделите трафик на одном
base_url(https://api.apiyi.com/v1) по типам задач: сначала переносите автоматизацию и точечные исправления, а задачи для терминала и всего репозитория оставьте на Opus 5.5. Через две недели посмотрите на долю переделок и решите, что делать дальше.
Часто задаваемые вопросы (FAQ)
Q1: Кто лучше подходит на роль coding-агента — Qwen4-Max или Opus 5.5?
Всё зависит от гранулярности задачи. При исправлении отдельного issue (DeepSWE) оба варианта на равных, и можно взять Qwen4-Max, чтобы сэкономить; в многошаговых операциях в терминале и сборке всего репозитория (Terminal-Bench, ProgramBench) Opus 5.5 заметно впереди — особенно в ProgramBench, где разрыв составляет 33.5 балла, так что для таких задач продолжайте использовать Opus.
Q2: Можно ли сравнивать оценки с графиков Alibaba и с рейтингом arena?
Нет, это не одна и та же метрика. Первые — сравнение на одном графике, которое опубликовал сам Qwen, вторые — снимок публичного рейтинга (2026-11-14), к тому же у Qwen4-Max там всего 1,814 голосов и он всё ещё в статусе Preliminary. По ним можно сверять тренды, но не стоит объединять их в вывод «на сколько баллов впереди».
Q3: Сколько денег реально удастся сэкономить, перейдя на Qwen4-Max?
По прайсу на входе экономия 62.5%, на выходе — 77.5%. Но по публичному рейтингу отношение стоимости одной задачи P50 составляет около 46%, потому что у Qwen4-Max по умолчанию выше уровень рассуждений и больше токенов на размышления. Реальную экономию придётся считать, воспроизведя ваш трафик.
Q4: Можно ли сейчас вызывать Qwen4-Max через APIYI?
Пока нет — Qwen4-Max ещё не добавлен, но мы добавим его как можно скорее. Сейчас для построения цепочки миграции можно использовать `qwen3.8-max`, а после добавления достаточно будет изменить поле `model`. Статус моделей проверяйте в списке моделей на APIYI apiyi.com.
Q5: Сколько кода придётся менять при переходе с Opus на Qwen?
Если вы уже используете OpenAI-совместимый интерфейс, то после указания `base_url` на `https://api.apiyi.com/v1` останется только изменить имя модели и при необходимости задать `reasoning_effort`. После регистрации на APIYI apiyi.com можно воспользоваться бесплатным тестовым лимитом для новых пользователей и сначала прогнать одно сравнение.
Q6: Какие известные ограничения есть у Qwen4-Max?
Терминал и кодирование по всему репозиторию — самое слабое место; понимание графиков отстаёт на 12.1 балла, Elo на офисных deliverables ниже на 115, а способность к многораундовому самосовершенствованию тоже слабовата. Кроме того, все сравнительные оценки — самозаявленные производителем, третьестороннего воспроизведения пока нет, а по китайскому языку не хватает специализированных бенчмарков.
Qwen4-Max против Opus 5.5: ключевые выводы
- Главная слабость: в ProgramBench отставание на 33.5 балла — сборку и рефакторинг всего репозитория по-прежнему лучше вести на Opus 5.5.
- Где паритет: DeepSWE, APEX-Agents и HealthBench идут практически вровень — сюда можно смело перенаправлять задачи.
- Преимущества Qwen: автоматизация рабочих процессов, биомедицинские рассуждения, сверхдлинный вывод на 393K токенов.
- Структура цен: вход — 37.5%, выход — 22.5%, все четыре параметра кеша полностью повторяют схему Opus.
- Разница в фактической оплате: по умолчанию включён уровень рассуждений high, поэтому стоимость задач с публичных бенчмарков — около 46% от цены Opus.
- Путь миграции: на APIYI apiyi.com запускаете
qwen3.8-maxчерез тот же эндпоинт, а когда Qwen4-Max появится в продаже — просто меняете модель.
Итог
Выбор между Qwen4-Max и Opus 5.5 сводится к трём пунктам:
- Терминал и репозитории кода остаются за Opus 5.5: разрыв в Terminal-Bench и ProgramBench такой, что разница в цене не покрывает стоимость переделок.
- Автоматизацию и высокую нагрузку отдаём Qwen4-Max: на задачах, где возможности равны или выше, счёт меньше на 30–50% — это чистая экономия.
- Маршрутизация по задачам вместо полной замены: один и тот же интерфейс плюс распределение запросов по типу задачи — самый безопасный способ миграции.
Рекомендуем сначала на APIYI apiyi.com прогнать свой набор задач на qwen3.8-max и claude-opus-5-5, а окончательное решение о переключении принимать уже после выхода Qwen4-Max.
📚 Справочные материалы
- Блог о выпуске Qwen4-Max: сравнение спецификаций модели с официально заявленными бенчмарками
- Ссылка:
qwen.ai/blog?id=qwen4-max -
Описание: включает архитектурные параметры, контекст и лимиты вывода, а также сравнительные оценки на одном графике
-
Обзор моделей Anthropic: описание спецификаций Opus 5.5
- Ссылка:
platform.claude.com/docs/en/about-claude/models/overview.md -
Описание: контекст, максимальный вывод, значение effort по умолчанию и дата отсечки знаний
-
Страница цен Anthropic: стоимость ввода, вывода и кэширования для Opus 5.5
- Ссылка:
platform.claude.com/docs/en/about-claude/pricing.md -
Описание: включая цены записи в кэш на 5 минут и 1 час
-
Список моделей APIYI: текущие цены и доступные модели на платформе
- Ссылка:
docs.apiyi.com/models - Описание: проверка статуса доступности и цен моделей перед миграцией
Автор: техническая команда APIYI
Техническое общение: свяжитесь с нами на главной странице сайта APIYI apiyi.com — дополнительные материалы по интеграции доступны в центре документации docs.apiyi.com